Vous avez une URL de pin Pinterest et vous voulez le titre, la description et le nombre de sauvegardes. Vous n’avez pas besoin d’un navigateur pour le scraper. Une page de pin déconnectée contient les trois dans un bloc JSON-LD, plus le pinner et le lien sortant. Les flux RSS de profil et de tableau listent les URLs de pins via HTTP simple.
Mais rien de tout cela n’atteint la recherche. Pinterest construit la grille de recherche dans le navigateur et place une fenêtre modale de connexion par-dessus pour les visiteurs déconnectés. Les tuiles qui s’affichent n’ont ni titres ni liens.
Ce guide explique comment scraper Pinterest correctement, et obtenir toutes les données publiques dont vous avez besoin.
TL;DR
Un pin public s’analyse via HTTP simple, tandis que la recherche par mot-clé et les crawls complets de profil nécessitent une API gérée.
- La barrière sur la recherche lit l’état du compte, pas un score de bot, donc un navigateur furtif ne change rien.
- Les anciens guides échouent pour deux raisons :
pinWrapperne correspond à rien, et l’enregistrement n’est pas dans le store Redux. - Une IP de centre de données obtient la page du pin sans son bloc JSON-LD, donc exécutez depuis une adresse résidentielle.
- Les deux méthodes gratuites combinées sur les tableaux d’un compte ont atteint 435 pins uniques, sur plus de 9 000 détenus.
Ce que vous pouvez extraire de Pinterest
Un enregistrement de pin contient le titre, la description, les URLs d’image ou de vidéo, les hashtags, une catégorie, un nombre de commentaires, et l’URL de profil du pinner. Les profils listent le nombre d’abonnés, les noms de tableaux, et les pins qu’un utilisateur a publiés.
La difficulté est l’accès, pas le modèle de données. Les directives développeurs de Pinterest interdisent “tout moyen automatisé ou forme de scraping ou d’extraction de données pour accéder aux informations de Pinterest”. Le fichier robots est une liste d’autorisation, pas une liste de blocage : il nomme des centaines de crawlers un par un et donne à User-agent: * un Disallow: /. Tout client qu’il ne nomme pas n’est pas autorisé.
Donc collectez uniquement des données publiques, gardez les taux de requêtes bas, et ne vous connectez pas avec un compte personnel pour automatiser cela. Les noms de pinners et les URLs de profil sont des données personnelles sous le RGPD, et les mêmes directives interdisent d’utiliser le matériel Pinterest pour entraîner des modèles d’IA. Pour tout ce qui dépasse cela, consultez un professionnel.
Ce qu’une page de pin retourne en HTTP simple
Pour une URL de pin que vous avez déjà, vous n’avez pas besoin d’un navigateur. Une page de pin déconnectée intègre un bloc JSON-LD SocialMediaPosting, et ce bloc est l’enregistrement.
Vous avez besoin de Python 3 et de rien d’autre pour commencer : json, re et urllib sont tous de la bibliothèque standard. Le premier pip install vient plus tard, quand vous transformez un profil en flux de tableaux.
Analysez le bloc et vous obtenez les données du pin en quelques lignes :
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
BOILERPLATE = "Discover (and save!) your own Pins"

def scrape_pin(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script[^>]*type="application/ld\+json"[^>]*>(.*?)</script>',
        html, re.S)
    if not block:            # pin supprimé : pas de bloc JSON-LD sur la page
        return None
    data = json.loads(block.group(1))

    # Les pins de recettes utilisent name/description, tous les autres headline/articleBody
    description = data.get("articleBody") or data.get("description")
    if description and BOILERPLATE in description:
        description = None   # texte de remplissage Pinterest, pas les mots propres du pin

    saves = next((s.get("userInteractionCount")
                  for s in data.get("interactionStatistic") or []), None)
    return {
        "schema": data.get("@type"),
        "title": data.get("headline") or data.get("name"),
        "description": description,
        "pinner": (data.get("author") or {}).get("name"),
        "image": data.get("image"),
        "date": data.get("datePublished"),
        "source_link": (data.get("sharedContent") or {}).get("url"),
        "saves": saves,
    }

if __name__ == "__main__":
    print(json.dumps(scrape_pin(
        "https://www.pinterest.com/pin/99360735523397542/"), indent=2))
Exécutez-le et un pin actif retourne un enregistrement complet :
{
  "schema": "SocialMediaPosting",
  "title": "12 Bombshell Hair Color Ideas To Try This Summer | Ecemella",
  "description": "A person with long, straight reddish-brown hair wearing a black leather jacket...",
  "pinner": "Sarah Komnick",
  "image": "https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
  "date": "2023-05-24T22:32:51.000Z",
  "source_link": "https://www.ecemella.com/summer-hair-color-ideas/",
  "saves": 196
}
Tout cela provient d’une seule requête.
L’enregistrement est dans le bloc JSON-LD, pas dans le store Redux de la page. Un second script, __PWS_INITIAL_PROPS__, définit initialReduxState.pins sur un objet vide. Un scraper qui lit le store ne trouve rien. Et un pin supprimé n’a aucun bloc JSON-LD du tout, donc scrape_pin retourne None plutôt qu’un enregistrement partiel.
Pinterest sert plus d’un type JSON-LD, et ignorer schema casse un scraper silencieusement. Sur 105 pins, 100 ont retourné SocialMediaPosting et 5 ont retourné Recipe, et chacun incluait un bloc JSON-LD.
Les 105 provenaient de deux sources : 90 des flux RSS de 10 comptes, qui n’ont retourné aucun pin vidéo du tout. Les 15 autres venaient d’une recherche par mot-clé via le Scraper API, dont 10 étaient des vidéos. Les pins vidéo utilisent le même schéma SocialMediaPosting et s’analysent sans erreur.
La séparation entre les deux schémas est totale plutôt que partielle, ce qui la rend facile à manquer. Dans l’échantillon de 90 pins issu des flux, les 85 posts sociaux incluaient tous headline, articleBody, datePublished, et sharedContent, et aucune des 5 recettes n’en incluait aucun. Un pin recette utilise name et description à la place. Lire seulement headline ne retourne rien pour toute la catégorie, et vous laisse sans date ni lien sortant.
Les pins vidéo ont un problème différent. Leur image JSON-LD est une image fixe .jpg, et le bloc ne contient ni contentUrl, ni duration, ni embedUrl.
La vidéo elle-même est un manifeste HLS, le format de playlist HTTP Live Streaming, sur v1.pinimg.com. Il apparaît dans le HTML de la page plutôt que dans le bloc structuré, donc un pin vidéo s’analyse avec succès et retourne une miniature. Les enregistrements du Scraper API incluent video_length et une URL de média directement, ce qui identifie les pins vidéo sans seconde requête.
Le mélange dépend du compte, et il peut s’inverser. Échantillonné séparément, le flux d’un compte culinaire a retourné 19 des 25 pins comme Recipe. Une analyse ne lisant que headline aurait retourné un titre vide pour les trois quarts d’entre eux. Les pins recettes ajoutent recipeYield et aggregateRating si ceux-ci vous sont utiles.
Sur les pins recettes, la description est souvent une chaîne de remplissage Pinterest plutôt que quelque chose écrit par le pinner. Le code retourne None au lieu de la traiter comme contenu.
Ce qui casse réellement en volume
Pinterest place Akamai devant ses pages de pins, mais rien dans les réponses ne suggère que Bot Manager y soit actif. Douze requêtes rapides envoyées avec le User-Agent urllib par défaut ont toutes retourné 200. Les réponses ont défini uniquement csrftoken, _pinterest_sess, _auth, et _routing_id. Aucun des cookies Akamai Bot Manager n’est apparu, et aucune charge utile de capteur n’a été servie, donc il n’y avait aucun défi TLS à résoudre.
Sur six identités clients, le même pin a servi son bloc JSON-LD à chaque fois. Celles-ci incluaient un User-Agent Chrome, curl, Googlebot, et une chaîne vide. Donc l’analyse n’a pas besoin d’un faux User-Agent.
C’est vrai depuis une adresse résidentielle. Sur cinq pins, une récupération résidentielle a inclus le bloc JSON-LD à chaque fois et une récupération depuis un centre de données jamais. Les deux ont retourné la bonne page, le bon titre, et un nombre similaire de scripts.
Pinterest indique la différence dans la page elle-même, sous l’objet context dans __PWS_DATA__. is_hosting lisait false côté résidentiel et true côté hébergement, avec is_bot à false dans les deux cas. Donc le test est la réputation du réseau, pas un score de bot.
Exécutez scrape_pin depuis une VM cloud et il a retourné None sur chaque pin testé, sans rien sur la page pour expliquer pourquoi. Un client à empreinte digitale ne change pas l’adresse depuis laquelle vous opérez.
Votre choix de client HTTP compte plus que tout cela une fois que vous payez pour le trafic. La bibliothèque standard urllib n’envoie aucun en-tête Accept-Encoding, donc le serveur répond non compressé. L’exemple stdlib télécharge environ 1,13 Mo par pin.
La bibliothèque requests négocie gzip par défaut et transfère environ 183 Ko. Un navigateur proposant Brotli obtient environ 124 Ko. C’est la même page et les mêmes données, avec une différence de 9x dans les octets transférés décidée par le client que vous avez choisi.
Cela compte car les proxys facturent les octets transférés. À 10 000 pins, l’exemple stdlib déplace 11,3 Go, contre 1,83 Go pour le même travail via requests. Au tarif résidentiel affiché de 8$/Go, c’est environ 90$ au lieu de 15$. Utilisez la version stdlib pour comprendre son fonctionnement, puis passez à requests ou curl_cffi pour tout ce que vous exécutez réellement.
La réputation IP empire en volume, pas votre empreinte TLS. Donc faire tourner des adresses résidentielles aide ici, alors qu’un client à empreinte digitale n’aide pas vraiment. Si vous trouvez plus tard une page Pinterest qui vérifie bien la poignée de main, curl_cffi (documentation de la bibliothèque) est le remplacement standard et laisse l’analyse intacte :
from curl_cffi import requests as cffi   # pip install curl_cffi

resp = cffi.get("https://www.pinterest.com/pin/99360735523397542/",
                impersonate="chrome", timeout=30)
html = resp.text                 # donnez ceci à la même analyse JSON-LD
Deux limites s’appliquent. Il ne donne pas accès aux points de terminaison internes de Pinterest. PinResource a retourné 403 à la fois au simple urllib et à un client imitant Chrome, donc l’empreinte digitale n’est pas le problème là. Et il ne peut pas répondre à un défi JavaScript si celui-ci est servi.
Le point de terminaison oEmbed officiel
Pinterest publie un point de terminaison oEmbed pour les pins publics. C’est la recherche de pin unique la plus légère ici, et elle répond avec du JSON plutôt qu’une page de HTML. Cet appel utilise curl, qui est inclus avec macOS, Linux et Windows 10 et versions ultérieures. Vous pouvez aussi le tester en collant l’URL directement dans un navigateur d’abord :
PIN="https://www.pinterest.com/pin/99360735523397542/"
curl "https://www.pinterest.com/oembed.json?url=$PIN"
Il répond avec l’attribution, une miniature, et un intégration prêt à l’emploi :
{"version":"1.0","type":"rich","provider_name":"Pinterest","title":" ",
 "author_name":"Sarah Komnick",
 "author_url":"https://www.pinterest.com/sarahkomnick/",
 "thumbnail_url":"https://i.pinimg.com/236x/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
 "thumbnail_width":236,"thumbnail_height":314,
 "html":"<iframe src=\"https://assets.pinterest.com/ext/embed.html?id=99360735523397542\" ...></iframe>"}
Parmi les routes que vous exécutez vous-même, celle-ci a la moindre exposition. oEmbed est le format standard que les sites publient pour que des tiers puissent intégrer leur contenu. C’est une interface publiée, pas une API interne.
Il accepte aussi les URLs de tableau et de profil, pas seulement les pins. Il a retourné un vrai titre pour les deux, là où l’appel du pin le laissait vide. Une description, un nombre de sauvegardes, et un lien source sortant ne sont pas dans la réponse.
Pinterest retourne des 404 souples pour ses pages de pins. Un pin supprimé, un ID numérique inexistant, et un slug mal formé ont tous retourné HTTP 200. Un ID tronqué et un ID numérique inutilisé aussi, tous avec le bloc JSON-LD absent. Toute vérification basée sur response.status ne mesure rien.
Le point de terminaison oEmbed répond HTTP 400 à la place. Il l’a fait dans les 5 cas de ce type, tandis qu’un pin actif a retourné 200.
Il transfère une médiane de 583 octets sur 19 pins, comparé à environ 124 Ko pour la page. Cela en fait le moyen économique de filtrer une liste d’URLs avant d’analyser quoi que ce soit. 80 appels consécutifs sans délai ont tous retourné 200, sans limitation de débit et sans changement de latence.
Découvrir les URLs de pins sans la grille de recherche
Tant l’analyse JSON-LD que oEmbed nécessitent une URL de pin que vous avez déjà. Alors d’où viennent les URLs ?
Une route semble évidente et ne l’est pas. Le fichier robots de Pinterest déclarait 50 URLs Sitemap: sous /v3_sitemaps/ lors de la vérification. Les noms décrivent exactement ce qu’un collecteur voudrait : image_pin_sitemap_recent_engagement_tier_1, video_product_pin_sitemap, plusieurs niveaux de sitemap de liens de tableaux. Les 50 ont retourné HTTP 404.
Un sitemap déclaré vaut une requête avant d’y faire confiance.
Pour un profil ou un tableau, les URLs proviennent du RSS. Pinterest publie encore des flux non authentifiés à /<username>/feed.rss et /<username>/<board-slug>.rss :
import re, urllib.request
import xml.etree.ElementTree as ET

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def list_pins(feed_url):
    req = urllib.request.Request(feed_url, headers={"User-Agent": UA})
    xml = urllib.request.urlopen(req, timeout=30).read()
    pins = []
    for item in ET.fromstring(xml).findall(".//item"):
        desc = item.findtext("description") or ""
        thumb = re.search(r'src="([^"]+)"', desc)
        pins.append({
            "url": item.findtext("link"),
            "published": item.findtext("pubDate"),
            "thumbnail": thumb.group(1) if thumb else None,
        })
    return pins

if __name__ == "__main__":
    feed = list_pins("https://www.pinterest.com/boredpanda/animals.rss")
    print(f"found {len(feed)} pins")
    print(feed[0])
Un flux de tableau a retourné une liste exploitable d’URLs de pins réelles :
found 26 pins
{'url': 'https://www.pinterest.com/pin/150307706316766946/',
 'published': 'Thu, 23 Jul 2026 12:14:04 GMT',
 'thumbnail': 'https://i.pinimg.com/236x/18/a4/8b/18a48b04fbe868130b0a2ad14759fe87.jpg'}
Ouvrez l’une de ces URLs de flux dans un navigateur et la structure est facile à lire. Chaque <item> contient le lien du pin, une date de publication, et une miniature dans la description :
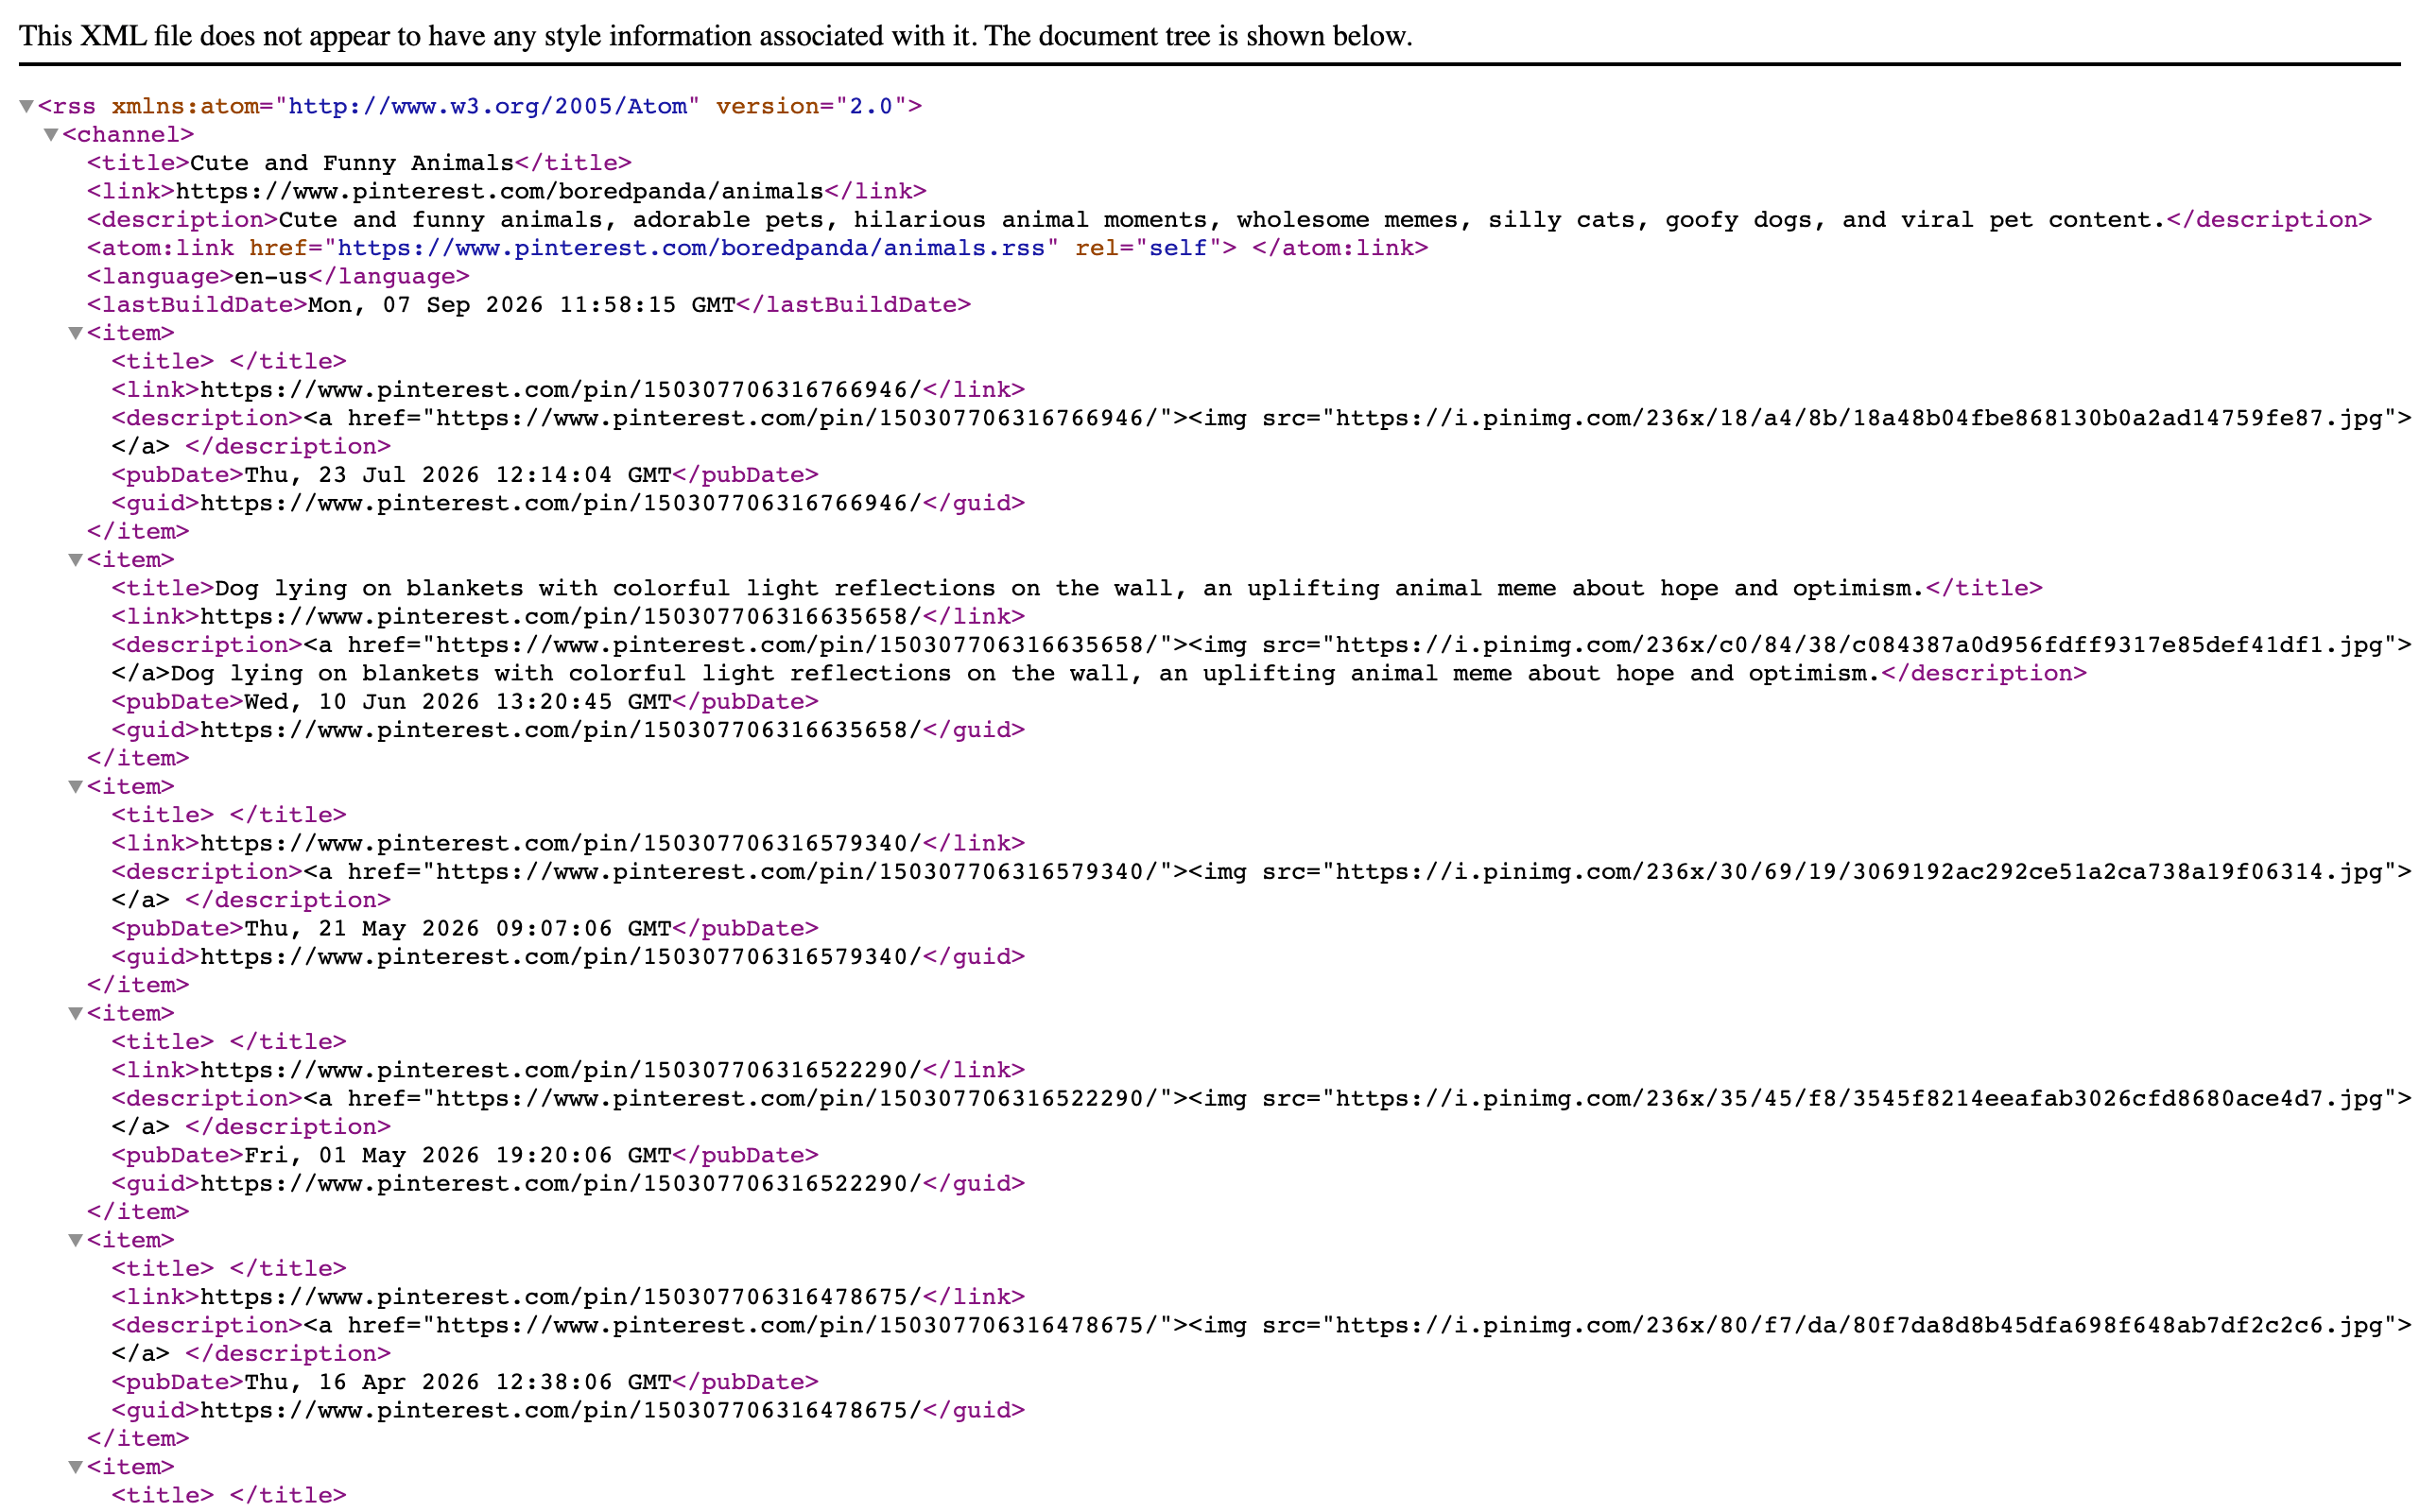
Les balises <title> vides sont la raison pour laquelle le flux est une source d’URLs plutôt que de métadonnées. Un élément de ce flux a un vrai titre ; le reste est vide.
Chaîner cela avec l’analyse par pin vous donne un pipeline complet qui ne charge jamais de navigateur. Enregistrez scrape_pin et list_pins ensemble sous pinterest.py, et ceci les importe sans modification :
import time, json
import xml.etree.ElementTree as ET
from pinterest import scrape_pin, list_pins   # depuis pinterest.py

def collect_feed(feed_url, delay=0.5):
    records = []
    try:
        pins = list_pins(feed_url)
    except (OSError, ET.ParseError) as err:   # passer un flux défectueux, continuer
        print(f"skipped feed {feed_url}: {err}")
        return records
    for pin in pins:
        time.sleep(delay)         # avant la requête, pour que les sauts restent polis aussi
        try:
            record = scrape_pin(pin["url"])
        except (OSError, ValueError) as err:  # transitoire : garder ce qu'on a
            print(f"skipped {pin['url']}: {err}")
            continue
        if record is None:        # pin supprimé : la page fait un soft-404 vers 200
            continue
        record["url"] = pin["url"]
        record["feed_published"] = pin["published"]
        records.append(record)
    return records

rows = collect_feed("https://www.pinterest.com/foodnetwork/feed.rss")
print(f"{len(rows)} pins enriched")
with open("feed-pins.json", "w") as f:
    json.dump(rows, f, indent=2)
Sur un compte culinaire, il a imprimé 25 pins enriched en 46 secondes. Les 25 avaient un titre, et le mélange de schémas était de 19 recettes pour 6 posts sociaux. Des flux étaient disponibles sur les 12 comptes testés, des créateurs individuels aux grandes marques. Les flux de profil ont retourné 22 à 25 éléments et les flux de tableau 23 à 26.
Le flux a une limite fixe plutôt que de croître avec le tableau. Un tableau rapportant près de 6 000 pins a retourné 24 éléments, le même nombre qu’un tableau en contenant 39. En dessous de cette limite, vous obtenez à peu près ce qu’il y a : un tableau contenant 6 pins en a retourné 5.
Transformer un profil en un ensemble de flux de tableaux
Un compte a plus d’un flux, et la page de profil les liste publiquement, avec noms et nombre de pins, sans connexion requise :
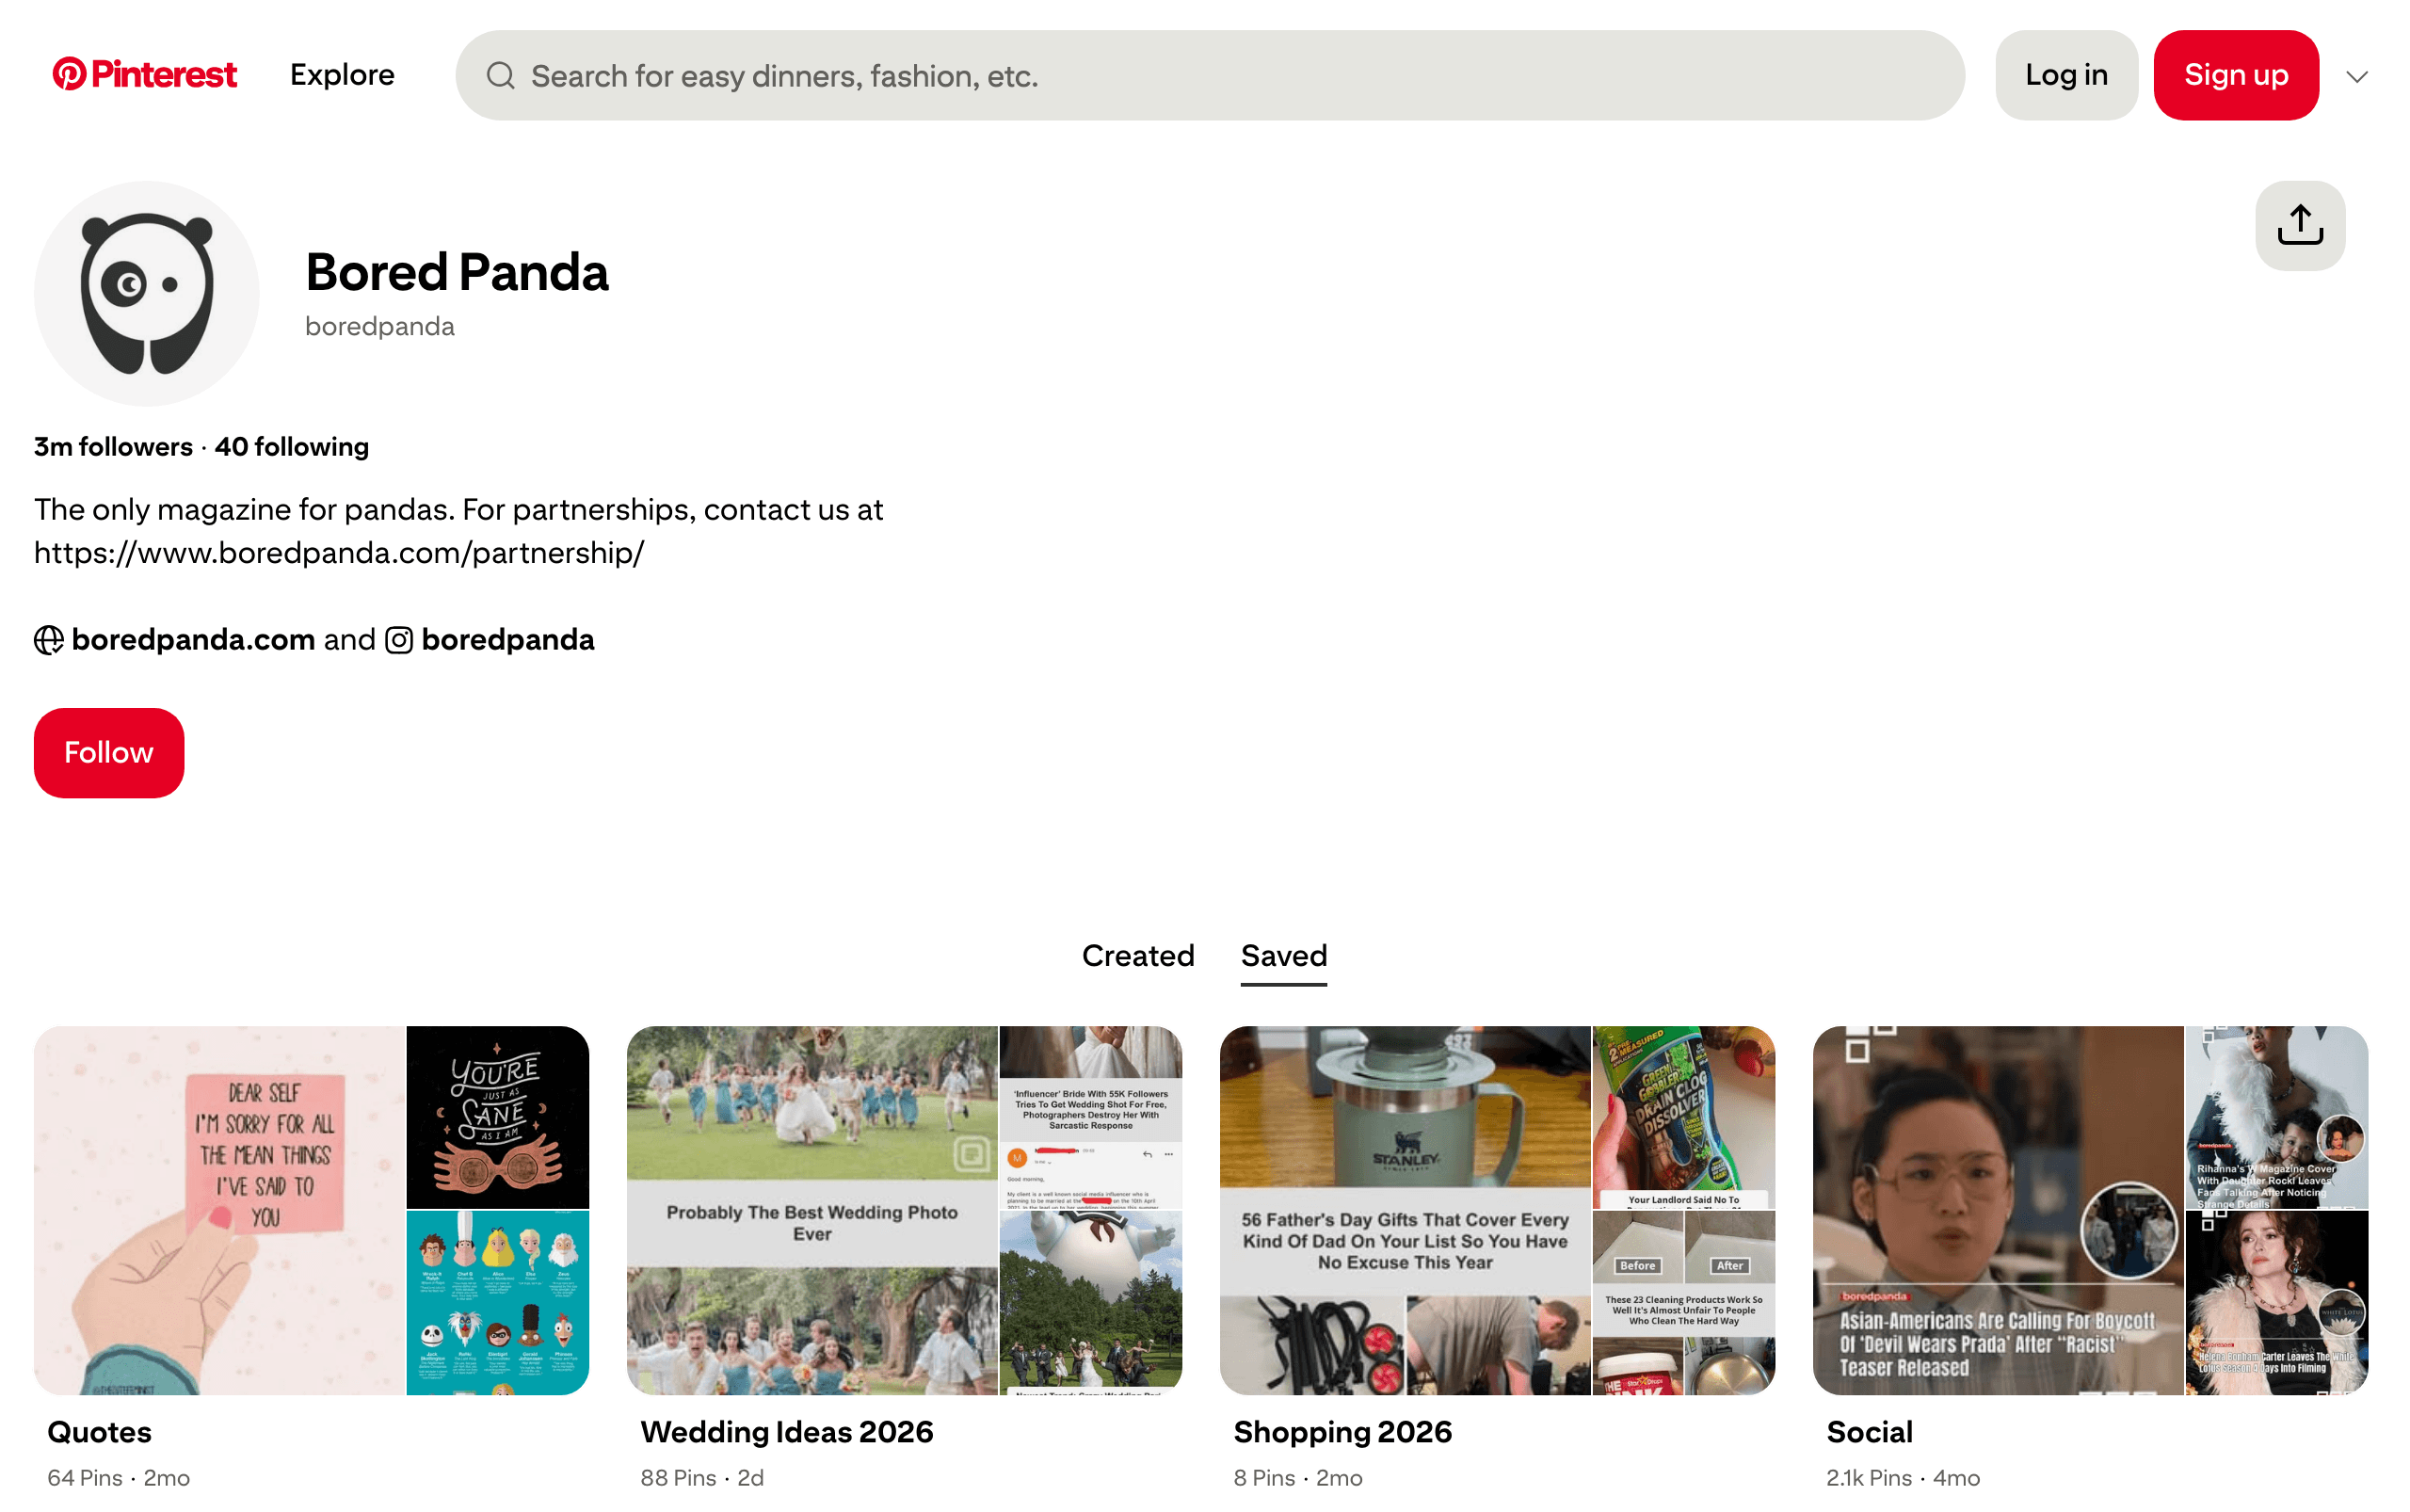
La recherche reçoit une fenêtre modale de connexion ; un profil non. Ces noms de tableaux sont les slugs que list_boards lit depuis le HTML de la page. Les nombres de pins vous indiquent quels tableaux atteindront la limite du flux et lesquels sont assez petits pour qu’il en retourne la plupart.
Les slugs de tableaux apparaissent généralement dans le HTML du profil via HTTP simple, donc une regex transforme un nom de compte en un ensemble d’URLs de flux :
import re, requests            # pip install requests

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
RESERVED = {"pins", "boards", "followers", "following"}   # routes, pas des tableaux

def list_boards(handle):
    html = requests.get(f"https://www.pinterest.com/{handle}/",
                        headers={"User-Agent": UA}, timeout=30).text
    found = re.findall(rf'"/{handle}/([A-Za-z0-9][A-Za-z0-9_-]*)/"', html)
    slugs = set(found) - RESERVED
    base = f"https://www.pinterest.com/{handle}"
    return [f"{base}/{s}.rss" for s in sorted(slugs)]

feeds = list_boards("boredpanda")
print(f"{len(feeds)} board feeds")
print(feeds[0])
Un compte a retourné neuf flux de tableaux :
9 board feeds
https://www.pinterest.com/boredpanda/animal-memes.rss
Aux côtés de la liste de tableaux, le HTML de profil déconnecté intègre un bloc JSON-LD ProfilePage. Il s’est analysé sur les 8 comptes testés.
Il donne le nom d’affichage, le handle, la bio, l’URL de l’avatar, et la date de création du compte. Un tableau sameAs pointe vers les autres profils du propriétaire, ce qui sur ces comptes signifiait Instagram et leur propre domaine. Six des 8 incluaient aussi un nombre d’abonnés sous interactionStatistic, celui d’Etsy lisant plus de 11 millions. C’est la même analyse que la page de pin, visant une URL différente.
Faire passer les 9 flux de tableaux par list_pins a retourné 208 URLs de pins uniques depuis boredpanda, comparé aux 25 d’un seul flux. Aucun pin n’est apparu dans deux flux de tableaux. Chaque compte testé listait ses tableaux ainsi : 10 sur 10, entre 8 et 10 slugs chacun. Le flux du premier tableau a retourné des éléments sur les 10.
Ces 9 sont les tableaux que la page de profil montre, pas l’ensemble complet du compte. L’enregistrement de profil de l’API rapporte 51 pour le même compte. Le HTTP simple atteint 9 de ces 51, chacun via la même limite de 25 éléments.
Le flux animals utilisé précédemment en est un qu’il manque, donc un tableau que vous connaissez déjà vaut toujours la peine d’être demandé directement. Un profil actif peut aussi ne retourner aucun slug du tout. Traitez une liste vide comme un signal pour vérifier le handle, pas comme une preuve que le compte n’a pas de tableaux.
Les titres de flux étaient vides sur tous sauf un élément parmi les flux testés. Laissez l’analyse par pin fournir le reste.
Deux routes au-delà de la limite du flux
Le scraper de profils dans le Scraper API atteint la liste de tableaux depuis l’autre direction. boards_num rapportait 51 tableaux pour boredpanda, donc vous connaissez la taille de l’ensemble avant de commencer.
Chaque entrée dans son tableau saved inclut une saved_collection_url, et cette URL plus .rss a retourné un flux sur les 6 tableaux testés. Le tableau lui-même a retourné 10 de ces 51, une autre liste partielle.
Retirez le slash final avant d’ajouter. saved_collection_url se termine par un, et Pinterest traite les deux formes résultantes très différemment. Se terminant par quotes.rss retourne un flux de 13 Ko.
Se terminant par quotes/.rss retourne HTTP 200 et l’application HTML à la place. Cela échoue à l’intérieur de votre analyseur XML avec une erreur de jeton invalide pointant vers une ligne de JavaScript. Construisez l’URL avec saved_collection_url.rstrip("/") + ".rss" et cette forme ne peut pas atteindre l’analyseur.
L’ancien backend de widget à widgets.pinterest.com/v3/pidgets/ répond aussi aux requêtes non authentifiées, et sur la plupart des tableaux il a retourné plus que RSS. Son point de terminaison de tableau a retourné 50 pins là où le flux du même tableau en retournait 26, chacun avec une description. Il rapporte aussi un pin_count au niveau du tableau, donc vous avez une idée de ce qui vous manque.
Cinquante est une limite plutôt qu’une taille de page. page, offset, limit, count et page_size ont tous été ignorés, chacun retournant les mêmes 50. Sur neuf tableaux de boredpanda, le backend de widget a atteint 362 pins uniques, comparé à 208 des flux de tableaux. Les deux ensemble ont atteint 435, sur plus de 9 000 détenus sur ces tableaux.
Trois choses avant d’en faire une dépendance. Son repin_count n’est pas le nombre de sauvegardes JSON-LD. Lus ensemble sur le pin utilisé tout au long de ce guide, il a retourné 77 là où le JSON-LD retournait 196. Seul le chiffre JSON-LD est celui que Pinterest étiquette comme Sauvegardes.
Les liens sortants varient selon le tableau : 50 sur 50 pins sur l’un, 5 sur 43 sur un autre. Les descriptions arrivaient sur presque tous les pins. Et ce n’est pas toujours mieux : sur un petit tableau, RSS a retourné 9 contre 8. Le point de terminaison n’est pas documenté, n’a pas de recherche, et n’a aucune garantie de compatibilité.
Au-delà de ce cinquantième pin, ou sur un calendrier, le crawl de profil dans le Scraper API s’exécute sur l’ensemble du compte comme une tâche en arrière-plan. Il retourne un enregistrement structuré pour chaque pin qu’il trouve.
La découverte dans le Scraper API fonctionne au niveau du profil, donc passez l’URL de profil et filtrez les enregistrements vers le tableau que vous voulez. Sur deux tableaux testés, une URL de tableau a retourné le profil plutôt que le tableau nommé dans la requête.
Pourquoi les méthodes gratuites s’arrêtent à la recherche
Récupérez une page de résultats de recherche et le HTML a zéro bloc JSON-LD. La grille est construite par des requêtes de navigateur ultérieures, et celles-ci sont barrées pour les sessions déconnectées. En septembre 2026, le bloc __PWS_DATA__ liste dix expériences lop_unauth_lockdown_*, _main, _closeup et _search parmi elles.
Deux des dix nomment les routes utilisées par ce guide : lop_unauth_lockdown_profile et lop_unauth_lockdown_board. Le barrage pour les déconnectés est une expérience en cours, pas une partie permanente du site. Donc traitez l’accès profil et tableau comme quelque chose à surveiller plutôt qu’à supposer.
Le même bloc montre ce que la barrière vérifie, car Pinterest enregistre sa propre vue de votre client dedans. Sous context, les pages de pin, recherche et profil incluent toutes les mêmes 15 champs de classification. Ceux-ci incluent is_bot, is_proxy, is_vpn, is_tor, is_hosting, is_unauth_botspam_asn et is_authenticated.
Demandé depuis une adresse résidentielle ordinaire, is_bot retournait "false" et chaque drapeau proxy et hébergement retournait false. La grille de recherche était barrée malgré tout. Les expériences de barrage lisent l’état déconnecté, pas un score de bot.
is_hosting séparait les récupérations qui retournaient le JSON-LD d’un pin de celles qui arrivaient sans lui. Alors lisez context depuis la balise <script id="__PWS_DATA__"> sur une seule page de pin. C’est le moyen le moins coûteux de confirmer que l’adresse depuis laquelle vous collectez se comporte comme prévu. Faites-le avant de gaspiller une exécution en blâmant un faible nombre d’enregistrements sur votre analyseur.
C’est non documenté et interne, pas une promesse que Pinterest fait, donc traitez-le comme une vérification que vous répétez. L’objet contient aussi un unauth_id et le pays et la région de votre IP. Masquez-les avant que les données ne quittent votre machine.
Cette vérification est l’analyse JSON-LD visant l’autre balise de script :
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
FLAGS = ("is_bot", "is_proxy", "is_vpn", "is_tor", "is_hosting",
         "is_unauth_botspam_asn", "is_authenticated")

def how_pinterest_sees_you(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script id="__PWS_DATA__" type="application/json">(.*?)</script>',
        html, re.S)
    if not block:
        return None
    ctx = json.loads(block.group(1)).get("context") or {}
    # cet objet contient aussi unauth_id et la géo de votre IP : ne retournez pas ça
    return {k: ctx.get(k) for k in FLAGS}

print(how_pinterest_sees_you(
    "https://www.pinterest.com/pin/99360735523397542/"))
Exécutez-le depuis une connexion domestique et depuis une VM cloud et un champ bouge :
# résidentiel
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': False, 'is_unauth_botspam_asn': False, 'is_authenticated': False}

# même pin, même analyse, plage d'hébergement
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': True, 'is_unauth_botspam_asn': False, 'is_authenticated': False}
is_bot arrive comme la chaîne "false" tandis que les autres drapeaux sont de vrais booléens, donc comparez-le comme une chaîne. is_hosting est le champ qui bouge, et il décide si la page de pin inclut un bloc JSON-LD.
Les points de terminaison JSON internes que les anciens guides appellent sont fermés en tant que classe, pas un par un. PinResource, BoardFeedResource, UserResource, BaseSearchResource et RelatedModulesResource ont tous retourné HTTP 403 aux requêtes non authentifiées. C’était vrai avec ou sans une empreinte TLS correspondant à un vrai navigateur.
Les requêtes passent par Akamai comme un CDN. La même vérification de cookies sur les pages de recherche et de profil n’a montré aucun marqueur Bot Manager là non plus.
Pourquoi l’API Pinterest officielle n’est pas un outil de scraping
Pinterest exploite bien une API REST, et il est tentant de l’essayer en premier. Elle ne collectera pas de contenu public à une échelle utile, et la raison est le périmètre, pas la qualité.
L’API v5 est construite pour gérer votre propre compte : vos tableaux, vos pins, vos publicités, vos analyses. La catégorie org_read s’applique à “la récupération des comptes utilisateur, tableaux, sections de tableau, ou Pins” pour le compte authentifié. En dehors de la bêta de recherche partenaire, aucun point de terminaison ne retourne un pin public que vous ne possédez pas.
La seule recherche par mot-clé est GET /v5/search/partner/pins, une bêta “non disponible pour toutes les applications” qui retourne les 10 premiers pins. Les données que la plupart des projets de scraping veulent, les pins et profils publics d’autres personnes, ne sont pas accessibles via l’API.
Cette même page publie aussi les limites de débit. En septembre 2026, l’accès d’essai autorisait 1 000 requêtes par jour sur tous les points de terminaison. L’accès standard autorisait 100 requêtes par seconde par utilisateur par application. Pinterest note là que tous sont “sujets à changement sans préavis”.
Pour des données publiques tierces à grande échelle, l’API officielle est le mauvais outil. Donc la collecte au-delà des routes HTTP simple nécessite une automatisation de navigateur ou un scraper géré.
Scraper Pinterest avec Playwright
La recherche est la seule route qui nécessite un navigateur pour rendre la page, et Playwright en pilote un depuis Python. Si vous ne l’avez jamais utilisé auparavant, le blog Bright Data a un tutoriel Playwright plus détaillé dont l’API fonctionne de la même manière.
Sachez ce que cette route retourne avant de l’installer : des URLs d’images et rien d’autre, sans titres, sans descriptions et sans liens de pins. Si cela ne suffit pas pour votre cas d’usage, lisez Où l’approche navigateur échoue et passez l’installation.
Installez la bibliothèque et un navigateur :
pip install playwright
playwright install chromium
Ce script ouvre une page de recherche, défile, et lit les tuiles de pins. Un détail compte en premier : le sélecteur de tuile a changé. Les anciens guides ciblent div[data-test-id='pinWrapper'], qui ne correspond à rien sur le site déconnecté aujourd’hui. La grille déconnectée actuelle utilise gated-pin-rep pour chaque tuile et gated-pin-image pour son image :
import asyncio, json
from playwright.async_api import async_playwright

BROWSER_UA = ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
              "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

async def scrape_pins(query, scrolls=6):
    url = f"https://www.pinterest.com/search/pins/?q={query}&rs=typed"
    seen = set()
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page(user_agent=BROWSER_UA,
                                      viewport={"width": 1280, "height": 900})
        await page.goto(url, wait_until="domcontentloaded")
        for _ in range(scrolls):
            await asyncio.sleep(1.5)
            images = await page.query_selector_all(
                "[data-test-id='gated-pin-image'] img")
            for img in images:
                src = await img.get_attribute("src")
                if src and "/236x/" in src:   # miniatures de pins, pas des images d'UI
                    seen.add(src)
            await page.mouse.wheel(0, 4000)
        await browser.close()
    return sorted(seen)

async def main():
    results = await scrape_pins("minimalist%20office")
    print(f"collected {len(results)} thumbnail URLs")
    with open("office-pins.json", "w") as f:
        json.dump(results, f, indent=2)

if __name__ == "__main__":
    asyncio.run(main())
Définir un User-Agent est le conseil le plus répété pour le scraping Pinterest, et il ne fait pas ce que les gens prétendent. Aucune surcharge, une chaîne Chrome actuelle, une chaîne Chrome vieille de deux ans, et un littéral python-requests/2.32.3 retournent tous HTTP 200 et le même nombre de tuiles. Chacun a retourné aucun lien de pin et la même fenêtre modale de connexion. Gardez-en un sensé malgré tout, car cela ne coûte rien et identifie votre trafic honnêtement.
L’ensemble compte car Pinterest réutilise les nœuds de tuiles au fur et à mesure que vous défilez. Exécutez-le et une session déconnectée imprime :
collected 16 thumbnail URLsDonc Playwright retourne des URLs de miniatures depuis la recherche, et rien au-delà.
Obtenir l’image en taille réelle depuis une miniature Pinterest
Les miniatures que ces exécutions retournent font 236 pixels de large. Si vous avez déjà le JSON-LD du pin ou un enregistrement de l’API, l’URL en taille réelle y est et aucune réécriture n’est nécessaire. En travaillant depuis une miniature à la place, le fichier en taille réelle se trouve au même chemin avec le segment de taille remplacé. Cet échange est habituellement écrit comme un remplacement de chaîne en une ligne, et cela seul échoue majoritairement.
Sur 40 miniatures de flux actifs, remplacer /236x/ par /originals/ et garder l’extension .jpg a fonctionné 5 fois. Il a retourné HTTP 403 les 35 autres fois. Pinterest ré-encode : la miniature est servie en .jpg tandis que l’original stocké est souvent en .png. Essayer les extensions les unes après les autres a fonctionné pour les 40.
Le fichier que vous téléchargez est la photographie de quelqu’un d’autre, donc ce que vous en faites est une question de licence plutôt que de scraping :
import re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def full_size(thumb_url):
    """Pinterest ré-encode, donc l'extension de l'original diffère souvent."""
    base = re.sub(r"/\d+x\d*/", "/originals/", thumb_url).rsplit(".", 1)[0]
    for ext in ("jpg", "png", "webp", "gif"):
        candidate = f"{base}.{ext}"
        req = urllib.request.Request(candidate, method="HEAD",
                                     headers={"User-Agent": UA})
        try:
            if urllib.request.urlopen(req, timeout=15).status == 200:
                return candidate
        except Exception:
            continue
    return None
Ne changez pas l’ordre cependant, car l’extension qui fonctionne varie selon le compte. Un échantillon de 40 a retourné .png 35 fois et .jpg 5 fois. Un échantillon ultérieur de 40 sur quatre comptes a retourné .webp 19 fois, .jpg 15 fois et .png 6 fois. Dans celui-ci, un compte était entièrement en .jpg, un autre entièrement en .webp, et un troisième majoritairement en .png.
Prévoyez environ deux requêtes HEAD par image : sur cet échantillon de quatre comptes, la boucle a fait en moyenne 2,1 recherches avant de trouver le fichier.
Où l’approche navigateur échoue
Playwright manque le reste de l’enregistrement. Le texte alt de chaque tuile est la chaîne littérale Pin, donc les tuiles n’ont pas de titres. Aucune d’entre elles n’enveloppe non plus un lien /pin/, donc la grille ne vous donne rien à suivre.
Vous obtenez une courte liste d’URLs d’images et rien d’autre : pas de descriptions, pas de pinner, pas de sauvegardes, pas de hashtags. Charger la même recherche dans un navigateur normal déconnecté montre pourquoi :
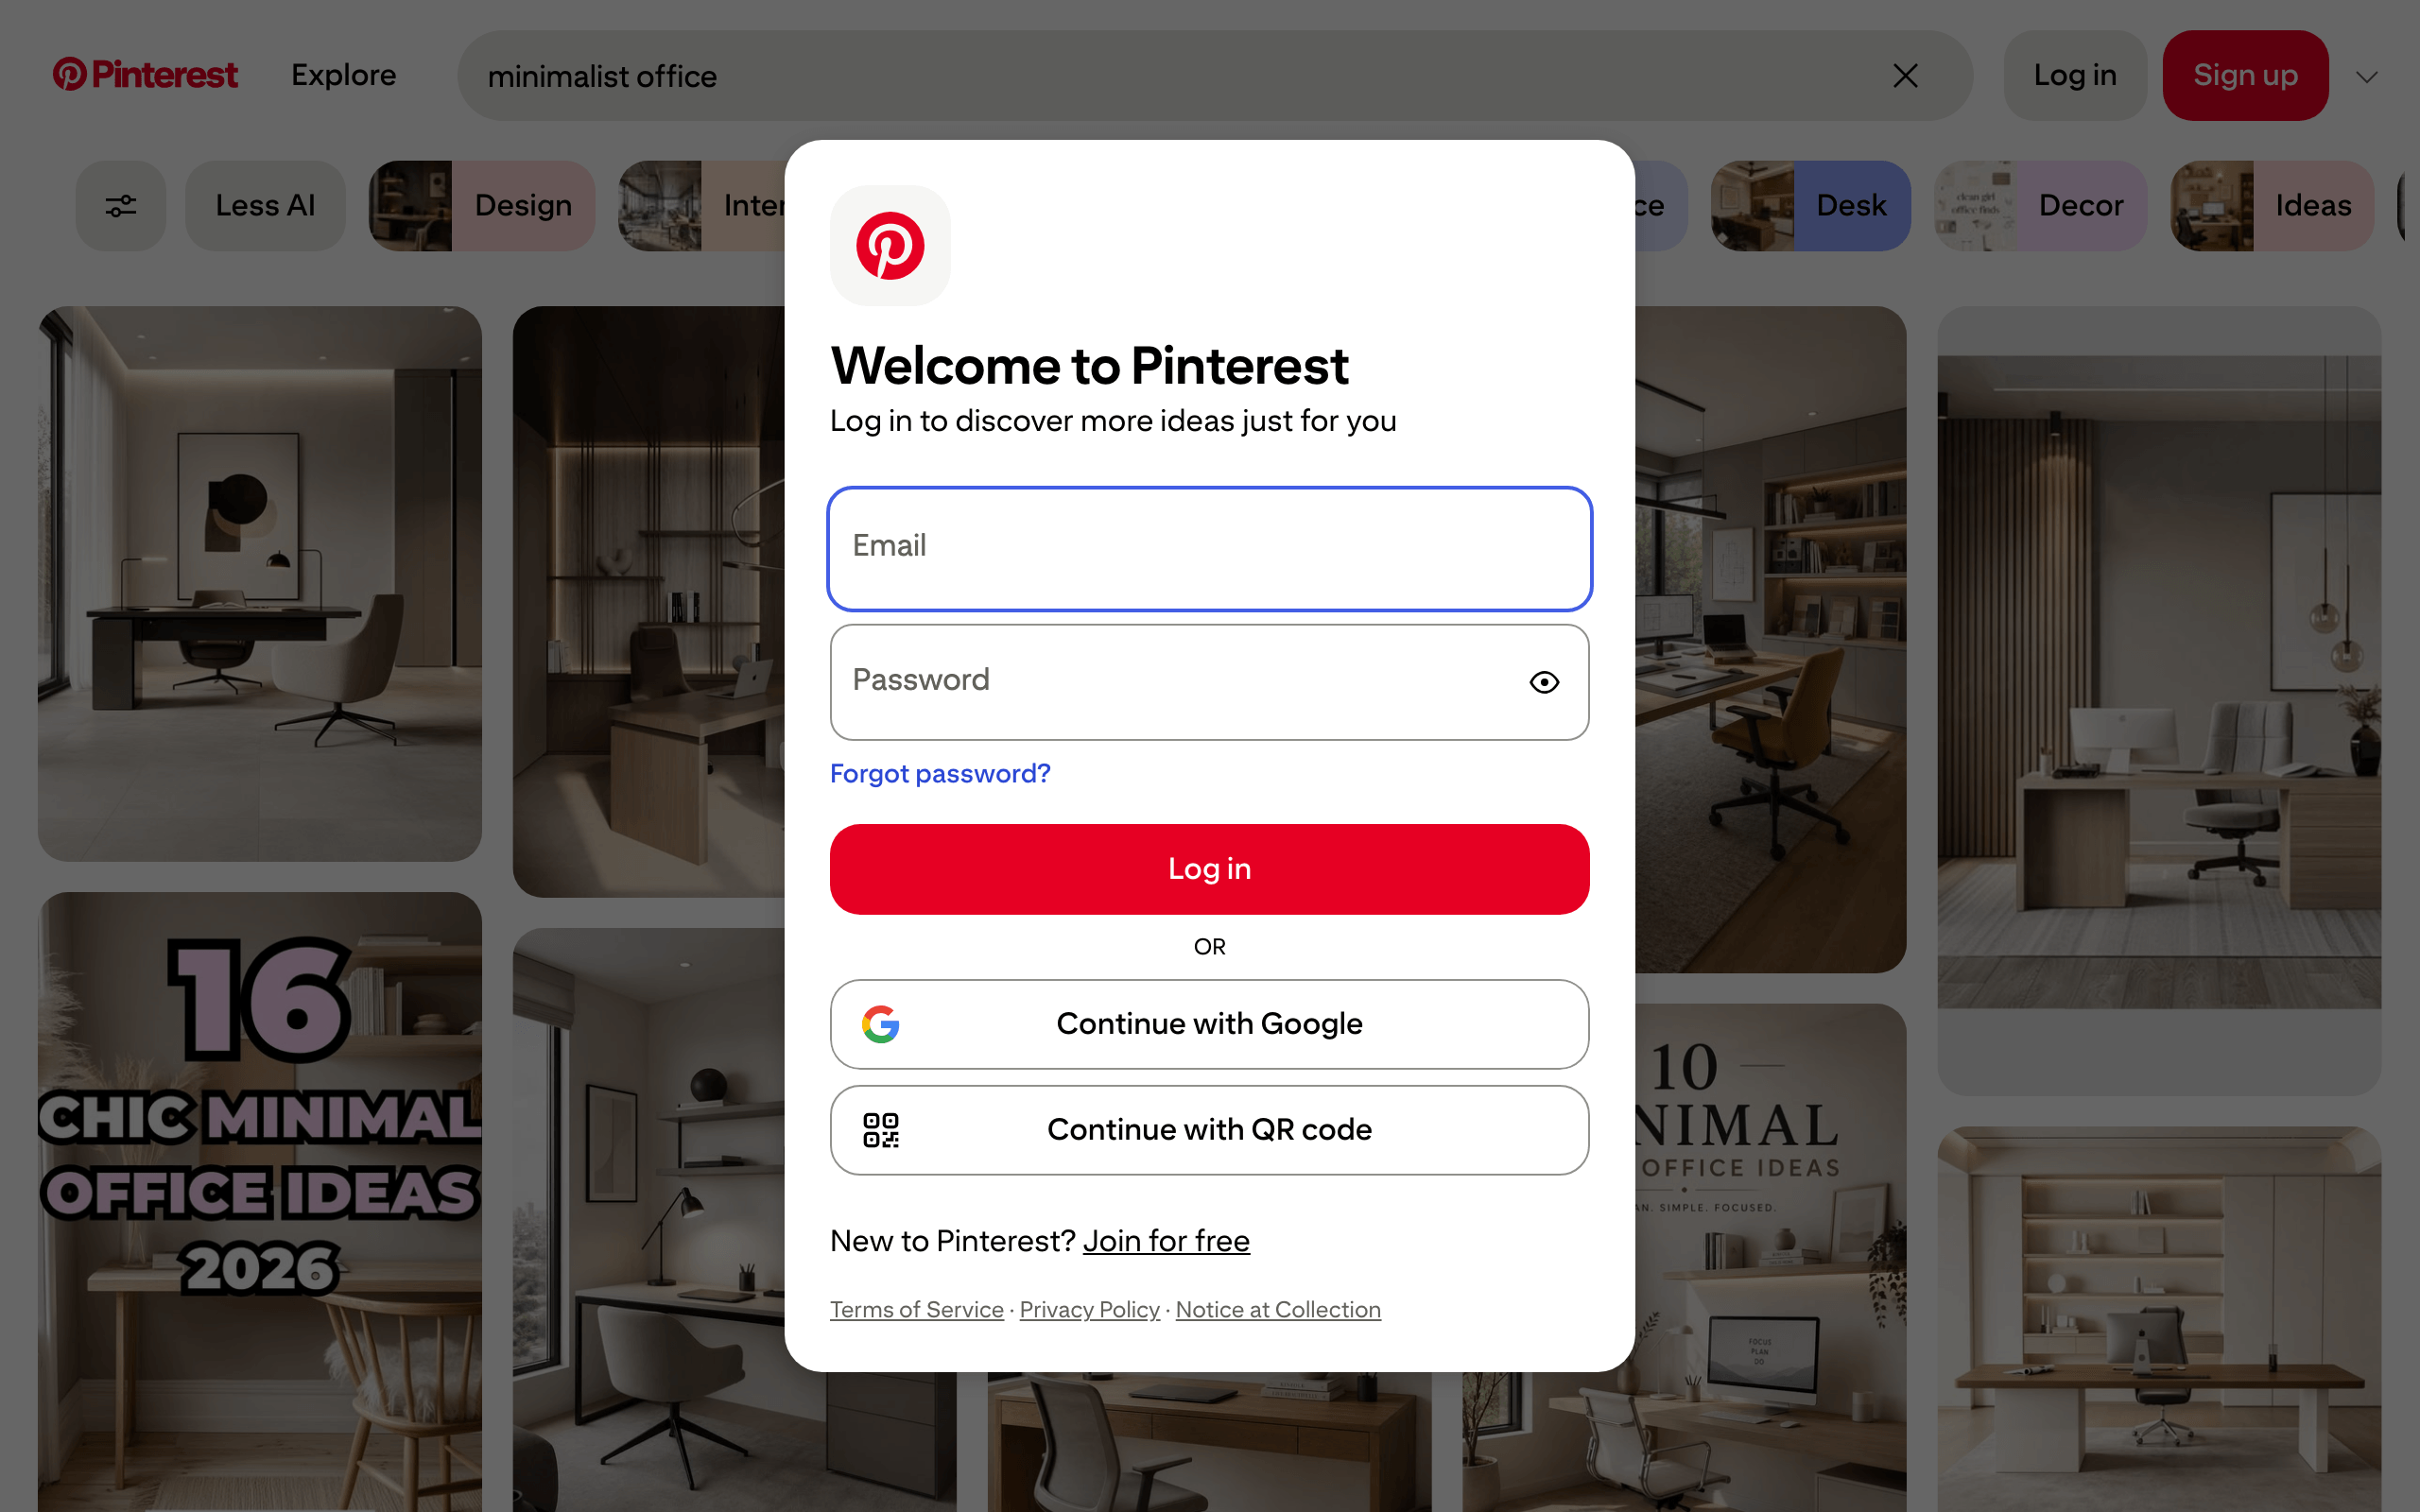
Les tuiles autour de la fenêtre modale sont les mêmes éléments gated-pin-rep que le script lit. Chacune contient une image et rien d’autre, c’est pourquoi l’exécution retourne des URLs et aucun titre.
Défiler davantage ne change rien. La grille maintient le même nombre après 3 défilements qu’après 25, et l’ensemble des URLs de miniatures ne dépasse jamais cette limite.
Ce nombre est stable à l’intérieur d’une session et varie entre elles. Des exécutions répétées dans une session ont retourné 17 à chaque fois pour minimalist office et 15 à chaque fois pour fall fashion. Des sessions séparées sur ces deux mêmes requêtes ont retourné 16, 17 et 18.
Attendez-vous à un nombre fixe quelque part dans la fourchette moyenne à haute des dizaines. Traitez le nombre exact comme spécifique à la session plutôt qu’un nombre sur lequel compter. Une fenêtre modale de connexion couvre le flux et bloque le défilement infini qu’une session connectée obtient, avec un vrai champ de mot de passe juste là dans le DOM.
Pourquoi un navigateur furtif ne le résout pas
Le prochain mouvement naturel est un navigateur furtif, et c’est le mauvais diagnostic pour une grille barrée. Playwright non modifié montre bien des signaux d’automatisation au niveau du protocole, le plus visiblement l’appel Runtime.enable dans le Chrome DevTools Protocol, et les versions corrigées les masquent. Patchright est un remplacement direct du package Playwright, et il est construit pour masquer ces signaux sans toucher à votre script. Camoufox est une build Firefox séparée plutôt qu’un patch de Playwright.
Visé sur la même requête avec un navigateur de rendu et son propre pool de proxies, un déblocateur commercial a retourné la page déconnectée en entier. Cela signifiait les invites d’inscription, les boutons de catégorie, la barre de filtre, et pas un seul titre de pin ni lien /pin/.
Exécutez Patchright côte à côte avec Playwright non modifié sur les deux mêmes requêtes dans une session et rien ne bouge. Les deux ont retourné 16 tuiles pour minimalist office et 15 pour fall fashion. Les deux ont retourné zéro lien /pin/, Pin comme texte alt de chaque tuile, et le même champ de mot de passe dans le DOM.
Une barrière d’état de compte limite le flux déconnecté, pas un score de bot. Aucun cookie Bot Manager n’apparaît sur les pages de recherche ou de profil. Les dix expériences lop_unauth_lockdown sont actives dans __PWS_DATA__ en septembre 2026, et le nombre de tuiles est inchangé sur quatre User-Agents.
Ce qu’il faut pour aller plus loin
Pour atteindre les descriptions, liens, et engagement à travers une recherche avec votre propre navigateur, vous avez besoin d’une session que Pinterest traite comme un vrai utilisateur connecté. Cela signifie se connecter et conserver des cookies. Automatiser une connexion personnelle enfreint les conditions de la plateforme, qui interdisent d’accéder aux données Pinterest “en utilisant des moyens automatisés (sans notre autorisation préalable expresse)”.
Le volume est l’autre contrainte, et sur cette cible c’est la réputation IP plutôt que l’empreinte digitale. Environ 250 requêtes depuis une adresse n’ont produit aucune limitation de débit et aucun défi, donc la limite est plus haute que ne le suggère une première tentative. Fonctionner en continu depuis une seule adresse change cela, et c’est le premier de trois problèmes qu’un scraper durable doit gérer.
Ce dont un scraper durable a besoin
Obtenir un écran de miniatures est une démo. Collecter des milliers d’enregistrements de pins complets selon un calendrier est un problème d’infrastructure.
- Diversité IP. Les proxys résidentiels répartissent le même travail sur de nombreuses IP de consommateurs au lieu d’une seule adresse de centre de données. Des trois, les preuves ici font de celui-ci celui qui vaut la peine d’être payé, et pas seulement à grande échelle. Une adresse classée comme hébergement obtient des pages de pins avec le bloc JSON-LD absent, donc l’analyse fonctionne uniquement depuis des IP de consommateurs. La rotation compte au-delà de cela, une fois qu’une seule adresse fonctionne en continu.
- Gestion d’empreinte digitale et de défis. Un navigateur géré tel que le Browser API est construit pour présenter une empreinte digitale réelle cohérente. Il répond aussi aux défis que Chromium headless simple laisse sans réponse, dont un pipeline a besoin dès l’instant où il vise un site qui en applique un. Les pages publiques Pinterest sont le cas facile : aucun cookie Bot Manager, aucune charge utile de capteur, et aucun défi sur six identités clients.
- Maintenance. Les sélecteurs et les barrières changent sans préavis, comme le montrent à la fois le passage de
pinWrapperàgated-pin-repet l’expérience de barrage. Scrapling est construit pour retrouver des éléments par similarité lorsque les noms de classe changent souvent, ce qui aide pour la moitié analyseur du problème.
Vous pouvez construire tout cela, et les modèles généraux pour empêcher un scraper d’être bloqué s’appliquent ici comme partout ailleurs.
Le compromis est que cela devient un travail d’ingénierie continu, pas un script que vous écrivez une fois. Quand la maintenance coûte plus cher que ne vaut la possession du pipeline, vous pouvez la déplacer vers un scraper API géré.
Scraper Pinterest avec le Scraper API de Bright Data
Le Pinterest Scraper API de Bright Data déplace la couche navigateur, proxy, et déblocage vers un service géré. Vous envoyez une URL de pin, un mot-clé, ou une URL de profil, et il retourne un enregistrement structuré. Il fait partie du Web Scraper API, avec une allocation mensuelle gratuite puis paiement à l’utilisation par enregistrement livré. Chaque exemple de Scraper API dans ce guide s’est exécuté dans cette allocation.
Utilisez le scraper Pinterest ici plutôt qu’un déblocateur généraliste : il retourne des enregistrements analysés plutôt que du HTML brut. Les modes d’accès généralistes sont une route séparée pour toute URL à travers les sites. Lesquels sont disponibles varie selon le compte. Cela varie aussi selon la zone, la configuration nommée que vous créez pour chaque produit.
Bright Data applique la liste d’autorisation robots décrite plus tôt dans ce guide à cette couche. Un de ces modes a décliné une requête Pinterest d’emblée exactement pour cette raison.
La configuration se fait en deux étapes. Le compte Bright Data s’ouvre sans carte, et vous créez la clé API vous-même dans vos paramètres de compte. Un nouveau compte n’a aucune clé encore, donc le tableau des clés API commence vide :
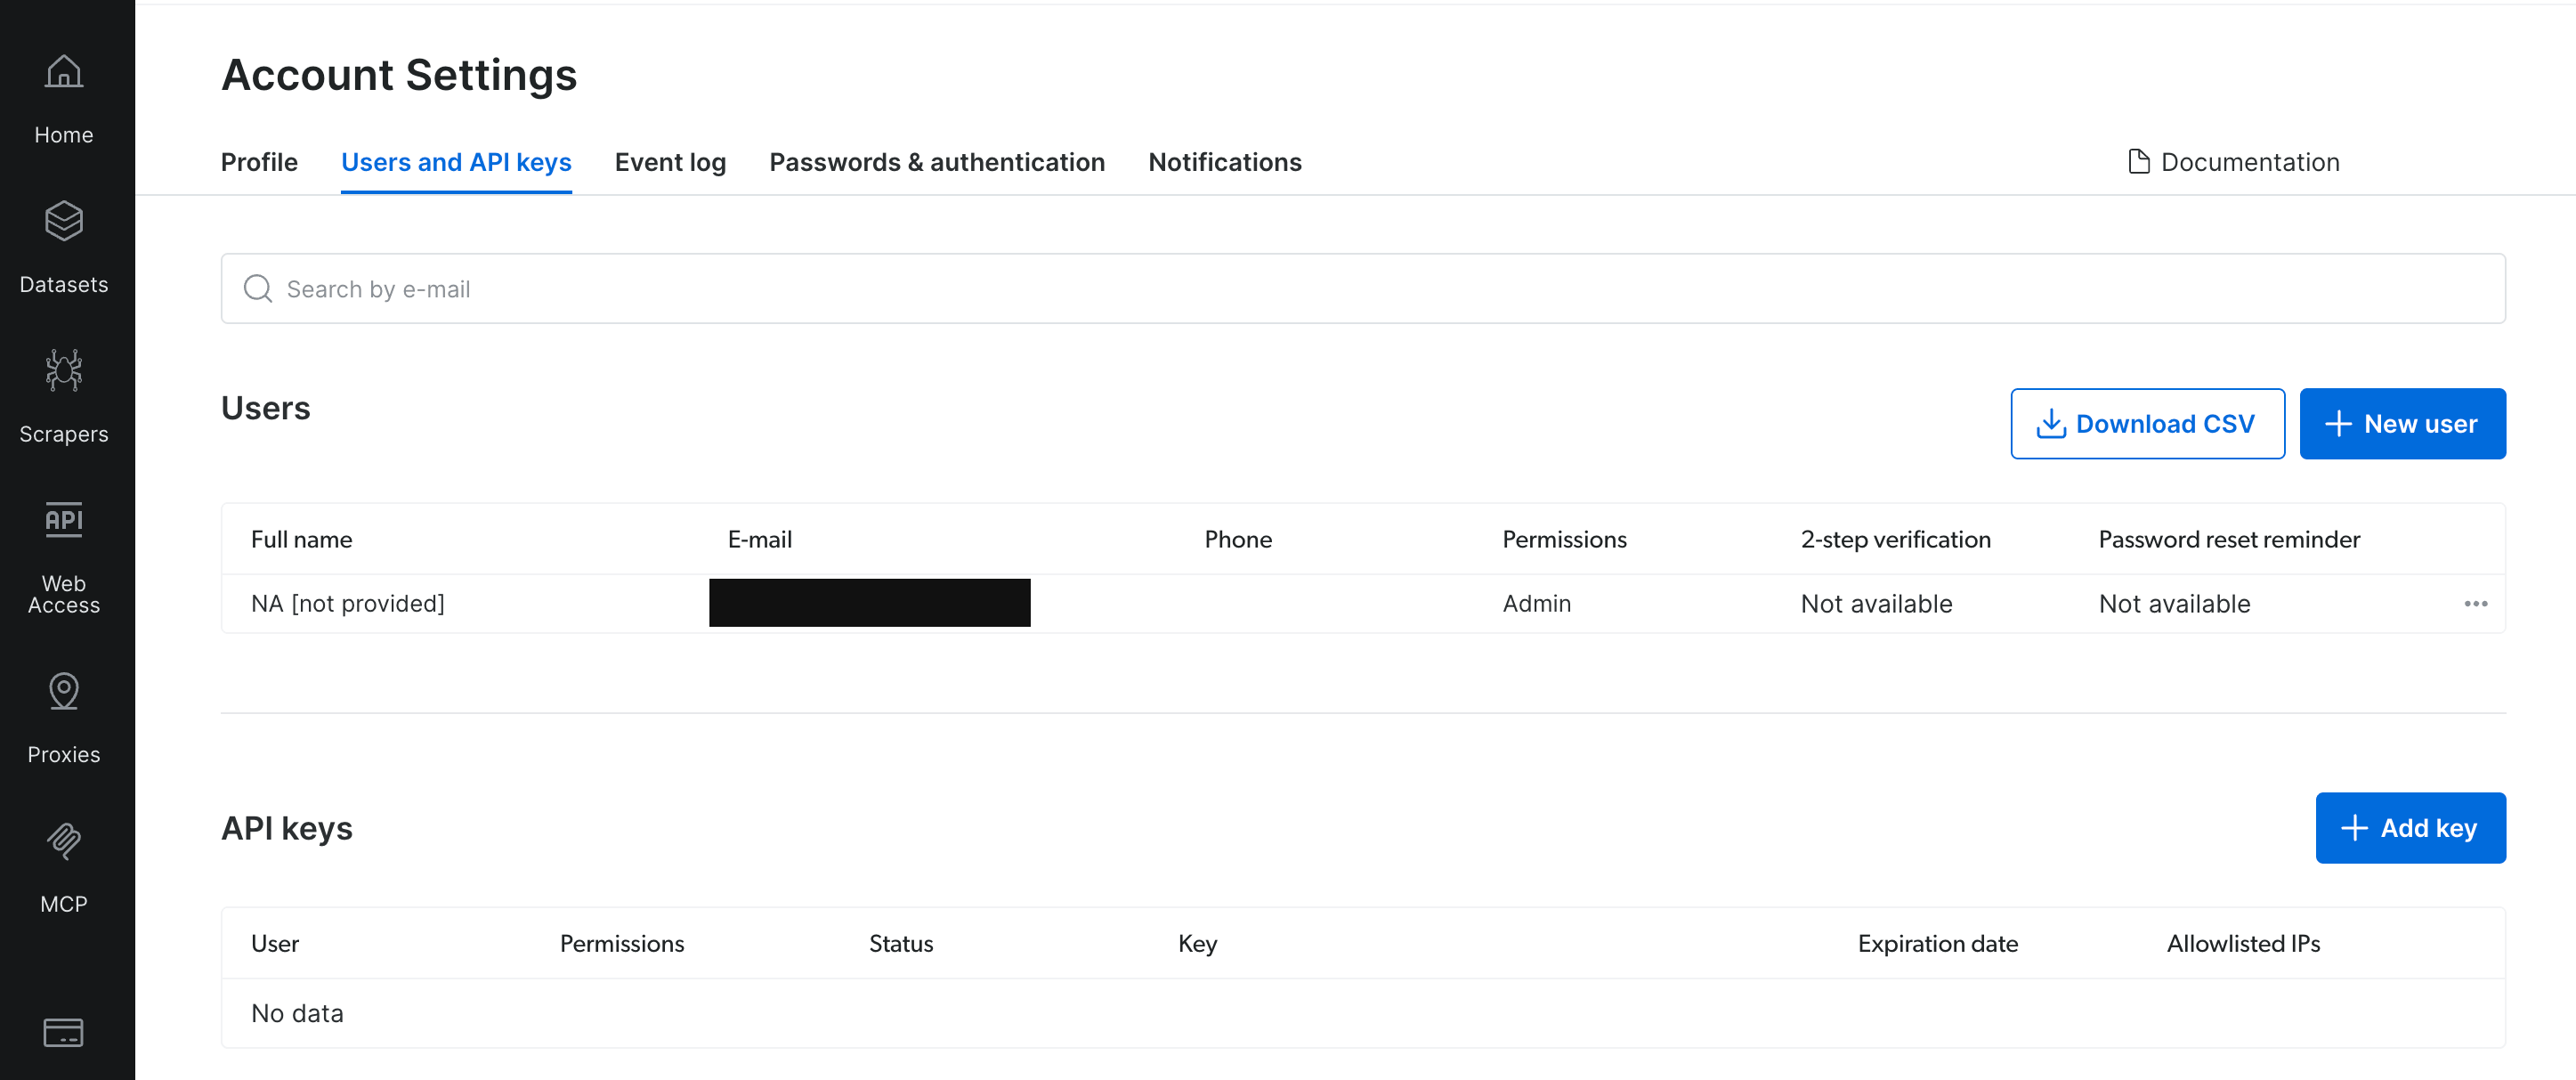
Ajoutez une clé et la fenêtre de dialogue demande un utilisateur, un niveau de permission, et une expiration.
Choisissez le niveau de permission destiné à l’accès API plutôt qu’à la facturation ou l’administration. La documentation d’authentification de Bright Data le décrit comme celui qui “permet l’utilisation de l’API au niveau proxy/API”. Pour l’expiration, choisissez une date postérieure à la fin de votre projet pour que la clé n’expire pas en cours d’exécution.
Les exemples utilisent le package requests, le même utilisé précédemment pour les flux de tableaux :
pip install requestsCe seul package est toute la liste de dépendances. Chaque mode de collecte partage cette configuration, et la console les liste ensemble afin que vous puissiez voir ce que chacun fait avant d’écrire quoi que ce soit :
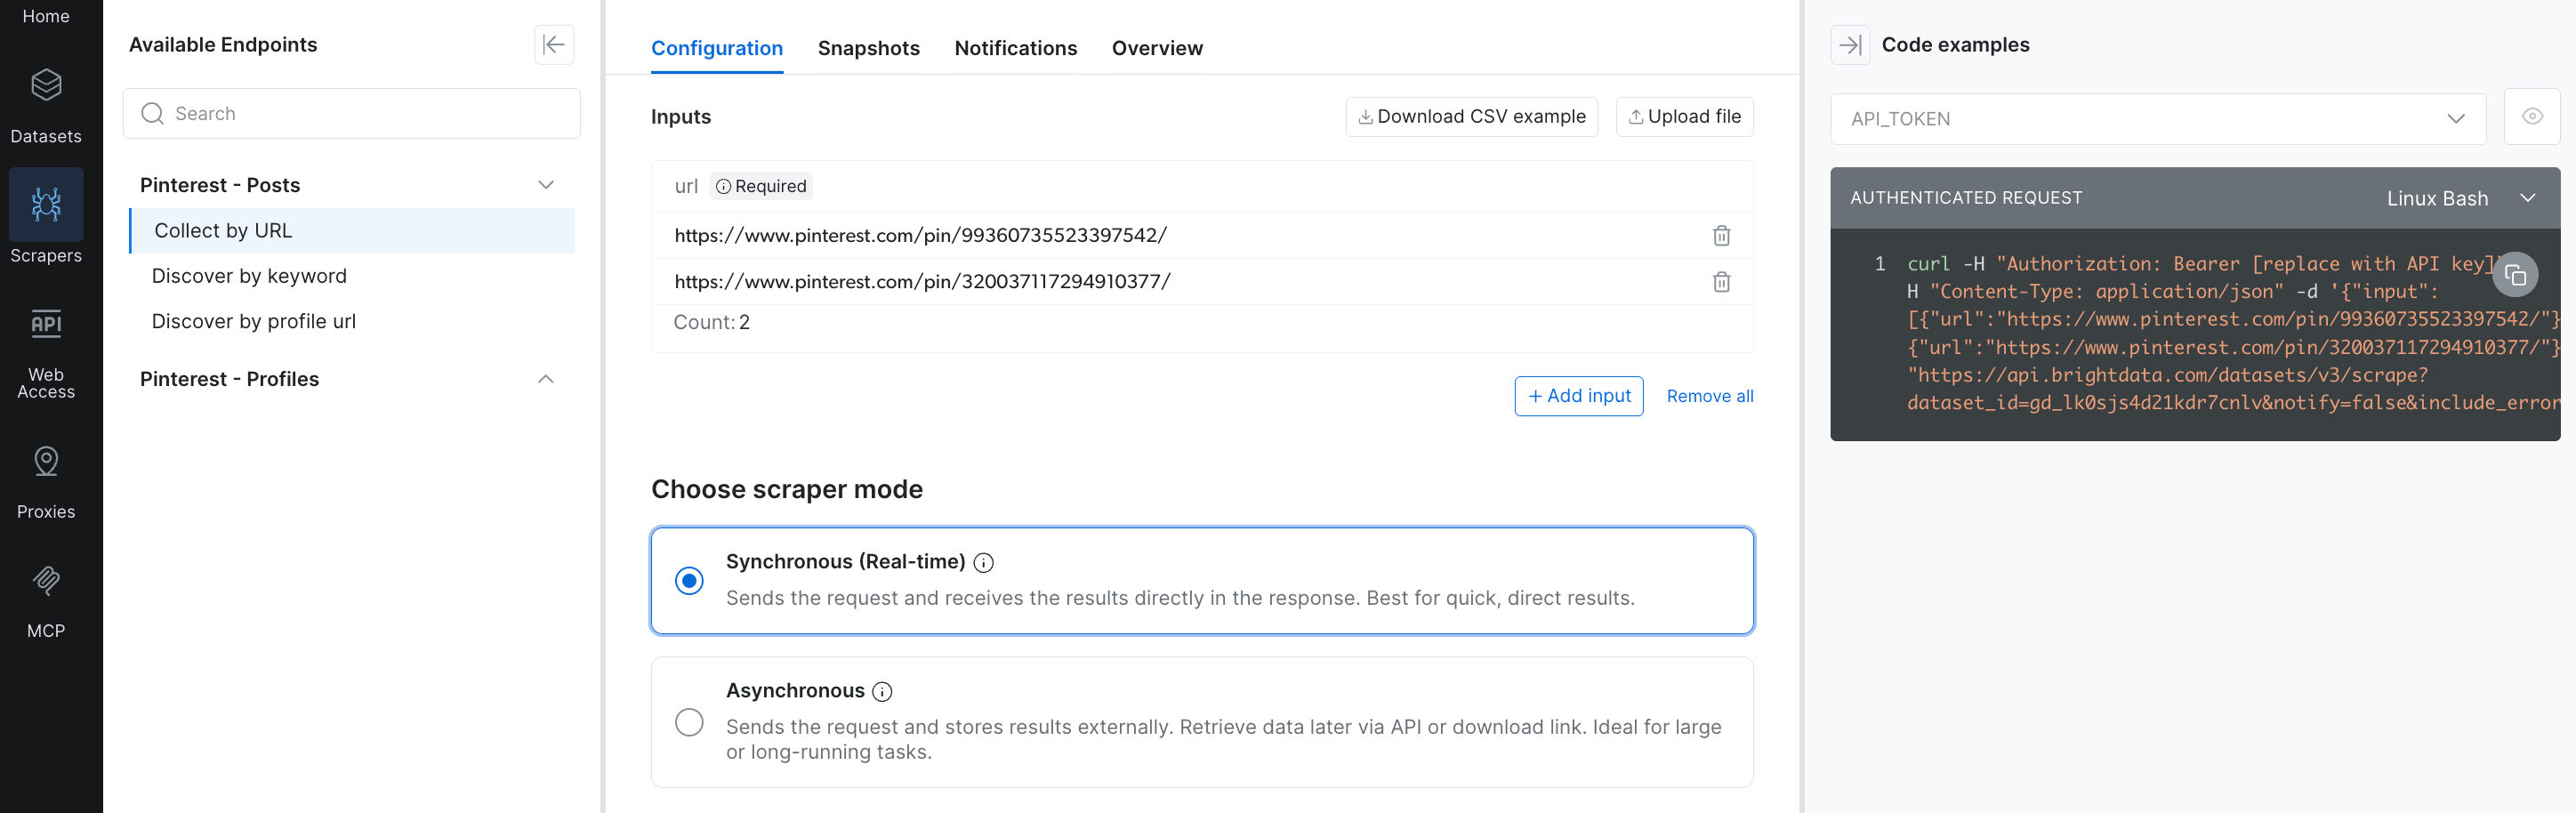
Le panneau liste les points de terminaison de ce scraper. Les trois utilisés ici sont collecter par URL, découvrir par mot-clé, et découvrir par profil.
Collecter des pins par URL
Envoyez une ou plusieurs URLs de pins et lisez les enregistrements depuis la réponse. Le drapeau include_errors=true fait que l’API rapporte les entrées échouées au lieu de les supprimer. Vous filtrez vous-même les erreurs, et en échange vous voyez le résultat de chaque entrée :
import requests

API_KEY = "YOUR_API_KEY"  # créez ceci dans vos paramètres de compte Bright Data
# copiez l'ID de dataset actuel depuis la page du scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true"},
    json={"input": [
        {"url": "https://www.pinterest.com/pin/99360735523397542/"},
        {"url": "https://www.pinterest.com/pin/3166662230556591/"},
    ]},
    timeout=60,
)

# une erreur HTTP lève ici, donc resp contient des enregistrements
resp.raise_for_status()
for line in resp.text.strip().splitlines():
    print(line)
La réponse est du JSON délimité par des sauts de ligne, un objet par entrée. L’URL active a retourné un enregistrement d’environ vingt champs, raccourci ici aux pertinents. Le pin supprimé a retourné une erreur :
{"url": "https://www.pinterest.com/pin/99360735523397542/", "post_id":
"99360735523397542", "title": "12 Bombshell Hair Color Ideas To Try This
Summer | Ecemella", "content": "Copper Red",
"date_posted": "2023-05-24T22:32:51.000Z", "user_name": "ecemella",
"user_url": "https://www.pinterest.com/ecemella", "likes": 2,
"categories": ["Beauty", "Hair"], "hashtags": ["Casual Fall Outfit
Inspiration", "Fall Fashion Outfit Ideas"], "image_video_url":
"https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
"video_length": 0, "post_type": "image", "comments_num": 0}
{"input": {"url": "https://www.pinterest.com/pin/3166662230556591/"},
"error": "Bad input. Page does not exist.", "error_code": "dead_page"}
L’enregistrement correspond à l’analyse JSON-LD sur le titre, la date, et l’image, et ajoute le handle du pinner, les catégories, et les hashtags en un seul appel. Le nombre de sauvegardes et le lien source sortant viennent plutôt du JSON-LD de la page du pin.
L’URL en échec est un véritable ID de pin que Pinterest a depuis supprimé. L’API retourne une erreur dead_page pour celui-ci plutôt qu’un crash, donc vous pouvez le journaliser et continuer. Bright Data tarife le Scraper API par enregistrement livré avec succès, donc sur cette base un pin mort ne devrait pas s’ajouter à la facture.
Les pins sont souvent supprimés, donc prévoyez cette erreur dans tout lot. Associez les réponses aux entrées par le propre champ url ou input de chaque objet plutôt que par position. Sur trois exécutions identiques, la ligne d’erreur est arrivée en premier deux fois et en deuxième une fois.
Le point de terminaison scrape répond habituellement en ligne. Quand une tâche a besoin de plus de temps, il retourne un snapshot_id et un message encore-en-cours, avec les enregistrements attendant sous cet ID. Vérifiez un snapshot_id avant d’analyser la réponse comme des enregistrements, quel que soit le mode que vous avez demandé.
Découvrir des pins par mot-clé
Le mode découverte est la route vers la recherche par mot-clé, le seul domaine que la barrière de connexion ferme au HTTP simple. C’est le mode à utiliser quand vous avez un sujet plutôt qu’une liste d’URLs. Ajoutez type=discover_new et discover_by=keyword, et limitez le volume par mot-clé avec limit_per_input :
import requests

API_KEY = "YOUR_API_KEY"
# copiez l'ID de dataset actuel depuis la page du scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "keyword"},
    json={"input": [{"keyword": "minimalist office"},
                    {"keyword": "fall fashion"}],
          "limit_per_input": 4},
    timeout=180,
)
# une erreur HTTP lève ici, donc resp contient des enregistrements
resp.raise_for_status()
print(resp.text)
Chaque mot-clé retourne jusqu’à la limite que vous définissez. Chaque enregistrement ajoute un champ discovery_input nommant le mot-clé qui l’a trouvé. Là où le pin a une description, un champ content contient le texte complet. Un enregistrement de l’exécution minimalist office, avec la description tronquée :
{"url": "https://www.pinterest.com/pin/320037117294910377", "title":
"Minimal Cream Office With Ultrawide Monitor, Wood Desk and Natural Window
Light", "content": "A pale wood desk sits beside a bright window with an
ultrawide monitor... #MinimalCreamOffice #PaleWoodWorkspace",
"user_name": "theSetupDistrict", "categories": ["Home Decor"],
"date_posted": "2026-08-25T15:59:51.000Z",
"discovery_input": {"keyword": "minimalist office"}}
Donc un mot-clé seul suffit à obtenir des enregistrements de pins structurés. La plupart incluent une description et des catégories, dont ni l’une ni l’autre n’apparaît dans la grille de recherche déconnectée.
Crawler un profil entier avec l’API asynchrone
Crawler chaque pin d’un profil est plus qu’une seule réponse ne peut contenir, donc l’API l’exécute comme une tâche en arrière-plan. Vous démarrez la tâche, recevez un ID, et collectez les enregistrements quand elle se termine. Changer de mode dans la console montre la différence dans la requête elle-même :
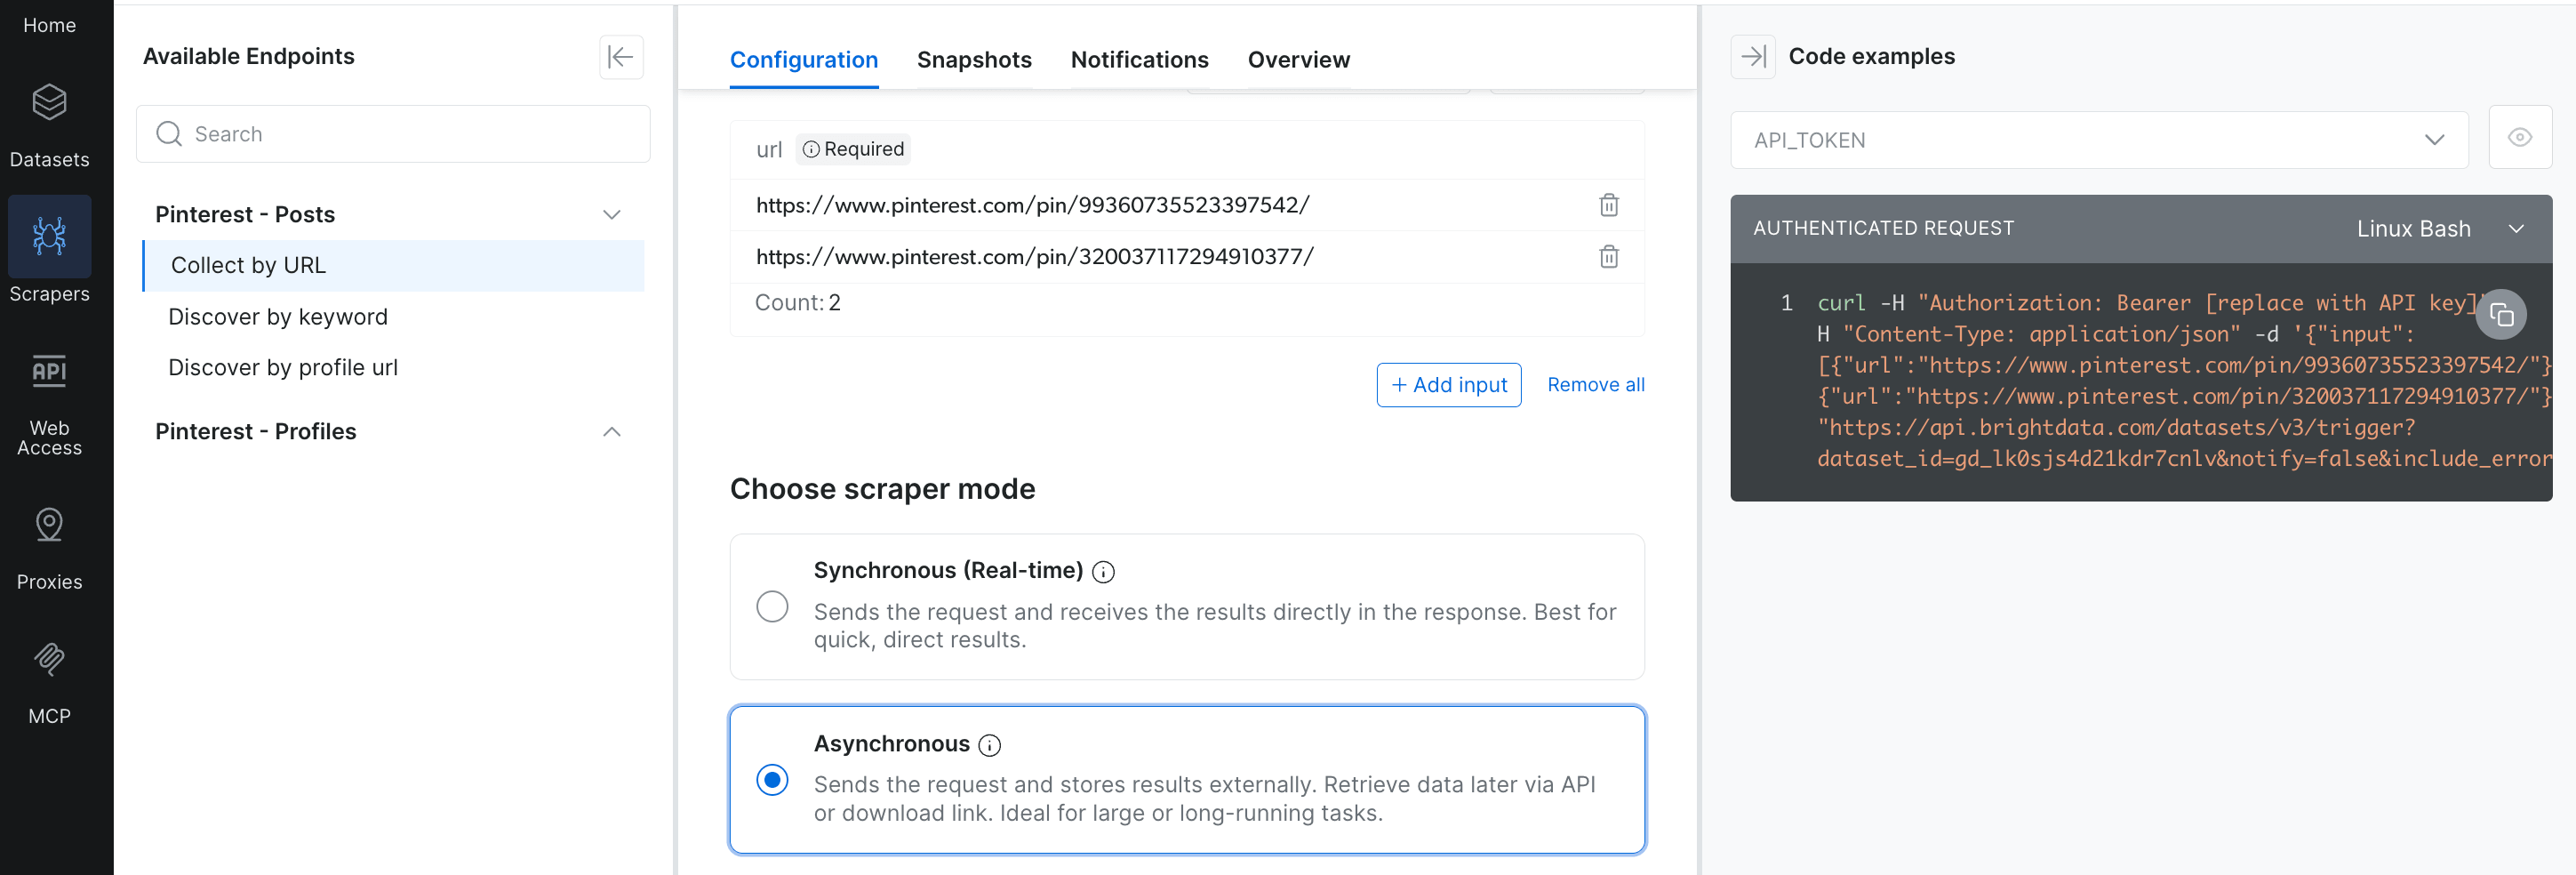
Sélectionner le mode asynchrone réécrit le chemin pour vous : le point de terminaison scrape devient trigger. L’exécution retourne alors un snapshot_id à interroger, au lieu de maintenir une connexion ouverte.
Utilisez le point de terminaison trigger, qui retourne immédiatement un snapshot_id :
import requests

API_KEY = "YOUR_API_KEY"
# copiez l'ID de dataset actuel depuis la page du scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}

start = requests.post(
    "https://api.brightdata.com/datasets/v3/trigger",
    headers=HEADERS,
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "profile_url"},
    json={"input": [{"url": "https://www.pinterest.com/boredpanda/",
                     "start_date": "", "end_date": ""}],
          "limit_per_input": 4},
    timeout=60,
)
# une erreur HTTP lève ici, donc start.json() contient un vrai snapshot_id
start.raise_for_status()
snapshot_id = start.json()["snapshot_id"]
print("snapshot:", snapshot_id)
Les start_date et end_date vides sont optionnels, et les laisser vides collecte sans filtre de date. Ensuite, interrogez le point de terminaison de progression jusqu’à ce que la tâche soit prête et téléchargez le snapshot. La réponse de progression rapporte les comptes et tout code d’erreur, donc vous savez ce que vous obtenez avant de le récupérer :
import requests, time

API_KEY = "YOUR_API_KEY"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}
# imprimé par le bloc trigger ; gardez-le pour retélécharger une exécution plantée
snapshot_id = "sd_..."

progress_url = f"https://api.brightdata.com/datasets/v3/progress/{snapshot_id}"
while True:
    poll = requests.get(progress_url, headers=HEADERS, timeout=30)
    # une erreur HTTP lève ici, donc poll.json() est un vrai objet de progression
    poll.raise_for_status()
    progress = poll.json()
    if progress["status"] in ("ready", "failed"):
        break
    time.sleep(10)

# records et error_codes disent ce que l'exécution a produit ; status dit seulement qu'elle s'est arrêtée
codes = progress.get("error_codes") or {}
if progress["status"] == "failed" or not progress.get("records"):
    raise RuntimeError(
        f"{snapshot_id} finished with no records to download: "
        f"{progress['status']}, {codes}")

data = requests.get(
    f"https://api.brightdata.com/datasets/v3/snapshot/{snapshot_id}",
    headers=HEADERS, params={"format": "json"}, timeout=120,
).json()

# include_errors=true rapporte les entrées échouées comme des lignes, donc filtrez avant de compter
records = [row for row in data if not row.get("error_code")]
if codes:
    print(f"skipped {sum(codes.values())} failed inputs: {codes}")
print(f"downloaded {len(records)} records")
Cette boucle gère la mécanique. Ce que la réponse dit sur l’exécution demande plus d’attention.
Lire la réponse de progression avant de télécharger
La réponse de progression inclut errors et error_codes aux côtés de status, et les trois comptent. ready seul signifie que la tâche s’est arrêtée, pas que chaque entrée a réussi. Une exécution peut se terminer ready avec records: 0 et un nombre errors non nul.
Une boucle qui teste seulement status imprimera downloaded 0 records et continuera comme si elle avait réussi. Lever une exception sur une exécution à zéro enregistrement est le bon défaut. Lever une exception sur les erreurs seules ne l’est pas : un crawl qui ignore quelques pins supprimés et retourne quand même des enregistrements fonctionne exactement comme prévu.
Le téléchargement demande la même attention, car include_errors=true place les entrées échouées dans le snapshot sous forme de lignes à côté des vrais enregistrements. Le nombre brut de lignes peut donc être plus élevé que les enregistrements que vous conservez. Une exécution rapportant un enregistrement peut retourner trois lignes : deux entrées dead_page sans url, et un pin complet. Filtrez sur error_code avant de compter ou stocker quoi que ce soit.
Une exécution de profil sur boredpanda revient en environ 21 secondes avec les 4 enregistrements que la limite autorisait, chacun étiqueté avec son discovery_input. Les crawls de profil s’exécutent de manière asynchrone par conception, même quand vous appelez le point de terminaison synchrone scrape.
Un crawl par mot-clé ou profil rapporte aussi les pins morts comme des entrées dead_page dans les error_codes de progression. Une exécution qui retourne moins d’enregistrements valides que votre limite a généralement trouvé des pins supprimés, pas un bug dans votre code.
Vérifier une exécution et collecter l’enregistrement de profil
Chaque exécution est journalisée dans la console, donc vous obtenez un historique d’exécution sans en construire un :
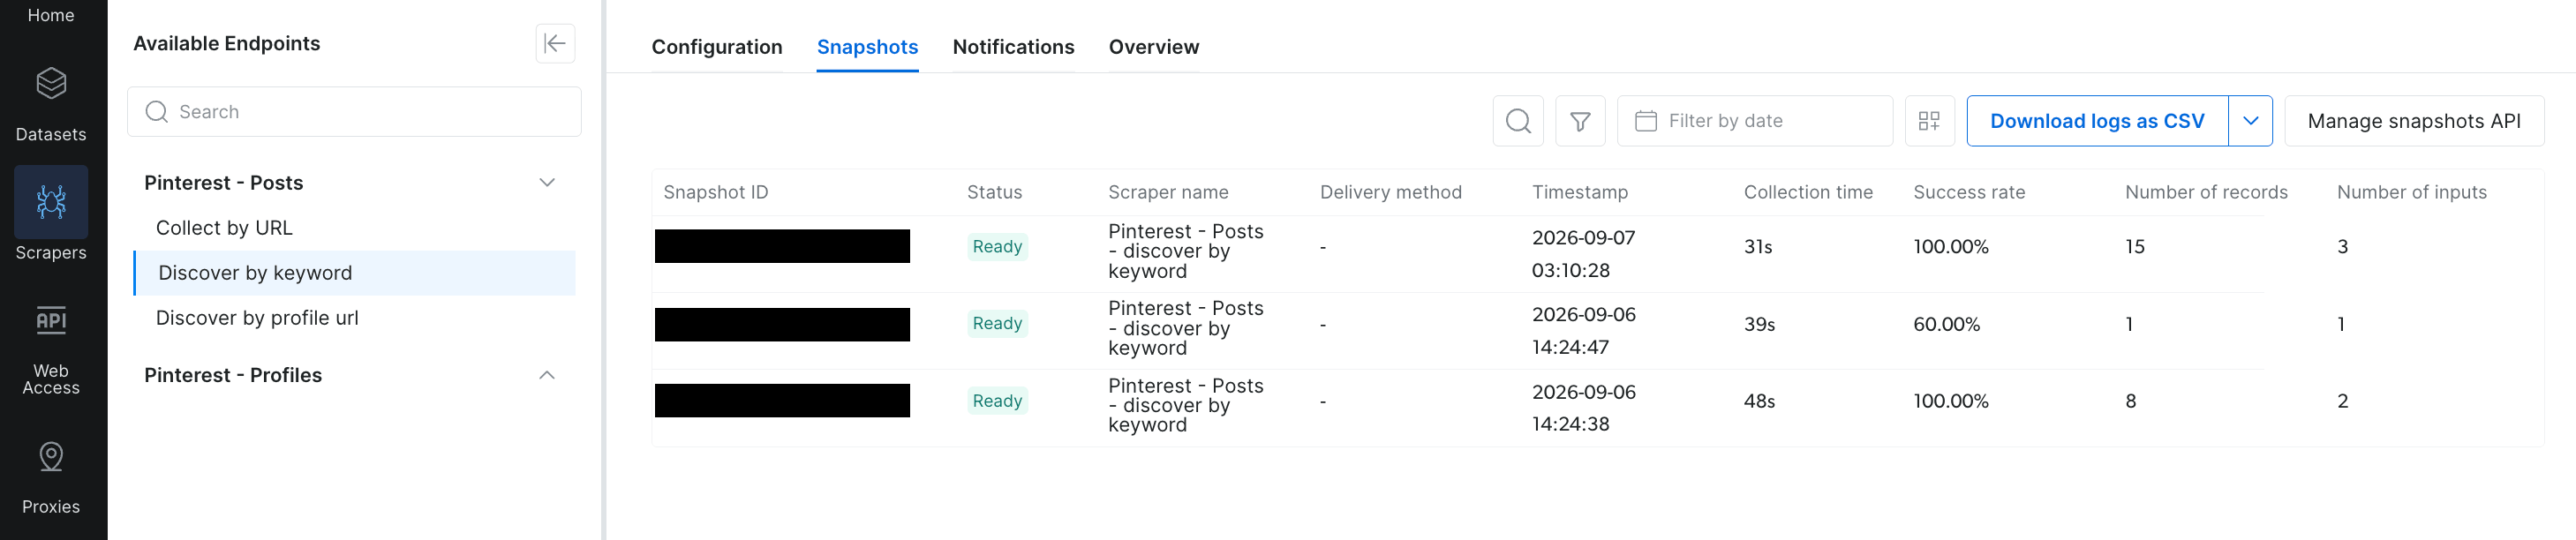
Une exécution dont vous n’avez jamais journalisé l’ID est toujours là pour être retéléchargée. Deux de ces exécutions se sont déroulées sans erreurs à 100% ; la troisième affiche 60%, avec deux pins supprimés journalisés dans sa colonne d’erreur.
Cette exécution du milieu a retourné un seul enregistrement parce que deux des pins qu’elle a trouvés avaient été supprimés. La console journalise cela comme dead_page: 2 sous une colonne d’erreur que ce recadrage n’atteint pas. Vérifiez cette colonne sur vos propres exécutions avant de traiter quelques enregistrements comme une requête cassée. Le taux de réussite est le propre chiffre de la console pour les pages qu’un crawl a visitées, donc lisez-le aux côtés des comptes d’enregistrements et d’erreurs.
Un second scraper retourne l’enregistrement de profil lui-même, aux côtés des pins que le crawl de profil collecte. Changez l’ID de dataset pour celui sur la page du scraper de profils Pinterest, et postez l’URL de profil sans discover_by. Pour le même compte, il a retourné un follower_count d’environ 3 millions et un boards_num de 51 au moment du test. Il a aussi retourné un tableau saved de tableaux avec leurs nombres de pins, 10 des 51.
Ce scraper retourne un snapshot_id plutôt que des enregistrements en ligne, donc interrogez-le de la même manière. Cela a pris un peu moins de quatre minutes lors des tests, comparé aux environ vingt secondes du crawl de pins, donc définissez l’intervalle d’interrogation en minutes.
Ce que contiennent les enregistrements
Dix champs sont apparus sur les 30 enregistrements testés : url, post_id, date_posted, user_name, user_url, post_type, image_video_url, video_length, likes, et comments_num. Ceux-ci étaient le noyau stable au moment du test. Quatre autres sont communs plutôt que garantis : title dans 27 des 30, categories dans 24, content dans 22, et hashtags dans 16. Lisez ce deuxième groupe avec .get() plutôt qu’une indexation directe.
Les nombres de sauvegardes sont le chiffre d’engagement que la plupart des analyses Pinterest veulent, et vous les obtenez via une jointure à deux sources sur post_id. L’API fournit la découverte et l’enregistrement structuré. Le JSON-LD de la page de pin fournit le nombre de sauvegardes, qu’il a retourné sur 5 des 6 pins vérifiés.
Vérifiez les chiffres réels avant de construire une métrique dessus. Échantillonner huit pins récents de chacun de trois comptes a retourné des médianes de 1, 1 et 2, tandis que des pins individuels atteignaient les centaines. Donc le compteur est par pin plutôt que par image. likes a retourné 0 sur 5 de ces mêmes 6, ce qui correspond au fait que Pinterest a supprimé les likes comme métrique publique il y a des années.
Sur les mêmes 6 pins, les titres concordaient entre les deux sources à chaque fois, et les dates sur 3 des 6. Les noms de pinners concordent aussi généralement, mais c’est le champ auquel ne pas faire confiance. Le pin utilisé tout au long de ce guide est un cas où ils diffèrent : sa réponse oEmbed et son enregistrement API nomment des personnes différentes.
L’enregistrement API nomme le compte derrière le site vers lequel le pin pointe, tandis que le JSON-LD et oEmbed nomment l’individu qui l’a sauvegardé. Quand un pin est re-sauvegardé depuis un autre compte, les deux sources peuvent nommer des personnes différentes. Joignez les deux jeux de données sur l’URL du pin ou post_id, jamais sur le pinner.
Là où les dates différaient, le date_posted de l’API était à la date ou proche de la date où le pin est apparu dans le flux. Le datePublished JSON-LD était plus ancien, dans un cas de plusieurs années. Décidez quelle définition votre analyse nécessite avant de mélanger les deux.
Quelle méthode de scraping Pinterest devriez-vous utiliser ?
Le choix dépend de votre point de départ et de la quantité d’enregistrement dont vous avez besoin :
| Facteur | HTTP simple (JSON-LD, oEmbed, RSS) | Playwright (DIY) | Bright Data Scraper API |
|---|---|---|---|
| Configuration | requests et la bibliothèque standard |
Installer Playwright et un navigateur | Clé API plus requests |
| Données retournées | Enregistrement complet pour un pin connu, plus un enregistrement de profil structuré | URLs d’images uniquement depuis la recherche ou un profil | Titre, description, pinner, hashtags, catégories, média ; les sauvegardes viennent de la page du pin, jointes sur post_id |
| Découverte | Flux de tableaux et le backend de widget, pas de recherche | Tuiles barrées sur une recherche | Pins par URL, mot-clé, ou profil complet |
| Blocage | Vos propres IP, aucun défi TLS observé | Vous gérez les proxys et la maintenance | Couche de proxy et déblocage gérée |
| Maintenance | La vôtre quand un flux ou le bloc JSON-LD change | La vôtre quand Pinterest change le balisage ou le barrage | Celle du fournisseur, à travers les mêmes changements de balisage et de barrage |
| Coût | Gratuit depuis une IP, 1,24 Go pour 10 000 pages de pins et bien moins via oEmbed | Gratuit, plus 43,5 Go de trafic proxy pour 10 000 pins | Une allocation mensuelle gratuite, puis tarifé par enregistrement livré avec succès |
Le HTTP simple atteint plus que ne le suggèrent la plupart des guides. Il retourne tout pin actif que vous nommez, un enregistrement de profil structuré, et les pins récents de chaque tableau qu’un compte montre. Exécuter les deux méthodes gratuites sur tous les tableaux d’un compte a retourné 435 pins uniques.
La contrainte est la quantité que vous pouvez atteindre, et c’est plus étroit qu’il n’y paraît. Ces 435 sont sur plus de 9 000 pins détenus sur les neuf tableaux d’où ils venaient, moins de 5%. Aucune méthode gratuite n’atteint la recherche par mot-clé, et Playwright n’ajoute que des miniatures barrées. Le Scraper API est pour la découverte par mot-clé, les crawls de profil complet, et la collecte récurrente.
Ce que coûte chaque méthode pour 10 000 pins
La taille de la charge utile fixe la facture, mesurée par les octets réellement transférés. Le tableau suppose un client qui négocie la compression. Une page de pin mesurant environ 1,13 Mo décompressé transfère environ 124 Ko avec Brotli, ou 183 Ko avec l’en-tête gzip que requests envoie. Exécutez l’exemple stdlib à la place et chaque chiffre dans la ligne du HTML de page de pin se multiplie par environ 9.
Les octets sont mesurés ici ; les tarifs non. Deux tarifs fixent chaque dollar dans le tableau. Les deux sont des prix de liste Bright Data de septembre 2026, donc les lignes de bande passante et la ligne d’enregistrement utilisent une base commune :
- Bande passante résidentielle, 8$/Go. Le tarif de liste paiement à l’utilisation sur la page de tarification du réseau de proxys, qui baisse pour le plan d’engagement publié le plus large.
- Scraper API, 1,50$ pour 1 000 enregistrements livrés. Le tarif de liste paiement à l’utilisation sur la page de tarification du Web Scraper API, qui baisse avec le volume sur les plans publiés supérieurs. La même page liste une allocation mensuelle gratuite ; le tableau utilise le prix de liste pour chaque enregistrement.
Les deux pages montrent aussi des promotions, et les deux changent sans que cet article ne change. Lisez les tarifs actuels sur ces deux pages avant d’estimer les coûts. Mettez ce qu’on vous cite dans la multiplication de la dernière colonne.
| Méthode | Mesuré sur | Octets transférés par pin | Volume pour 10 000 | Coût à ces tarifs |
|---|---|---|---|---|
| Flux RSS, par pin listé | bande passante | 147 o | 0,0015 Go | × 8$/Go = 0,01$ |
| JSON oEmbed | bande passante | 583 o | 0,006 Go | × 8$/Go = 0,05$ |
| HTML de page de pin | bande passante | 124 Ko | 1,24 Go | × 8$/Go = 9,92$ |
| Scraper API | enregistrements livrés | identique quelle que soit la taille de page | 10 000 enregistrements | × 1,50$/1k = 15,00$ |
| Page de pin via Playwright | bande passante | 4,35 Mo | 43,5 Go | × 8$/Go = 348,00$ |
Les lignes diffèrent dans ce que coûte un échec. Un pin supprimé répond toujours HTTP 200 avec une page complète, donc les lignes de bande passante paient pour ses octets. La ligne d’enregistrement est tarifée par enregistrement livré.
Ce que les chiffres en dollars ne montrent pas
Charger le même pin dans Chromium headless télécharge 4,35 Mo à travers environ 180 réponses. C’est environ 35 fois ce qu’une récupération simple déplace pour le même enregistrement.
Environ 3,1 Mo de cela est du JavaScript, ce qui explique pourquoi le moyen habituel d’économiser des octets aide à peine. Bloquer les images, polices, et feuilles de style le réduit à 3,8 Mo et pas plus bas, car la page a toujours besoin de ses scripts pour se rendre.
Le temps est l’autre coût. Une récupération de page de pin a pris une médiane de 0,8 à 1,0 seconde sur deux exécutions de 15 requêtes depuis une seule machine. Des exécutions complètes se terminent plus lentement que cette médiane ne le suggère.
Trois passages sur un flux de 25 pins avec un délai d’une demi-seconde se sont terminés à 21 à 33 pins par minute. En exécutant un à la fois, cela fait 5 à 8 heures pour 10 000 pins. Les exécuter en parallèle raccourcit cela et concentre votre taux de requêtes sur une adresse en même temps.
Ce que les chiffres de coût comparent réellement
oEmbed déplace 583 octets comparé aux 124 Ko de la page de pin. Récupérer une page entière pour lire un nom d’auteur est du gaspillage.
Une API gérée achète deux choses : la portée, et quelqu’un d’autre qui fait la maintenance. Elle atteint les types de pages au-delà du HTTP simple, recherche par mot-clé et crawls de profil complet. L’économie vient de cela, pas des octets transférés.
Sur la même base, la ligne page de pin et la ligne Scraper API sont proches, à environ 1,5x près. Les deux côtés ont des promotions qui les font baisser encore plus. Lequel est moins cher dépend de tarifs que ni cet article ni vous ne contrôlez.
La comparaison avec un navigateur headless n’est pas serrée. À chaque tarif publié sur cette même page de tarification de proxy, 43,5 Go de trafic coûtent un multiple de ce que font 10 000 enregistrements.
Les deux chiffres ne mesurent pas la même chose, donc lisez ce que chacun inclut. La ligne de trafic est la bande passante et rien d’autre. Elle exclut les minimums de plan de proxy et les heures passées à construire et maintenir le pipeline. Elle suppose aussi que vous détenez déjà 10 000 URLs de pins, ce qu’aucune méthode gratuite ne fournit à cette échelle.
Le chiffre d’enregistrement est plus large : il inclut la découverte qui a produit la liste d’URLs, et son tarif s’améliore avec le volume. Les minimums de plan s’appliquent des deux côtés, donc confirmez-les pour un grand travail de la même manière que vous vérifieriez un devis de proxy.
Prochaines étapes
Commencez avec l’outil le plus léger pour les données dont vous avez besoin. Si vous avez les URLs de pins, l’analyse JSON-LD retourne des enregistrements complets via HTTP simple, et oEmbed seul donne l’attribution. Si vous suivez un créateur ou un tableau, chaînez le flux RSS dans cette analyse et vous ne chargez jamais de navigateur.
La recherche par mot-clé et les crawls de profil complet sont les cas au-delà de ces routes. Le Pinterest Scraper API prend un mot-clé ou une URL de profil et retourne des enregistrements structurés, avec une allocation mensuelle gratuite pour tester.
Pour tout ce que vous prévoyez de continuer à exécuter, définissez trois défauts dès le départ :
- Gérez les pins supprimés à chaque lot. Cela signifie un
Nonede l’analyse JSON-LD, ou une entréedead_pagede l’API. - Gardez environ une demi-seconde entre les requêtes. Ce rythme a fait 21 à 33 pins par minute sur des exécutions complètes, et n’a produit aucune limitation de débit sur environ 250 requêtes.
- Journalisez le
snapshot_idpour les tâches asynchrones. Une exécution plantée peut alors être retéléchargée.
Pour aller au-delà d’une seule adresse, acheminez via des proxys résidentiels et conservez l’analyse que vous avez déjà. Si vous préférez acheter les données plutôt que de les collecter, le jeu de données Pinterest est déjà construit et prêt à télécharger
FAQ
Peut-on scraper Pinterest ?
Oui. Une URL de pin retourne généralement le titre, la description, le nombre de sauvegardes, le pinner et le lien sortant depuis un bloc JSON-LD via HTTP simple, sans navigateur nécessaire. Les flux RSS de profil et de tableau listent les URLs de pins récentes. La recherche par mot-clé est l’exception et nécessite une API de scraping.
Pinterest bloque-t-il les scrapers ?
Non, pas sur les pages de pins publics depuis une adresse résidentielle. Douze requêtes avec le User-Agent urllib par défaut ont toutes retourné HTTP 200, sans cookies Akamai Bot Manager. Une IP de centre de données est l’exception : la page retourne toujours 200, mais sans son bloc JSON-LD.
Pourquoi mon scraper Pinterest ne fonctionne-t-il pas ?
L’enregistrement est dans un bloc JSON-LD, pas dans le store Redux, donc initialReduxState.pins se lit vide. Sur les grilles de recherche, l’ancien sélecteur pinWrapper ne correspond à rien, car les tuiles déconnectées utilisent maintenant gated-pin-rep. Un pin supprimé répond toujours HTTP 200 sans aucun bloc JSON-LD du tout.
Pinterest a-t-il une API publique ?
Oui, mais elle est limitée à votre propre compte. L’API Pinterest v5 gère vos tableaux, pins, et publicités, pas les pins publics d’autres utilisateurs. L’accès d’essai a une limite de requêtes quotidienne. La seule recherche par mot-clé est une bêta non disponible pour toutes les applications, limitée aux 10 premiers résultats.
Pinterest a-t-il un flux RSS ?
Oui. Pinterest publie des flux non authentifiés à /<username>/feed.rss et /<username>/<board-slug>.rss. Sur 12 comptes, ils ont retourné 22 à 26 éléments récents, avec URLs de pins, horodatages, et miniatures mais presque aucun titre. Les flux listent uniquement les nouveaux pins, sans recherche par mot-clé et sans profondeur historique.
Comment télécharger des images Pinterest en taille réelle ?
Remplacez le segment de taille dans l’URL de miniature par originals, puis essayez .jpg, .png, .webp et .gif tour à tour. Garder le .jpg propre de la miniature a retourné 403 sur 35 des 40 pins, car Pinterest ré-encode. Prévoyez environ deux requêtes HEAD par image.
Comment scraper un tableau Pinterest ?
Retirez tout slash final de l’URL du tableau et ajoutez .rss. Un slash final retourne la page HTML au lieu du flux. Le flux s’arrête près de 25 éléments quelle que soit la taille du tableau. Le backend de widget à widgets.pinterest.com/v3/pidgets/ retourne jusqu’à 50, et au-delà vous crawlez le profil entier.