Yahoo Finance propose des cotations gratuites, un historique des prix, des états financiers et des estimations d’analystes, mais aucune API officielle. Ses pages de cotation contiennent ces données en JSON dans le HTML, donc un pipeline Python peut les lire sans navigateur.
Le code de nombreux anciens tutoriels échouait de 2 façons. Avec son User-Agent par défaut, la bibliothèque requests de Python recevait un 429 Too Many Requests dès sa première requête. Quand une requête réussissait, les anciens sélecteurs ne correspondaient à rien ou récupéraient le prix du S&P 500 au lieu de celui de l’action.
Ce guide vous montre comment scraper Yahoo Finance à partir de ce JSON, éviter le 429, et passer à un serveur.
En bref
- Le 429 de Yahoo sur la première requête dépend du client, pas du taux de requêtes. En imitant Chrome, curl_cffi a demandé 503 pages de cotation du S&P 500 sans 429.
- Une seule requête retourne l’historique complet des prix d’un ticker. Avec period1=0, l’onglet historique de MSFT a retourné chaque barre quotidienne depuis 1986.
- Validez chaque page, même si elle retourne 200. FB, l’ancien symbole de Meta, retournait un ETF ProShares, et le prix londonien de Vodafone était en pence.
- Passez à un serveur en remplaçant la fonction de récupération. Le Web Unlocker de Bright Data ajoute la rotation d’IP et des réessais automatiques. Ou le Yahoo Finance Scraper API de Bright Data retourne des enregistrements structurés.
Où Yahoo Finance conserve ses données
Les chiffres d’une page de cotation sont intégrés en JSON dans son HTML. Yahoo rend les pages côté serveur avec SvelteKit, un framework JavaScript, et appelle ses propres API JSON pendant le rendu. SvelteKit intègre chaque réponse dans le HTML, afin que le navigateur puisse la réutiliser sans la récupérer à nouveau. Chaque réponse est dans sa propre balise script, qui possède un attribut data-sveltekit-fetched et l’URL de l’API source dans data-url.
Une balise de l’onglet résumé de MSFT ressemble à ceci, avec son corps JSON raccourci :
<script type="application/json" data-sveltekit-fetched
data-url="https://query1.finance.yahoo.com/v1/finance/quoteType/MSFT?formatted=true&enablePrivateCompany=true&overnightPrice=true&lang=en-US&region=US"
data-hash="1ibomen" data-ttl="1800">
{"status":200,"statusText":"","headers":{"cache-control":"public, max-age=1800, stale-while-revalidate=1800"},"body":"{\"quoteType\":{\"result\":[{\"symbol\":\"MSFT\",\"quoteType\":\"EQUITY\",\"exchange\":\"NMS\",\"longName\":\"Microsoft Corporation\"}],\"error\":null}}"}
</script>Le champ body contient la réponse de l’API sous forme de chaîne JSON. Analyser une balise nécessite 2 appels json.loads(). Le premier appel analyse l’enveloppe, et le second analyse la chaîne body. Chaque onglet d’une page de cotation intègre un ensemble différent de réponses d’API :
| Onglet | Réponse API intégrée | Ce que vous pouvez y lire |
|---|---|---|
/quote/MSFT/ |
v10/finance/quoteSummary et v7/finance/spark |
Prix, capitalisation boursière, P/E, dividende, fourchette 52 semaines, objectifs de prix des analystes, jusqu’à 24 heures de clôtures sur 5 minutes |
/quote/MSFT/history/ |
v8/finance/chart |
Prix quotidiens, hebdomadaires ou mensuels, clôture ajustée, fractionnements, dividendes |
/quote/MSFT/financials/, balance-sheet/, cash-flow/ |
ws/fundamentals-timeseries |
Postes annuels et sur 12 mois glissants |
/quote/MSFT/analysis/ |
v10/finance/quoteSummary avec earningsTrend |
Estimations de BPA et de revenus, nombre d’analystes, surprises de résultats |
/quote/MSFT/key-statistics/ |
ws/fundamentals-timeseries |
Capitalisation boursière trimestrielle, valeur d’entreprise, ratios de valorisation |
/quote/MSFT/profile/ |
v10/finance/quoteSummary avec assetProfile |
Principaux dirigeants, nombre d’employés, secteur, dépôts SEC |
/quote/MSFT/holders/ |
v10/finance/quoteSummary avec modules de détention |
Détenteurs institutionnels, fonds et initiés |
/quote/MSFT/options/ |
v7/finance/options |
La chaîne d’options pour l’échéance la plus proche, plus la liste des dates d’échéance |
Les hôtes API de Yahoo, query1.finance.yahoo.com et query2.finance.yahoo.com, servent le même JSON, et la bibliothèque open-source yfinance les appelle directement. Sur ces hôtes, les points de terminaison quote, quoteSummary et options retournaient 401 quand une requête n’avait pas de crumb. Un crumb est un jeton que Yahoo émet avec chaque cookie de session et attend comme paramètre de requête crumb=.
L’ancien téléchargement CSV retournait 401 User is not logged in. Sur les deux hôtes API, robots.txt interdit chaque chemin (Disallow: /). Les réponses intégrées dans la page de cotation ne nécessitent ni cookie, ni crumb, ni accès à l’hôte API :
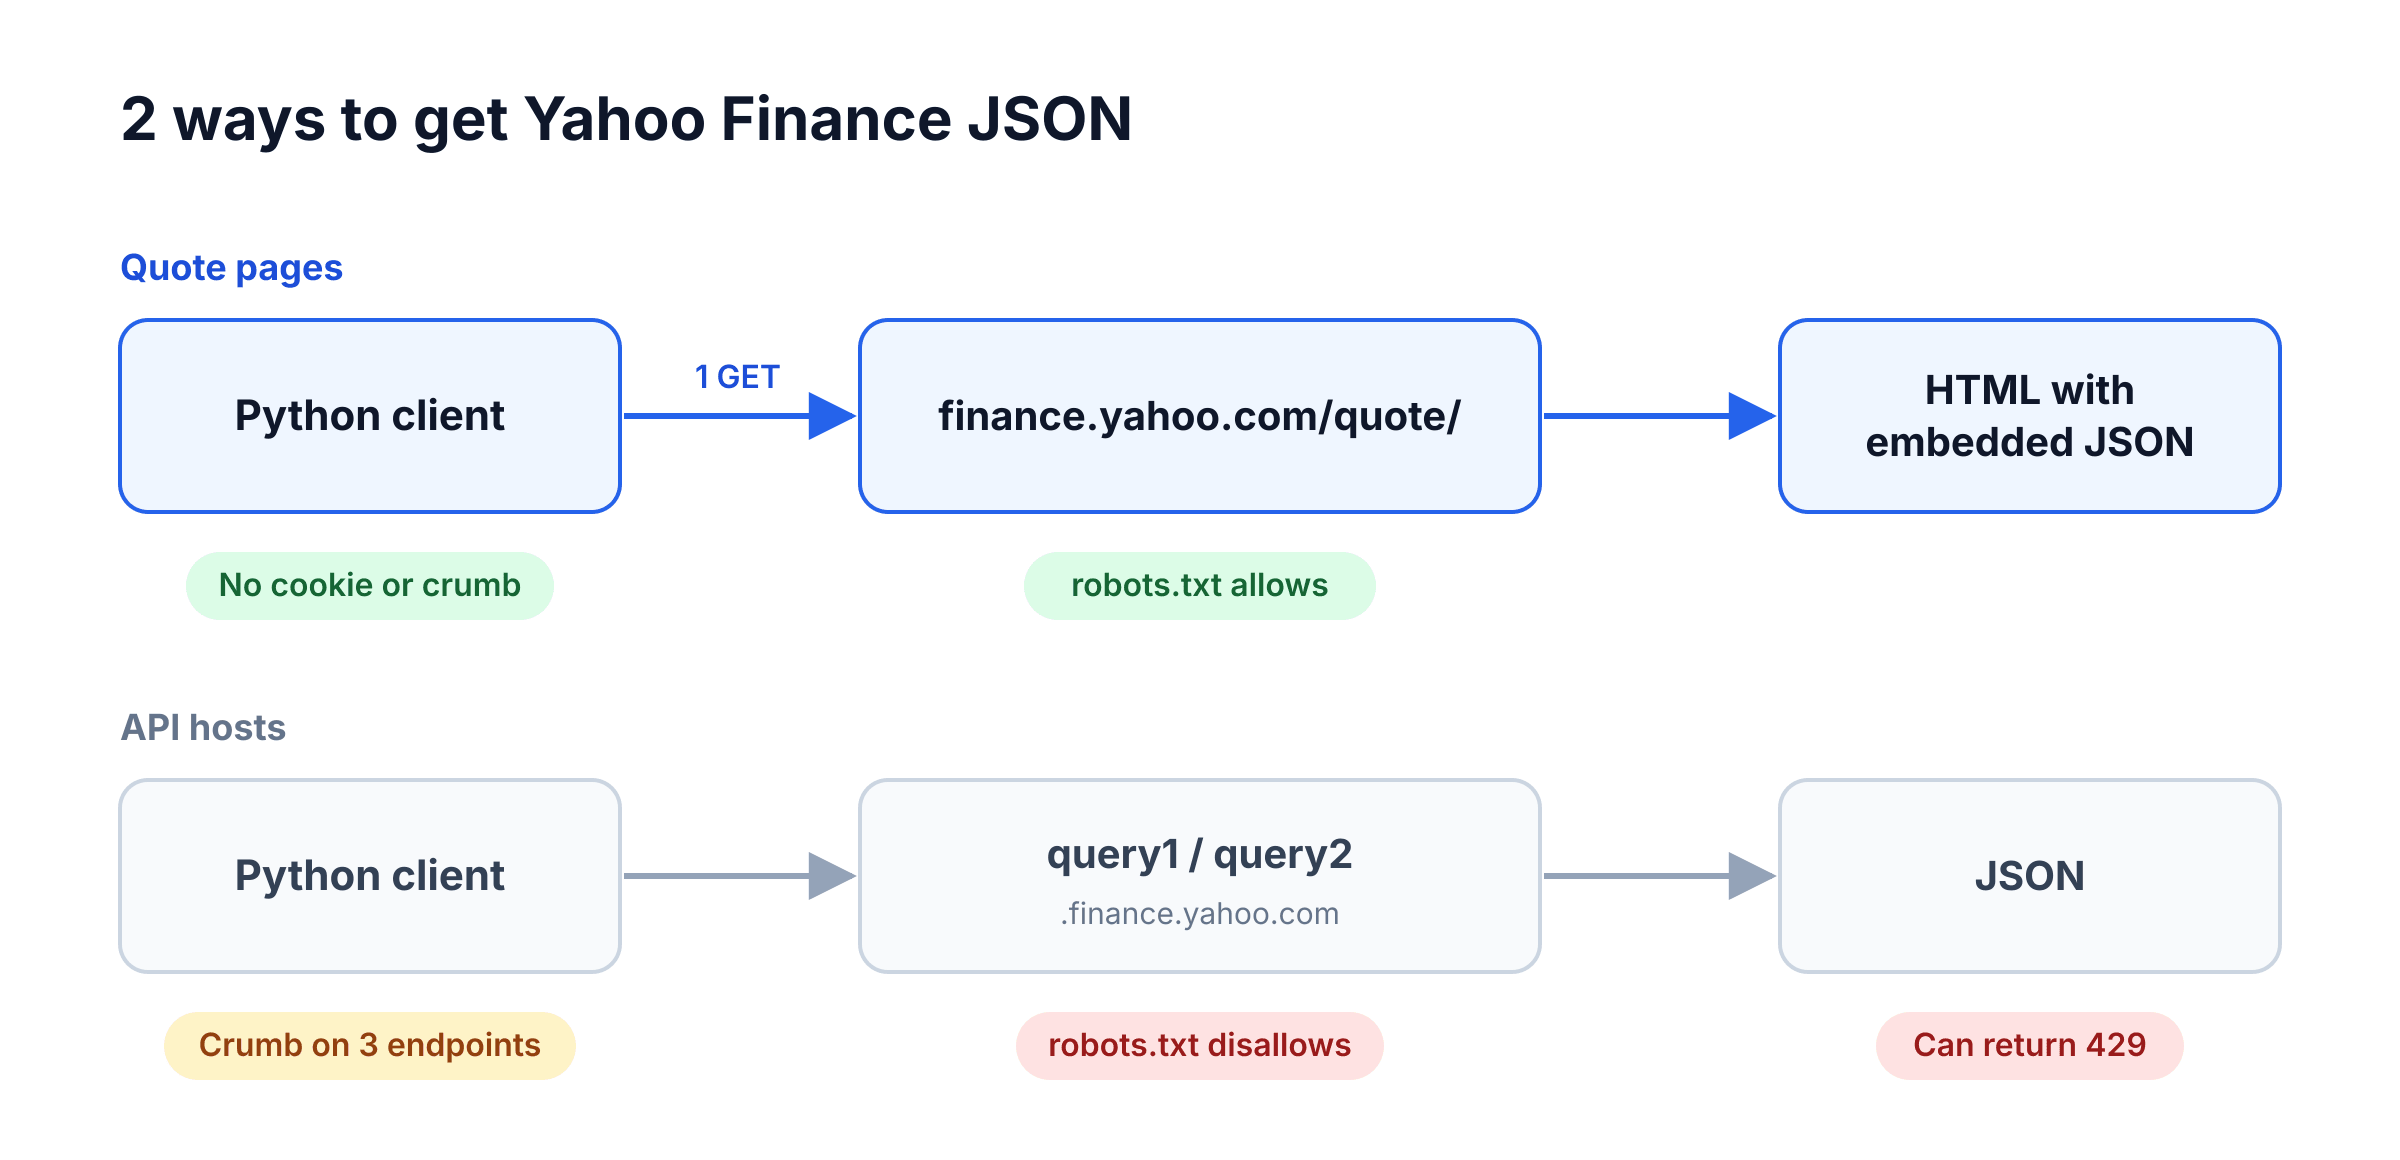
Les scripts ne lisent que les pages de cotation, donc ils n’appellent jamais les hôtes API.
De nombreux anciens tutoriels lisaient les prix avec des sélecteurs CSS qui ne fonctionnent plus. Sur la page MSFT, [data-symbol="MSFT"][data-field="regularMarketPrice"] et #quote-summary [data-test="PREV_CLOSE-value"] ne correspondaient à 0 élément. Le sélecteur moins spécifique fin-streamer[data-field="regularMarketPrice"] correspondait à 9, et la première correspondance contenait le prix du S&P 500 provenant du résumé de marché de la page.
D’autres tutoriels automatisent un navigateur. Le JSON intégré rend un navigateur inutile pour les cotations, l’historique quotidien, les états annuels et les estimations, car 1 requête HTTP par onglet retourne les mêmes données.
Si vous utilisez un navigateur, lisez la réponse HTML brute, car le code côté client de SvelteKit supprime chaque balise script après l’avoir lue. Dans 2 des 4 chargements de page testés, page.content() retournait la page sans les balises. Dans 1 de ces cas, le scraper lisait la page dès que DOMContentLoaded se déclenchait.
Pourquoi Yahoo Finance peut retourner 429 dès la première requête
Les réponses de Yahoo dépendaient du User-Agent du client et de la négociation TLS, donc un client peut obtenir un 429 dès sa première requête. L’en-tête server: ATS dans les réponses identifie Apache Traffic Server. Avec ses paramètres par défaut, la bibliothèque requests de Python obtenait un 429 dès sa première requête. Les réponses 429 avaient 2 formes :
- Avec le User-Agent par défaut
python-requests/2.34.2, chaque pile TLS du tableau ci-dessous obtenait une réponse de 23 octetsEdge: Too Many Requests. La bibliothèque requests de Python obtenait la même réponse surfinance.yahoo.com. - Sur les hôtes API, certains User-Agent de navigateur via la pile TLS de Python obtenaient une réponse de 19 octets
Too Many Requests.
Le tableau montre comment query1, l’hôte API utilisé par yfinance, a répondu aux requêtes de graphiques envoyées depuis 1 connexion résidentielle espacées d’au moins 1,5 seconde. La bibliothèque curl_cffi, un client HTTP Python, peut imiter la négociation TLS d’un navigateur. Chaque ligne associe une pile TLS à un en-tête User-Agent :
| Pile TLS | En-tête User-Agent | A obtenu 429 |
|---|---|---|
| Python requests (OpenSSL) | python-requests/2.34.2, par défaut |
5 sur 5 |
| Python requests (OpenSSL) | Chrome 140 sur macOS | 26 sur 26 |
| Python requests (OpenSSL) | Firefox 147 sur Windows | 16 sur 17 |
| Python requests (OpenSSL) | Safari 26 sur macOS | 8 sur 11 |
| Python requests (OpenSSL) | Chrome 150 sur macOS | 3 sur 6 |
| Python requests (OpenSSL) | Chrome 150 sur Windows | 0 sur 11 |
| Python requests (OpenSSL) | Mozilla/5.0 seul |
0 sur 11 |
| curl_cffi (négociation Chrome, Firefox ou Safari) | Chrome 140 ou 150, Firefox 147, Safari 26, ou Mozilla/5.0 |
0 sur 80 |
| curl_cffi (mêmes 3 négociations) | python-requests/2.34.2 |
15 sur 15 |
Pourquoi la négociation TLS est-elle importante ?
La réponse de Yahoo dépendait de la pile TLS, même quand le User-Agent était identique. Dans un test contrôlé, requests et curl_cffi envoyaient le même User-Agent (Chrome 140 sur macOS) et le même en-tête Accept via HTTP/1.1 depuis la même adresse IP. Seuls le client HTTP et sa pile TLS changeaient. Via la bibliothèque requests de Python, 0 requête sur 8 a réussi, et via la pile TLS Chrome de curl_cffi, 8 sur 8 ont réussi.
Les 2 piles diffèrent déjà avant l’envoi de tout en-tête. Une empreinte JA4, une forme courante de fingerprinting TLS, résume le ClientHello, le premier message qu’un client envoie lors d’une négociation TLS. La négociation OpenSSL de Python a produit t13d1812h1_85036bcba153_b26ce05bbdd6, et la cible chrome de curl_cffi a produit t13d1516h2_8daaf6152771_806a8c22fdea, qui correspond aux suites de chiffrement de Chrome. Interrogez https://tls.peet.ws/api/all depuis votre propre client pour voir ce qu’il envoie.
Chaque résultat dépendait de la combinaison de la pile TLS et du User-Agent. La chaîne Mozilla/5.0 seule a réussi 11 fois sur 11 via le TLS de Python. Chrome 140 sur macOS a échoué 26 fois sur 26, et Firefox 147 a échoué 16 fois sur 17. Ainsi, un User-Agent de navigateur réaliste peut faire échouer plus souvent la bibliothèque requests de Python.
Avec une négociation TLS de navigateur via curl_cffi, les User-Agent de navigateur du tableau ont réussi 80 requêtes sur 80. Dans un test plus restreint, finance.yahoo.com lui-même a accepté la chaîne Chrome 140 via le TLS de Python et a bloqué la chaîne python-requests par défaut. Le code du scraper utilise aussi curl_cffi sur finance.yahoo.com, de sorte que le User-Agent et la négociation TLS correspondent tous deux à Chrome.
Si vous envoyez un User-Agent de navigateur, envoyez aussi une négociation TLS de navigateur.
Le taux de requêtes compte-t-il ?
Pas pour les 429 sur les premières requêtes, qui dépendent du client. Avec 8 threads, curl_cffi a demandé les 503 pages de cotation du S&P 500, puis 501 pages d’historique, sans 429. C’est le volume d’une actualisation quotidienne du S&P 500. Si un 429 apparaît à un volume plus élevé, le code du scraper recule et réessaie.
Un extrait de limitation de débit posté dans le suivi des problèmes de yfinance limite le trafic à 60 requêtes par minute, 360 requêtes par heure, et 8 000 requêtes par jour. Ces chiffres proviennent de la page de limitation de débit de l’API DSP Traffic de Yahoo. Yahoo DSP est une plateforme côté demande pour l’achat de publicités, donc l’extrait utilise les limites d’un autre produit.
La bibliothèque yfinance recevait aussi des erreurs 429 de Yahoo, qu’elle levait sous forme de YFRateLimitError('Too Many Requests. Rate limited. Try after a while.'). Après qu’un fil de discussion sur les erreurs 429 a reçu plus de 140 commentaires, les mainteneurs de yfinance ont adopté la même solution : une négociation TLS de navigateur. La version 0.2.58 (2025) a migré la bibliothèque vers curl_cffi, et la version 1.7.0 crée sa session par défaut avec impersonate="chrome".
Le code fonctionne-t-il depuis un serveur cloud ?
Oui, sur 3 runners GitHub Actions avec des adresses IP Microsoft Azure. Sur chaque runner, la première requête de curl_cffi a retourné une page de cotation pour chacun des 20 symboles, allant des actions et ETF américains aux cryptomonnaies et cotations étrangères. Lors d’une seconde exécution, chaque runner a demandé les 503 pages de cotation du S&P 500 sans 429.
Les scripts ont retourné le même historique, états financiers et estimations que depuis le domicile. Sur les runners, la bibliothèque requests de Python avec son User-Agent par défaut obtenait la même réponse 429 de 23 octets, tandis que yfinance récupérait l’historique quotidien complet de MSFT.
Les échecs cloud rapportés impliquaient d’anciens clients et des plages d’IP partagées, donc testez les scripts depuis votre propre serveur avant de planifier une tâche. En 2025, avant que yfinance ne migre vers curl_cffi, ses mainteneurs ont supprimé leur tâche de test GitHub Actions après qu’elle n’a pas réussi à récupérer des données de Yahoo. Un autre développeur a retracé des réponses 401 “Invalid Crumb” jusqu’à la plage d’IP partagée du niveau gratuit de Render, une plateforme cloud. Les mêmes appels fonctionnaient depuis une IP résidentielle.
Extraire le JSON intégré d’une page de cotation
Vous avez besoin de Python 3.11 ou ultérieur et de 5 paquets. Le code a été testé sur Python 3.11, 3.13 et 3.14 avec curl_cffi 0.16.3, beautifulsoup4 4.15.0, lxml 6.1.3, pandas 3.0.6, et requests 2.34.2. Installez-les avec pip :
pip install curl_cffi beautifulsoup4 lxml pandas requestsPour les bases du scraping Python, consultez notre guide du scraping web avec Python. Le module principal récupère un seul onglet, vérifie que Yahoo a retourné une page de cotation, et renvoie les réponses intégrées indexées par leur URL d’API. Enregistrez-le sous yahoo_embedded.py, car les scripts qui lisent les pages de Yahoo en dépendent :
import json
import random
import threading
import time
from urllib.parse import quote

from bs4 import BeautifulSoup
from curl_cffi import requests

QUOTE_URL = "https://finance.yahoo.com/quote"
_local = threading.local()


class SymbolNotFound(Exception):
    """Yahoo returned its lookup page or a soft 404 instead of a quote page."""


def page_url(symbol: str, tab: str = "") -> str:
    return (
        f"{QUOTE_URL}/{quote(symbol.upper(), safe='')}/{tab}"  # ^GSPC becomes %5EGSPC
    )


def embedded(html: str) -> dict[str, dict]:
    """Map the API URLs the page was rendered from to their JSON bodies."""
    soup = BeautifulSoup(html, "lxml")
    found = {}
    for tag in soup.select('script[type="application/json"][data-sveltekit-fetched]'):
        try:
            wrapper = json.loads(tag.string)
            found[tag["data-url"]] = json.loads(wrapper["body"])
        except (TypeError, KeyError, ValueError):
            continue  # an embedded response whose body isn't JSON
    return found


def pick(found: dict[str, dict], path: str) -> dict:
    """Return the first embedded response whose URL contains `path`."""
    for url, body in found.items():
        if path in url:
            return body
    raise LookupError(f"no embedded response for {path}")


def is_quote_page(html: str, symbol: str) -> bool:
    """True for a quote page, False otherwise, SymbolNotFound for an unknown symbol."""
    found = embedded(html)
    if any("/v1/finance/lookup" in url for url in found):
        raise SymbolNotFound(symbol)
    for url, body in found.items():
        if "/v1/finance/quoteType/" in url:
            result = (body.get("quoteType") or {}).get("result") or [{}]
            if not result[0].get("exchange"):
                # A soft 404, as for BRK.B (Yahoo spells it BRK-B)
                raise SymbolNotFound(symbol)
            return True
    return False


def _session() -> requests.Session:
    # One Chrome-impersonating session per thread, as curl_cffi recommends.
    if not hasattr(_local, "session"):
        _local.session = requests.Session(impersonate="chrome")
    return _local.session


def fetch_page(
    symbol: str, tab: str = "", params: dict | None = None, attempts: int = 4
) -> str:
    """Return the HTML of a quote page, for example tab="history/"."""
    for attempt in range(attempts):
        if attempt:
            time.sleep(2**attempt + random.random())  # back off before each retry
        try:
            response = _session().get(
                page_url(symbol, tab), params=params, timeout=30, allow_redirects=False
            )
        except requests.RequestException:
            continue  # timeout or dropped connection
        if response.is_redirect:
            location = response.headers.get("location", "")
            if "/lookup" in location:
                raise SymbolNotFound(symbol)
            # For example, a tab that doesn't exist
            raise LookupError(f"{symbol} {tab}: Yahoo redirected to {location}")
        if response.status_code == 200 and is_quote_page(response.text, symbol):
            return response.text
        if 400 <= response.status_code < 500 and response.status_code != 429:
            response.raise_for_status()
    # Every attempt timed out or got a 429, a 5xx, or a page without quote data
    raise RuntimeError(f"{symbol} {tab}: no quote data after {attempts} attempts")


if __name__ == "__main__":
    from urllib.parse import urlsplit

    found = embedded(fetch_page("MSFT"))
    print(len(found), "embedded responses")
    for url in found:
        if url.startswith("https://"):
            print(urlsplit(url).netloc, urlsplit(url).path)
Le module gère 3 cas particuliers :
allow_redirects=Falsearrête le client à une redirection au lieu de la suivre. Un 302 vers/lookup/signifie un symbole inconnu, donc le module lèveSymbolNotFound. Il ne récupère pas la page de recherche, que robots.txt interdit. Toute autre redirection, comme un onglet qu’un ETF n’a pas, lèveLookupErrordès la première tentative.is_quote_page()vérifie la présence de la réponsequoteType, car un statut 200 seul ne prouve pas que la page contient des données. Les 11 onglets de MSFT l’intégraient, y comprisnews/. UnquoteTypesans exchange signifie un faux 404, une page avec statut 200 mais sans données de cotation. Yahoo a retourné ce type de page pourBRK.B, car il orthographie le symboleBRK-B.quote(symbol.upper(), safe='')met le symbole en majuscules et encode en pourcentage les symboles d’indices comme^GSPC, car^n’est pas un caractère URL valide avant d’être encodé.
Pour MSFT, le module liste les API Yahoo que la page appelle :
23 embedded responses
query1.finance.yahoo.com /ws/obi-integration/v1/premiumTiersMeta
query1.finance.yahoo.com /v1/finance/quoteType/MSFT
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v6/finance/quote/marketSummary
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v6/finance/recommendationsbysymbol/MSFT
query1.finance.yahoo.com /v6/finance/markettime
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v10/finance/quoteSummary/MSFT
query1.finance.yahoo.com /v1/finance/trending/US
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v1/finance/screener/predefined/saved
Les statistiques de l’onglet résumé proviennent de v10/finance/quoteSummary, qui contenait environ 223 Ko de JSON répartis sur 17 modules pour MSFT. La liste montre les 13 URLs API absolues, et les 10 autres réponses provenaient des propres points de terminaison /xhr/ de Yahoo. La plupart des 23 fournissent des données pour les widgets de la page, comme les tickers tendance et les résumés de marché. Le nombre varie : depuis des runners cloud américains, la même page intégrait 26 réponses, et celles en plus incluaient price-insights.
Analyser les champs de prix, valorisation et notation
De nombreux nombres dans quoteSummary sont des paires {"raw": 516.17, "fmt": "516.17"}, donc une fonction utilitaire conserve la valeur brute. Cette fonction retourne 20 champs de cotation. Enregistrez-la sous quote_summary.py, car les scripts d’estimations et de traitement par lots la réutilisent :
import json

from yahoo_embedded import embedded, fetch_page, pick


def raw(module: dict, key: str):
    """Many numbers are {"raw": 516.17, "fmt": "516.17"} pairs. Keep the raw value."""
    value = module.get(key)
    return value.get("raw") if isinstance(value, dict) else value


def quote_summary(symbol: str, fetch=fetch_page) -> dict:
    found = embedded(fetch(symbol))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    price = result.get("price", {})
    detail = result.get("summaryDetail", {})
    stats = result.get("defaultKeyStatistics", {})
    analysts = result.get("financialData", {})
    return {
        "symbol": price.get("symbol"),
        "name": price.get("longName") or price.get("shortName"),
        "quote_type": price.get("quoteType"),
        "currency": price.get("currency"),
        "price": raw(price, "regularMarketPrice"),
        "change_pct": raw(price, "regularMarketChangePercent"),
        "market_time": raw(price, "regularMarketTime"),
        "market_state": price.get("marketState"),
        "delay_minutes": price.get("exchangeDataDelayedBy"),
        "market_cap": raw(price, "marketCap"),
        "trailing_pe": raw(detail, "trailingPE"),
        "forward_pe": raw(detail, "forwardPE"),
        "dividend_yield": raw(detail, "dividendYield"),
        "beta": raw(detail, "beta"),
        "week52_low": raw(detail, "fiftyTwoWeekLow"),
        "week52_high": raw(detail, "fiftyTwoWeekHigh"),
        "eps_ttm": raw(stats, "trailingEps"),
        "target_mean": raw(analysts, "targetMeanPrice"),
        "recommendation": analysts.get("recommendationKey"),
        "reporting_currency": analysts.get("financialCurrency"),
    }


if __name__ == "__main__":
    print(json.dumps(quote_summary("MSFT"), indent=2))
Pour MSFT, la fonction a affiché les valeurs brutes des 20 champs après une clôture de marché :
{
  "symbol": "MSFT",
  "name": "Microsoft Corporation",
  "quote_type": "EQUITY",
  "currency": "USD",
  "price": 516.17,
  "change_pct": 0.0366316,
  "market_time": 1790366401,
  "market_state": "CLOSED",
  "delay_minutes": 0,
  "market_cap": 3832843862016,
  "trailing_pe": 28.739979,
  "forward_pe": 21.801512,
  "dividend_yield": 0.0076,
  "beta": 1.108,
  "week52_low": 349.2,
  "week52_high": 553.72,
  "eps_ttm": 17.96,
  "target_mean": 577.26135,
  "recommendation": "strong_buy",
  "reporting_currency": "USD"
}
L’onglet résumé affichait les mêmes chiffres formatés, comme une capitalisation boursière de 3,833T, un P/E de 28,74, et un rendement du dividende de 0,76% :
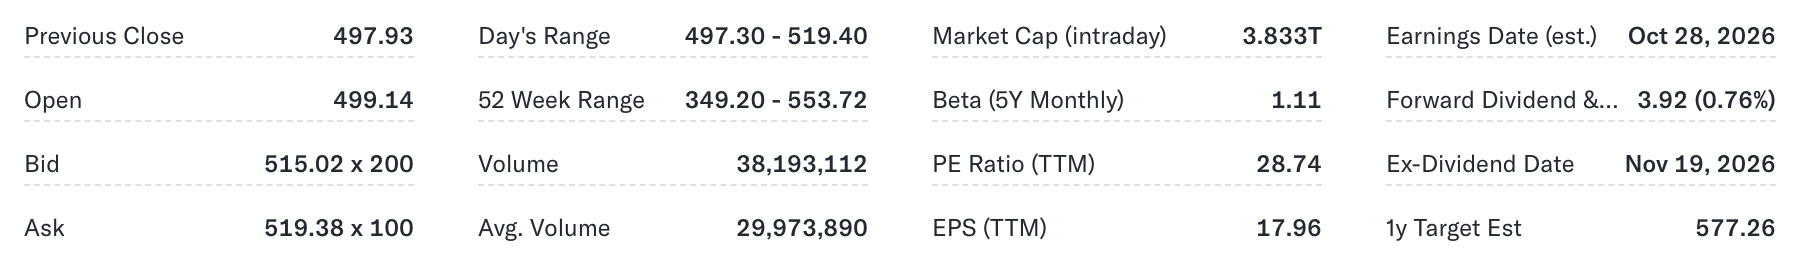
Le JSON contient plutôt les valeurs brutes, comme 3832843862016 pour la capitalisation boursière de 3,833T.
Dans les valeurs brutes, les pourcentages sont des fractions, donc un change_pct de 0,0366316 est une variation de 3,66%, et un dividend_yield de 0,0076 vaut 0,76%. La fonction lit chaque module avec .get() car les modules intégrés diffèrent selon le type d’actif. SPY, ^GSPC, BTC-USD, et EURUSD=X ont tous retourné des prix sans le module financialData, donc leurs champs d’analystes étaient None. SPY incluait plutôt fundProfile et topHoldings.
Télécharger l’historique complet des prix en 1 requête
L’onglet historique (history/) transmet les paramètres period1, period2, et frequency de sa propre URL à la requête de graphique qu’il intègre. Les deux paramètres de période sont des horodatages Unix, donc un period1 de 0 demande chaque barre depuis le 1er janvier 1970. Le sélecteur de dates commence alors à cette date, et frequency=1d affiche les lignes quotidiennes :
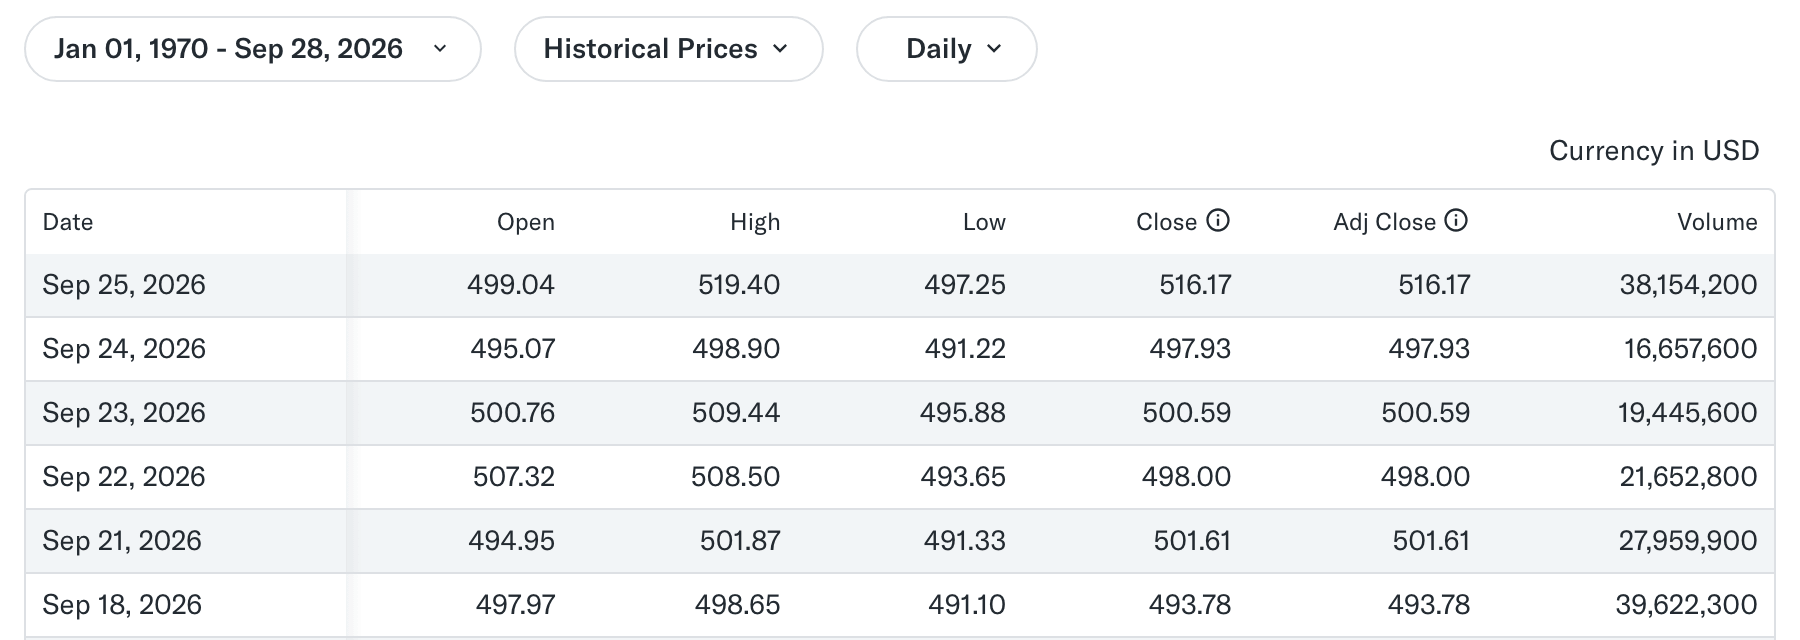
La ligne la plus récente du tableau correspond à la dernière ligne que price_history() affiche ci-dessous.
La fonction price_history() convertit la réponse de graphique intégrée en DataFrame indexé par les dates dans le fuseau horaire de la bourse. Enregistrez-la sous price_history.py :
import time

import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def price_history(
    symbol: str, frequency: str = "1d", fetch=fetch_page
) -> tuple[pd.DataFrame, dict]:
    """Every bar since 1970 at 1d, 1wk or 1mo, plus split and dividend events."""
    params = {"period1": 0, "period2": int(time.time()), "frequency": frequency}
    found = embedded(fetch(symbol, "history/", params))
    result = pick(found, "/v8/finance/chart/")["chart"]["result"][0]
    bars, meta = result["indicators"]["quote"][0], result["meta"]
    utc = pd.to_datetime(result["timestamp"], unit="s", utc=True)
    index = utc.tz_convert(meta["exchangeTimezoneName"]).tz_localize(None).normalize()
    frame = pd.DataFrame(
        {
            "open": bars["open"],
            "high": bars["high"],
            "low": bars["low"],
            "close": bars["close"],
            "adj_close": result["indicators"]["adjclose"][0]["adjclose"],
            "volume": bars["volume"],
        },
        index=index,
    )
    if frequency != "1d" and result["timestamp"][-1] == meta.get("regularMarketTime"):
        frame = frame.iloc[:-1]  # Yahoo appends the latest session as an extra bar
    return frame.dropna(how="all"), result.get("events", {})


if __name__ == "__main__":
    history, events = price_history("MSFT")
    print(history.tail(3).round(2).to_string())
    print(
        f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
        f"to {history.index[-1]:%Y-%m-%d}"
    )
    splits = sorted(
        pd.Timestamp(s["date"], unit="s").date()
        for s in events.get("splits", {}).values()
    )
    if splits:
        print(f"{len(splits)} splits, the last one on {splits[-1]}")
Une seule requête a retourné l’historique complet de MSFT :
              open    high     low   close  adj_close    volume
2026-09-23  500.76  509.44  495.88  500.59     500.59  19445600
2026-09-24  495.07  498.90  491.22  497.93     497.93  16657600
2026-09-25  499.04  519.40  497.25  516.17     516.17  38154200
10,213 daily bars from 1986-03-13 to 2026-09-25
9 splits, the last one on 2003-02-18
Via l’hôte API, yfinance a retourné les mêmes 10 213 barres pour cette période. Gérez ces 5 détails dans un pipeline d’historique :
- Dans les tests, l’historique ne commençait pas avant 1970. La page d’aide de Yahoo sur les données historiques indique que les prix ne commencent généralement pas avant cette date. Coca-Cola est coté depuis 1919, mais son historique complet commençait le 1970-01-02. Un
period1négatif retournait 404. frequencyprend en charge1d,1wk, et1mo. En1wket1mo, Yahoo ajoutait la dernière session comme barre supplémentaire, et la fonction la supprime. Cette barre retirée, la dernière barre hebdomadaire ou mensuelle peut exclure la dernière session de trading, donc prenez les clôtures récentes à partir des barres quotidiennes.- Les valeurs intrajournalières comme
1h,5m, et1mretournaient plutôt des barres quotidiennes. L’onglet résumé intègre jusqu’à 24 heures de clôtures sur 5 minutes depuis/v7/finance/spark. Il intègre aussi une seconde réponse spark pour le résumé de marché, donc choisissez la réponse dont le paramètresymbolscorrespond à votre ticker. Les pages de cotation ne contiennent que ces 24 heures de données intrajournalières, car l’historique intrajournalier plus long provient des hôtes API, que robots.txt interdit. - Yahoo ajuste
closepour les fractionnements etadj_closepour les fractionnements et les dividendes. Les anciennes barres changent après chaque nouveau fractionnement ou dividende, donc stockez les événements de fractionnement et de dividende avec chaque téléchargement. - La taille de la page augmente avec la plage de dates. Avec la plage de dates complète, l’onglet historique de MSFT faisait 4,9 Mo de HTML, et l’onglet résumé environ 1,1 Mo. Pour une actualisation quotidienne, définissez
period1sur un horodatage récent, et retéléchargez la plage complète après chaque nouveau fractionnement ou dividende.
Récupérer les états financiers et les estimations d’analystes
Les états et les estimations se trouvent sur des onglets différents, donc chacun a sa propre fonction.
Obtenir les états financiers annuels
Les états financiers proviennent de la réponse fundamentals-timeseries sur les onglets financials, balance sheet, et cash flow. Sur l’onglet financials de MSFT, cette réponse contenait 96 séries annuelles et 96 séries sur 12 mois glissants. statement() conserve les séries annuelles et les pivote en un tableau avec 1 colonne par exercice fiscal. Enregistrez-la sous statements.py :
import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def statement(symbol: str, tab: str = "financials/", fetch=fetch_page) -> pd.DataFrame:
    """Annual line items from the financials/, balance-sheet/ or cash-flow/ tab."""
    found = embedded(fetch(symbol, tab))
    series = pick(found, "/fundamentals-timeseries/")["timeseries"]["result"]
    rows = []
    for item in series:
        name = item["meta"]["type"][0]  # for example "annualTotalRevenue"
        if not name.startswith("annual"):
            continue  # skip non-annual series, such as trailing 12 months
        for point in item.get(name) or []:
            if point:
                rows.append(
                    {
                        "line_item": name.removeprefix("annual"),
                        "fiscal_year_end": point["asOfDate"],
                        "value": point["reportedValue"]["raw"],
                    }
                )
    table = pd.DataFrame(rows).pivot(
        index="line_item", columns="fiscal_year_end", values="value"
    )
    return table.sort_index(axis=1)


if __name__ == "__main__":
    income = statement("MSFT")
    billions = (
        income.loc[["TotalRevenue", "GrossProfit", "OperatingIncome", "NetIncome"]].T
        / 1e9
    )
    billions["DilutedEPS"] = income.loc["DilutedEPS"]
    print(billions.round(2).to_string())
    print(f"{len(income)} line items")
Le script a affiché 4 exercices fiscaux du compte de résultat, en milliards de dollars sauf pour le BPA :
line_item        TotalRevenue  GrossProfit  OperatingIncome  NetIncome  DilutedEPS
fiscal_year_end
2023-06-30             211.92       146.05            88.52      72.36        9.68
2024-06-30             245.12       171.01           109.43      88.14       11.80
2025-06-30             281.72       193.89           128.53     101.83       13.64
2026-06-30             331.84       225.46           155.24     133.75       17.95
47 line items
Sur l’onglet financials, Yahoo affiche les mêmes chiffres en milliers, donc les 331,84 Md de revenus dans la sortie apparaissent comme 331 839 000 :
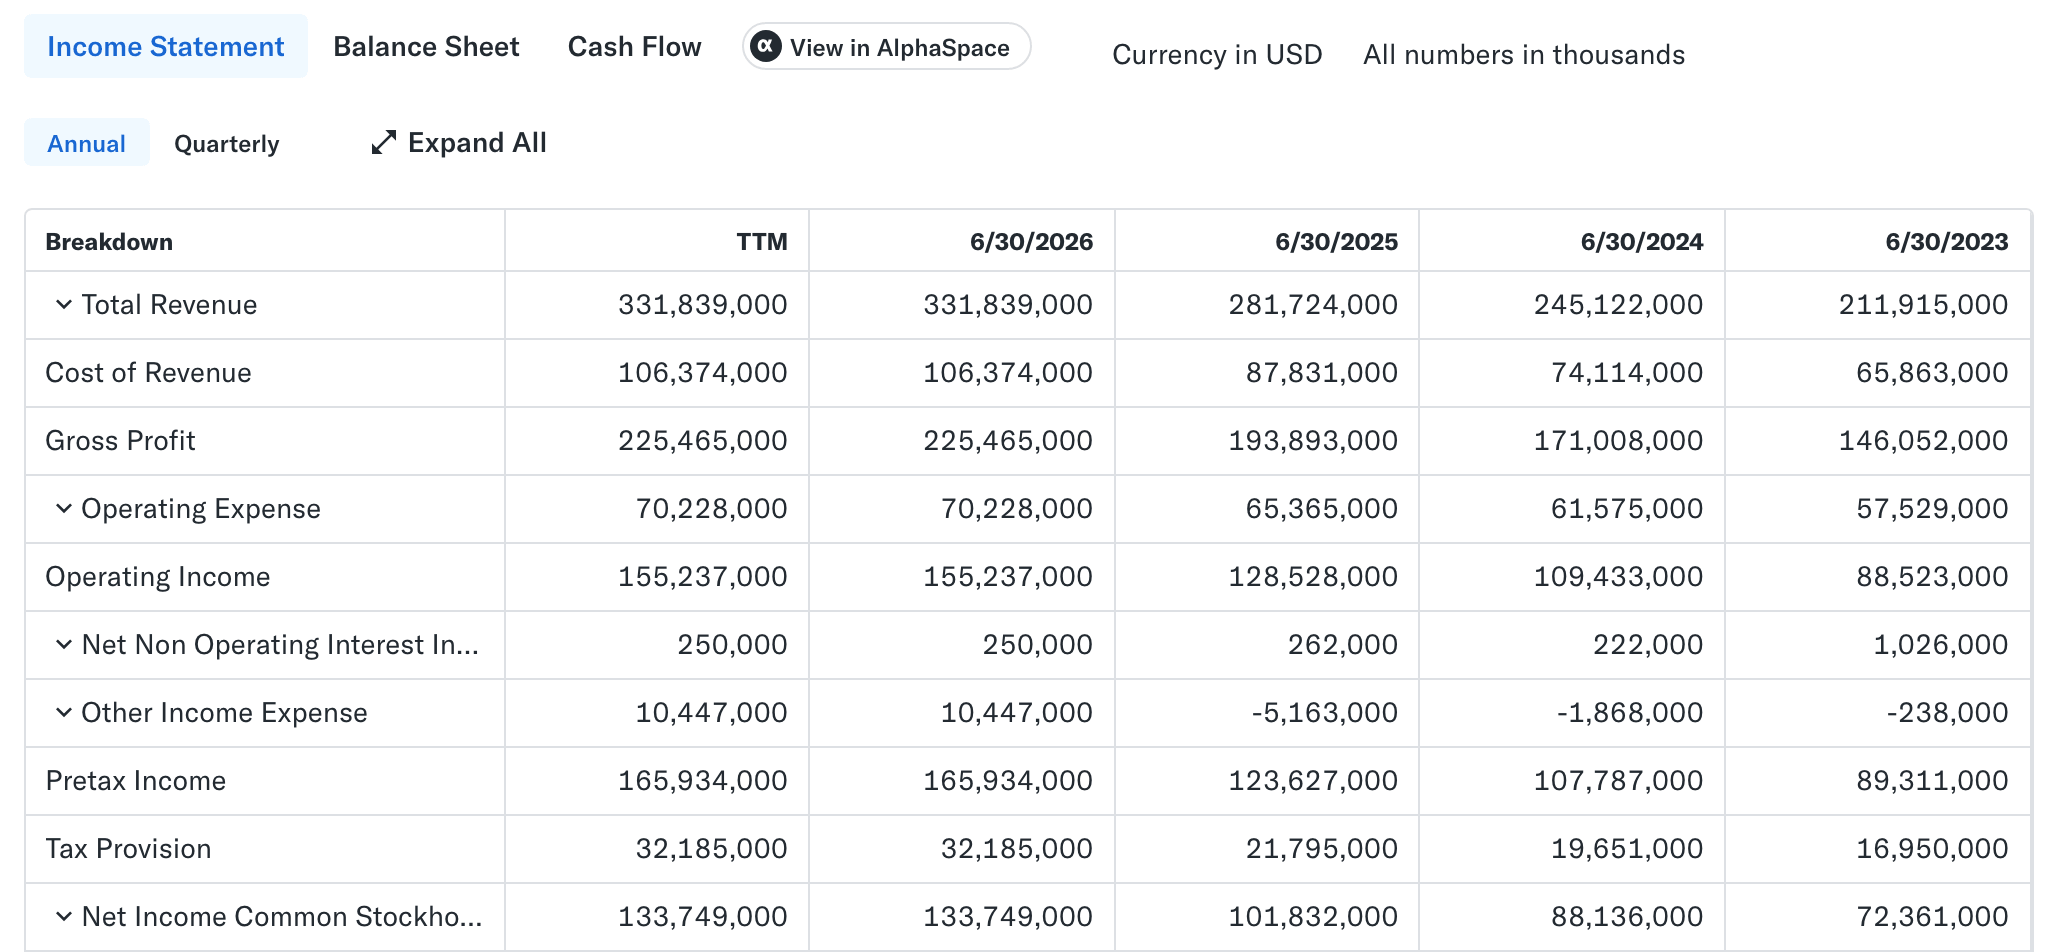
Les vues Income Statement, Balance Sheet, et Cash Flow sont les onglets financials/, balance-sheet/, et cash-flow/ que statement() lit.
Pour MSFT, 47 des 96 séries annuelles avaient des valeurs. Les séries vides correspondaient à des postes comme les sinistres d’assurance, les dividendes privilégiés, et les taxes d’accise. Pour ces 4 années, la fonction a retourné 79 postes depuis balance-sheet/ et 59 postes depuis cash-flow/. Les états trimestriels ne se chargent qu’après avoir sélectionné le bouton Quarterly, et aucun paramètre d’URL testé ne changeait cela.
Ignorez les modules incomeStatementHistory et balanceSheetHistory dans quoteSummary. Leurs lignes de résultat n’avaient de valeurs réelles que pour le revenu total et le revenu net, dans les versions annuelle et trimestrielle. Les lignes du bilan n’avaient que des dates. D’autres champs de résultat contenaient 0 comme valeur de remplacement, donc un analyseur qui leur fait confiance stockerait un profit brut de 0.
Obtenir les estimations d’analystes
L’onglet analysis intègre earningsTrend, qui contient le BPA consensuel et les revenus pour le trimestre en cours, le trimestre suivant, l’année en cours, et l’année suivante. estimates() l’aplatit en 1 ligne par période. Enregistrez-la sous estimates.py :
import pandas as pd

from quote_summary import raw
from yahoo_embedded import embedded, fetch_page, pick


def estimates(symbol: str, fetch=fetch_page) -> pd.DataFrame:
    """Consensus EPS and revenue for the current and next quarter and year."""
    found = embedded(fetch(symbol, "analysis/"))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    rows = []
    for period in result["earningsTrend"]["trend"]:
        eps, revenue = period["earningsEstimate"], period["revenueEstimate"]
        revenue_avg = raw(revenue, "avg")
        rows.append(
            {
                "period": period["period"],  # 0q, +1q, 0y, +1y
                "ends": period["endDate"],
                "eps_avg": raw(eps, "avg"),
                "eps_low": raw(eps, "low"),
                "eps_high": raw(eps, "high"),
                "eps_analysts": raw(eps, "numberOfAnalysts"),
                "revenue_avg_bn": None if revenue_avg is None else revenue_avg / 1e9,
                "revenue_analysts": raw(revenue, "numberOfAnalysts"),
            }
        )
    return pd.DataFrame(rows).set_index("period")


if __name__ == "__main__":
    print(estimates("MSFT").round(2).to_string())
Pour MSFT, chaque estimation provenait de 25 à 51 analystes :
              ends  eps_avg  eps_low  eps_high  eps_analysts  revenue_avg_bn  revenue_analysts
period
0q      2026-09-30     4.72     4.43      4.83            25           90.66                38
+1q     2026-12-31     4.82     4.72      5.02            25           95.49                37
0y      2027-06-30    19.76    19.21     20.70            33          391.04                50
+1y     2028-06-30    23.68    22.08     26.00            32          467.27                51
Sur l’onglet analysis, le tableau Earnings Estimate affiche les mêmes chiffres de BPA. Ses colonnes Current Qtr., Next Qtr., Current Year, et Next Year correspondent aux lignes 0q, +1q, 0y, et +1y :
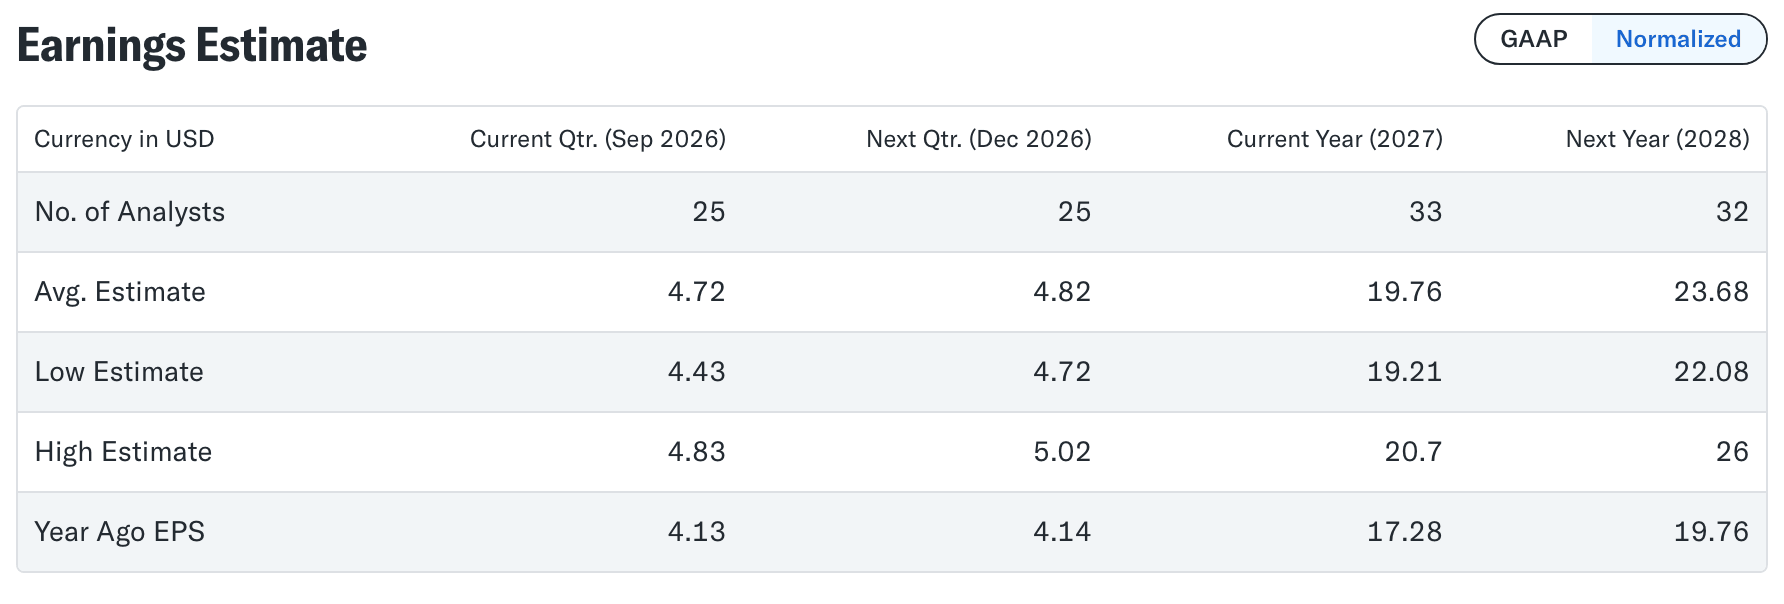
La vue Normalized du tableau montre les mêmes chiffres que contient earningsTrend.
La même requête retourne aussi epsTrend et epsRevisions pour chaque période, et earningsHistory avec les 4 derniers trimestres publiés et leurs pourcentages de surprise.
Scraper Yahoo Finance pour des centaines de tickers
De nombreuses listes de tickers en production incluent d’anciens symboles, des indices, et des cotations étrangères, donc votre script par lots doit signaler les problèmes et continuer. Enregistrez le prochain script sous batch.py. Il exécute 8 threads par défaut, collecte séparément les symboles manquants et échoués, et convertit les unités monétaires mineures :
from concurrent.futures import ThreadPoolExecutor

import pandas as pd

from quote_summary import quote_summary
from yahoo_embedded import SymbolNotFound, fetch_page

# Yahoo quotes many London, Johannesburg, and Tel Aviv prices in minor units.
# Market cap stays in major units.
MINOR_UNITS = {"GBp": ("GBP", 100), "ZAc": ("ZAR", 100), "ILA": ("ILS", 100)}
PRICE_FIELDS = ("price", "week52_low", "week52_high", "target_mean")


def to_major_units(row: dict) -> dict:
    unit = MINOR_UNITS.get(row["currency"])
    if unit is None:
        return row
    currency, divisor = unit
    prices = {key: row[key] / divisor for key in PRICE_FIELDS if row[key] is not None}
    return {**row, **prices, "currency": currency}


def collect(symbols: list[str], fetch=fetch_page, workers: int = 8):
    """Quote rows for many symbols, plus the symbols that were missing or failed."""
    # " msft" and "MSFT" are the same ticker
    symbols = list(dict.fromkeys(s.strip().upper() for s in symbols))
    missing, failed = [], {}

    def one(symbol: str) -> dict | None:
        try:
            return to_major_units(quote_summary(symbol, fetch=fetch))
        except SymbolNotFound:
            missing.append(symbol)
        except Exception as error:  # keep the batch running, report at the end
            failed[symbol] = repr(error)
        return None

    with ThreadPoolExecutor(max_workers=workers) as pool:
        rows = [row for row in pool.map(one, symbols) if row]
    return pd.DataFrame(rows), missing, failed


if __name__ == "__main__":
    tickers = "AAPL MSFT SQ ^GSPC SPY BTC-USD 7203.T SAP.DE VOD.L NPN.JO".split()
    table, missing, failed = collect(tickers)
    cols = "symbol price currency market_cap delay_minutes reporting_currency".split()
    print(table[cols].to_string(index=False))
    print("missing:", missing, "| failed:", failed)
Une liste mixte de 10 symboles s’est terminée en 2,5 secondes :
 symbol     price currency   market_cap  delay_minutes reporting_currency
   AAPL   341.070      USD 4.977637e+12              0                USD
   MSFT   516.170      USD 3.832844e+12              0                USD
  ^GSPC  7743.410      USD          NaN              0                NaN
    SPY   771.350      USD          NaN              0                NaN
BTC-USD 85011.320      USD 1.707212e+12              0                NaN
 7203.T  2989.500      JPY 3.540116e+13             20                JPY
 SAP.DE   185.920      EUR 2.145897e+11             15                EUR
  VOD.L     1.258      GBP 2.907280e+10             15                EUR
 NPN.JO   709.380      ZAR 5.307029e+11             15                USD
missing: ['SQ'] | failed: {}
Le lot a signalé SQ comme manquant car Block, Inc. a changé son symbole en XYZ. Yahoo redirige l’ancien symbole vers sa page de recherche, mais un symbole réutilisé échoue silencieusement. FB, l’ancien symbole de Meta, retournait un ETF ProShares avec le statut 200, donc comparez chaque name avec votre liste de tickers. La page de cotation FB ressemble à n’importe quelle autre page de cotation :
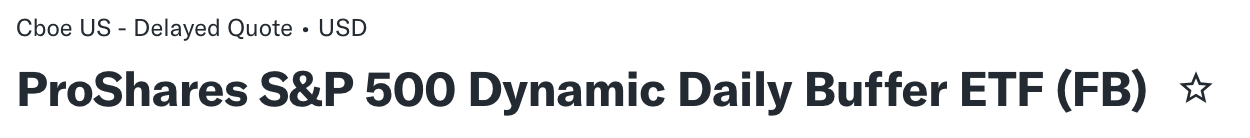
Un symbole réutilisé retourne une page de cotation normale, donc le nom est le signe le plus clair du changement.
Vérifier les unités, devises, et délais
Une vérification du code de statut ne détectera pas 3 problèmes supplémentaires :
- Unités monétaires mineures. Yahoo a rapporté le prix de VOD.L comme 125,8 en
GBp(pence) et sa capitalisation boursière comme 29,07 Md en livres. Le prix de NPN.JO était 70 938 enZAc(cents).to_major_units()ne divise que les champs de prix, donc la capitalisation boursière conserve ses unités majeures. - Devise de déclaration. Les valeurs des états utilisent la devise de déclaration de l’entreprise, et les points de données de séries temporelles incluent cette devise dans un champ
currencyCode. Vodafone (VOD.L) se négocie en pence mais déclare en euros, et Naspers (NPN.JO) se négocie en rand mais déclare en dollars américains. Les ratios peuvent mélanger les 2 devises. Le P/E à terme de TEVA.TA était 43,5, tandis que TEVA, sa cotation new-yorkaise, avait 12,9. Yahoo avait divisé le prix en shekels de TEVA.TA par une estimation de BPA en dollars. - Délai de bourse.
delay_minutesétait 0 pour les cotations américaines et le Bitcoin. Les cotations Xetra, Londres, et Johannesburg avaient un délai de 15 minutes, et la cotation de Tokyo avait un délai de 20 minutes. Conservezdelay_minutesetmarket_timeavec chaque ligne avant de comparer les prix entre bourses.
Exécuter des lots plus volumineux
Avec ses 8 threads par défaut, collect() a traité les 503 symboles du S&P 500 en 74 secondes depuis la connexion résidentielle sans 429 ni réessai. Seuls BRK.B et BF.B manquaient, car la liste du S&P 500 de Wikipedia les orthographie avec des points et Yahoo utilise BRK-B et BF-B. Avec period1 réglé à il y a 7 jours, les 501 historiques se sont actualisés en 48 secondes. La page médiane faisait moins de 1 Mo, contre 4,9 Mo pour l’historique complet de MSFT.
Avec un recul exponentiel, fetch_page() réessaie déjà les délais d’attente, les 429, les réponses 5xx, et les pages sans données de cotation. Notre guide pour réessayer les requêtes échouées en Python explique le recul avec le Retry d’urllib3 et Tenacity.
Si vous passez à asyncio, vérifiez d’abord la limite de taille d’en-tête de réponse de votre client. La réponse pour l’onglet résumé de MSFT avait environ 37 Ko d’en-têtes, incluant un Content-Security-Policy de 8 765 octets et un en-tête Link de 27 039 octets. Avec les paramètres par défaut, aiohttp 3.14.3 a levé une ClientResponseError sur une page que Yahoo avait servie avec le statut 200. Son message commençait par 400, message='Got more than 8190 bytes when reading.
Passer max_field_size=65536 à aiohttp.ClientSession a corrigé l’erreur. Httpx et l’AsyncSession de curl_cffi ont tous deux géré la page avec les paramètres par défaut. Notre comparaison de requests, httpx, et aiohttp explique les autres compromis entre eux.
Exécuter le même analyseur depuis un serveur avec Web Unlocker API
Notre Web Unlocker API prend une URL et retourne la page. Il gère la rotation d’IP, la résolution de CAPTCHA, et les réessais automatiques sur nos serveurs, donc le même analyseur s’exécute depuis votre serveur pendant que nous assurons le déblocage. fetch_page_unlocker() accepte les mêmes arguments symbol, tab, et params que fetch_page(), donc quote_summary(), price_history(), statement(), et estimates() l’acceptent tous via leur paramètre fetch. Enregistrez-le sous unlocker.py :
import os
from urllib.parse import urlencode

import requests

from yahoo_embedded import page_url

API_URL = "https://api.brightdata.com/request"


def fetch_page_unlocker(symbol: str, tab: str = "", params: dict | None = None) -> str:
    """Takes the same symbol, tab, and params as fetch_page(), via Web Unlocker API."""
    url = page_url(symbol, tab) + (f"?{urlencode(params)}" if params else "")
    response = requests.post(
        API_URL,
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={
            "zone": os.environ["BRIGHTDATA_UNLOCKER_ZONE"],
            "url": url,
            "format": "json",  # Yahoo's status, headers, and HTML, wrapped in JSON
            "country": "us",
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.json()["body"]
Il lit votre clé API et le nom de votre zone Web Unlocker API depuis 2 variables d’environnement. Une zone est une configuration de produit nommée dans votre compte. Vous trouverez la clé sur la page des paramètres de compte et les étapes pour créer une zone dans le guide de démarrage rapide de Web Unlocker API. Une fois la zone créée, son onglet Overview affiche les deux valeurs :
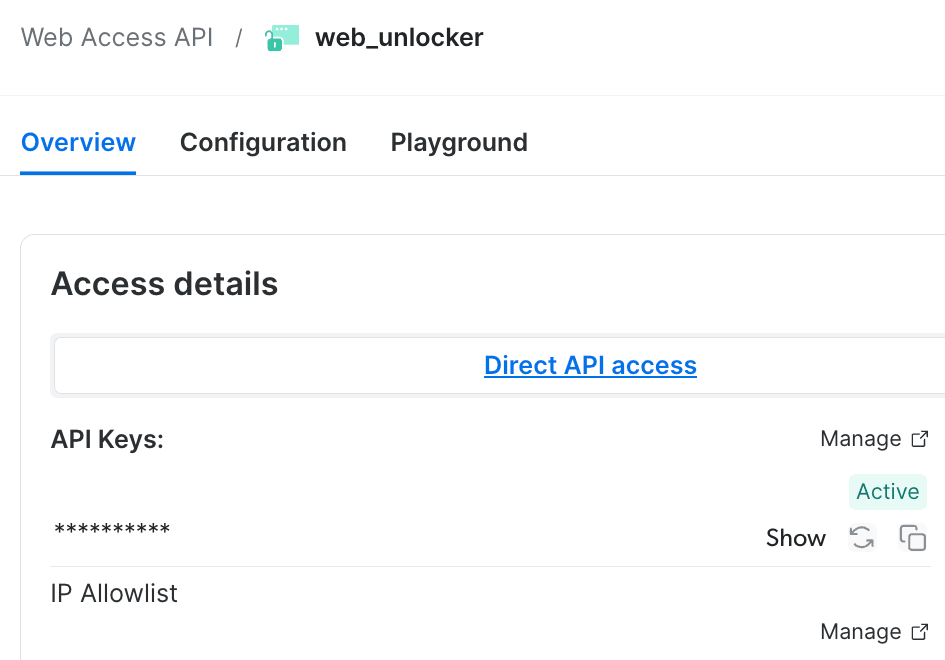
Le nom de la zone, ici web_unlocker, est en haut, et le bouton de copie sous API Keys copie votre clé.
Définissez les deux dans votre shell avant d’exécuter le script suivant :
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_UNLOCKER_ZONE="your-zone-name"
Pour router quote_summary(), price_history(), statement(), ou estimates() via Web Unlocker API, passez fetch_page_unlocker comme argument fetch. Enregistrez ce script sous unlocker_demo.py :
from price_history import price_history
from unlocker import fetch_page_unlocker

history, events = price_history("MSFT", fetch=fetch_page_unlocker)
print(
    f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
    f"to {history.index[-1]:%Y-%m-%d}"
)
Il a affiché le même historique que price_history.py :
10,213 daily bars from 1986-03-13 to 2026-09-25Une seule requête a retourné la page complète d’historique, et l’analyseur n’a nécessité aucune modification pour la lire. Le script par lots accepte la même fonction via collect(tickers, fetch=fetch_page_unlocker).
Notez ces 3 détails :
- Utilisez
"format": "json". La réponse contient alors le code de statut, les en-têtes, et le HTML complet de Yahoo dans un seul objet JSON. La fonction retourne le HTML depuis son champbody. - Encodez les caractères spéciaux.
page_url()encode déjà en pourcentage les symboles d’indices comme^GSPCen%5EGSPC, donc chaque URL qu’il construit est valide. - Ou utilisez notre SDK Python. Installez
brightdata-sdkavecpip install brightdata-sdk, et passezresponse_format="json"àscrape_url()pour obtenir le code de statut de Yahoo avec la page.
Chaque onglet est une requête distincte, et vous ne payez que pour les requêtes réussies.
Obtenir des enregistrements structurés depuis le Yahoo Finance Scraper API
Notre Yahoo Finance Scraper API retourne un enregistrement structuré par ticker, et les proxys, le déblocage, et les réessais sont intégrés. C’est un scraper prêt à l’emploi dans notre Web Scraper API. Un enregistrement combine les champs de résumé, le profil de l’entreprise, les principaux dirigeants, les finances annuelles, et les objectifs de prix des analystes, que la page produit du scraper liste champ par champ. Le panneau de contrôle affiche les modes synchrone et asynchrone du scraper et le point de terminaison que le code ci-dessous appelle :
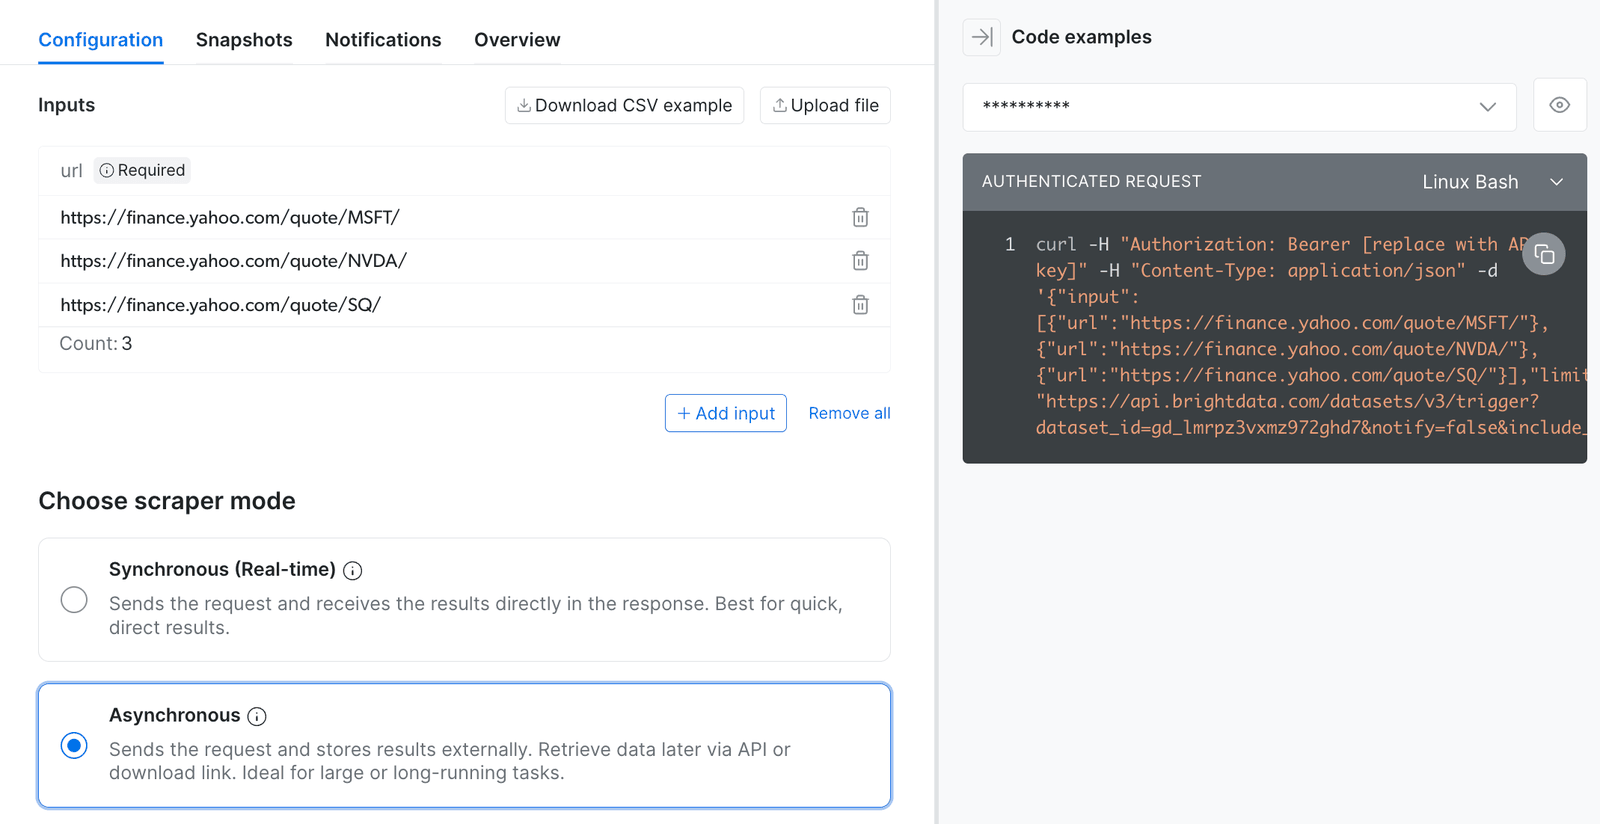
L’exemple curl du panneau utilise les mêmes URLs de cotation, point de terminaison de déclenchement, et ID de jeu de données que scraper_api.py, et le mode Asynchronous fonctionne mieux pour les tâches par lots planifiées.
Déclencher une tâche et télécharger les enregistrements
Enregistrez le script suivant sous scraper_api.py. Il déclenche une tâche pour une liste d’URLs, interroge sa progression, télécharge les enregistrements, et signale les symboles que Yahoo ne liste plus :
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_lmrpz3vxmz972ghd7"  # Yahoo Finance business information
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
# The API returns only these fields, so the list keeps input, error, and error_code.
FIELDS = (
    "input|error|error_code|stock_ticker|closing_price|"
    "market_cap|pe_ratio|currency|timestamp"
)


def job_status(snapshot_id: str) -> str:
    progress = requests.get(
        f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60
    )
    return progress.json()["status"]


def run_batch(urls: list[str], poll_seconds: int = 30) -> list[dict]:
    """Trigger one collection job, wait until it's ready, and return its records."""
    trigger = requests.post(
        f"{API}/trigger",
        params={
            "dataset_id": DATASET_ID,
            "include_errors": "true",
            "custom_output_fields": FIELDS,
        },
        headers=HEADERS,
        json={"input": [{"url": url} for url in urls]},
        timeout=60,
    )
    trigger.raise_for_status()
    snapshot_id = trigger.json()["snapshot_id"]

    while job_status(snapshot_id) != "ready":
        time.sleep(poll_seconds)

    records = requests.get(
        f"{API}/snapshot/{snapshot_id}",
        params={"format": "json"},
        headers=HEADERS,
        timeout=300,
    )
    records.raise_for_status()
    return records.json()


def collect_records(urls: list[str]) -> tuple[list[dict], dict[str, str]]:
    """Run one job and split its records into results and per-URL errors."""
    records = run_batch(list(dict.fromkeys(urls)))  # drop duplicate URLs
    done = [record for record in records if not record.get("error")]
    errors = {
        record["input"]["url"]: f'{record.get("error_code")}: {record["error"]}'
        for record in records
        if record.get("error")
    }
    return done, errors


if __name__ == "__main__":
    urls = [f"https://finance.yahoo.com/quote/{s}/" for s in ("MSFT", "NVDA", "SQ")]
    records, errors = collect_records(urls)
    for record in records:
        print(record)
    print("errors:", errors)
Il a affiché 2 enregistrements et une erreur pour SQ :
{'input': {'url': 'https://finance.yahoo.com/quote/MSFT/'}, 'stock_ticker': 'MSFT', 'closing_price': 516.17, 'market_cap': 3832843862016, 'pe_ratio': 28.739979, 'currency': 'USD', 'timestamp': '2026-09-27T16:15:44.789Z'}
{'input': {'url': 'https://finance.yahoo.com/quote/NVDA/'}, 'stock_ticker': 'NVDA', 'closing_price': 225.07, 'market_cap': 5434765213696, 'pe_ratio': 28.489874, 'currency': 'USD', 'timestamp': '2026-09-27T16:16:02.513Z'}
errors: {'https://finance.yahoo.com/quote/SQ/': 'dead_page: Target quote not found on lookup page'}
Le scraper a marqué SQ comme dead_page car Yahoo redirige SQ vers sa page de recherche, et fetch_page() lève SymbolNotFound dans le même cas.
Mettre en place un pipeline planifié
Exécutez le Scraper API comme une tâche par lots. Envoyez de nombreux tickers à chaque appel de déclenchement, puis interrogez le point de terminaison de progression ou attendez un webhook.
Le point de terminaison synchrone /scrape retourne les enregistrements directement dans sa réponse. Pour une tâche plus longue, le point de terminaison retourne plutôt un snapshot_id à interroger, comme le décrit la référence de l’API synchrone.
L’appel de déclenchement accepte quelques paramètres importants pour un pipeline planifié. La référence de l’API asynchrone les liste, et le panneau de contrôle offre les mêmes options sous Scraper settings :
- Rapport d’erreurs.
include_errors=trueajoute unerroret unerror_codeà toute entrée sans résultat, comme un symbole que Yahoo ne liste plus.collect_records()signale ces entrées par URL. - Champs de sortie.
custom_output_fieldsne conserve que les champs que vous listez, séparés par|, donc ajoutezinput,error, eterror_codepour conserver le rapport d’erreurs. - Limites d’enregistrements.
limit_per_inputlimite les enregistrements par entrée, etlimit_multiple_resultslimite les enregistrements par tâche. Les deux limites contrôlent le coût d’une recherche Discover by keyword. - Livraison et webhooks.
endpointlivre les enregistrements à votre URL de webhook.notify=trueenvoie une notification lorsque la tâche se termine, donc un planificateur n’a pas besoin d’interroger/progress. Passezuncompressed_webhook=truepour recevoir les charges utiles de webhook non compressées. Delivery settings dans le panneau peut aussi écrire les résultats vers Amazon S3, Google Cloud Storage, ou Snowflake, comme le décrit la documentation sur la livraison de données. - Planifications. Le panneau de contrôle peut exécuter la même collecte selon une planification récurrente, comme une actualisation quotidienne des tickers.
Sur une liste de tickers plus longue, le scraper a aussi signalé MMC, BK, et FI comme dead_page. Ces entreprises avaient changé leurs symboles en MRSH, BNY, et FISV. Vous ne payez que pour les enregistrements livrés avec succès.
Rechercher par mot-clé ou l’exécuter depuis la CLI
Le mode Discover by keyword trouve les cotations correspondant à un mot-clé à travers les bourses et types d’actifs. Une requête WIX a trouvé Wix.com, Wickes Group (WIX.L), et des contrats d’options WIX, et une requête MSFT a aussi trouvé la cotation torontoise de Microsoft et des ETF mono-action. Filtrez sur entity_type et stock_ticker pour ne garder que les cotations que vous souhaitez.
Le Yahoo Finance Scraper API s’exécute aussi depuis un terminal sous forme de brightdata pipelines yahoo_finance_business <url> dans le Bright Data CLI. Via l’outil web_data_yahoo_finance_business, un agent IA peut récupérer l’enregistrement pour une URL de cotation que vous lui donnez. L’outil s’exécute sur notre Yahoo Finance MCP Server, après avoir activé son groupe d’outils finance.
Choisir la bonne approche pour votre pipeline
Commencez par lire les pages de cotation gratuitement, et ajoutez Web Unlocker API pour les tâches serveur planifiées. Pour des enregistrements structurés, utilisez le Scraper API ou le Yahoo Finance Dataset :
| Option | Idéal pour | Vous gérez | Tarification |
|---|---|---|---|
| yfinance | Recherche personnelle, comme l’indique son README | Mises à jour de la bibliothèque, IP bloquées | Gratuit |
| Pages de cotation avec curl_cffi | Centaines de tickers par jour depuis le domicile ou un runner GitHub Actions | Analyseur, réessais, IP bloquées | Gratuit |
| Pages de cotation avec Web Unlocker API | Tâches serveur planifiées lisant n’importe quel onglet | Analyseur | Par requête réussie |
| Playwright avec Browser API | États trimestriels et autres données apparaissant après sélection d’un bouton | Script navigateur, analyseur | Par Go de trafic |
| Yahoo Finance Scraper API | Enregistrements analysés livrés selon une planification | Liste des champs de sortie | Par enregistrement livré |
| Yahoo Finance Dataset | Fichiers prêts à l’emploi d’entreprises, de fonds, et d’indices | Paramètres de livraison | Par enregistrement |
Pour estimer un budget mensuel, comptez 1 requête Web Unlocker API par onglet, par ticker, par actualisation. Le Yahoo Finance Scraper API nécessite 1 enregistrement par ticker par actualisation. Multipliez l’un ou l’autre volume par le prix actuel sur la page de tarification Web Unlocker API ou la page de tarification Web Scraper API.
Pour les états trimestriels, un script Playwright ou Puppeteer peut sélectionner le bouton Quarterly de l’onglet financials dans notre Browser API. Il exécute Chromium dans le cloud, et la résolution de CAPTCHA et le rendu JavaScript sont intégrés. Notre guide du scraping de sites dynamiques avec Python montre ce flux de travail étape par étape.
Notre Yahoo Finance Dataset regroupe le même type d’enregistrements que le Scraper API dans des fichiers JSON, NDJSON, CSV, ou Parquet prêts à l’emploi. Il inclut les actions, fonds communs de placement, indices, ETF, devises, et fonds du marché monétaire, donc filtrez sur entity_type pour ne garder que les classes d’actifs souhaitées.
Vous pouvez acheter un sous-ensemble avec seulement les points de données dont vous avez besoin et obtenir des mises à jour selon une planification quotidienne, hebdomadaire, mensuelle, ou personnalisée. Chaque livraison peut ne contenir que les enregistrements nouveaux ou mis à jour et aller directement vers Amazon S3, Google Cloud, Azure, Snowflake, ou SFTP. La page du jeu de données affiche le nombre actuel d’enregistrements et la tarification, et vous pouvez télécharger un fichier d’exemple en JSON ou CSV avant d’acheter.
Pour d’autres sources de données de marché, consultez nos guides sur le scraping de données financières et le scraping de Google Finance. Nos autres scrapers et jeux de données offrent plus de données boursières et d’autres résultats Yahoo :
- Le Stock Market Scraper collecte des données boursières depuis des sites tels que Yahoo Finance, Google Finance, et TradingView.
- Le Google Finance Scraper et le TradingView Scraper collectent les prix boursiers et les tendances de marché de ces 2 sites.
- Le Nasdaq Scraper collecte des données Nasdaq telles que le prix d’ouverture, le prix de clôture, et le volume d’actions.
- Le Stocktwits Scraper collecte les publications Stocktwits, le sentiment, et les symboles tendance.
- Le Financial Data Scraper API retourne des champs tels que le nom de l’entreprise, le ticker boursier, la bourse, et le prix de clôture.
- Le Stock Market Dataset, le Stock Prices Dataset, et le Financial Dataset fournissent des profils d’entreprises, des tickers boursiers, et des prix sous forme de fichiers prêts à l’emploi.
- Les Google Finance Datasets, les Historical Financial Data, et le Financial News Dataset fournissent des données Google Finance, des données financières historiques, et des actualités financières sous forme de fichiers prêts à l’emploi.
- Le Yahoo News API et le Yahoo Search API retournent les résultats Yahoo News et Yahoo Search.
Réflexions finales
Les pages de cotation de Yahoo Finance contiennent leurs propres réponses d’API en JSON, donc 1 requête par onglet retourne les données sans navigateur, cookie, ou crumb. Corrigez le client avant d’ajouter des délais, car les 429 de Yahoo sur les premières requêtes dépendaient de la négociation TLS et du User-Agent du client. Analysez les réponses intégrées, validez chaque page, comparez chaque nom avec votre liste de tickers, et convertissez les unités monétaires mineures dans l’analyseur.
Pour les tâches serveur planifiées, routez le même analyseur via Web Unlocker API, ou laissez le Yahoo Finance Scraper API retourner des enregistrements structurés. Nos crédits gratuits mensuels s’appliquent aux deux, donc vous pouvez essayer l’un ou l’autre avec votre propre liste de tickers.
FAQ
Existe-t-il une API officielle Yahoo Finance ?
Non. Yahoo indique avoir désactivé l’accès API aux données de cotation car ses fournisseurs de données “n’autorisent pas actuellement” la redistribution sous forme d’API. Les hôtes API internes utilisés par yfinance ne sont pas documentés et sont interdits dans robots.txt. Les pages de cotation de Yahoo intègrent les mêmes données en JSON.
yfinance est-il encore utilisable ?
Oui, depuis le domicile et 3 runners GitHub Actions, yfinance a récupéré l’historique quotidien complet de MSFT en moins de 1,5 seconde. Il utilise la négociation TLS Chrome de curl_cffi. Son README qualifie l’API Yahoo de “destinée à un usage personnel uniquement”. Des développeurs ont signalé des erreurs 401 et des échecs de récupération depuis certains hébergeurs cloud, donc testez-le depuis votre propre serveur.
Yahoo Finance bloque-t-il le web scraping ?
Oui, pour certains clients. Yahoo a bloqué le client requests par défaut de Python dès sa première requête. Avec la négociation TLS de Chrome, curl_cffi n’a obtenu aucun 429 sur une connexion résidentielle ni sur 3 runners GitHub Actions. Pour les tâches planifiées, le Web Unlocker API de Bright Data récupère les mêmes pages avec rotation d’IP et réessais automatiques.
Peut-on télécharger des données depuis Yahoo Finance ?
Oui, mais la page d’aide de Yahoo limite le téléchargement CSV aux abonnés payants de Yahoo Finance. En code, une seule requête vers l’onglet historique a retourné chaque barre quotidienne de MSFT depuis 1986. Pour des fichiers en masse, le Yahoo Finance Dataset de Bright Data livre des enregistrements pour des entreprises, fonds, et indices selon la planification de votre choix.
L’API Yahoo Finance est-elle gratuite ?
Pas officiellement. Les points de terminaison internes de Yahoo ne coûtent rien à appeler, mais ils ne sont pas documentés et sont interdits aux robots d’exploration. La page d’aide de Yahoo limite les téléchargements CSV aux abonnés payants. Le Yahoo Finance Scraper API de Bright Data retourne des enregistrements structurés, et les nouveaux comptes reçoivent des crédits gratuits mensuels pour le tester.