Le scraping web traditionnel implique souvent d’écrire du code complexe et chronophage adapté à des mises en page de sites spécifiques, qui peut facilement se casser lorsque les sites changent. ScrapeGraphAI utilise de grands modèles de langage (LLM) pour extraire des informations et les interpréter comme le ferait un humain, vous permettant de vous concentrer sur les données plutôt que sur la mise en page. L’intégration des LLM avec ScrapeGraphAI améliore l’extraction de données, automatise l’agrégation de contenu et permet une analyse en temps réel.
Dans cet article, vous apprendrez à utiliser ScrapeGraphAI pour le scraping web. Mais avant cela, laissez-nous vous présenter les solutions de Bright Data qui peuvent vous faire gagner du temps et de l’argent.
Les solutions de scraping web de Bright Data
Bright Data propose une suite complète de solutions de scraping web, optimisées pour une extraction de données efficace, évolutive et conforme :
- Web Scraper API
- Jeux de données prêts à l’emploi
- Jeux de données personnalisés
Ces solutions permettent une collecte de données rapide, précise et évolutive, parfaite pour des projets de toute envergure, des applications à petite échelle aux besoins au niveau de l’entreprise.
Mise en œuvre du scraping web LLM avec ScrapeGraphAI
Avant de commencer ce tutoriel, vous avez besoin des prérequis suivants :
- Python 3.x installé.
- Un co mpte OpenAI. Ce tutoriel utilise les LLM d’OpenAI pour scraper des données avec ScrapeGraphAI. Bien qu’il soit possible d’utiliser d’autres modèles, comme Anthropic, Google, ou des modèles open source, comme Llama et Mistral AI, ce tutoriel utilise GPT-4 en raison de sa popularité et de sa facilité de configuration.
Si vous n’êtes pas familier avec le scraping web en Python, consultez ce tutoriel de scraping web pour commencer.
Configurez votre environnement
La première chose à faire est de créer un environnement virtuel. Ouvrez votre terminal et naviguez vers votre répertoire de projet :
python -m venv venv
Ensuite, activez l’environnement virtuel. Sur macOS et Linux, vous pouvez le faire avec la commande suivante :
source venv/bin/activate
Sur Windows, vous pouvez utiliser cette commande :
venvScriptsactivate
Une fois que vous avez activé l’environnement virtuel, vous devez installer ScrapeGraphAI et ses dépendances :
pip install scrapegraphai
playwright install
La commande playwright install configure les navigateurs nécessaires pour Chromium, Firefox et WebKit.
Pour gérer les variables d’environnement de manière sécurisée, installez python-dotenv :
pip install python-dotenv
Il est important de protéger les informations sensibles, comme les clés API. Il est recommandé de stocker les variables d’environnement dans un fichier .env pour le séparer des fichiers de code.
Créez un nouveau fichier nommé .env dans le répertoire du projet et ajoutez la ligne suivante en spécifiant votre clé OpenAI :
OPENAI_API_KEY="your-openai-api-key"
Ce fichier ne doit pas être soumis à des systèmes de contrôle de version comme Git. Pour éviter cela, ajoutez .env à votre fichier .gitignore.
Scraper des données avec ScrapeGraphAI
Dans ce tutoriel, vous commencerez par scraper des données de produits sur Books to Scrape, un site web de démonstration spécifiquement conçu pour pratiquer les techniques de scraping web. Ce site imite une librairie en ligne, proposant une variété de livres dans différents genres, avec des prix, des évaluations et un statut de disponibilité :
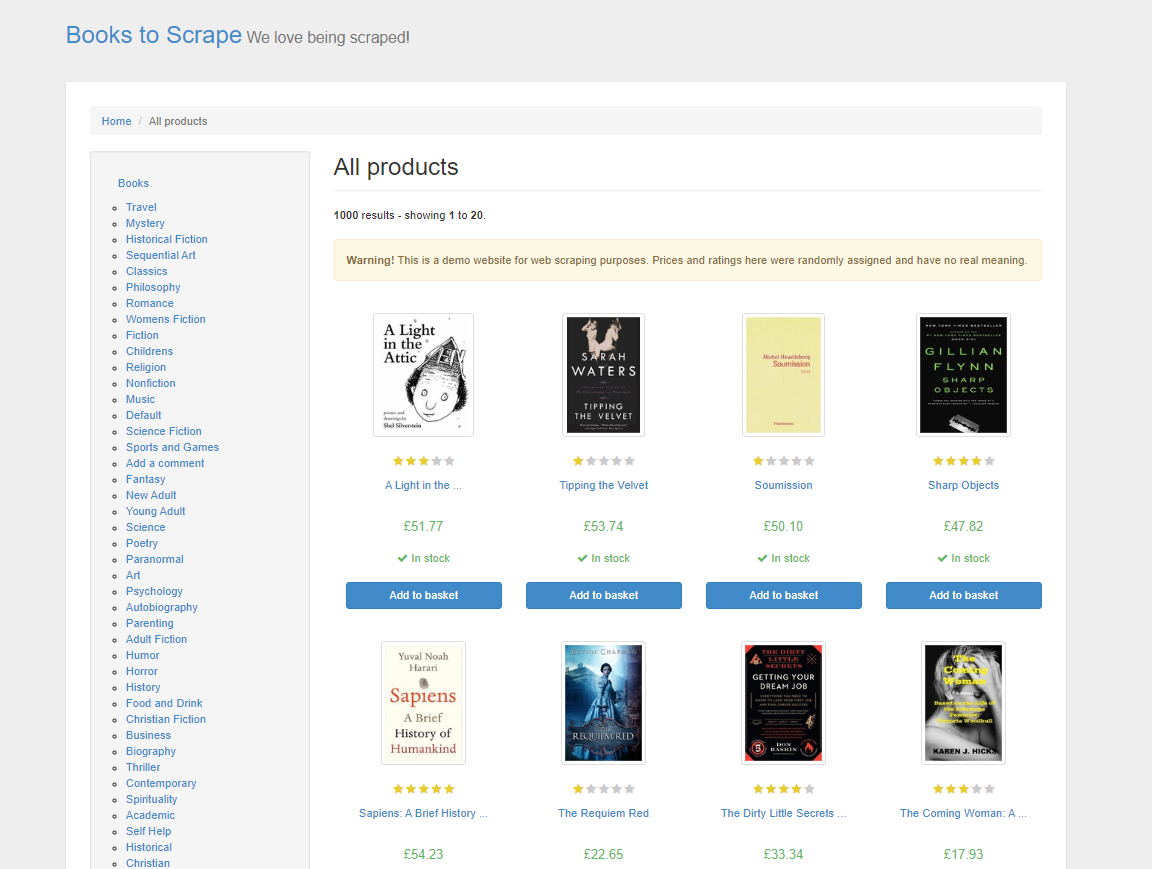
Dans le scraping web HTML traditionnel, vous devriez analyser le HTML de la page, en inspectant manuellement les éléments et les balises pour localiser les données que vous souhaitez. Ce processus est chronophage et nécessite une solide compréhension des structures web. Avec ScrapeGraphAI, vous n’avez besoin de spécifier les données souhaitées qu’à l’aide d’une invite, et le LLM est suffisamment intelligent pour les extraire.
ScrapeGraphAI propose différents types de graphes pour différents besoins de scraping. Ces graphes définissent comment le processus de scraping est structuré et ce qu’il vise à accomplir. Voici un bref aperçu de quelques-uns des différents graphes :
- SmartScraperGraph est un scraper d’une seule page où vous fournissez une invite et une URL ou un fichier local. Il utilise un LLM pour extraire les informations que vous spécifiez.
- SearchGraph est un scraper multi-pages qui extrait des informations des résultats de moteurs de recherche en fonction de votre invite.
- SpeechGraph étend SmartScraperGraph en ajoutant une fonction de synthèse vocale, générant un fichier audio du contenu extrait.
- ScriptCreatorGraph prend une invite et une URL et, au lieu de générer des résultats, produit un script Python capable de scraper l’URL donnée.
Si ces graphes ne correspondent pas exactement à vos besoins, ScrapeGraphAI vous permet également de créer des graphes personnalisés en combinant différents nœuds et en adaptant le processus de scraping à vos exigences spécifiques.
En plus de choisir le bon type de graphe, vous devez également configurer correctement votre scraper, en particulier en ce qui concerne l’invite et la sélection du modèle. L’invite guide le LLM pour comprendre exactement quelles données extraire—assurez-vous qu’elle soit claire et explicite. De plus, le choix du bon modèle LLM détermine la qualité avec laquelle le scraper traite et interprète le contenu du site web. Vous pouvez également configurer d’autres options comme les proxies pour assurer un scraping plus fluide de contenu géorestreint et le mode headless pour garder le processus efficace et rapide. Une configuration appropriée détermine finalement la précision et la pertinence des données scrapées.
Écrivez le code du scraper
Pour écrire le code du scraper, créez un nouveau fichier nommé app.py et ajoutez-y les lignes de code suivantes :
from dotenv import load_dotenv
import os
from scrapegraphai.graphs import SmartScraperGraph

# Load environment variables from .env file
load_dotenv()

# Access the OpenAI API key
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')

# Configuration for ScrapeGraphAI
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 }
}

# Define the prompt and source
prompt = "Extract the title, price and availability of all books on this page."
source = "http://books.toscrape.com/"

# Create the scraper graph
smart_scraper_graph = SmartScraperGraph(
 prompt=prompt,
 source=source,
 config=graph_config
)

# Run the scraper
result = smart_scraper_graph.run()

# Output the results
print(result)
Ce code importe des modules essentiels comme os et dotenv pour gérer les variables d’environnement et la classe SmartScraperGraph de ScrapeGraphAI, qui est utilisée pour le scraping. Il charge ensuite les variables d’environnement via dotenv pour garder les données sensibles comme les clés API sécurisées. Ensuite, le code crée une configuration LLM pour le scraping en spécifiant quel modèle utiliser et la clé API. Cette configuration, ainsi que l’URL du site et l’invite de scraping, est utilisée pour définir votre SmartScraperGraph, qui est exécuté à l’aide de la méthode run(), déclenchant le processus de collecte des données spécifiées.
Pour exécuter ce code, ouvrez votre terminal et lancez python app.py. Votre résultat devrait ressembler à ceci :
{
    "books": [
        {
            "title": "A Light in the Attic",
            "price": "£51.77",
            "availability": "In stock"
        },
        {
            "title": "Tipping the Velvet",
            "price": "£53.74",
            "availability": "In stock"
        }, ...
       ]
}
Remarque : Si vous rencontrez des problèmes lors de l’exécution du code, vous devrez peut-être installer manuellement le package
grpcio, qui est une dépendance sous-jacente de ScrapeGraphAI. Vous pouvez le faire avec la commande suivante :
pip install grpcio
Bien que ScrapeGraphAI facilite la partie extraction de données du scraping web, il existe encore des défis courants, comme les CAPTCHA et les blocages d’IP, que vous devez savoir gérer.
Pour imiter un comportement de navigation, vous pouvez implémenter des délais chronométrés dans votre code. Vous pouvez également utiliser des proxies rotatifs pour éviter la détection. De plus, des services de résolution de CAPTCHA comme le solveur de CAPTCHA de Bright Data ou Anti Captcha peuvent être intégrés à votre scraper pour résoudre automatiquement les CAPTCHA à votre place.
Veuillez noter : Assurez-vous toujours d’être conforme aux conditions d’utilisation d’un site web. Le scraping pour un usage personnel est souvent acceptable, mais la redistribution des données peut avoir des implications juridiques.
Utilisation de proxies avec ScrapeGraphAI
ScrapeGraphAI vous permet de configurer un service proxy pour éviter le blocage d’IP et accéder au contenu géorestreint. Vous pouvez utiliser un service proxy gratuit ou configurer votre propre serveur proxy personnalisé.
Pour utiliser un service proxy gratuit, ajoutez ce qui suit à votre graph_config :
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "broker",
            "criteria": {
                "anonymous": True,
                "secure": True,
                "countryset": {"US"},
                "timeout": 10.0,
                "max_tries": 3
 },
 },
 }
}
Cette configuration indique à ScrapeGraphAI d’utiliser un service proxy gratuit correspondant à vos critères.
Pour utiliser un serveur proxy personnalisé d’un fournisseur comme Bright Data, modifiez votre graph_config comme suit, en insérant l’URL de votre serveur, votre nom d’utilisateur et votre mot de passe :
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "http://your_proxy_server:port",
            "username": "your_username",
            "password": "your_password",
 },
 }
}
L’utilisation d’un serveur proxy personnalisé offre plusieurs avantages, en particulier pour le scraping web à grande échelle. Il vous offre un contrôle sur l’emplacement du proxy, vous permettant de scraper du contenu géorestreint. De plus, les proxies personnalisés sont plus fiables et sécurisés par rapport aux proxies gratuits, réduisant les risques de blocage de votre IP ou de limitation de débit.
Nettoyer et préparer les données
Après avoir scrapé des données, vous devez les nettoyer et les prétraiter, surtout si vous prévoyez de les intégrer à un modèle d’IA. Des données propres garantissent que vos modèles apprennent à partir d’informations précises et cohérentes, ce qui a un impact direct sur leurs performances et leur fiabilité. Le nettoyage des données implique généralement de gérer les valeurs manquantes, de corriger les types de données, de normaliser le texte et de supprimer les doublons.
Voici un exemple de la façon dont vous pouvez nettoyer les données que vous avez scrapées précédemment en utilisant pandas :
import pandas as pd

# Convert the result to a DataFrame
df = pd.DataFrame(result["books"])

# Remove currency symbols and convert prices to float
df['price'] = df['price'].str.replace('£', '').astype(float)

# Standardize availability text
df['availability'] = df['availability'].str.strip().str.lower()

# Handle missing values if any
df.dropna(inplace=True)

# Preview the cleaned data
print(df.head())
Ce code nettoie les données en supprimant le symbole monétaire des prix des livres, standardise le statut de disponibilité en le convertissant en minuscules, et gère les valeurs manquantes éventuelles.
Avant d’exécuter le code, vous devez installer la bibliothèque pandas pour la manipulation de données :
pip install pandas
Pour exécuter le code, ouvrez votre terminal et lancez python app.py. Votre résultat devrait ressembler à ceci :
                                   title  price availability
0                   A Light in the Attic  51.77     in stock
1                     Tipping the Velvet  53.74     in stock
2                             Soumission  50.10     in stock
3                          Sharp Objects  47.82     in stock
4  Sapiens: A Brief History of Humankind  54.23     in stock
Ceci n’est qu’un exemple de la façon dont vous pouvez nettoyer des données scrapées—le processus de nettoyage varie selon les données et le cas d’usage du LLM en cours d’entraînement. Lorsque vous nettoyez vos données, vous vous assurez que vos modèles de langage reçoivent une entrée bien structurée et significative. Si vous souhaitez en savoir plus sur l’utilisation des données pour des projets d’IA, consultez Données pour l’IA.
Tout le code de ce tutoriel est disponible dans ce dépôt GitHub.
Conclusion
ScrapeGraphAI utilise les LLM pour fournir une approche adaptative du scraping web, s’ajustant aux changements de structures de sites web et extrayant les données intelligemment. Cependant, l’extension du scraping web s’accompagne de défis, comme le blocage d’IP, la résolution de CAPTCHA et le maintien de la conformité légale.
Pour aider à surmonter ces défis, Bright Data fournit une suite complète de solutions de scraping web adaptées aux projets d’IA et d’apprentissage automatique. Cela inclut les API Web Scraper de Bright Data, les services de proxy, et le Scraping sans serveur. Au-delà de cela, Bright Data propose également des jeux de données prêts à l’emploi remplis de données provenant de plus d’une centaine de sites web populaires.
Commencez dès aujourd’hui !