DSPy est un framework Python qui améliore les programmes de modèles de langage avec des données. DSPy charge les outils d’agent depuis les serveurs Model Context Protocol (MCP). Avec le serveur MCP de Bright Data, un agent recherche sur Google et lit les pages en Markdown, tandis que le serveur gère la protection anti-bot.
Le modèle de tutoriel MCP de DSPy fonctionne bien pour une seule exécution d’agent. L’évaluateur de DSPy et GEPA, son optimiseur de prompt, exécutent les agents sur des threads de travail, où les appels d’outils asynchrones échouaient silencieusement lors des tests et l’agent répondait de mémoire.
Ce guide vous montre comment construire cet agent, exécuter ses outils en parallèle, et mesurer ce que les données web apportent.
En bref
- Les données web ont amélioré la précision. Avec le serveur MCP de Bright Data,
gpt-5.4-minia répondu correctement à 54-58 des 60 questions, contre 14 auparavant, et à toutes les 8 questions sur des événements postérieurs à sa date limite de connaissance, contre 0. - Choisissez 2 outils et ajoutez un callback d’élicitation. Moins d’outils gardent les prompts compacts. Le callback approuve les pages marquées comme injection de prompt possible.
- Donnez des outils synchrones aux exécutions threadées. Les outils asynchrones échouaient silencieusement ou se bloquaient dans
dspy.Evaluateet GEPA. Une boucle d’événements en arrière-plan a corrigé les deux. - Corrigez d’abord les outils. GEPA copiait les réponses d’entraînement dans ses instructions sans augmenter le score. Sur 6 questions à pages longues, un argument
finda divisé par deux les tokens de prompt.
Ce dont vous avez besoin
L’agent se connecte en HTTP au Web MCP de Bright Data, le serveur MCP hébergé de Bright Data, donc Python est le seul environnement d’exécution à installer. Le serveur fonctionne sur l’API Web Unlocker, qui gère la rotation de proxy et la protection anti-bot pour l’agent. Pour le code, le dépôt GitHub compagnon contient tous les scripts et fichiers de données, y compris evaluate.py et post_cutoff_questions.csv pour les étapes d’évaluation. Vous avez besoin de :
- Python 3.10 ou ultérieur, et uv pour installer les packages
- Un compte Bright Data gratuit et sa clé API depuis les Paramètres du compte
- Une clé API OpenAI, ou une clé pour un autre fournisseur que
dspy.LMprend en charge avec l’appel d’outils
Copiez la clé Bright Data depuis le tableau Clés API de l’onglet Utilisateurs et clés API :
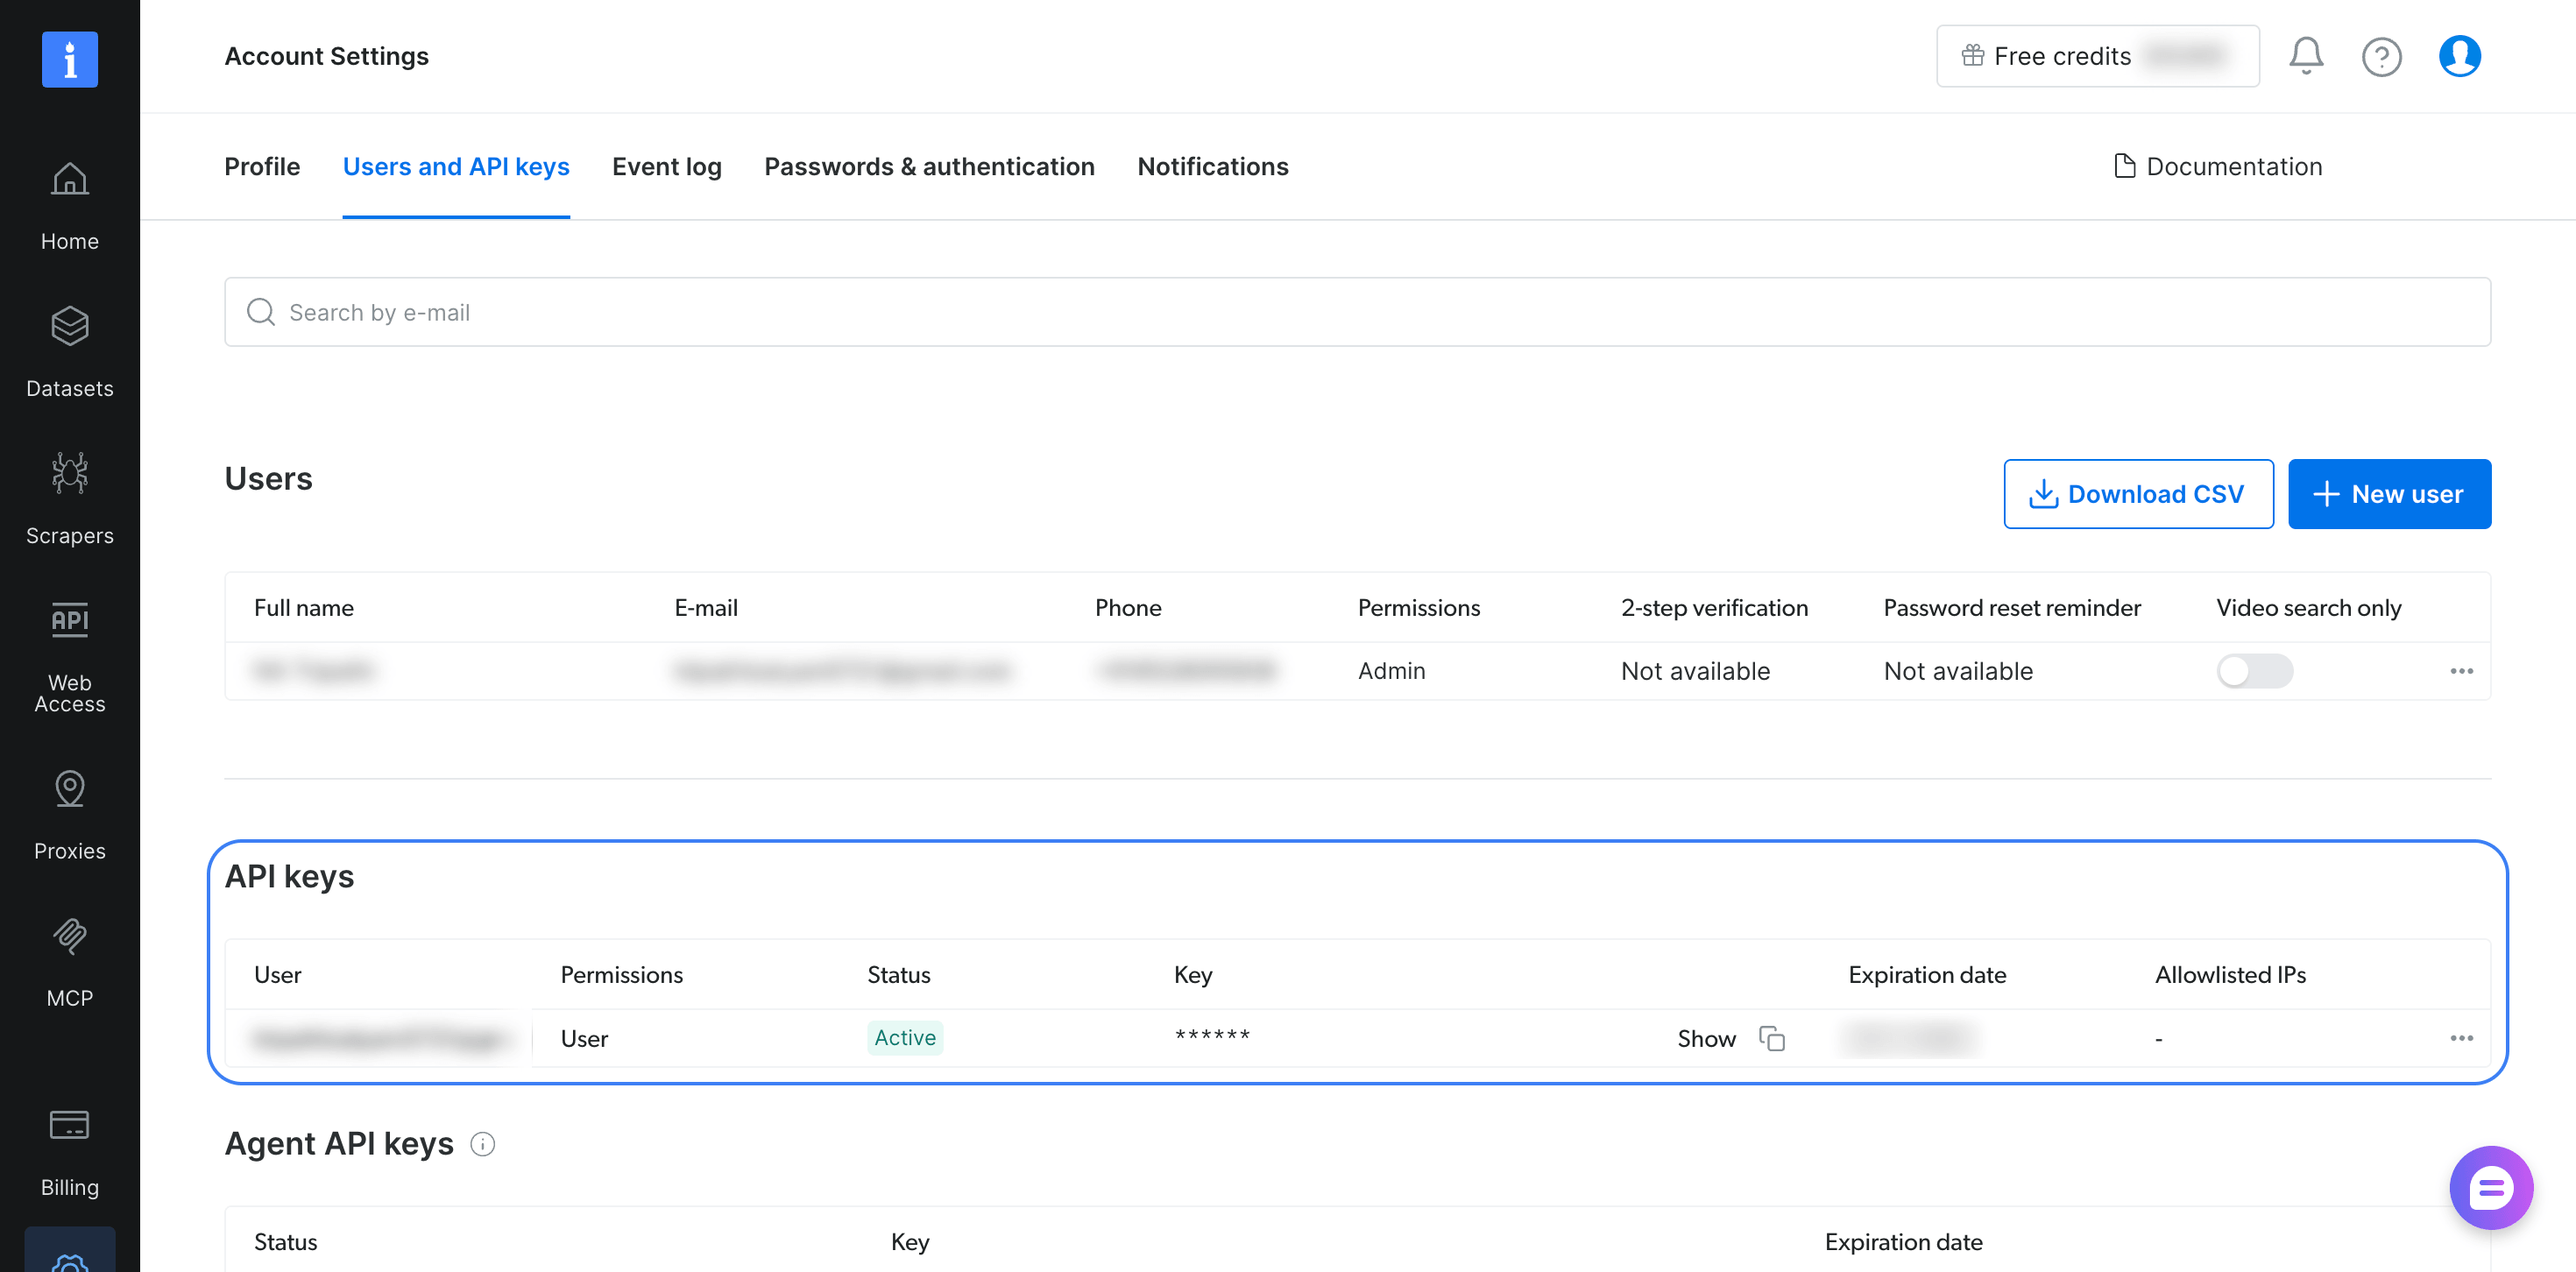
La même clé fonctionne avec le serveur hébergé et le serveur local.
Clonez le dépôt, installez DSPy avec son extra MCP, épinglé aux versions testées, et exportez les deux clés :
git clone https://github.com/triposat/dspy-bright-data-research-agent && cd dspy-bright-data-research-agent
uv venv && source .venv/bin/activate
uv pip install "dspy[mcp]==3.4.1" "mcp==2.3.0"
export BRIGHTDATA_API_TOKEN="votre-cle-api-bright-data"
export OPENAI_API_KEY="votre-cle-api-openai"
La commande épingle le SDK Python MCP à la version testée 2.3.0, car l’extra dspy[mcp] de DSPy 3.4.1 n’épingle pas la version du SDK. Vous pouvez commencer avec des requêtes mensuelles gratuites, et la page de tarification du serveur MCP liste l’allocation actuelle.
Connecter le serveur MCP de Bright Data à DSPy
dspy.Tool.from_mcp_tool convertit chaque outil qu’un serveur MCP liste en un outil DSPy, afin que l’agent voie le nom, la description et le schéma d’arguments de chaque outil. Le script ci-dessous, agent.py dans le dépôt, se connecte au serveur MCP hébergé de Bright Data et charge ses outils de recherche et d’extraction. Il demande ensuite des informations sur un événement postérieur à la date limite de connaissance du modèle :
import asyncio
import os

import dspy
from mcp import types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

dspy.configure(
    lm=dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000),
    adapter=dspy.ChatAdapter(use_native_function_calling=True),
)

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


async def approve_page(context, params):
    # Le serveur demande avant de retourner une page qui contient des
    # instructions de configuration MCP. Les outils de cet agent ne font
    # que lire le web, donc retournez-la.
    return types.ElicitResult(action="accept", content={"return_content": True})


class ResearchQuestion(dspy.Signature):
    """Répondre à la question avec des faits trouvés sur le web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="une réponse courte et directe")
    sources: list[str] = dspy.OutputField(desc="URLs des pages qui soutiennent la réponse")


async def main():
    async with create_mcp_http_client(headers=HEADERS) as http:
        transport = streamable_http_client(SERVER_URL, http_client=http)
        async with Client(transport, elicitation_callback=approve_page) as client:
            mcp_tools = (await client.list_tools()).tools
            tools = [dspy.Tool.from_mcp_tool(client, t) for t in mcp_tools]
            agent = dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)

            question = "Qui a gagné la finale de la Coupe du monde FIFA 2026, et quel était le score ?"
            pred = await agent.acall(question=question)
            for event in pred.history.messages:
                for call in getattr(event.get("tool_calls"), "tool_calls", []):
                    print(f"{call.name}: {call.args}")
            print("\nRéponse :", pred.answer)
            print("Sources :", pred.sources)


asyncio.run(main())
L’exécution de python agent.py a affiché 2 recherches, puis l’appel final submit :
search_engine: {'query': '2026 FIFA World Cup final winner score', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
search_engine: {'query': '2026 FIFA World Cup final winner score site:en.wikipedia.org OR site:fifa.com', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
submit: {'answer': 'L'Espagne a gagné la finale de la Coupe du monde FIFA 2026, battant l'Argentine 1–0 après prolongation.', 'sources': ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']}

Réponse : L'Espagne a gagné la finale de la Coupe du monde FIFA 2026, battant l'Argentine 1–0 après prolongation.
Sources : ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']
Sans outils, gpt-5.4-mini a répondu que la finale de la Coupe du monde 2026 était postérieure à sa date limite de connaissance.
Le script est basé sur le tutoriel MCP de DSPy, qui utilise un serveur de démonstration local, et ajoute 3 paramètres pour le serveur hébergé.
Envoyez la clé API dans un en-tête. create_mcp_http_client envoie la clé comme en-tête Authorization sur chaque requête, donc la clé n’apparaît pas dans les URLs, que les proxies et les journaux enregistrent.
Choisissez les outils dont l’agent a besoin. Le serveur MCP de Bright Data propose des outils pour la recherche, l’extraction, les tâches par lots, l’automatisation de navigateur, et des scrapers préconstruits qui retournent du JSON structuré pour des sites comme Amazon et LinkedIn. Le paramètre d’URL tools sélectionne ceux que l’agent voit, et la référence des outils du serveur MCP liste chaque nom, comme search_engine_batch et scraping_browser_navigate. Le schéma de chaque outil sélectionné est envoyé à chaque appel de modèle, donc cet agent sélectionne seulement search_engine et scrape_as_markdown pour garder le prompt compact.
Répondez aux demandes d’élicitation du serveur. Le serveur MCP de Bright Data inclut une protection contre l’injection de prompt. Quand une page extraite contient des instructions pour modifier une configuration MCP, le serveur demande au client de confirmer via l’élicitation MCP avant de retourner la page. Passez un callback d’élicitation à Client avec l’argument elicitation_callback afin que le client DSPy puisse répondre.
approve_page approuve chaque demande car cet agent ne fait que lire le web. Pour un agent qui peut écrire des fichiers ou modifier sa propre configuration, envoyez la demande à une personne pour approbation.
Pour exécuter le serveur localement à la place, installez Node.js et passez StdioServerParameters(command="npx", args=["-y", "@brightdata/mcp@latest"], env=...) au même Client, avec API_TOKEN et TOOLS dans env. Avec @latest, npx récupère la version vers laquelle pointe le tag latest à chaque démarrage. Pour des évaluations reproductibles, remplacez-le par la version que vous avez testée depuis les versions de Bright Data MCP.
Dans un notebook Jupyter, remplacez asyncio.run(main()) par await main(), car Jupyter exécute déjà une boucle d’événements.
Le script utilise dspy.ReActV2, que la documentation DSPy ReAct liste comme l’implémentation que dspy.ReAct utilise à partir de DSPy 3.5, le nom ReActV2 étant supprimé dans la 3.6. ReActV2 retourne history au lieu de trajectory et termine avec un outil submit. Lorsque vous effectuez la mise à niveau, remplacez dspy.ReActV2 par dspy.ReAct et relancez votre évaluation.
Le même serveur fonctionne aussi avec d’autres frameworks d’agents, comme AutoGen, LangGraph, et Pydantic AI.
Exécuter les outils MCP de DSPy avec des threads et GEPA
Dans DSPy 3.4.1, dspy.Evaluate exécute votre programme de manière synchrone sur des threads de travail, et GEPA l’utilise pour évaluer chaque instruction candidate. Les outils de from_mcp_tool sont des fonctions asynchrones liées à la boucle d’événements qui a ouvert la session MCP. Lors des tests, les appeler depuis des threads de travail synchrones a échoué de 2 façons faciles à manquer.
Avec les outils chargés comme dans le tutoriel MCP de DSPy, Evaluate s’est terminé sans exception. Chaque appel d’outil a échoué avant d’atteindre le serveur, et Python a seulement affiché un avertissement qu’une coroutine n’a jamais été attendue. L’agent répondait de mémoire, et Evaluate rapportait quand même un score. Avec le paramètre allow_tool_async_sync_conversion de DSPy activé, l’exécution se bloquait et attendait encore 9 minutes plus tard.
La solution maintient une seule session MCP ouverte sur une boucle d’événements en arrière-plan et donne à DSPy des fonctions synchrones qui envoient chaque appel à cette boucle :
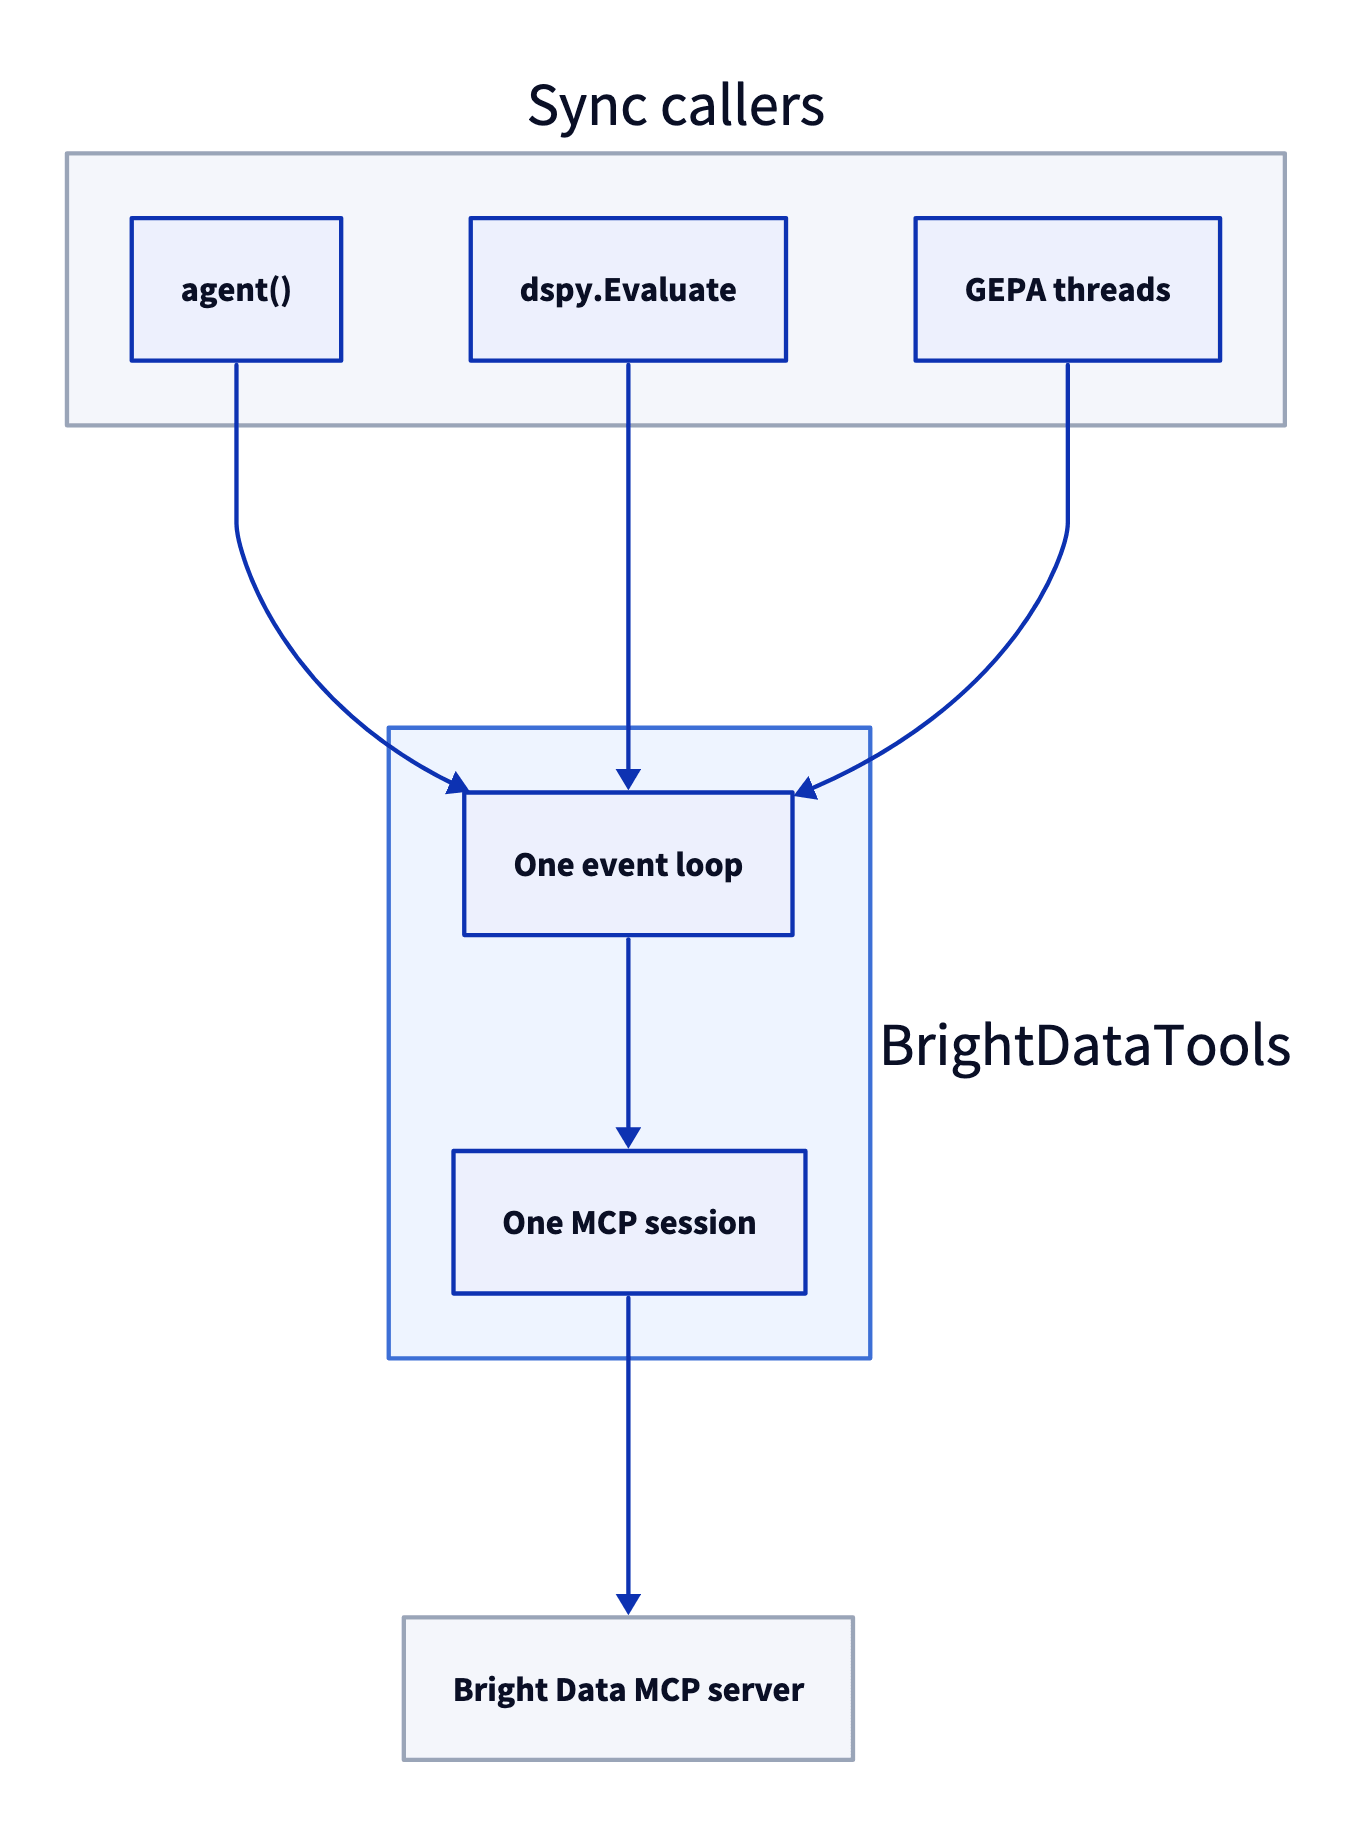
Chaque appel synchrone est envoyé à la boucle avec run_coroutine_threadsafe, donc seule la boucle d’événements qui a ouvert la session MCP utilise cette session.
La classe se trouve dans brightdata_tools.py, le module que les scripts d’évaluation et d’optimisation importent :
import asyncio
import json
import os
import re
import threading
from urllib.parse import urlparse

import dspy
from mcp import StdioServerParameters, types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
# Le serveur MCP de Bright Data enveloppe les résultats dans un avis de sécurité et deux marqueurs
WRAPPED = re.compile(r"(=====UNTRUSTED_\w+_BEGIN=====\n)(.*)(\n=====UNTRUSTED_\w+_END=====)", re.S)


async def approve_page(context, params):
    # Outils en lecture seule, donc les pages avec du texte de configuration MCP sont retournées comme données
    return types.ElicitResult(action="accept", content={"return_content": True})


class BrightDataTools:
    """Une session MCP sur une boucle d'événements en arrière-plan, exposée comme dspy.Tools synchrones."""

    def __init__(self, country="us", max_chars=20_000, retries=2,
                 blocked_domains=(), timeout=180, cache=False, remote=True):
        self.country = country
        self.max_chars = max_chars
        self.retries = retries
        self.blocked = tuple(blocked_domains)
        self.timeout = timeout
        self.cache = {}  # pages toujours, recherches aussi quand cache=True
        self.keep_all = cache  # réutiliser les résultats de recherche pendant l'optimisation
        self.lock = threading.Lock()
        self.stats = {"calls": 0, "sent": 0, "errors": 0}
        self.error = None  # pourquoi la session MCP n'a pas démarré ou s'est arrêtée
        self.remote = remote
        self.loop = asyncio.new_event_loop()
        self.ready = threading.Event()
        self.thread = threading.Thread(target=self.loop.run_until_complete,
                                       args=(self._serve(),), daemon=True)
        self.thread.start()
        self.ready.wait()
        if self.error:
            raise RuntimeError("Impossible de se connecter au serveur MCP") from self.error

    async def _serve(self):
        try:
            await self._connect()
        except Exception as e:  # le signaler au lieu d'attendre indéfiniment
            self.error = e
        finally:
            self.ready.set()

    async def _connect(self):
        token = os.environ["BRIGHTDATA_API_TOKEN"]
        if self.remote:  # serveur hébergé via HTTP streamable
            async with create_mcp_http_client(headers={"Authorization": f"Bearer {token}"}) as http:
                async with Client(streamable_http_client(SERVER_URL, http_client=http),
                                  elicitation_callback=approve_page) as client:
                    await self._hold(client)
        else:  # serveur local, dernière version
            local = StdioServerParameters(
                command="npx", args=["-y", "@brightdata/mcp@latest"],
                env={"API_TOKEN": token, "TOOLS": "search_engine,scrape_as_markdown",
                     "PATH": os.environ["PATH"]})
            async with Client(local, elicitation_callback=approve_page) as client:
                await self._hold(client)

    async def _hold(self, client):
        self.client = client
        self.mcp_tools = (await client.list_tools()).tools
        self.stop = asyncio.Event()
        self.ready.set()
        await self.stop.wait()

    def close(self):
        self.loop.call_soon_threadsafe(self.stop.set)
        self.thread.join(timeout=30)  # laisser la session se fermer proprement

    def _is_blocked(self, url):
        host = urlparse(url).netloc.lower()
        return any(host == d or host.endswith("." + d) for d in self.blocked)

    def call(self, name, args):
        start = int(args.pop("start", 0) or 0)  # où reprendre une page longue
        find = args.pop("find", "") or ""  # expression à rechercher dans une page longue
        if name == "search_engine":
            args = {**args, "geo_location": self.country}
        if name == "scrape_as_markdown" and self._is_blocked(args.get("url", "")):
            return "Ce domaine est exclu pour cette tâche. Utilisez une autre source."
        key = (name, json.dumps(args, sort_keys=True))
        with self.lock:
            self.stats["calls"] += 1
            text = self.cache.get(key)
        if text is None:
            try:
                text = self._send(name, args)
            except Exception:
                with self.lock:
                    self.stats["errors"] += 1  # l'agent voit une erreur, pas une page
                raise
            with self.lock:
                self.stats["sent"] += 1
                if self.keep_all or name == "scrape_as_markdown":
                    self.cache[key] = text  # les pages restent en cache, donc la lecture suivante est gratuite
        wrapped = WRAPPED.search(text)
        head, body, tail = (text[:wrapped.start(2)], wrapped.group(2), text[wrapped.end(2):]
                            ) if wrapped else ("", text, "")
        if name == "search_engine" and self.blocked:
            data = json.loads(body)
            data["organic"] = [r for r in data.get("organic", [])
                               if not self._is_blocked(r["link"])]
            body = json.dumps(data, indent=1)
        if find:
            spans = [(max(0, m.start() - 1500), m.end() + 1500)
                     for m in re.finditer(re.escape(find), body, re.I)][:6]
            body = ("\n...\n".join(body[a:b] for a, b in spans)
                    or f"[{find!r} introuvable dans la page de {len(body)} caractères]")
        end = start + self.max_chars
        if len(body) > end:
            body = (body[start:end] + f"\n[affichage des caractères {start} à {end} sur {len(body)}. "
                    f"Rappelez {name} avec start={end} pour continuer la lecture, ou avec "
                    "find='un mot ou une expression' pour obtenir les passages correspondants de la page entière]")
        elif start:
            body = body[start:] + f"\n[fin de page : caractères {start} à {len(body)}]"
        return head + body + tail

    def _send(self, name, args):
        if self.error or not self.thread.is_alive():
            raise RuntimeError("La session MCP est fermée") from self.error
        for _ in range(self.retries + 1):
            future = asyncio.run_coroutine_threadsafe(
                self.client.call_tool(name, args), self.loop)
            try:
                result = future.result(self.timeout)
            finally:
                future.cancel()  # un appel en timeout s'arrête au lieu de continuer
            text = "\n".join(c.text for c in result.content if hasattr(c, "text"))
            wrapped = WRAPPED.search(text)
            body = wrapped.group(2) if wrapped else text
            if not result.is_error and body.strip():
                return text
        raise RuntimeError(text[:500] or "résultat vide")

    def tools(self):
        out = []
        for t in self.mcp_tools:
            spec = dspy.Tool.from_mcp_tool(self.client, t)  # nom, description, args
            args, types, desc = dict(spec.args), dict(spec.arg_types), spec.desc
            if t.name == "scrape_as_markdown":  # laisser l'agent lire au-delà de la limite de caractères
                args["start"] = {"type": "integer", "default": 0,
                                 "description": "Décalage de caractère à partir duquel lire, pour les pages longues"}
                args["find"] = {"type": "string", "default": "",
                                "description": "Mot ou expression à trouver ; retourne les passages correspondants"}
                types["start"], types["find"] = int, str
                desc += (f" Retourne {self.max_chars} caractères à la fois ; passez find pour rechercher"
                         " un mot ou une expression dans la page entière.")

            def run(_name=t.name, **kwargs):
                return self.call(_name, kwargs)

            out.append(dspy.Tool(run, name=spec.name, desc=desc,
                                 args=args, arg_types=types))
        return out
BrightDataTools().tools() retourne 2 outils synchrones qui conservent les noms, descriptions et arguments d’outils du serveur. L’outil d’extraction reçoit 2 arguments supplémentaires, start et find, afin que l’agent puisse lire du texte au-delà de la limite de caractères fixée par max_chars. Le serveur MCP de Bright Data enveloppe les résultats dans un avis de sécurité qui marque le texte de la page et indique au modèle de le traiter comme des données. La classe filtre et tronque seulement le texte marqué, donc le modèle reçoit quand même l’avis complet.
Les paramètres du constructeur :
remote=Falseutilise le serveur local au lieu de l’hébergé.countryfixegeo_locationsur chaque recherche, afin que chaque exécution obtienne des résultats pour le même pays.max_charslimite chaque résultat à 20 000 caractères, car certains sites publient des pages très longues, comme des articles Wikipédia complets. Sans la limite, 1 requête de modèle comptait 491 564 tokens et dépassait la fenêtre de contexte du modèle. Avec elle, aucune question n’a utilisé plus de 58 651 tokens de prompt sur 2 exécutions d’évaluation. Les pages restent en cache, donc un appel avecstartoufindn’envoie aucune nouvelle requête.retriesettimeoutaident les longues exécutions d’évaluation à se terminer. Un appel qui retourne une erreur est renvoyé jusqu’à 2 fois, et un appel encore en cours aprèstimeoutsecondes est annulé au lieu de continuer en arrière-plan. Chaque appel qui échoue encore est compté dansstats["errors"], queevaluate.pyetoptimize.pyaffichent. Vérifiez-le avant de faire confiance à un score, car l’agent répond de mémoire quand ses outils échouent.blocked_domainssupprime les sites choisis des résultats de recherche et bloque l’extraction de ces sites. Utilisez-le pendant l’évaluation, et laissez-le vide en production.cache=Trueréutilise aussi les résultats de recherche, etoptimize.pyl’active.
BrightDataTools est conçu pour les tâches synchrones et threadées comme dspy.Evaluate et GEPA, et il fonctionne sans modification dans un notebook Jupyter. Dans un service web asynchrone, comme un endpoint FastAPI, exécutez un agent construit sur BrightDataTools dans un thread de travail avec await asyncio.to_thread(agent, question=question), afin que la boucle d’événements continue de servir d’autres requêtes.
Évaluer l’agent sur SimpleQA Verified
GEPA améliore un programme en l’évaluant avec une métrique, donc l’agent a d’abord besoin de questions à réponses connues. SimpleQA Verified les fournit. C’est un ensemble public sous licence MIT de 1 000 questions factuelles courtes avec des réponses vérifiées.
Téléchargez les questions dans le dossier du dépôt :
curl -L -o simpleqa_verified.csv https://huggingface.co/datasets/google/simpleqa-verified/resolve/main/simpleqa_verified.csvresearch.py contient l’agent, un juge LLM de style SimpleQA nommé grader, et la métrique que GEPA utilise :
import csv
import random

import dspy

# Hôtes qui publient les réponses du benchmark, exclus pendant l'évaluation
EVAL_BLOCKLIST = ("huggingface.co", "github.com", "raw.githubusercontent.com",
                  "kaggle.com", "openaipublic.blob.core.windows.net")

AGENT_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)
JUDGE_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)


class ResearchQuestion(dspy.Signature):
    """Répondre à la question avec des faits trouvés sur le web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="une réponse courte et directe")
    sources: list[str] = dspy.OutputField(desc="URLs des pages qui soutiennent la réponse")


def make_agent(tools):
    return dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)


def load_examples(path="simpleqa_verified.csv", seed=7):
    rows = list(csv.DictReader(open(path)))
    random.Random(seed).shuffle(rows)
    return [dspy.Example(question=r["problem"], gold=r["answer"]).with_inputs("question")
            for r in rows]


class Grade(dspy.Signature):
    """Noter une réponse prédite par rapport à la réponse de référence, style SimpleQA.
    CORRECT : la prédiction contient le sens de la réponse de référence et ne la contredit pas.
    De petites différences d'orthographe ou de formatage sont acceptables ; pour les nombres et les dates, la valeur doit correspondre.
    INCORRECT : la prédiction donne une réponse différente ou contradictoire, ou hésite entre plusieurs.
    NOT_ATTEMPTED : la prédiction ne donne pas de réponse."""

    question: str = dspy.InputField()
    gold_answer: str = dspy.InputField()
    predicted_answer: str = dspy.InputField()
    grade: str = dspy.OutputField(desc="CORRECT, INCORRECT, ou NOT_ATTEMPTED")


grader = dspy.Predict(Grade)


def tool_calls(pred):
    calls = []
    history = getattr(pred, "history", None)
    for event in (history.messages if history else []):
        for call in getattr(event.get("tool_calls"), "tool_calls", []):
            if call.name != "submit":
                calls.append((call.name, call.args))
    return calls


def metric(gold, pred, trace=None, pred_name=None, pred_trace=None):
    """Score pour GEPA, plus retour qui ne montre jamais la réponse de référence."""
    answer = getattr(pred, "answer", "") or ""
    with dspy.context(lm=JUDGE_LM):
        grade = grader(question=gold.question, gold_answer=gold.gold,
                       predicted_answer=answer).grade.strip().upper()
    correct = grade.startswith("CORRECT")
    calls = tool_calls(pred)
    searches = [args.get("query") for name, args in calls if name == "search_engine"]
    pages = [args.get("url") for name, args in calls if name == "scrape_as_markdown"]
    feedback = (f"Note : {'CORRECT' if correct else 'INCORRECT'}. L'agent a répondu : {answer!r}. "
                f"Recherches ({len(searches)}) : {searches}. Pages ouvertes ({len(pages)}) : {pages}.")
    if not correct and not pages:
        feedback += " L'agent a répondu sans ouvrir de page."
    return dspy.Prediction(score=float(correct), feedback=feedback)


def leaked_answers(instruction, examples):
    """Réponses de référence (4+ caractères) qu'une instruction optimisée répète."""
    text = instruction.lower()
    return sorted({ex.gold for ex in examples if len(ex.gold) >= 4 and ex.gold.lower() in text})
Le juge utilise le propre petit modèle de l’agent pour attribuer les 3 notes de SimpleQA, qui sont correct, incorrect, et non tenté. La métrique retourne un score et un retour écrit qui liste les recherches et pages de l’agent, mais pas la réponse de référence. Pendant l’évaluation, EVAL_BLOCKLIST bloque les sites qui publient les réponses du benchmark, afin que l’agent doive trouver chaque réponse sur le web ouvert.
evaluate.py dans le dépôt exécute l’agent sur une tranche des questions mélangées, 8 à la fois, et sauvegarde chaque réponse dans results.json. Par défaut, il évalue les 60 questions de test. --no-tools évalue le modèle seul, et --local utilise le serveur local. Les exécutions ont donné ces résultats :
Configuration, toutes avec gpt-5.4-mini |
Correctes, sur les 60 mêmes questions SimpleQA Verified |
|---|---|
| Modèle seul, sans outils | 14 (1 exécution) |
Agent avec outils Bright Data, serveur local, sans find |
58, 55, 58, 54 (4 exécutions) |
Agent avec outils Bright Data, serveur hébergé, avec find |
57 (1 exécution) |
Les 46 erreurs du modèle seul étaient toutes des réponses spécifiques erronées, comme Omaha pour un peintre né à Beatrice, Nebraska. Les mauvaises réponses du modèle ressemblaient à des bonnes réponses.
Répéter des exécutions du même agent montre à quel point un seul score est du bruit. Les 4 exécutions de l’agent différaient en partie à cause de l’échantillonnage aléatoire du modèle et de la notation du juge. L’agent a nommé différents instruments pour la même pièce de John Cage d’une exécution à l’autre, et le juge a noté « 4½ points » comme correct mais « 4,5 » comme incorrect pour le même score d’échecs.
Traitez un changement allant jusqu’à 4 questions sur 60 comme du bruit, et comparez les programmes question par question dans leurs résultats sauvegardés, pas par totaux. DSPy met en cache les appels de modèle par défaut, donc définissez cache=False sur les deux LM avant de répéter une exécution.
Vérifiez aussi ponctuellement les notes du juge, surtout quand le juge est le même modèle que l’agent. Dans une révision manuelle d’une autre exécution, les 60 notes étaient correctes lorsque vérifiées par rapport aux réponses de référence.
Ce que coûte une exécution. Une exécution de 60 questions a eu en moyenne 2,3 appels d’outils par question, moins de 200 requêtes à Bright Data, et 0,29 $ d’appels gpt-5.4-mini pour l’agent. L’évaluation complète tient dans les requêtes mensuelles gratuites.
Tester l’agent sur des événements postérieurs à la date limite de connaissance du modèle
Les questions stables de SimpleQA Verified ne sont pas conçues pour tester des faits postérieurs à la date limite de connaissance du modèle. Pour ces faits, post_cutoff_questions.csv dans le dépôt contient 14 questions sur des événements de 2025 et 2026, avec des réponses vérifiées par rapport à Wikipédia. Exécutez python evaluate.py --csv post_cutoff_questions.csv --start 0 --n 14, puis à nouveau avec --no-tools. Chaque configuration a été exécutée une fois :
| Questions sur, 1 exécution chacune | gpt-5.4-mini seul |
gpt-5.4-mini avec outils Bright Data, serveur hébergé |
|---|---|---|
| Événements de 2025 | 5 sur 6 | 6 sur 6 |
| Événements de 2026 | 0 sur 8 | 8 sur 8 |
Sans outils, le modèle a affirmé que plusieurs événements de 2026 n’avaient pas encore eu lieu. Il connaissait 5 des 6 faits de 2025, bien qu’il ait déclaré que sa date limite de connaissance était juin 2024. Testez ce qu’un modèle sait au lieu de faire confiance à sa date limite de connaissance déclarée, et ajoutez des questions de votre propre cas d’usage dont les réponses apparaissent seulement sur des pages récemment publiées.
Optimiser l’agent avec GEPA
GEPA est l’optimiseur de prompt réflexif de DSPy. Il exécute le programme sur de petits lots de questions d’entraînement. Puis il montre les exécutions échouées et le retour de la métrique à un modèle de réflexion plus puissant, qui est gpt-5.5 dans ces exécutions. GEPA conserve les nouvelles instructions qui performent le mieux sur un ensemble de validation.
GEPA a besoin de mauvaises réponses pour apprendre. Quand l’agent répond correctement à chaque question d’entraînement échantillonnée, GEPA ne propose aucune nouvelle instruction.
Construisez donc l’ensemble d’entraînement à partir de questions où l’agent se trompe. Exécutez python evaluate.py --start 108 --n 400 --out pool.json sur des questions en dehors de l’ensemble de test. optimize.py combine ensuite 12 mauvaises réponses avec 12 bonnes réponses pour l’ensemble d’entraînement et construit l’ensemble de validation de la même manière :
import json
import random

import dspy
from brightdata_tools import BrightDataTools
from research import AGENT_LM, EVAL_BLOCKLIST, leaked_answers, make_agent, metric

dspy.configure(lm=AGENT_LM, adapter=dspy.ChatAdapter(use_native_function_calling=True))

# Moitié mauvaises, moitié bonnes réponses d'une exécution evaluate.py hors de l'ensemble de test
pool = json.load(open("pool.json"))
misses = [r for r in pool if not r["correct"] and not r.get("error")]
hits = [r for r in pool if r["correct"]]
random.Random(0).shuffle(hits)


def to_ex(rows):
    return [dspy.Example(question=r["question"], gold=r["gold"]).with_inputs("question")
            for r in rows]


half = min(12, len(misses) // 2)
trainset = to_ex(misses[:half] + hits[:half])
valset = to_ex(misses[half:2 * half] + hits[half:2 * half])

bd = BrightDataTools(blocked_domains=EVAL_BLOCKLIST, cache=True)
agent = make_agent(bd.tools())
gepa = dspy.GEPA(
    metric=metric,
    reflection_lm=dspy.LM("openai/gpt-5.5", temperature=1.0, max_tokens=32000),
    max_metric_calls=300,
    num_threads=8,
    track_stats=True,
    log_dir="gepa_logs",
)
optimized = gepa.compile(agent, trainset=trainset, valset=valset)
optimized.save("optimized_agent.json")

instruction = optimized.react.signature.instructions
print(instruction)
print("Réponses d'entraînement dans l'instruction :", leaked_answers(instruction, trainset + valset))
print("Appels d'outils :", bd.stats["calls"], "| requêtes envoyées :", bd.stats["sent"],
      "| erreurs :", bd.stats["errors"])
bd.close()
Exécutez-le avec python optimize.py. Le cache dans BrightDataTools compte ici, car GEPA pose les mêmes questions plusieurs fois. Lors d’1 exécution de GEPA, le cache a répondu à 524 des 994 appels d’outils sans nouvelle requête.
Ces 4 exécutions de GEPA ont chacune utilisé 24 questions d’entraînement, 24 questions de validation, et les mêmes 60 questions de test :
| Ensemble d’entraînement | Réponse attendue dans le retour | Score de validation, sur 24 | Réponses d’entraînement copiées dans l’instruction | Score de test, sur 60 |
|---|---|---|---|---|
| 24 questions aléatoires | Oui | 21 à 23 | 3 | 55, 52 |
| 24 questions aléatoires | Non | 24, aucune nouvelle instruction | 0 | Non mesuré |
| 12 mauvaises, 12 bonnes réponses | Oui | 18 à 21 | 3 | 57, 55 |
| 12 mauvaises, 12 bonnes réponses | Non | 20 à 21 | 3 | Non mesuré |
GEPA peut écrire des réponses d’entraînement dans l’instruction. L’instruction de la première exécution se terminait ainsi :
Faits connus qui peuvent être utiles pour des questions répétées :
- Galip Ulsoy a reçu le Charles Russ Richards Memorial Award de l'ASME et Pi Tau Sigma en 2013. ...
- La taille du bassin de la rivière Koshi/Kosi est généralement listée à environ 74 500 km². ...
- Pour le tremblement de terre du Népal/Gorkha du 25 avril 2015, une réplique de Mw 6,6 s'est produite environ 34 minutes après l'événement initial de Mw 7,8 ...
Chaque ligne répond à 1 question d’entraînement, et chaque instruction que GEPA a proposée dans cette exécution avait un bloc similaire. Masquer la réponse attendue ne l’a pas arrêté. Le modèle de réflexion a ensuite pris les réponses des propres exécutions correctes de l’agent, comme le nombre de ménages à Weston, Ohio, lors du recensement de 2000.
Relancez les mauvaises réponses avant de vous entraîner dessus. Sur l’ensemble de validation construit à partir de mauvaises réponses, l’agent de référence a déjà obtenu un score de 18 à 20 sur 24. Donc au moins 6 de ses 12 mauvaises réponses étaient correctes lors d’une relance. Conservez seulement les questions où l’agent se trompe sur plus d’une exécution.
Mesurez le résultat sur des questions mises de côté. Les scores de validation ont augmenté dans chaque exécution qui a proposé une instruction. Sur les 60 questions de test, les programmes optimisés ont obtenu un score de 52 à 57, et l’agent de référence avec outils Bright Data a obtenu un score de 54 à 58. Les modifications d’instructions de GEPA n’ont pas augmenté le score de manière mesurable, et la première exécution seule a coûté 3,31 $ d’appels de modèle pour l’agent gpt-5.4-mini et le modèle de réflexion gpt-5.5.
Vérifiez l’instruction pour des réponses copiées. leaked_answers dans research.py détecte les réponses de référence de 4 caractères ou plus qu’une instruction répète. Dans ces exécutions, il a trouvé la plupart des réponses copiées, mais une correspondance de chaîne ne détecte pas les courts nombres ou les réponses reformulées. Lisez l’instruction entière, et supprimez toute ligne concernant une question d’entraînement spécifique.
Trouver des corrections d’outils avec l’analyse des erreurs
GEPA ne fait que réécrire des instructions, donc il ne peut pas corriger un problème dans les outils eux-mêmes. L’analyse des erreurs des mauvaises réponses trouve ces problèmes. Ici, les mauvaises réponses se regroupaient sur les dates et les nombres. Sur 3 exécutions et 519 questions notées, l’agent s’est trompé sur environ 15 % des questions de dates et de nombres, contre 7 % des questions sur les personnes et les lieux.
Ces exécutions limitaient chaque page à 20 000 caractères avec le propre paramètre max_chars de l’agent. Dans 24 de ses 62 mauvaises réponses, l’agent avait ouvert une page plus longue que la limite. Une fois récupérées à nouveau en entier, 6 de ces pages avaient la réponse au-delà de la limite :
| Page ouverte par l’agent | La réponse commence au caractère (limite de l’agent est 20 000) | Réponse de l’agent | Bonne réponse |
|---|---|---|---|
| Wikipédia, Equinoxe | 38 604 | équinoxe | équilux |
| Wikipédia, ChromeOS | 24 709 | octobre 2011 | août 2011 |
| Wikipédia, Cannibal Corpse | 25 566 | mars 1993 | février 1993 |
| Notes de version Aseprite | 59 987 | v1.2.22 | v1.3-rc8 |
| Baseball-Reference, Tim Wakefield | 65 663 | 2,25 | 12,27 |
| RuPaul’s Drag Race Wiki, Saison 1 | 99 250 | « I Will Survive » | « Stronger » |
Dans les 6 cas, l’agent a cité la page qui contenait la bonne réponse. Une citation montre où l’agent a regardé, pas ce que la page dit.
Dans BrightDataTools, la classe d’enveloppe, start retourne les 20 000 caractères suivants, et find retourne jusqu’à 6 passages d’environ 3 000 caractères autour de chaque correspondance d’un mot ou d’une expression. Une note à la fin d’une page tronquée informe l’agent des deux arguments. La pagination seule ne suffisait pas. Dans un test séparé avec seulement start, l’agent a demandé la partie suivante d’une page dans 3 des 18 exécutions.
Chaque configuration a été exécutée 8 fois par question :
| Configuration, mêmes 6 questions à pages longues | Correctes, sur 48 exécutions | Tokens de prompt par exécution | Coût gpt-5.4-mini, les 48 exécutions |
|---|---|---|---|
| Limite de caractères seulement | 24 | 23 023 | 0,52 $ |
Limite de caractères avec start et find |
33 | 11 908 | 0,35 $ |
L’agent a appelé find dans 28 des 48 exécutions. Le gain de précision est prometteur mais pas encore statistiquement significatif à 48 exécutions par version (p ≈ 0,10).
Vérifiez les sources avant de les montrer aux utilisateurs. L’agent citait souvent des résultats de recherche qu’il n’avait jamais ouverts. Dans les exécutions locales, il avait ouvert moins de 1 URL citée sur 4. Pour vérifier une source, appelez l’outil d’extraction de BrightDataTools avec find et une partie distinctive de la réponse.
Tracer chaque appel d’outil avec MLflow
Une trace montre chaque recherche que l’agent a exécutée et chaque page qu’il a lue. Avec elle, vous pouvez voir comment l’agent a produit chaque réponse et trouver rapidement l’étape qui a causé une erreur. L’intégration MLflow pour DSPy enregistre chaque module, appel de modèle et appel d’outil comme un span. Installez la version MLflow testée :
uv pip install "mlflow==3.17.1"Ajoutez ensuite ces lignes à agent.py, avant l’exécution de l’agent :
import mlflow

mlflow.set_tracking_uri("sqlite:///mlflow.db")
mlflow.dspy.autolog()
MLflow 3.17 nécessite un backend de base de données, donc l’URI de suivi est défini sur un fichier SQLite local. Exécutez mlflow ui --backend-store-uri sqlite:///mlflow.db pour voir les traces. Cet arbre de spans provient d’1 question :
CHAIN       ReActV2.forward
LLM         Predict.forward          x6
CHAT_MODEL  LM.__call__              x6
PARSER      ChatAdapter.format       x6
TOOL        Tool.search_engine       x4
TOOL        Tool.scrape_as_markdown  x1
TOOL        Tool.submit              x1
Chaque span TOOL stocke les arguments envoyés par le modèle et le texte retourné par le serveur MCP de Bright Data. Sélectionner le premier span de recherche dans l’interface MLflow montre les deux pour cet appel :
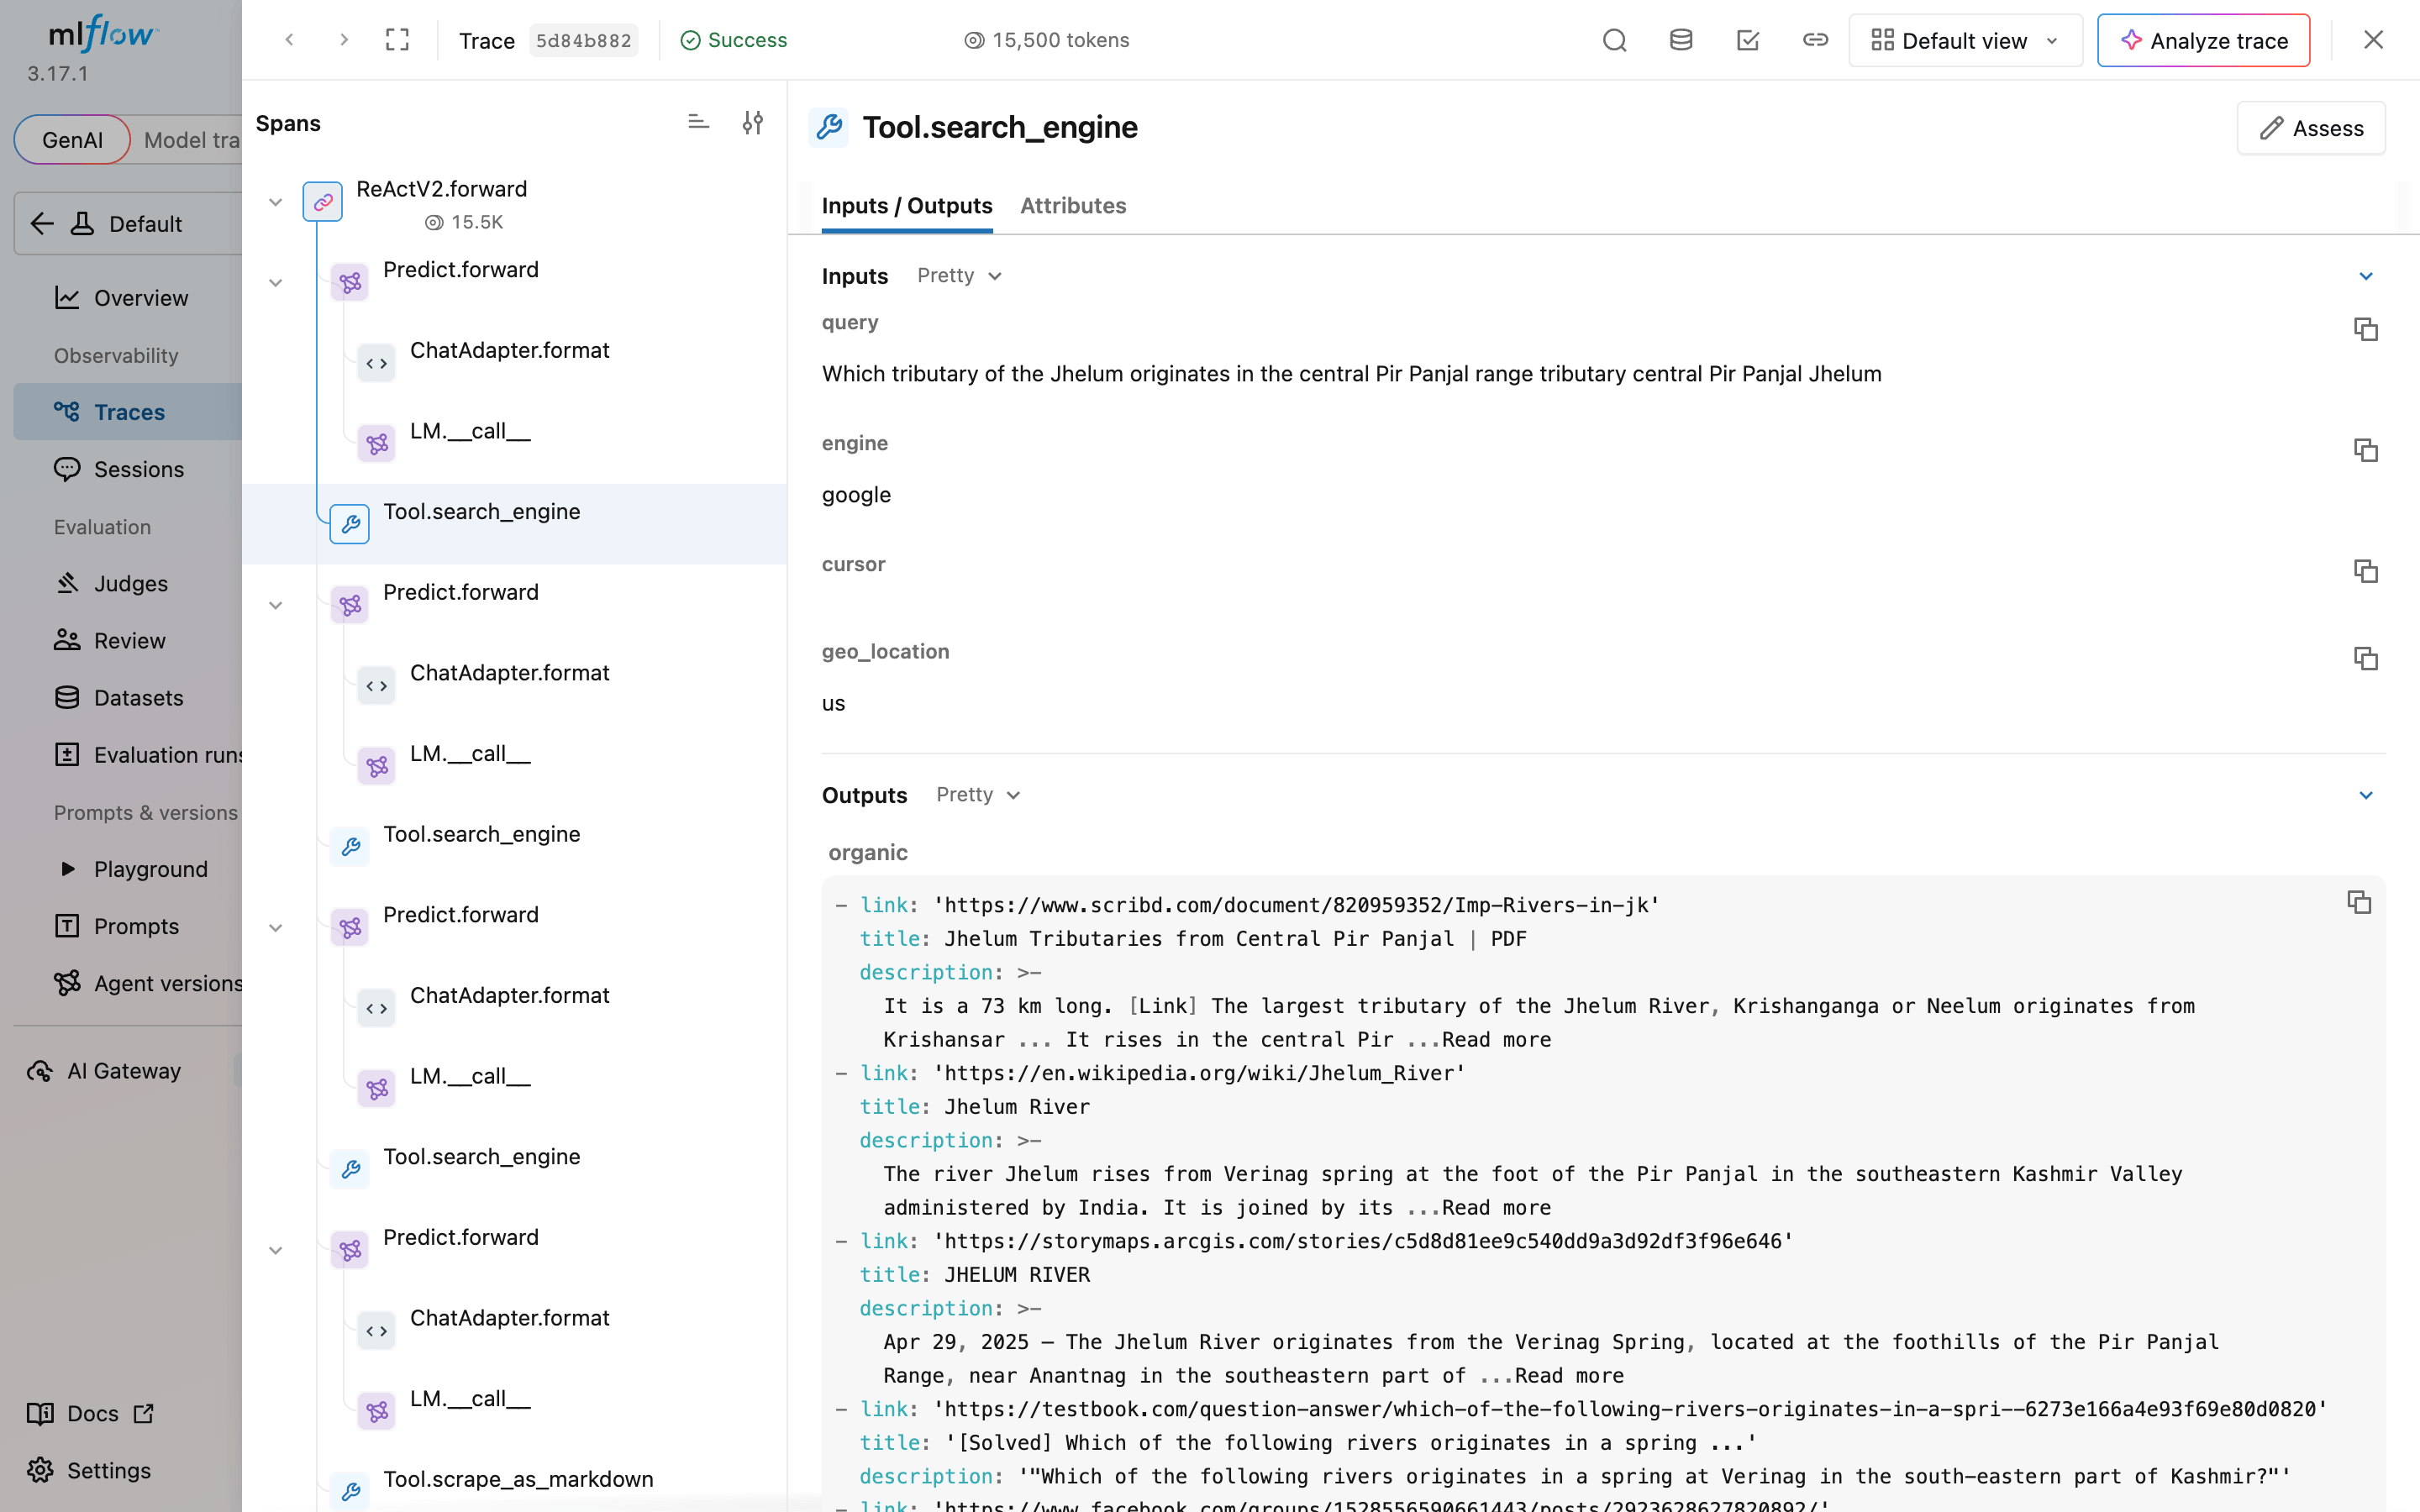
Pour une mauvaise réponse, cette vue montre si la requête de l’agent a trouvé une page avec la bonne réponse.
Réflexions finales
Avec le serveur MCP de Bright Data, cet agent DSPy a répondu correctement à 54 à 58 des 60 questions de référence, contre 14 auparavant, et à toutes les 8 questions sur des événements postérieurs à sa date limite de connaissance. Pour l’évaluer et l’optimiser, gardez la session MCP sur sa propre boucle d’événements, car dspy.Evaluate et GEPA appellent les outils depuis des threads de travail. Examinez les mauvaises réponses avant d’optimiser, car 6 d’entre elles ici avaient la réponse au-delà de la propre limite de caractères de l’agent, et find permet à l’agent de rechercher dans la page entière. GEPA peut aider le plus quand les mauvaises réponses partagent une cause qu’une instruction peut corriger, et vous devriez vérifier sa sortie pour des réponses copiées. Créez un compte Bright Data gratuit, exécutez agent.py sur une question à laquelle votre modèle ne peut pas répondre de mémoire, et exécutez evaluate.py sur vos propres questions.
FAQ
DSPy prend-il en charge les serveurs MCP ?
Oui. Avec dspy.Tool.from_mcp_tool et un client du SDK Python MCP, DSPy convertit les outils d’un serveur MCP, comme le serveur MCP de Bright Data, en outils DSPy. Installez l’extra MCP avec pip install "dspy[mcp]". Dans DSPy 3.4.1, les outils MCP sont asynchrones, donc appelez les agents avec acall. Sur les threads de travail, utilisez des enveloppes synchrones sur une boucle d’événements en arrière-plan.
DSPy est-il un client MCP ?
Non, pas par lui-même. DSPy utilise un client du SDK Python MCP, et dspy.Tool.from_mcp_tool convertit les outils de ce client en outils DSPy. DSPy construit et optimise le programme d’agent, et MCP connecte l’agent à des serveurs comme le serveur MCP de Bright Data.
Comment ajouter la recherche web à un agent DSPy ?
Connectez le serveur MCP de Bright Data et passez ses outils de recherche et d’extraction à dspy.ReActV2, l’implémentation que dspy.ReAct utilise à partir de DSPy 3.5. L’agent recherche sur Google, lit les pages en Markdown, et retourne ses URLs source. Une fonction Python qui appelle l’API SERP de Bright Data, qui retourne les résultats de recherche en JSON, fonctionne aussi comme outil DSPy.
Quel outil de recherche web fonctionne avec DSPy ?
Le serveur MCP de Bright Data donne à un agent DSPy des résultats Google et des pages complètes en Markdown via une seule connexion, et le serveur gère la protection anti-bot. Sur 60 questions SimpleQA Verified, gpt-5.4-mini a répondu correctement à 54-58 avec lui, contre 14 sans lui. D’autres outils de recherche fonctionnent aussi, et la comparaison des outils de recherche pour agents IA les couvre.
Qu’est-ce que DSPy ReActV2 ?
dspy.ReActV2 est le module d’agent DSPy expérimental construit sur l’appel d’outils natif. Il garde un historique structuré, peut effectuer plusieurs appels d’outils par tour, et termine avec un outil submit. La documentation DSPy le liste comme l’implémentation que dspy.ReAct utilise à partir de DSPy 3.5, le nom ReActV2 étant supprimé dans la 3.6.
DSPy est-il toujours pertinent ?
Oui, pour les programmes que vous pouvez évaluer avec une métrique. DSPy garde la tâche séparée du prompt, donc vous pouvez changer de modèle et ré-optimiser avec une métrique et un optimiseur comme GEPA. Avec les paramètres par défaut, GEPA ne propose des changements que lorsque le programme répond encore incorrectement à certaines questions d’entraînement, donc évaluez d’abord le programme.
DSPy est-il prêt pour la production ?
Oui, lorsque vous épinglez les versions et rendez les appels d’outils robustes. Épinglez dspy et tout serveur MCP, limitez la taille de sortie des outils, laissez l’agent rechercher du texte au-delà de cette limite, ajoutez des relances, des délais d’expiration, et des compteurs d’erreurs aux appels d’outils, et tracez les exécutions avec MLflow. Les modules expérimentaux comme ReActV2 peuvent changer entre les versions mineures.
DSPy peut-il être utilisé pour l’optimisation de prompt ?
Oui. Les optimiseurs DSPy comme GEPA réécrivent les instructions d’un programme en fonction d’exemples évalués. GEPA examine les exécutions évaluées et leur retour écrit et propose de nouvelles instructions, puis conserve celles qui performent le mieux sur un ensemble de validation. Vérifiez le résultat avant de le déployer, car GEPA peut parfois copier des réponses d’entraînement dans l’instruction.