Scraper Yelp consiste à collecter des fiches d’entreprises, des notes et des avis pour l’analyse de sentiment, l’étude de marché ou la prospection commerciale. Les plans de l’API en libre-service de Yelp incluaient au plus 7 extraits d’avis par entreprise, alors que yelp.com affiche le texte intégral.
La protection anti-bot de Yelp renvoyait une page de défi à chaque requête HTTP Python que nous avons envoyée. Un navigateur Chromium local recevait un CAPTCHA à curseur. Même quand une page d’entreprise se chargeait, son HTML ne contenait aucun texte d’avis complet.
Ce guide montre où Yelp stocke ses données et comment collecter les détails d’entreprises et les avis complets en Python. Il explique aussi quand utiliser le Yelp Scraper API de Bright Data.
TL;DR
- DataDome, la protection anti-bot de Yelp, a bloqué les clients HTTP Python avec un défi JavaScript, même avec usurpation TLS et IPs résidentielles américaines. Web Unlocker API de Bright Data a chargé les 30 pages d’entreprises testées.
- Les avis complets provenaient de l’API GraphQL de Yelp, jusqu’à 49 par appel. Les 582 avis recommandés d’un restaurant ont nécessité 12 appels.
- L’ID de requête persistée peut changer lors des déploiements de Yelp, et un script Browser API capture le nouveau. Un scraper open source publiait un ID obsolète.
- Le Yelp Scraper API de Bright Data gère pour vous la maintenance du parser et de l’ID de requête, à un prix par avis plus élevé. Il collecte aussi les avis non recommandés par Yelp.
Ce qui bloque un scraper Yelp
Dans nos tests, les pages de Yelp étaient protégées par DataDome, un service commercial de protection anti-bot. Les réponses bloquées incluaient ses en-têtes (server: DataDome et x-datadome: protected) et définissaient un cookie datadome.
Nous avons envoyé des requêtes vers des pages d’entreprises Yelp depuis plusieurs configurations clientes. Les clients incluaient curl_cffi, un client HTTP Python qui imite la poignée de main TLS d’un navigateur.
Sur une connexion domestique, chaque configuration a demandé la même page. Via des proxys résidentiels américains, chaque client a demandé 12 pages différentes. Aucune configuration n’a passé le défi :
| Client | Réseau | Ce que Yelp a renvoyé |
|---|---|---|
requests et httpx (HTTP/2) |
Connexion domestique hors des États-Unis | Page CAPTCHA 403, 5 sur 5 chacun |
curl_cffi avec un profil TLS Chrome, Safari ou Firefox |
Connexion domestique hors des États-Unis | Page de vérification d’appareil 403, 5 sur 5 chacun |
curl_cffi avec un profil TLS Chrome et un User-Agent Python |
Connexion domestique hors des États-Unis | Page CAPTCHA 403, 5 sur 5 |
requests et curl_cffi |
Proxys résidentiels américains, nouvelle IP par requête | Page de vérification d’appareil 403, 12 sur 12 chacun |
| Playwright avec Chromium en mode headless | Connexion domestique hors des États-Unis | Page CAPTCHA 403 |
| Playwright avec Chromium en mode visible | Connexion domestique hors des États-Unis | Vérification d’appareil d’abord, puis un CAPTCHA à curseur sous 8 secondes |
Chaque corps 403 de ces configurations était la page de défi de DataDome. La page intégrait un objet var dd={...}, et le champ rt de l’objet indiquait le type de défi. La valeur c chargeait le script CAPTCHA, et i chargeait une page de vérification d’appareil.
Sur la connexion domestique, requests et httpx ont obtenu c. Avec un profil TLS de navigateur, curl_cffi a obtenu i, et avec un User-Agent Python il a de nouveau obtenu c. Via des IPs résidentielles américaines, la bibliothèque requests a aussi obtenu i. Forcer HTTP/1.1 dans curl_cffi a renvoyé la même page de vérification d’appareil.
La vérification d’appareil exécutait du JavaScript, qu’un client HTTP ne peut pas exécuter. Un navigateur en mode visible a exécuté la vérification d’appareil puis a reçu ce curseur :
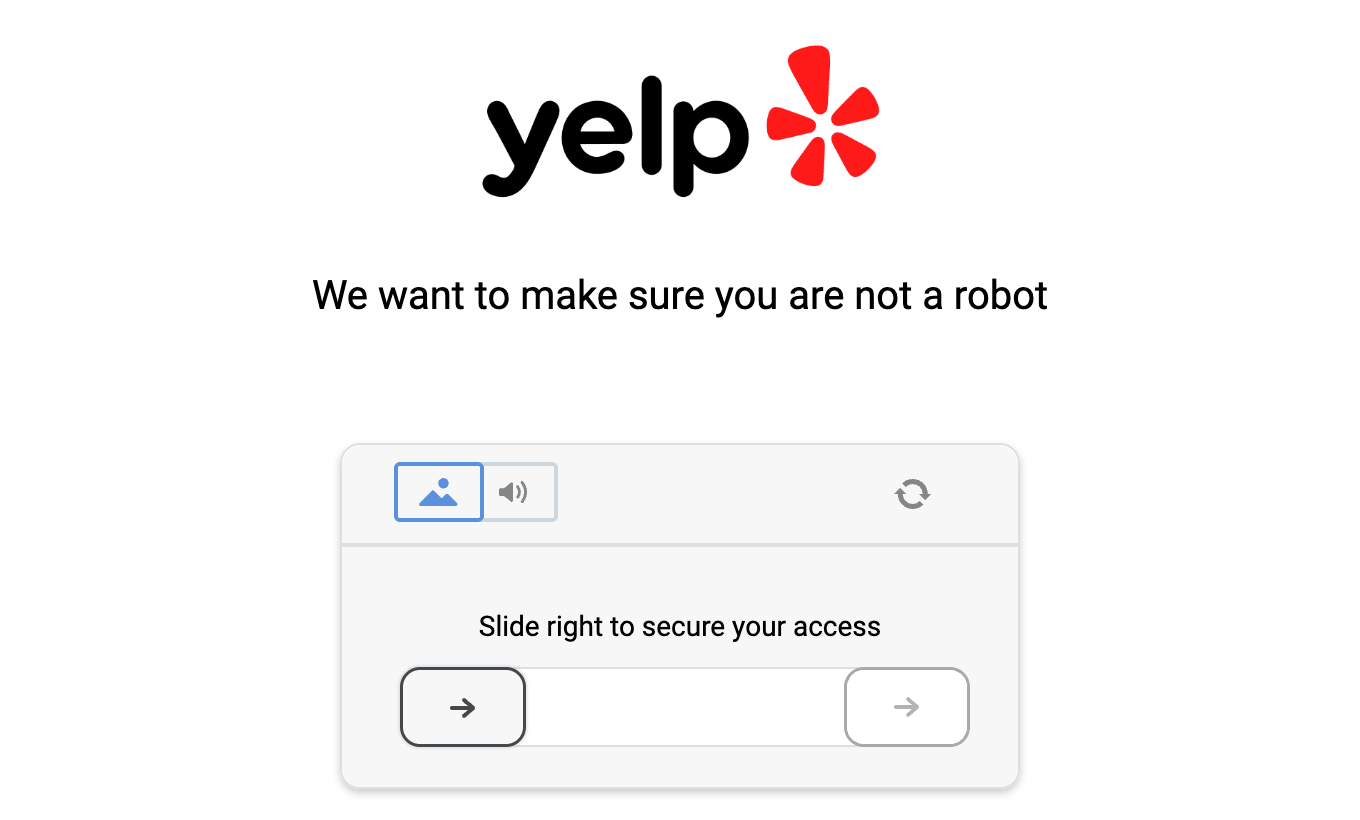
Une session Chromium en mode visible sur une connexion domestique a affiché ce curseur dans les 8 secondes suivant le chargement de la page. Si une personne doit faire glisser le curseur, un scraper ne peut pas fonctionner automatiquement.
Les clients HTTP se sont arrêtés à un défi JavaScript qu’ils ne peuvent pas exécuter, même via des IPs résidentielles américaines. Les navigateurs pouvaient exécuter JavaScript mais utilisaient une seule IP domestique, et Yelp renvoyait des pages CAPTCHA à cette IP. Web Unlocker API de Bright Data gère l’environnement navigateur, l’IP et les défis DataDome pour vous, y compris les CAPTCHAs sur Yelp. Chaque requête Yelp du scraper Python l’utilise.
Où Yelp stocke les données d’entreprises et d’avis
Browser API de Bright Data, un navigateur cloud que vous contrôlez avec Playwright, montre comment une page d’entreprise Yelp charge ses données. Un chargement de page enregistré a envoyé 12 requêtes XHR et fetch vers www.yelp.com, dont 7 sur 12 étaient des requêtes POST vers /gql/batch. Les données se trouvaient à 3 endroits :
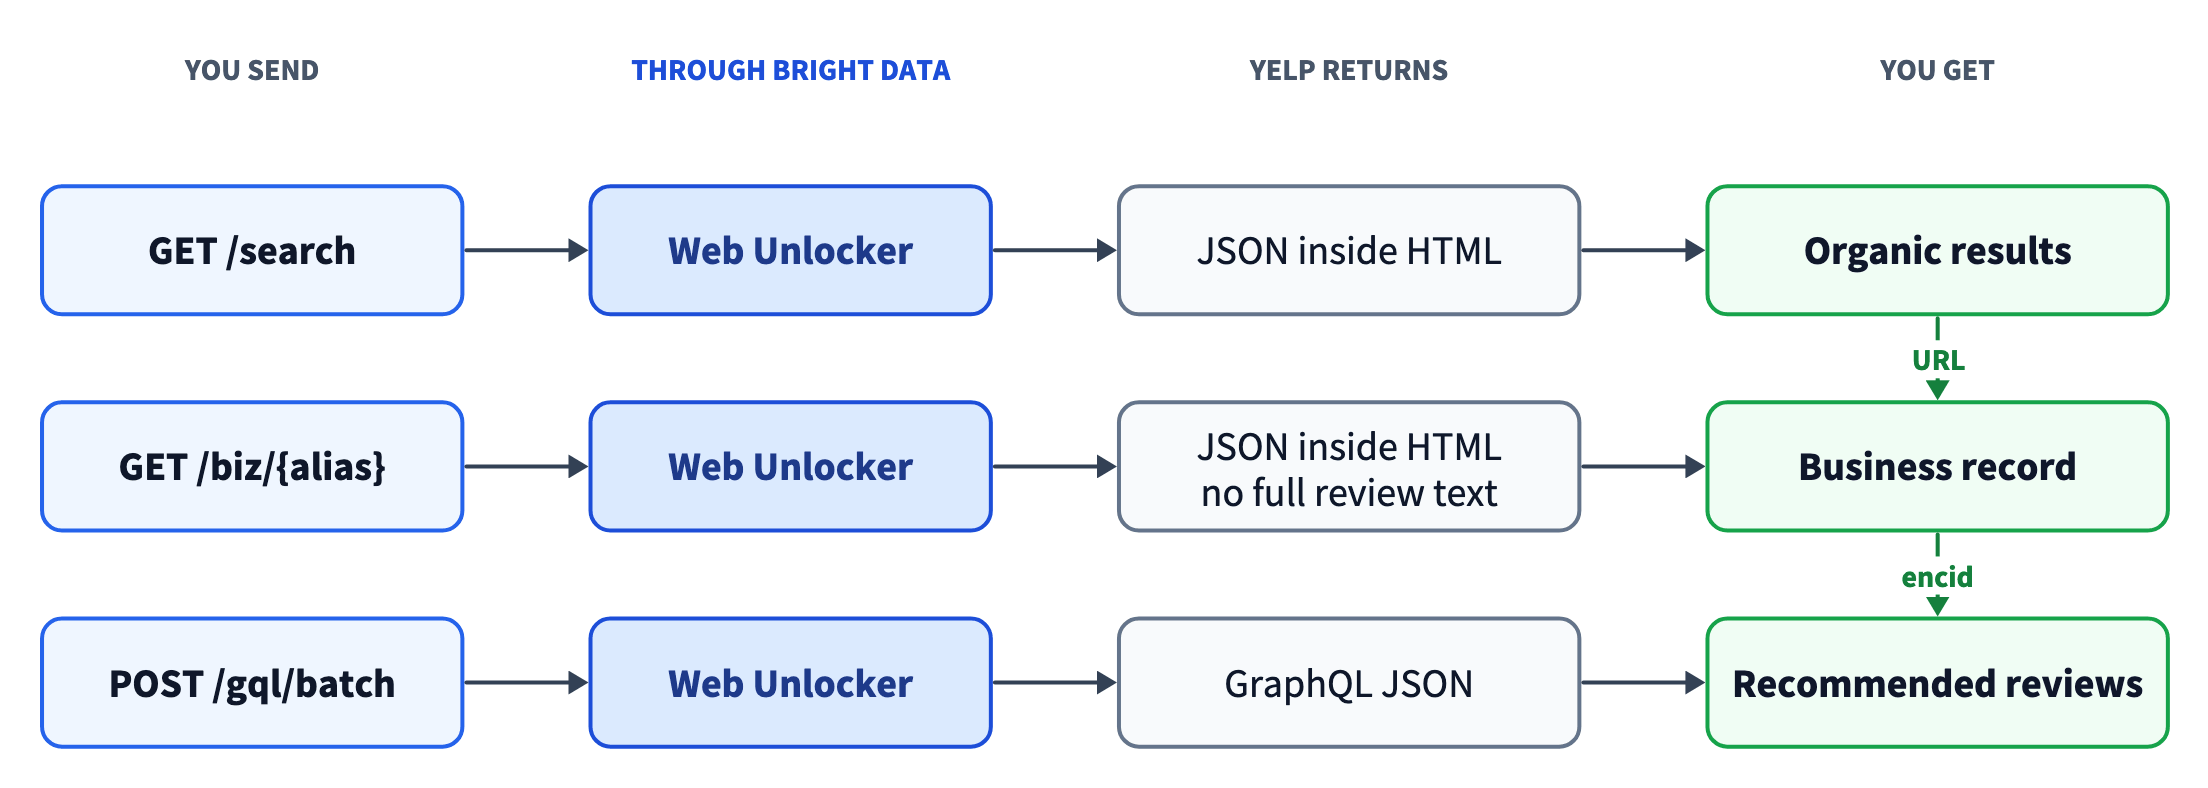
Les pages de recherche et d’entreprise contenaient leurs données sous forme de JSON dans le HTML. Les avis nécessitaient un appel GraphQL séparé utilisant l’ID d’entreprise de la page.
Pages de recherche
Yelp rendait les résultats de recherche côté serveur avec Hypernova, qui intégrait 2 objets JSON dans le HTML. Une balise <script data-hypernova-key> contenait les props de la page, y compris la liste des cartes de résultats. Une balise <script data-apollo-state> contenait un cache Apollo Client. Les deux objets JSON étaient enveloppés dans un commentaire HTML, et le cache Apollo était aussi échappé en HTML (").
Les 2 objets se partageaient chaque résultat entre eux. Une carte organique n’incluait que son bizId, son rang et son URL, tandis que le nom, la note et le nombre d’avis se trouvaient dans le cache Apollo sous Business:<bizId>. Les cartes sponsorisées étaient l’inverse, avec leurs détails en ligne et des liens via /adredir. Un parser qui ne lirait que les cartes obtiendrait les détails complets pour les résultats sponsorisés et aucun nom, note ou nombre d’avis pour les résultats organiques.
Sur la page de recherche rendue, les 2 types de carte ressemblaient à ceci :
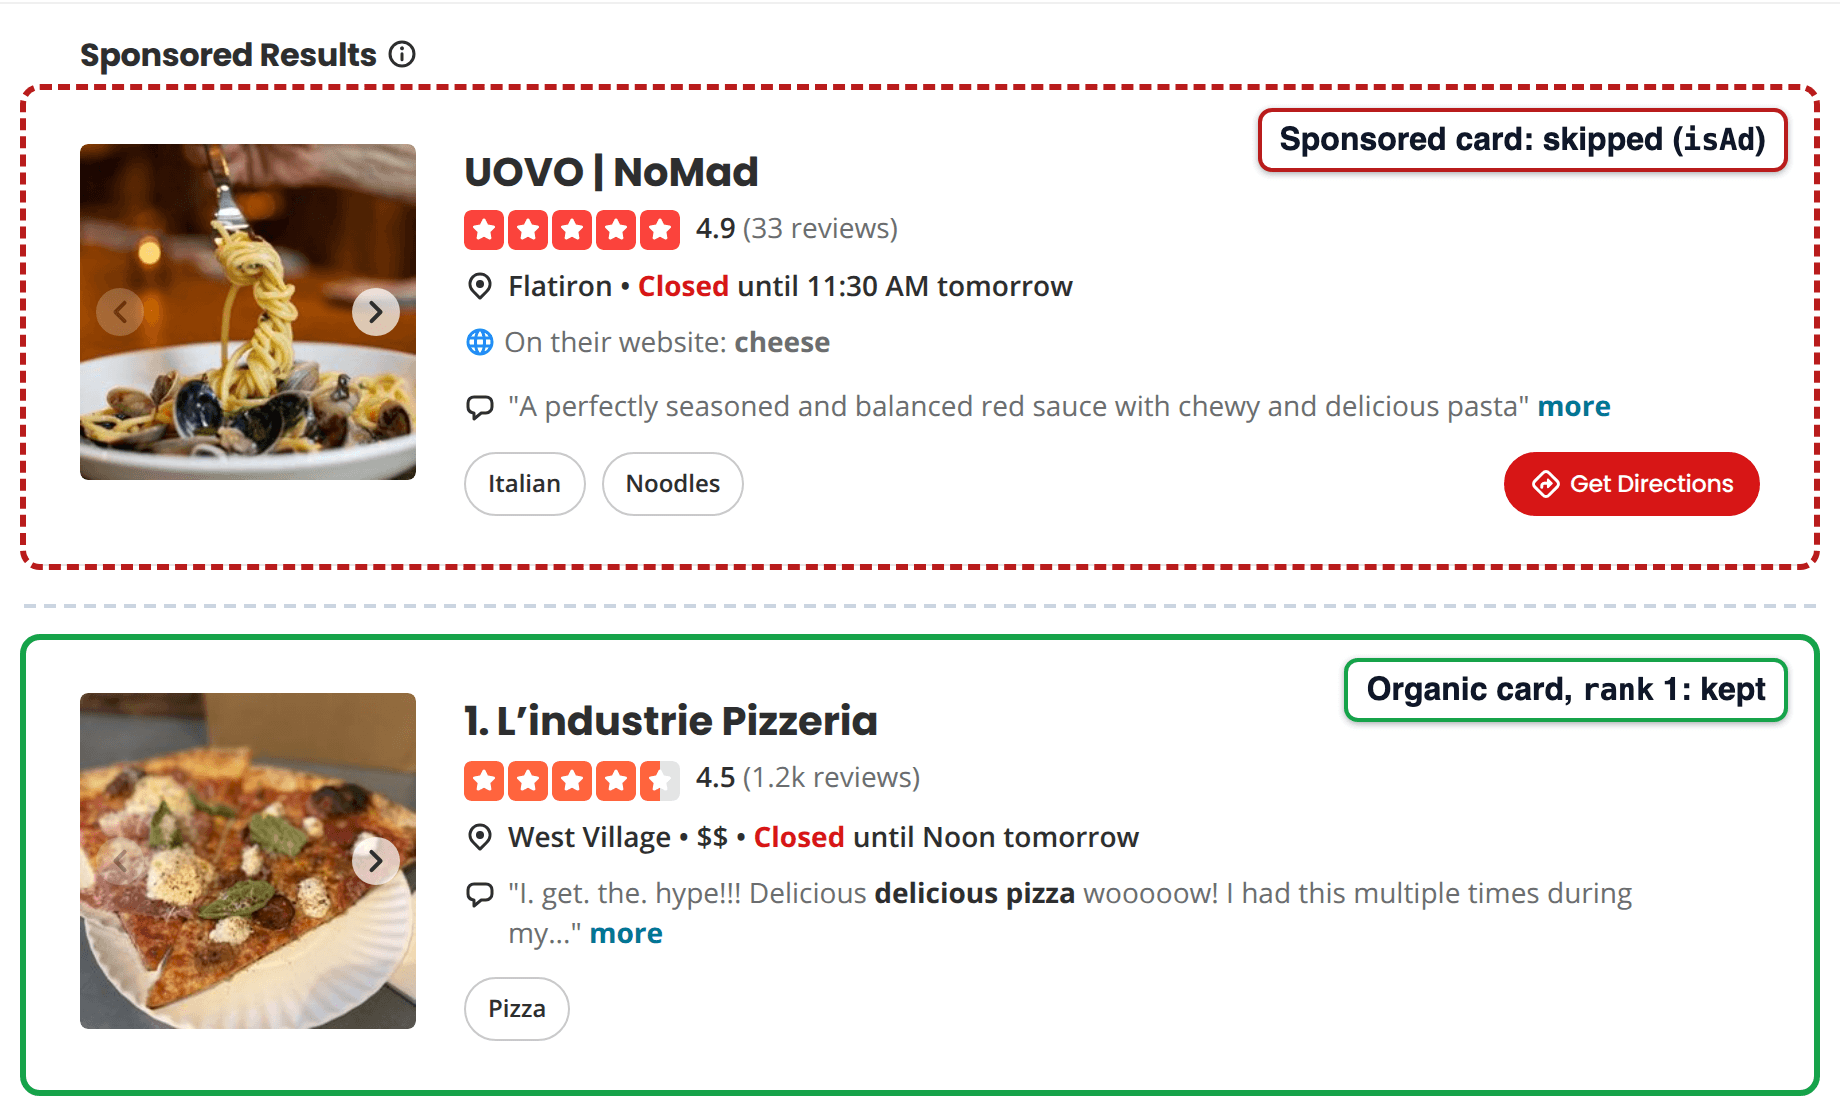
Yelp listait les résultats sponsorisés avant les résultats organiques numérotés. parse_search() conserve le rang de chaque carte organique et ignore toute carte marquée isAd.
La recherche Yelp limitait aussi le nombre de résultats. Le bloc de pagination indiquait totalResults: 240 pour les 4 requêtes vérifiées, y compris “Restaurants” à Dallas, et chaque page affichait 10 résultats. Pour collecter les résultats d’une ville entière, divisez la requête par quartier, catégorie ou zone cartographique.
Pages d’entreprises
Une page d’entreprise contenait le même cache Apollo, et ce cache avait la plupart des champs d’entreprise. Il incluait l’ID d’entreprise (encid), la note, le nombre d’avis, l’adresse, le téléphone, la gamme de prix, les catégories, le statut de revendication et le site web. La balise <meta name="yelp-biz-id"> contenait aussi l’encid. Les cartes de recherche appellent le même ID bizId, et la requête GraphQL l’appelle encBizId.
Sur la page de L’industrie Pizzeria, ces champs apparaissaient dans l’en-tête et la barre latérale :
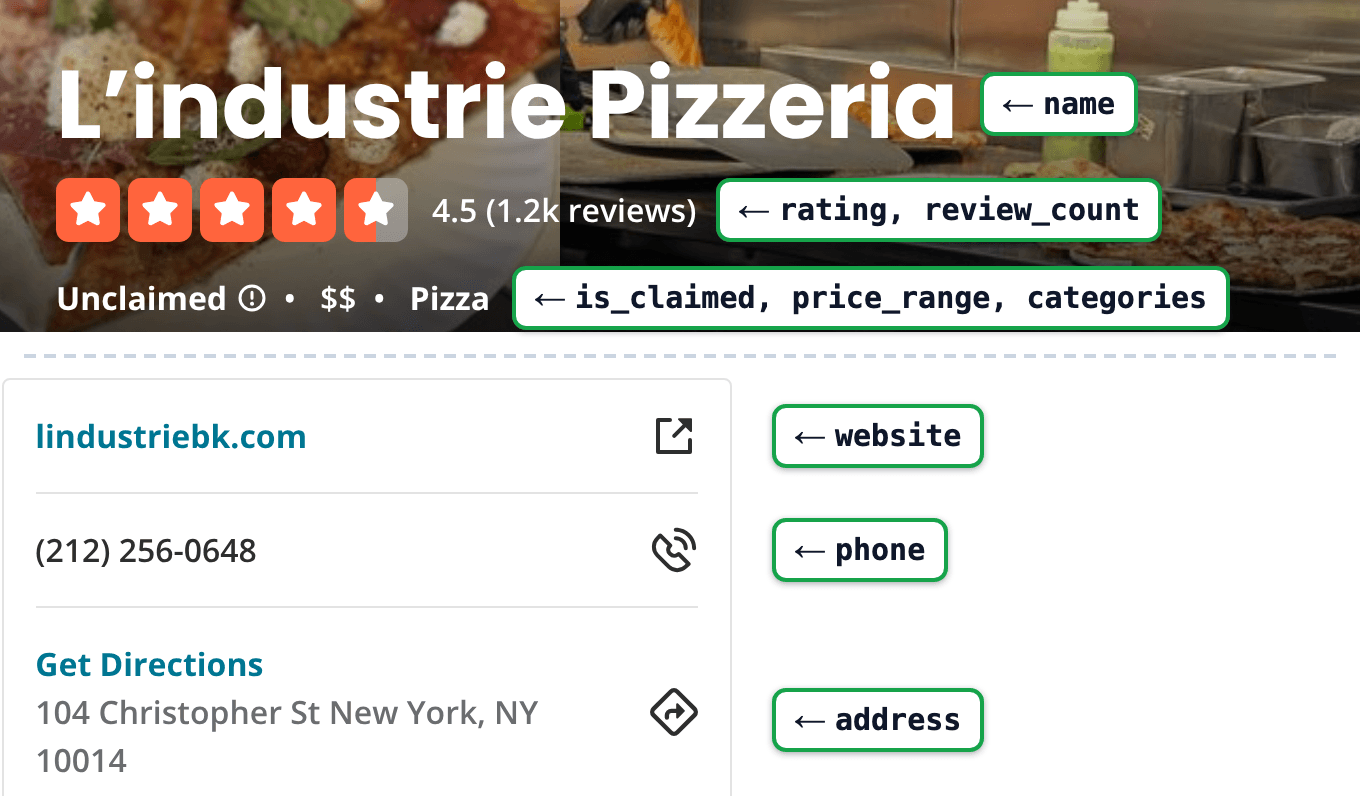
Les étiquettes sont les clés que parse_business() renvoie, et chaque valeur provenait du cache Apollo dans le HTML de la page. La page arrondissait le nombre d’avis à 1.2k, tandis que le cache avait le nombre exact.
Les anciens guides lisaient la note depuis le JSON-LD et lisaient les avis depuis la page elle-même. Sur les 19 pages d’entreprises que nous avons sauvegardées, les blocs JSON-LD ne contenaient que des listes de photos et des fils d’Ariane, sans note d’entreprise. Le cache Apollo ne contenait aucun texte d’avis complet sur aucune des 19 pages.
Sur 14 de ces pages, le cache avait des IDs d’avis et de courts extraits en surbrillance, et les 5 autres n’avaient aucune référence d’avis. La liste complète des avis se chargeait plus tard, via une requête GraphQL depuis le navigateur.
Avis dans l’API GraphQL
Les avis provenaient du point de terminaison GraphQL de Yelp. La page envoyait un POST vers /gql/batch avec un tableau JSON d’opérations, et l’opération GetBusinessReviewFeed renvoyait la liste des avis. Yelp utilisait des requêtes persistées, donc la requête contenait un ID de requête persistée (documentId) de 64 caractères au lieu du texte de la requête. Le serveur rejetait les IDs qu’il ne reconnaissait pas.
Ouvrir la page 2 des avis a envoyé cette requête, montrée ici dans Chrome DevTools :
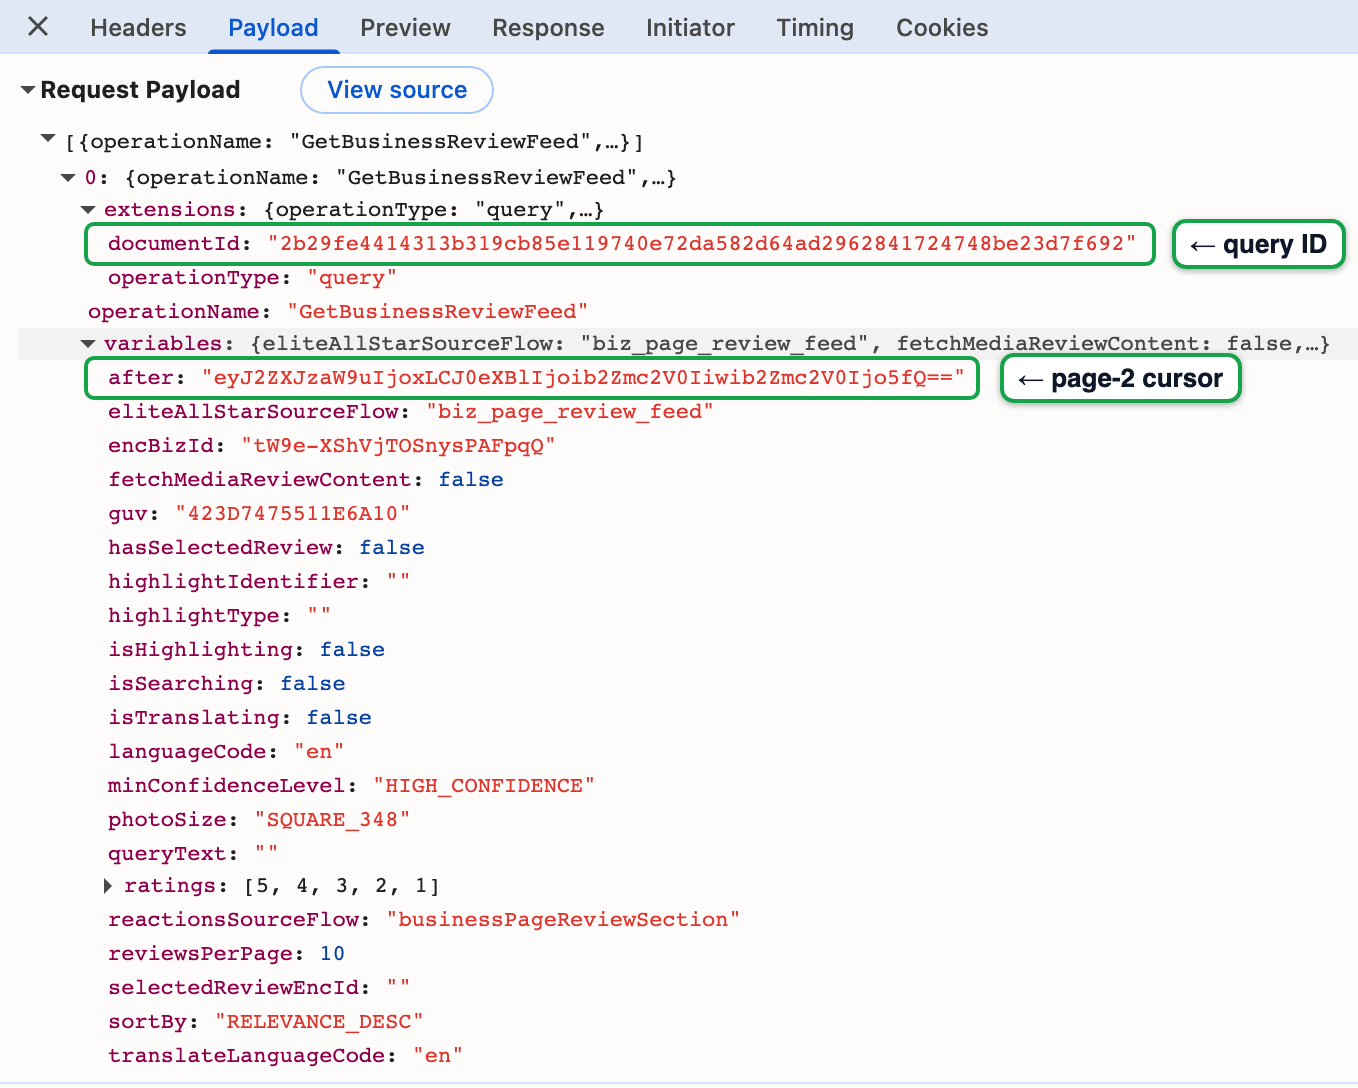
La requête propre de la page pour la page d’avis 2. Le scraper envoie le même documentId et construit lui-même le curseur after.
L’API GraphQL se comportait ainsi dans nos tests :
- Taille de page :
reviewsPerPageacceptait 49. Une valeur de 50 renvoyait une erreurBAD_USER_INPUT. - Pagination : le curseur
afterétait du JSON encodé en base64. Le navigateur demandait 10 avis par page, et son curseur de page 2 se décodait en{"version":1,"type":"offset","offset":9}. Ce format permet de construire soi-même le curseur de chaque page et de récupérer les pages en parallèle. - Tri et filtres :
sortByacceptaitRELEVANCE_DESC,DATE_DESC,DATE_ASC,RATING_ASC, etELITES_DESC. Une valeurratingsde[1]réduisaittotalCountà 35. C’est le nombre d’avis 1 étoile chez Ziziki’s à Dallas, le restaurant utilisé pour les tests GraphQL. - Erreurs : les erreurs de validation étaient renvoyées dans une réponse HTTP 200 et listaient chaque variable manquante. Un
documentIdinconnu obtenait une réponse HTTP 403Forbiddendans le navigateur. Via Web Unlocker, la même requête renvoyait502avec le code d’erreurhttp_status, signifiant que Yelp a renvoyé un statut d’erreur. Aucune des deux réponses ne contenait la page de défi de DataDome, donc un ID obsolète ne ressemble pas à un blocage. - Portée :
GetBusinessReviewFeedrenvoyait les avis recommandés par Yelp, l’ensemble listé sur la page d’entreprise. Selon Yelp, son logiciel déplace les avis qu’il signale comme peu fiables, sollicités ou injustement biaisés vers une liste séparée de non-recommandés. Pour Ziziki’s,totalCountétait 582, l’en-tête de l’entreprise affichait 583, et la section repliée de la page affichait 39 avis non recommandés.
La page de Yelp montrait la même répartition. Sous la pagination des avis, une section repliée affichait le nombre d’avis non recommandés :
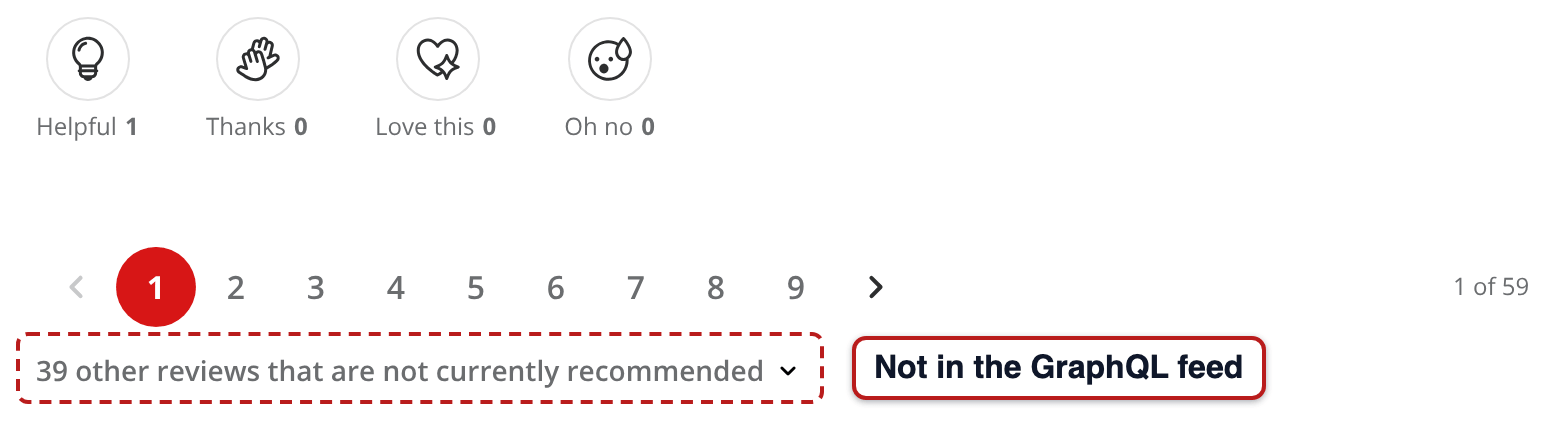
La page de Ziziki’s listait 59 pages d’avis recommandés, 10 par page, et affichait 39 de plus dans la section repliée.
Le documentId peut changer lorsque Yelp déploie un nouveau code frontend. Un scraper Yelp open source populaire publiait un documentId, mais cet ID ne correspondait plus à celui que la page en direct envoyait. Un court script Browser API, refresh_doc_id.py, capture l’ID actuel depuis une page en direct, afin que vous puissiez mettre à jour le scraper après que Yelp publie un nouveau code.
Créer un scraper Yelp en Python
Le scraper demande les pages de recherche et d’entreprise via Web Unlocker avec GET. Il envoie la requête GraphQL pour les avis en POST avec un corps JSON.
Le code lève une erreur quand un objet JSON ou une clé requise est manquant. Il en lève aussi une quand l’ID de requête persistée est obsolète ou que Yelp rejette une variable GraphQL. D’autres changements apparaissent comme des champs vides ou un nombre de lignes inférieur à totalCount, donc vérifiez les deux après chaque exécution.
Si vous débutez dans le scraping avec Python, commencez par notre guide de web scraping Python, qui couvre les bases. Vous avez besoin de Python 3.10 ou ultérieur, du package requests, et d’un compte Bright Data. Créez une zone Web Unlocker, la configuration nommée que chaque requête référence, en suivant le guide de démarrage rapide de Web Unlocker de Bright Data. Puis générez une clé API.
Le niveau gratuit inclut 5K crédits par mois, partagés entre les APIs de scraping de Bright Data. Chaque requête Web Unlocker ou enregistrement Yelp Scraper API livré utilise 1 crédit. Web Unlocker facture uniquement les requêtes réussies. Installez la dépendance et exportez votre clé API et le nom de la zone :
pip install requests
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_UNLOCKER_ZONE="web_unlocker"
Les requêtes Web Unlocker et Browser API vers Yelp nécessitent un compte avec accès complet. Les comptes en mode d’accès immédiat, qui ne nécessite pas de vérification KYC, respectent le robots.txt. Le robots.txt de Yelp interdisait les crawlers qu’il ne nommait pas, au moment où nous l’avons lu.
Vous obtenez l’accès complet après vérification KYC ou via votre gestionnaire de compte. Jusque-là, Web Unlocker renvoie une erreur ub_bad_endpoint_robots pour les URLs Yelp, et le Browser API renvoie une erreur brob.
Récupérer les pages via Web Unlocker
L’assistant envoie chaque URL au point de terminaison /request de Web Unlocker et renvoie le corps de la réponse de la cible, avec jusqu’à 3 tentatives par URL. Enregistrez-le comme première partie de yelp_scraper.py :
import base64
import html
import json
import os
import re
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("BRIGHTDATA_UNLOCKER_ZONE", "web_unlocker")

# ID de requête persistée de l'opération GetBusinessReviewFeed de Yelp.
# Il peut changer lors d'un déploiement de Yelp. refresh_doc_id.py le capture.
REVIEW_FEED_DOC_ID = os.environ.get(
    "YELP_REVIEW_FEED_DOC_ID",
    "2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692",
)
PAGE_SIZE = 49  # L'API GraphQL de Yelp a rejeté 50 avec BAD_USER_INPUT


class FetchError(Exception):
    pass


def unlock(url, method="GET", body=None, attempts=3):
    """Récupère une URL via Web Unlocker ; renvoie le corps de réponse de la cible."""
    payload = {"zone": ZONE, "url": url, "format": "raw",
               "country": "us", "method": method}
    if body is not None:
        payload["body"] = json.dumps(body)
        payload["headers"] = {"content-type": "application/json"}
    last_error = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json=payload,
                timeout=180,
            )
            # r.status_code concerne l'appel API lui-même.
            # Le statut propre de la cible est dans x-brd-status-code.
            status = r.headers.get("x-brd-status-code", str(r.status_code))
            if status == "200" and r.text:
                return r.text
            last_error = f"{status} {r.headers.get('x-brd-error-code')}"
        except requests.RequestException as exc:
            last_error = type(exc).__name__
        if attempt < attempts - 1:
            time.sleep(2 ** attempt)
    raise FetchError(f"{url}: {last_error}")
Dans un test séparé sur 30 pages d’entreprises Yelp, unlock() a chargé chaque page.
Analyser les détails d’entreprise depuis le cache Apollo
Ajoutez ce parser à yelp_scraper.py. Il extrait le cache Apollo, trouve l’entreprise concernée par la page, et aplatit ses champs en un seul enregistrement :
def embedded_json(page, marker, escaped):
"""Renvoie le JSON que Yelp enveloppe dans <!-- --> à l'intérieur d'une balise <script>."""
m = re.search(
r"<script[^>]*" + marker + r"[^>]*>\s*<!--(.*?)-->\s*</script>",
page,
re.S,
)
if not m:
raise FetchError(f"{marker} manquant : blocage doux ou changement de balisage")
raw = html.unescape(m.group(1)) if escaped else m.group(1)
return json.loads(raw)
def apollo_state(page):
# Le cache Apollo était échappé en HTML (") dans un commentaire HTML.
return embedded_json(page, "data-apollo-state", escaped=True)
def parse_business(page):
state = apollo_state(page)
ref = next(v["__ref"] for k, v in state["ROOT_QUERY"].items()
if k.startswith("business("))
biz = state[ref]
loc = state[biz["location"]["__ref"]]
claim = next((v for k, v in biz.items()
if k.startswith("claimability(")), None) or {}
website = (biz.get("externalResources") or {}).get("website") or {}
return {
"encid": biz["encid"],
"alias": biz["alias"],
"name": biz["name"],
"rating": biz["rating"],
"review_count": biz["reviewCount"],
"price_range": (biz.get("priceRange") or {}).get("display"),
"phone": (biz.get("phoneNumber") or {}).get("formatted"),
"address": loc["address"]["formatted"].replace("\n", ", "),
"neighborhoods": loc.get("neighborhoods"),
"categories": [state[c["__ref"]]["title"] for c in biz["categories"]],
"is_claimed": claim.get("isClaimed"),
"is_closed": biz.get("isClosed"),
"website": website.get("url"),
}
def get_business(url):
return parse_business(unlock(url))Apollo stocke les objets liés une seule fois et pointe vers eux avec des clés __ref, donc le parser suit location et categories jusqu’à leurs propres entrées. Certaines clés incluaient leurs arguments de requête, comme claimability({"useConsumerClaimability":true}), donc le code fait correspondre ces clés par préfixe. Le parser a lu les 19 pages d’entreprises sauvegardées sans erreur.
Scraper les avis Yelp depuis l’API GraphQL
Pour scraper les avis Yelp, envoyez une requête avec l’encid de l’entreprise, le documentId persisté, et les variables attendues par la requête. La partie suivante de yelp_scraper.py construit elle-même le curseur de décalage, afin que chaque page après la première s’exécute en parallèle. Le curseur de Yelp contenait le décalage du dernier avis de la page précédente, donc review_page() passe start - 1 :
def review_cursor(offset):
    # Le curseur "after" de Yelp est du JSON base64 avec un décalage numérique à l'intérieur.
    raw = json.dumps({"version": 1, "type": "offset", "offset": offset},
                     separators=(",", ":"))
    return base64.b64encode(raw.encode()).decode()


def review_page(encid, start, sort_by="DATE_DESC"):
    variables = {
        "encBizId": encid,
        "reviewsPerPage": PAGE_SIZE,
        "after": review_cursor(start - 1) if start else None,
        "sortBy": sort_by,  # RELEVANCE_DESC, DATE_DESC, DATE_ASC, ...
        "ratings": [5, 4, 3, 2, 1],
        "queryText": "",
        "isSearching": False,
        "selectedReviewEncId": "",
        "hasSelectedReview": False,
        "isTranslating": False,
        "translateLanguageCode": "en",
        "isHighlighting": False,
        "highlightType": "",
        "highlightIdentifier": "",
        "photoSize": "SQUARE_348",
        "fetchMediaReviewContent": False,
        "eliteAllStarSourceFlow": "biz_page_review_feed",
        "reactionsSourceFlow": "businessPageReviewSection",
        "minConfidenceLevel": "HIGH_CONFIDENCE",
    }
    body = [{
        "operationName": "GetBusinessReviewFeed",
        "variables": variables,
        "extensions": {"operationType": "query",
                       "documentId": REVIEW_FEED_DOC_ID},
    }]
    try:
        raw = unlock("https://www.yelp.com/gql/batch", method="POST",
                     body=body)
    except FetchError as exc:
        # Via Web Unlocker, un documentId inconnu renvoyait
        # 502 http_status, donc le message suggère d'actualiser l'ID.
        raise FetchError(f"{exc} (documentId obsolète ? exécutez refresh_doc_id.py)")
    result = json.loads(raw)[0]
    # Les erreurs GraphQL peuvent être renvoyées dans une réponse HTTP 200.
    if result.get("errors"):
        raise FetchError(result["errors"][0]["message"])
    return result["data"]["business"]["reviews"]


def flatten_review(node):
    author = node.get("author") or {}
    # Les champs d'auteur sont des données personnelles, à retirer si vous n'avez besoin que du sentiment.
    return {
        "review_id": node["encid"],
        "rating": node["rating"],
        "created_at": node["createdAt"]["localDateTimeForBusiness"],
        "text": (node.get("text") or {}).get("full"),
        "language": (node.get("text") or {}).get("language"),
        "author": author.get("displayName"),
        "author_location": author.get("displayLocation"),
        "author_review_count": author.get("reviewCount"),
    }


def get_reviews(encid, max_reviews=None, workers=4):
    first = review_page(encid, 0)
    total = first["totalCount"]
    if max_reviews:
        total = min(total, max_reviews)
    reviews = [e["node"] for e in first["edges"]]
    # Les décalages sont connus à l'avance, donc les pages restantes s'exécutent en parallèle.
    starts = range(PAGE_SIZE, total, PAGE_SIZE)
    with ThreadPoolExecutor(workers) as pool:
        for page in pool.map(lambda s: review_page(encid, s), starts):
            reviews += [e["node"] for e in page["edges"]]
    unique = {r["encid"]: flatten_review(r) for r in reviews}
    return list(unique.values())[:total], first["totalCount"]
get_reviews() a collecté les 582 avis recommandés de Ziziki’s en 12 appels GraphQL, et les dates d’avis couvraient environ 20 ans.
Le navigateur envoyait aussi un ID visiteur guv et une valeur languageCode. L’API GraphQL n’exigeait ni l’un ni l’autre dans nos tests, donc le code ne les envoie pas.
La valeur created_at est dans le fuseau horaire local de l’entreprise, avec un décalage tel que -05:00 ou -06:00 pour Dallas, selon l’heure d’été. Avant de comparer les dates d’avis entre villes, conservez le décalage lors du stockage de chaque valeur, ou convertissez-le en UTC.
Découvrir des entreprises depuis les résultats de recherche
Les fonctions vues jusqu’ici partent d’une URL d’entreprise que vous avez déjà. Les pages de recherche donnent les URLs d’entreprises pour get_business() et les valeurs encid pour get_reviews(). Ajoutez aussi les fonctions de recherche à yelp_scraper.py. Le parser relie chaque carte organique à son enregistrement Apollo et ignore les cartes sponsorisées :
def parse_search(page):
    props = embedded_json(page, "data-hypernova-key", escaped=False)
    comps = (props["legacyProps"]["searchAppProps"]["searchPageProps"]
             ["mainContentComponentsListProps"])
    state = apollo_state(page)
    hits = []
    for comp in comps:
        section = comp.get("props") or {}
        if comp.get("type") != "searchResultSection":
            continue
        for item in section.get("searchResults", []):
            if item.get("isAd"):
                continue  # ignorer les cartes sponsorisées
            # Prend les détails dans le cache Apollo ; les cartes organiques peuvent en manquer.
            biz = state.get(f"Business:{item['bizId']}", {})
            hits.append({
                "rank": item.get("ranking"),
                "encid": item["bizId"],
                "name": biz.get("name"),
                "rating": biz.get("rating"),
                "review_count": biz.get("reviewCount"),
                "url": "https://www.yelp.com"
                       + item["businessUrl"].split("?")[0],
            })
    paging = next(c["props"] for c in comps if c.get("type") == "pagination")
    return hits, paging["totalResults"]


def search(term, location, pages=1):
    query = urllib.parse.urlencode({"find_desc": term, "find_loc": location})
    base = f"https://www.yelp.com/search?{query}"
    hits = []
    for n in range(pages):
        # La page 1 n'a pas de paramètre start, comme un navigateur la charge.
        url = f"{base}&start={n * 10}" if n else base
        batch, total = parse_search(unlock(url))
        hits += batch
        if (n + 1) * 10 >= total:
            break
    return hits
search() envoie la page 1 sans start, comme un navigateur charge d’abord une recherche. Elle s’arrête à la dernière page que totalResults permet, donc une requête qui atteint la limite de 240 résultats de Yelp nécessite 24 pages.
Exécuter le scraper Yelp
Le dernier bloc de yelp_scraper.py exécute les étapes dans l’ordre. Il récupère 2 pages de recherche, 1 page d’entreprise, et les 150 avis les plus récents de cette entreprise, et écrit les avis dans un fichier JSON Lines :
if __name__ == "__main__":
    hits = search("Pizza", "Lower Manhattan, New York, NY", pages=2)
    print(f"{len(hits)} résultats organiques")
    for hit in hits[:3]:
        print(hit["rank"], hit["name"], hit["rating"], hit["review_count"])

    business = get_business(hits[0]["url"])
    print(json.dumps(business, indent=2, ensure_ascii=False))

    reviews, reported = get_reviews(business["encid"], max_reviews=150)
    print(f"{len(reviews)} avis collectés sur {reported}")
    for r in reviews[:2]:
        print(r["created_at"], r["rating"], r["text"][:60])

    with open("reviews.jsonl", "w") as f:
        for row in reviews:
            f.write(json.dumps({"business": business["alias"], **row}) + "\n")
Exécutez le script depuis le répertoire où vous l’avez sauvegardé. La première ligne ne s’affiche qu’une fois que les deux pages de recherche sont chargées :
python yelp_scraper.pyL’exécution a affiché les meilleurs résultats de recherche, la fiche d’entreprise, et les 2 premiers avis :
20 résultats organiques
1 L’industrie Pizzeria 4.5 1222
2 Prince Street Pizza 4.3 5720
3 Juliana's 4.4 2997
{
  "encid": "G9hV4H2iGpWD8RoUpjtokg",
  "alias": "l-industrie-pizzeria-new-york",
  "name": "L’industrie Pizzeria",
  "rating": 4.5,
  "review_count": 1222,
  "price_range": "$$",
  "phone": "(212) 256-0648",
  "address": "104 Christopher St, New York, NY 10014",
  "neighborhoods": [
    "West Village"
  ],
  "categories": [
    "Pizza"
  ],
  "is_claimed": false,
  "is_closed": false,
  "website": "http://lindustriebk.com"
}
150 avis collectés sur 1220
2026-09-25T20:43:26-04:00 4 I arrived here on a Saturday afternoon and man what a line.
2026-09-25T20:37:09-04:00 4 The pizza was like 4.25/5, I came with locals and they said
L’exécution a utilisé 7 requêtes facturables (2 pour les pages de recherche, 1 pour la page d’entreprise, et 4 pour les appels GraphQL). La page d’entreprise indiquait 1 222 avis, tandis que le totalCount de l’API GraphQL était 1 220. Comparez votre nombre de lignes avec totalCount, et non avec le nombre affiché sur la page, pour vérifier qu’une exécution est complète.
Actualiser l’ID de requête persistée lors des déploiements de Yelp
Quand les appels d’avis commencent à échouer avec 502 http_status alors que les pages d’entreprises se chargent toujours, le documentId a probablement changé. Enregistrez ce script sous refresh_doc_id.py. Il ouvre une seule page d’entreprise dans le Browser API et fait défiler jusqu’à ce que la page envoie la requête GraphQL pour les avis. Il affiche l’ID de cette requête, ou None après 30 défilements sans résultat :
import asyncio
import json
import os

from playwright.async_api import async_playwright

# Point de terminaison Browser API depuis l'onglet Overview de la zone, avec -country-us ajouté.
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
BIZ_URL = "https://www.yelp.com/biz/zizikis-dallas-2"


async def capture_review_feed_doc_id():
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()
        found = asyncio.get_running_loop().create_future()

        def on_request(request):
            if (request.url.endswith("/gql/batch")
                    and "GetBusinessReviewFeed" in (request.post_data or "")
                    and not found.done()):
                ops = json.loads(request.post_data)
                op = next(o for o in ops
                          if o["operationName"] == "GetBusinessReviewFeed")
                found.set_result(op["extensions"]["documentId"])

        page.on("request", on_request)
        await page.goto(BIZ_URL, wait_until="domcontentloaded",
                        timeout=120_000)
        # Fait défiler jusqu'à ce que la page envoie la requête GraphQL pour les avis.
        for _ in range(30):
            if found.done():
                break
            await page.mouse.wheel(0, 1200)
            await page.wait_for_timeout(1500)
        await browser.close()
        return found.result() if found.done() else None


if __name__ == "__main__":
    print(asyncio.run(capture_review_feed_doc_id()))
Installez Playwright avec pip install playwright, et créez une zone Browser API en suivant le guide de démarrage rapide de Browser API de Bright Data. Puis définissez BRIGHTDATA_BROWSER_WSS sur le point de terminaison de la zone, et ajoutez -country-us au nom d’utilisateur. La valeur a la forme wss://brd-customer-<id>-zone-<zone>-country-us:<password>@brd.superproxy.io:9222. L’exécution a affiché l’ID déjà utilisé par le scraper :
2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692Quand l’ID affiché diffère, exportez-le en tant que YELP_REVIEW_FEED_DOC_ID et relancez yelp_scraper.py.
Le Browser API facture par Go de trafic, et 6 chargements de pages d’entreprises Yelp ont pesé en moyenne environ 8 Mo chacun. Web Unlocker facture par requête réussie. Utilisez le Browser API uniquement pour l’actualisation occasionnelle du documentId, et envoyez les requêtes de pages et d’avis via Web Unlocker.
Dépanner les erreurs courantes
Associez ce que vous voyez à une cause probable :
| Ce que vous voyez | Cause probable | Que faire |
|---|---|---|
FetchError avec 401 None ou 400 None |
Une mauvaise clé API (401) ou un nom de zone incorrect (400) | Vérifiez BRIGHTDATA_API_KEY, et définissez BRIGHTDATA_UNLOCKER_ZONE sur le nom exact de la zone |
FetchError avec ub_bad_endpoint_robots, ou brob depuis le Browser API |
Le compte est en mode d’accès immédiat (sans KYC), qui respecte le robots.txt de Yelp | Complétez la vérification KYC, ou demandez l’accès complet à votre gestionnaire de compte |
FetchError avec data-apollo-state missing ou data-hypernova-key missing |
Un blocage doux (une page de blocage renvoyée avec HTTP 200) ou un changement de balisage | Sauvegardez le HTML renvoyé par unlock() et recherchez-y la balise <script> nommée dans l’erreur |
Les appels d’avis échouent avec 502 http_status alors que les pages d’entreprises se chargent |
Un nouveau documentId |
Exécutez refresh_doc_id.py et exportez l’ID qu’il affiche |
FetchError avec un message de validation GraphQL |
Une variable manquante ou hors plage | Comparez vos variables avec le payload de la page dans DevTools |
Toute autre FetchError depuis unlock() |
La requête a échoué aux 3 tentatives | Réessayez l’URL plus tard, ou augmentez attempts dans unlock() |
Champs vides, ou KeyError ou StopIteration dans un parser |
Une clé renommée dans le JSON de Yelp | Comparez le JSON de la page avec les clés que le parser lit |
Passer à l’échelle avec le Yelp Scraper API de Bright Data
Quand vous écrivez votre propre scraper, vous le maintenez aussi. L’ID de requête persistée, la liste des variables et les parsers dépendent tous du frontend de Yelp, donc chacun peut se casser quand Yelp publie des changements frontend.
Le Yelp Scraper API, qui fait partie du Web Scraper API de Bright Data, prend des URLs Yelp ou des filtres de recherche et renvoie des enregistrements analysés. Bright Data maintient les parsers à mesure que le frontend de Yelp change. Bright Data propose aussi un scraper d’images Yelp dédié et un serveur MCP Yelp pour les agents IA.
Le Yelp Scraper API peut aussi collecter les avis non recommandés, que la requête GetBusinessReviewFeed ne renvoyait pas dans nos tests. Le logiciel de Yelp n’a pas recommandé 17% des avis publiés en 2025, selon son rapport de confiance et sécurité 2025.
Exécuter le Yelp Scraper API depuis Python
Dans le panneau de contrôle, la bibliothèque de scrapers liste les points de terminaison Yelp. Les points de terminaison d’entreprises acceptent des URLs, des filtres de recherche ou une zone géographique en entrée, et les points de terminaison d’avis acceptent des URLs d’entreprises ou des filtres de recherche. Chaque point de terminaison accepte une liste d’entrées et s’exécute en mode synchrone ou asynchrone :
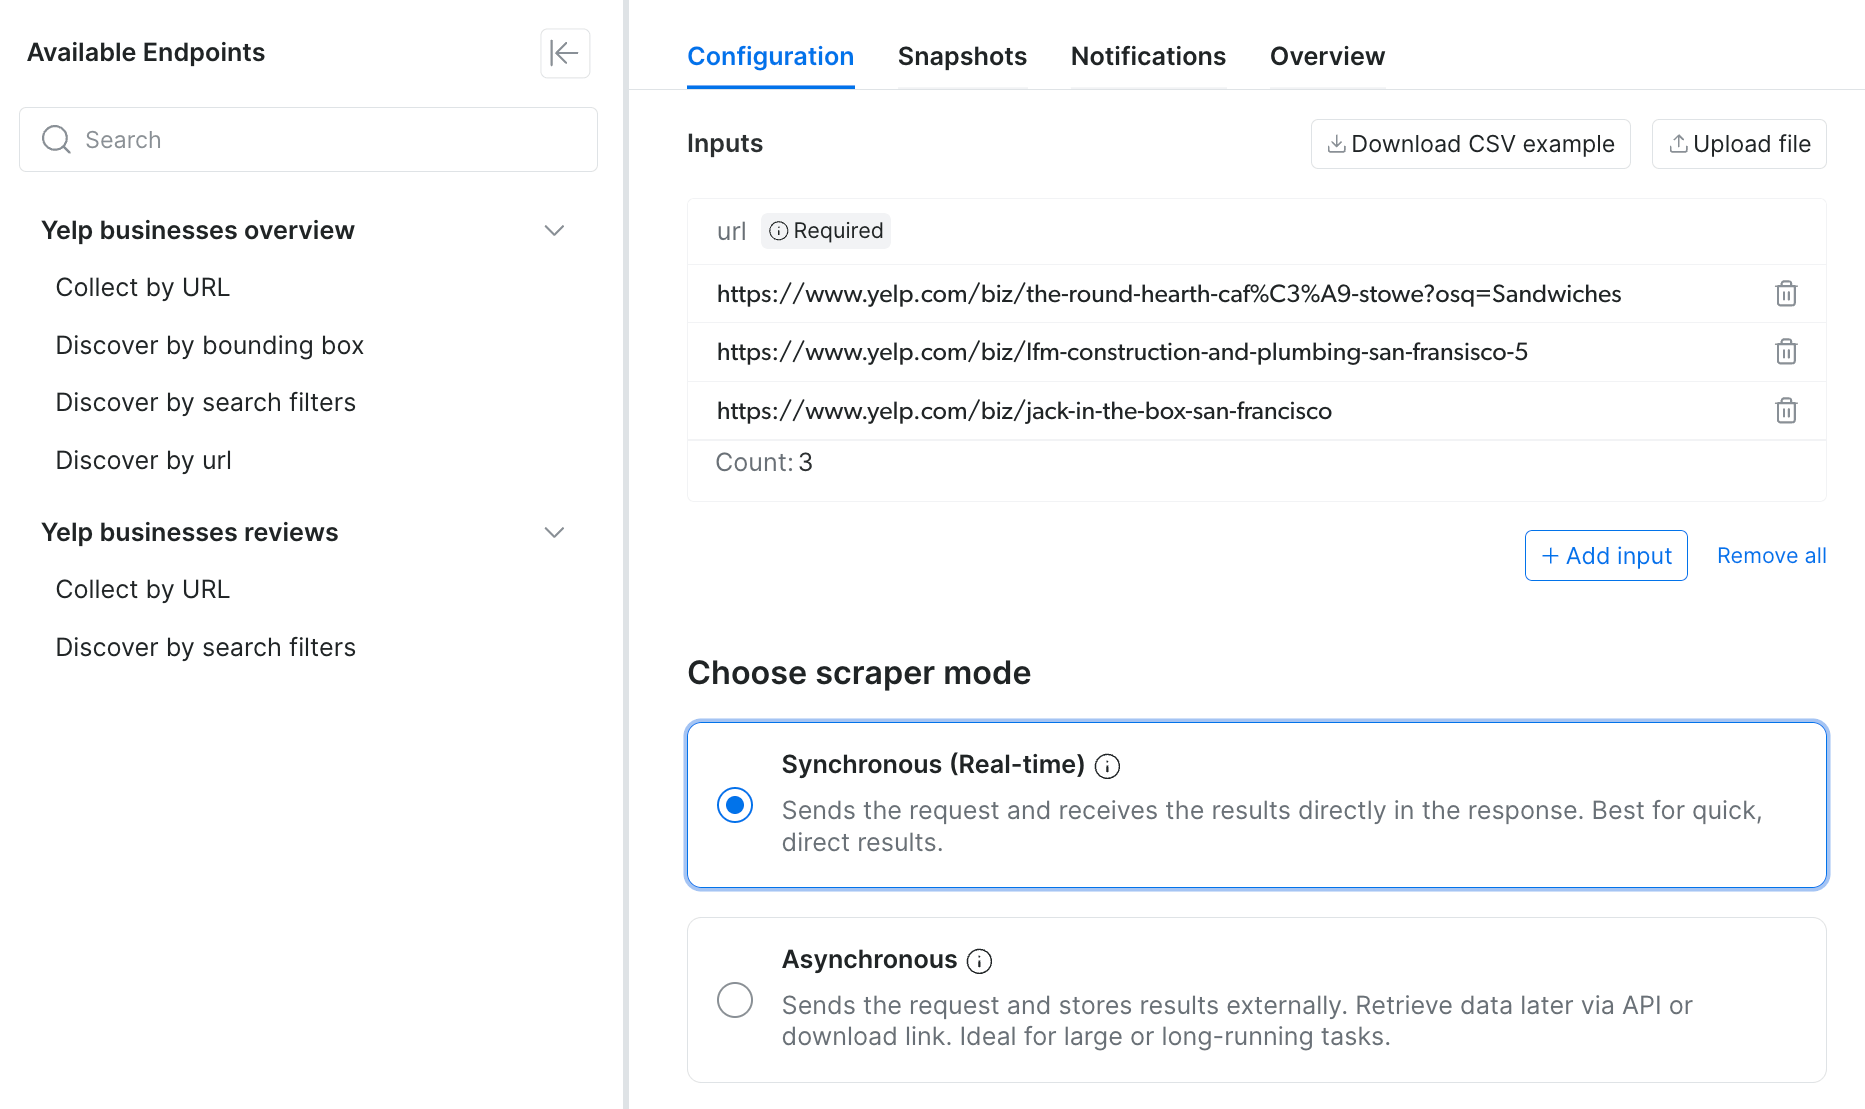
Le point de terminaison Collect by URL pour les fiches d’entreprises, avec 3 entrées d’exemple et le mode Synchrone sélectionné. Un appel synchrone qui dépasse sa limite de 1 minute renvoie un ID de snapshot au lieu d’enregistrements, donc scraper_api.py s’exécute en mode asynchrone.
Vous pouvez exécuter les mêmes scrapers depuis Python via le point de terminaison de déclenchement asynchrone. Enregistrez ce script sous scraper_api.py. Il n’a besoin que de BRIGHTDATA_API_KEY, car les appels du Scraper API n’utilisent pas de zone. Il exécute une recherche de découverte pour pizza à Brooklyn, NY, puis collecte les 20 avis les plus récents du premier résultat :
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}

YELP_BUSINESSES = "gd_lgugwl0519h1p14rwk"
YELP_REVIEWS = "gd_lgzhlu9323u3k24jkv"


def collect(dataset_id, inputs, limit_per_input=None, poll_every=15,
            **params):
    """Déclenche un job Scraper API, attend sa fin, et renvoie ses enregistrements."""
    body = {"input": inputs}
    if limit_per_input:
        body["limit_per_input"] = limit_per_input
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": dataset_id, "include_errors": "true",
                **params},
        json=body,
        timeout=60,
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]

    while True:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=60).json()
        if progress["status"] == "ready":
            break
        if progress["status"] in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id}: {progress}")
        time.sleep(poll_every)

    records = requests.get(f"{API}/snapshot/{snapshot_id}",
                           headers=HEADERS, params={"format": "json"},
                           timeout=120).json()
    # Avec include_errors=true, les entrées échouées sont renvoyées comme enregistrements d'erreur.
    errors = [x for x in records if x.get("error")]
    rows = [x for x in records if not x.get("error")]
    return rows, errors


if __name__ == "__main__":
    rows, errors = collect(
        YELP_BUSINESSES,
        [{"country": "US", "category": "Pizza",
          "location": "Brooklyn, NY, United States"}],
        limit_per_input=5,
        type="discover_new",
        discover_by="search_filters",
    )
    for row in rows:
        print(row["name"], row["overall_rating"], row["reviews_count"],
              row["url"])
    print(f"{len(rows)} entreprises, {len(errors)} erreurs")
    if not rows:
        raise SystemExit("la découverte n'a renvoyé aucune entreprise")

    reviews, errors = collect(
        YELP_REVIEWS,
        [{"url": rows[0]["url"], "unrecommended_reviews": False,
          "sort_by": "DATE_DESC"}],
        limit_per_input=20,
    )
    print(f"{len(reviews)} avis, {len(errors)} erreurs")
    for r in reviews[:1]:
        print(r["date_iso_format"], r["Rating"], r["Content"][:120])
YELP_BUSINESSES et YELP_REVIEWS sont les IDs de jeux de données des scrapers Yelp de Bright Data, affichés dans les exemples d’API de chaque scraper dans le panneau de contrôle. collect() vérifie la progression de chaque job toutes les 15 secondes et renvoie ses enregistrements une fois le job prêt. Pour chaque entreprise découverte, le script affiche le nom, la note, le nombre d’avis et l’URL. Il affiche ensuite le nombre d’avis et la date, la note et les 120 premiers caractères du texte du premier avis.
Le Yelp Scraper API facture uniquement les livraisons réussies. limit_per_input définit le nombre maximum d’enregistrements par entrée. Ce script utilise 5 pour les entreprises et 20 pour les avis, donc une exécution de test sur une entreprise avec 5K avis n’est pas facturée pour 5K enregistrements. Les entrées qu’un job n’a pas pu collecter sont renvoyées comme enregistrements d’erreur qui incluent leur entrée, prêts à être soumis à nouveau.
Configurer les jobs d’avis et mapper leurs champs
Ces 3 détails affectent les enregistrements qu’un job renvoie et la façon dont vous les lisez :
unrecommended_reviewssélectionnait 1 des 2 ensembles d’avis. Avectrue, un job ne renvoyait que les avis non recommandés (recommended_review: false). Pour collecter les deux ensembles, envoyez l’URL de l’entreprise une fois avec chaque valeur. Laissez la plage de dates vide sur l’entréetruepour collecter les avis non recommandés de toutes les dates.- Les filtres de date sur les avis recommandés correspondaient au nombre GraphQL. Avec
unrecommended_reviewsdéfini àfalseet une plage de dates destart_dateàend_date, le job a renvoyé 6 avis. Le scraper GraphQL en a trouvé les mêmes 6 pour cette plage. - Les étiquettes de réaction de Yelp ont changé au fil du temps. Les enregistrements récents utilisaient
Helpful,Thanks,Love this, etOh no, tandis que les anciens avis Yelp utilisaientuseful,funny, etcool. Mappez les deux ensembles avant de comparer les réactions entre les années.
Pour les jobs récurrents, le Yelp Scraper API livre vers un webhook, Amazon S3, Google Cloud Storage, Google Pub/Sub, Microsoft Azure Storage, Snowflake, ou SFTP.
API Yelp, scraper ou jeu de données : le coût de 1K entreprises
Le bon choix dépend du besoin de texte d’avis complet et de qui maintient la collecte de données. Ce tableau montre le coût d’une seule charge de travail, 1K entreprises avec 200 avis chacune, aux prix catalogue au moment de notre vérification :
| Option | Texte d’avis complet | Coût pour 1K entreprises et 200K avis | Votre travail continu |
|---|---|---|---|
| Yelp Places API, plan Enhanced | Non, 3 extraits d’environ 160 caractères | 299 $ par mois, dans les 30K appels inclus | Suivre les règles d’affichage et la limite de mise en cache de 24 heures |
| Yelp Insights API, plan Premium | Oui | Devis personnalisé de l’équipe commerciale de Yelp, à partir de 0,08 $ par emplacement sur une base glissante de 12 mois | Suivre les conditions contractuelles de Yelp |
| Votre propre scraper sur Web Unlocker | Oui, avis recommandés | 9 $ pour 6K requêtes (1K pages d’entreprises et 5K appels GraphQL) à 1,5 $ pour 1K | Mettre à jour l’ID de requête persistée, les variables, et les parsers quand le frontend de Yelp change |
| Bright Data Yelp Scraper API | Oui, recommandés et non recommandés | 301,50 $ pour 201K enregistrements à 1,5 $ pour 1K | Gérer les listes d’entrées et la livraison |
| Jeux de données Yelp de Bright Data | Oui, pré-collectés | Jusqu’à 502,50 $ pour 201K enregistrements à jusqu’à 0,0025 $ par enregistrement (commande minimum de 250 $) | Aucun travail de collecte, actualisation mensuelle des données |
Le chiffre de Web Unlocker est bas car chaque appel GraphQL renvoyait jusqu’à 49 avis, et Web Unlocker facture uniquement les requêtes réussies. Le Yelp Scraper API facture par enregistrement, donc les jobs avec de nombreux avis coûtent plus cher. Pour ce prix, vous ne dépensez pas de temps d’ingénierie sur les parsers ou les IDs de requête persistée.
La découverte ajoute un coût avec les deux options. Sur Web Unlocker, vous payez pour les pages de recherche, qui affichaient 10 résultats chacune. Sur le Yelp Scraper API, vous payez pour les enregistrements de découverte.
Les jeux de données Yelp de Bright Data fonctionnent bien pour les remplissages historiques. Ils incluent plus de 200M d’enregistrements d’avis et plus de 9M d’enregistrements d’entreprises. Un jeu de données séparé de restaurants Yelp est aussi disponible.
Chaque page de jeu de données dans le panneau de contrôle affiche les champs, le prix, et un échantillon de données avant achat :
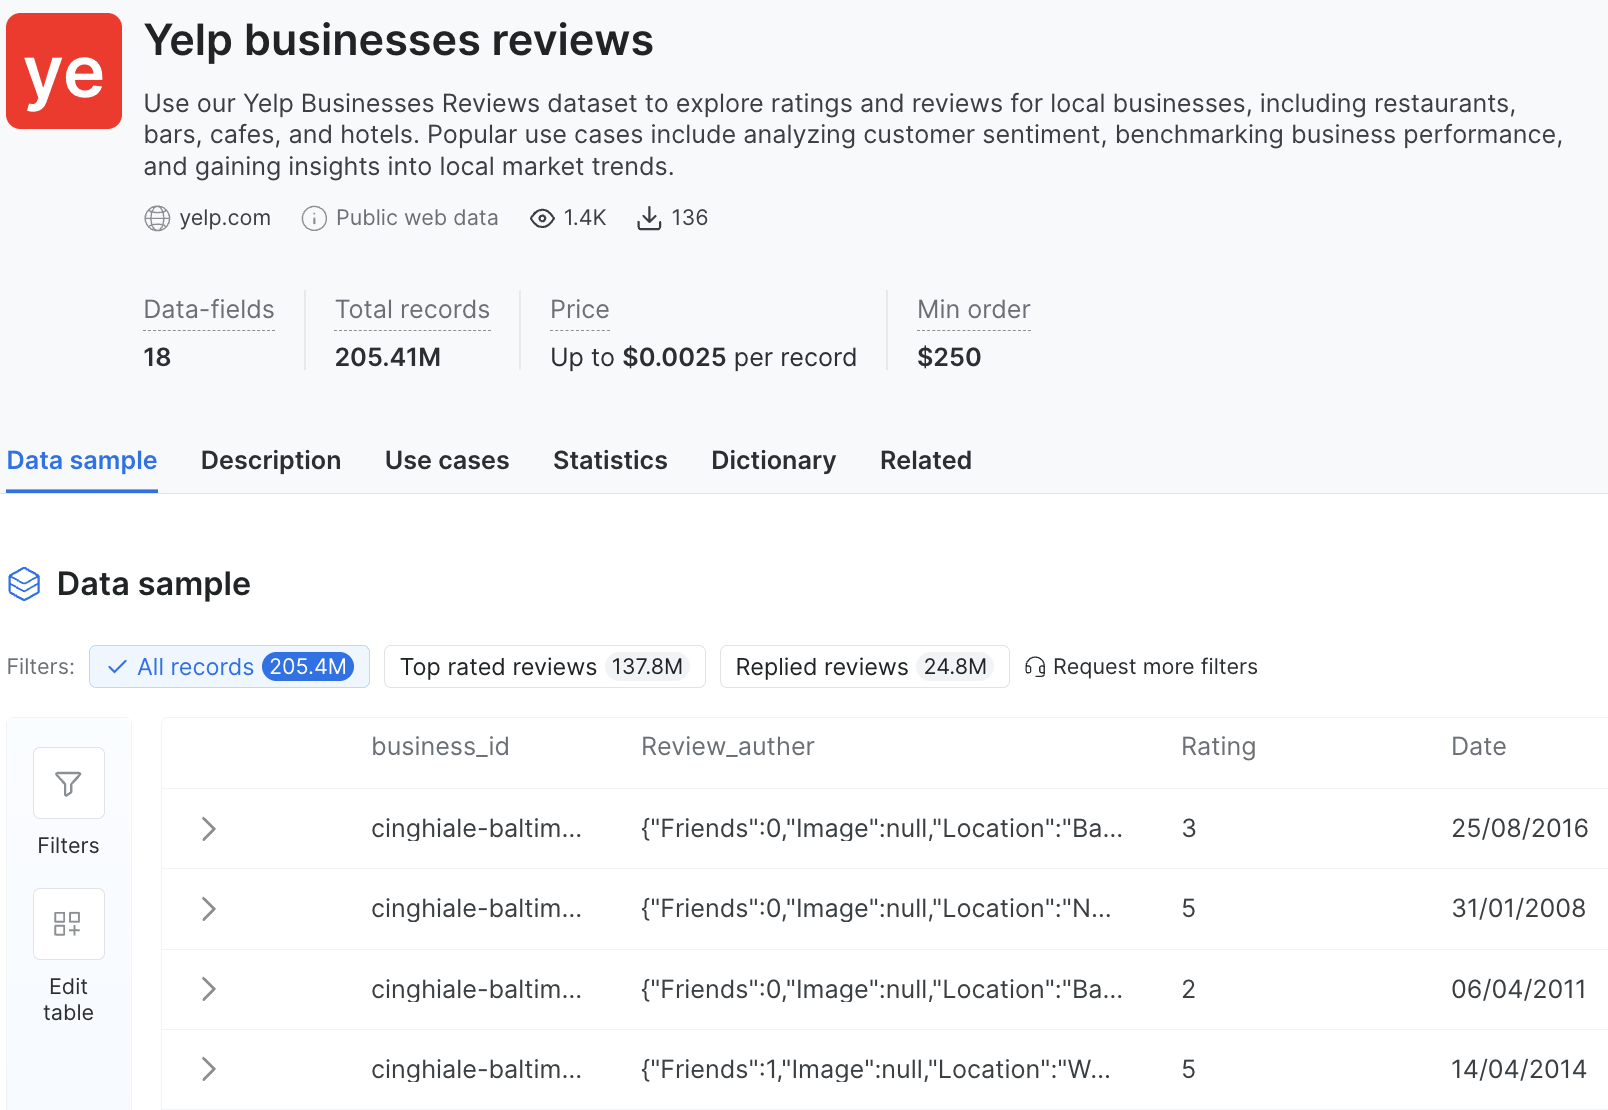
Le jeu de données des avis d’entreprises Yelp. À jusqu’à 0,0025 $ par enregistrement, la commande minimum de 250 $ achète au moins 100K avis.
Conclusion
Scraper Yelp en Python a fonctionné dans nos tests une fois que chaque requête utilisait Web Unlocker et que les avis provenaient de l’API GraphQL, et non du HTML. L’ID de requête persistée peut changer lors des déploiements de Yelp, donc si les appels d’avis commencent à échouer, exécutez d’abord refresh_doc_id.py. Le Yelp Scraper API de Bright Data gère la maintenance du parser et ajoute les avis non recommandés, à un prix par avis plus élevé. Les jeux de données Yelp de Bright Data fournissent des données historiques pour les remplissages. Commencez sur le niveau gratuit de Bright Data avec une entreprise que vous connaissez, et comparez le nombre de lignes de yelp_scraper.py avec totalCount avant de l’exécuter sur plus d’entreprises.
FAQ
Comment scraper les avis Yelp ?
Demandez-les depuis le point de terminaison GraphQL de Yelp, /gql/batch, avec l’ID de requête persistée GetBusinessReviewFeed, car le HTML de la page d’entreprise ne contenait aucun texte d’avis complet dans nos tests. Chaque appel renvoyait jusqu’à 49 avis. Routez les appels via le Web Unlocker API de Bright Data, car DataDome, la protection anti-bot de Yelp, a bloqué les clients HTTP Python que nous avons testés.
L’API Yelp donne-t-elle tous les avis ?
Non, pas au moment de notre vérification. La documentation de Yelp listait 3 extraits d’avis de la Places API sur Enhanced et jusqu’à 7 sur Premium, chacun d’environ 160 caractères. Le texte complet était disponible depuis le plan Premium de la Yelp Insights API ou depuis l’API GraphQL qu’utilise yelp.com, qui renvoyait les avis recommandés. Le Yelp Scraper API de Bright Data renvoie aussi le texte complet, y compris les avis non recommandés.
Puis-je utiliser l’API Yelp gratuitement ?
Seulement pour l’évaluation. La documentation de Yelp listait 5K appels gratuits de la Places API pendant un essai de 30 jours, et les appels d’essai n’étaient pas destinés à un usage commercial. Les plans payants commençaient à 229 $ par mois pour le plan Base, qui n’incluait aucun extrait d’avis ni photo.
Combien coûte l’API Yelp Fusion ?
La page tarifaire de Yelp listait la Places API (aussi appelée Fusion) à 229 $ par mois pour Base, 299 $ pour Enhanced, et 643 $ pour Premium. Chaque plan incluait par défaut 30K appels par mois, et les appels supplémentaires coûtaient de 5,91 $ à 14,13 $ pour 1K, selon le plan.
Existe-t-il un scraper Yelp gratuit ?
Oui, les scrapers Yelp open source sont gratuits, mais dans nos tests, DataDome, la protection anti-bot de Yelp, bloquait les clients HTTP Python. Le niveau gratuit de Bright Data inclut 5K crédits par mois, suffisant pour 5K enregistrements du Yelp Scraper API. Les requêtes Web Unlocker vers Yelp nécessitent un compte avec accès complet.
Les sites web peuvent-ils détecter le scraping ?
Oui. Les services de protection anti-bot peuvent vérifier les empreintes TLS, les IPs, et l’exécution JavaScript, et Yelp utilisait DataDome dans nos tests. Les clients HTTP Python ont obtenu des pages de défi 403 à chaque requête de test, même avec des empreintes TLS de navigateur et des IPs résidentielles américaines. Les 30 pages d’entreprises testées se sont chargées via le Web Unlocker API de Bright Data.