Pour la surveillance des prix, scraper les produits Target à grande échelle signifie lire les prix et stocks des magasins depuis des API JSON internes plutôt que le HTML des pages.
Dans nos tests, un paquet de 31 dosettes Tide coûtait 9,99 $ à Cedar Rapids et 12,69 $ à Chicago au même moment. Certaines réponses semblaient valides mais contenaient un prix en ligne ou une fourchette de prix d’un produit parent. Depuis des IP américaines, seulement 1 appel API produit sur 112 depuis des clients curl et Python avec paramètres par défaut a réussi.
Ce guide vous montre comment collecter ces prix, détecter les mauvaises réponses, et décider s’il faut construire un scraper ou utiliser un Target Price Scraper.
TL;DR
- Demandez les prix par ID de magasin. Associez les codes postaux aux ID de magasin, puis appelez l’API produit de Target avec sa clé API publique.
- Vérifiez l’emplacement et la variante de chaque prix. L’emplacement 3991 indique un prix en ligne, et un produit parent peut renvoyer une fourchette, donc enregistrez 1 ligne par variante.
- Trouvez les blocages dans le corps des réponses. Les appels bloqués renvoyaient le code HTTP 435, parfois sous forme de JSON valide.
- Choisissez l’outil selon votre suivi des emplacements. Pour les codes postaux, le Target Scraper API de Bright Data correspondait à notre scraper dans 20 vérifications sur 20. Pour les ID de magasin ou le stock par canal, exécutez votre code sur le Web Unlocker API.
Comment Target diffuse les données produit
Dans nos tests, un scraper pouvait lire les prix, stocks et détails produit depuis 3 hôtes Target. Le HTML de la page produit était la seule source sans prix. Target identifie chaque produit par un TCIN (Target.com Item Number), le numéro après A- dans l’URL d’un produit.
Les 3 hôtes étaient derrière le CDN Fastly de Target. Sur les hôtes www et redsky, la vérification anti-bot de HUMAN Security pouvait bloquer une requête et renvoyer une réponse de blocage au lieu de données :
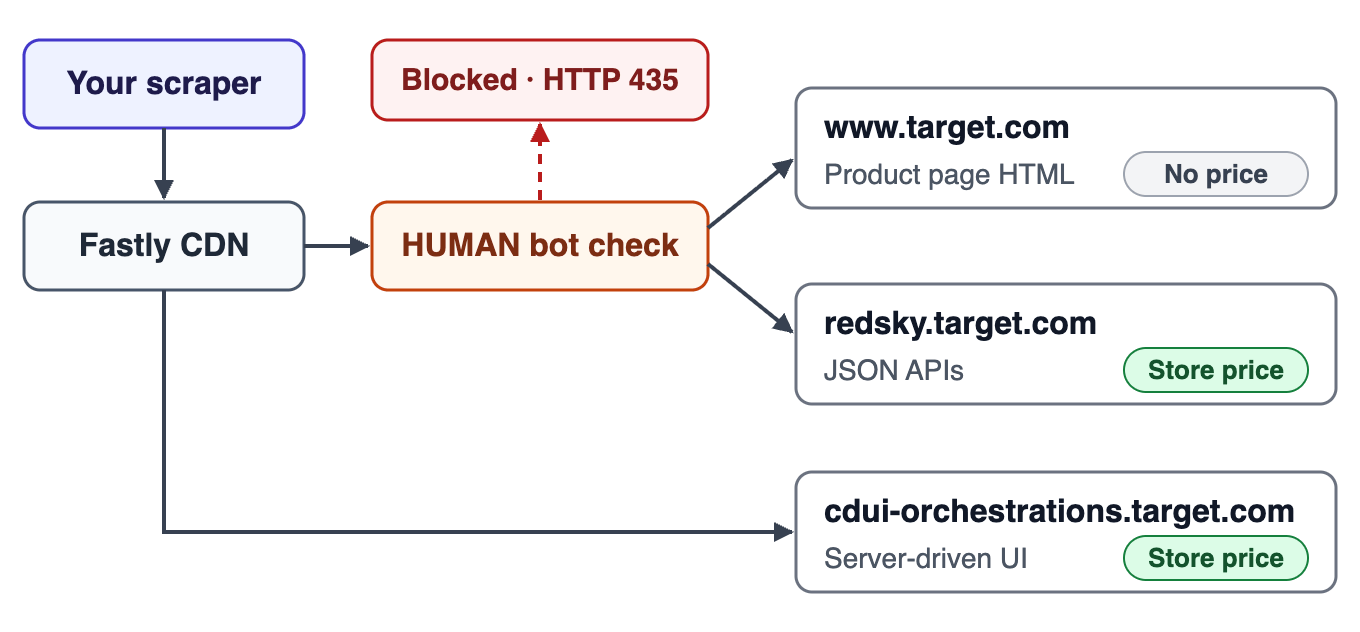
Dans nos tests, le HTML de la page n’avait pas de prix, tandis que les API JSON et les modules d’interface pilotés par le serveur avaient le prix du magasin.
Le HTML de la page n’avait pas de prix
La page produit était une application Next.js. Son script __NEXT_DATA__ contenait le titre, la description, les images et un résumé des avis, mais pas de prix. Les props de page contenaient isProductDetailServerSideRenderPriceEnabled: false dans chaque page que nous avons récupérée avec curl, que l’agent utilisateur soit curl, python-requests, Chrome ou HeadlessChrome. Si ce flag devient true, le HTML peut inclure des prix, donc vérifiez le flag avant d’analyser le HTML.
Les mêmes props étiquetaient chaque visiteur avec des flags isBot, isAiAgent et isSeoPhantom. Les requêtes prétendant être un robot de moteur de recherche, comme Googlebot, recevaient une page différente et mise en cache avec du JSON-LD schema.org et un prix affiché.
Ce prix appartenait à un unique emplacement par défaut. Les moteurs de recherche publient comment vérifier leurs robots via le DNS inversé, pour qu’un site puisse détecter un robot usurpé. Pour les prix des magasins, utilisez les API JSON ci-dessous plutôt que cette page.
Les prix et stocks provenaient des API JSON
L’API d’agrégation de Target sur redsky.target.com renvoie les prix par magasin. Chaque point d’accès que nous avons appelé nécessitait un paramètre key. Sans la clé, l’API renvoyait 401 avec "no API key found in request".
La clé est une clé API publique, pas un secret. Elle apparaissait 28 fois dans chaque page produit que nous avons sauvegardée, sauf la page mise en cache reçue par les robots. Lisez-la depuis une page Target, comme la page d’accueil, plutôt que de la coder en dur.
Lors de notre vérification, le fichier robots.txt de l’hôte API interdisait tous les robots, tandis que le robots.txt du site principal autorisait les pages produit.
Ces 4 points d’accès suffisaient pour chaque tâche de données produit que nous avons testée :
| Point d’accès | Ce qu’il renvoie | Limites et erreurs dans nos tests |
|---|---|---|
pdp_client_v1 |
Produit, prix à 1 store_id, et chaque variante de la famille |
404 pour un TCIN qui n’existe plus |
plp_search_v2 |
Résultats de recherche pour un mot-clé ou un code-barres UPC | count jusqu’à 28, offset jusqu’à 1 199 |
nearby_stores_v1 |
ID de magasins proches d’un code postal | Aucune |
product_fulfillment_v1 |
Expédition, retrait et stock en magasin au magasin demandé, parfois avec un magasin proche | Aucune |
Cette requête obtient le prix d’une brique de lait UHT Parmalat au magasin Chelsea à New York, magasin 3412, avec curl et jq :
KEY=$(curl -s https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
Le champ location_id de la réponse indique à quel magasin le prix appartient :
{
  "current_retail": 3.89,
  "display_was_now": false,
  "formatted_current_price": "$3.89",
  "formatted_current_price_type": "reg",
  "formatted_unit_price": "$0.12",
  "formatted_unit_price_suffix": "/fluid ounce",
  "reg_retail": 3.89,
  "location_id": 3412,
  "external_system_id": "15078349-3412-3.89-2025080815"
}
Le prix se trouve sous children car ce TCIN est une variante d’un produit parent. Les deux commandes curl ci-dessus ont fonctionné depuis notre connexion en Inde. Depuis des IP américaines, la vérification anti-bot de Target a bloqué presque toutes ces requêtes dans nos tests. Dans ce cas, jq affichait une erreur d’analyse, car la réponse était une page de blocage HTML, pas du JSON.
Le Web Unlocker API envoie les mêmes requêtes via sa couche de déblocage et renvoie le JSON de Target. Définissez d’abord les variables d’environnement BRIGHTDATA_API_KEY et UNLOCKER_ZONE, comme le montre le guide de démarrage rapide du Web Unlocker API :
unlock() {
  curl -s https://api.brightdata.com/request \
    -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
    -H "Content-Type: application/json" \
    -d "{\"zone\": \"$UNLOCKER_ZONE\",
         \"url\": \"$1\", \"format\": \"raw\"}"
}

KEY=$(unlock https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
unlock "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
La fonction unlock accepte toute URL Target, y compris la requête de stock ci-dessous.
La page en direct chargeait des modules d’interface pilotés par le serveur
Dans nos captures réseau du navigateur, la page produit n’appelait pas pdp_client_v1. Sa mise en page provenait de modules d’interface pilotés par le serveur, des sections de page que le serveur envoie sous forme de données, soit dans __NEXT_DATA__, soit depuis cdui-orchestrations.target.com. Un appel deferred_enrichment sur www.target.com ajoutait les modules spécifiques à l’emplacement.
La réponse cdui-orchestrations.target.com et les modules deferred_enrichment contenaient tous deux des prix. Avec include_data_source_modules=true, une requête à cdui-orchestrations.target.com pour le magasin Chelsea a renvoyé le même prix et le même ID d’emplacement que pdp_client_v1 pour 16 produits testés sur 16. Un point d’accès que la page produit n’appelle pas, comme pdp_client_v1, peut disparaître sans préavis, et les prix cdui correspondants offrent un repli testé.
Pourquoi les scrapers Target échouent à grande échelle
Certaines défaillances surviennent dès la première requête, d’autres n’apparaissent que lorsqu’une tâche inclut de nombreux magasins et produits.
Les blocages dépendaient de l’IP et du client
Dans nos tests, Target utilisait HUMAN Security, un service de détection de bots qui a fusionné avec PerimeterX en 2022. Chaque page produit récupérée avec un agent utilisateur de navigateur ou de client HTTP chargeait le script capteur de HUMAN depuis client.px-cloud.net.
Dans notre test IP et client, nous avons envoyé les mêmes 16 URL pdp_client_v1 depuis chaque source IP et client, lors de passages étalés sur 3 heures. Un appel réussissait s’il renvoyait 200 ou 206 sans blocage HUMAN dans le corps :
| Source IP | Client | Appels réussis |
|---|---|---|
| IP en Inde | curl | 63 sur 64 |
| IP aux États-Unis | curl ou Python requests, agent utilisateur par défaut |
1 sur 112 |
| Web Unlocker API avec IP de sortie américaines | Sélectionné par Web Unlocker API | 32 sur 32 |
Depuis l’Inde, même curl réussissait. Depuis des IP américaines, le résultat dépendait du client, et les en-têtes similaires à ceux d’un navigateur permettaient à plus d’appels de passer. Le Web Unlocker API sélectionne les en-têtes et l’empreinte du navigateur pour vous, et il a réussi tous les appels de ce test.
L’hôte cdui-orchestrations.target.com se comportait différemment lorsque nous alternions les appels vers lui et vers pdp_client_v1 avec l’agent utilisateur par défaut de Python depuis des IP américaines. L’hôte cdui a répondu aux 8 appels, tandis que la vérification anti-bot a bloqué les 8 appels vers pdp_client_v1. Depuis notre connexion en Inde, les réponses cdui avec prix avaient une taille médiane de transfert de 80 Ko, et les réponses pdp_client_v1 de 9 Ko. L’hôte cdui a évité le blocage dans nos tests, mais son format de données suit la mise en page et peut changer avec toute nouvelle version de page.
Dans nos tests, changer un seul en-tête faisait échouer une configuration qui fonctionnait auparavant, et la réponse de blocage de HUMAN ne donnait aucune raison. Changez une variable à la fois. Avant de faire confiance à une correction, alternez-la avec l’ancienne configuration et exécutez suffisamment d’appels pour voir une différence claire. Lorsque vous comparez les empreintes TLS avec un service d’écho d’empreinte, utilisez JA4 et l’empreinte HTTP/2, car les poignées de main de style Chrome changent le JA3 entre connexions.
HUMAN définit aussi ses propres cookies. Lors de notre vérification, sa documentation sur les cookies indiquait une durée de vie de 5,5 minutes pour _px3 et 1 an pour _pxvid. La même page indiquait que ces cookies maintiennent une session et aident à distinguer les vrais utilisateurs des bots. Pour toute la session, utilisez chaque pot de cookies avec l’IP et le client qui l’a reçu, ou laissez le Web Unlocker API gérer les cookies.
Les appels bloqués renvoyaient le code HTTP 435 sous 2 formats
Lors de notre vérification, la documentation sur les enforcers de HUMAN indiquait 403 et 429 comme statuts de blocage et précisait que chaque site pouvait personnaliser la réponse. Sur Target, les appels API bloqués renvoyaient plutôt le code HTTP 435, et la réponse de blocage avait 2 formats.
Nos appels curl ne demandaient pas de JSON et recevaient une page de défi HTML. Affichée dans un navigateur, cette page demandait au visiteur d’appuyer et maintenir un bouton :
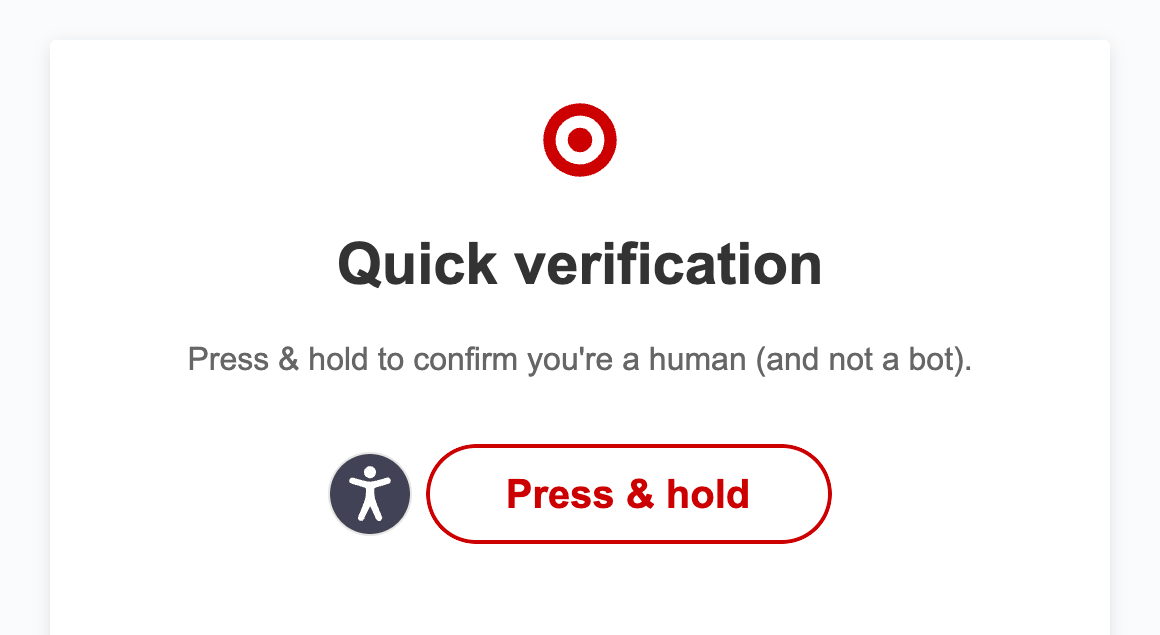
La page de défi reçue par nos appels curl avec le code HTTP 435 au lieu de données.
Nos appels Python requests demandaient du JSON et recevaient un objet JSON de 343 octets commençant par {"appId". Si vous vérifiez seulement un JSON valide, ce blocage ressemble à des données valides. Les deux formats contenaient l’URL du script captcha de HUMAN, absente de toute réponse normale dans nos échantillons :
def is_human_block(body):
    """HUMAN envoie un blocage sous forme de page HTML ou de petit objet JSON.

    Les deux formats contiennent l'URL de son script captcha. Les pages
    Target normales n'en contiennent pas.
    """
    return "captcha.px-" in body
Sur un ensemble de 21 réponses Target, la vérification a signalé les 4 blocages dans les deux formats et validé les 17 réponses normales. Une vérification plus simple sur la chaîne px-captcha aurait signalé une page produit affichée et manqué le blocage JSON.
Les prix différaient selon le magasin
Sur 8 magasins, 12 des 16 produits vérifiés avaient plus d’un prix. Target a déclaré plus de 2 000 magasins. Le point d’accès nearby_stores_v1 associe un code postal aux ID de magasin les plus proches. Pour chacun des 8 codes postaux, nous avons collecté les prix des 16 produits au magasin le plus proche en un seul passage de 2 minutes.
Un sous-ensemble de 6 produits dans 5 des 8 magasins montre les différences de prix en dollars américains. Ces 5 magasins incluent le prix le plus bas et le plus élevé de chaque produit :
| Produit | New York | Chicago | Cedar Rapids | Anchorage | Honolulu |
|---|---|---|---|---|---|
| Lait entier UHT Parmalat, 32 fl oz | 3,89 | 3,49 | 3,59 | 4,49 | 3,89 |
| Dosettes Tide Original, 31 unités | 11,19 | 12,69 | 9,99 | 10,59 | 10,59 |
| Cheerios, Format Familial 18 oz | 5,99 | 5,69 | 5,29 | 6,79 | 5,69 |
| Market Pantry Classic Roast, 25,9 oz | 14,69 | 14,19 | 12,89 | 16,99 | 17,59 |
| Starbucks Fall Blend, 10 oz | 14,39 | 13,59 | 12,79 | 14,29 | 13,59 |
| LEGO Creator Space Shuttle 31134 | 7,99 | 7,99 | 7,99 | 7,99 | 7,99 |
Le café Market Pantry avait l’écart le plus large : 17,59 $ à Honolulu, soit 36% de plus que 12,89 $ à Cedar Rapids. Même sans Anchorage et Honolulu, 11 des 16 produits avaient plus d’un prix, et les dosettes Tide variaient le plus, de 27%.
Les prix peuvent aussi changer au cours d’une journée. Entre 2 de nos passages le même jour, le magasin de Chicago a baissé le prix du lait de 3,49 $ à 2,97 $, et pdp_client_v1 l’a étiqueté sale. Réglez la fréquence d’actualisation selon la fréquence de changement des prix dans vos catégories. Conservez le type de prix, promotionnel ou régulier, avec chaque ligne.
Les 4 produits au même prix dans tous les magasins étaient 2 sets LEGO et 2 modèles AirPods. Pour les 4, l’API a renvoyé un prix de l’emplacement 3991, quel que soit le magasin demandé. L’emplacement 3991 indique un prix en ligne, pas un prix de magasin.
Passer 3991 comme ID de magasin renvoyait 206 avec "Parameter store_id cannot be digital store 3991." dans le tableau errors. Pour notre connexion en Inde, la page produit de Target définissait aussi le magasin sur 3991 et le code postal sur 52404.
Vous pouvez utiliser l’emplacement 3991 pour économiser des requêtes. D’abord, demandez chaque produit à 2 magasins. Si les deux réponses montrent l’emplacement 3991, collectez le produit une fois par actualisation plutôt qu’une fois par magasin. Pour 4 de nos 16 produits testés, cette règle a réduit les requêtes de 8 à 1 par actualisation.
Pour collecter les prix des magasins, envoyez la requête produit avec un ID de magasin via le Web Unlocker API. Le Target Scraper API renvoie les prix pour le code postal que vous envoyez.
Les produits parents renvoyaient des fourchettes de prix
Target liste chaque variante, comme une taille de paquet, comme un TCIN enfant sous un produit parent. Les résultats de recherche renvoyaient le TCIN enfant, mais le point d’accès produit renvoyait le parent. Le TCIN 87767249 des dosettes Tide renvoyait le parent 79394303 avec le prix "$11.19 - $30.99", et son tableau children listait les paquets de 31, 42, 76 et 112. Si un scraper n’enregistre que le prix du niveau supérieur, il enregistre une fourchette ou sa valeur la plus basse pour un produit ayant 4 prix.
La fourchette peut aussi masquer des différences entre magasins. Au niveau parent, Pampers Swaddlers affichait "$9.99 - $59.99" dans les 8 magasins lors d’un passage précédent. Au niveau variante, le paquet de 164 unités taille 1 coûtait 47,99 $ à New York et 44,99 $ dans les 7 autres magasins.
Une requête renvoie chaque variante de la famille au magasin demandé. Si vous envoyez 1 TCIN par famille, vous payez pour 1 requête par famille à chaque magasin.
La recherche s’arrêtait à un offset de 1 199
Le point d’accès de recherche rejetait tout count au-dessus de 28 avec "Parameter 'count' cannot be requested with more than 28". Il rejetait aussi tout offset au-dessus de 1 199, donc 1 requête pouvait renvoyer environ 1 227 résultats. Une recherche pour “shirts” a rapporté 131 690 résultats dans notre test, donc un seul mot-clé pouvait en renvoyer environ 1%.
Lors de notre vérification, le robots.txt de www.target.com interdisait les pages de recherche pour tous les agents utilisateurs et listait 6 index de sitemap. L’index de sitemap des produits pointait vers 110 fichiers, qui listaient 2 504 600 URL de produits lors de notre téléchargement. Découvrez les produits via les sitemaps et pages de catégorie, et utilisez l’API de recherche pour des recherches occasionnelles comme la résolution UPC-vers-TCIN. Avec l’UPC comme mot-clé, les deux UPC testés ont renvoyé exactement 1 produit avec son TCIN.
Certains codes de statut étaient trompeurs
Target renvoie 3 types de réponses nécessitant leur propre traitement, et 2 d’entre elles ont un code de statut trompeur :
| Réponse | Ce que cela signifiait | Que faire |
|---|---|---|
206 avec un tableau errors |
Une partie de la requête a échoué, et les données produit étaient toujours présentes | Analysez les données, enregistrez l’erreur |
404 avec "No product found with tcin" |
Le produit n’existe plus | Marquez l’URL comme morte, ignorez les nouvelles tentatives |
435 avec un corps HTML ou JSON |
Un blocage HUMAN | Détectez-le depuis le corps, suspendez ce client, et attendez avant de réessayer |
Les produits supprimés peuvent apparaître dans toute liste d’entrée, donc planifiez-les. Un produit de notre liste de test a renvoyé "No product found with tcin 1002219928".
Le stock avait 3 canaux par magasin
Dans nos tests, le point d’accès product_fulfillment_v1 indiquait séparément l’expédition, le retrait en magasin et la disponibilité en magasin, et donnait une quantité par magasin. Cette requête réutilise KEY et REDSKY de la requête API produit ci-dessus et vérifie le lait au magasin Chelsea :
Q="key=$KEY&tcin=15078349&store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/product_fulfillment_v1?$Q" \
  | jq '.data.product.fulfillment | {
      shipping: .shipping_options.availability_status,
      stores: [.store_options[] | {
        store: .location_id,
        units: .location_available_to_promise_quantity,
        pickup: .order_pickup.availability_status,
        in_store: .in_store_only.availability_status
      }]
    }'
Le magasin Chelsea n’avait aucune unité ni retrait disponible, mais l’expédition indiquait le lait en stock, et un magasin proche en listait 6 unités :
{
  "shipping": "IN_STOCK",
  "stores": [
    {
      "store": "3412",
      "units": 0.0,
      "pickup": "UNAVAILABLE",
      "in_store": "OUT_OF_STOCK"
    },
    {
      "store": "1886",
      "units": 6.0,
      "pickup": "IN_STOCK",
      "in_store": "IN_STOCK"
    }
  ]
}
Dans une autre requête, le magasin d’Anchorage listait 2 unités du même lait. Enregistrez le statut d’expédition, de retrait et de disponibilité en magasin pour chaque magasin, car un seul flag is_available ne peut pas contenir 3 valeurs distinctes. Pour le stock, utilisez des points d’accès de lecture comme product_fulfillment_v1, qui renvoient déjà des quantités par magasin, plutôt que des requêtes de panier. Les ingénieurs qui font de la rétro-ingénierie des API de vente au détail rapportent aussi que les points d’accès d’écriture sont mieux protégés.
Scraper les prix des magasins Target avec le Web Unlocker API
Le Web Unlocker API achemine chaque requête via des IP et empreintes de navigateur qu’il sélectionne pour chaque site. Il gère aussi les en-têtes, cookies, CAPTCHA et nouvelles tentatives, et renvoie la réponse du site. Les fournisseurs de détection de bots mettent à jour fréquemment leurs vérifications, et le Web Unlocker API s’adapte à ces mises à jour pour vous. Vous gardez le contrôle total de votre analyseur et de la logique des points d’accès.
Pour commencer, créez un compte Bright Data avec une clé API et une zone Web Unlocker API, une configuration nommée pour les requêtes et leur facturation. Vous avez aussi besoin de Python et de la bibliothèque requests, et le script s’exécute sur Python 3.13. Le Web Unlocker API est en libre-service et ne facture que les requêtes réussies. La page de tarification du Web Unlocker API liste les tarifs actuels, et le niveau gratuit inclut 5 000 requêtes par mois sans carte de crédit requise.
Le script lit la clé API de Target depuis sa page d’accueil et associe chaque code postal à un magasin. Il obtient ensuite le prix de chaque variante et sépare les lignes valides des rejetées :
"""Collecter les prix Target par magasin via le Web Unlocker API de Bright Data.

Utilisation :
    export BRIGHTDATA_API_KEY=...        # clé API du compte
    export UNLOCKER_ZONE=web_unlocker    # votre zone Web Unlocker API
    python target_store_prices.py 15078349,87767249 10001,99501
"""
import collections
import html
import json
import os
import re
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone
from urllib.parse import urlencode

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("UNLOCKER_ZONE", "web_unlocker")
REDSKY = "https://redsky.target.com/redsky_aggregations/v1/web/"
ONLINE_STORE = "3991"  # l'emplacement que l'API de Target appelle magasin numérique


def is_human_block(body):
    """HUMAN envoie un blocage sous forme de page HTML ou de petit objet JSON.

    Les deux formats contiennent l'URL de son script captcha. Les pages
    Target normales n'en contiennent pas.
    """
    return "captcha.px-" in body


def unlock(url, attempts=3):
    """Récupérer une URL via Web Unlocker API et renvoyer la réponse de Target."""
    status = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=120,
            )
        except requests.RequestException as error:
            status = type(error).__name__
            time.sleep(2 ** attempt)
            continue
        # Web Unlocker API rapporte le résultat de Target lui-même dans les
        # en-têtes x-brd-status-code et x-brd-error.
        status = int(r.headers.get("x-brd-status-code", r.status_code))
        if is_human_block(r.text):
            status = "blocked"  # un blocage peut arriver avec n'importe quel code de statut
        elif status in (200, 206):
            return status, r.text
        elif "404" in r.headers.get("x-brd-error", ""):
            return 404, ""  # page produit morte : ne pas réessayer
        time.sleep(2 ** attempt)
    return status, ""


def web_api_key():
    """Lire la clé API web que Target intègre dans ses propres pages."""
    status, page = unlock("https://www.target.com/")
    keys = re.findall(r'apiKey\\?"\s*:\s*\\?"([0-9a-f]{40})', page)
    if not keys:
        raise RuntimeError(f"pas d'apiKey dans la page d'accueil (statut {status})")
    return collections.Counter(keys).most_common(1)[0][0]


def store_for_zip(key, zip_code):
    """Résoudre un code postal vers l'ID du magasin Target le plus proche."""
    query = urlencode({"key": key, "place": zip_code, "limit": 1,
                       "within": 100, "channel": "WEB", "page": "/s"})
    status, body = unlock(f"{REDSKY}nearby_stores_v1?{query}")
    try:
        store = json.loads(body)["data"]["nearby_stores"]["stores"][0]
    except (ValueError, KeyError, IndexError) as error:
        raise RuntimeError(f"pas de magasin pour {zip_code} ({status})") from error
    return store["store_id"], store["location_name"]


def price_rows(key, tcin, store_id, zip_code):
    """Renvoyer une ligne par variante vendable (TCIN enfant) à un magasin."""
    query = urlencode({"key": key, "tcin": tcin, "store_id": store_id,
                       "pricing_store_id": store_id,
                       "has_pricing_store_id": "true", "channel": "WEB",
                       "page": f"/p/A-{tcin}"})
    status, body = unlock(f"{REDSKY}pdp_client_v1?{query}")
    error = {"tcin": tcin, "store_id": store_id, "zip": zip_code}
    try:
        product = json.loads(body)["data"]["product"]
    except (ValueError, KeyError, TypeError):
        return [{**error, "error": status or "no_response"}]
    # Un TCIN enfant renvoie son parent. Le prix parent est une fourchette,
    # donc enregistrer le prix de chaque enfant sur sa propre ligne.
    items = product.get("children") or [product]
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    rows = []
    for item in items:
        price = item.get("price", {})
        priced_at = str(price.get("location_id"))
        rows.append({
            "tcin": item["tcin"],
            "parent_tcin": product["tcin"],
            "title": html.unescape(
                item["item"]["product_description"]["title"]),
            "zip": zip_code,
            "store_id": store_id,
            "priced_at": priced_at,
            "scope": "online" if priced_at == ONLINE_STORE else "store",
            "price": price.get("current_retail"),
            "regular_price": price.get("reg_retail"),
            "price_type": price.get("formatted_current_price_type"),
            "collected_at": now,
        })
    return rows


def valid(row):
    """Conserver les lignes avec un prix du magasin demandé ou en ligne."""
    return (isinstance(row.get("price"), (int, float))
            and row["priced_at"] in (str(row["store_id"]), ONLINE_STORE))


if __name__ == "__main__":
    tcins = sys.argv[1].split(",")
    zips = sys.argv[2].split(",")
    key = web_api_key()
    stores = {z: store_for_zip(key, z) for z in zips}
    jobs = [(t, stores[z][0], z) for t in tcins for z in zips]
    with ThreadPoolExecutor(max_workers=8) as pool:
        results = list(pool.map(lambda job: price_rows(key, *job), jobs))
    # Les TCIN d'une même famille renvoient les mêmes lignes. Conserver une
    # ligne par variante et magasin, et ne jamais laisser une erreur
    # remplacer une ligne avec un prix.
    unique = {}
    for row in (r for batch in results for r in batch):
        slot = (row["tcin"], row["store_id"])
        if slot not in unique or "error" in unique[slot]:
            unique[slot] = row
    good = [r for r in unique.values() if valid(r)]
    bad = [r for r in unique.values() if not valid(r)]
    # Ajouter, pour que chaque passage enrichisse l'historique des prix.
    for name, batch in (("target_prices", good), ("target_rejects", bad)):
        with open(f"{name}.jsonl", "a") as out:
            out.writelines(json.dumps(row) + "\n" for row in batch)
    print(f"{len(good)} valides, {len(bad)} rejetées, magasins : {stores}")
Avec 2 TCIN en entrée à 2 codes postaux, le script a produit 12 lignes, car chaque requête renvoyait toute la famille de variantes :
12 valides, 0 rejetées, magasins : {'10001': ('3412', 'Chelsea 23rd and 8th'), '99501': ('2371', 'Anchorage NE')}Les premières lignes de target_prices.jsonl montrent la famille du lait au magasin Chelsea :
{"tcin": "15078348", "parent_tcin": "94758333", "title": "Parmalat UHT 2% Reduced Fat Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
{"tcin": "15078349", "parent_tcin": "94758333", "title": "Parmalat UHT Whole Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
Le passage qui a produit le tableau des prix comprenait 128 paires de produits et magasins, 16 produits dans 8 magasins, et a écrit 800 lignes sans rejets. Ce script a répété le passage le lendemain en 97 secondes avec 8 workers, et les 800 prix correspondaient au premier passage. Le script conserve aussi un fichier target_rejects.jsonl pour toute paire nécessitant une nouvelle tentative.
Le Web Unlocker API rapporte le résultat de Target lui-même dans les en-têtes x-brd-status-code et x-brd-error, donc le script lit les deux. Pour un produit supprimé, x-brd-error affiche le 404 de Target, et le script l’enregistre sans réessayer.
Chaque choix de conception gère une défaillance pouvant survenir dans un scraper Target :
- Clé depuis la page : le scraper continue de fonctionner après une rotation de clé, tant que la page intègre toujours la clé comme
apiKey. - Une ligne par enfant : votre tableau ne stocke jamais une fourchette parent.
- Colonne
scope: un prix en ligne est étiquetéonline, pour qu’il ne soit jamais confondu avec un prix de magasin. - Vérification de blocage : un blocage HUMAN en HTML ou JSON est enregistré comme
blocked, quel que soit le code de statut. - Pas d’écrasement : une erreur pour une variante ne remplace jamais la ligne d’une autre variante ayant un prix.
- Fichier des rejets : les lignes sans prix valide de magasin ou en ligne sont enregistrées pour une nouvelle tentative, et les produits supprimés conservent leur
404.
Le code dépend de pdp_client_v1 et nearby_stores_v1, donc envoyez une requête canari quotidienne aux deux et alertez en cas de changement du schéma de réponse. Notre guide pour réessayer les requêtes Python échouées explique le backoff plus en détail.
Pour exécuter le même code sur des proxys résidentiels, envoyez un requests.get() via proxy dans unlock() et traitez un simple 404 comme un produit supprimé. Le reste du script reste identique. Avec les proxys résidentiels, vous contrôlez le client et l’agent utilisateur, donc testez-les ainsi que chaque point d’accès face à Target avant de passer à l’échelle.
Collecter les produits Target avec le Target Scraper API
Le Target Scraper API est le scraper du Web Scraper API pour Target. Vous envoyez des URL de produits et des codes postaux, et il renvoie des enregistrements structurés avec des champs tels que le prix, les variantes, les évaluations, les spécifications et le vendeur. Bright Data maintient l’analyse et les points d’accès, donc votre code normalise seulement les enregistrements. Bright Data propose aussi un Target Price Scraper, un Target Reviews Scraper, et un Target Image Scraper pour des tâches plus ciblées.
La console affiche les champs d’entrée du scraper au-dessus de ses modes synchrone et asynchrone. Les champs sont une URL, un flag all_variations, et un code postal :
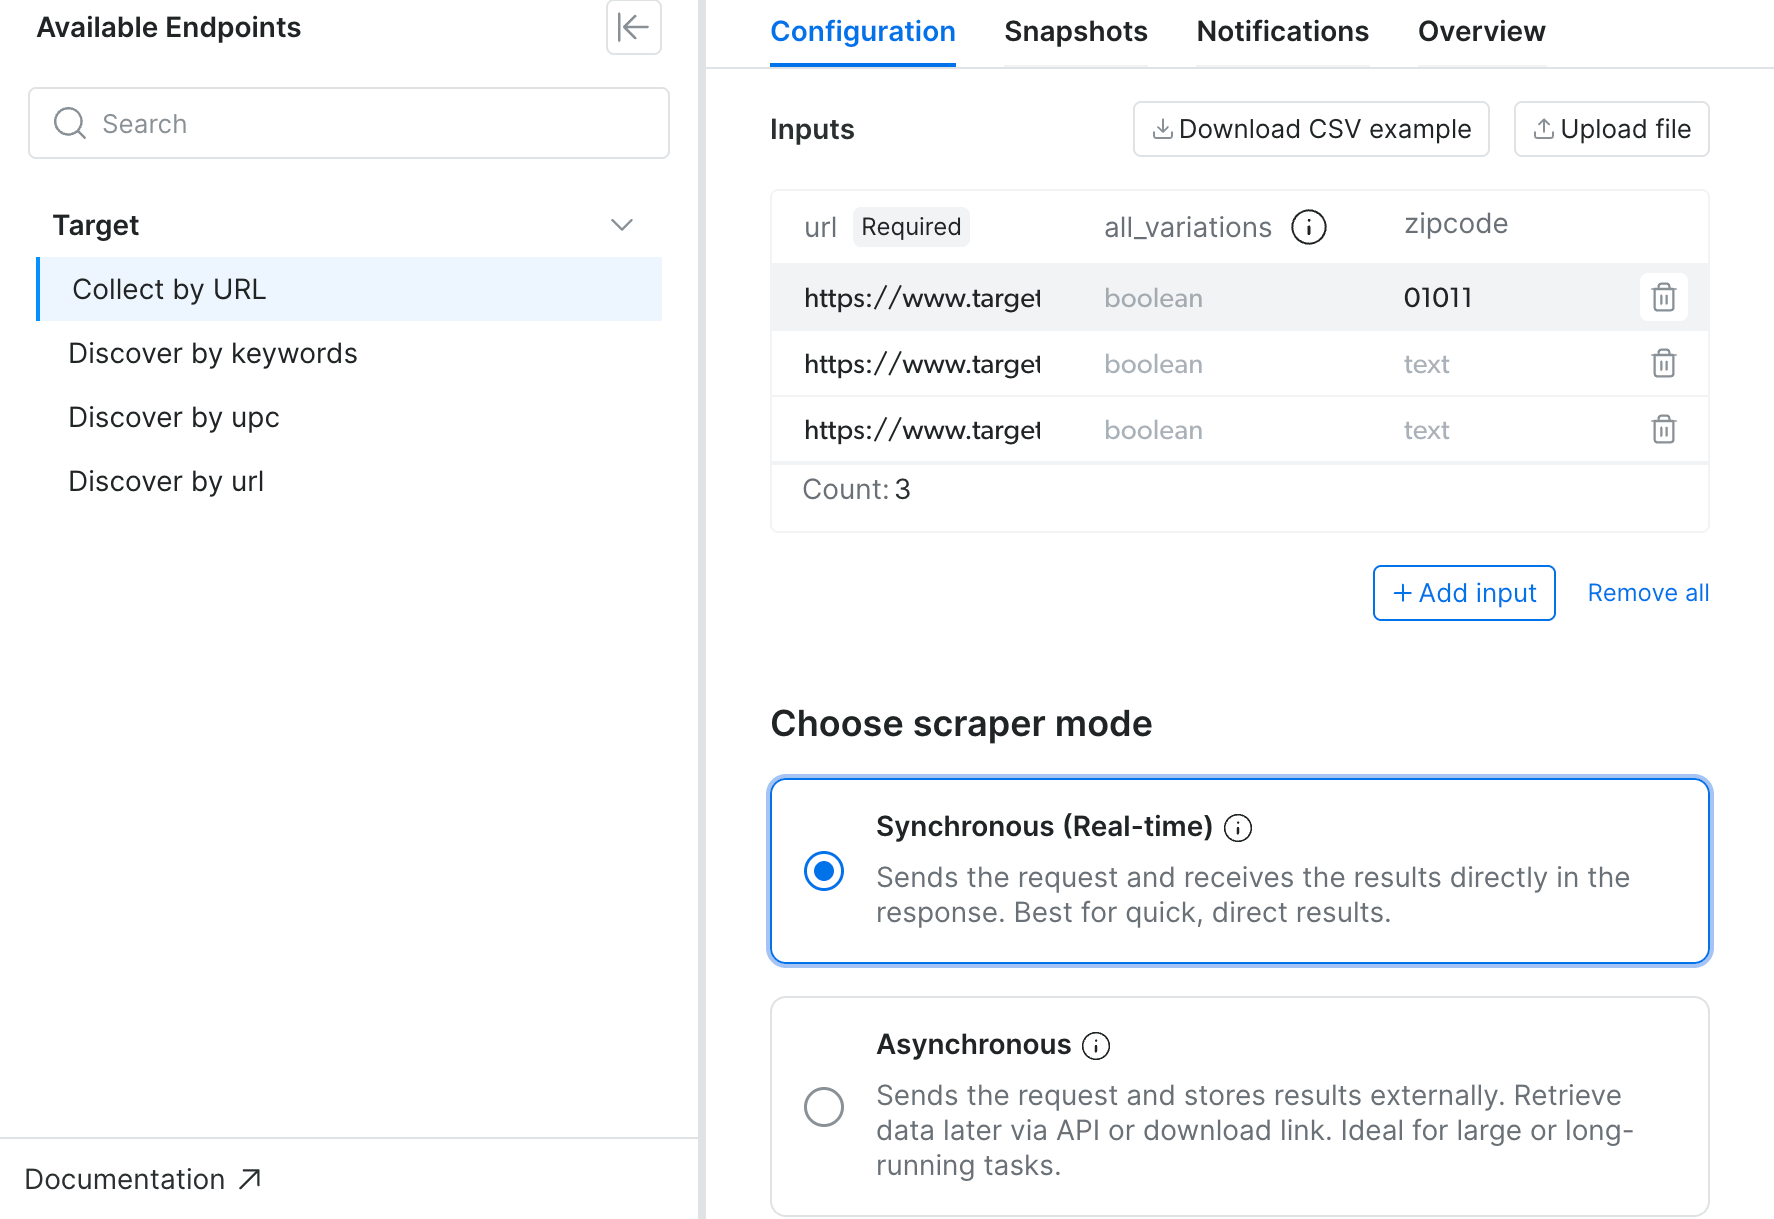
Chaque ligne d’entrée liste un seul produit et peut ajouter un code postal, qui définit l’emplacement pour le prix de l’enregistrement.
Le Web Scraper API ne facture que les enregistrements livrés. La page de tarification du Web Scraper API liste les tarifs actuels, et le niveau gratuit inclut 5 000 requêtes par mois sans carte de crédit requise. Pour une bibliothèque client, installez le SDK Python Bright Data avec pip install brightdata-sdk.
Le script ci-dessous démarre une tâche asynchrone, l’attend, télécharge les enregistrements, et les normalise :
"""Collecter les enregistrements de produits Target par URL et code postal avec le Web Scraper API.

Utilisation :
    export BRIGHTDATA_API_KEY=...
    python target_scraper_api.py inputs.csv   # colonnes : url,zipcode
"""
import csv
import json
import os
import re
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_ltppk5mx2lp0v1k0vo"  # scraper de produits Target
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}


def trigger(inputs):
    """Démarrer une collecte asynchrone et renvoyer son ID de snapshot."""
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": DATASET_ID, "include_errors": "true"},
        json=inputs,
        timeout=60,
    )
    r.raise_for_status()
    return r.json()["snapshot_id"]


def wait(snapshot_id, poll_seconds=15, max_minutes=60):
    """Interroger le snapshot jusqu'à ce qu'il soit prêt et renvoyer son enregistrement de progression."""
    deadline = time.time() + max_minutes * 60
    while time.time() < deadline:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=30).json()
        if progress["status"] in ("ready", "failed"):
            return progress
        time.sleep(poll_seconds)
    raise TimeoutError(snapshot_id)


def download(snapshot_id):
    """Télécharger tous les enregistrements, y compris les erreurs, sous forme de liste."""
    r = requests.get(f"{API}/snapshot/{snapshot_id}",
                     headers=HEADERS, params={"format": "json"}, timeout=300)
    r.raise_for_status()
    return r.json()


def normalize(record):
    """Mapper un enregistrement vers une ligne plate, ou renvoyer None pour un enregistrement d'erreur."""
    if record.get("error_code"):
        return None
    price = record.get("final_price")
    if price is None and record.get("price_range"):
        # Un enregistrement peut avoir son prix dans price_range, comme "$24.99".
        match = re.fullmatch(r"\$([\d,]+\.\d{2})", record["price_range"])
        price = float(match.group(1).replace(",", "")) if match else None
    origin = record.get("discovery_input") or record.get("input") or {}
    reviewed = bool(record.get("reviews_count"))  # évaluation 0 signifie non évalué
    url_tcin = re.search(r"/A-(\d+)", record.get("url") or "")
    return {
        "tcin": url_tcin.group(1) if url_tcin else record.get("tcin_id"),
        "parent_tcin": record.get("group_id"),
        "title": record.get("title"),
        "zipcode": origin.get("zipcode") or None,
        "price": price,
        "initial_price": record.get("initial_price"),
        "available": record.get("is_available"),
        "rating": record.get("rating") if reviewed else None,
        "reviews_count": record.get("reviews_count"),
        "collected_at": record.get("timestamp"),
    }


if __name__ == "__main__":
    with open(sys.argv[1], newline="") as f:
        inputs = [{"url": row["url"], "zipcode": row["zipcode"]}
                  for row in csv.DictReader(f)]
    snapshot_id = trigger(inputs)
    progress = wait(snapshot_id)
    records = download(snapshot_id)
    rows = [row for row in map(normalize, records) if row]
    with open("target_records.jsonl", "w") as out:
        out.writelines(json.dumps(row) + "\n" for row in rows)
    print(f"snapshot {snapshot_id}: {len(rows)} lignes, "
          f"erreurs : {progress.get('error_codes', {})}")
Le fichier d’entrée a le lait à 2 codes postaux, plus un set LEGO au prix national et un paquet Tide de 112 unités, tous deux à Anchorage. La dernière ligne est un produit que Target a supprimé :
url,zipcode
https://www.target.com/p/-/A-15078349,10001
https://www.target.com/p/-/A-15078349,60601
https://www.target.com/p/-/A-86216189,99501
https://www.target.com/p/-/A-84114518,99501
https://www.target.com/p/petal-and-pup-skarlett-top/-/A-1002219928,10001
La tâche a renvoyé 4 enregistrements et signalé le produit supprimé comme dead_page :
snapshot sd_muifuppi1d0g830zfd: 4 lignes, erreurs : {'dead_page': 1}Les 4 prix correspondaient à notre scraper. Le café Market Pantry et le paquet Tide de 31 unités variaient en prix selon l’emplacement. Nous les avons comparés avec notre scraper aux 8 codes postaux, au même moment :
| Produit | Paires produit et code postal | Prix distincts | Correspondait à notre scraper |
|---|---|---|---|
| Market Pantry Classic Roast, 25,9 oz | 8 | 7 | 8 sur 8 |
| Dosettes Tide Original, 31 unités | 8 | 5 | 8 sur 8 |
| Lait, set LEGO, et Tide 112 unités (fichier d’entrée ci-dessus) | 4 | Non applicable | 4 sur 4 |
Les 20 paires produit et code postal correspondaient au prix de notre scraper au magasin le plus proche. Un jour plus tard, une nouvelle exécution du fichier d’entrée a renvoyé le nouveau prix promotionnel de 2,97 $ à Chicago, que notre scraper a confirmé.
Chaque enregistrement inclut le code postal utilisé pour son prix et un flag de disponibilité pour ce code postal. Le normaliseur mappe ces champs :
- ID parent :
group_idcontient le TCIN parent. - Origine :
inputcontient l’URL et le code postal d’un enregistrement collecté.discovery_inputcontient le mot-clé ou l’URL de catégorie, et tout code postal, lorsque le Target Scraper API a trouvé le produit lui-même. - Prix : le normaliseur prend le prix depuis
final_priceouprice_range. - Produits non évalués : une
ratingde 0 avec 0 avis signifie que le produit n’a pas d’évaluation.
Choisissez le mode synchrone ou asynchrone
Le point d’accès synchrone /scrape renvoie les résultats dans la réponse pour les tâches rapides et renvoie un snapshot_id à interroger pour les tâches plus longues. La documentation des requêtes synchrones donne la limite de temps actuelle. Utilisez /trigger pour les lots programmés. Vous interrogez un snapshot_id depuis l’un ou l’autre point d’accès de la même manière.
Pour les tâches récurrentes, configurez l’API pour livrer les résultats. Les options de livraison incluent les webhooks et le stockage cloud tel qu’Amazon S3, Google Cloud Storage et Microsoft Azure. Sur /scrape, définissez limit_per_input dans le corps de la requête pour limiter les enregistrements par entrée, comme le montre la documentation.
Découvrir des produits par mot-clé ou catégorie
Le Target Scraper API peut aussi trouver des produits pour vous :
- Mot-clé : “dog treats” et “shirts” avec
limit_per_inputdéfini à 20 ont renvoyé 40 enregistrements sans erreurs. - URL de catégorie : 2 pages de catégorie, chacune avec un code postal, ont renvoyé 40 enregistrements.
Le normaliseur ci-dessus lit déjà discovery_input, donc le même code traite les enregistrements découverts.
Utiliser le Browser API pour les sessions et le débogage
Le Browser API exécute un Chrome distant que vous pilotez avec Playwright ou Puppeteer via le Chrome DevTools Protocol (CDP), ou avec Selenium via WebDriver. Sur Target, il chargeait la page produit comme une session de navigateur complète, incluant le script de HUMAN. Parce qu’il charge la page entière, le Browser API fonctionne bien pour capturer le trafic réseau après que Target modifie son frontend.
Le Bright Data MCP Server fournit des outils aux agents IA via le Model Context Protocol (MCP). Ses outils de navigateur donnent aux agents le même navigateur distant pour les workflows qui cliquent ou tapent sur une page.
Le Browser API facture par Go, comme le montre la page de tarification du Browser API. Bloquer les images et trackers aide à garder chaque session légère. Une fois qu’une capture montre les requêtes dont vous avez besoin, le Web Unlocker API peut les envoyer directement, sans charger la page.
Sans cookie d’emplacement stocké, Target assignait à chacune de nos sessions de navigateur américaines un magasin proche de l’IP de sortie. La commande Proxy.setLocation du Browser API, envoyée via CDP, sélectionne une IP de sortie proche des coordonnées que vous choisissez. Pour exécuter le script, installez playwright et définissez la chaîne de connexion d’une zone Browser API dans la variable d’environnement BROWSER_API_WSS, comme le montre le guide de démarrage rapide du Browser API :
import asyncio
import os

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>:<password>@brd.superproxy.io:9222
WSS = os.environ["BROWSER_API_WSS"]


async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(WSS)
        page = await browser.contexts[0].new_page()
        cdp = await page.context.new_cdp_session(page)
        # Sortie près de Manhattan, pour que Target géolocalise la session là-bas.
        await cdp.send("Proxy.setLocation", {
            "lat": 40.7506, "lon": -73.9972, "distance": 10, "strict": True,
        })
        await page.goto("https://www.target.com/p/-/A-15078349",
                        wait_until="domcontentloaded", timeout=120_000)
        # La page affiche le prix deux fois, et une copie reste cachée.
        price = page.locator('[data-test="product-price"]').first
        await price.wait_for(state="attached", timeout=60_000)
        cookies = await page.context.cookies("https://www.target.com")
        store = {c["name"]: c["value"] for c in cookies}.get("fiatsCookie")
        print(store, await price.text_content())
        await browser.close()

asyncio.run(main())
Sur 3 exécutions avec les mêmes coordonnées, Target a assigné 3 magasins new-yorkais différents proches de ces coordonnées. La valeur fiatsCookie listait l’ID du magasin (DSI), le nom (DSN) et le code postal (DSZ) :
DSI_2475|DSN_Bronx%20Terminal|DSZ_10451 $3.59
DSI_3284|DSN_Lower%20East%20Side%20Grand%20and%20Clinton|DSZ_10002 $3.99
DSI_3394|DSN_Upper%20West%20Side%2098th%20and%20Columbus|DSZ_10025 $3.99
Puisque chaque session recevait un magasin proche, cette configuration est utile pour échantillonner les prix dans une zone métropolitaine.
Acheter le Target Dataset pour le remplissage de catalogue
Le Target Dataset propose des enregistrements de produits Target pré-collectés que vous pouvez filtrer et acheter sans exécuter de scraper. Il fonctionne bien pour un remplissage de catalogue nécessitant de nombreuses lignes à la fois.
La page du jeu de données liste le nombre actuel d’enregistrements, les champs et la tarification. Dans le Dataset Marketplace, vous pouvez filtrer les enregistrements et prévisualiser un échantillon avant d’acheter :
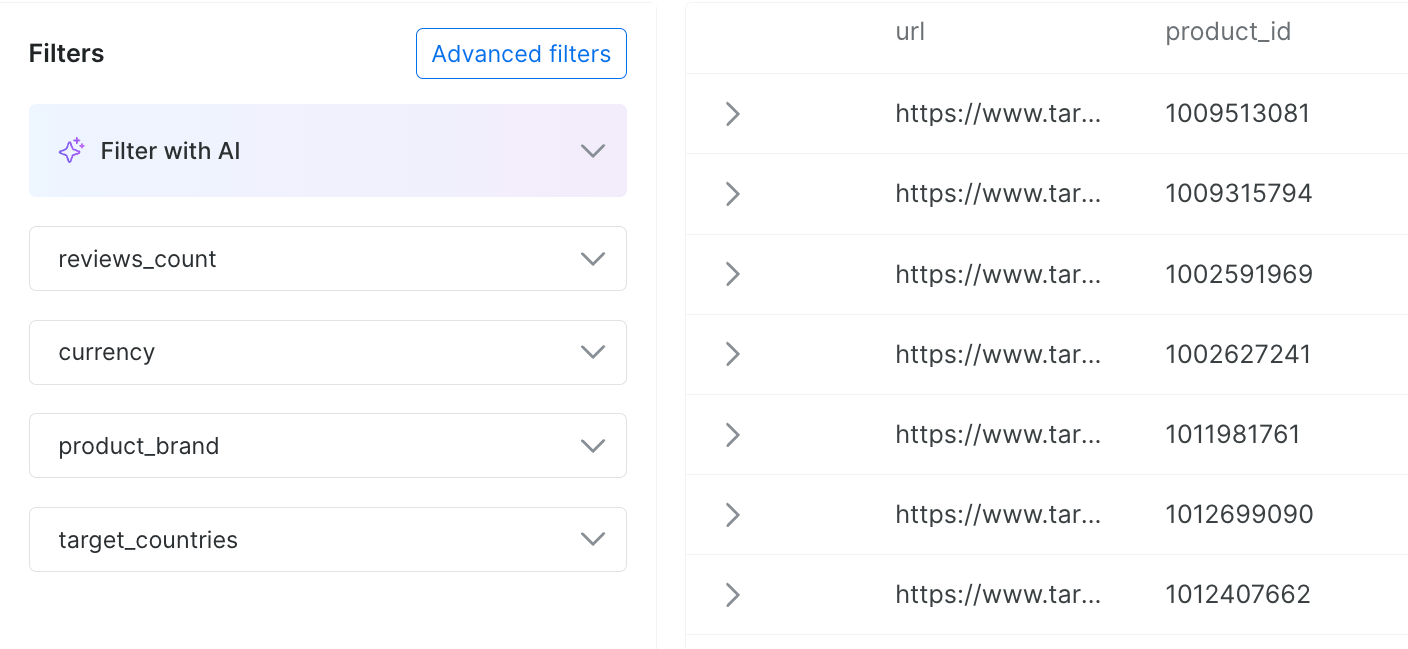
Les filtres de champs du jeu de données Target et un échantillon de ses enregistrements.
Avant le chargement, mappez les enregistrements vers votre propre schéma :
- ID produit : utilisez le TCIN dans l’URL de chaque enregistrement comme clé de votre tableau, le même ID que les scrapers ci-dessus utilisent.
- Évaluations : une
ratingde 0 avec 0 avis signifie que le produit n’a pas encore d’évaluation.
Choisir l’approche selon l’emplacement, le volume et la fréquence d’actualisation
Les options offrant plus de contrôle nécessitent plus de maintenance, qui croît selon la fréquence des changements de pages et points d’accès de Target. Les équipes souhaitant des tableaux de bord Target prêts à l’emploi peuvent utiliser le Target Price Tracker ou le Target Inventory Tracker. Pour d’autres détaillants, consultez notre guide du scraping web pour l’e-commerce. Chaque approche facture selon sa propre unité, et la page de tarification de chaque produit liste les tarifs actuels :
| Approche | Facturé par | Portée d’1 appel ou enregistrement | Meilleur usage |
|---|---|---|---|
| Votre code avec Web Unlocker API | Requête réussie | 1 famille de variantes à 1 ID de magasin | ID de magasin et stock par canal |
| Votre code avec proxys résidentiels | Go de trafic | 1 famille de variantes à 1 ID de magasin, environ 15 Ko compressé dans nos tests | Faible coût par appel, avec contrôle total du client |
| Target Scraper API | Enregistrement livré | 1 produit à 1 code postal | Collecte récurrente avec analyse et maintenance gérées pour vous |
| Browser API | Go de trafic | 1 session de navigateur complète | Sessions et débogage |
| Target Dataset | Enregistrement | 1 enregistrement de produit pré-collecté | Remplissage et recherche de catalogue |
Choisissez selon votre suivi des emplacements. Si vous suivez par code postal, le Target Scraper API correspondait au prix du magasin le plus proche dans nos tests, et Bright Data le maintient pour vous. Si vous suivez les ID de magasin et le stock par canal, exécutez votre propre code sur le Web Unlocker API ou les proxys résidentiels. Pour un remplissage, choisissez le jeu de données, comme l’explique notre comparaison des jeux de données et des API de scraping web.
Avant de choisir, estimez le volume mensuel en multipliant les produits par les magasins, par les actualisations par jour, et par 30. Suivre 5K produits dans 50 magasins une fois par jour signifie 7,5M requêtes ou enregistrements par mois. Le stock par canal ajoute 1 requête product_fulfillment_v1 par TCIN et magasin. Multipliez le total par le tarif unitaire de la page de tarification, où les plans mensuels réduisent le tarif.
Votre propre code peut envoyer moins de requêtes que cette estimation, de 2 façons. Parmi nos 16 produits testés, 4 avaient le même prix dans tous les magasins et ne nécessitaient qu’1 requête par actualisation. Une requête API produit renvoie aussi toute une famille de variantes, donc 128 paires de produits et magasins ont produit 800 lignes dans notre passage.
Sur les proxys résidentiels, 7,5M appels pdp_client_v1 compressés en gzip transféreraient environ 110 Go. Comme le note la page de tarification des proxys résidentiels, la facturation compte les en-têtes et corps, qui en moyenne faisaient 15 Ko par appel pour nous. La FAQ de facturation explique comment le trafic est mesuré. Demandez des réponses compressées, car les mêmes corps pdp_client_v1 faisaient en moyenne 134 Ko sans compression et 14 Ko avec gzip.
Le Web Unlocker API gère le déblocage pour vous et ne facture que les requêtes réussies. Dans notre test IP et client, il a réussi chaque appel sur des IP de sortie américaines sans ajustement client. Vous pouvez aussi utiliser à la fois le Web Unlocker API et les proxys résidentiels. Envoyez les requêtes de chaque point d’accès via l’option qui correspond à leur volume, et déplacez un point d’accès vers le Web Unlocker API quand la vérification anti-bot de Target change.
Valider et surveiller la collecte Target
Un blocage que is_human_block() détecte apparaît comme une erreur. Un prix du mauvais magasin qui paraît valide apparaît comme une donnée, donc aucune erreur ne le signale. Les vérifications ci-dessous aident à détecter les défaillances pouvant ressembler à des données valides ou gaspiller des requêtes :
| Vérification | Où chercher | Détecte |
|---|---|---|
| Le prix est un nombre supérieur à zéro | price |
Prix manquants et fourchettes |
| Le prix provient du magasin demandé, ou est étiqueté en ligne | location_id, scope |
Prix du mauvais magasin |
| La ligne est un TCIN enfant | tcin, children |
Fourchettes au niveau parent |
| Le corps a le schéma JSON attendu et aucun blocage HUMAN | Corps de la réponse | Réponses de blocage HTML et JSON (HTTP 435) |
| Le produit existe toujours | 404, dead_page |
URL mortes réessayées à chaque passage |
| Le changement de prix depuis le dernier passage est dans votre seuil | Historique des prix | Prix mal analysés ou incorrects |
Exécutez les vérifications sur chaque lot, et enregistrez chaque ligne avec son TCIN, ID de magasin et heure de collecte, pour que l’historique s’enrichisse. Comptez les échecs par raison, comme un blocage, un mauvais magasin, un produit supprimé, ou un délai d’attente. Un taux d’échec global peut masquer une hausse des échecs pour une raison, donc alertez quand le taux pour une raison dépasse la normale. Suivez aussi le coût par enregistrement réussi, pour comparer les approches avec la même mesure.
Réflexions finales
Target affiche publiquement ses données produit, mais un prix peut dépendre du magasin, de la variante et du moment de la collecte. Dans nos tests, les prix en ligne de l’emplacement 3991, les fourchettes de prix parent et les réponses de blocage JSON ressemblaient tous à des données valides. Conservez l’ID de magasin, la variante et le statut de la requête avec chaque ligne, et exécutez une requête canari quotidienne contre chaque point d’accès dont vous dépendez.
Le Web Unlocker API gère le déblocage et votre code contrôle les magasins et canaux, tandis que le Target Scraper API gère aussi l’analyse et la maintenance. Pour choisir, exécutez un échantillon de vos produits et codes postaux sur les deux via le niveau gratuit, qui inclut 5 000 requêtes par mois sans carte de crédit requise, et comparez les prix.
FAQ
Target a-t-il une API produit publique ?
Non, le portail développeur de Target est réservé aux employés de Target, vendeurs Target Plus, et partenaires. Le site web appelle des API JSON internes sur redsky.target.com avec une clé API provenant de ses pages, et ces points d’accès peuvent changer sans préavis. Le Target Scraper API de Bright Data renvoie des enregistrements produit à partir d’une URL et d’un code postal.
Comment obtenir les prix des produits Target par magasin ?
Appelez l’API produit de Target avec un ID de magasin et sa clé API publique pour obtenir le prix de chaque variante à ce magasin. Un autre point d’accès associe un code postal à l’ID de magasin le plus proche. Un ID d’emplacement de 3991 indique le prix en ligne de Target, pas un prix de magasin. Le Target Scraper API de Bright Data renvoie les prix pour le code postal que vous envoyez.
Peut-on suivre l’inventaire Target par magasin ?
Oui, dans nos tests, le point d’accès product_fulfillment_v1 de Target renvoyait un compte d’unités ainsi que le statut d’expédition, de retrait et de disponibilité en magasin pour le magasin demandé. Un magasin new-yorkais avait 0 unité et un magasin proche en avait 6, tandis que l’expédition indiquait l’article en stock. Enregistrez le stock par magasin et par canal.
Combien coûte le scraping des données Target ?
Le coût croît avec le nombre de produits, de magasins, et d’actualisations quotidiennes. Suivre 5K produits dans 50 magasins quotidiennement signifie 7,5M requêtes ou enregistrements par mois. Bright Data facture les enregistrements du Web Scraper API à la livraison, les requêtes du Web Unlocker API en cas de succès, et les proxys résidentiels par Go. Chaque page de tarification liste les tarifs actuels.
Comment scraper les produits Target gratuitement ?
Le niveau gratuit de Bright Data inclut 5 000 requêtes par mois sans carte de crédit requise, et couvre à la fois le Target Scraper API et le Web Unlocker API, pour que vous puissiez tester les prix sur vos propres produits. Les requêtes HTTP simples sont gratuites, mais la vérification anti-bot de Target a bloqué les clients avec paramètres par défaut depuis des IP américaines dans nos tests.