Dans ce guide, vous verrez :
- Ce qu’est Containers as a Service et ce qu’il gère pour vous.
- Comment fonctionne CaaS et l’importance de l’orchestration de conteneurs dans ce modèle.
- Les principaux avantages et inconvénients de cette approche du service cloud.
- Pourquoi CaaS est bien adapté aux charges de travail de récupération de données web.
- Comment créer un pipeline de données web évolutif avec CaaS et Bright Data.
Plongeons-y !
CaaS (Containers as a Service) expliqué
Avant d’examiner comment CaaS peut prendre en charge les pipelines de données web et les agents IA, vous devez comprendre ce que c’est et ce qu’il gère réellement.
Qu’est-ce que CaaS ?
CaaS, abréviation de Containers as a Service, est un modèle de service cloud qui fournit un environnement géré pour déployer, exécuter et faire évoluer des applications conteneurisées. Il se situe entre les services d’infrastructure et les services au niveau applicatif.
Pour comprendre où CaaS s’intègre, considérez ce qui se passe lorsque vous créez un conteneur. Une image de conteneur représente une unité portable de votre application qui peut s’exécuter de manière cohérente dans différents environnements.
L’image est ensuite utilisée pour créer des conteneurs en cours d’exécution. Or, exploiter ces conteneurs de manière fiable en production nécessite une infrastructure pour le déploiement, la mise en réseau, la mise à l’échelle, la surveillance et la gestion du cycle de vie.
CaaS comble le fossé entre une image de conteneur terminée et un runtime prêt pour la production. Au lieu de configurer manuellement des serveurs et de gérer des conteneurs individuels, vous pouvez déployer vos images de conteneurs sur une plateforme CaaS, qui définit comment ils doivent s’exécuter et les orchestre.
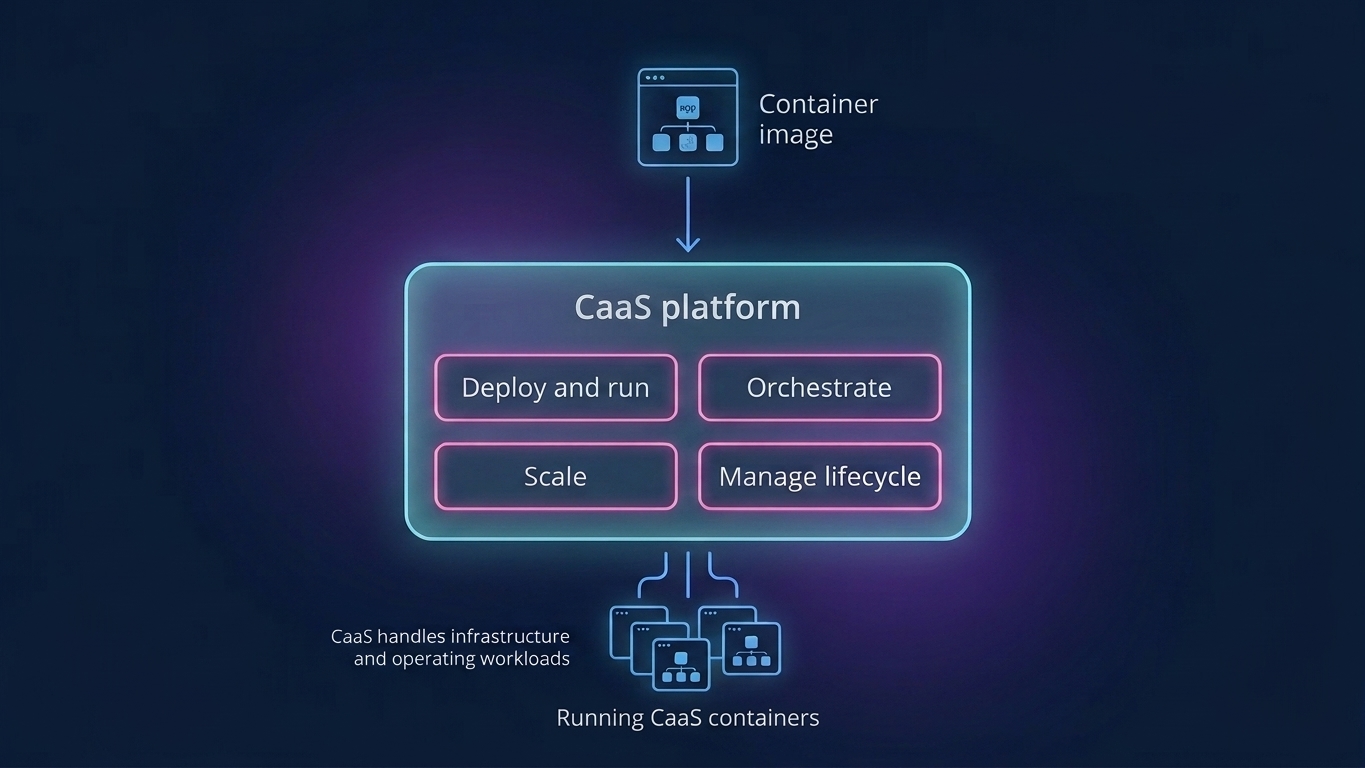
En d’autres termes, ce modèle est bien plus que simplement exécuter Docker sur une machine virtuelle. Avec Docker seul, vous devez toujours gérer l’infrastructure sous-jacente et coordonner les conteneurs vous-même. Une solution CaaS offre les fonctionnalités supplémentaires nécessaires pour exploiter des charges de travail conteneurisées à grande échelle.
Que gère CaaS ?
Une plateforme CaaS gère généralement le déploiement de conteneurs, l’orchestration, la mise à l’échelle, la mise en réseau, la découverte de services, les vérifications de santé et les opérations de cycle de vie.
En termes pratiques, vous définissez votre charge de travail souhaitée, comme le nombre d’instances de conteneurs à exécuter et les ressources qu’elles nécessitent. Ensuite, la plateforme gère une grande partie de l’exécution pour vous.
Cette approche réduit la charge opérationnelle et facilite l’exécution fiable d’applications distribuées, en particulier lorsque les charges de travail doivent évoluer ou changer fréquemment.
Comment fonctionne CaaS ?
Maintenant que vous savez ce qu’est CaaS, il est temps de comprendre comment il fonctionne.
De l’image de conteneur à la charge de travail en production
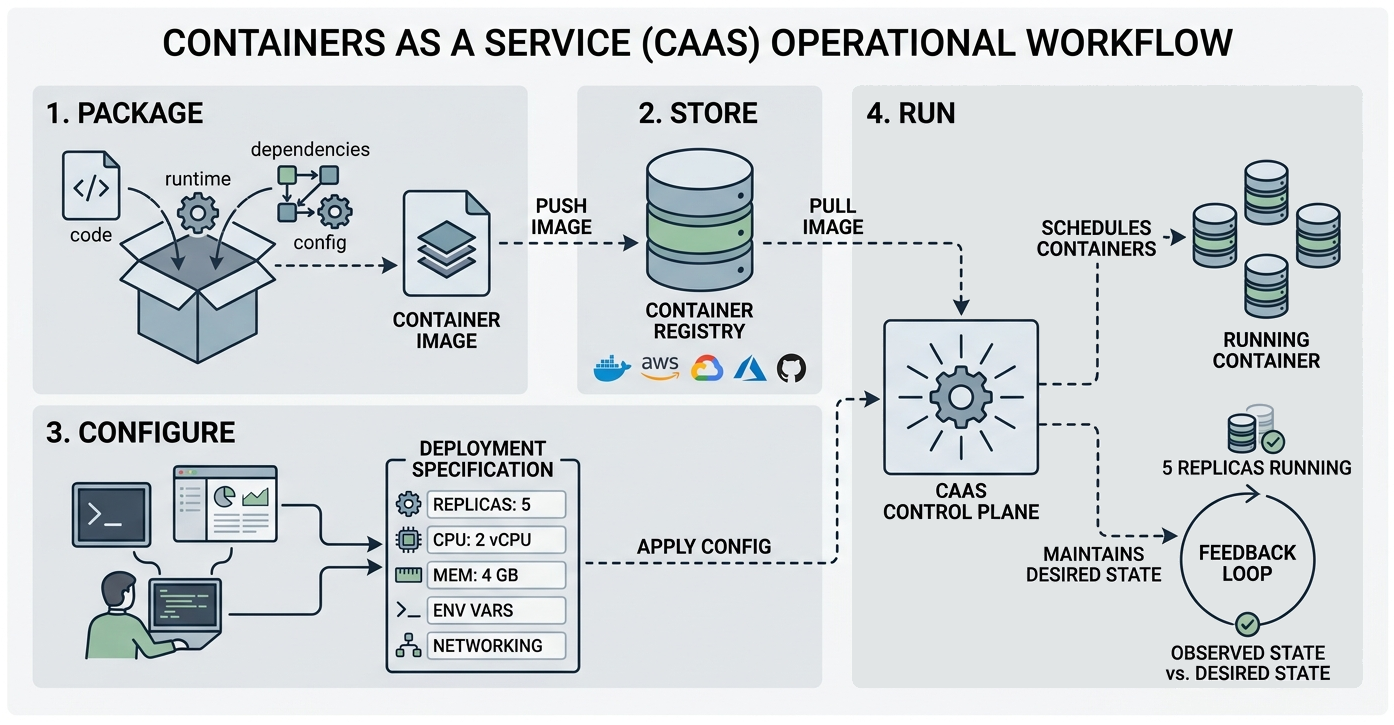
La première étape du déploiement d’une application avec CaaS consiste à empaqueter l’application et tout ce dont elle a besoin pour s’exécuter dans une image de conteneur. Cela inclut le code de l’application, les dépendances, le runtime, la configuration et d’autres composants requis.
L’image est généralement stockée dans un registre de conteneurs, tel que Docker Hub, Amazon ECR, Google Artifact Registry, Azure Container Registry, ou GitHub Container Registry. Un registre agit comme un système centralisé pour stocker, gérer et distribuer des images de conteneurs. Lors du déploiement d’une application, l’image requise est récupérée depuis le registre et utilisée pour créer des conteneurs.
Vous spécifiez ensuite comment l’application doit s’exécuter. Selon la solution CaaS, cela peut inclure le nombre d’instances de conteneurs, les exigences en CPU et mémoire, les règles de mise en réseau, les variables d’environnement et d’autres paramètres de configuration. Ces paramètres peuvent généralement être fournis via une interface web, un outil en ligne de commande, un fichier de configuration ou une API.
Le service CaaS transforme cette configuration en charge de travail en cours d’exécution. Il planifie les conteneurs sur l’infrastructure sous-jacente disponible et travaille en continu pour maintenir l’état souhaité.
Le rôle de l’orchestration de conteneurs
Exécuter un seul conteneur est relativement simple. Cependant, à mesure qu’une application grandit, vous pourriez avoir besoin d’exécuter des dizaines, voire des centaines de conteneurs. Dans la plupart des cas, ces conteneurs doivent communiquer entre eux, s’adapter en fonction de la demande ou se rétablir automatiquement en cas de problème. Gérer tout cela manuellement devient rapidement difficile.
C’est là qu’intervient l’orchestration de conteneurs. L’orchestration automatise les tâches nécessaires pour exécuter et coordonner plusieurs conteneurs. Elle peut ajouter ou supprimer automatiquement des conteneurs en fonction de la demande, vérifier leur état de santé, remplacer les instances défaillantes et permettre aux services de se trouver et de communiquer entre eux.
Kubernetes est la technologie la plus reconnue pour l’orchestration de conteneurs et est couramment utilisée comme base pour les solutions CaaS modernes. Il expose les mécanismes nécessaires pour déployer, planifier, mettre à l’échelle et maintenir des charges de travail conteneurisées sur un cluster de machines.
Cependant, gardez à l’esprit que CaaS et Kubernetes ne sont pas la même chose. Kubernetes est la technologie de référence pour orchestrer les conteneurs, tandis que CaaS offre un moyen géré d’utiliser l’infrastructure de conteneurs sans avoir à tout exploiter soi-même.
Avantages et défis de CaaS
Le modèle Containers as a Service peut simplifier le déploiement et l’exploitation des applications conteneurisées, mais il introduit également de nouvelles considérations.
Principaux avantages :
- Les applications s’exécutent de manière identique dans les environnements de développement, de test et multi-cloud, évitant les bugs de déploiement causés par des incompatibilités de configuration.
- La mise à l’échelle horizontale automatisée ajuste instantanément le nombre de conteneurs pour correspondre aux pics de Trafic, optimisant la consommation des ressources serveur.
- L’externalisation de la gestion des clusters et du provisionnement du système d’exploitation hôte élimine les charges de maintenance d’infrastructure pour les équipes d’ingénierie internes.
- L’isolation granulaire des composants permet le déploiement, la mise à l’échelle et la récupération après incident indépendants pour les architectures modulaires basées sur les microservices.
- L’intégration native avec les pipelines de déploiement continu accélère les cycles de publication en automatisant les tests et la création de conteneurs.
Principaux défis :
- L’architecture à noyau OS partagé introduit des vulnérabilités d’échappement de conteneurs, élargissant la surface d’attaque globale par rapport aux machines virtuelles.
- Les configurations complexes de réseau, de stockage et d’orchestration créent des courbes d’apprentissage abruptes et nécessitent une expertise opérationnelle spécialisée.
- Les API spécifiques aux fournisseurs et les outils d’orchestration propriétaires compliquent la migration des charges de travail entre différents fournisseurs de services cloud.
CaaS pour les données web et les workflows IA
Découvrez pourquoi Containers as a Service est particulièrement bien adapté à la collecte de données web et aux workflows qui préparent des données fraîches pour les applications IA.
Applications courantes
L’un des scénarios les plus populaires pour CaaS est l’exécution de microservices. Chaque service peut s’exécuter dans son propre conteneur, vous permettant de déployer, mettre à jour et faire évoluer des composants individuels séparément.
Le modèle est également utile pour la modernisation des applications, le déploiement continu, l’infrastructure hybride et les charges de travail avec des exigences de ressources variables. Les conteneurs fournissent des environnements d’exécution cohérents, tandis que la couche CaaS fournit l’infrastructure nécessaire pour les exécuter et les mettre à l’échelle.
Une autre adéquation naturelle concerne toute charge de travail impliquant des tâches répétées ou parallèles. Au lieu de tout traiter une tâche à la fois, vous pouvez distribuer des jobs individuels sur plusieurs workers conteneurisés. Cette approche fonctionne particulièrement bien pour les pipelines de données, où les workers peuvent indépendamment récupérer, transformer, valider, enrichir ou traiter des données.
CaaS pour la collecte de données web
Le Scraping web est un bon exemple de charge de travail pouvant bénéficier d’une exécution conteneurisée. Imaginez que vous devez récupérer des données depuis des milliers d’URL. Plutôt que de les traiter séquentiellement dans une seule application, vous pouvez distribuer les URL sur plusieurs workers conteneurisés.
Chaque worker peut traiter ses tâches assignées de manière autonome, vous permettant d’augmenter la capacité de collecte en exécutant davantage de conteneurs. Une file d’attente de tâches peut améliorer encore cette architecture en distribuant les jobs dynamiquement à mesure que les workers deviennent disponibles.
CaaS pour les workflows de traitement de données IA
L’architecture mentionnée précédemment peut s’étendre au-delà de la collecte de données. Les workers conteneurisés peuvent récupérer des données web fraîches, les traiter et les enrichir, puis acheminer les informations résultantes vers des systèmes d’analyse, des bases de données, des pipelines RAG ou des applications IA.
En détail, une file d’attente pourrait distribuer des milliers de tâches de collecte de données entre des workers. Une fois collectées, un autre ensemble de workers pourrait nettoyer et structurer les résultats avant de les transmettre à un agent IA ou un LLM.
Mise à l’échelle de la collecte de données web avec CaaS et Bright Data
CaaS fournit l’infrastructure d’exécution pour les workers de scraping conteneurisés, mais ne résout pas les défis d’accès aux sites web à grande échelle. L’automatisation des navigateurs, la gestion des Proxys, la rotation des IP, le blocage des sites web et les mécanismes anti-bot nécessitent tous une infrastructure supplémentaire.
C’est là que Bright Data s’intègre dans l’architecture. Son infrastructure de données web fournit l’accès à un large réseau de Proxys et des API gérées pour l’accès web, la recherche, l’automatisation des navigateurs et l’extraction de données structurées.
Bright Data est soutenu par un réseau de Proxys de plus de 400 millions d’IP, une concurrence illimitée, une disponibilité de 99,99 % et un taux de succès de 99,95 % sur l’ensemble de son réseau.
L’idée est de séparer les deux couches :
- CaaS fournit un calcul évolutif pour votre application.
- Bright Data apporte l’infrastructure nécessaire pour accéder et collecter des données web.
Apprenez-en davantage sur la façon de combiner CaaS et Bright Data pour créer des pipelines de données et des workflows IA prêts pour la production !
Étape #1 : Choisir la bonne API Bright Data
La première étape consiste à choisir les produits Bright Data qui correspondent au type de données que vous devez collecter. Ceux-ci incluent :
- API de Scraping web : Extrayez des données structurées depuis plus de 800 domaines pris en charge à l’aide de plus de 1 500 Scrapers préconstruits.
- API Web Unlocker : Récupérez du contenu depuis des pages web tout en gérant de nombreux défis d’accès, notamment les Proxys, les blocages et les CAPTCHA.
- API SERP : Récupérez des résultats de recherche structurés depuis des moteurs tels que Google, Bing, Yandex et plus encore.
- API Navigateur : Exécutez des sessions de navigateur gérées pour les sites web nécessitant l’exécution JavaScript, des clics, du défilement ou d’autres automatisations de navigateur.
Note : Tous ces produits sont inclus dans le niveau gratuit mensuel récurrent de Bright Data, vous pouvez donc les utiliser gratuitement.
Étape #2 : Créer un worker de scraping conteneurisé
Après avoir sélectionné l’API de données web appropriée, vous pouvez empaqueter votre application sous forme de conteneur. Celle-ci doit simplement envoyer des requêtes aux API Bright Data choisies et optionnellement traiter les données retournées.
Par exemple, un worker Python peut utiliser l’API Web Unlocker pour récupérer du contenu Markdown prêt pour les LLM depuis une page web :
# worker.py

import os
import requests

def fetch_page(url):
    response = requests.post(
        "https://api.brightdata.com/request",
        headers={
            "Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "zone": os.environ["BRIGHTDATA_WEB_UNLOCKER_API"], # Replace with your Bright Data Web Unlocker API name
            "url": url,
            "format": "raw",
            "data_format": "markdown",
        },
    )

    response.raise_for_status()

    return response.text
Pour plus d’informations sur l’intégration, consultez la documentation Web Unlocker de Bright Data.
Notez qu’il n’y a rien de spécifique à Docker dans cette requête. L’application utilise une requête HTTP standard via la bibliothèque Python requests. Ainsi, le même code peut s’exécuter localement, sur une machine virtuelle ou dans un conteneur géré par un service CaaS.
Ensuite, vous pouvez lister les dépendances requises dans un fichier requirements.txt. Celui-ci contiendra :
requests==2.34.2Pour conteneuriser le worker, vous pouvez ensuite écrire un Dockerfile simple :
FROM python:3.14-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

CMD ["python", "worker.py"]
Vous devez également fournir la clé API Bright Data et le nom de l’API Web Unlocker séparément de votre code d’application. Lors du développement local, vous pouvez utiliser un fichier .env :
BRIGHTDATA_API_KEY=<BRIGHTDATA_API_KEY>
BRIGHTDATA_WEB_UNLOCKER_ZONE=<BRIGHTDATA_WEB_UNLOCKER_API>
Pour les déploiements en production, vous devriez utiliser la fonctionnalité de gestion des secrets de votre fournisseur CaaS pour injecter la clé API dans le conteneur.
Très bien ! De même, vous pouvez conteneuriser des applications qui appellent d’autres produits basés sur l’API Bright Data.
Étape #3 : Distribuer le travail entre les conteneurs
Une fois que le worker de scraping fonctionne correctement, l’architecture peut mettre à l’échelle le nombre d’instances de workers en fonction de la charge de travail.
Imaginez maintenant une file d’attente de scraping contenant 100 000 URL. Le service CaaS peut exécuter plusieurs instances du worker et distribuer les tâches entre elles. À mesure que la charge de travail augmente, davantage de workers seront ajoutés pour traiter les requêtes simultanément. C’est bien mieux que de les traiter séquentiellement dans une seule application.
N’oubliez pas que l’API Web Unlocker, comme tout autre produit Bright Data, est conçue pour la collecte de données à grande échelle. Cela signifie que vous pouvez mettre à l’échelle le nombre de workers conteneurisés sans vous soucier des problèmes de concurrence.
Étape #4 : Traiter et utiliser les données retournées
L’architecture finale ressemble à ceci :
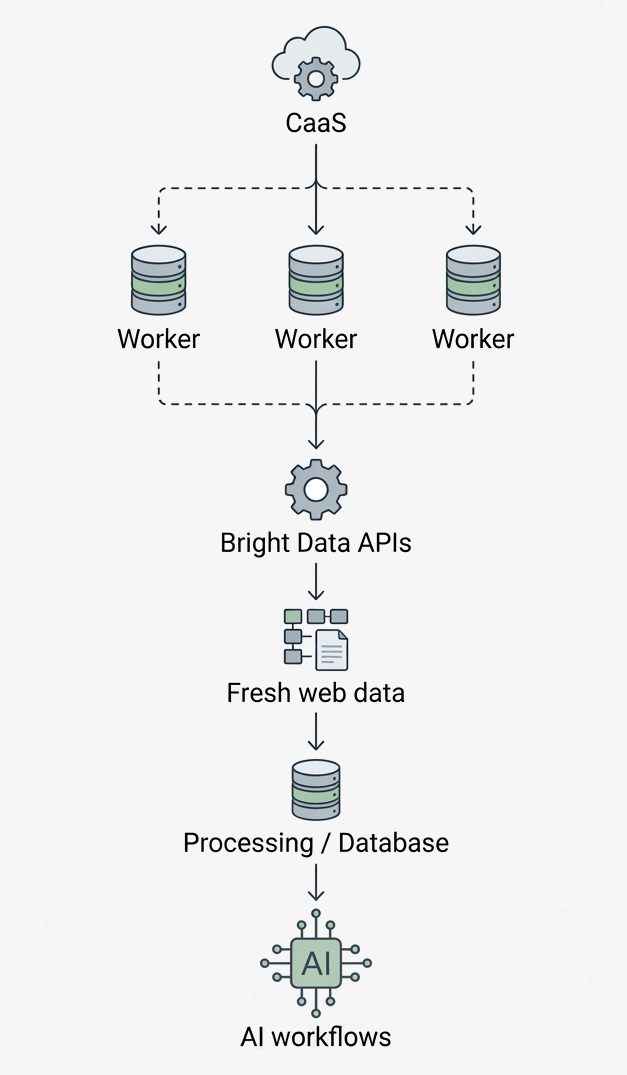
Une file d’attente de tâches peut se placer entre l’application et les workers, permettant aux jobs d’être distribués dynamiquement à mesure que les conteneurs deviennent disponibles. Si la charge de travail augmente, vous pouvez exécuter davantage de workers. Lorsque la demande diminue, vous pouvez les réduire.
Cela crée une séparation nette des responsabilités :
- CaaS : Fournit l’environnement de calcul et met à l’échelle les workers conteneurisés.
- Docker : Empaquète l’application et ses dépendances dans un runtime portable.
- Bright Data : Fournit l’infrastructure spécialisée pour accéder et collecter des données web à grande échelle.
- Votre application : Traite les données retournées et les envoie vers des bases de données, des systèmes basés sur le ML ou des agents IA.
Notez que CaaS ne facilite pas en soi la récupération web. Il facilite le déploiement et la mise à l’échelle des applications de Scraping web. Combiné à une infrastructure de données web gérée comme Bright Data, il vous permet de créer des pipelines de données web évolutifs pour l’analyse et l’IA sans gérer vous-même chaque couche de la pile d’accès web. Extraordinaire !
Conclusion
Dans cet article, vous avez appris à utiliser Containers as a Service (CaaS) pour créer des pipelines de données web évolutifs et des workflows IA. Comme illustré ici, la combinaison de CaaS avec Bright Data vous permet de mettre à l’échelle les couches de calcul et de données web de votre architecture.
Cette intégration vous permet de distribuer la collecte de données sur des workers conteneurisés, de récupérer des données web fraîches via les API Bright Data et d’envoyer les résultats aux composants en aval.
Créez un nouveau compte Bright Data et commencez à utiliser nos API pour créer des pipelines de données et de traitement IA évolutifs !
FAQ
Quelle est la différence entre CaaS et une infrastructure de conteneurs DIY ?
Avec CaaS, le fournisseur cloud gère une grande partie de l’infrastructure sous-jacente et des opérations sur les conteneurs. Avec une approche DIY, vous êtes responsable de la configuration, de la maintenance, de la mise à l’échelle et de la sécurisation de l’environnement de conteneurs.
| CaaS | DIY | |
|---|---|---|
| Infrastructure | Gérée par le fournisseur | Gérée par votre équipe |
| Orchestration | Gérée ou intégrée | Configurée et maintenue par votre équipe |
| Mise à l’échelle | Automatisation intégrée | À configurer et maintenir soi-même |
| Maintenance | Plus faible | Plus élevée |
| Contrôle | Moins de contrôle au niveau infrastructure | Plus grand contrôle |
| Expertise | Moins requise | Plus requise |
En résumé, CaaS réduit la charge opérationnelle, tandis que DIY offre un plus grand contrôle et une meilleure personnalisation. Découvrez-en plus sur le débat entre services gérés et DIY.
CaaS vs IaaS vs PaaS vs FaaS vs SaaS : Quelle est la différence ?
Les modèles de service cloud diffèrent principalement par la quantité de gestion d’infrastructure et d’application qu’ils laissent à l’utilisateur :
| Modèle | Ce qu’il fournit | Vous gérez | Le fournisseur gère | Utilisation typique |
|---|---|---|---|---|
| IaaS (Infrastructure as a Service) | Calcul virtualisé, stockage et réseau | OS, middleware, runtime, applications et données | Infrastructure physique et virtualisation | Infrastructure et applications personnalisées |
| CaaS (Containers as a Service) | Environnement géré pour applications conteneurisées | Images de conteneurs, applications et configurations | Infrastructure, orchestration et mise à l’échelle des conteneurs | Applications conteneurisées et microservices |
| PaaS (Platform as a Service) | Plateforme applicative et runtime gérés | Code d’application et données | Infrastructure, OS, runtime et plateforme | Développement et déploiement d’applications |
| FaaS (Function as a Service) | Exécution de fonctions serverless pilotées par événements | Fonctions individuelles et leur code | Serveurs, runtime, mise à l’échelle et infrastructure | Tâches éphémères pilotées par événements |
| SaaS (Software as a Service) | Logiciel complet prêt à l’emploi | Configuration et données | Pile applicative complète et infrastructure | Applications destinées aux utilisateurs finaux |
CaaS se situe entre IaaS et PaaS, vous donnant le contrôle sur les applications conteneurisées tandis que le fournisseur gère une grande partie de l’infrastructure sous-jacente et de l’orchestration.
Bright Data prend-il en charge le modèle de service cloud CaaS ?
Bright Data complète CaaS en fournissant l’infrastructure de données web nécessaire pour la collecte de données à grande échelle, tandis que CaaS fournit l’infrastructure de calcul pour exécuter et mettre à l’échelle vos workers conteneurisés.