Dans la nouvelle ère de l’ingénierie agentique, le « contexte » n’est plus simplement de la donnée ; c’est le carburant de chaque décision que prend votre agent. Pourtant, la plupart des équipes traitent le contexte comme une entrée statique plutôt que comme un défi d’ingénierie dynamique. Le vrai goulot d’étranglement n’est pas seulement l’accès aux données – c’est la capacité à façonner ces données dans un état suffisamment frais, vérifié et efficace en tokens pour un raisonnement fiable.
Le Contexte en tant que Service est apparu comme une solution fondamentale pour fournir aux agents le meilleur contexte possible. Le CaaS fournit l’infrastructure permettant de transformer ces gigantesques données web non structurées en une base de connaissances prête pour les agents. Ils investissent du temps dans l’ingénierie du contexte et des sources à partir desquelles les agents reçoivent leurs informations finales connectées et structurées.
Le CaaS fait le lien entre la base de connaissances brute que les humains ont mis toute une vie à construire (les données web) et l’exécution intelligente en proposant des couches de données spécifiques à un domaine ; garantissant que les agents ne cherchent pas des informations, mais sont alimentés par un contexte enrichi et vérifié, adapté au raisonnement automatisé et à la prise de décision.
Cependant, cela a un coût : vous louez constamment le contexte conçu par quelqu’un d’autre pour alimenter vos agents.
Le coût caché de la location de contexte
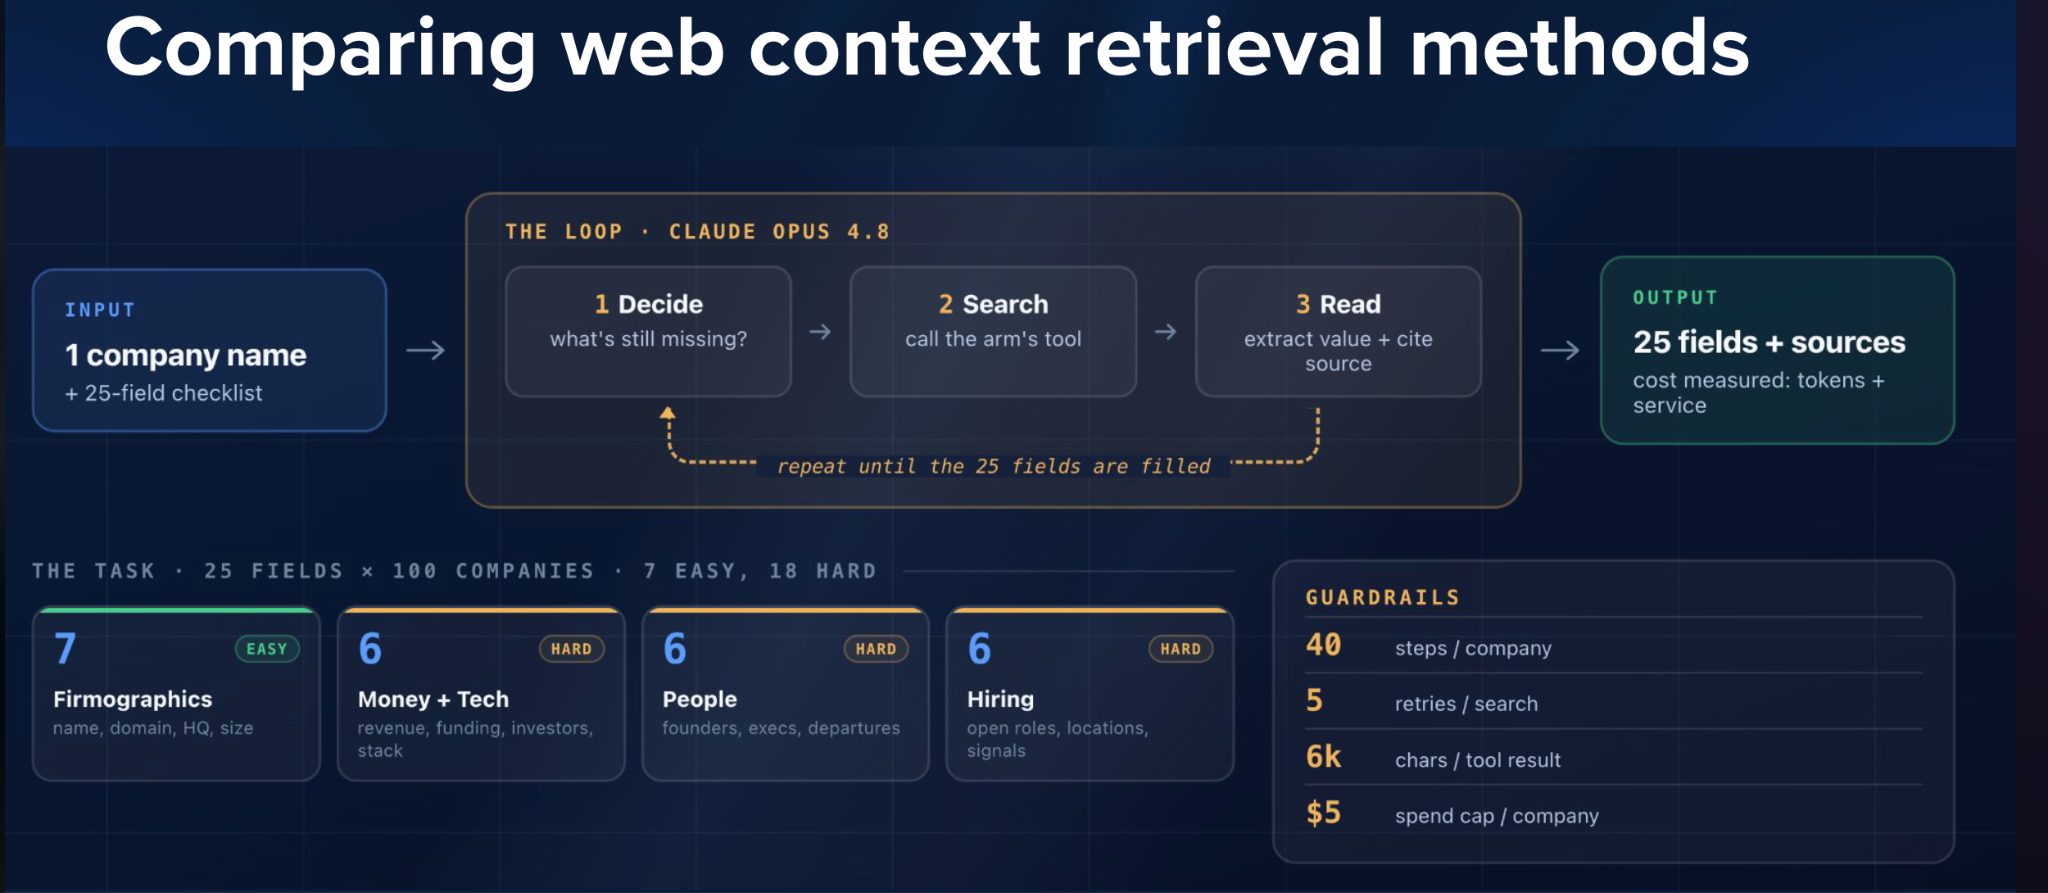
Pour comprendre les compromis économiques de cette infrastructure, nous avons demandé à un agent IA d’enrichir 100 entreprises avec 25 champs de données en utilisant différentes méthodes de récupération. Les champs comprenaient des données firmographiques faciles à obtenir (siège social, nombre d’employés, domaine) et des données plus difficiles comme les revenus, les données financières, la pile technologique, les personnes et les signaux de recrutement.
L’outil de récupération auquel l’IA avait accès était la seule variable changeante.
Structure du harnais
Méthodes comparées
| Nom public | Ce qu’il représente |
|---|---|
| Search 1 / Search 2 / Search 3 | Outils de recherche IA conçus pour alimenter une fenêtre de contexte plutôt qu’un onglet de navigateur. |
| Native | Recherche native au modèle dans l’environnement du modèle. |
| CaaS 1 / CaaS 2 / CaaS 3 | Services de contexte et fournisseurs verticaux. |
| Unlocker + SERP | Agent sur infrastructure web brute : résultats de recherche et pages débloquées. |
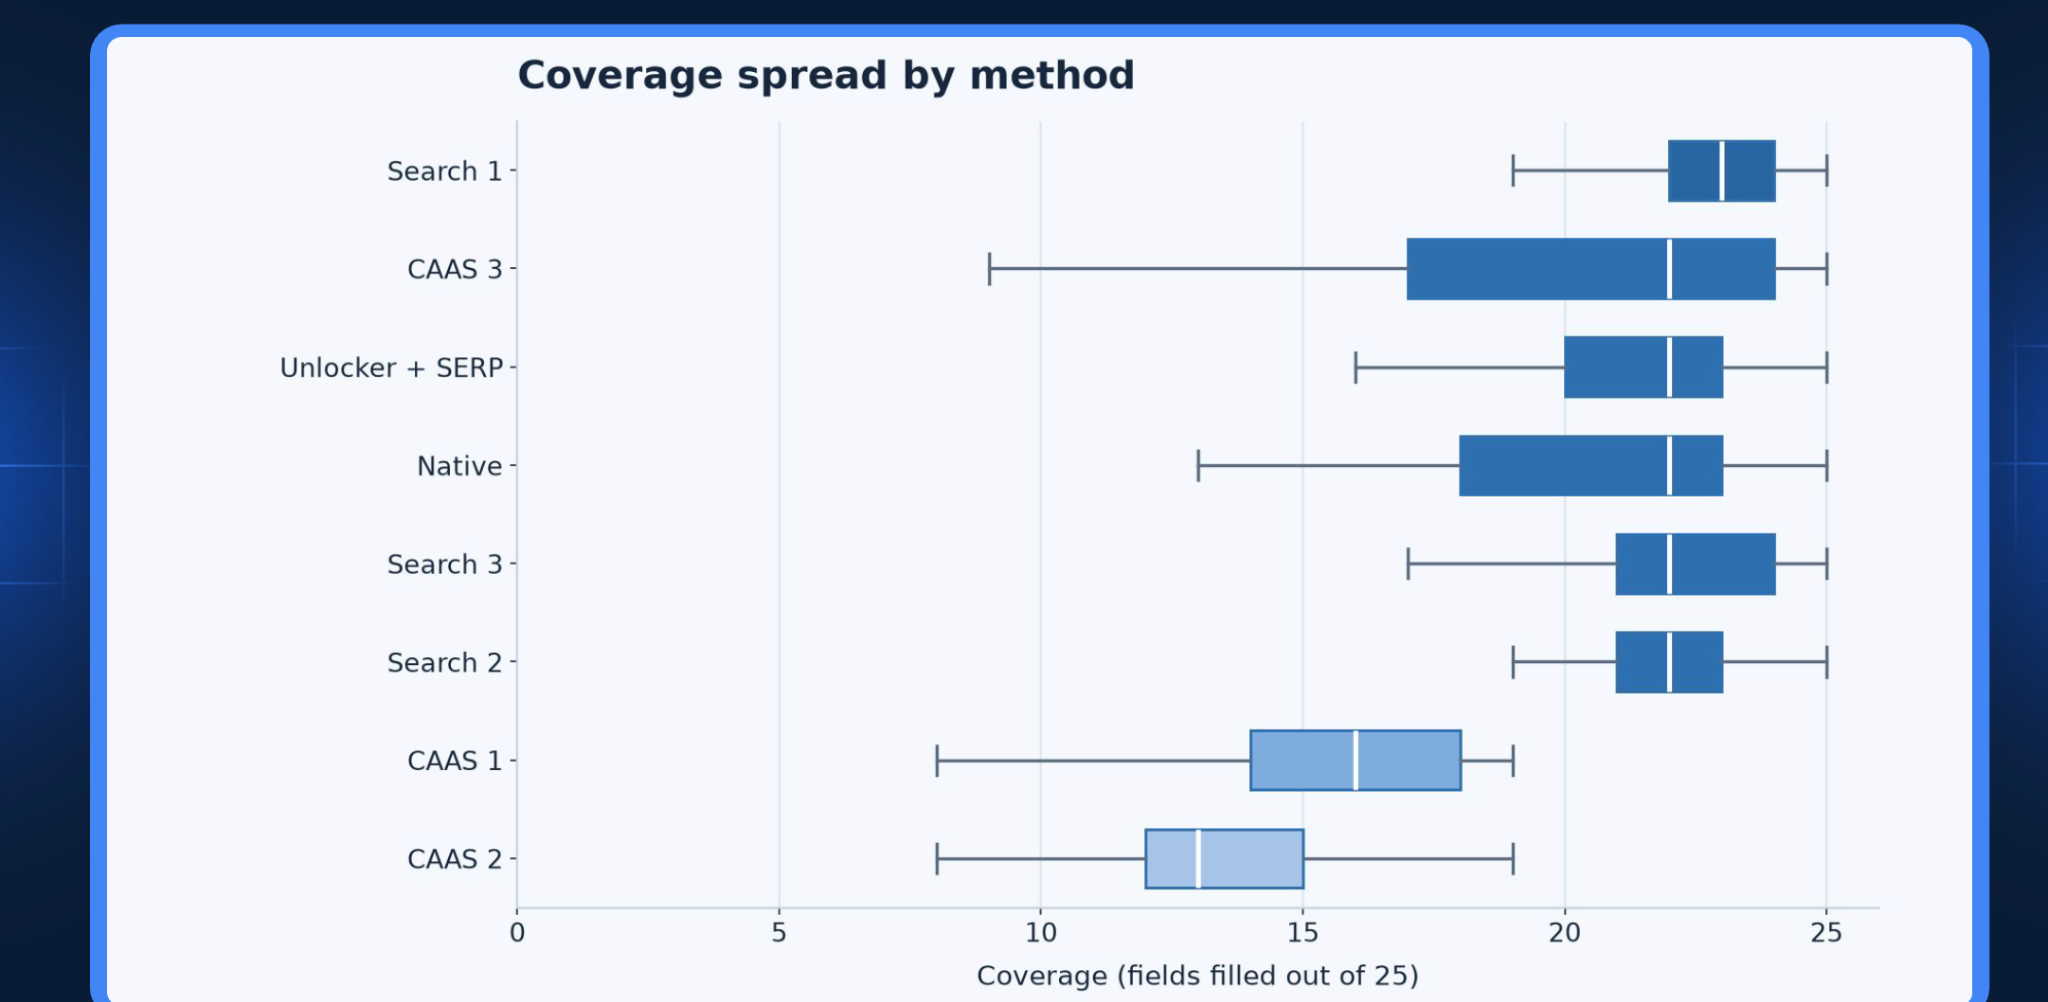
La couverture représente la quantité de données que chaque méthode a pu renseigner…
Le coût se décompose en deux parties : le prix du service lui-même, et les tokens que l’IA dépense pour absorber et structurer les données.
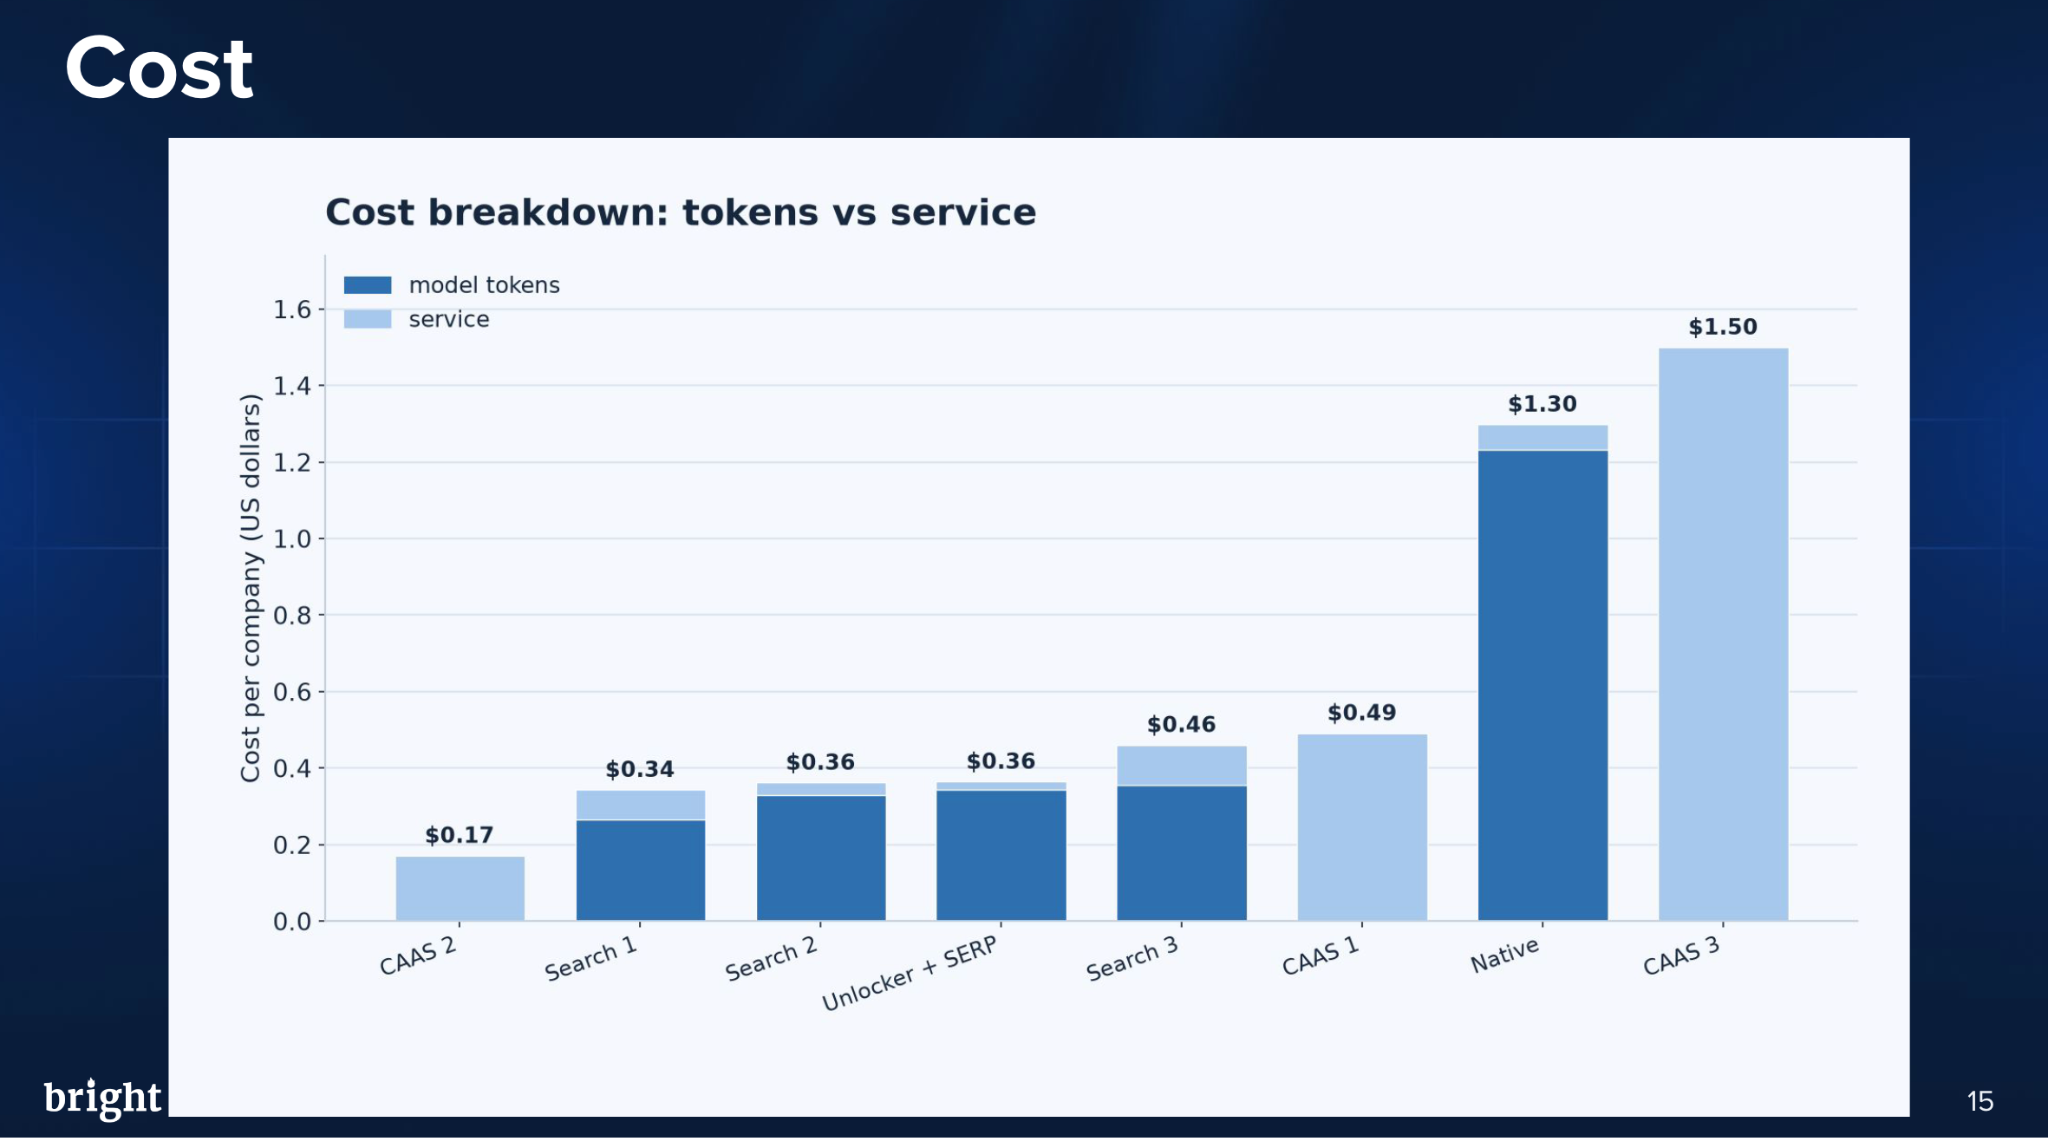
Les recherches et les CaaS sont idéaux pour ce cas d’usage – quand vous voulez des données de base rapidement, exactement comme une voiture de location.
Mais est-ce que cela s’adapte à l’échelle ?
Il y a une structure de base ici : vous payez à chaque fois que vous demandez du contexte. Que vous demandiez pour 100 entreprises, 1k, 100k, ou des millions d’entreprises ou de données, vous « louez » toujours vos données.
- Chaque entité répétée coûte autant que la première
- Bruit et faux positifs que vous ne pouvez pas filtrer
- Les coûts en tokens ne se compriment pas avec le volume
- Les équipes commencent à rogner sur les coins pour gérer la facture
À grande échelle, il est assez évident que mieux vaut posséder la voiture que d’en louer une chaque jour pour aller au même endroit.
Alors comment la posséder ? Comment posséder votre outil de recherche IA ou votre CaaS ?
L’ingénierie du contexte web
L’ingénierie du contexte web consiste à architecturer vos diverses sources en un pipeline spécifique que vous pouvez réutiliser et faire évoluer, et à apporter l’information de la meilleure façon possible pour l’IA.
Au lieu de demander à un agent de chercher sur le web en direct pour chaque entreprise, nous avons construit un pipeline répétable s’appuyant sur des scrapers.
Nous avons utilisé Scraper Studio de Bright Data, ainsi que certains scrapers Bright Data existants, pour collecter les sources que nous savions importantes, puis nous avons mappé ces enregistrements dans les mêmes 25 champs.
L’agent n’effectue plus tout le travail de récupération en direct. La couche de contexte fait davantage de travail avant que le modèle ne le voie jamais.
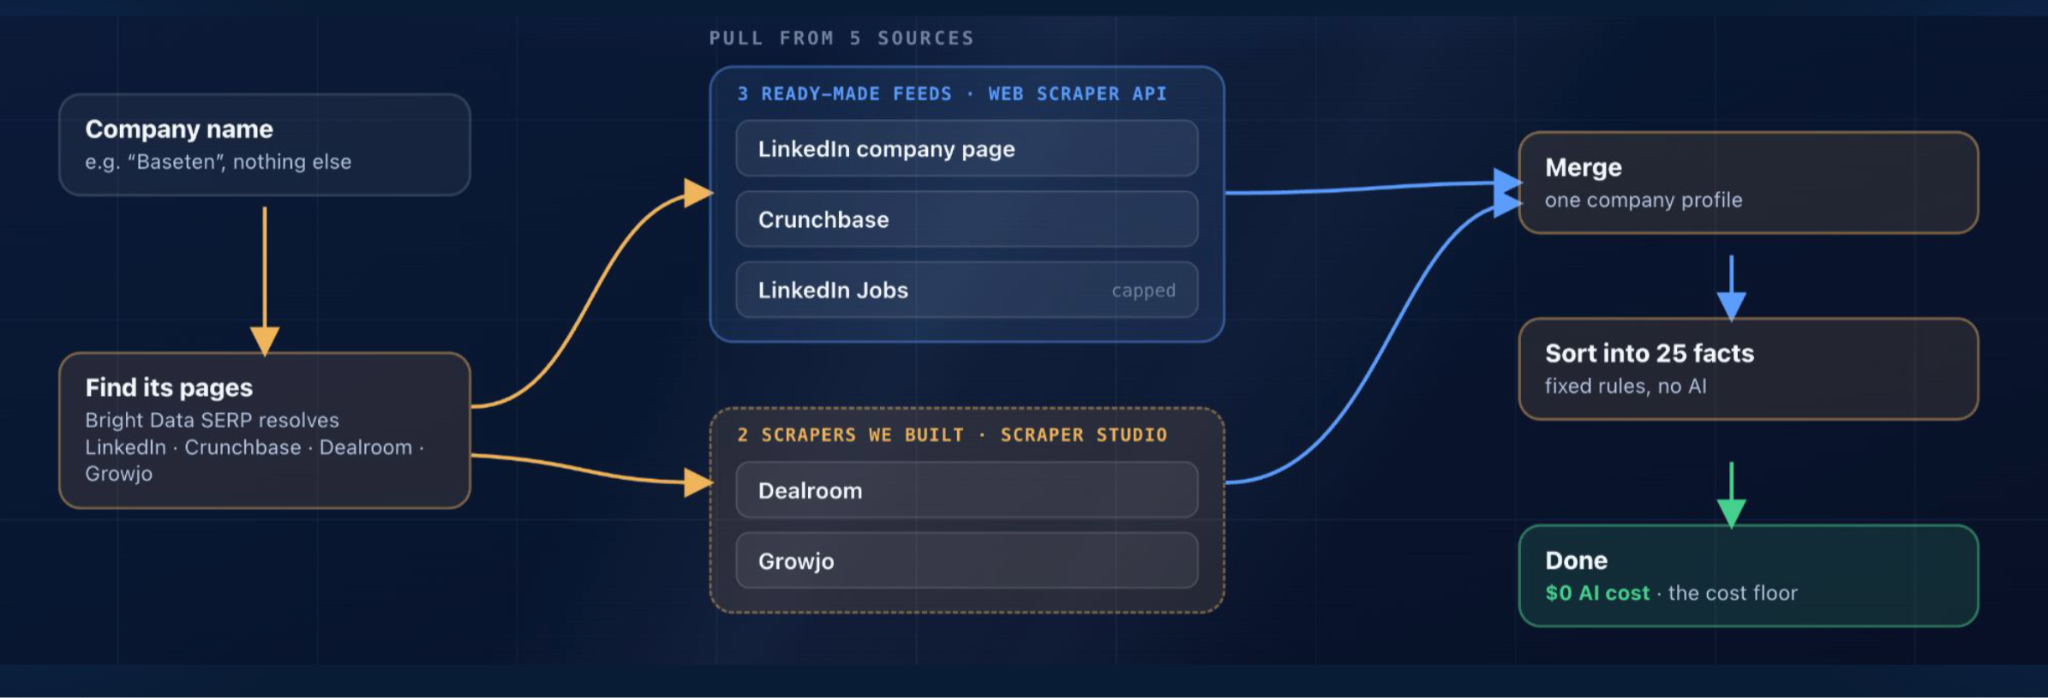
Figure : pipeline de contexte propriétaire
Rebondissement : le coût de configuration
Pour rendre la comparaison équitable, nous avons également attribué au pipeline propriétaire un vrai coût de configuration.
Imaginez que j’aie engagé la personne la plus intelligente que je connaisse pour construire ce scraper et lui aie payé un exagéré de 5 000 $ pour rechercher et planifier les sources d’où extraire les données, ce qui a réellement pris environ trois heures de discussion avec Claude.
Et nous avons appelé cette méthode DIY, qui signifie « Faites-le (ou construisez-le) vous-même ».
Après cela, le chiffre important est le coût marginal à chaque fois que nous enrichissons une autre entreprise.
L’avantage DIY : construire pour l’échelle
La couverture est à peu près la même ; bien qu’elle soit légèrement inférieure, il n’y a pas d’écart majeur.
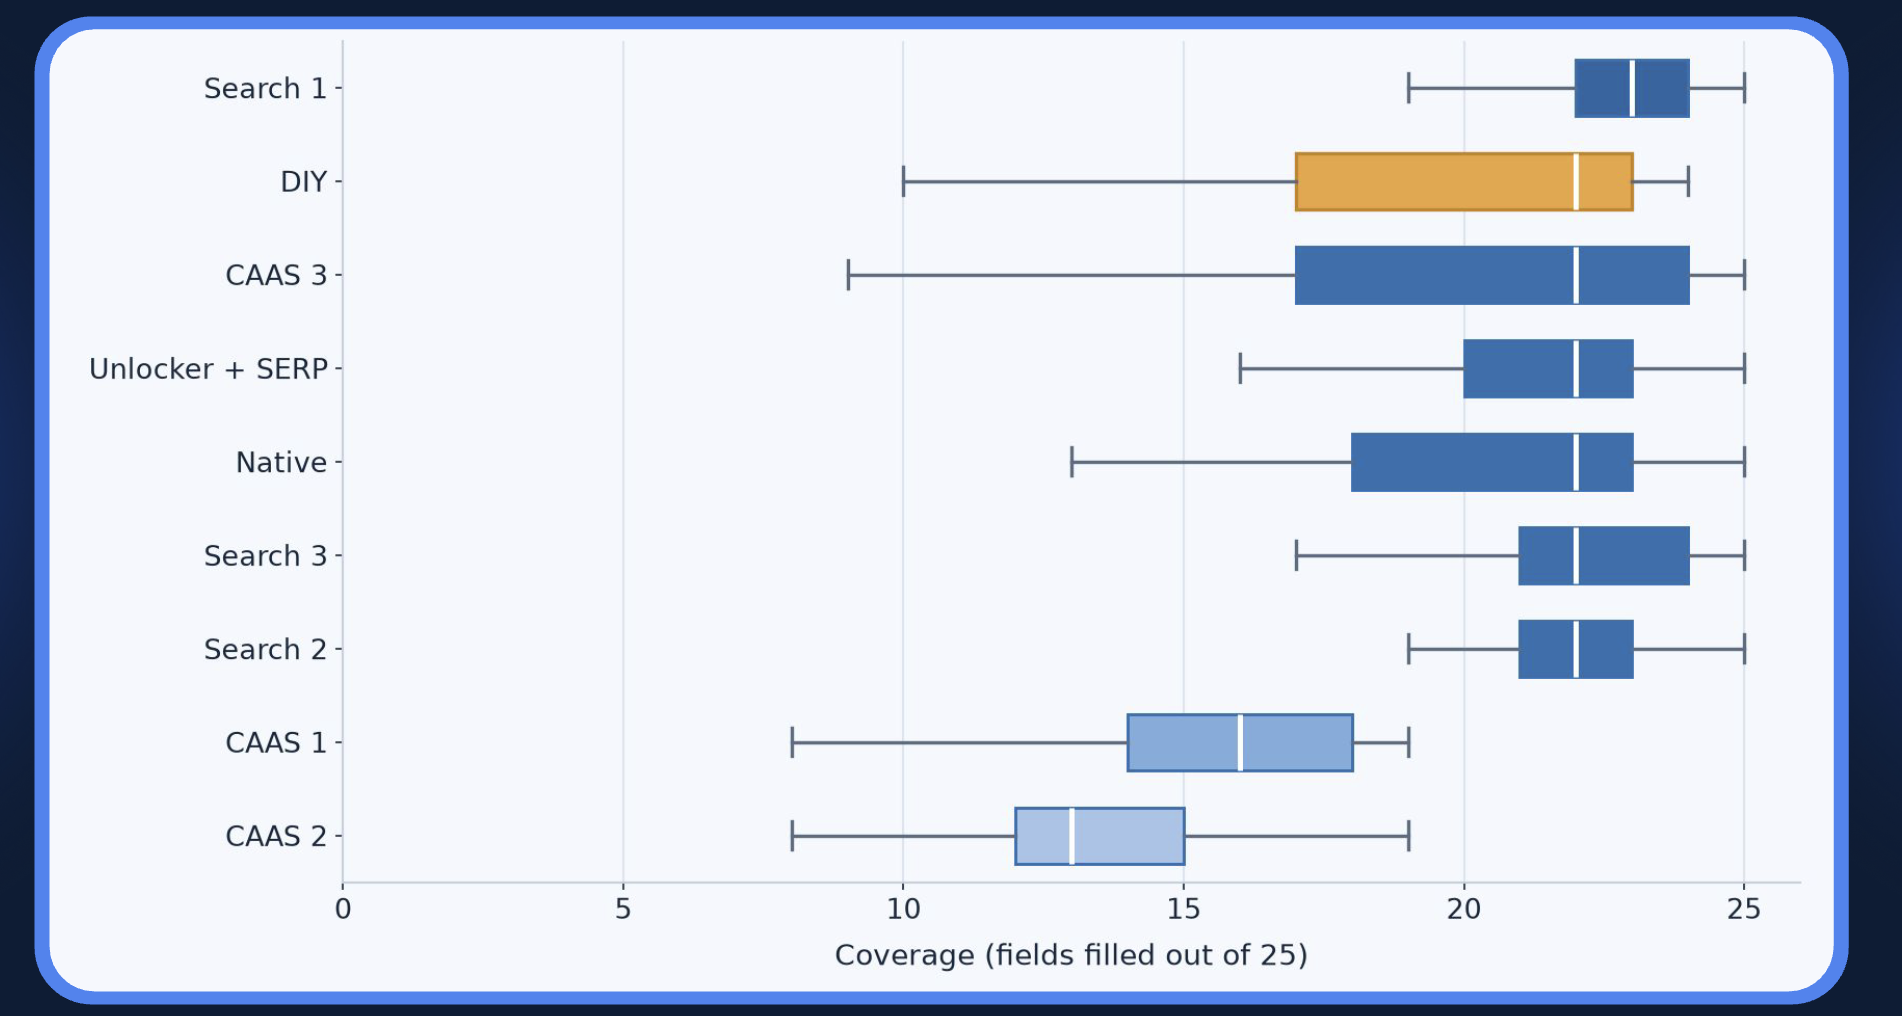
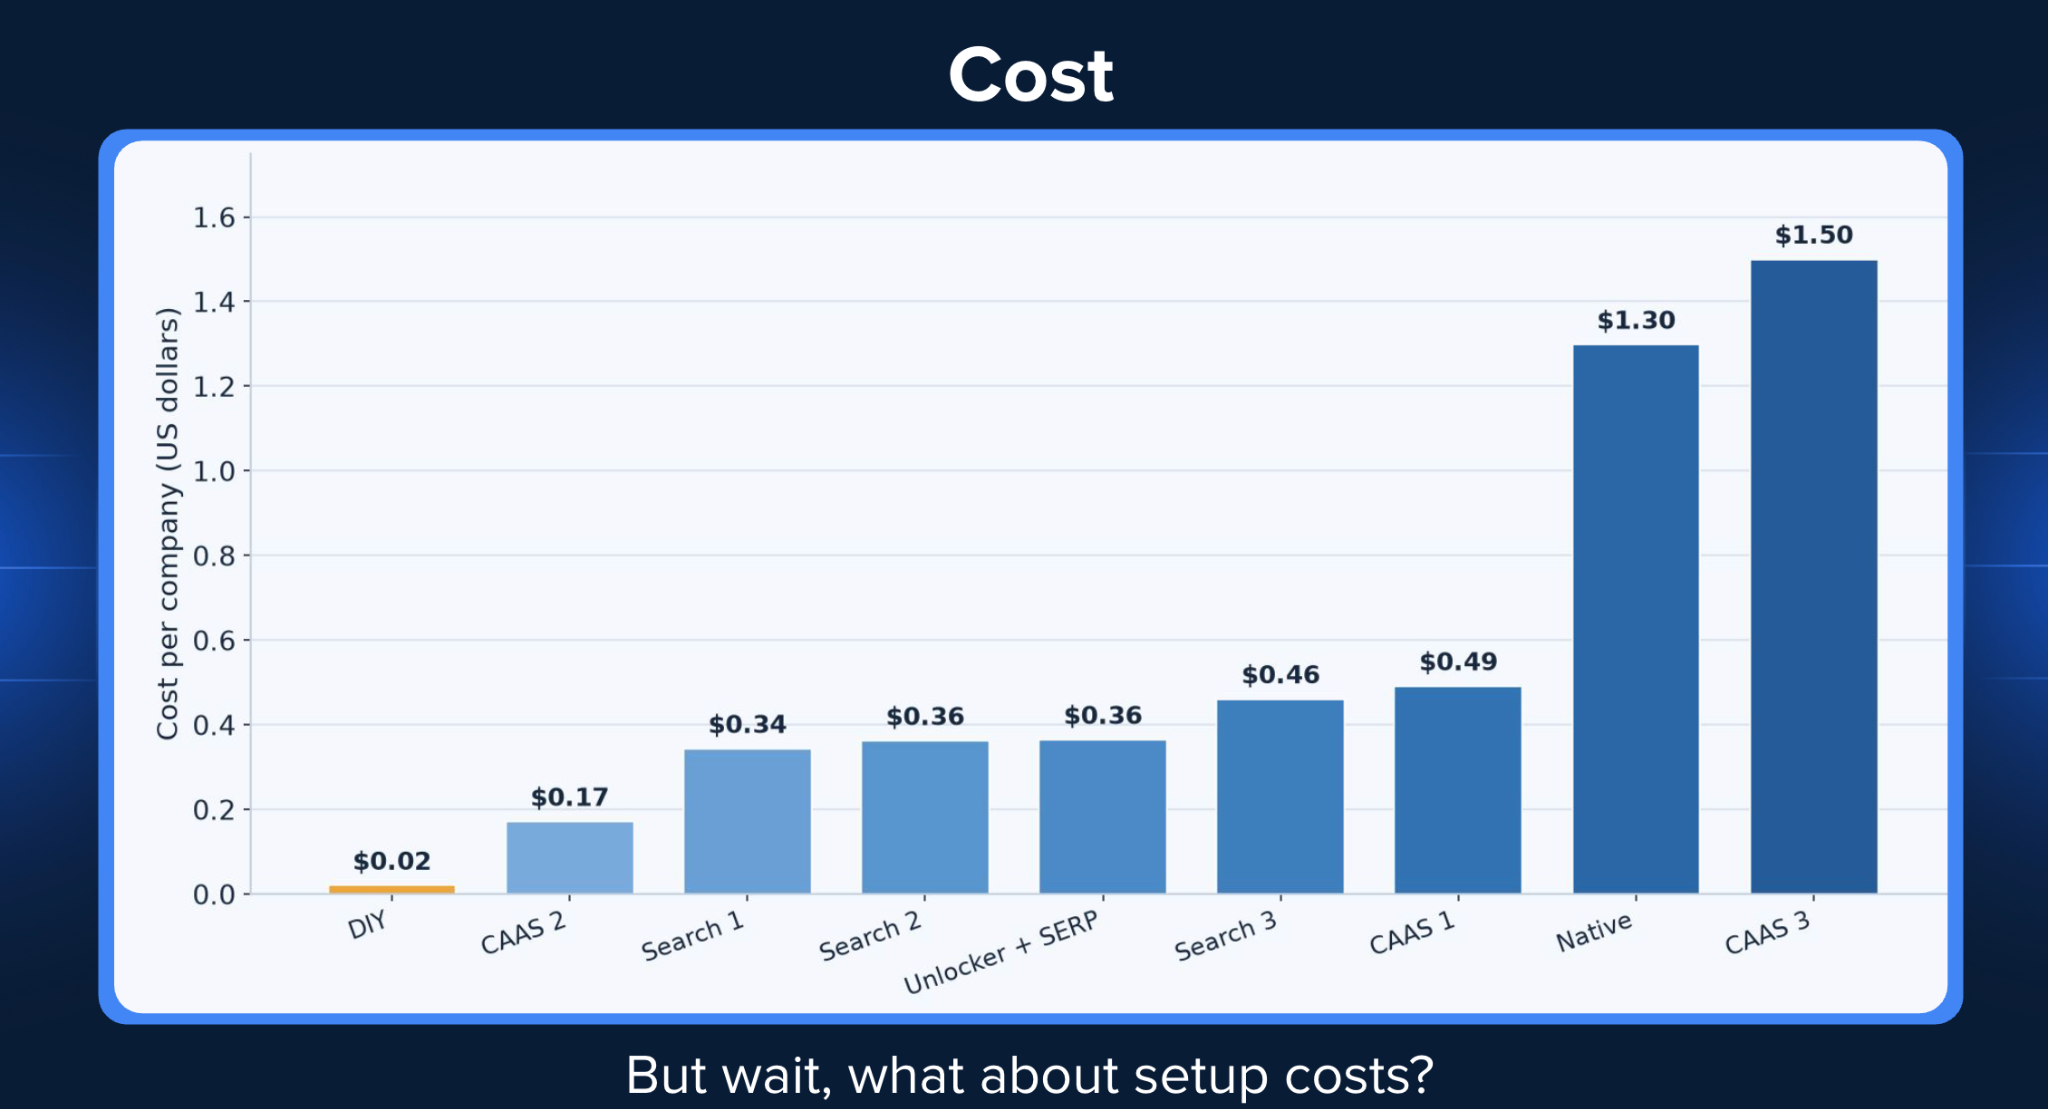
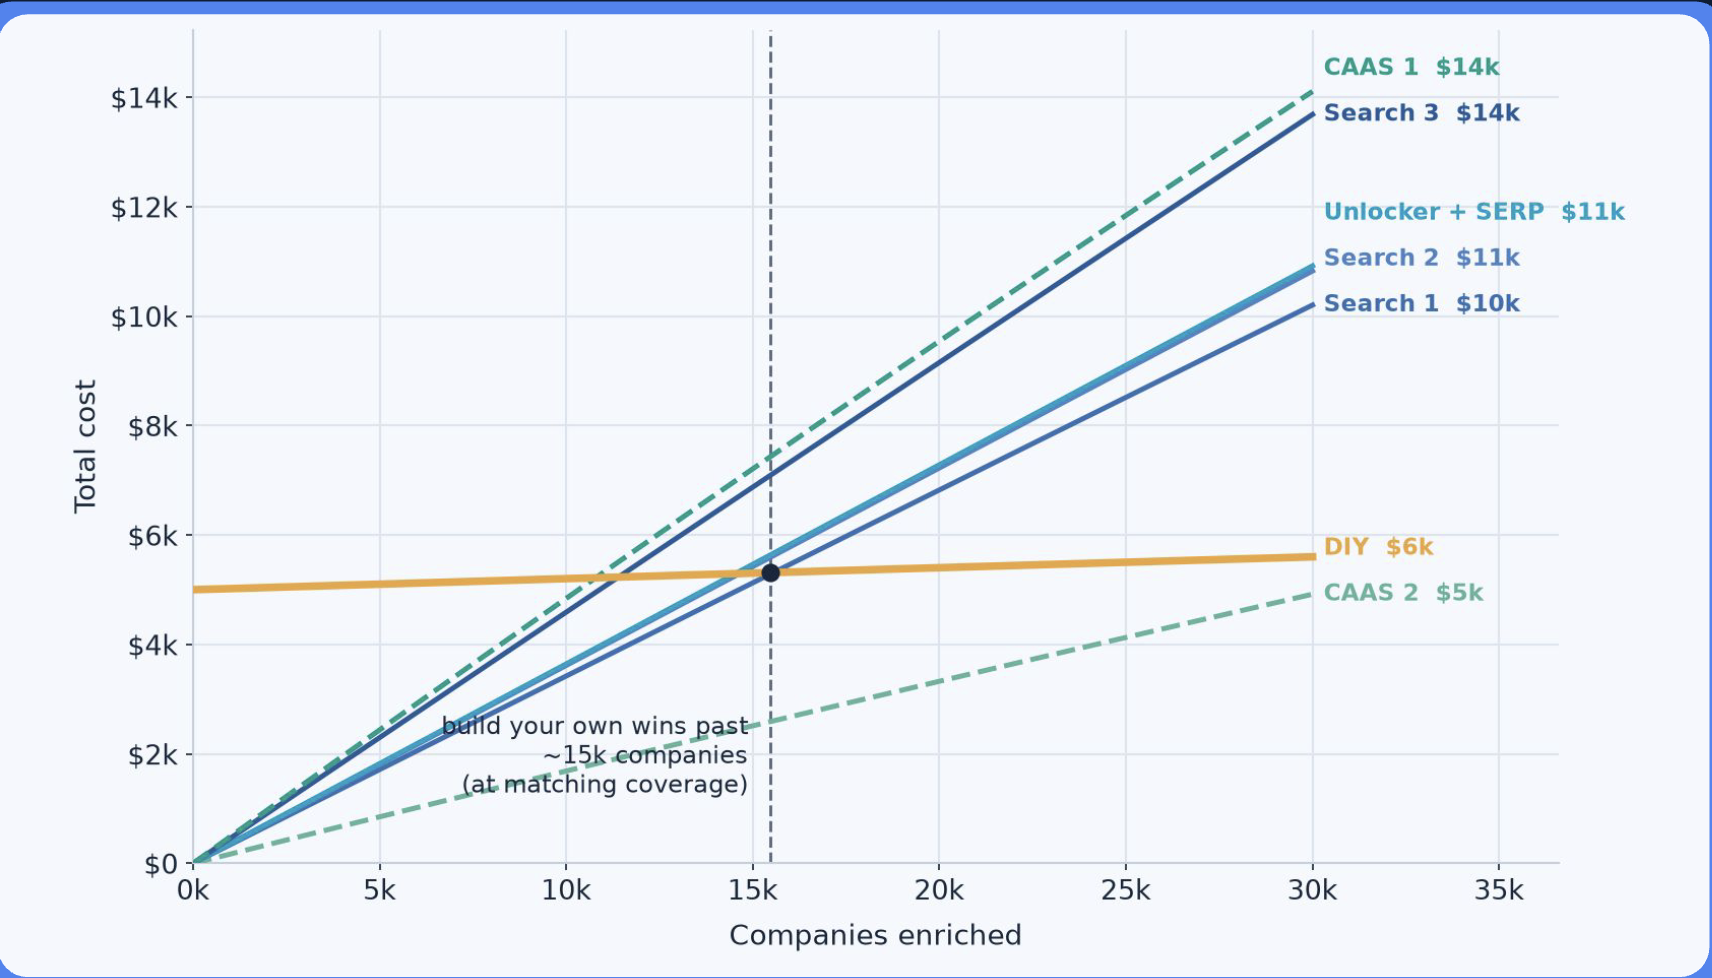
Figure : point de bascule entre construire et louer
À petite échelle, la location peut encore être le choix évident. À plus grande échelle, le coût de construction unique se répartit sur de plus en plus d’enrichissements.
Le point de bascule nous indique qu’au-delà d’une certaine échelle, posséder votre pipeline devient bien plus efficace.
L’économie de l’ingénierie du contexte web
Comme le montrent les données, le modèle de location a un plafond. À un certain volume, le coût de ces services dépasse l’investissement initial de la construction de votre propre infrastructure. Prenons du recul vers une plus grande échelle…
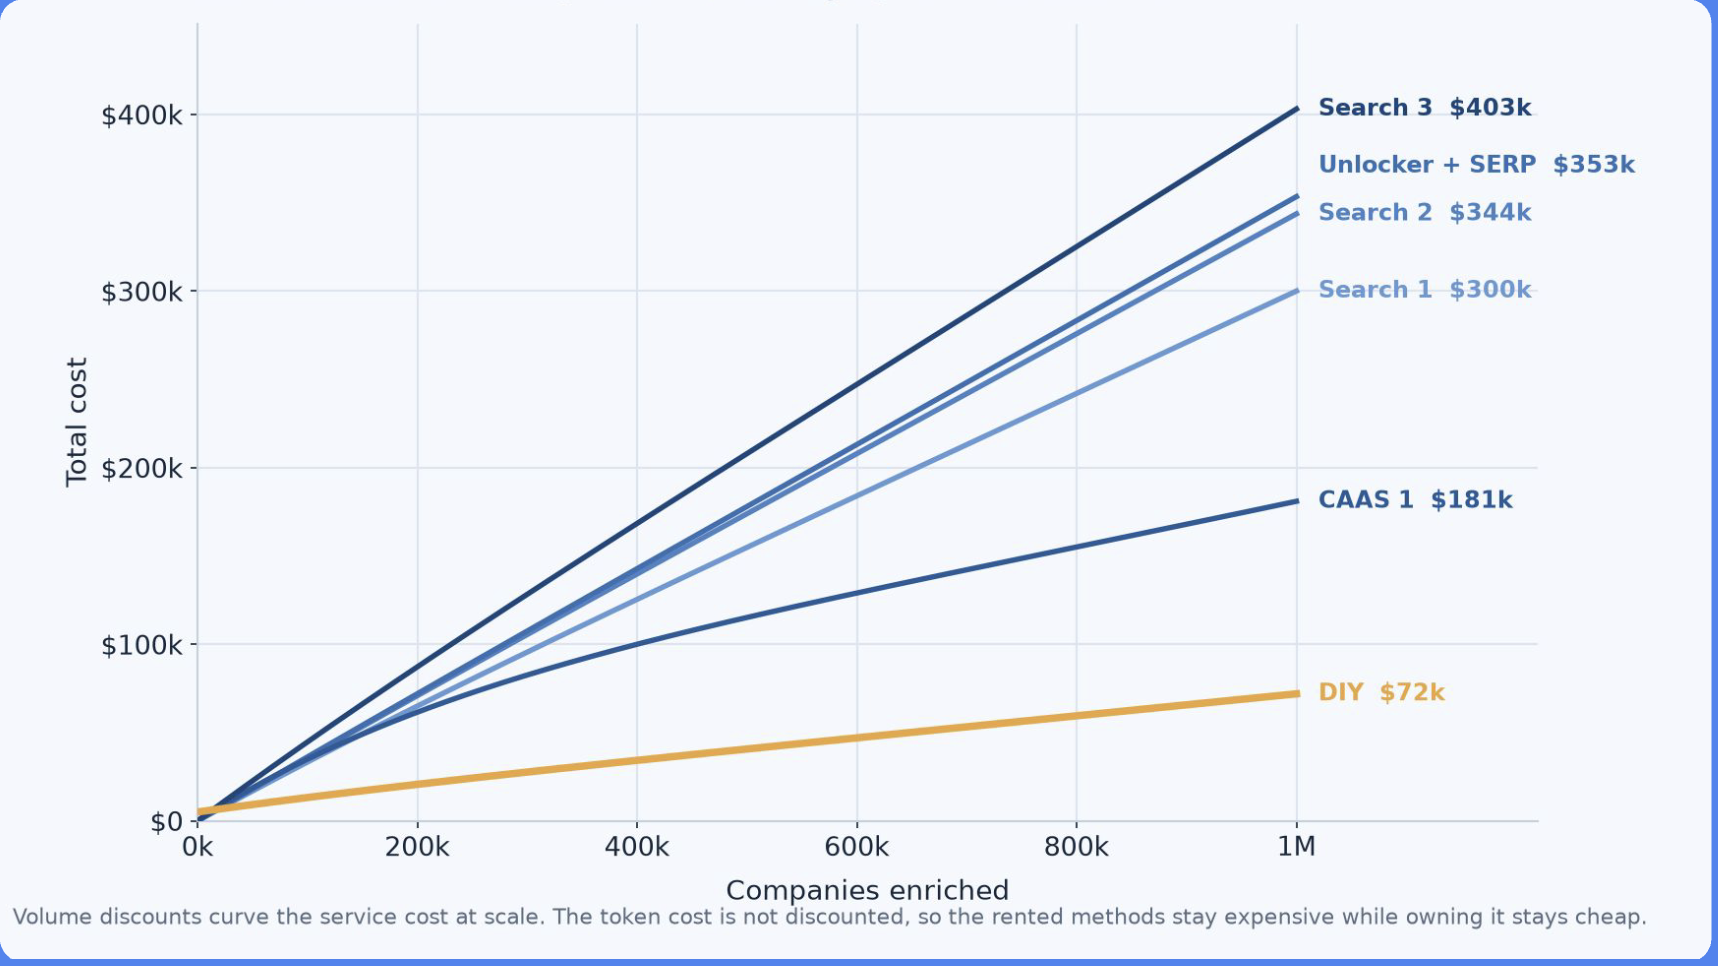
Le constat est établi :
- Louez lorsque vos besoins en connaissances sont petits et diversifiés.
- Utilisez la recherche lorsque la tâche est ponctuelle et ouverte.
- Utilisez le CaaS lorsque le domaine est récurrent et spécialisé, et que vous souhaitez un contexte structuré, vérifié et prêt pour les agents.
Construisez lorsque le flux de travail se répète, que les mêmes entités reviennent, que la fraîcheur des données compte et que vous avez besoin de contrôler la logique métier.
C’est là que l’ingénierie du contexte web devient un véritable avantage opérationnel.
Et si vous êtes un bâtisseur, c’est aussi l’opportunité.
Le CaaS n’est pas seulement une catégorie de fournisseurs. C’est un signe que les agents ont besoin d’une couche de contexte gouvernée :
- Entités contrôlées
- Schémas contrôlés
- Règles de fraîcheur
- Vérification des sources
- Ontologies spécifiques au domaine
- Pipelines de contexte réutilisables
L’ère des agents transforme les données web en infrastructure. Les gagnants sont les équipes capables de transformer des données web désordonnées et en constante évolution en contexte fiable, structuré et réutilisable.
Allez construire le vôtre !