Dans cet article, vous apprendrez :
- Pourquoi l’acquisition fiable de données web est un élément essentiel d’un pipeline de données prêt pour l’IA, et comment Bright Data peut gérer cela.
- Comment le flux de travail Bright Data + Snowflake peut aider à optimiser les coûts du pipeline de données.
- Comment le filtrage et l’envoi uniquement des données web pertinentes réduisent les coûts de stockage Snowflake et éliminent les cycles de calcul inutiles.
- Comment livrer les jeux de données web Bright Data à Snowflake et les transformer en informations exploitables via Cortex Agents.
- Comment choisir entre des jeux de données par lots persistants et un accès web en direct (Bright Data MCP) pour votre architecture d’IA.
- Ce que fait chaque composant Snowflake Cortex (Analyst, Search, Sense et Agents) dans le flux de travail.
- Comment Bright Data et Snowflake peuvent fonctionner ensemble pour recueillir des données web en direct via MCP et CoCo CLI.
Plongeons dans le sujet !
Des données web à l’intelligence prête pour l’IA
Pour de nombreuses entreprises, le web est l’une des sources de données externes les plus riches disponibles. Informations sur les produits, profils d’entreprises, signaux de marché, activité sur les réseaux sociaux, avis, tarification et autres informations publiques peuvent fournir un contexte précieux pour les décisions commerciales.
Le défi consiste à accéder de manière fiable à ces données en grand volume. Les données web sont réparties sur des millions de sites web, changent continuellement, et nécessitent souvent une infrastructure spécialisée pour les collecter, les structurer et les maintenir à jour. Construire cette capacité en interne peut nécessiter un effort d’ingénierie important.
C’est là qu’intervient l’infrastructure d’acquisition de données de Bright Data. La plateforme est conçue pour collecter des données web à grande échelle, avec la couverture, la fiabilité et la disponibilité en temps réel nécessaires aux charges de travail d’entreprise.
Plutôt que de construire et de maintenir votre propre infrastructure de collecte de données web, vous pouvez utiliser Bright Data pour gérer la complexité de la collecte et de la préparation des données requises par votre cas d’usage.
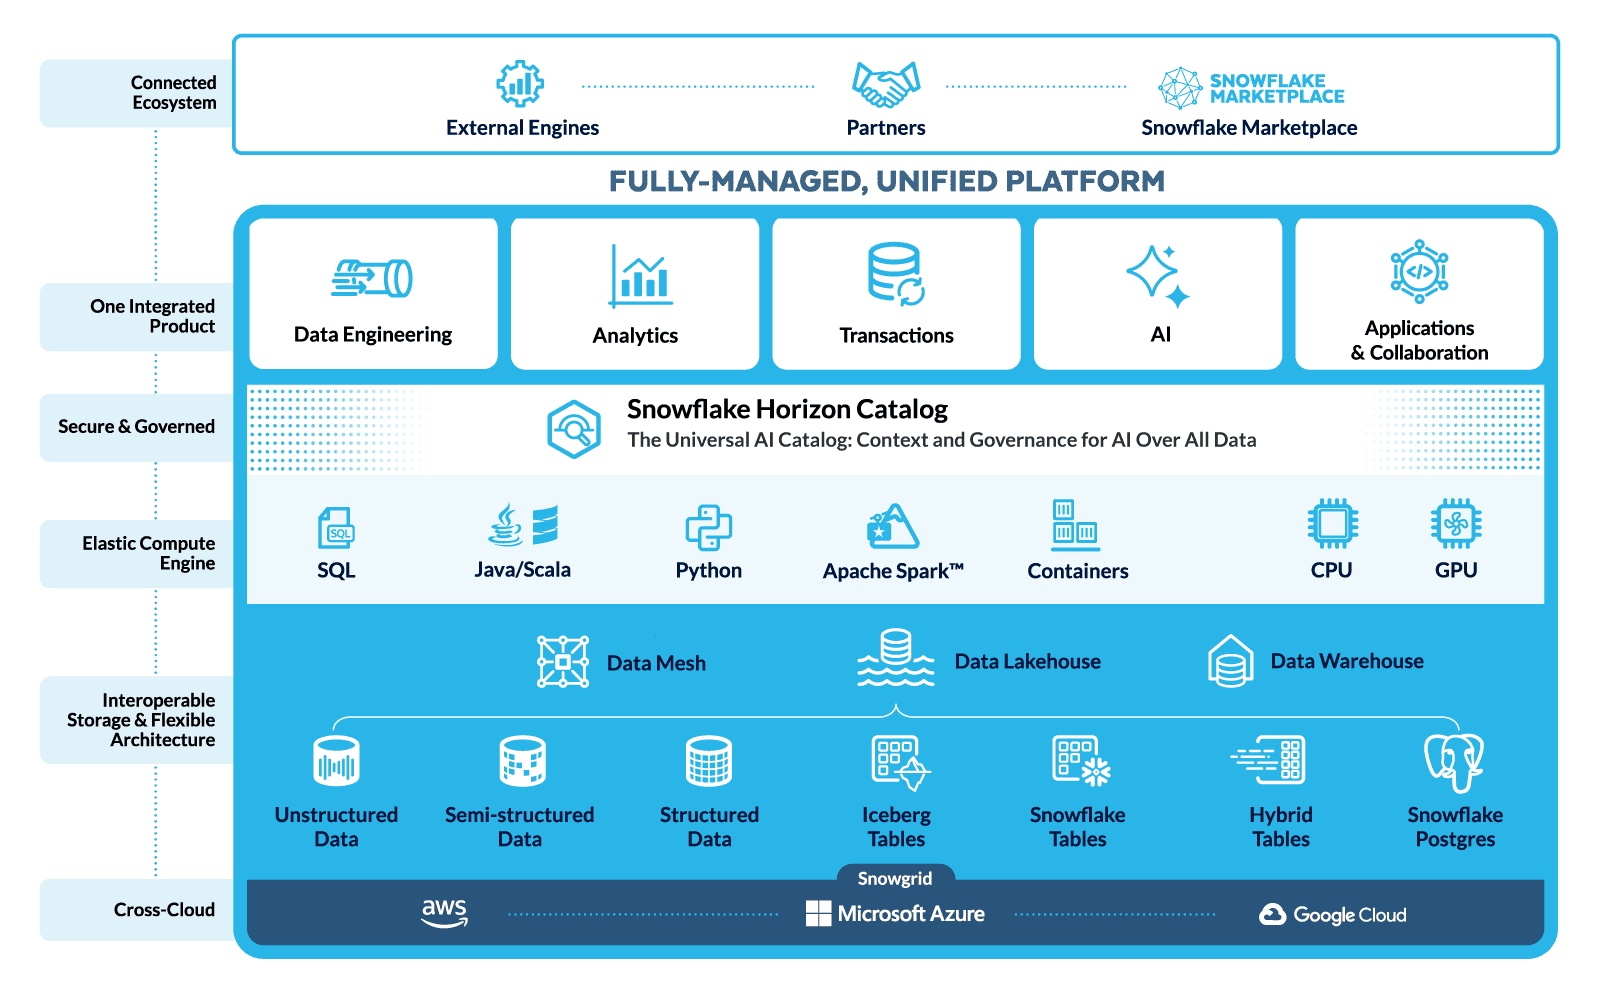
Snowflake vous offre ensuite l’environnement où ces données externes peuvent être stockées. Elles peuvent également être traitées puis consolidées avec les données d’entreprise existantes grâce à Cortex AI.
Le résultat est un chemin clair des données web externes à l’intelligence d’affaires, Bright Data gérant la complexité de la récupération des données web et Snowflake fournissant l’infrastructure pour l’analyse et l’activation alimentée par l’IA.
Bright Data comme couche de données pour Snowflake
Avant que les données web puissent être analysées dans Snowflake, elles doivent être collectées et préparées pour l’utilisation. Bright Data répond à ce défi avec une infrastructure de niveau entreprise pour la collecte de données web.
La plateforme Bright Data comprend plus de 400 millions d’IPs résidentielles, permettant une haute évolutivité et concurrence, avec un temps de disponibilité de 99,99 % et un taux de réussite de 99,95 %.
En matière de données web, Bright Data fournit des centaines de jeux de données contenant plus de 21 milliards d’enregistrements, plus de 1 000 API Web Scraper prêtes à l’emploi, et plus de 90 Po de données en cache interrogeables via des API.
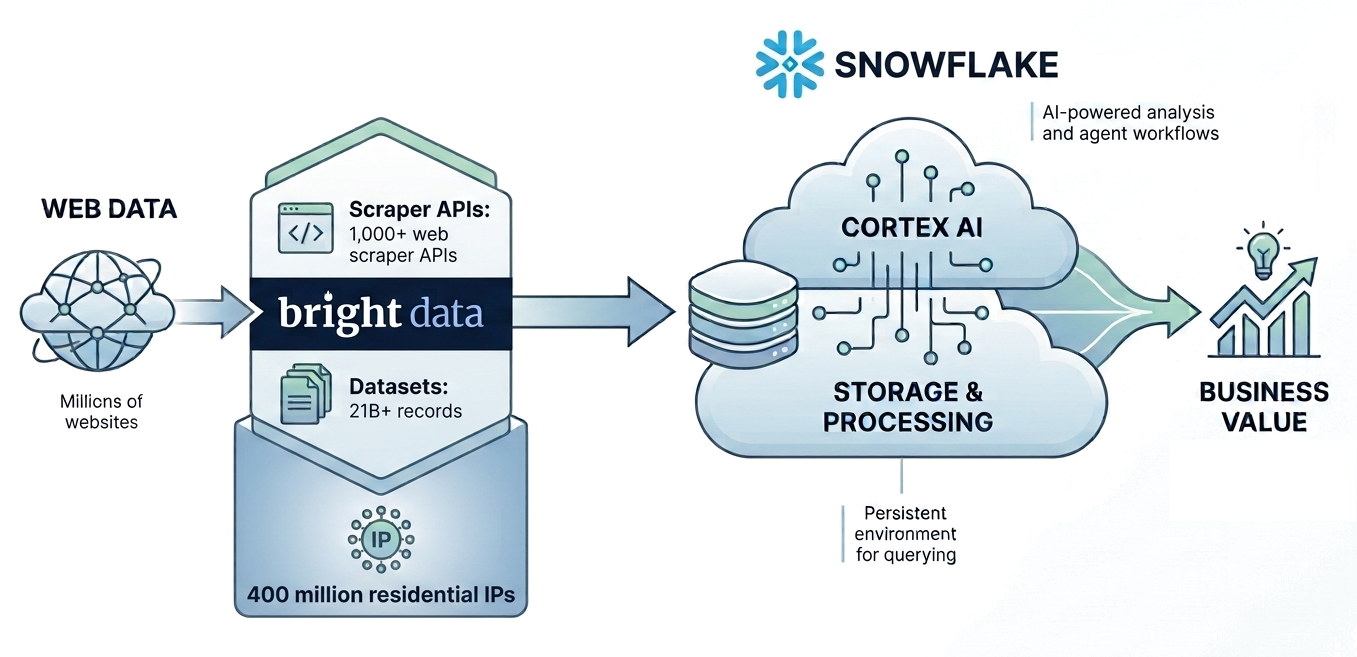
Ensemble, Bright Data et Snowflake couvrent deux capacités complémentaires :
- Acquérir les bonnes données externes avec Bright Data : Identifiez les données web dont votre entreprise a besoin et collectez-les à l’échelle et à la fraîcheur requises.
- Stocker, fusionner et activer ces données dans Snowflake : Rassemblez ces données externes avec vos données Snowflake actuelles et utilisez les capacités de traitement et d’IA de Snowflake pour les transformer en intelligence exploitable.
Cette approche vous permet également d’optimiser le pipeline de données en amont. Au lieu de déplacer automatiquement des jeux de données entiers dans Snowflake, les capacités de filtrage et de personnalisation de Bright Data vous aident à sélectionner uniquement les données dont vous avez besoin. Cela signifie moins de données inutiles à stocker, tout en préservant les informations nécessaires pour le traitement ultérieur.
Jeux de données persistants ou accès web en direct ? Choisir votre modèle d’ingestion
Avant de créer votre agent, décidez comment vous souhaitez accéder aux données web et les stocker. Devriez-vous charger les données scrapées dans Snowflake et les interroger là-bas, ou votre Cortex Agent devrait-il récupérer les données du web de manière dynamique au moment de l’inférence ?
Bright Data prend en charge les deux modèles, chacun étant adapté à différents cas d’usage.
| Jeux de données par lots persistants | Ingestion en direct via Bright Data MCP | |
|---|---|---|
| Fonctionnement | Un jeu de données filtré est livré aux tables Snowflake une fois ou selon un calendrier. | Le Cortex Agent appelle les outils Bright Data pour la recherche, le scraping ou l’automatisation du navigateur lorsqu’il a besoin d’une réponse. |
| Où résident les données | Dans Snowflake, aux côtés de vos données d’entreprise. | Récupérées à la demande et non stockées sauf si vous les persistez explicitement. |
| Fraîcheur | À jour au moment de la dernière livraison du jeu de données. | Données web fraîches récupérées au moment de la requête. |
| Latence par question | Faible, car les requêtes s’exécutent directement contre l’entrepôt. | Plus élevée, car les données doivent être récupérées depuis le web et les pages peuvent nécessiter un rendu. |
| Meilleur modèle de requête | Analyse répétable, agrégée et riche en jointures. | Recherches ponctuelles, sensibles au temps ou de longue traîne. |
| Jointures avec des données internes | Jointures SQL natives avec vos données d’entrepôt existantes. | L’agent combine les résultats web avec d’autres informations dans son contexte. |
| Reproductibilité et auditabilité | Élevée, car le même instantané du jeu de données peut produire le même résultat. | Faible, car les pages web et leur contenu peuvent changer entre les requêtes. |
| Profil de coût | Livraison du jeu de données, plus les coûts de stockage et de calcul Snowflake. | Utilisation par requête qui évolue avec l’activité de l’agent. |
| Exemples typiques | Évaluation des influenceurs, dimensionnement du marché, enrichissement des données et tableaux de bord BI. | Vérifications de prix, surveillance des actualités, vérification des affirmations et lecture d’URL spécifiques. |
Comme règle générale pour choisir l’approche à suivre, retenez ceci : si vous prévoyez de poser les mêmes types de questions de manière répétée sur une population définie, stockez les données. Si la réponse dépend de ce que dit le web en ce moment ou d’une page que vous ne pouvez pas prévoir à l’avance, récupérez les données à la demande.
Dans les sections suivantes, vous verrez d’abord comment travailler avec l’approche des jeux de données persistants, puis vous explorerez comment ajouter un accès web en direct avec Bright Data MCP.
Du stockage à l’IA : comprendre le modèle de consommation Snowflake
Maintenant que vous avez vu comment Bright Data et Snowflake s’assemblent, la question suivante porte naturellement sur le coût. Les pipelines de données peuvent impliquer plusieurs couches de consommation, de l’acquisition de données web au stockage, au traitement et à l’analyse avec l’IA.
L’intégration de données web dans Snowflake implique plusieurs couches de consommation. Selon le flux de travail, les coûts peuvent provenir de l’acquisition de données via Bright Data, du stockage et du calcul Snowflake, et des services d’IA utilisés pour analyser les données.
La tarification de Bright Data dépend du produit, de la source de données, du volume et des exigences de collecte. Trouvez les derniers tarifs et options disponibles sur la page de tarification Bright Data.
Une fois les données arrivées dans Snowflake, la consommation dépend de la quantité de données que vous stockez, traitez, interrogez et activez. Le modèle de tarification de Snowflake couvre le stockage, le calcul et les services supplémentaires, y compris les capacités d’IA. Pour les détails tarifaires actuels, consultez les options de tarification de Snowflake.
Vous voulez une répartition détaillée des coûts ? Contactez [email protected].
Comment livrer les données web Bright Data dans Snowflake et les activer avec Cortex AI
Dans cette section étape par étape, vous apprendrez comment envoyer des données web collectées avec Bright Data vers Snowflake pour le stockage et le calcul. Plus précisément, vous verrez ensuite comment connecter ces données à un agent Snowflake Cortex AI pour l’analyse.
Ce tutoriel utilise le modèle de jeu de données par lots persistant décrit dans la comparaison ci-dessus. Il convient à ce cas d’usage car l’évaluation des influenceurs est une analyse répétable sur une population définie qui bénéficie de jointures avec des données de campagne internes.
Prérequis
Pour suivre ce tutoriel, assurez-vous d’avoir :
- Un compte Snowflake avec une base de données et un schéma configurés et prêts pour l’ingestion de données.
- Un compte Bright Data.
Une familiarité avec les options de livraison de données Bright Data pour Snowflake sera également utile.
Étape n° 1 : Sélectionner le jeu de données Bright Data
Tous les jeux de données Bright Data peuvent être configurés pour l’ingestion dans Snowflake, ainsi que vers plusieurs autres plateformes cloud.
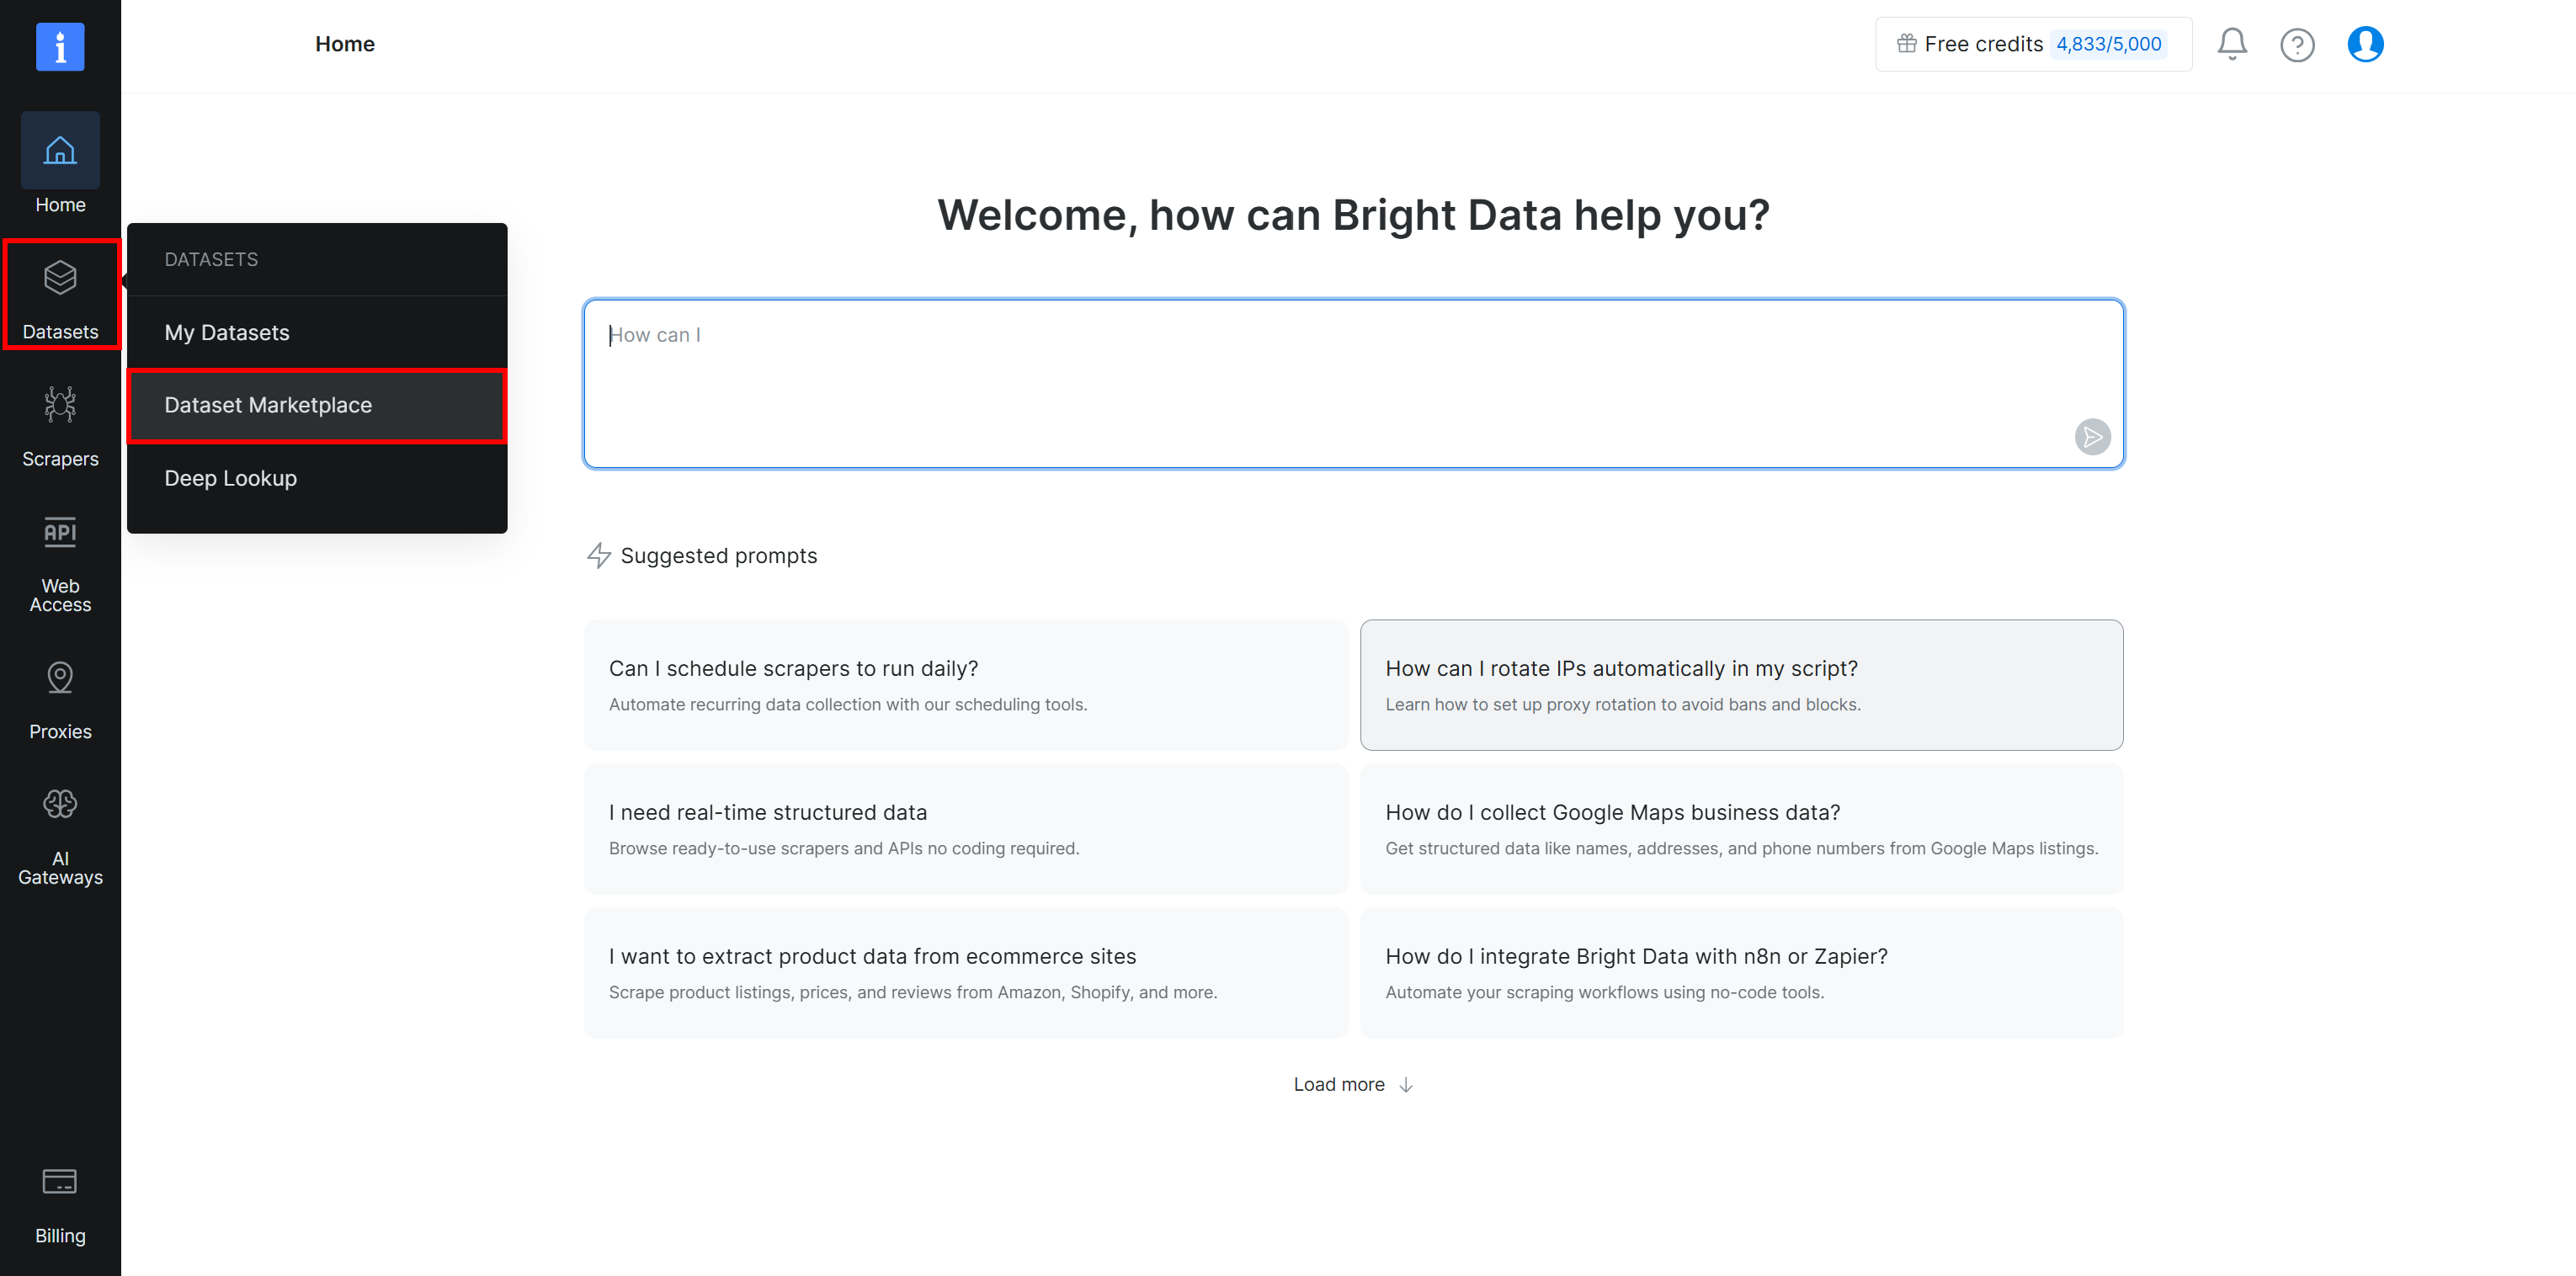
Commencez par vous connecter à votre compte Bright Data et naviguez vers « Datasets > Dataset Marketplace » :
 Sur la page « Dataset Marketplace », recherchez le jeu de données qui vous intéresse.
Dans ce tutoriel, nous exploiterons les données de profils Instagram pour identifier des influenceurs qui pourraient bien convenir pour sponsoriser un produit de soin de la peau.
Le jeu de données Bright Data fournit des informations externes sur les influenceurs, tandis que vos enregistrements Snowflake préexistants peuvent fournir un contexte interne tel que les informations sur le produit, les publics cibles, les exigences de campagne ou les performances de campagnes précédentes. Un Cortex Agent peut ensuite fusionner ces sources pour déterminer quels influenceurs conviennent le mieux à une campagne particulière.
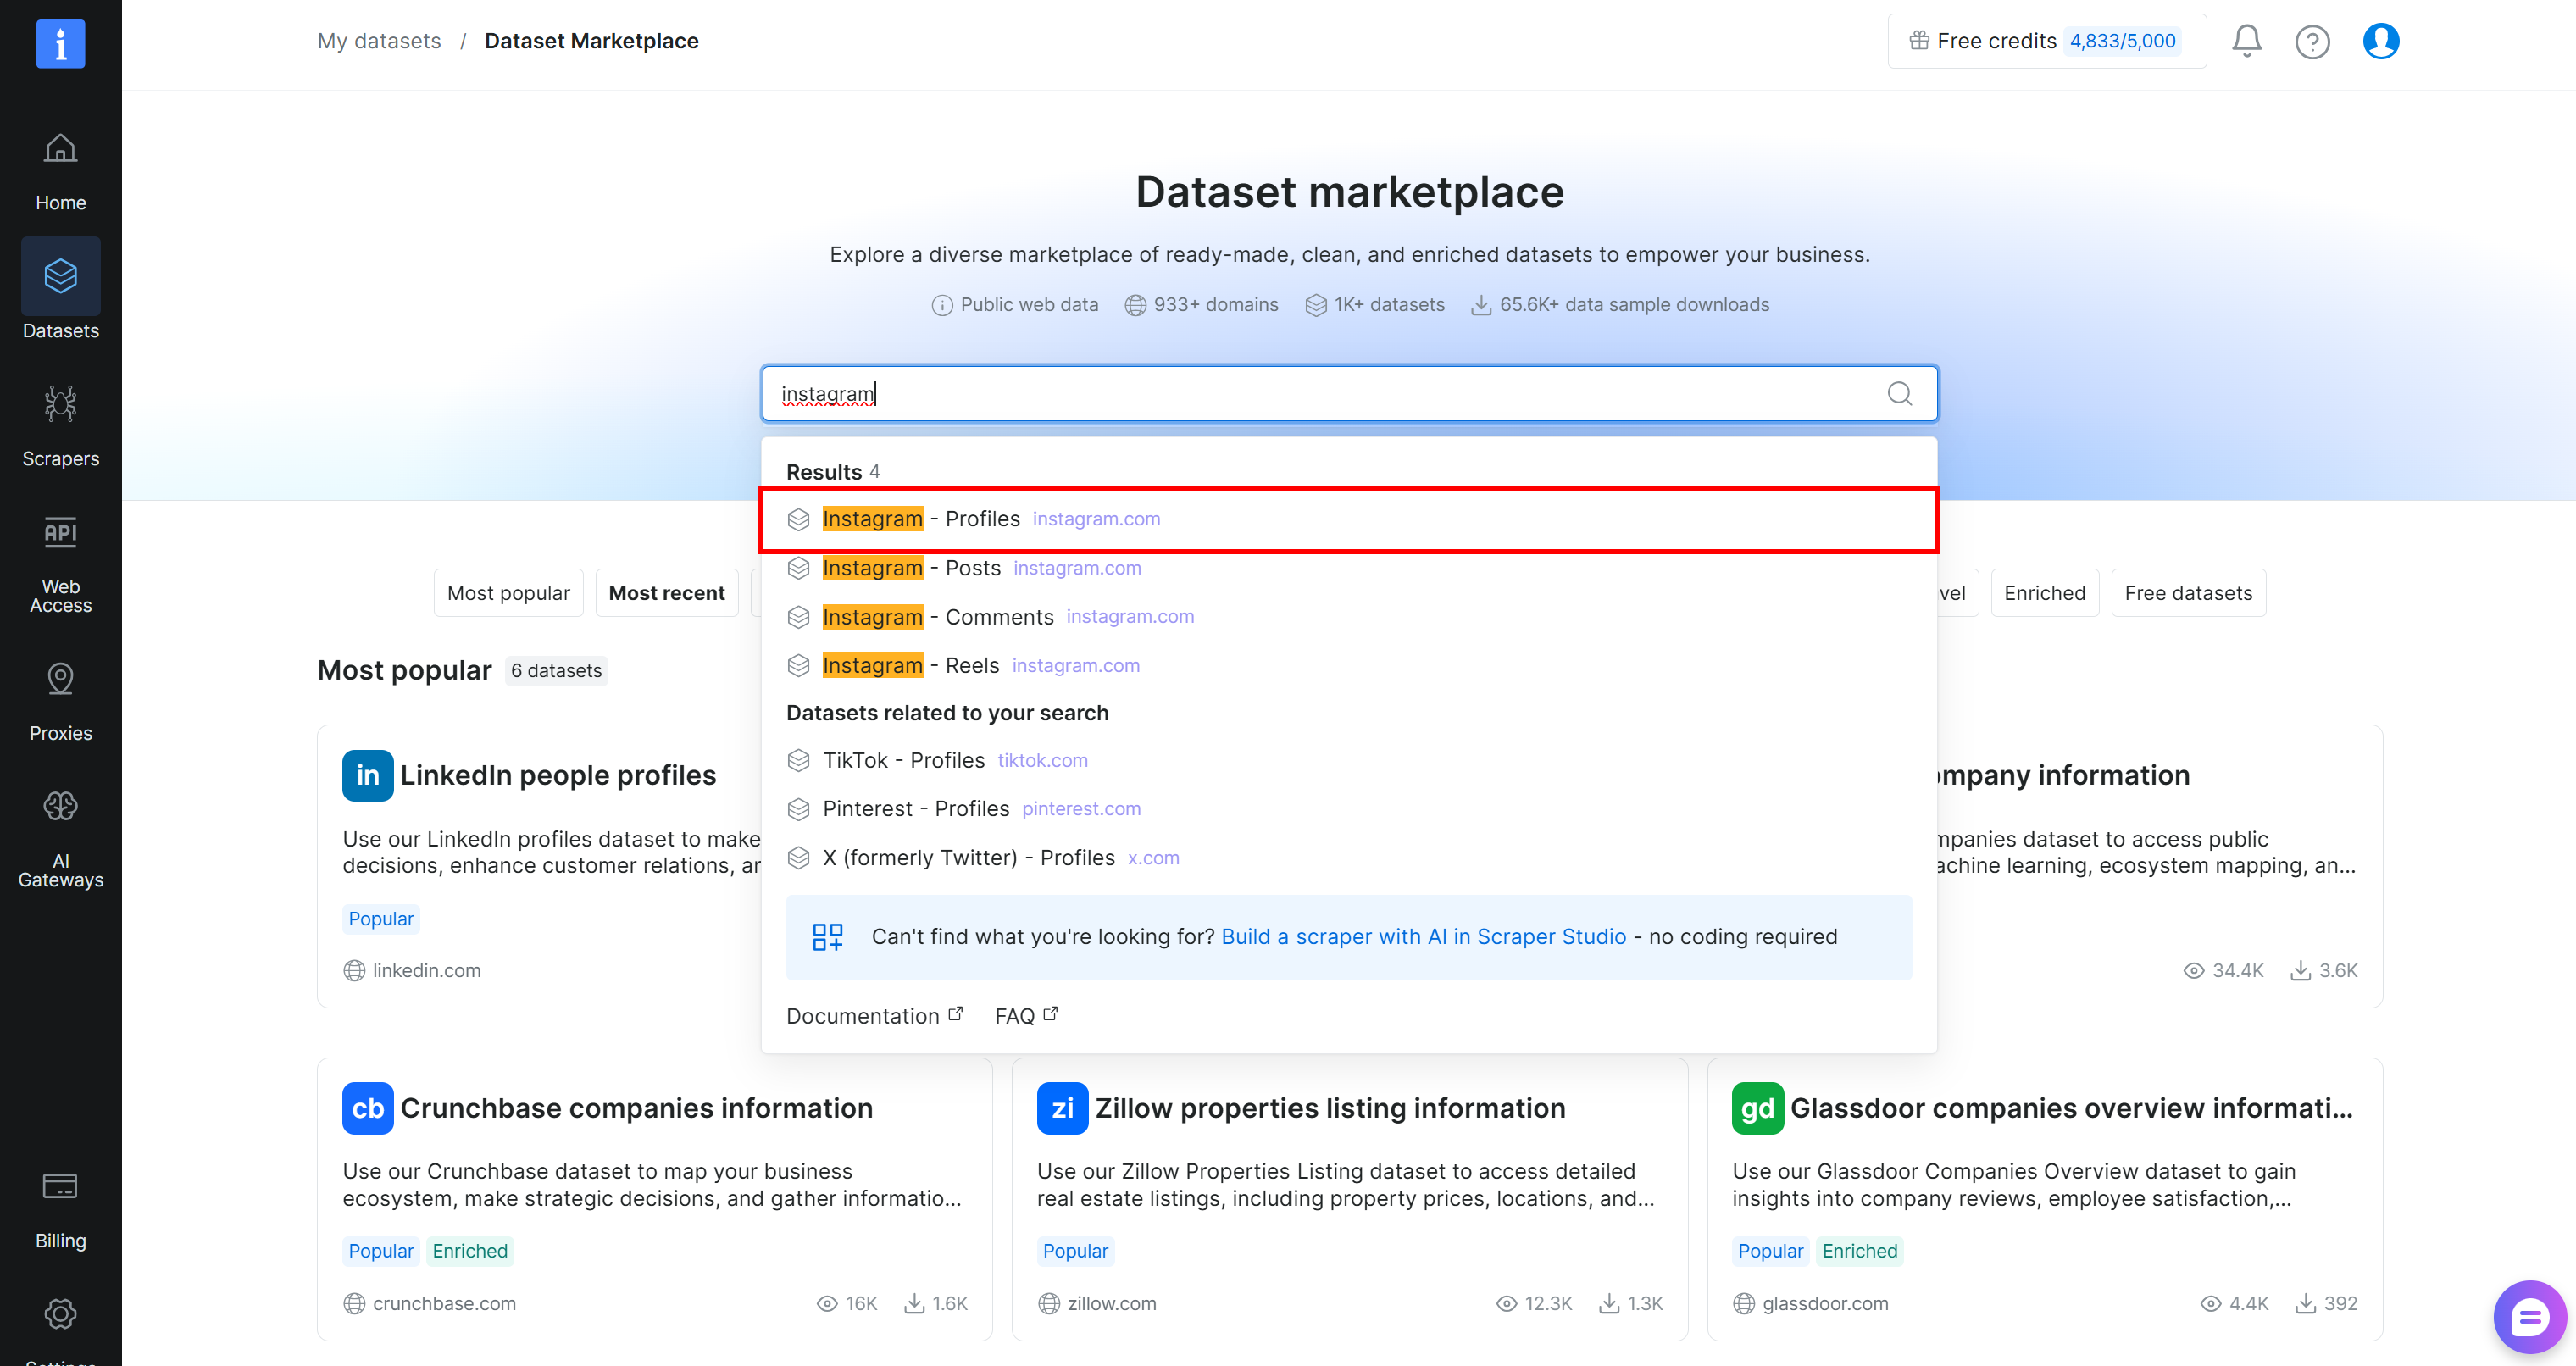
Ainsi, recherchez « instagram » et sélectionnez le jeu de données « Instagram – Profiles » :
Bien joué ! Vous serez ensuite redirigé vers la page du jeu de données, où vous pourrez procéder à l’achat.
Approche alternative : Vous pouvez également obtenir les services Bright Data directement depuis le Snowflake Marketplace :
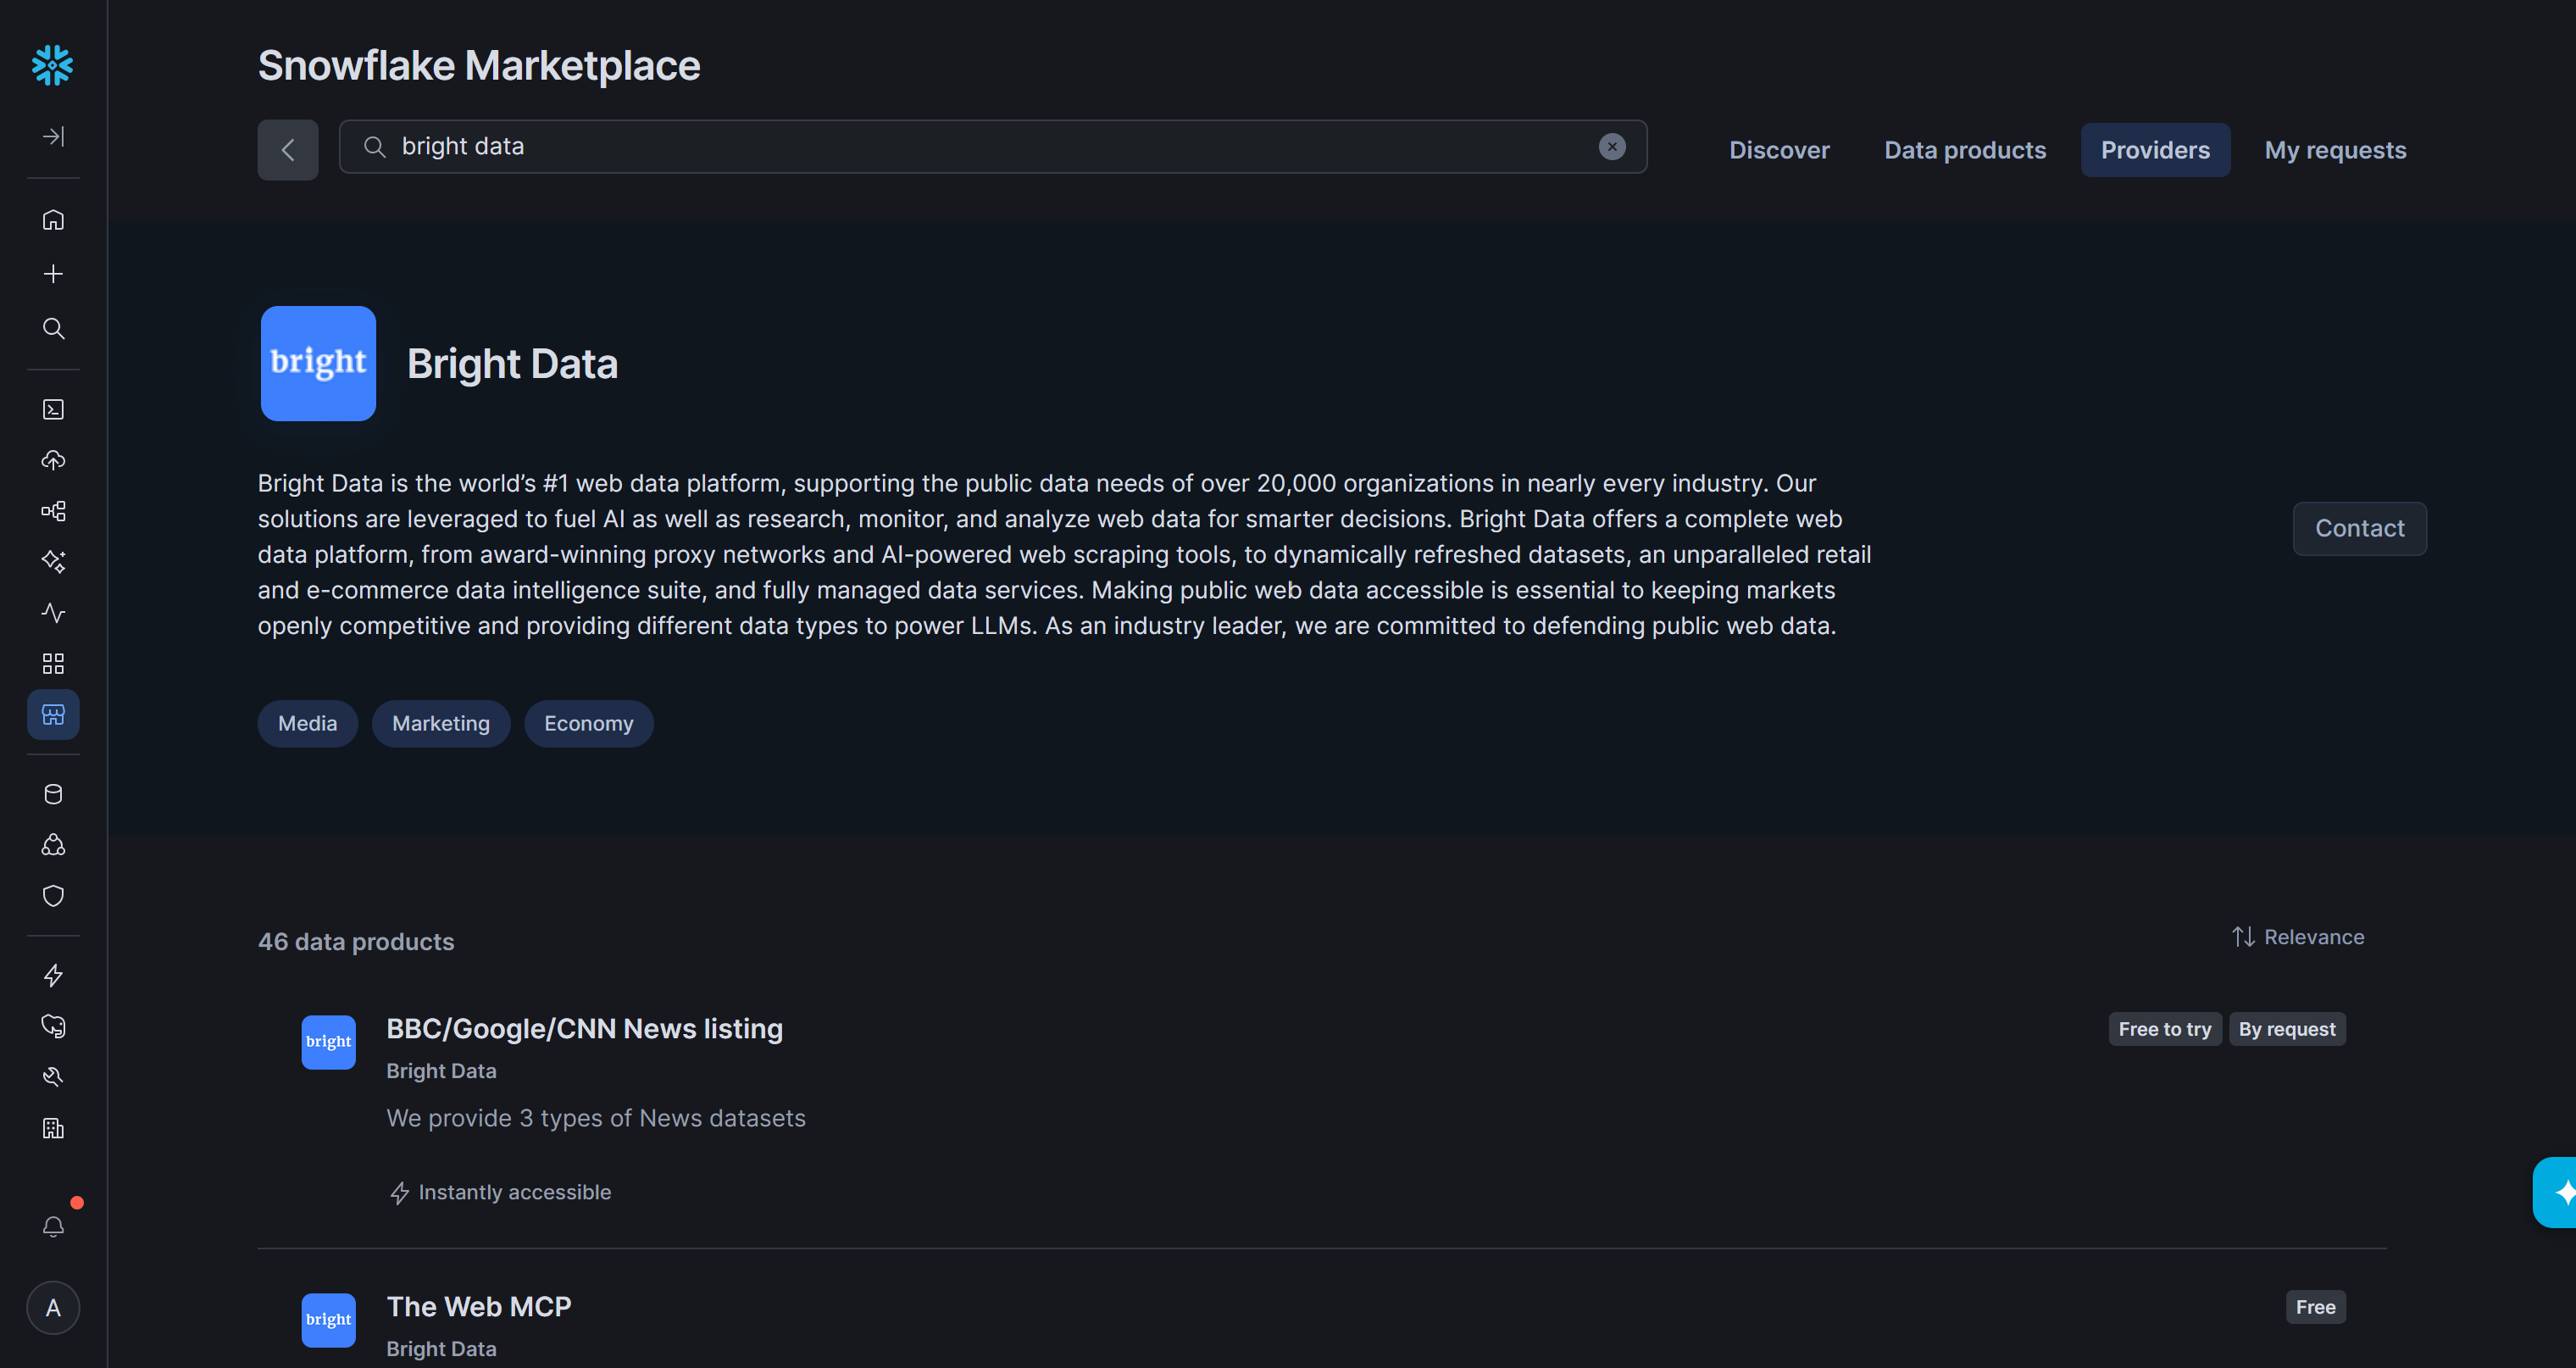
Rappelez-vous que Bright Data est un fournisseur et partenaire officiel de Snowflake.
Étape n° 2 : Obtenir les données d’intérêt
Le jeu de données Bright Data « Instagram – Profiles » contient plus de 650 millions d’enregistrements. Dans la plupart des cas, cependant, vous n’avez besoin que d’un sous-ensemble du jeu de données complet. C’est pourquoi Bright Data dispose d’options de filtrage intégrées.
Sur la page du jeu de données « Instagram – Profiles », cliquez sur « Filters » à gauche :
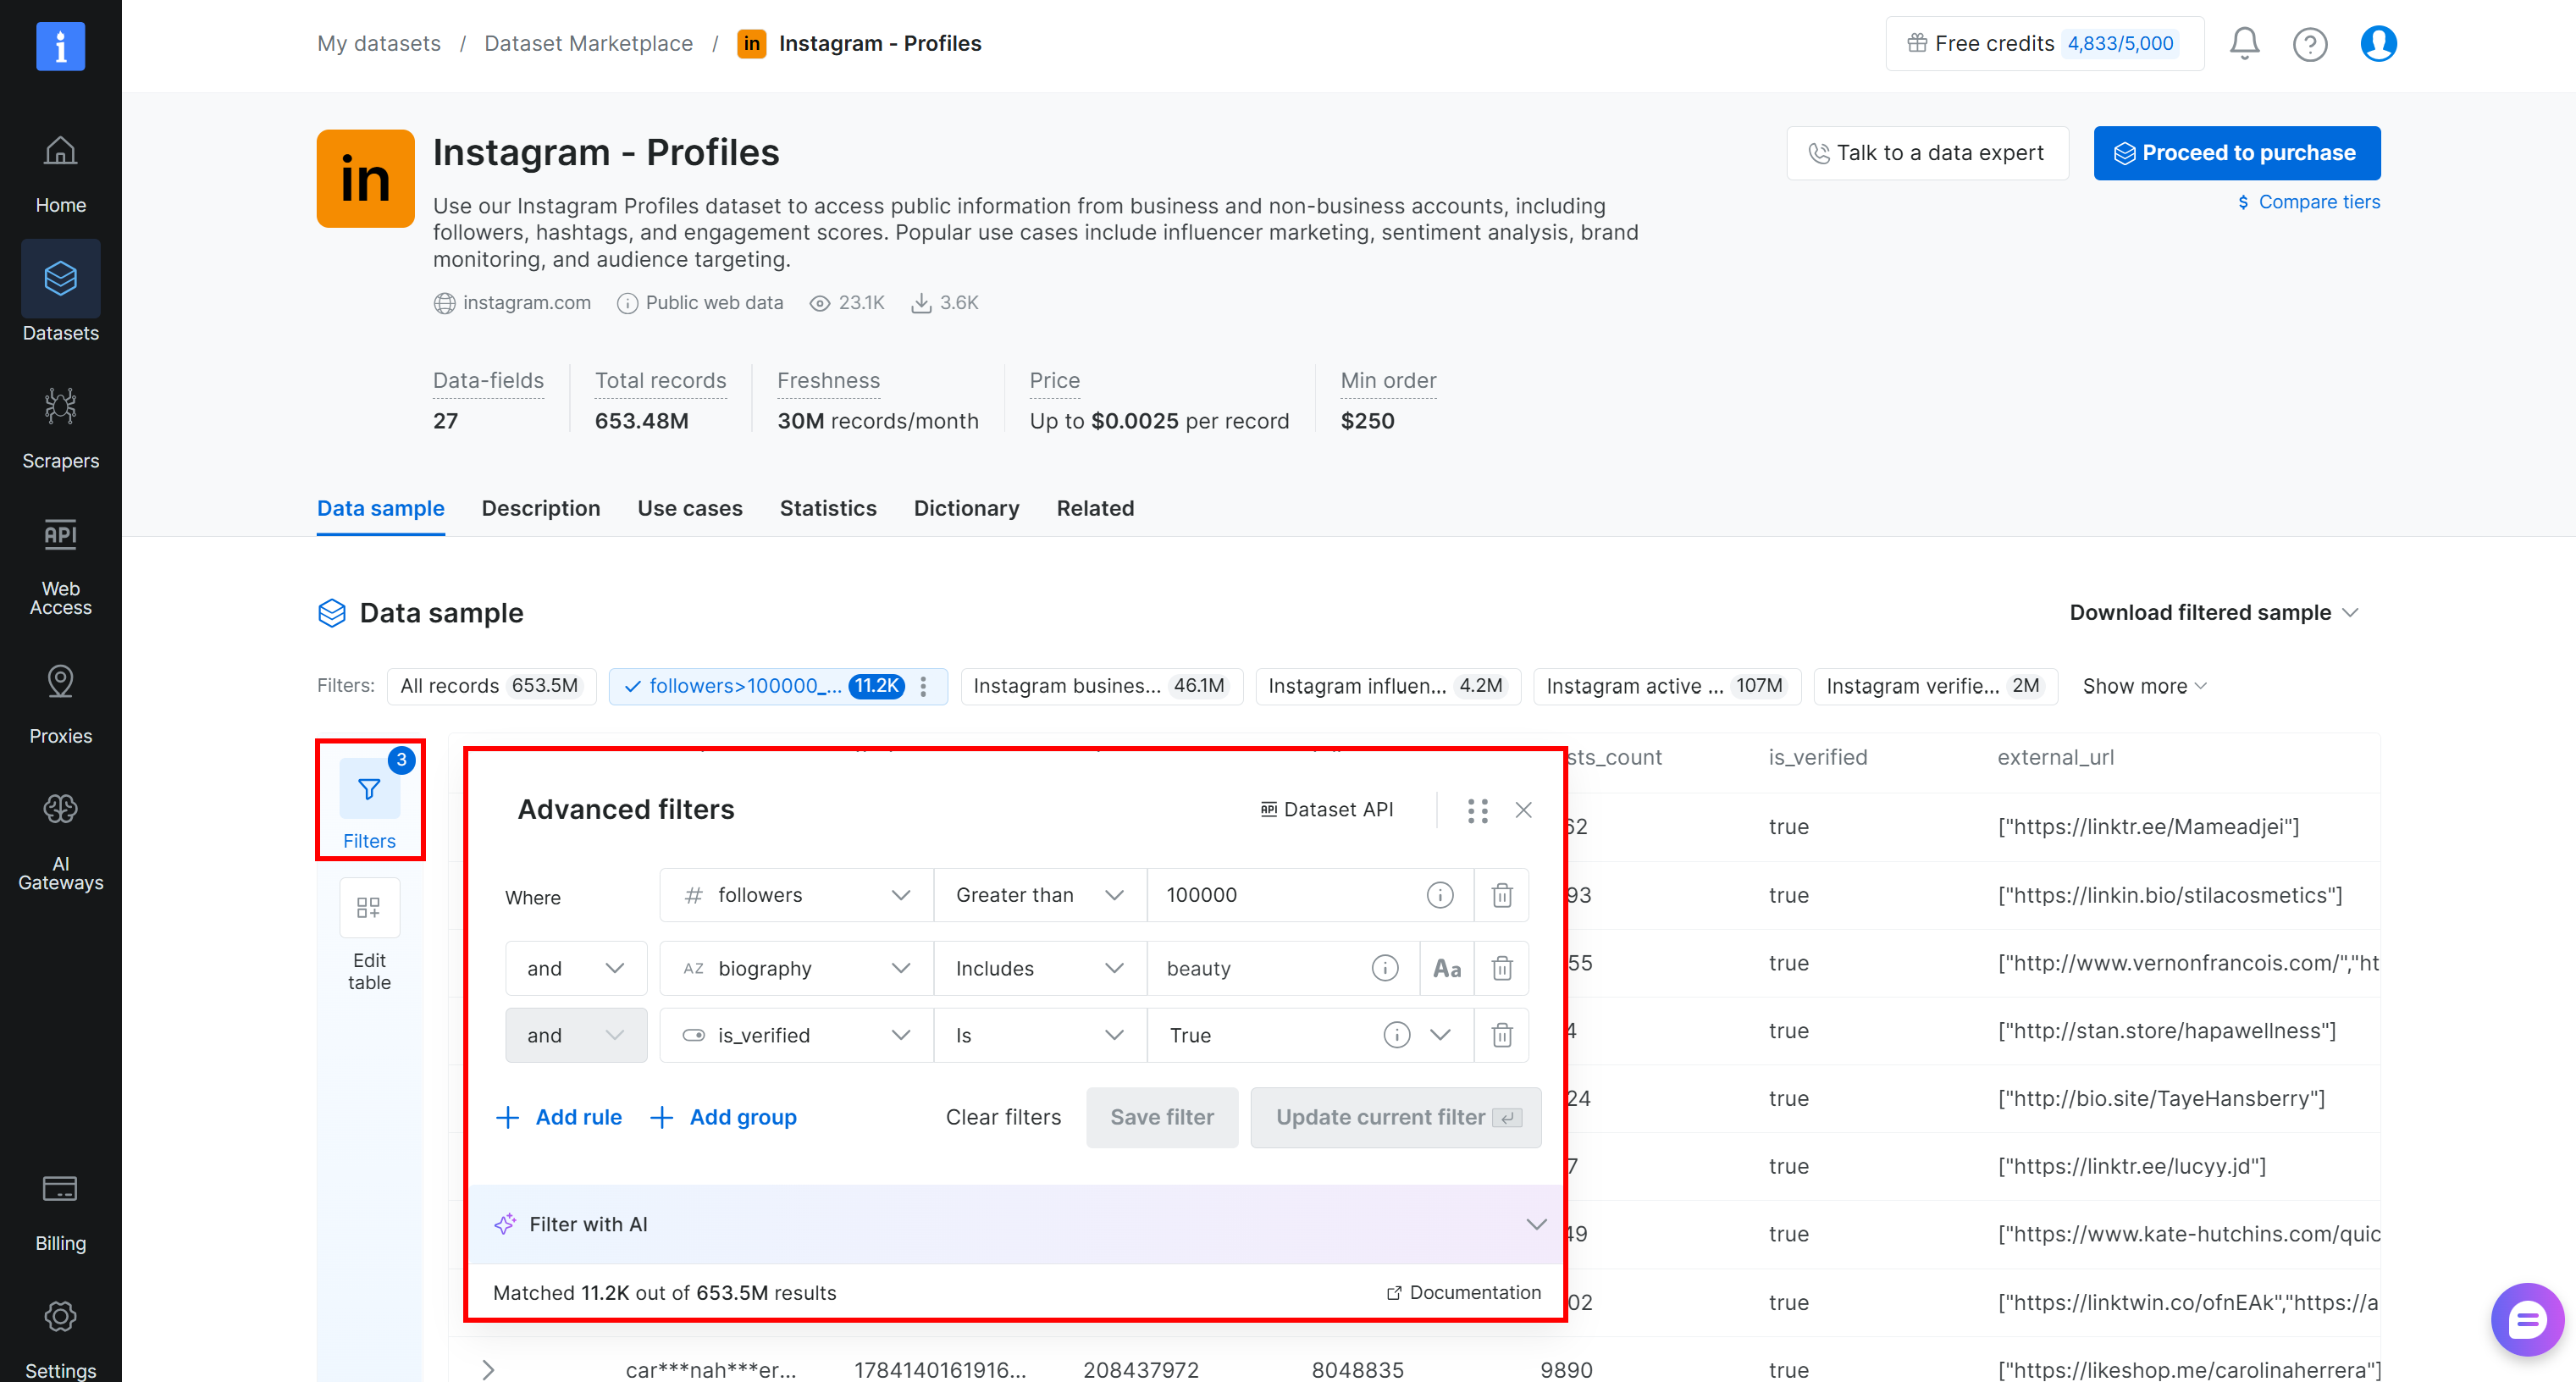
Maintenant, supposez que vous voulez des profils Instagram qui :
- Ont plus de 100 000 abonnés.
- Incluent le mot « beauty » dans leur biographie.
- Sont vérifiés.
Cette étape de filtrage est également importante du point de vue de l’efficacité des données. Au lieu de déplacer l’intégralité des 653,5 millions d’enregistrements dans Snowflake, vous pouvez d’abord les réduire aux enregistrements requis. Ici, le filtrage de Bright Data réduit le jeu de données à environ 11,2K profils, aidant à éviter les coûts de stockage excessifs.
Appliquez les filtres. Vous pouvez également explorer les profils filtrés directement dans le panneau de contrôle Bright Data ou télécharger un échantillon allant jusqu’à 1K enregistrements (avec certains champs masqués).
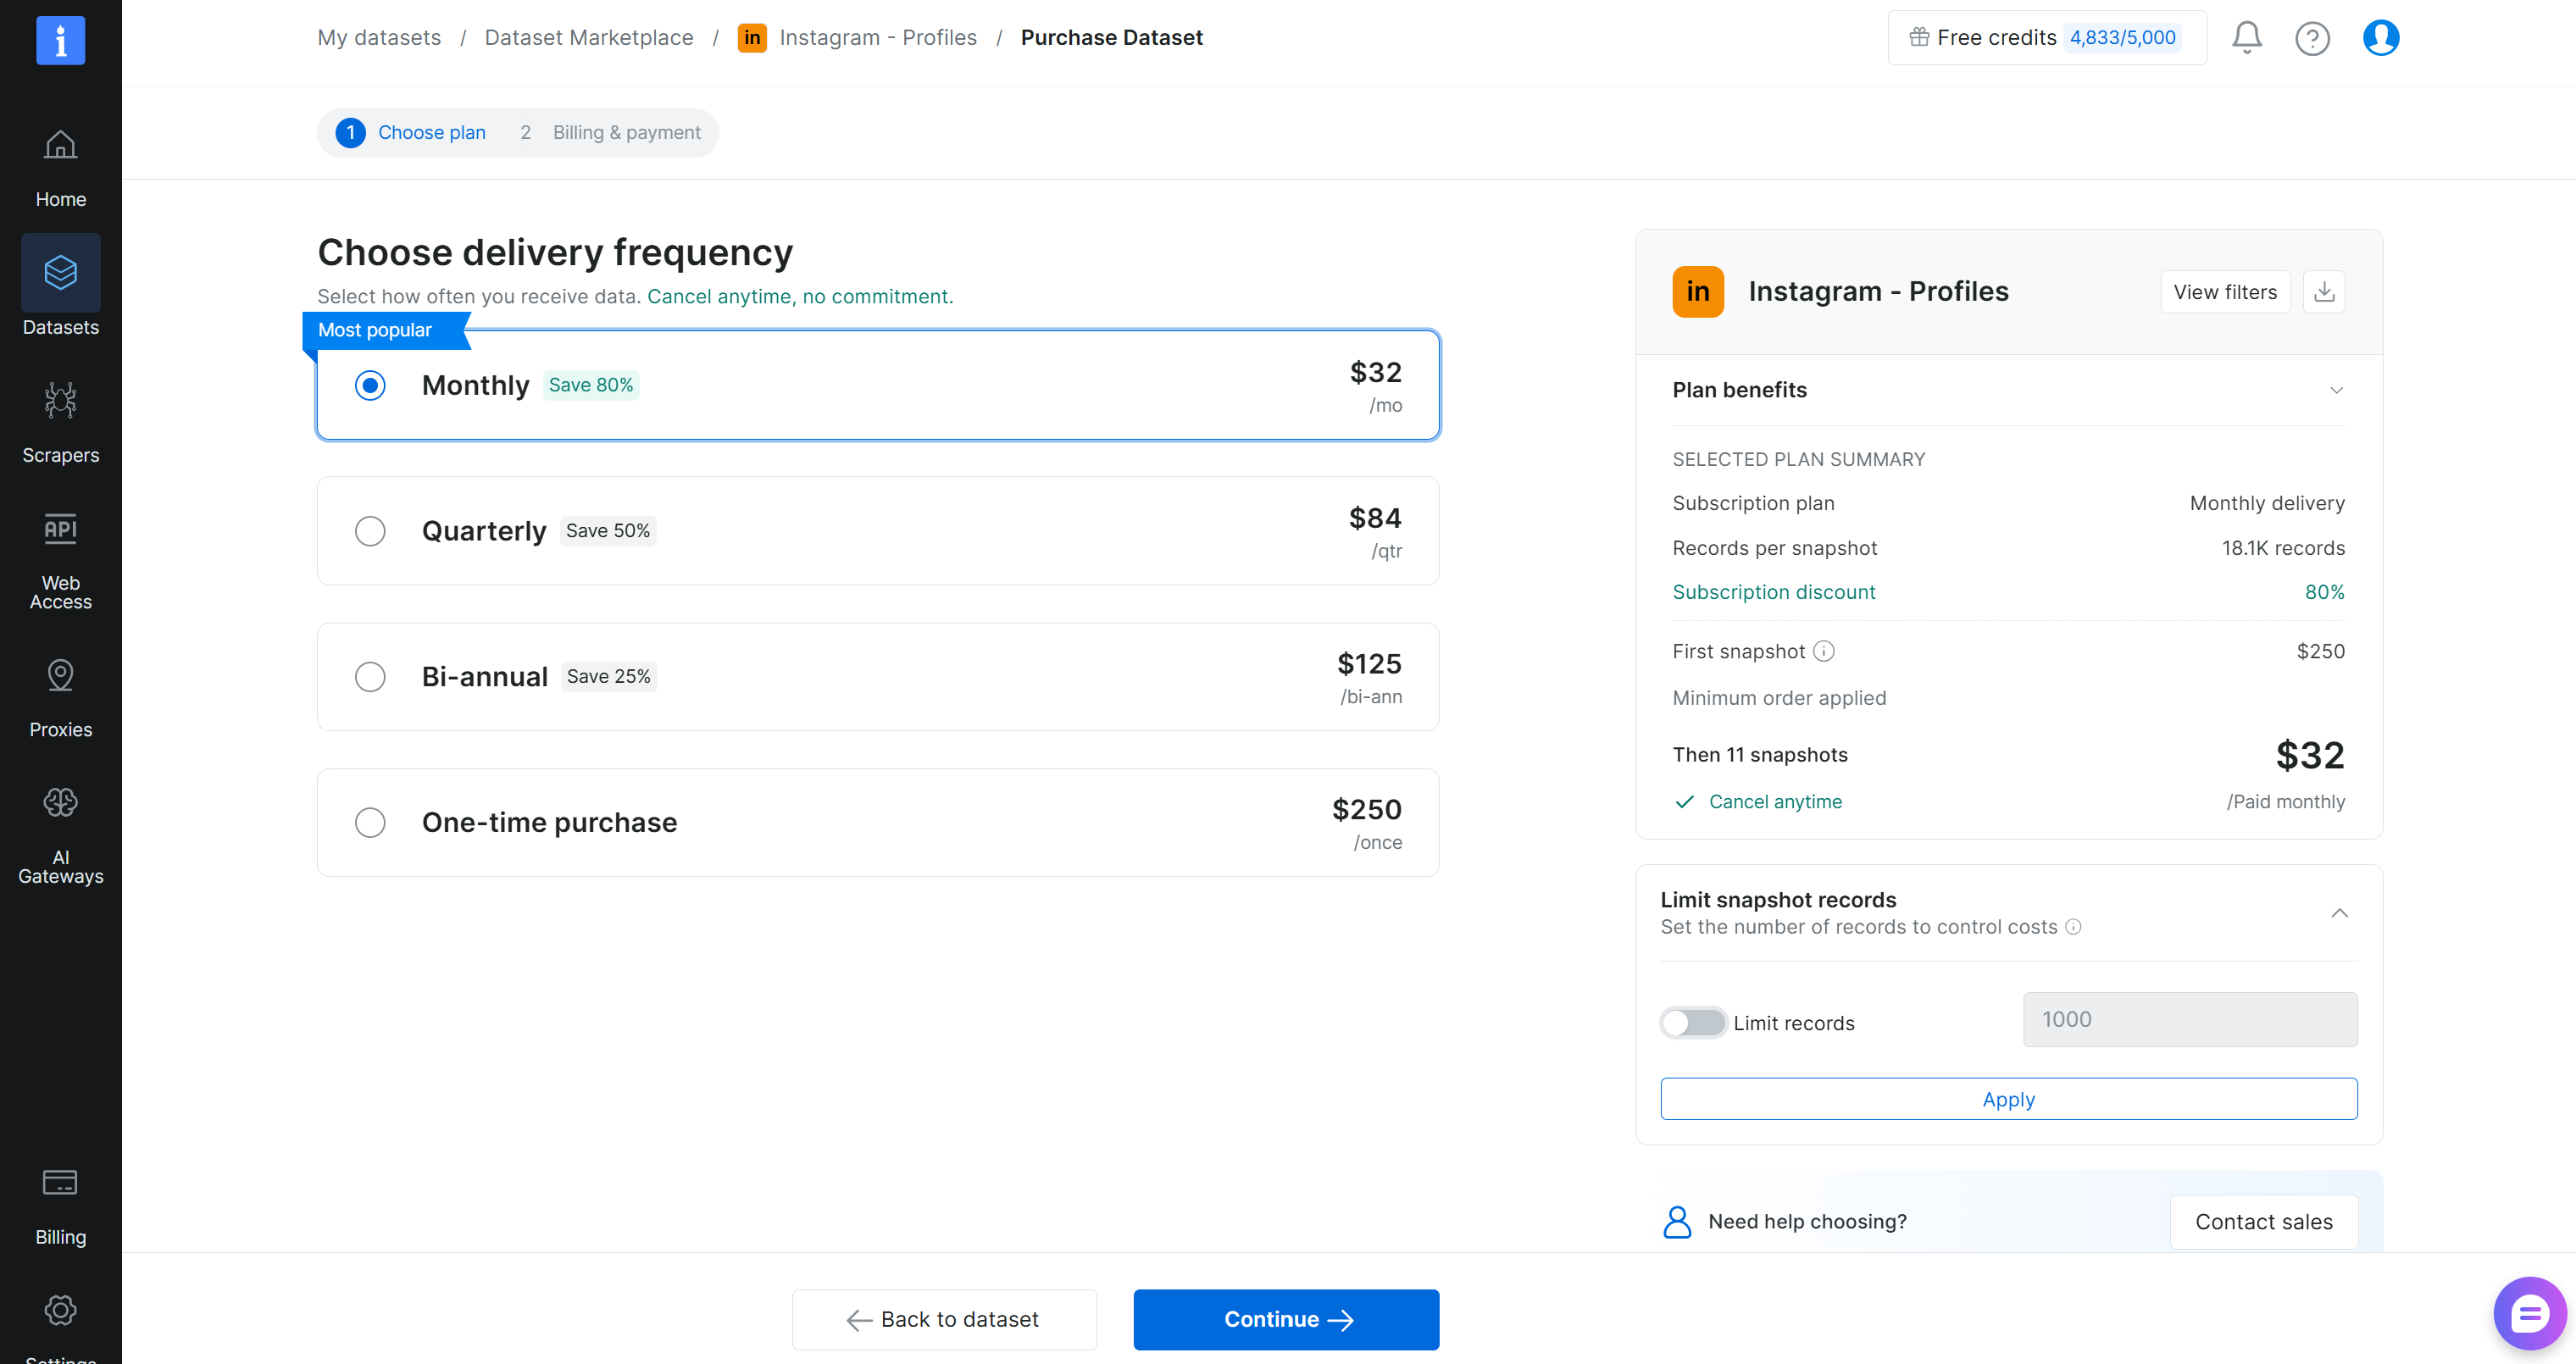
Une fois satisfait des filtres et des résultats, cliquez sur « Proceed to purchase » et sélectionnez une fréquence de livraison. Vous pouvez choisir entre un achat unique ou des mises à jour périodiques des données sélectionnées (mensuelle, trimestrielle ou semestrielle) :
Terminez le processus de paiement et attendez que le jeu de données soit préparé. Dès que l’instantané du jeu de données est prêt, vous recevrez un e-mail avec un lien vers celui-ci :
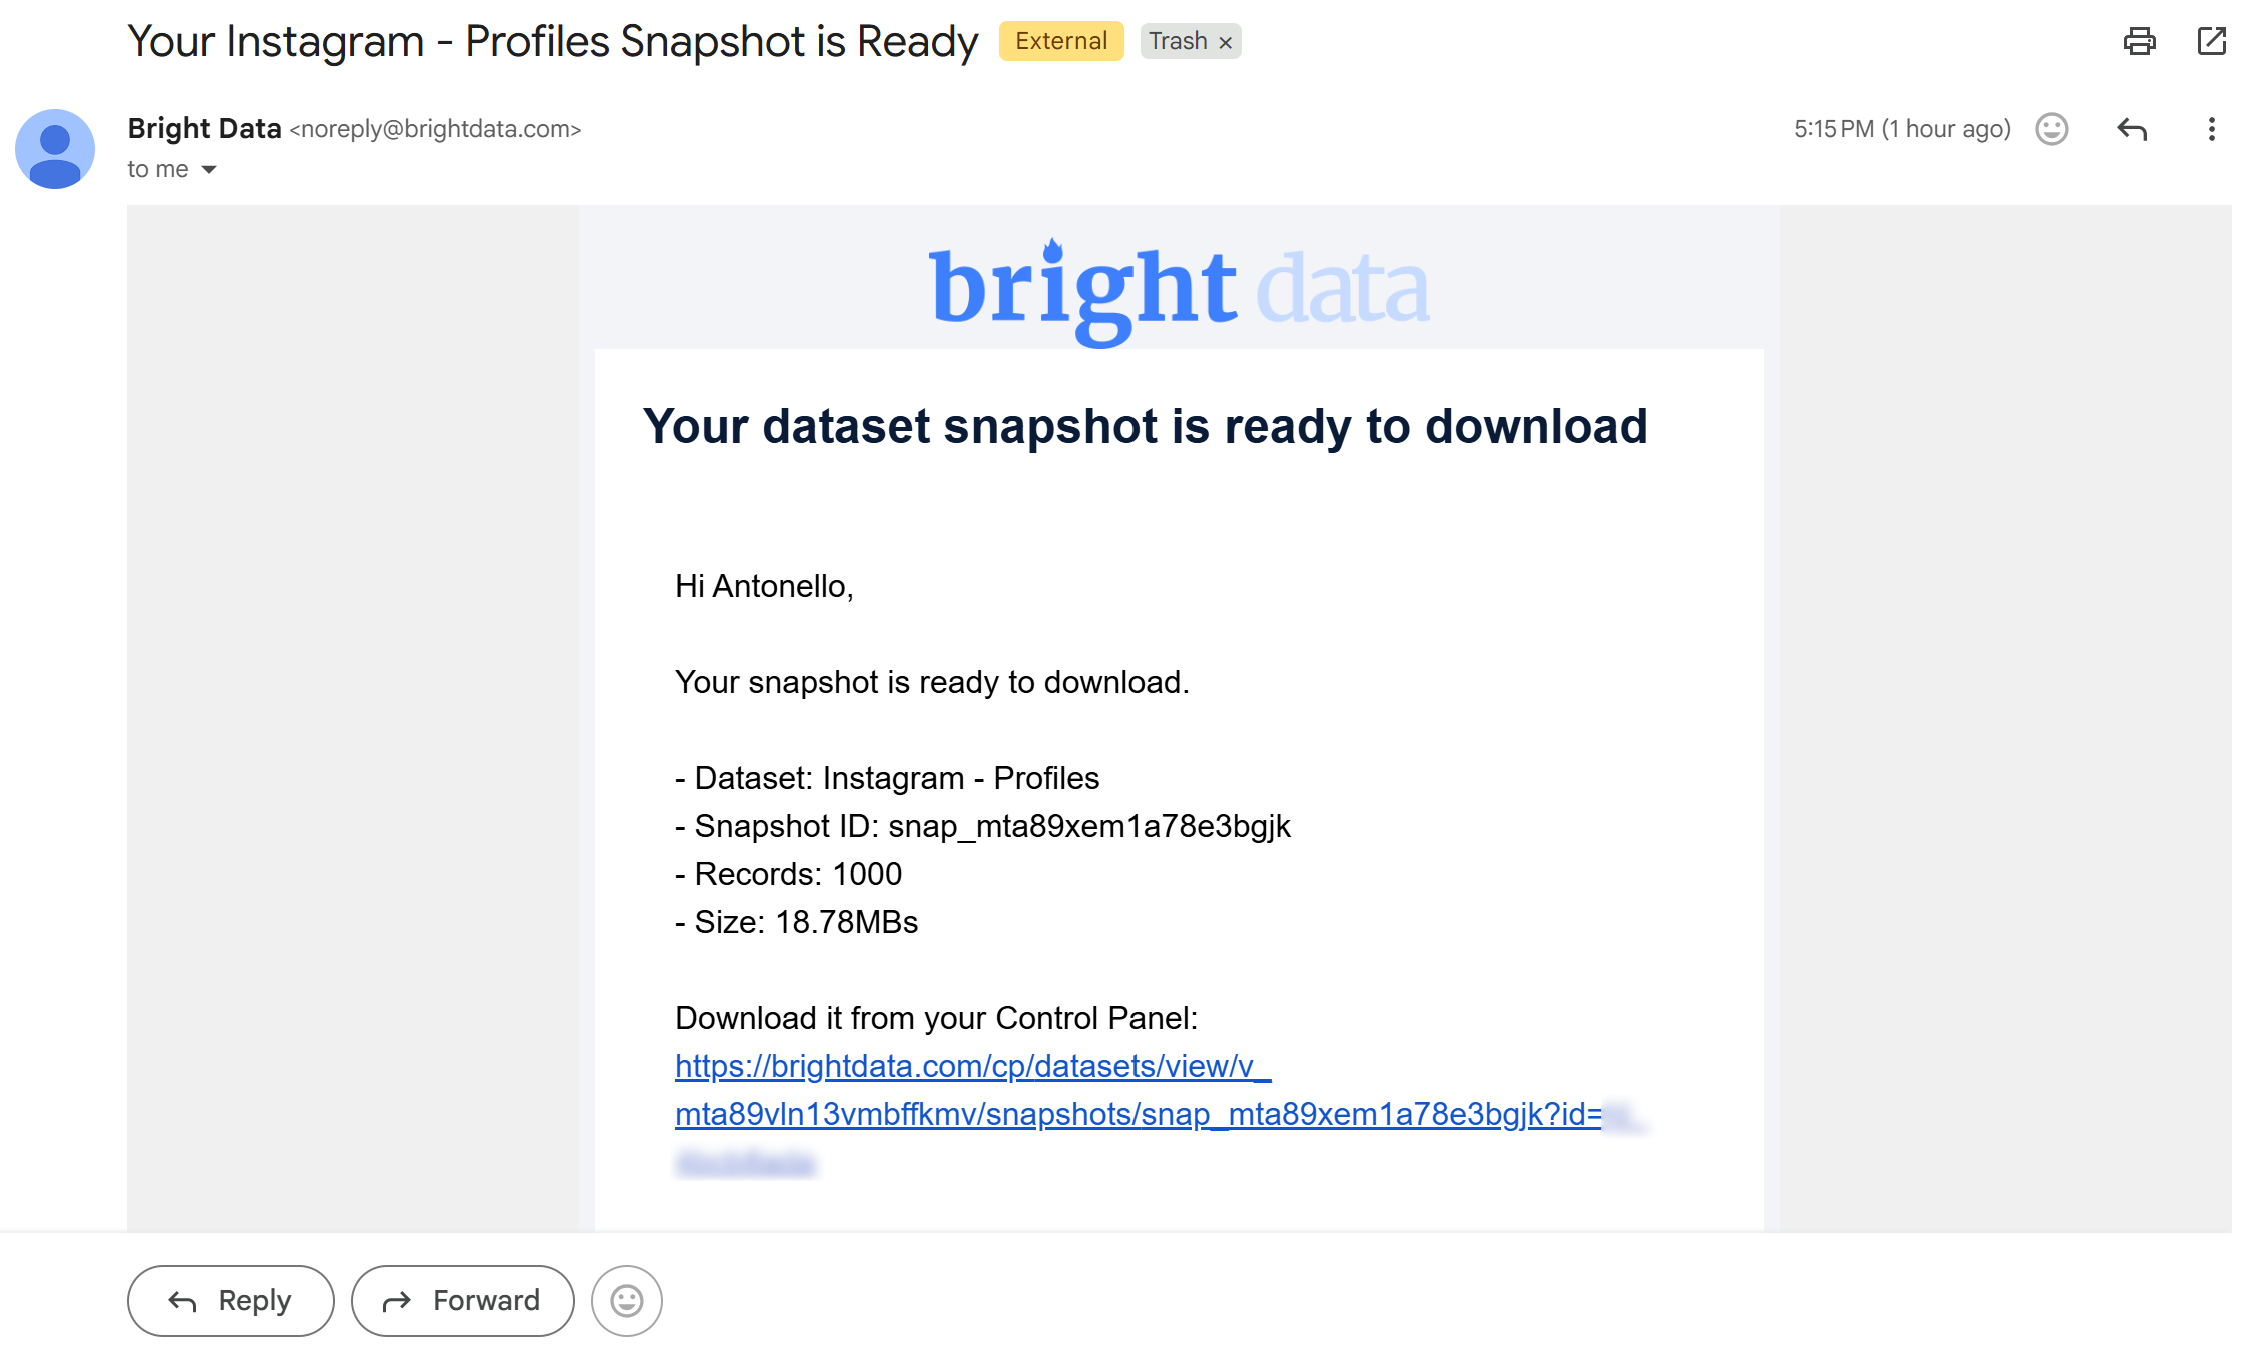
Cliquez sur l’URL dans l’e-mail pour ouvrir la page de l’instantané :
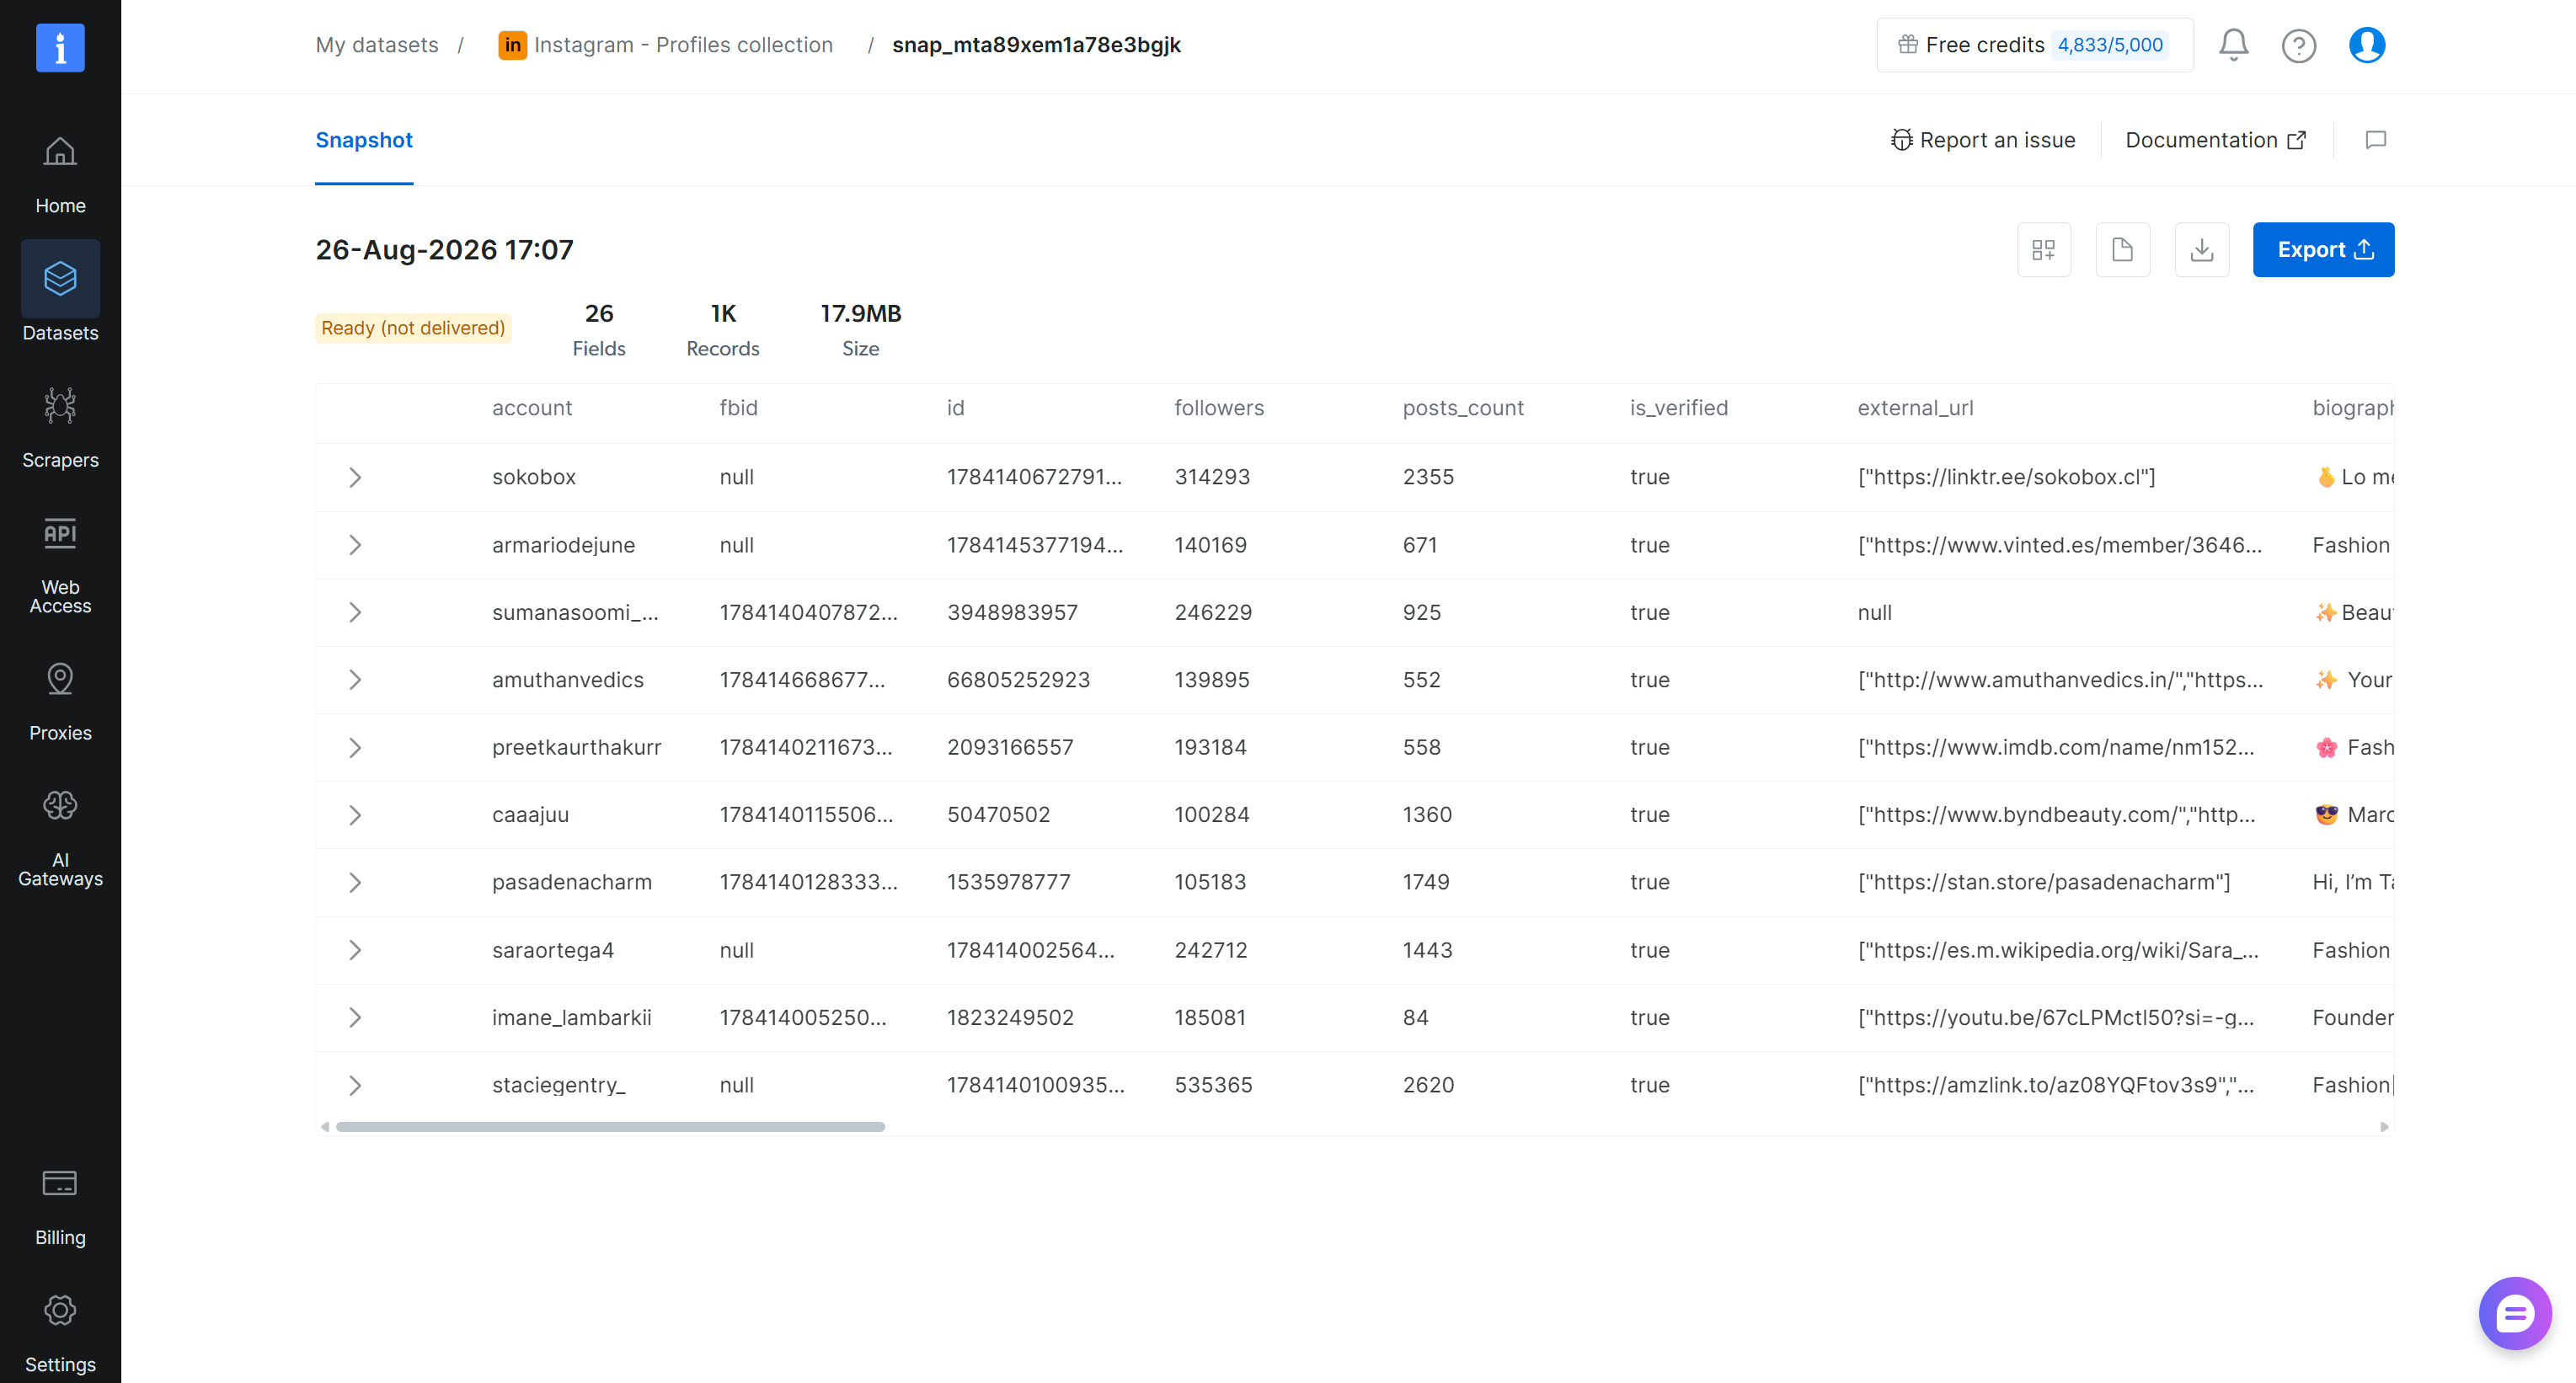
Ici, vous pouvez prévisualiser certaines données et consulter un rapport avec des détails tels que le coût et le nombre d’enregistrements. Plus important encore, vous pouvez télécharger le jeu de données ou l’exporter directement vers Snowflake, ainsi que vers d’autres destinations prises en charge.
Remarque : Dans cet exemple, nous avons limité le nombre d’enregistrements achetés à 1K pour simplifier. C’est pourquoi le nombre d’enregistrements est fixé à 1K au lieu de 11,2K.
Étape n° 3 : Envoyer les données web Bright Data à Snowflake
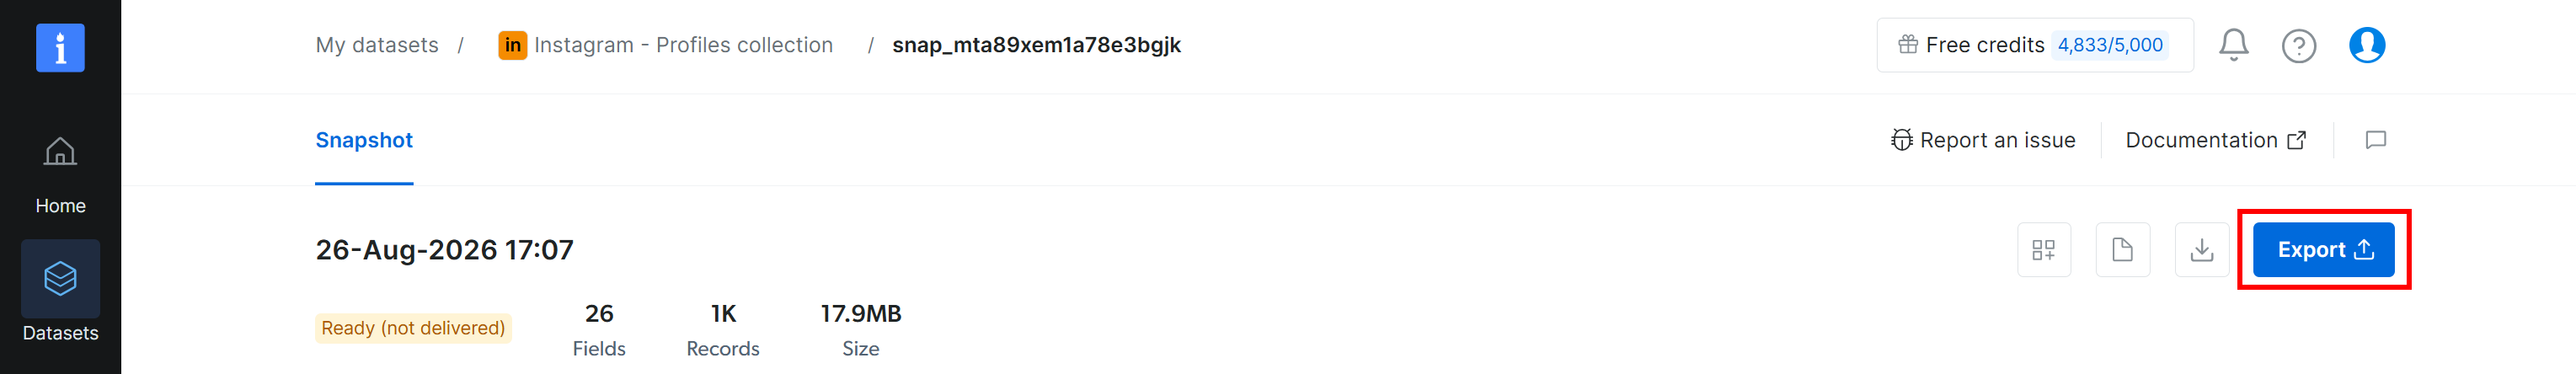
Pour envoyer le jeu de données filtré à Snowflake, commencez par cliquer sur le bouton « Export » sur la page d’instantané du jeu de données :
Sélectionnez « Snowflake » et remplissez les champs requis pour configurer la livraison des données :
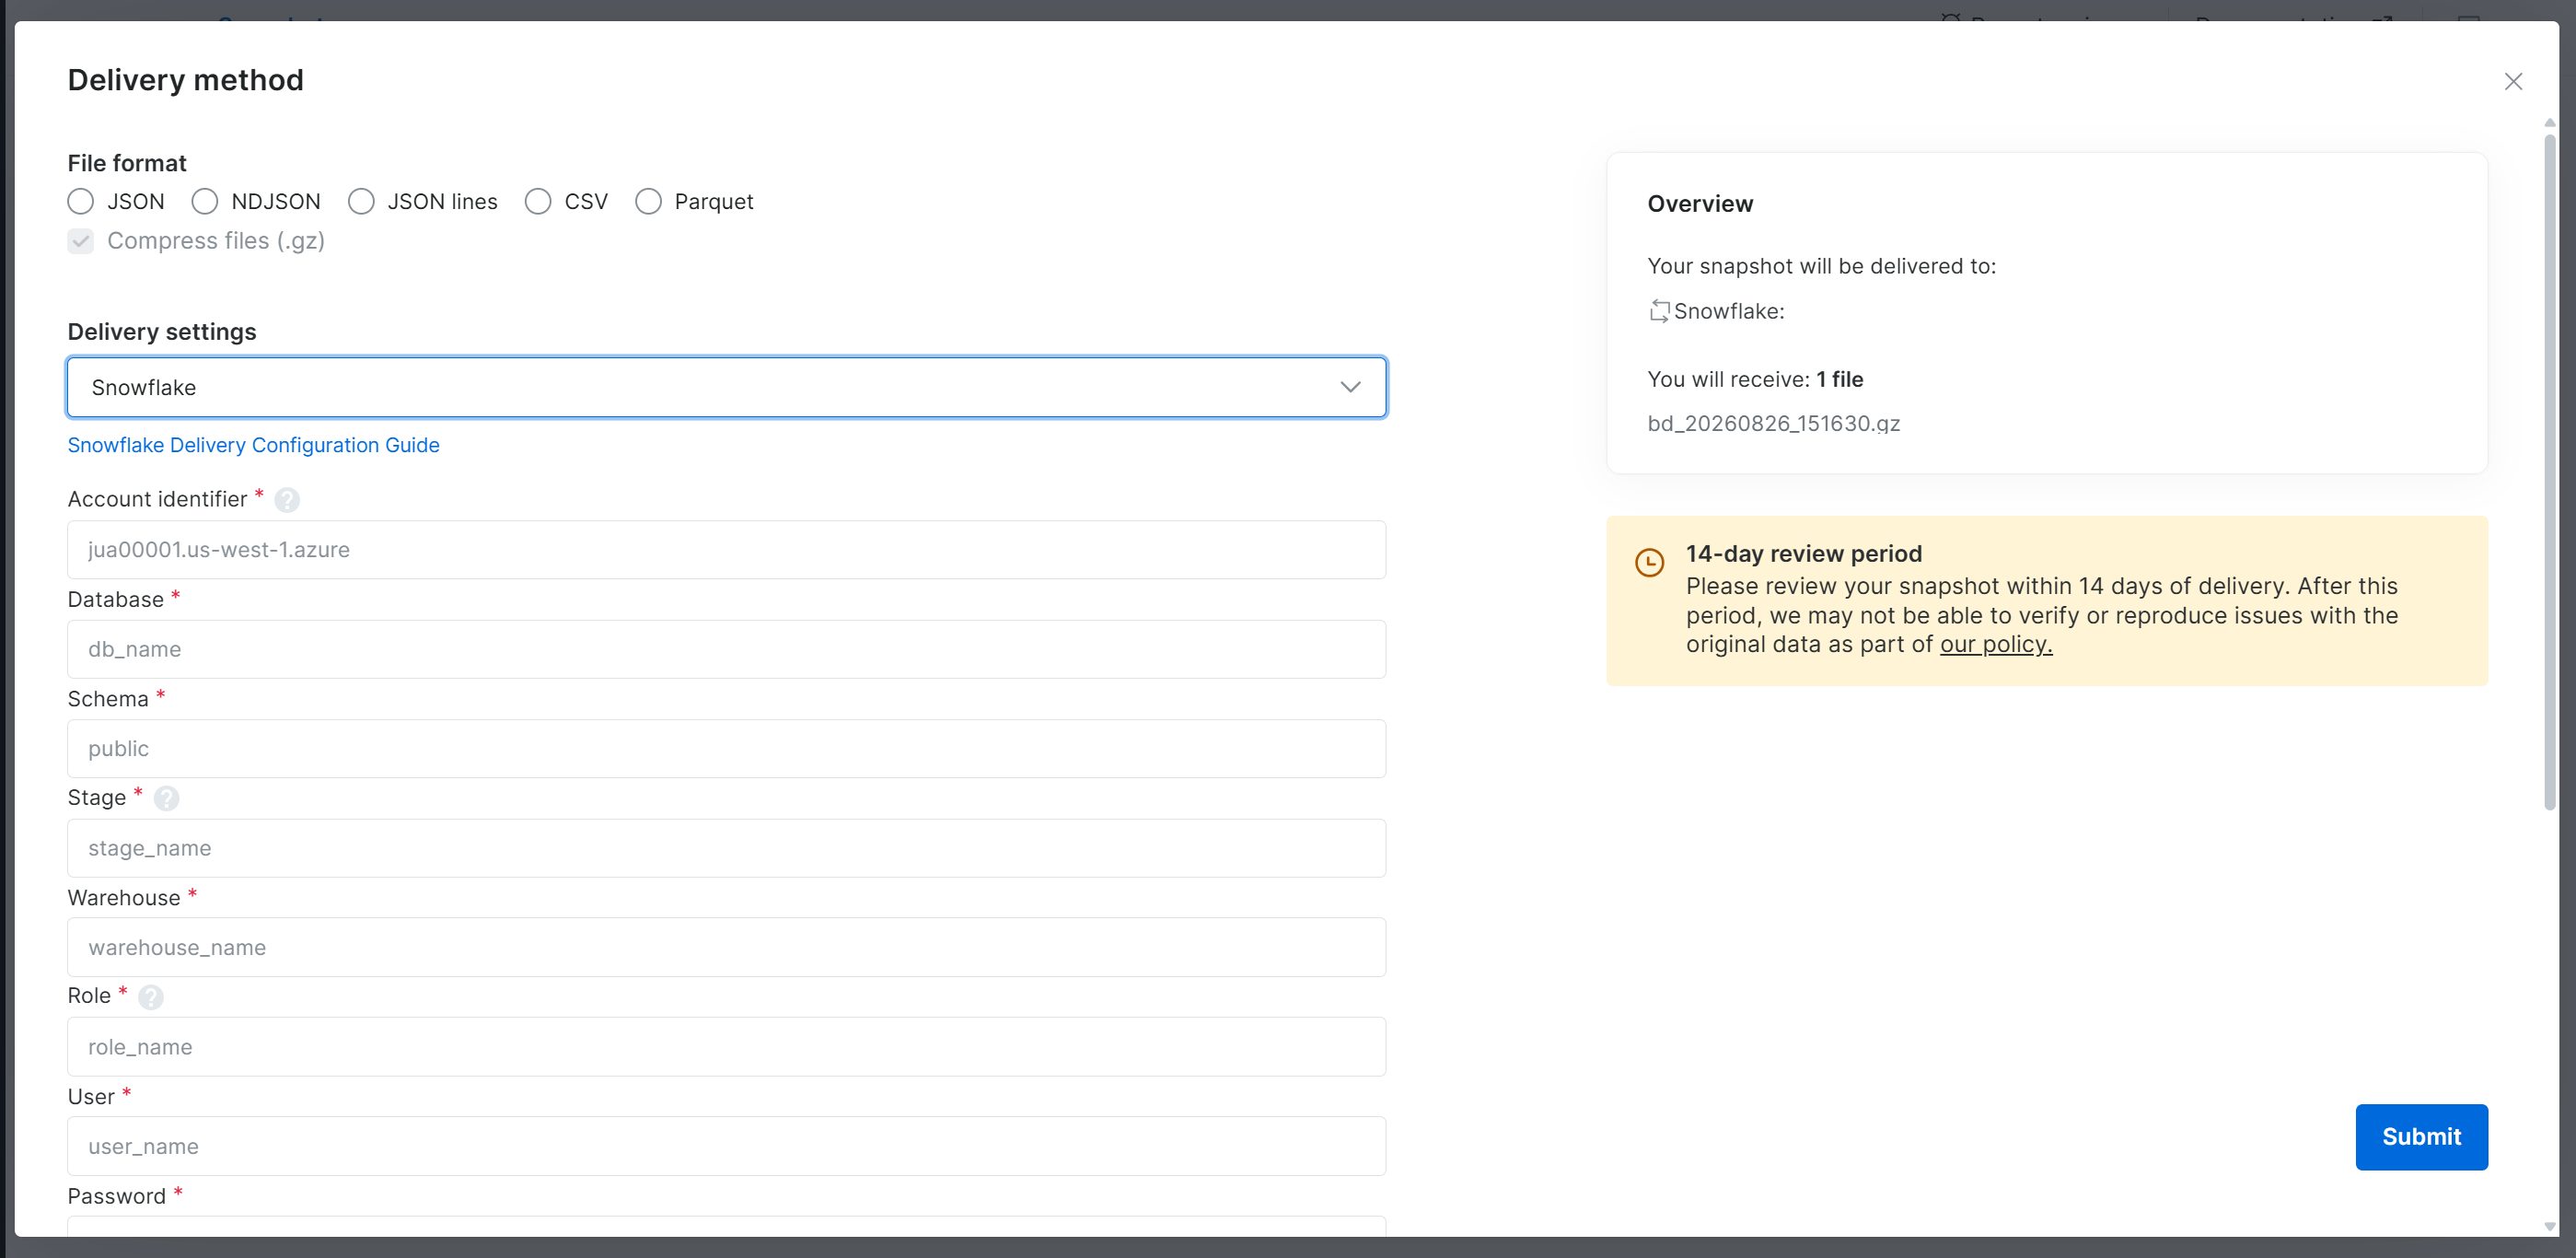
Si vous n’êtes pas familier avec ces paramètres, consultez notre guide complet sur comment ingérer des jeux de données Bright Data dans Snowflake. Vous y trouverez toutes les instructions pour configurer Snowflake pour la livraison de jeux de données Bright Data, ainsi que des conseils sur la façon de remplir les champs requis.
Pour cet exemple, supposez que vous avez configuré la livraison pour importer les données dans la table SNOWFLAKE_INTELLIGENCE.PUBLIC.INSTAGRAM_PROFILES. Une fois l’ingestion terminée, vous pouvez explorer les données importées directement dans Snowflake :
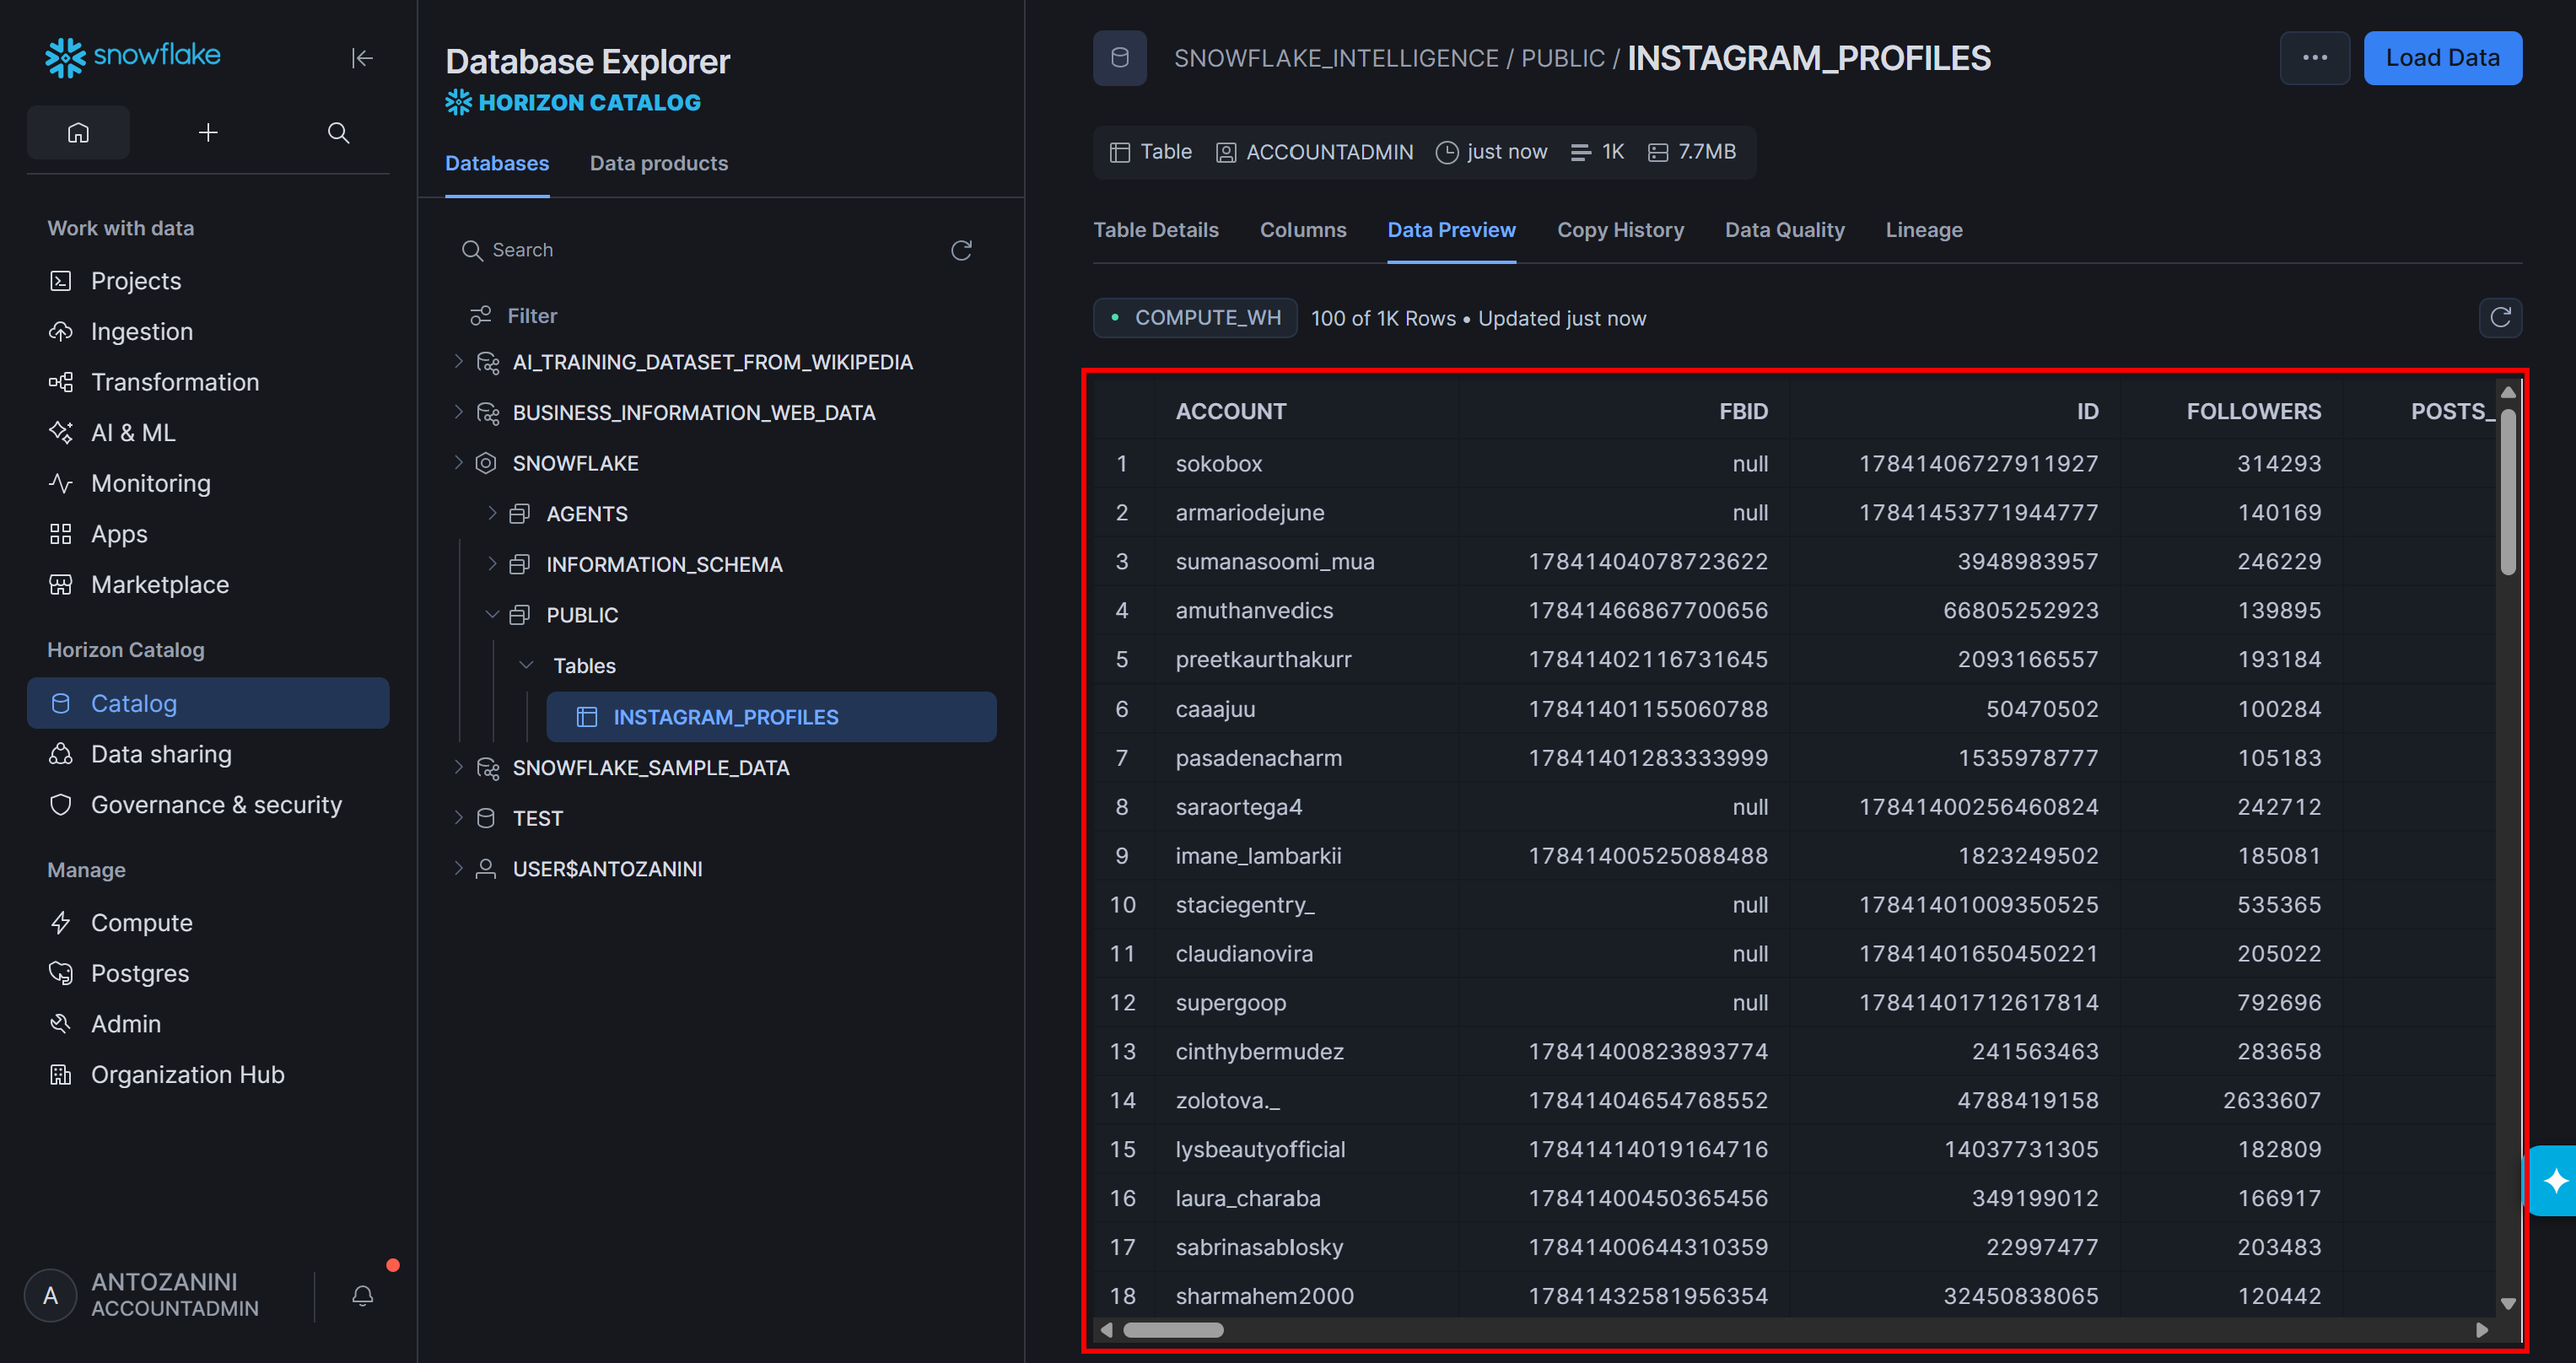
Remarquez comment la table contient les mêmes données de profils Instagram filtrées que vous avez sélectionnées dans le jeu de données Bright Data. Les données sont désormais disponibles dans Snowflake aux côtés de vos données d’entreprise, permettant à un Cortex AI Agent d’analyser les deux sources ensemble.
Étape n° 4 : Créer un Cortex Agent
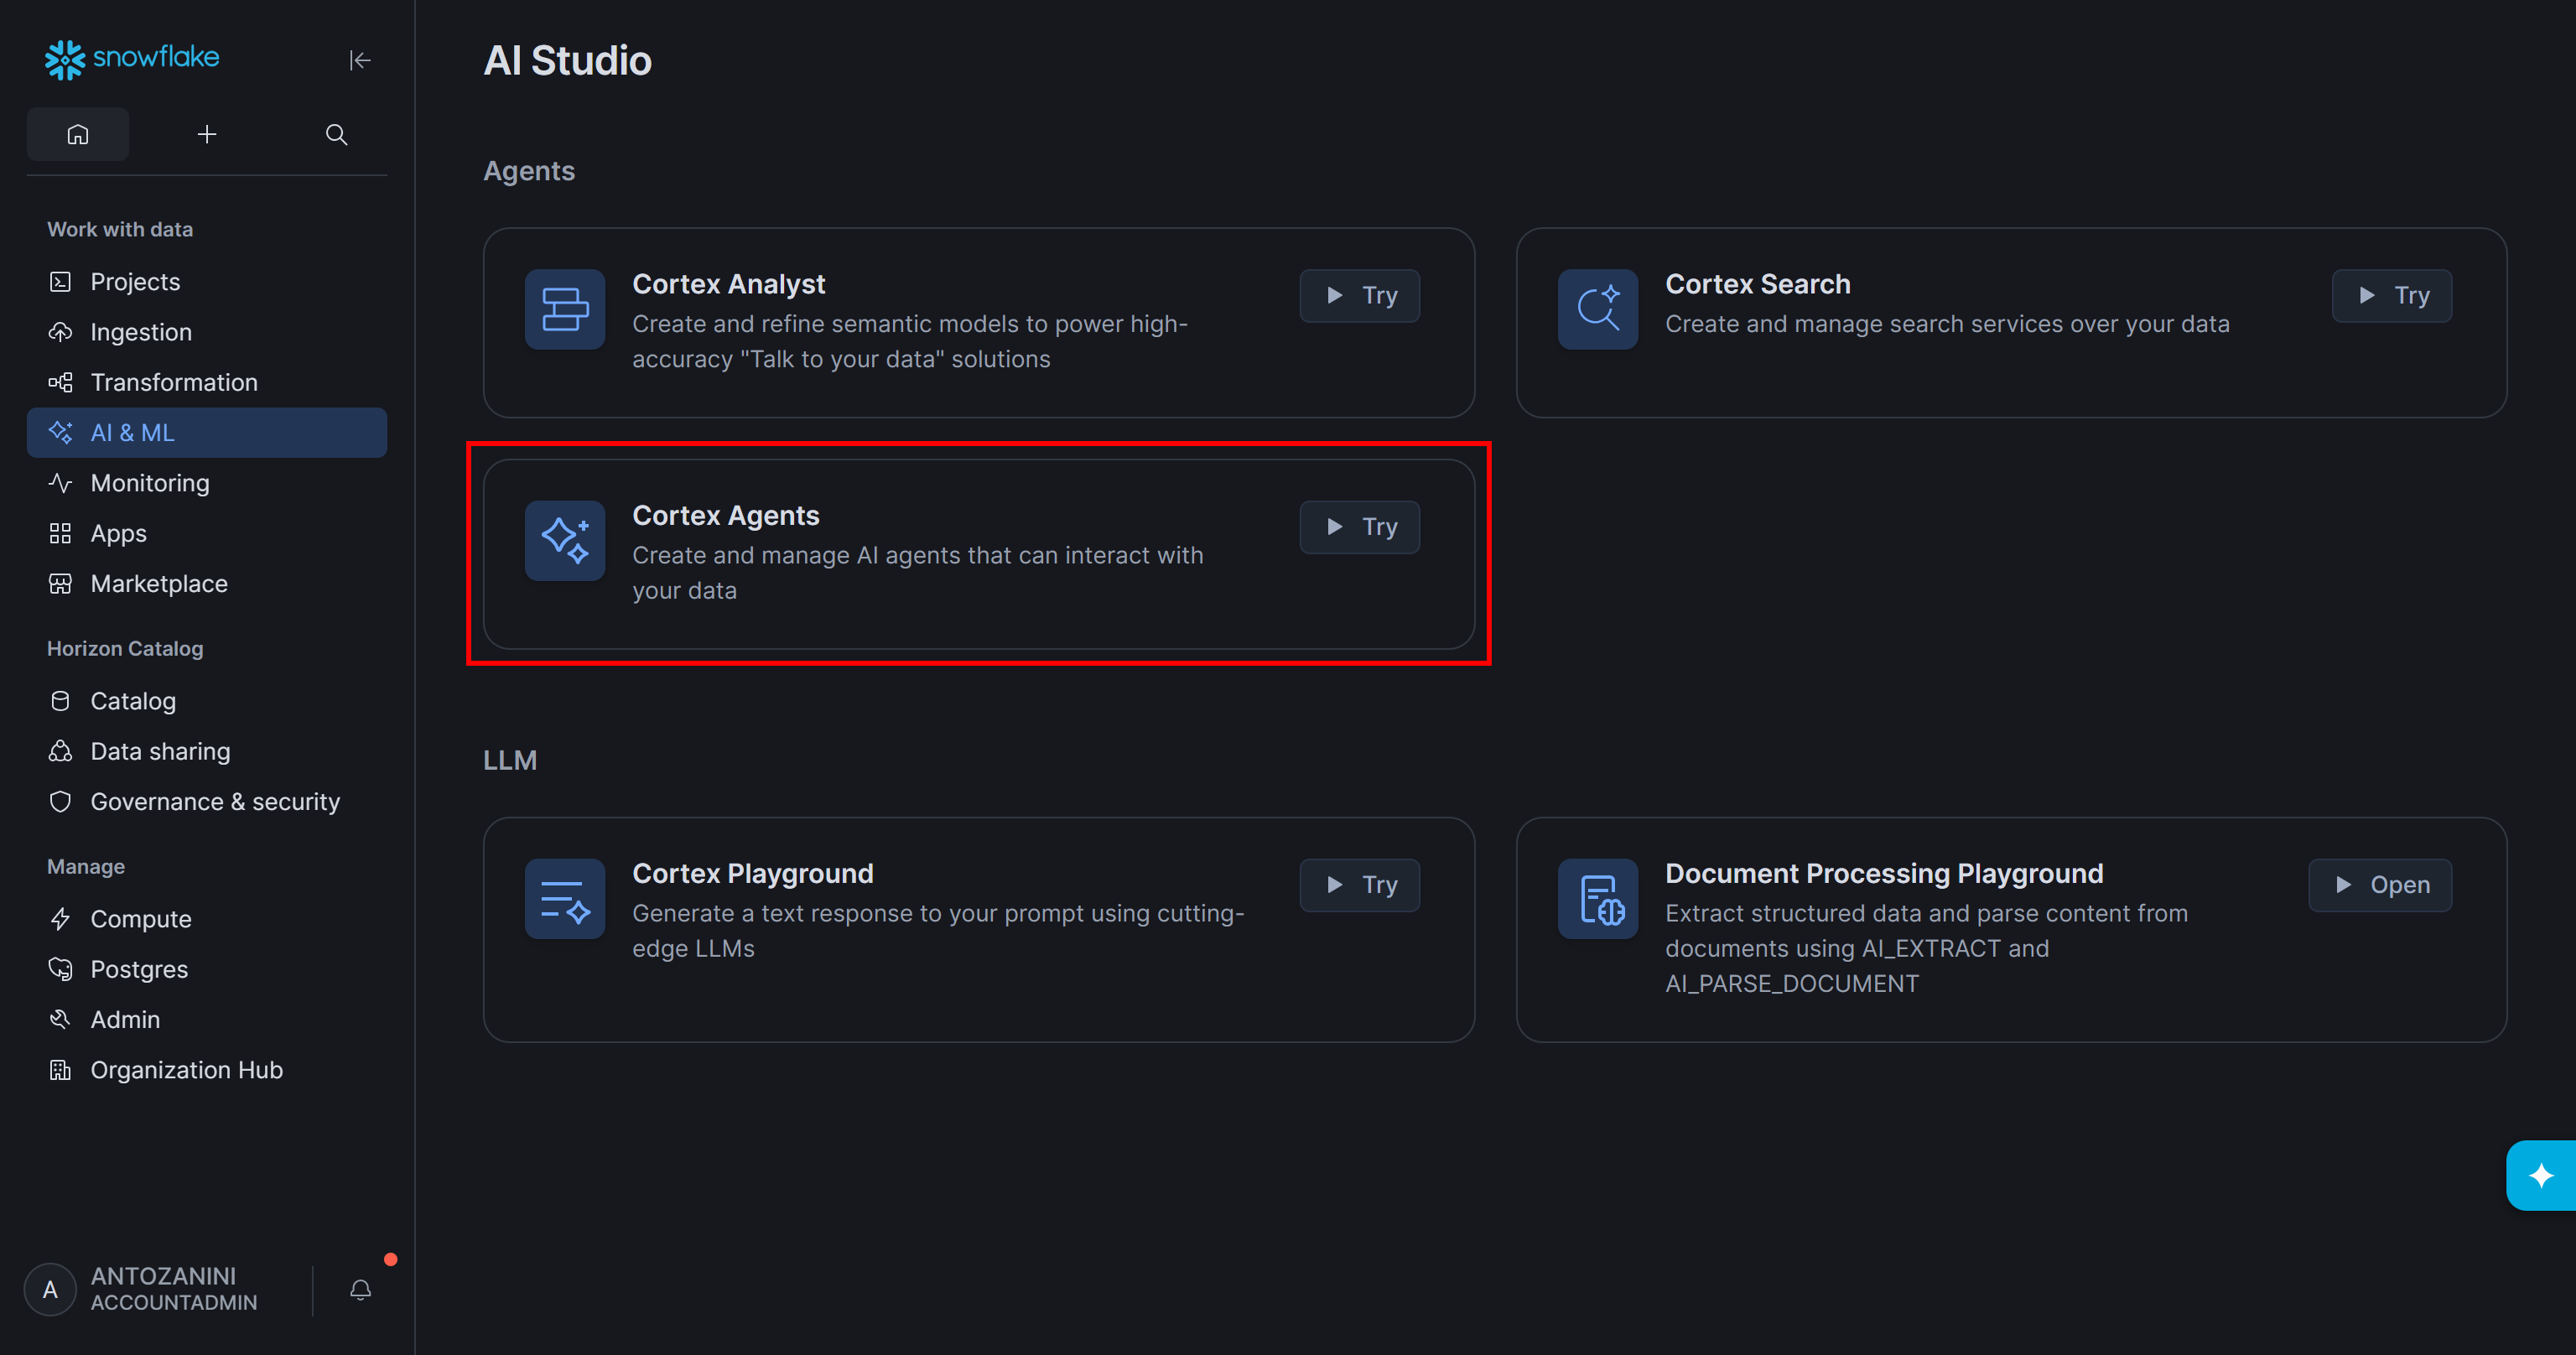
Pour ajouter un nouveau Cortex Agent à votre entrepôt Snowflake, accédez à la page « AI & ML » et sélectionnez la carte « Cortex Agents » :
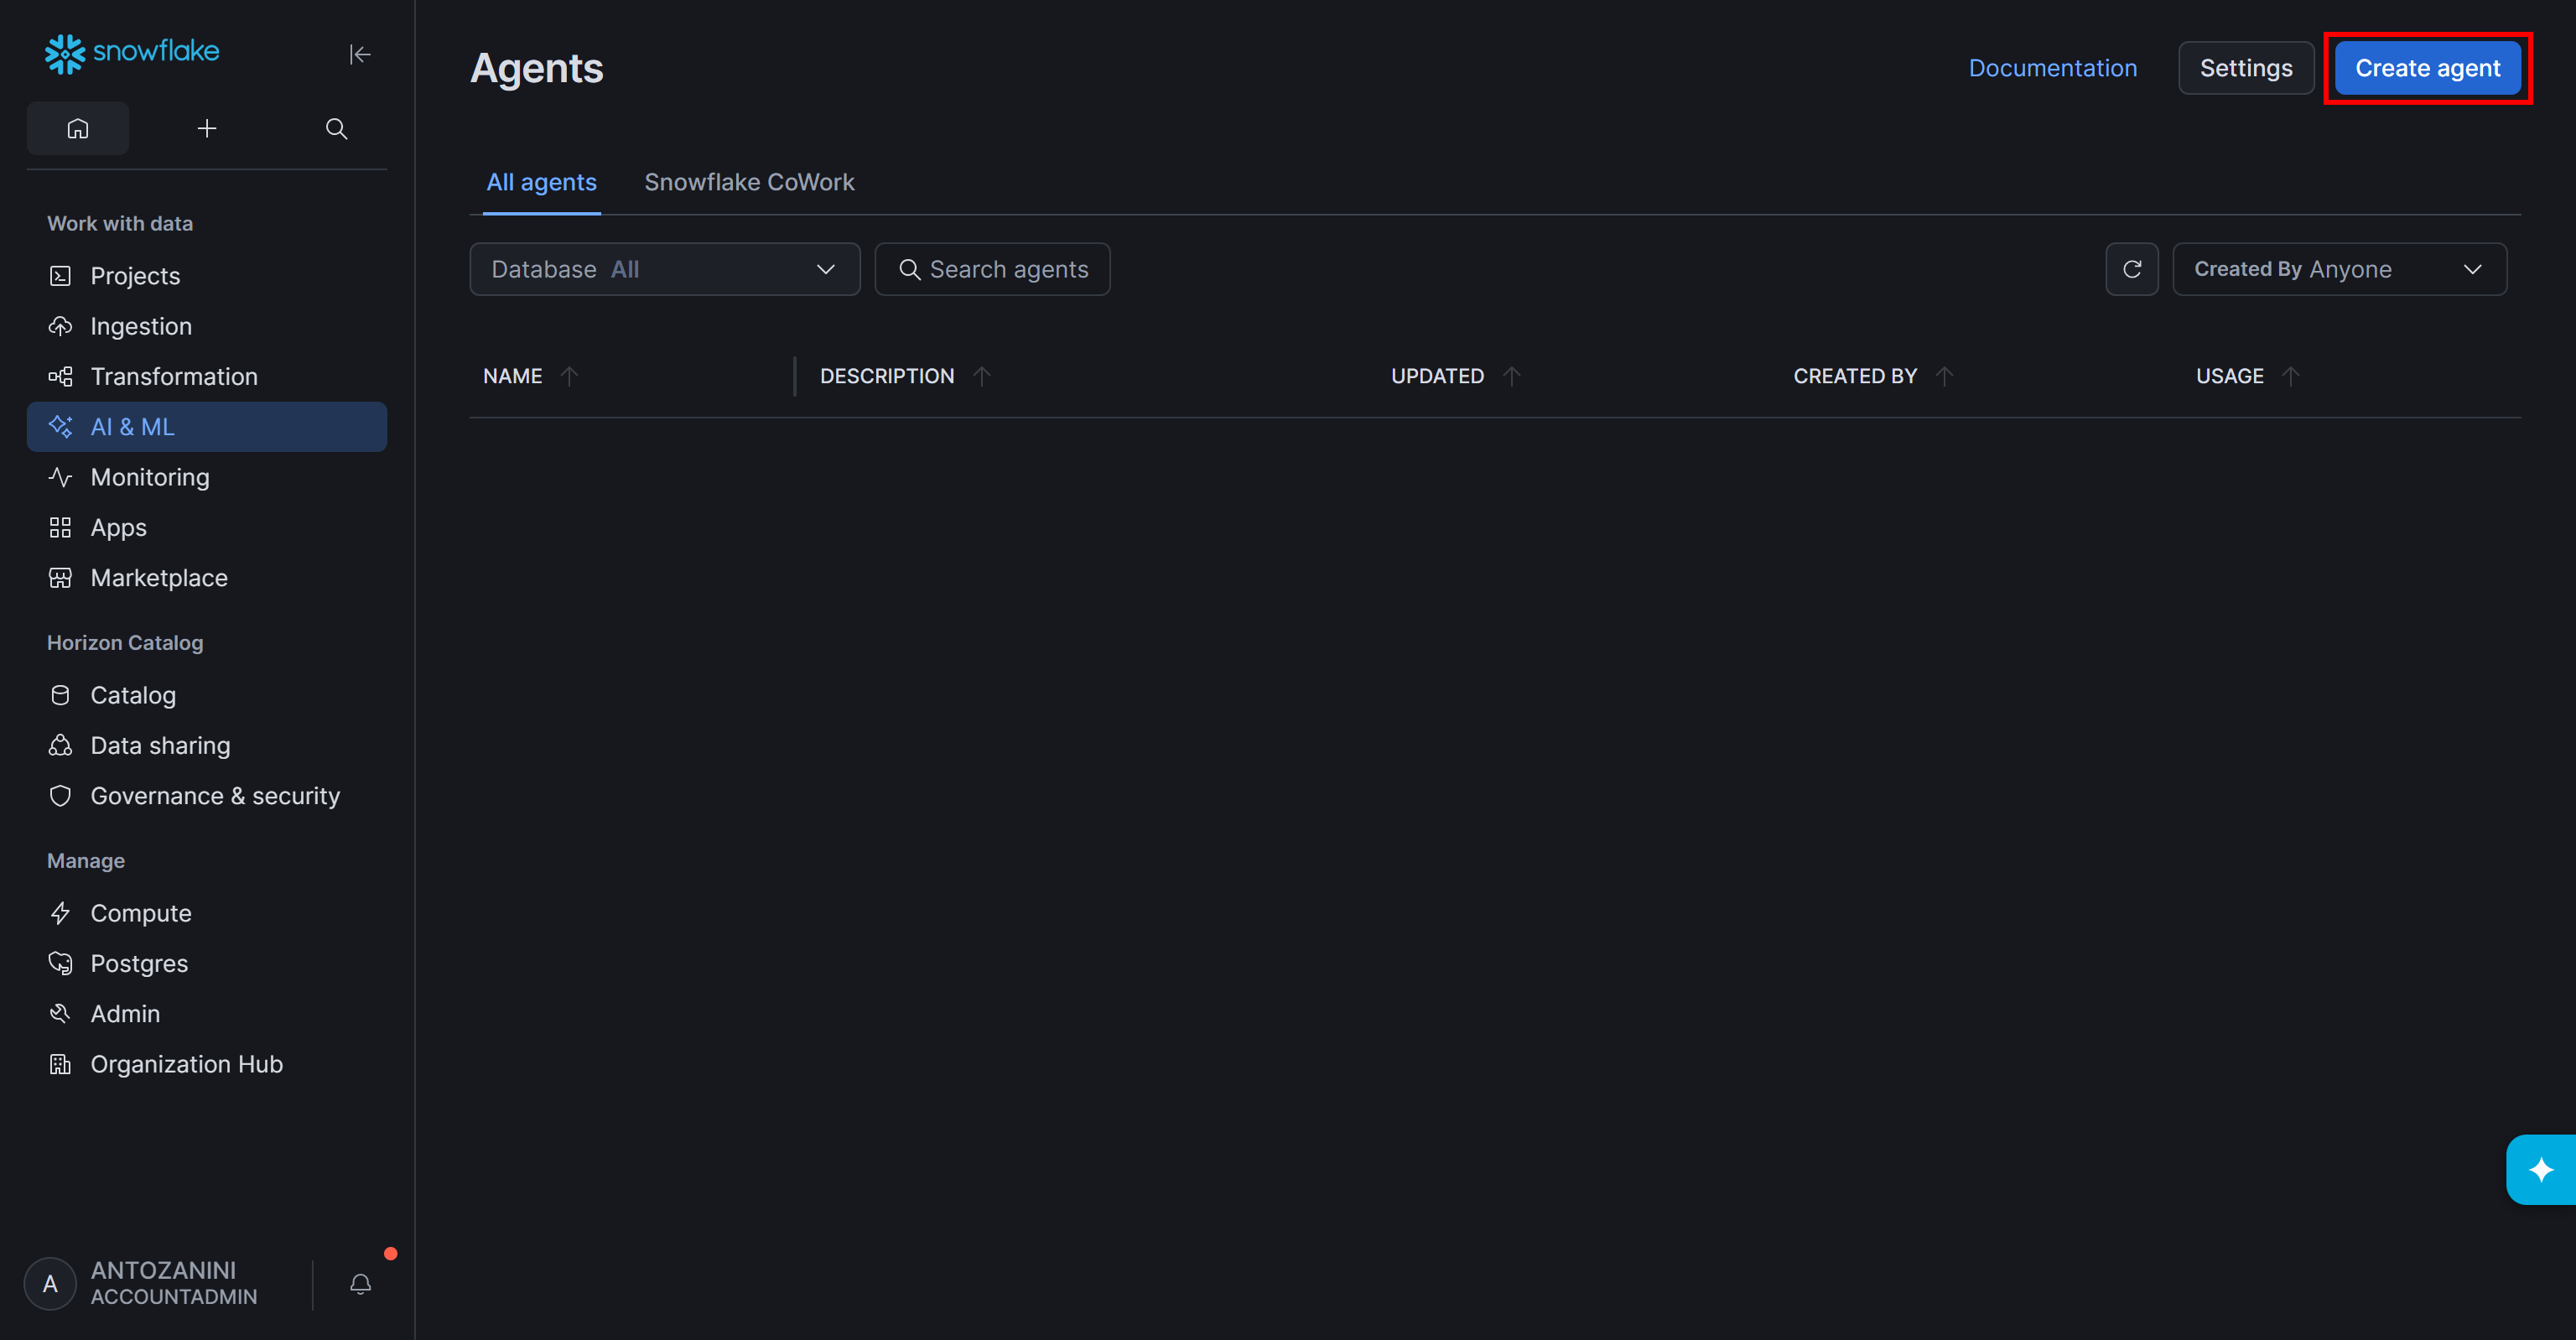
Sur la page « Agents », cliquez sur « Create agent » :
Sélectionnez la base de données et le schéma contenant votre jeu de données Bright Data importé (ainsi que d’autres données d’entreprise précieuses). Ensuite, donnez un nom à votre agent (par exemple, « Influencer_Analyzer ») :
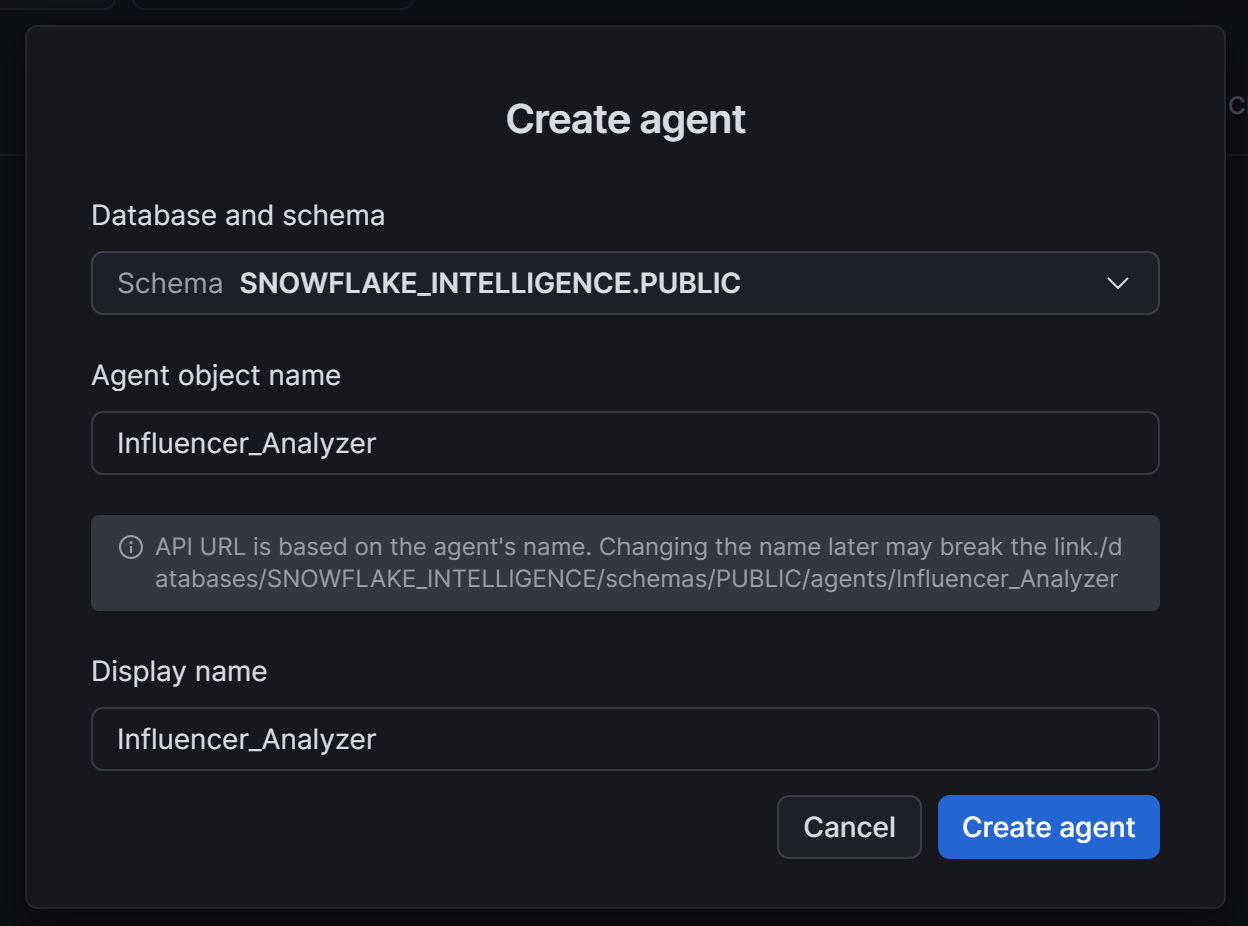
Enfin, cliquez sur le bouton « Create agent » pour terminer la configuration de votre Cortex Agent.
Étape n° 5 : Finaliser la configuration de l’agent
Sur la page Cortex Agent, lancez la configuration guidée via Snowflake CoCo en cliquant sur « Connect » :
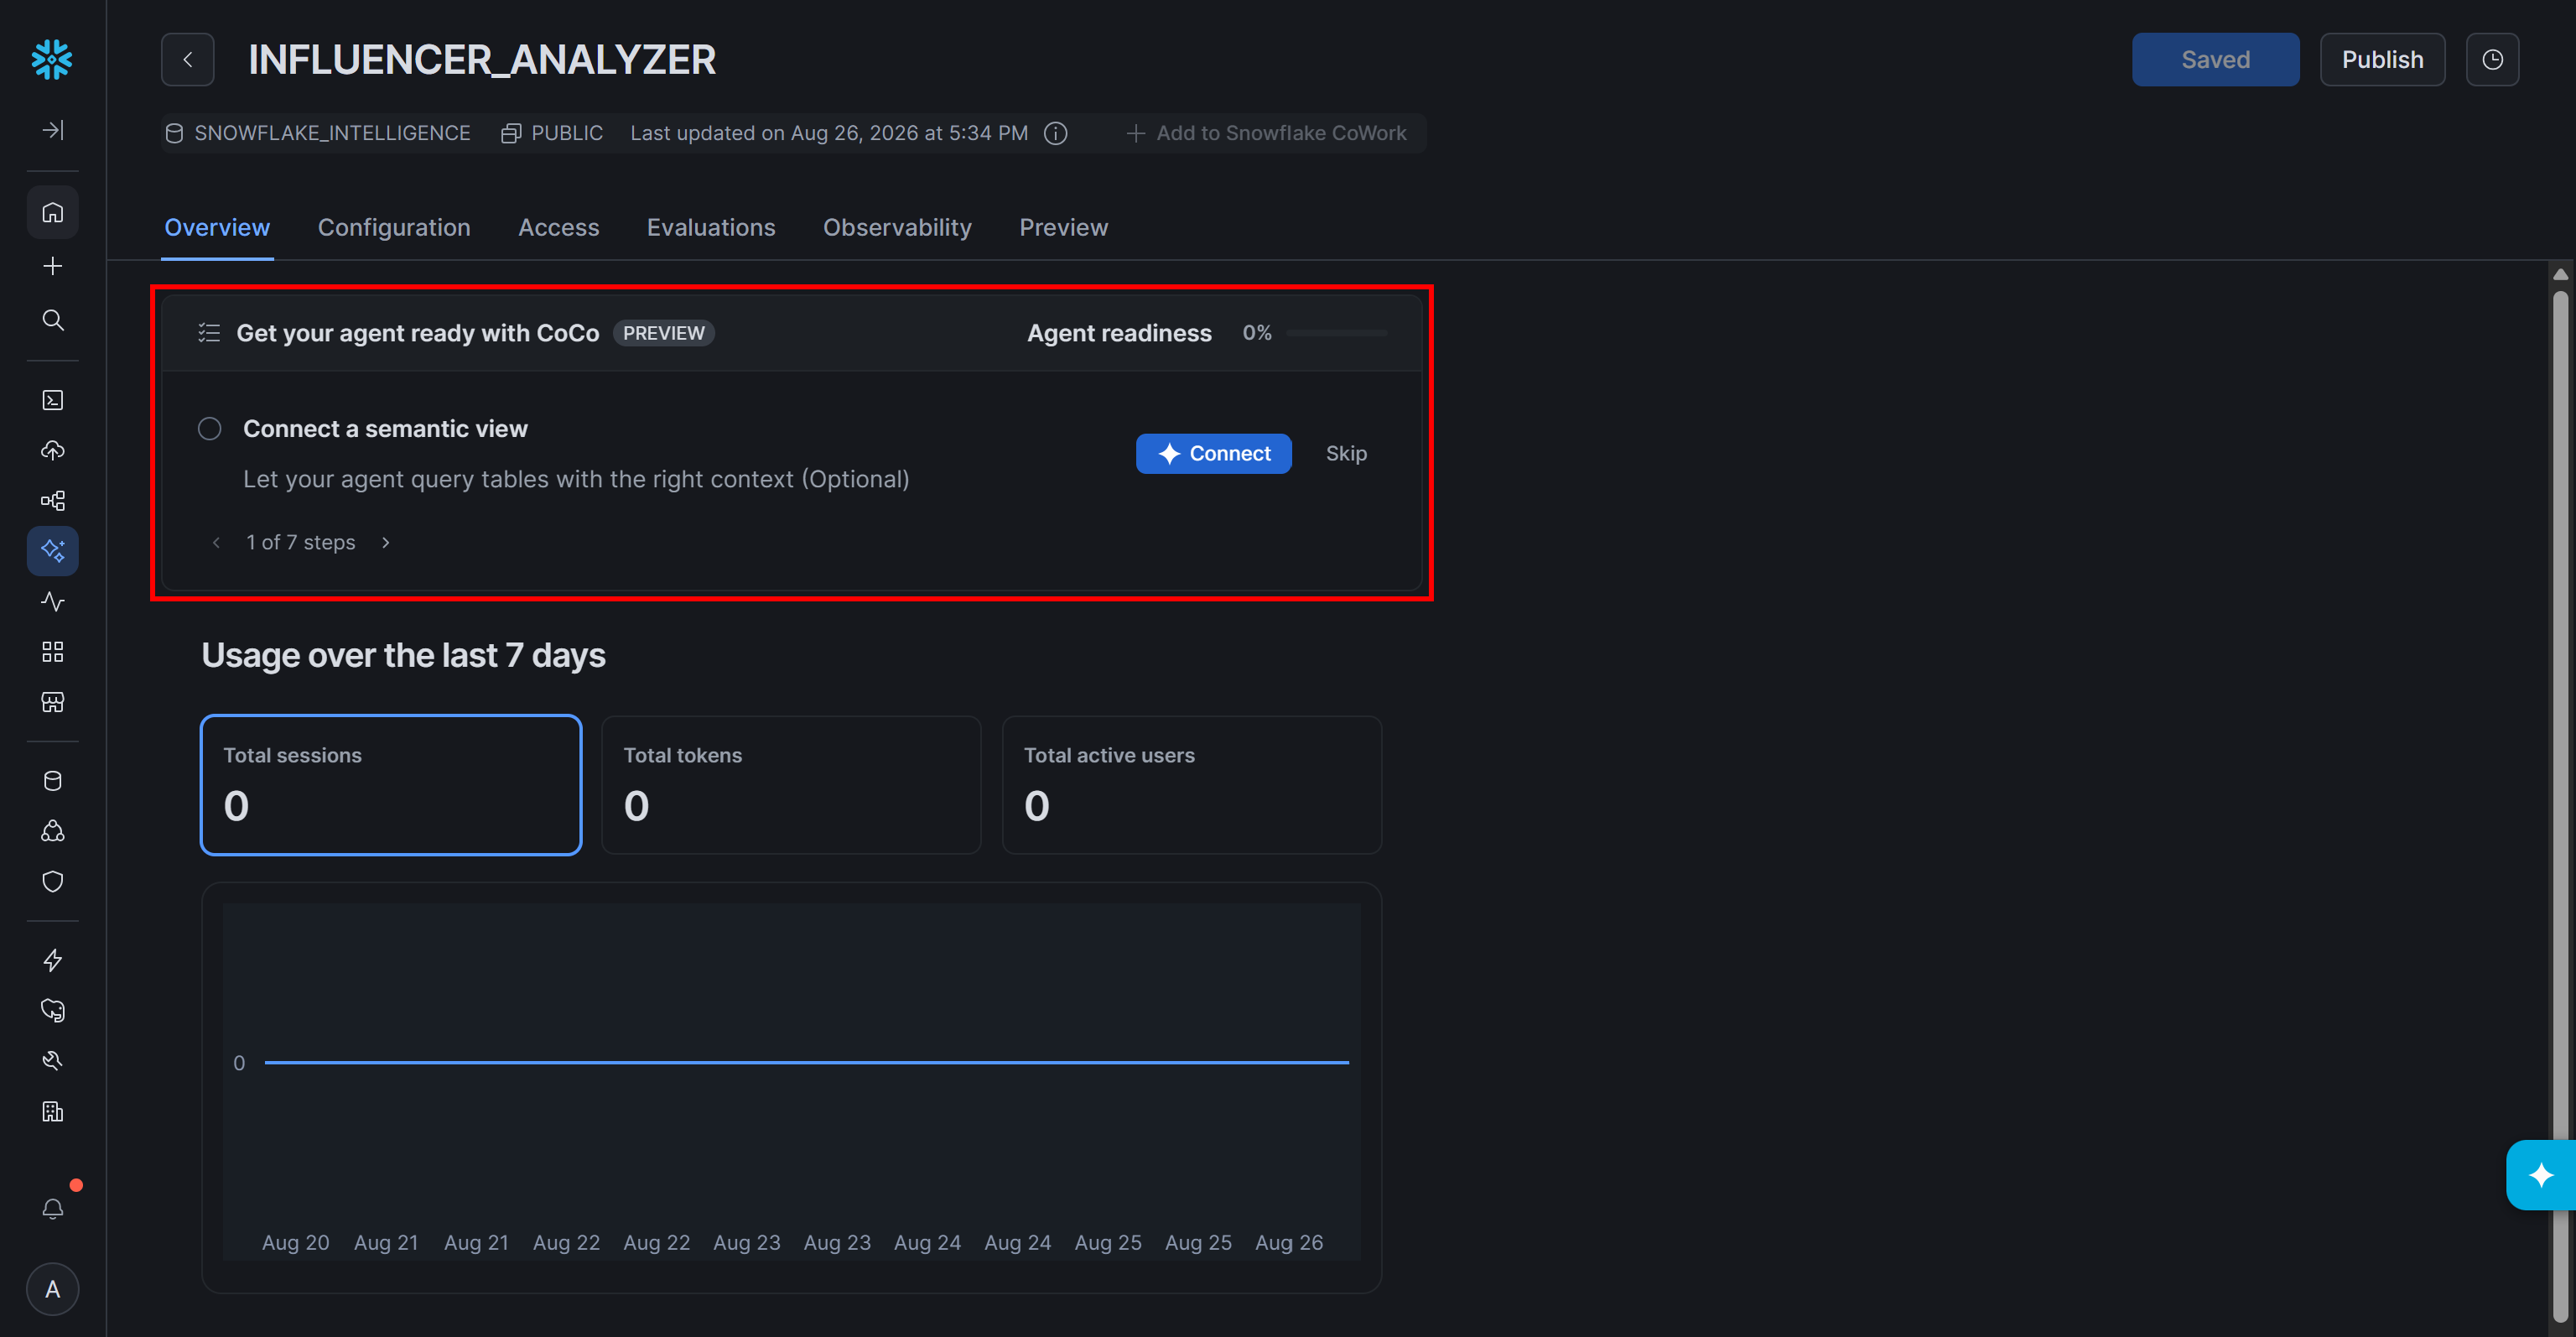
Dans le chat CoCo, vous serez guidé à travers le processus de configuration, y compris la création de la vue sémantique de l’agent, la connexion d’un service de recherche :
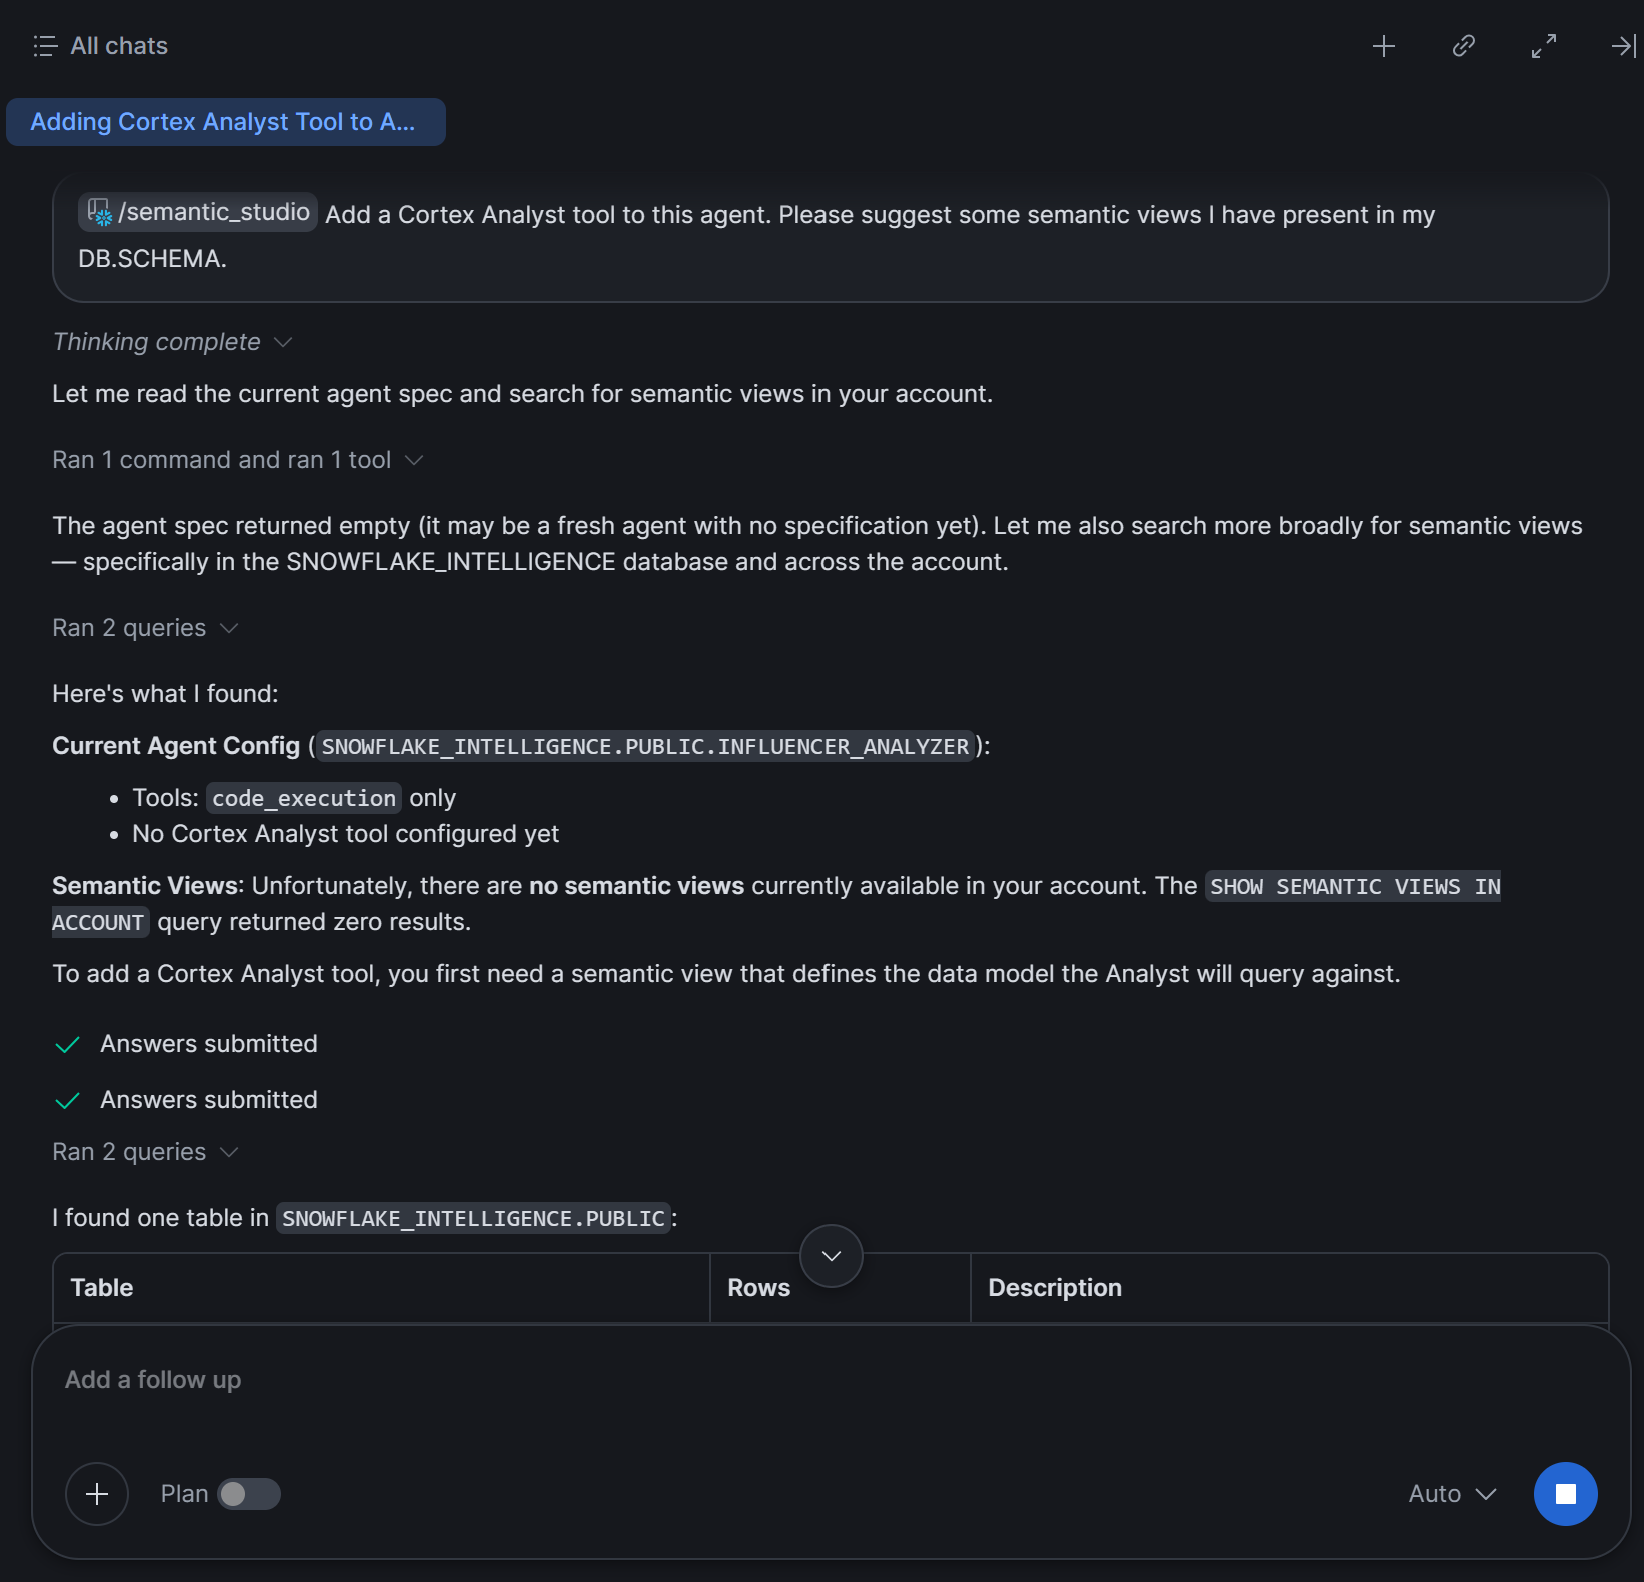
CoCo assemble également les composants Snowflake Cortex requis, qui comprennent :
| Composant | Ce qu’il fait |
|---|---|
| Cortex Analyst | Convertit les questions en langage naturel en SQL sur des tables structurées. Il est guidé par une vue sémantique (ou un modèle sémantique YAML) qui définit les métriques, dimensions et relations. |
| Cortex Search | Construit des index hybrides combinant recherche vectorielle (sémantique) et par mots-clés sur du texte non structuré, permettant à l’agent de récupérer des informations par sens ainsi que par termes exacts. |
| Cortex Sense | Une couche de contexte d’exécution qui apprend les définitions métier, les métriques et les relations entre tables à partir de l’historique des requêtes et des métadonnées, ancrant l’agent sans vous obliger à maintenir manuellement une vue sémantique. |
| Cortex Agents | L’orchestrateur qui planifie une tâche et oriente chaque étape vers l’outil approprié. |
Ensuite, ouvrez l’onglet « Configuration » pour définir la description et les instructions de l’agent, et ajouter des outils, des compétences et des intégrations MCP :
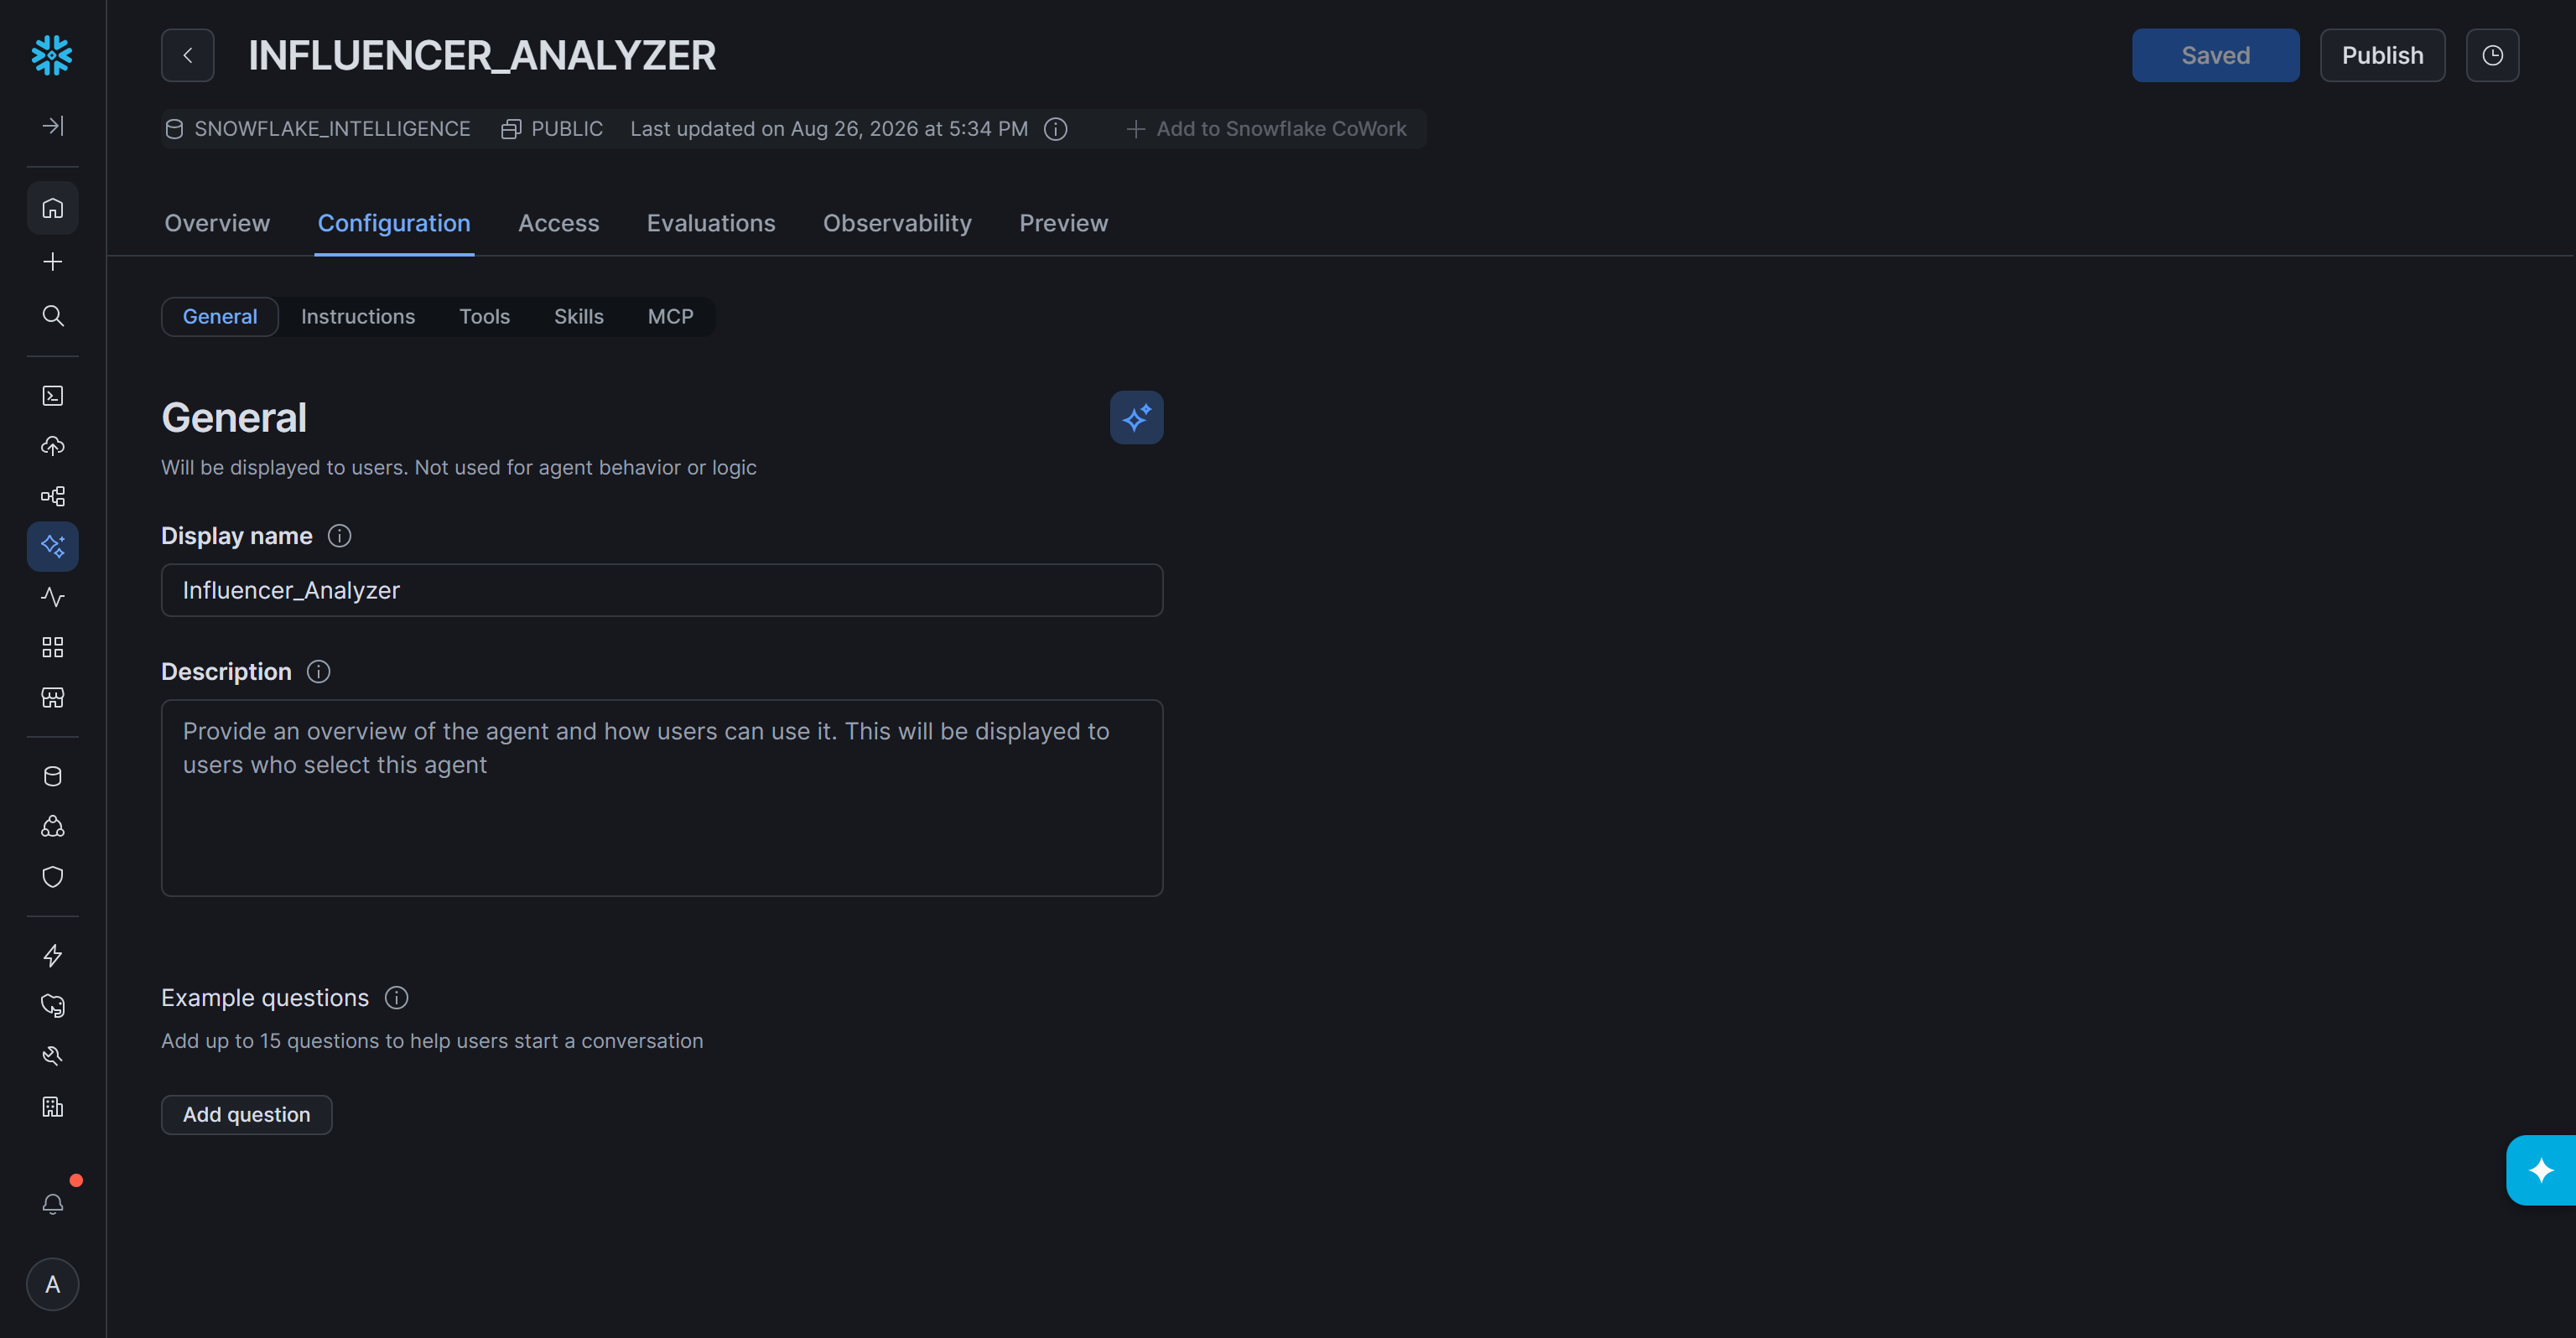
Votre agent peut désormais interroger, raisonner sur et traiter les données stockées dans le schéma Snowflake configuré.
Étape n° 6 : Tester l’agent
Une fois configuré, passez à l’onglet « Preview » pour tester votre agent. Par exemple, saisissez une invite telle que :
Récupère les 5 meilleurs influenceurs hispanophones de la liste pour promouvoir notre produit révolutionnaire de soin de la peau ciblant les adolescentes. Attribue à chaque influenceur un score de pertinence.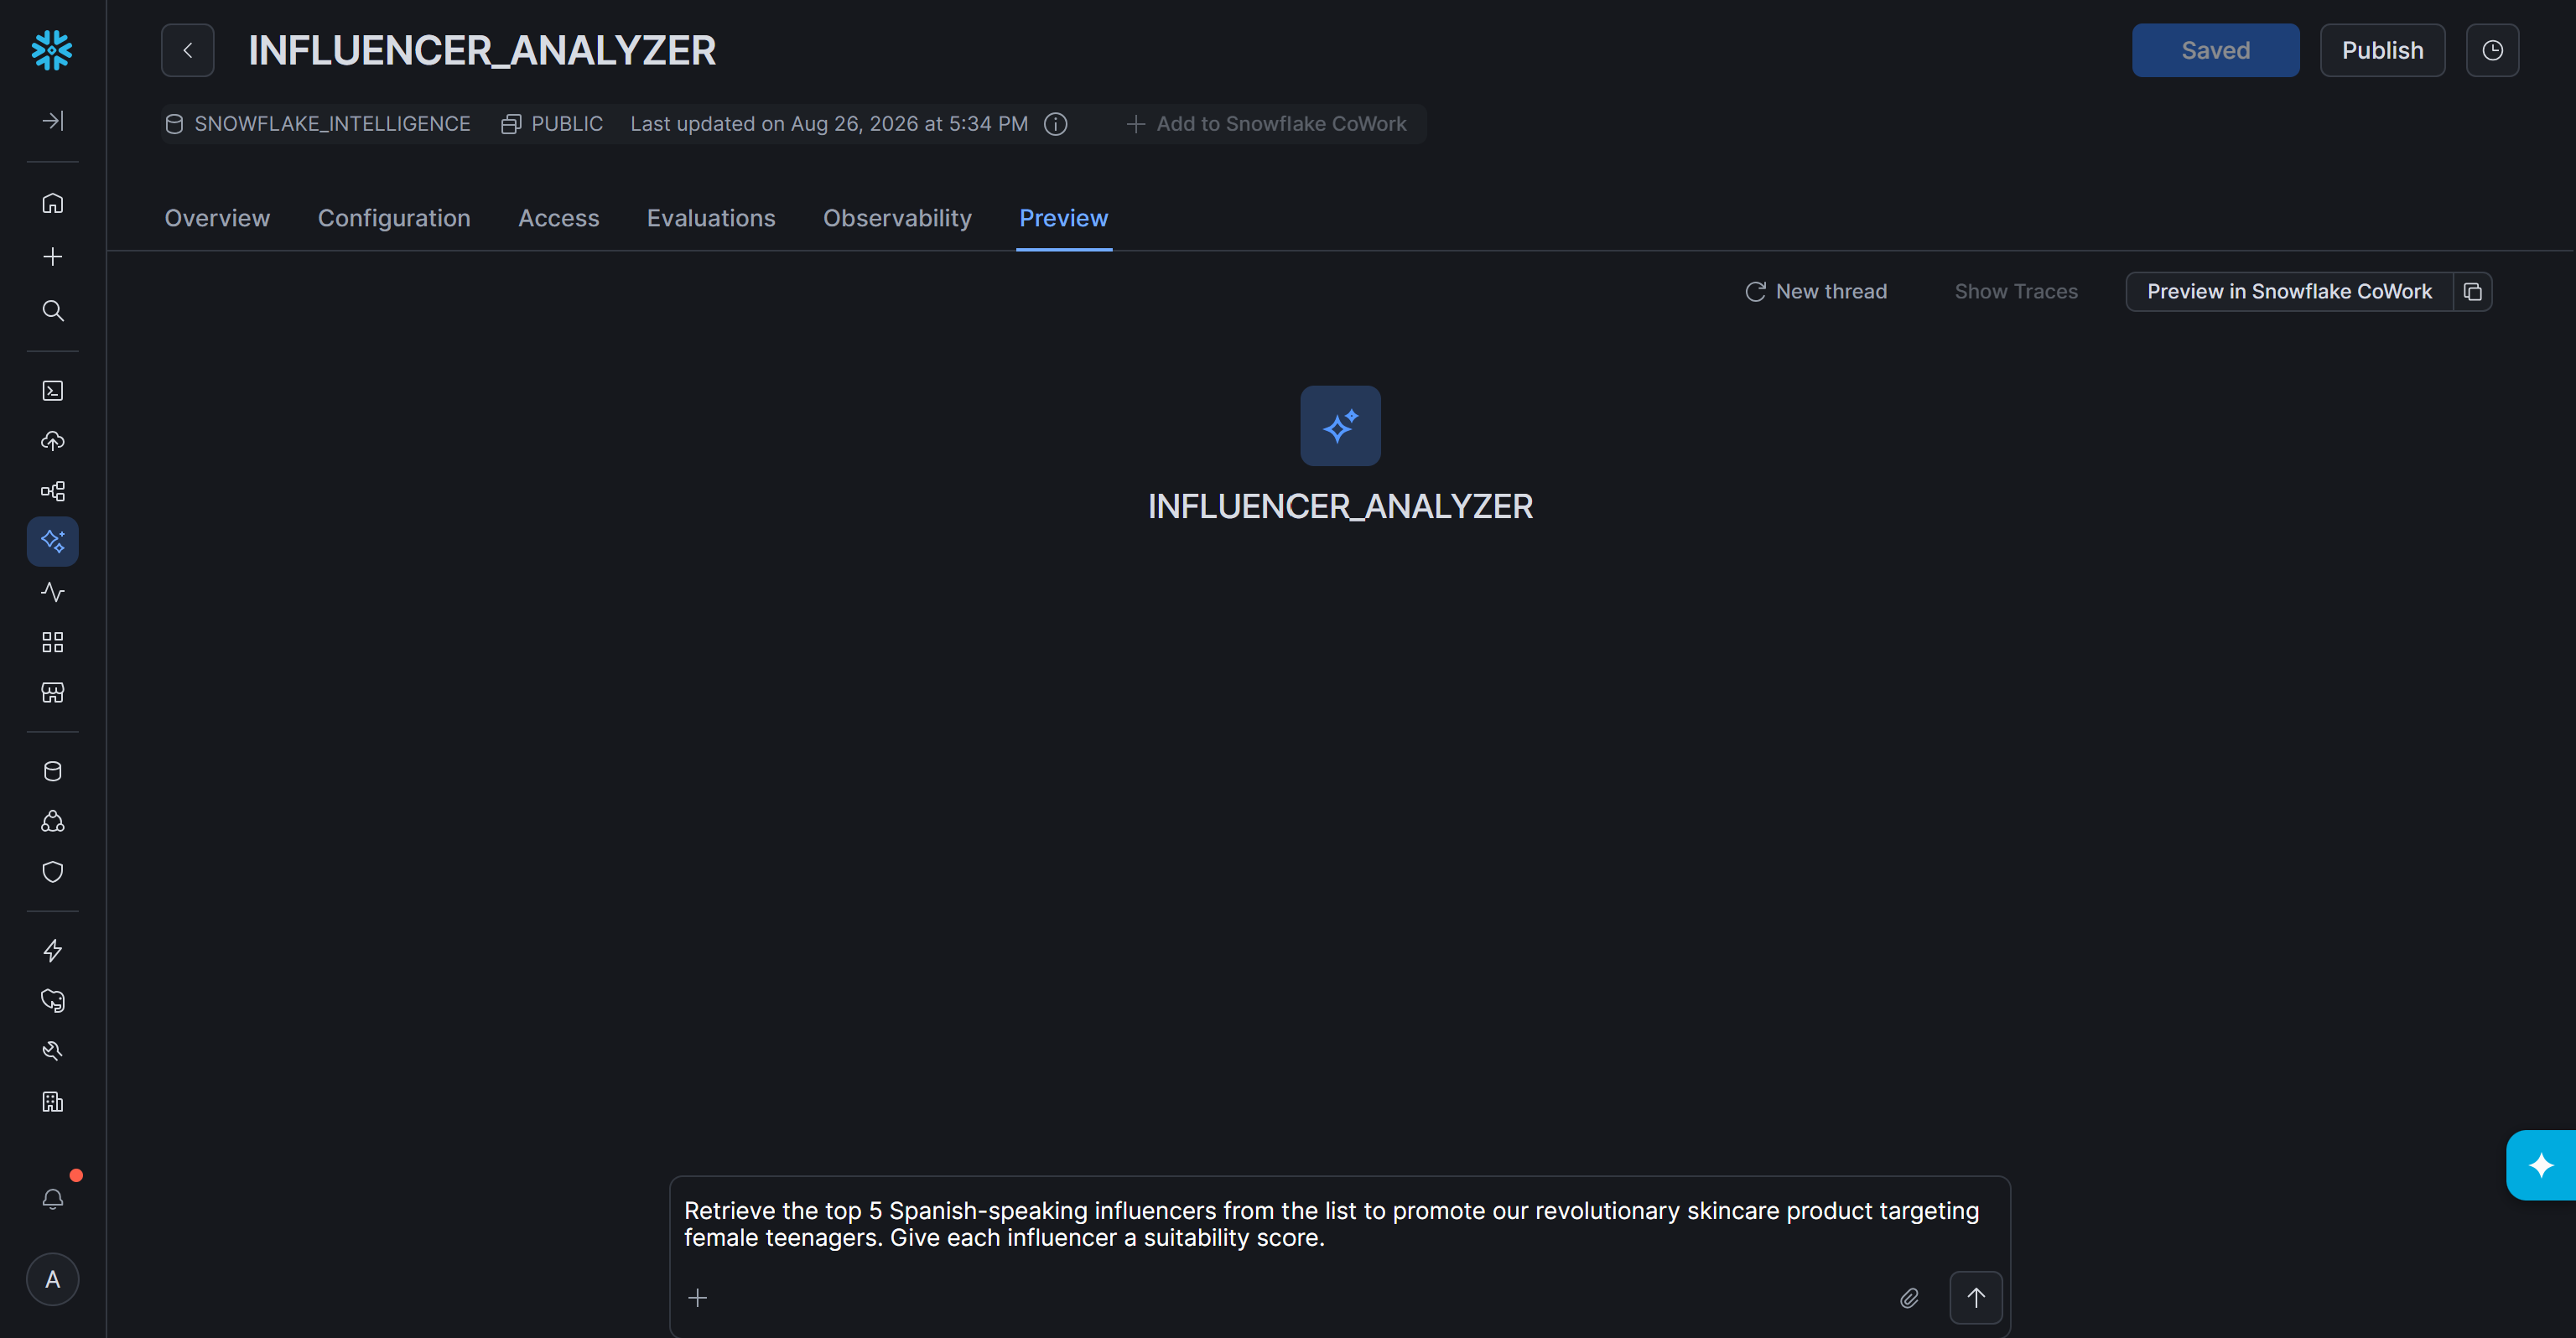
L’agent interrogera les données de profils Instagram dans votre table Snowflake et renverra les cinq influenceurs les plus adaptés, accompagnés d’un score de pertinence pour chacun. En coulisses, il peut utiliser Cortex Analyst pour le filtrage structuré (comme la langue et les attributs de profil) et Cortex Search pour évaluer l’adéquation de la biographie et des légendes avant le scoring. Dans un scénario plus réaliste, vous pourriez également donner à l’agent un contexte sur les données de votre produit pour l’aider à mieux affiner les résultats.
Ajouter un accès web en direct avec Bright Data MCP
Le flux de travail ci-dessus couvre le modèle de jeu de données par lots persistant. Comme le montre la matrice de comparaison, l’autre modèle est l’ingestion en direct : au lieu de stocker d’abord les données web, votre agent les récupère au moment de l’inférence.
Vous pouvez connecter Bright Data aux Cortex Agents via MCP, ou l’intégrer avec CoCo CLI (anciennement connu sous le nom de Cortex Code CLI).
Obtenir des données web en direct via Bright Data MCP
Tous les flux de travail ne nécessitent pas le même type de données web. Les jeux de données persistants sont utiles lorsque vous analysez de manière répétée une collection définie d’informations structurées, tandis que d’autres applications d’IA nécessitent un accès à des informations en direct. Dans l’exemple des influenceurs, vous pourriez conserver le jeu de données de 1K profils pour le classement, puis utiliser MCP pour vérifier les dernières publications d’un influenceur présélectionné avant la prise de contact.
Bright Data MCP fournit la couche de données en direct complémentaire. Au lieu de stocker d’abord un jeu de données web dans Snowflake, les agents peuvent interagir avec les solutions basées sur API de Bright Data via MCP pour rechercher, scraper et interagir avec le contenu web actuel.
Cela donne à l’intégration Bright Data + Snowflake deux modèles d’ingestion de données : des jeux de données filtrés et persistants pour l’analyse répétable, et un accès web en direct pour les questions sensibles au temps.
Notez que l’application Bright Data MCP est également disponible directement via le Snowflake Marketplace :
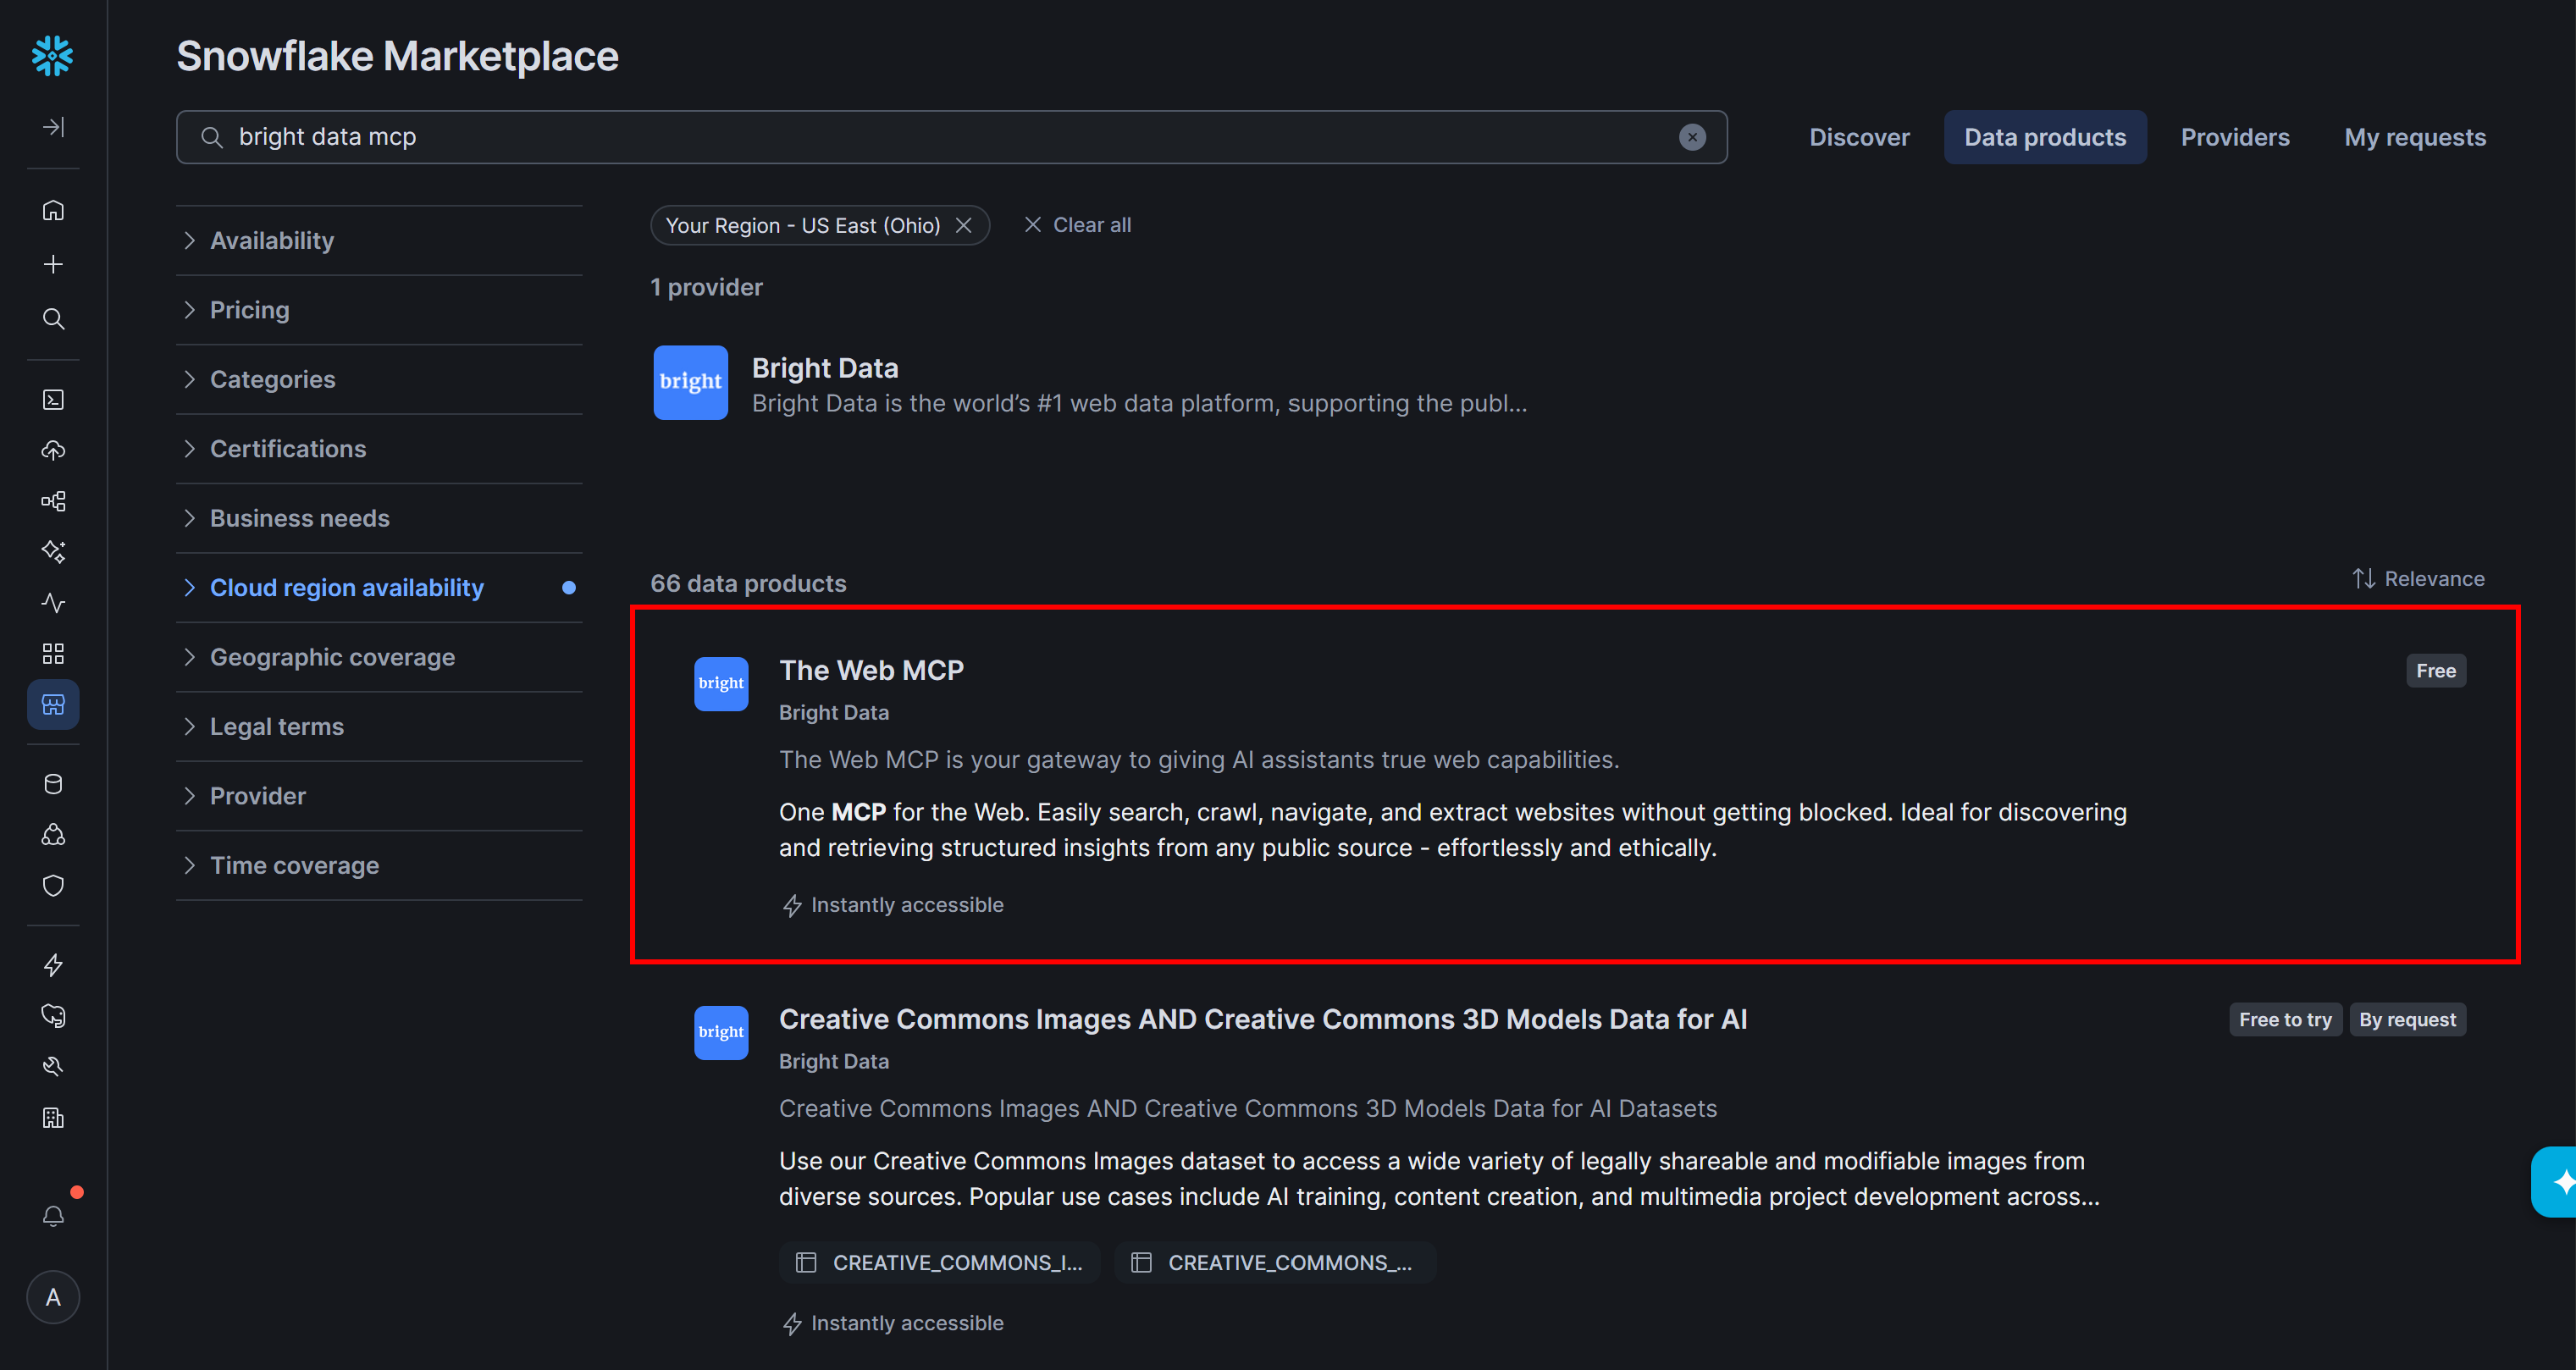
Alternativement, vous pouvez configurer le serveur MCP manuellement.
Voici quelques-uns des scénarios les plus intéressants pris en charge par Bright Data MCP :
| Cas d’usage | Capacité Bright Data MCP |
|---|---|
| Récupérer le contenu d’une page | Outils de scraping Markdown |
| S’appuyer sur les informations les plus récentes | Outils d’interrogation de moteurs de recherche + outils de scraping Markdown |
| Extraire des informations structurées | Outils d’extraction spécifiques à une plateforme |
| Interagir avec des sites web dynamiques | Automatisation du navigateur |
En bref, les jeux de données vous offrent une analyse répétable sur un instantané stocké, tandis que Bright Data MCP donne à votre agent un accès en direct au web. De nombreuses architectures matures utilisent les deux.
Connecter Bright Data avec CoCo CLI
Le Bright Data MCP et les compétences d’agent peuvent étendre les capacités basées sur Snowflake de CoCo CLI avec un accès web de niveau entreprise. Ceci est utile lorsque vous souhaitez un assistant IA capable de fusionner les opérations Snowflake avec la recherche web en temps réel, le scraping et l’automatisation du navigateur.
Pour plus d’indications, lisez notre article dédié sur Snowflake CoCo CLI avec Bright Data.
Conclusion
Dans cet article de blog, vous avez appris comment l’intégration Bright Data + Snowflake relie l’acquisition fiable de données web à l’analytique d’entreprise et à l’IA.
Bright Data fournit l’infrastructure pour récupérer des données web significatives à grande échelle, tandis que ses capacités de filtrage et de personnalisation vous permettent d’affiner ces données avant de les intégrer dans Snowflake. Cela peut aider à garder les données inutiles hors du stockage et du calcul en aval.
Une fois le jeu de données dans Snowflake, il peut être combiné avec vos données existantes et utilisé dans les charges de travail analytiques et d’IA. Pour les charges de travail qui dépendent d’informations actuelles, Bright Data MCP permet aux agents de récupérer des données web en direct au moment de l’inférence, seul ou aux côtés de jeux de données persistants dans une architecture hybride.
Ensemble, Bright Data et Snowflake offrent un chemin flexible des données web à l’intelligence prête pour l’IA : choisissez le bon modèle d’ingestion (jeux de données persistants, accès MCP en direct, ou les deux), intégrez les données dans l’environnement où résident déjà vos données d’entreprise, et activez-les avec les capacités Cortex AI telles qu’Analyst, Search et Agents.
Créez un compte Bright Data dès aujourd’hui et commencez à intégrer des données web pertinentes dans Snowflake pour une analyse alimentée par l’IA !