Les sites d’emploi ne recherchent que par mots exacts, donc le bon poste reste caché quand votre formulation ne correspond pas à l’annonce. La recherche sémantique associe sur le sens à la place. Nous la construisons de bout en bout, puis mesurons quel mode de recherche gagne plutôt que de supposer que le plus complexe l’emporte.
TL;DR
Ce guide construit un moteur de recherche d’emploi sémantique sur 200 vraies offres LinkedIn en utilisant Bright Data (Scraping web), Cohere (embeddings + rerank) et LanceDB (vector store local).
- La recherche par mots-clés correspond aux mots exacts. La recherche vectorielle correspond au sens. Une requête comme « ingénieur qui travaille sur les LLMs » trouve un poste « Développeur GenAI » que la recherche par mots-clés rate.
- L’API Web Scraper de Bright Data retourne des offres LinkedIn structurées en JSON à 0,0015 $ par enregistrement, sans analyse HTML ni maintenance de Scraper.
- LanceDB fonctionne localement et combine la recherche vectorielle avec des filtres SQL (salaire, ancienneté) en 1 requête, plus la recherche plein texte et le reranking Cohere.
- Sur 10 requêtes de test, la recherche vectorielle a obtenu 70 % de précision@3 contre 43 % pour les mots-clés. Le mode hybride + rerank n’a apporté aucune amélioration mesurable à cette échelle, donc en dessous de ~10 000 lignes, le vecteur seul est une valeur par défaut raisonnable.
- Le projet complet comprend 9 petits fichiers, dont un harnais d’évaluation, et le code complet est sur GitHub. L’exécution complète coûte ~0,34 $.
Le problème avec la recherche par mots-clés
La recherche par mots-clés sur un site d’emploi fait exactement ce que vous demandez. Elle retourne les annonces dont le titre ou la description contient les tokens littéraux de votre requête. Demandez « ingénieur qui travaille sur les LLMs et le prompt engineering » et vous raterez des postes comme « Développeur GenAI » même quand ils correspondent parfaitement. La recherche lexicale correspond aux mots exacts, pas au sens.
La recherche vectorielle correspond au sens. Chaque description de poste est convertie en embedding (un vecteur haute dimension qui capture son contenu sémantique), ainsi que votre requête. Un poste dont le vecteur est proche de celui de votre requête est une bonne correspondance en termes de sens, même quand il ne partage aucun des mêmes mots.
Transformer cela en moteur de recherche fonctionnel nécessite 3 éléments :
- Bright Data scrape 200 vraies offres d’emploi LinkedIn en JSON structuré propre.
- Cohere transforme les descriptions en embeddings et reclasse les résultats finaux.
- LanceDB stocke les embeddings localement et sert des requêtes hybrides (vecteur + plein texte) avec des filtres de style SQL.
La stack en un coup d’œil
Ce que fait chaque couche, et pourquoi nous l’utilisons :
| Couche | Outil | Pourquoi celui-ci |
|---|---|---|
| Données web | Bright Data API Web Scraper | Le Scraper LinkedIn pré-construit retourne du JSON structuré avec salaire, ancienneté et localisation, sans analyse HTML ni maintenance de Scraper. |
| Embeddings | Cohere embed-english-v3.0 |
Encodage asymétrique (types d’entrée différents pour les documents vs les requêtes). Cohere propose aussi embed-v4.0, qui est multimodal. Nous utilisons v3 ici pour son profil prix/latence en anglais uniquement (prévoir de ré-embedder avant la fin de vie de v3). |
| Reranker | Cohere rerank-v3.5 |
Nous épinglons v3.5 pour son profil prix/latence. Cohere propose aussi rerank-v4.0 (-pro pour la qualité, -fast pour la latence). |
| Vector store | LanceDB | Local, embarqué, sans serveurs. Il supporte la recherche hybride (vecteur + BM25) et les préfiltres SQL. |
| UI (optionnel) | Streamlit | Interface web à code minimal pour une application de données Python. |
Cette stack fonctionne depuis un seul venv Python sur votre ordinateur portable. Bright Data et Cohere sont les seuls services gérés impliqués.
Configuration
Le projet complet et exécutable est sur GitHub. Clonez-le et installez les dépendances (Python 3.10 ou plus récent) :
git clone https://github.com/triposat/semantic-job-search.git
cd semantic-job-search
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
Copiez le fichier env exemple et ajoutez vos deux clés API, un token Bright Data et une clé Cohere depuis dashboard.cohere.com (une clé d’essai fonctionne pour tout le guide) :
cp .env.example .env
# then edit .env with your keys:
#   BRIGHTDATA_API_TOKEN=...
#   COHERE_API_KEY=...
Les deux clés en place, exécutez python scrape.py pour récupérer les données et python index.py pour construire l’index.
Architecture
Le système comprend deux flux, pas un. L’ingestion construit l’index (exécuté une fois, ou selon un calendrier). La requête s’exécute à chaque recherche. Les deux utilisent Cohere et LanceDB, mais pour des travaux différents.
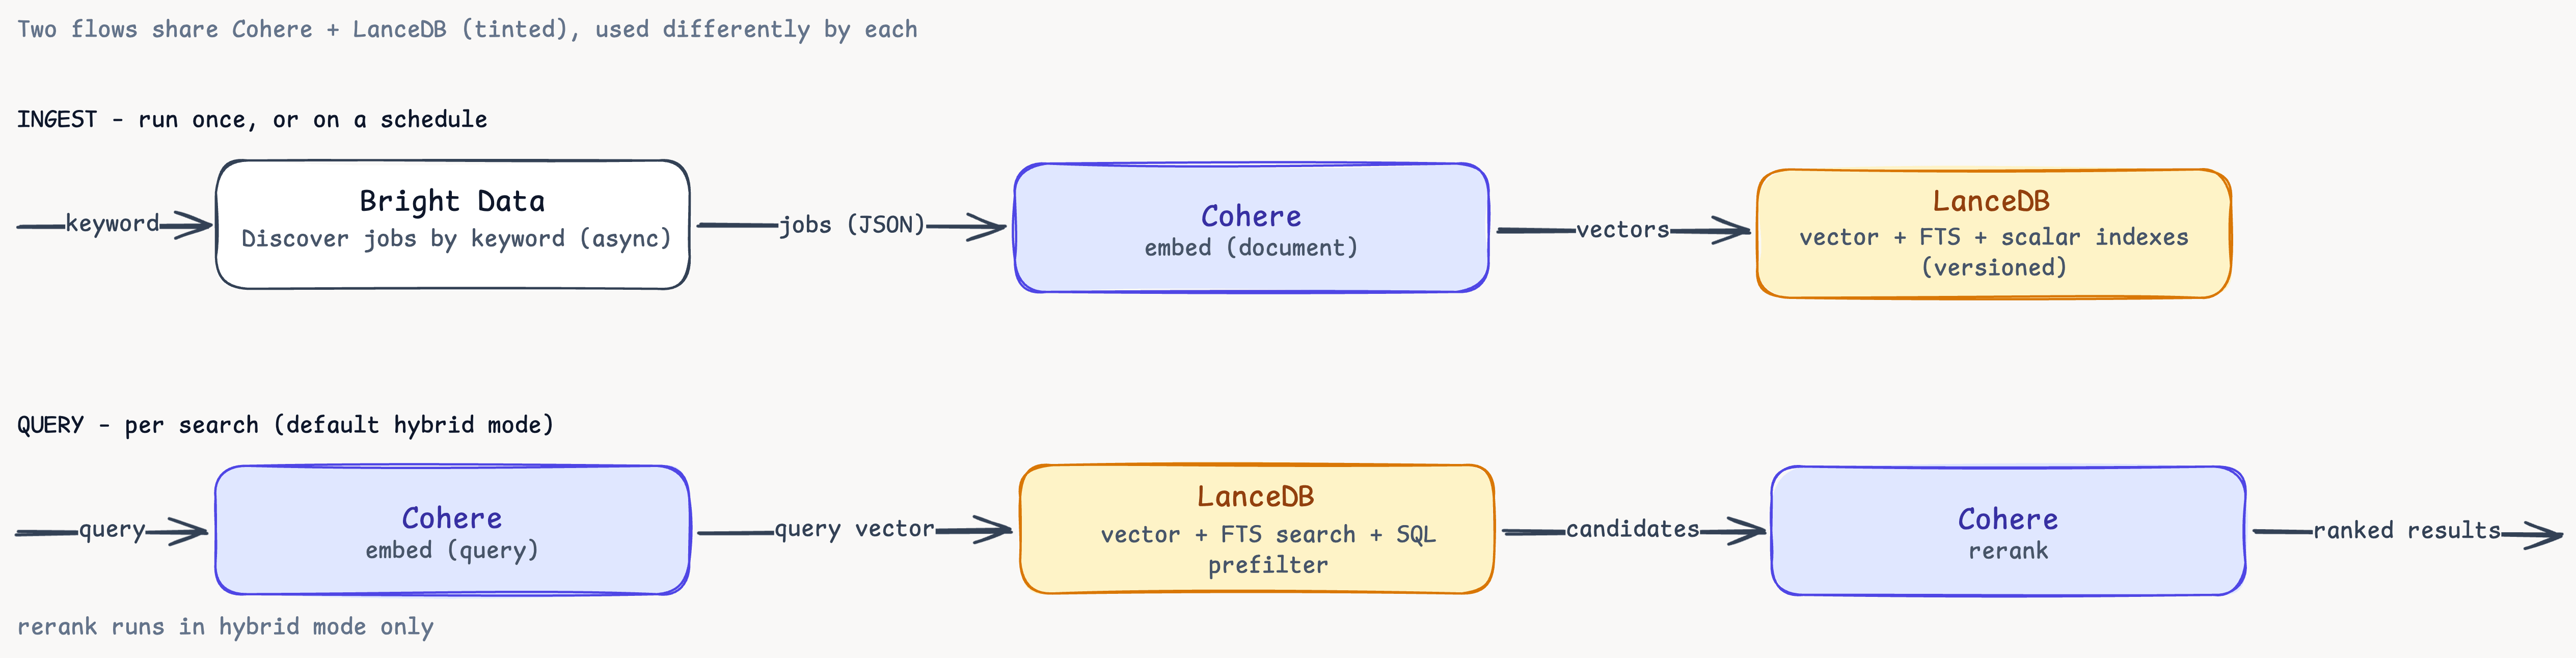
Les deux flux côte à côte. L’ingestion embed les documents et les stocke. La requête embed le texte de recherche, exécute une recherche vecteur + plein texte avec un préfiltre SQL, puis reclasse. Cohere et LanceDB apparaissent dans les deux flux mais font un travail différent dans chacun, c’est pourquoi le rerank ne touche jamais le chemin d’ingestion.
3 scripts exécutent le pipeline : scrape.py, index.py, search.py. 6 autres helpers : lib.py (backend de recherche partagé), compare.py (comparaison de modes), eval.py (précision@3), stats.py (résumé du jeu de données), versions.py (navigateur de snapshots), et app.py (UI Streamlit).
Scraper LinkedIn avec Bright Data
LinkedIn est une source majeure de données d’emploi, mais difficile à scraper de manière fiable : limites de débit, balisage dynamique et HTML qui change sans préavis. L’API Web Scraper retourne du JSON structuré propre depuis des endpoints pré-construits, donc vous ne maintenez pas de parsers.
Choisir le bon endpoint
Bright Data expose plusieurs Scrapers LinkedIn :
- Profils de personnes → profils de membres individuels
- Informations d’entreprise → pages d’entreprises
- Offres d’emploi → Collecter par URL → URLs d’emploi spécifiques que vous avez déjà
- Offres d’emploi → Découvrir par mot-clé ← c’est ce que nous voulons
- Offres d’emploi → Découvrir par URL → emplois depuis une URL de résultats de recherche
- Publications LinkedIn et Recherche de personnes → autres types d’entités
Découvrir par mot-clé est le bon choix car nous voulons une découverte d’emplois en masse depuis une requête de recherche. Un seul appel API retourne jusqu’à 1 000 offres d’emploi structurées par mot-clé, incluant titre, entreprise, localisation, niveau d’ancienneté, type d’emploi, fourchette salariale si indiquée, et la description complète du poste.
Chaque Scraper a son propre dataset_id. Pour en trouver un, ouvrez la Bibliothèque de Scrapers de Bright Data, recherchez le site (ici, linkedin.com), et ouvrez-le. Choisissez l’endpoint Offres d’emploi → Découvrir par mot-clé, et son dataset_id (gd_lpfll7v5hcqtkxl6l) ainsi qu’une requête prête à exécuter apparaissent dans le panneau Exemples de code. Un token valide est tout ce dont scrape.py a besoin pour l’appeler.
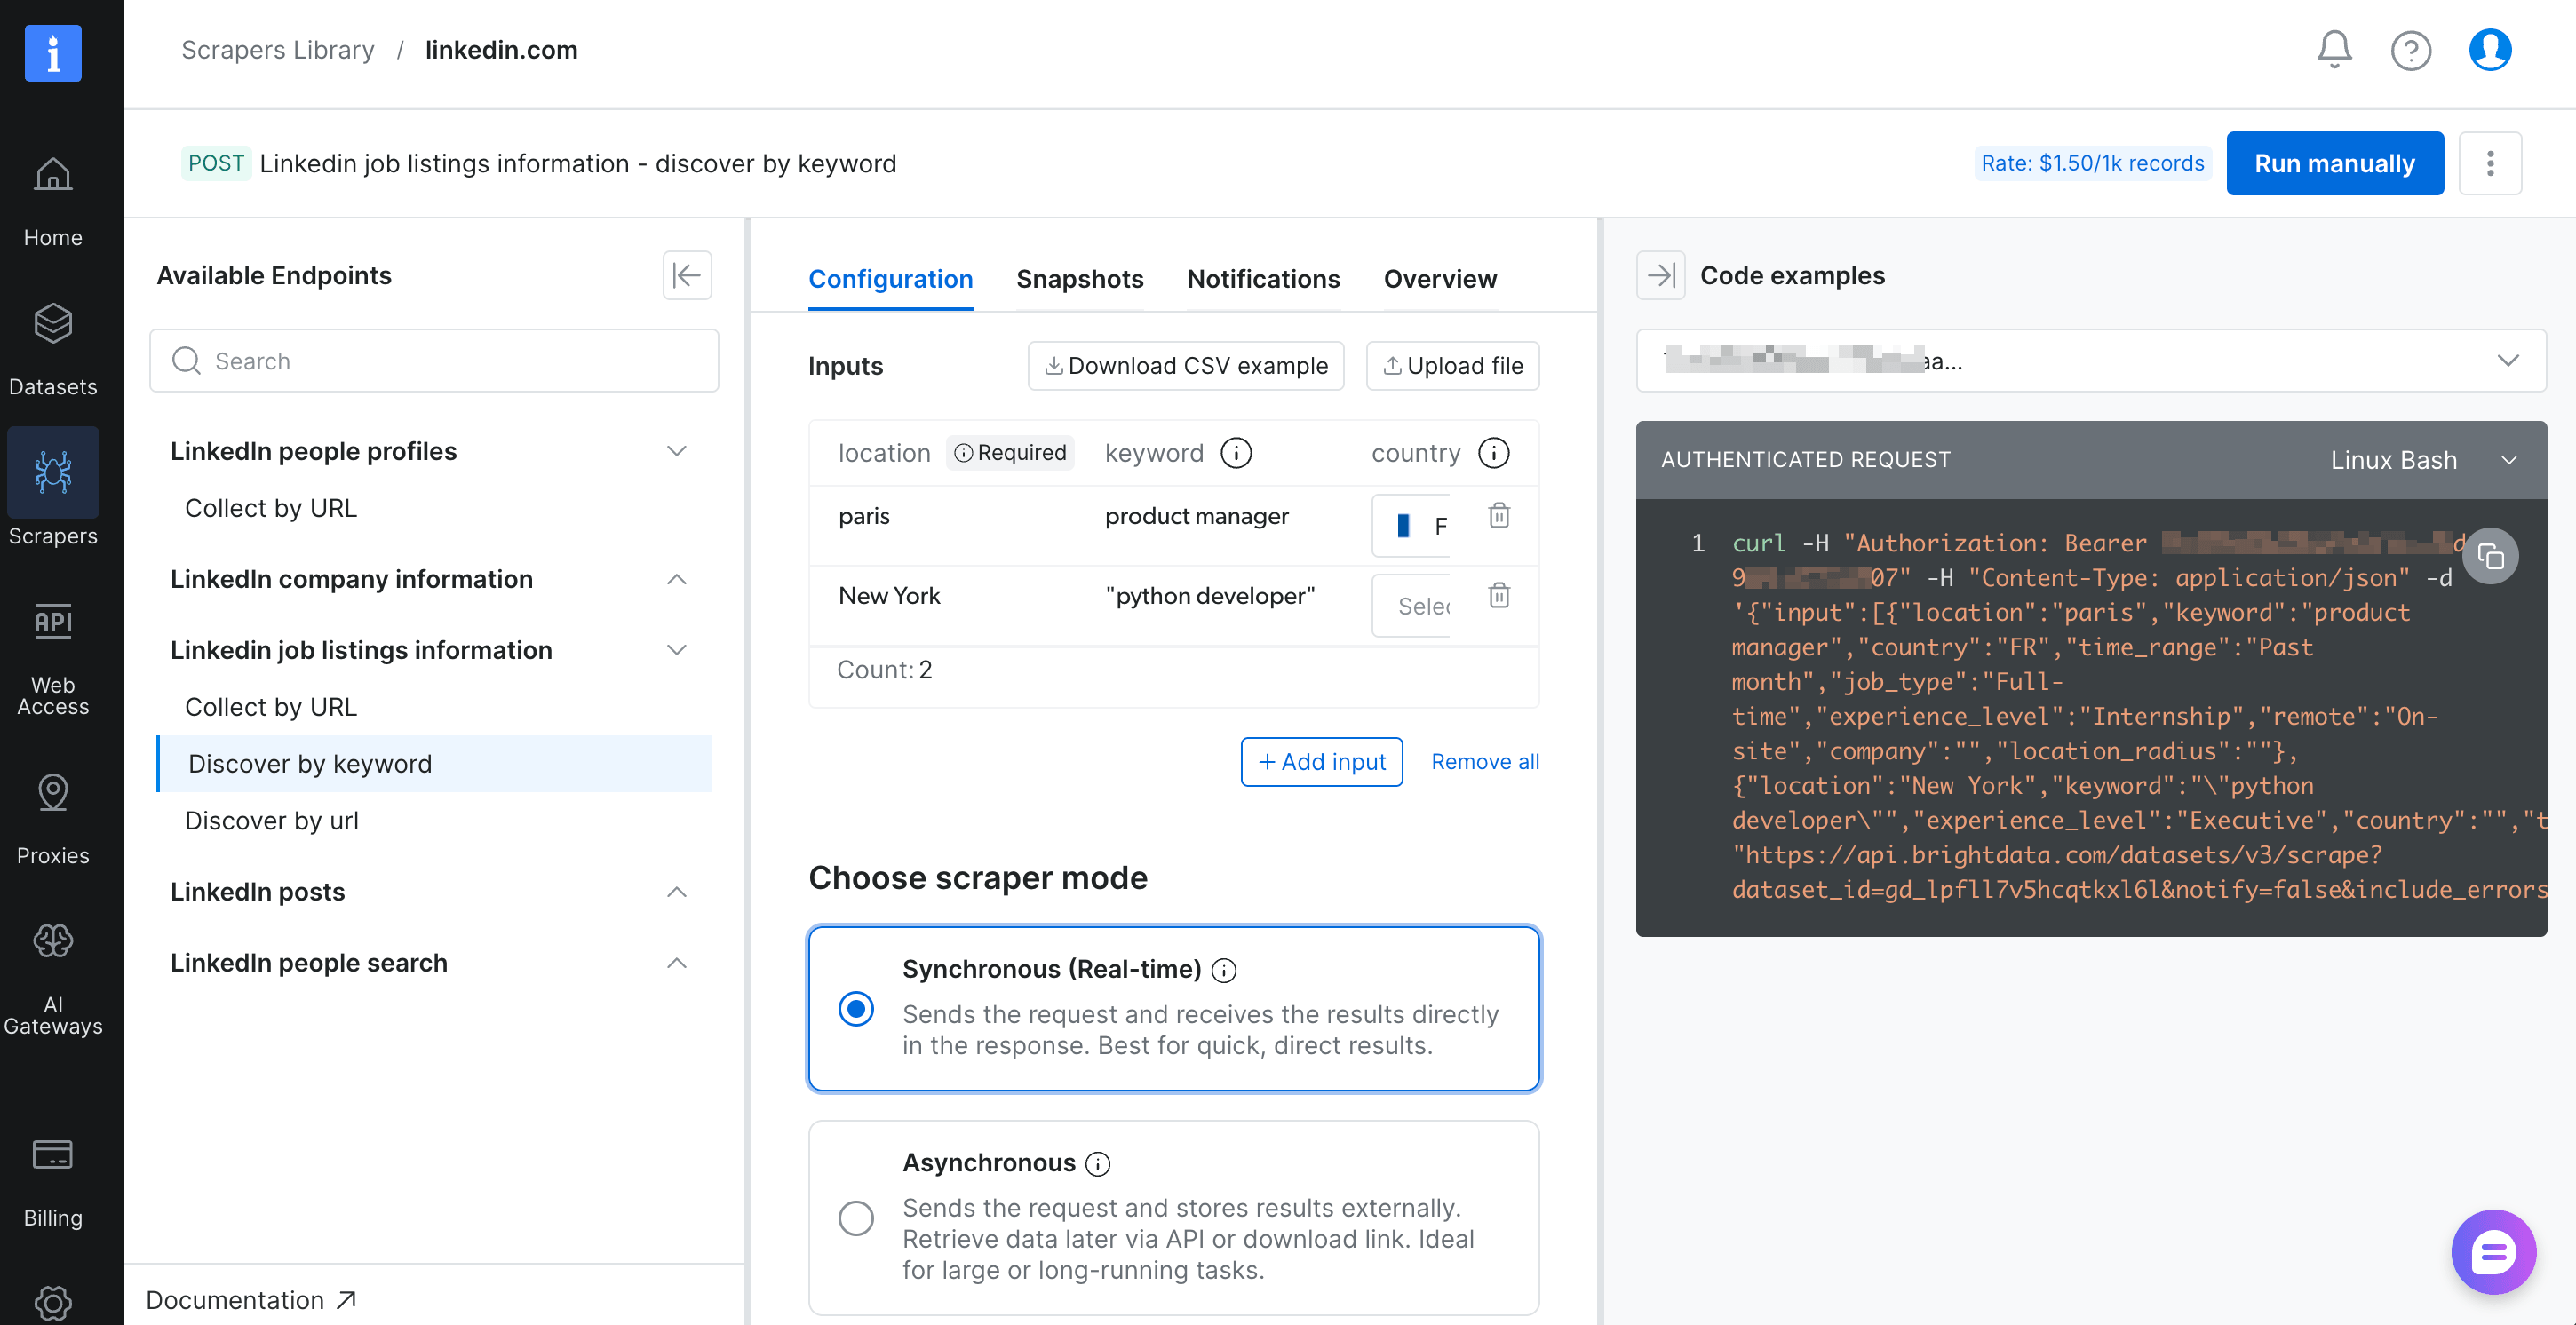
La page du Scraper ‘Découvrir par mot-clé’. Le panneau Exemples de code à droite est là où vous trouverez le dataset_id.
Synchrone vs asynchrone
Bright Data propose 2 modes de livraison :
- Synchrone (
POST /datasets/v3/scrape) retourne les données en ligne, idéal pour les petits lots. - Asynchrone (
POST /datasets/v3/trigger) retourne un ID de snapshot. Vous interrogez jusqu’à la complétion et téléchargez le résultat, idéal pour tout ce qui est plus grand.
Dans nos exécutions, le temps de réponse était en moyenne de ~6 secondes par entrée. Pour 2 mots-clés avec limit_per_input=100 (200 emplois au total), un appel synchrone doit maintenir la connexion ouverte pour tout le lot, ce qui risque d’expirer. L’asynchrone est la valeur par défaut sûre.
Contrôler le coût avec des limites par entrée
Le paramètre de requête limit_per_input=N plafonne le nombre de résultats que chaque recherche d’entrée retourne, ce qui est exactement le levier que vous voulez pour une dépense prévisible :
2 keywords × 100 jobs × $0.0015 = $0.30 per runAugmentez-le pour des exécutions plus grandes, jusqu’à 1 000 emplois par mot-clé.
Le code
Le Scraper déclenche un snapshot, interroge jusqu’à ce qu’il soit prêt, et télécharge le JSON. L’essentiel est ci-dessous (une version de production ajouterait des tentatives/backoff et une gestion d’erreurs plus riche) :
# scrape.py
import json, time, sys
from pathlib import Path
import requests
from lib import require_env

BD_TOKEN = require_env("BRIGHTDATA_API_TOKEN")
DATASET_ID = "gd_lpfll7v5hcqtkxl6l"  # LinkedIn jobs - discover by keyword
LIMIT_PER_INPUT = 100

SEARCHES = [
    {"location": "San Francisco", "keyword": "machine learning engineer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
    {"location": "New York", "keyword": "python developer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
]

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {BD_TOKEN}", "Content-Type": "application/json"}

def trigger_snapshot() -> str:
    r = requests.post(f"{API}/trigger", headers=HEADERS, json={"input": SEARCHES},
        params={"dataset_id": DATASET_ID, "type": "discover_new",
                "discover_by": "keyword", "include_errors": "true",
                "limit_per_input": str(LIMIT_PER_INPUT)})
    r.raise_for_status()
    return r.json()["snapshot_id"]

def wait_until_ready(snapshot_id: str) -> None:
    while True:
        status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS).json()["status"]
        if status == "ready": return
        if status == "failed": raise RuntimeError("snapshot failed")
        time.sleep(10)

def download(snapshot_id: str) -> list[dict]:
    return requests.get(f"{API}/snapshot/{snapshot_id}",
                        headers=HEADERS, params={"format": "json"}).json()
Exécution :
$ python scrape.py
→ scraping 2 keyword searches, max 100 jobs each
  estimated max cost: $0.30 (at $0.0015/record × 200 max records)
  triggered snapshot: sd_mojicp6g39xwbwqn2
  status: ready
✓ saved 204 jobs → data/raw_jobs.json
  actual cost: $0.31
Ce que vous obtenez en retour
Chaque emploi dans le JSON possède plus de 25 champs. Voici ceux qui comptent :
{
  "job_posting_id": "<id>",
  "job_title": "Associate Machine Learning Engineer",
  "company_name": "ExampleCo",
  "job_location": "San Francisco, CA",
  "job_seniority_level": "Entry level",
  "job_employment_type": "Full-time",
  "job_industries": "Software Development",
  "job_summary": "About ExampleCo. ExampleCo is the career network for the AI economy...",
  "base_salary": {
    "min_amount": 115000,
    "max_amount": 144000,
    "currency": "$",
    "payment_period": "yr"
  },
  "job_posted_date": "2026-04-25T03:41:21.072Z",
  "url": "https://www.linkedin.com/jobs/view/<id>"
}
Le champ structuré base_salary est ce qui rend possibles les requêtes de filtre par salaire à l’étape suivante.
Indexer avec Cohere et LanceDB
Nous avons 204 enregistrements d’emplois bruts, dont 4 lignes d’erreur que nous filtrons au chargement. Maintenant nous rendons les 200 restants sémantiquement consultables.
Pourquoi Cohere
Nous avons choisi Cohere plutôt que les alternatives (modèles d’embedding d’OpenAI, Voyage AI, ou sentence-transformers locaux) :
- Encodage asymétrique. Cohere vous permet de taguer l’entrée comme
search_documentlors de l’indexation ousearch_querylors de la recherche. Le modèle encode chaque côté différemment, ce qui fonctionne mieux que de traiter les deux de la même façon. - Embedding déclaratif. Le registre de LanceDB supporte Cohere nativement (comme OpenAI et sentence-transformers), donc l’embedding se produit à l’insertion et à la requête sans appels manuels à
embed(). - L’API Rerank. C’est un modèle séparé qui prend une requête et une liste de candidats et réordonne les candidats par pertinence réelle. C’est la deuxième étape qui peut affiner le classement d’un pipeline hybride, et nous ajoutons cette étape avec un seul appel
.rerank().
Le registre d’embedding LanceDB
Les embeddings dans LanceDB passent par son registre d’embedding. Vous déclarez votre schéma une fois, et les embeddings se produisent automatiquement à chaque insertion et chaque requête, chacun avec le bon input_type.
# index.py
import lancedb
from lancedb.embeddings import get_registry
from lancedb.pydantic import LanceModel, Vector

cohere = get_registry().get("cohere").create(
    name="embed-english-v3.0",
    api_key=COHERE_API_KEY,
)

class Job(LanceModel):
    text: str = cohere.SourceField()              # ← quoi embedder
    vector: Vector(cohere.ndims()) = cohere.VectorField()  # ← embedding stocké
    job_id: str
    title: str
    company: str
    location: str
    country_code: str
    seniority: str
    employment_type: str
    job_function: str
    industry: str
    posted_date: str
    apply_url: str
    search_keyword: str
    salary_min_annual: float
    salary_max_annual: float
    salary_currency: str
    salary_display: str
    description_snippet: str
Tout ce qui suit vector est une colonne stockée ordinaire, utilisée pour le filtrage et l’affichage.
L’astuce de normalisation des salaires
La plupart des emplois ont des salaires exprimés par an, mais quelques-uns sont par heure. Pour que salary_min_annual >= 200000 fonctionne de manière cohérente, nous normalisons à l’ingestion :
HOURS_PER_YEAR = 2080

def _normalize_salary(base):
    if not base:
        return 0.0, 0.0, "", ""
    lo = float(base.get("min_amount") or 0)
    hi = float(base.get("max_amount") or 0)
    if (base.get("payment_period") or "").lower() == "hr":
        lo *= HOURS_PER_YEAR
        hi *= HOURS_PER_YEAR
    currency = base.get("currency") or ""
    display = f"{currency}{int(lo):,}–{currency}{int(hi):,}/yr" if (lo and hi) else ""
    return lo, hi, currency, display
Nous stockons à la fois les valeurs numériques brutes (pour les filtres) et une chaîne d’affichage lisible par l’homme (pour l’UI).
Mises à jour incrémentielles avec des upserts
La première fois que index.py s’exécute, il crée la table. Chaque exécution suivante est un upsert basé sur job_id :
result = (
    table.merge_insert("job_id")
         .when_matched_update_all()       # actualiser les offres d'emploi existantes
         .when_not_matched_insert_all()   # ajouter les nouvelles découvertes
         .execute(rows)
)
print(f"inserted={result.num_inserted_rows}, updated={result.num_updated_rows}")
Les nouvelles offres d’emploi d’un nouveau scrape Bright Data sont insérées, et les offres re-publiées (même job_id) ont leurs salaires, descriptions et horodatages actualisés. Pour supprimer entièrement les offres obsolètes, chaînez .when_not_matched_by_source_delete().
L’upsert entier est une transaction atomique unique. Parce que Lance stocke les données de manière colonnaire avec copie sur écriture, la ré-ingestion est une écriture incrémentielle plutôt qu’une reconstruction complète de la table.
Index scalaires pour des filtres SQL rapides
Quand search.py, where "salary_min_annual >= 200000" s’exécute, LanceDB applique le filtre avant le scan vectoriel (prefilter=True). À 200 lignes c’est instantané dans tous les cas. À 200 000 lignes, le filtre parcourrait toute la colonne à moins que nous ne disions à LanceDB comment l’indexer :
table.create_scalar_index("salary_min_annual", index_type="BTREE",  replace=True)
table.create_scalar_index("seniority",         index_type="BITMAP", replace=True)
table.create_scalar_index("search_keyword",    index_type="BITMAP", replace=True)
table.create_scalar_index("employment_type",   index_type="BITMAP", replace=True)
2 types d’index couvrent ce dont nous avons besoin :
- BTREE pour les colonnes triables à cardinalité élevée.
salary_min_annualen bénéficie car nous voulons des requêtes de plage (>=,BETWEEN). - BITMAP pour les enums à faible cardinalité.
senioritya ~6 valeurs distinctes,employment_typeest presque entièrementFull-time, etsearch_keywordest l’un de nos 2 mots-clés de scrape. Chaque valeur distincte obtient son propre bitmap. Un filtre=devient un simple AND bit à bit.
Les deux s’exécutent avec replace=True, donc ré-exécuter index.py les reconstruit de manière idempotente. Après l’appel, table.list_indices() rapporte les 5 (les 4 scalaires + l’index FTS) :
text_idx               type=FTS      columns=['text']
salary_min_annual_idx  type=BTree    columns=['salary_min_annual']
seniority_idx          type=Bitmap   columns=['seniority']
search_keyword_idx     type=Bitmap   columns=['search_keyword']
employment_type_idx    type=Bitmap   columns=['employment_type']
Inspecter les données indexées
Après avoir exécuté python index.py, notre script compagnon stats.py résume ce qui se trouve dans la base de données :
$ python stats.py

📊 LanceDB · table 'jobs'  ·  200 rows

by source keyword
  machine learning engineer  ████████████████████ 100
  python developer           ████████████████████ 100

by seniority
  Mid-Senior level  ████████████████████ 99
  Entry level       ████████████ 62
  Not Applicable    ████ 20
  Internship        ██ 14
  Associate          4
  Director           1

salary coverage: 43/200 jobs (22%)
  min  $   65,000
  med  $  150,000
  max  $1,000,000

  highest-paying jobs:
    • Quantitative Developer (Python)                  Fintal Partners       $400,000–$1,000,000/yr
    • Machine Learning Engineer                        Mercor                $130,000–$500,000/yr
    • Data Scientist                                   Triumph               $200,000–$400,000/yr
    • Senior Python Developer (Middle Office Tech)     Quantitative Systems  $200,000–$400,000/yr
    • ML Engineer (Infra & Distributed training)       techire ai            $250,000–$400,000/yr

top hiring companies (top 10)
  Turing          ████████████████████ 7
  Handshake       █████████████████ 6
  OpenAI          █████████████████ 6
  Meta            █████████████████ 6
  Jack & Jill     ██████████████ 5
  DataAnnotation  ██████████████ 5
  Catalyst Labs   ███████████ 4
  Notion          ███████████ 4
  LangChain       ███████████ 4
  Uber            ████████ 3
Exécuter la recherche hybride avec reranking
LanceDB supporte 3 modes de recherche, et notre lib.py expose les 3 derrière une seule fonction :
# lib.py
from lancedb.rerankers import CohereReranker

reranker = CohereReranker(model_name="rerank-v3.5")  # épinglé ; le modèle plus récent de Cohere est rerank-v4.0

def search(query: str, mode: str = "hybrid", limit: int = 10, where: str | None = None):
    table = _table()
    if mode == "vector":
        q = table.search(query, query_type="vector")
    elif mode == "keyword":
        q = table.search(query, query_type="fts")
    elif mode == "hybrid":
        q = table.search(query, query_type="hybrid").rerank(reranker=reranker)
    if where:
        q = q.where(where, prefilter=True)
    return q.limit(limit).to_pandas()
Trois éléments de search() méritent une explication :
query_type="hybrid"combine la similarité vectorielle et les scores BM25 de l’index plein texte que nous avons construit au moment de l’indexation (FTS natif de LanceDB). L’union des candidats est ensuite reclassée..rerank(reranker)envoie la liste de candidats à l’API Rerank de Cohere et retourne son classement. Nous passons explicitementmodel_name="rerank-v3.5"car le défaut LanceDB est plus ancien.prefilter=Trueapplique la clause SQLWHEREavant le scan vectoriel, pas après. C’est plus rapide (espace de recherche plus petit) et plus précis (vous ne perdez pas de résultats par troncature).
Une vraie requête
Voici les 2 meilleurs résultats pour une requête qui ne partage pas beaucoup de mots littéraux avec un titre de poste dans le jeu de données :
$ python search.py "deep learning model training with GPUs"

  ▸ Training: ML Framework Engineer  ·  score 0.275
    OpenAI — San Francisco, CA
    Entry level · Full-time · 2026-04-22
    "About The Team Training Runtime designs the core distributed
     machine-learning training runtime that powers everything from early
     research experiments to frontier-scale model runs..."

  ▸ Machine Learning Engineer  ·  score 0.138
    Skild AI — San Mateo, CA
    Entry level · Full-time · 2026-04-15
    "Company Overview At Skild AI, we are building the world's first
     general purpose robotic intelligence that is robust and adapts to
     unseen scenarios without failing. We believe massive scale through
     data-driven machine learning..."
Aucun titre de poste ne contient « GPUs », mais les deux descriptions parlent d’entraînement ML distribué, ce qui est ce que la requête demande. La recherche par mots-clés purs raterait probablement les deux.
Chaque mode retourne un type de score différent. Le mode vectoriel retourne la distance cosinus (plus bas = plus proche), hybride+rerank retourne le score de pertinence de Cohere (0 à 1, plus haut = meilleur), et le mode par mots-clés retourne le BM25 brut (non borné, plus haut = plus de chevauchement de mots-clés). Les chiffres ne sont pas comparables entre les modes, seulement au sein d’un seul mode.
Combiner la sémantique avec des contraintes strictes
La similarité sémantique et les filtres SQL se combinent en une seule requête dans LanceDB :
$ python search.py "fintech python role with equity" \
    --where "salary_min_annual >= 250000"

  ▸ Quantitative Developer (Python)  ·  score 0.374
    Fintal Partners — New York, United States
    Mid-Senior level · Full-time · $400,000–$1,000,000/yr · 2026-04-22

  ▸ Senior Software Engineer (Python)  ·  score 0.272
    Fintal Partners — New York, NY
    Mid-Senior level · Full-time · $250,000–$400,000/yr · 2026-04-23
La partie vectorielle correspond à la partie descriptive (« fintech python avec equity »). Le filtre SQL applique la contrainte numérique (>= 250 000 $). Les deux résultats sont des postes Fintal Partners dans la bonne fourchette salariale.
Le même pattern hybride + filtre s’exécute dans l’UI Streamlit, sur un scrape ultérieur (les annonces en direct diffèrent de l’exécution CLI ci-dessus) :
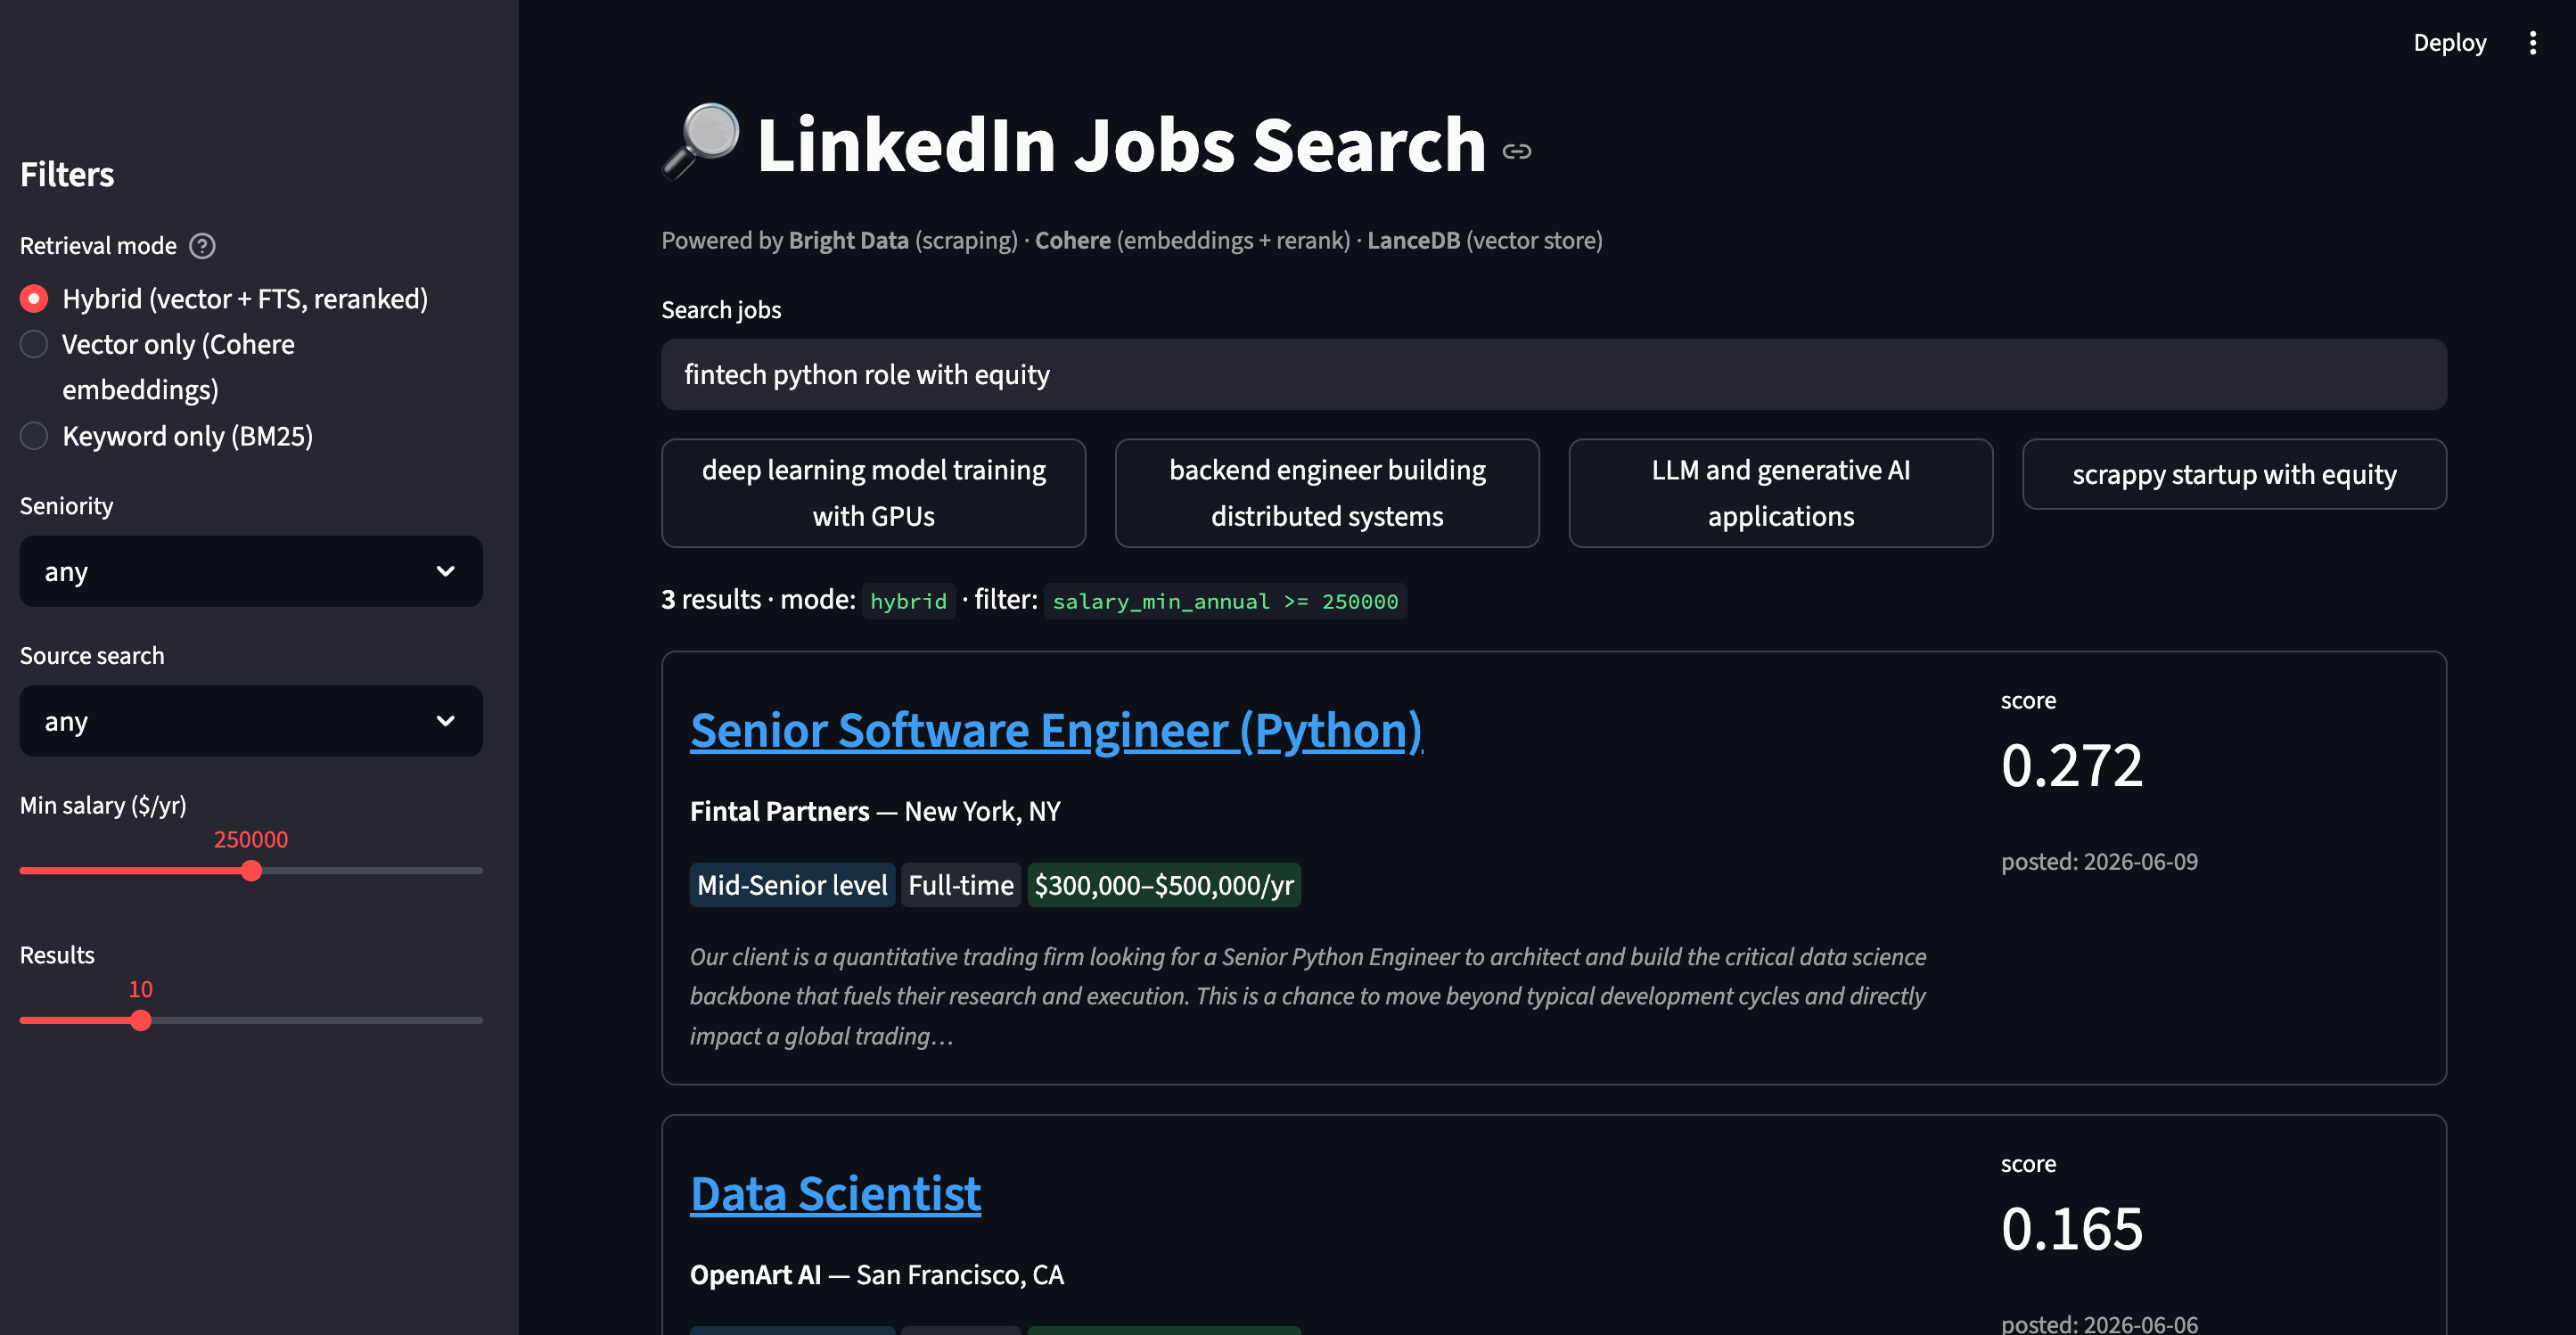 L’application Streamlit exécutant une recherche hybride. Le curseur de salaire produit le préfiltre
salary_min_annual >= 250000 affiché dans la bannière de filtre vert sur noir.
Où les mots-clés, le vecteur et le mode hybride divergent
compare.py exécute la même requête à travers les 3 modes et imprime un rapport côte à côte :
$ python compare.py "engineer working on LLMs and prompt engineering" --top 3

══════════════════════════════════════════════════════════════════════════
  query: engineer working on LLMs and prompt engineering
══════════════════════════════════════════════════════════════════════════

  ── keyword (BM25) ───────────────────────────────────────────────────────
  1. AI/ML Engineer                                          — Careerswift
  2. AI/ML Engineer                                          — Careerswift
  3. Applied AI Engineer                                     — Serval

  ── vector (Cohere) ──────────────────────────────────────────────────────
  1. Senior Software Engineer (Prompt Engineer Python/GenAI)        — Genpact
  2. 15+ Years exp/ Need f2f/ AI/ML Engineer or Python AI Engi...   — Jobs via Dice
  3. ML Engineer (Infra & Distributed training)                     — techire ai

  ── hybrid + rerank ──────────────────────────────────────────────────────
  1. Applied AI Engineer                                     — Serval
  2. Senior Software Engineer (Prompt Engineer Python/GenAI) — Genpact
  3. AI/ML Engineer                                          — Careerswift

  overlap: keyword∩vector=0/3 · hybrid∩vector=1/3 · hybrid∩keyword=2/3
Dans la ligne de chevauchement, les mots-clés et le vecteur ont trouvé 0 des mêmes emplois dans le top 3. Ils cherchent dans des espaces conceptuels différents.
- Les mots-clés (BM25) trouvent les annonces où les tokens littéraux « LLMs » et « prompt » apparaissent le plus fréquemment. Il retourne des titres IA/ML génériques.
- Le vecteur (Cohere) trouve l’annonce Senior Software Engineer (Prompt Engineer Python/GenAI) en #1, même si la requête utilisateur disait « prompt engineering » (gérondif) et le titre dit « Prompt Engineer » (nom). Il retourne aussi une annonce axée LLM de Jobs via Dice qui est une forte correspondance sémantique mais lexicalement éloignée de la requête.
- Hybride + rerank prend l’union, déduplique, et l’exécute à travers Cohere Rerank. Le poste Applied AI Engineer de Serval (200 k$ à 325 k$) passe en #1. Sa description est dense en travail de prompt engineering et d’agents LLM, mais ni son titre ni ses termes BM25 les mieux pondérés n’auraient classé le poste aussi haut.
Pour cette requête spécifique, le vecteur et le mode hybride ont tous deux fait mieux que les mots-clés. Le chevauchement brut de tokens a classé les résultats Genpact et Serval en dessous de ce que leur pertinence sémantique leur attribuait. Mais une seule requête est une anecdote, pas une preuve. Si ce pattern se maintient en général est une question à laquelle seule une vraie évaluation peut répondre.
Mesurer la qualité avec précision@3
Pour mesurer cela correctement, eval.py évalue 10 requêtes écrites à la main contre les 3 modes et calcule la précision@3, la fraction des 3 meilleurs résultats qui correspondent à un prédicat de vérité terrain transparent.
La vérité terrain pour chaque requête est un prédicat Python, pas un nombre magique, donc un lecteur peut décider s’il noterait les résultats de la même façon.
Pour « machine learning engineer chez OpenAI », un résultat compte comme pertinent uniquement si son champ company contient « OpenAI ». Pour « développeur quantitatif dans une société de trading », la règle est plus large. Un résultat compte si le titre contient « Quant » ou « Trading », ou si l’entreprise est une société de trading connue (Fintal Partners, DRW, Hudson River Trading, Tower Research, Mondrian Alpha). Ces prédicats sont calibrés sur le jeu de données exemple, donc vos scores évolueront sur de nouveaux emplois. Recalibrez-les sur vos propres données. L’écart entre les modes persiste même quand les pourcentages exacts ne le font pas.
Exécution :
$ python eval.py

precision@3 per query (hits/3)
────────────────────────────────────────────────────────────────────────
  query                                          keyword    vector     hybrid
────────────────────────────────────────────────────────────────────────
  machine learning engineer at OpenAI            1.00 (3/3)  1.00 (3/3)  1.00 (3/3)
  founding engineer at AI startup with equity    0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  prompt engineer working with LLMs              0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  quantitative developer at trading firm         0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  computer vision and robotics engineer          1.00 (3/3)  0.67 (2/3)  1.00 (3/3)
  data scientist role                            0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  distributed training infrastructure for ML     0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  backend engineer at AI company                 0.33 (1/3)  0.33 (1/3)  0.33 (1/3)
  python developer at fintech                    0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  high-paying machine learning role with equity  0.00 (0/3)  0.33 (1/3)  0.33 (1/3)
────────────────────────────────────────────────────────────────────────
  AVERAGE (10 queries)                           0.433       0.700       0.667
Les mêmes chiffres sous forme de graphique :
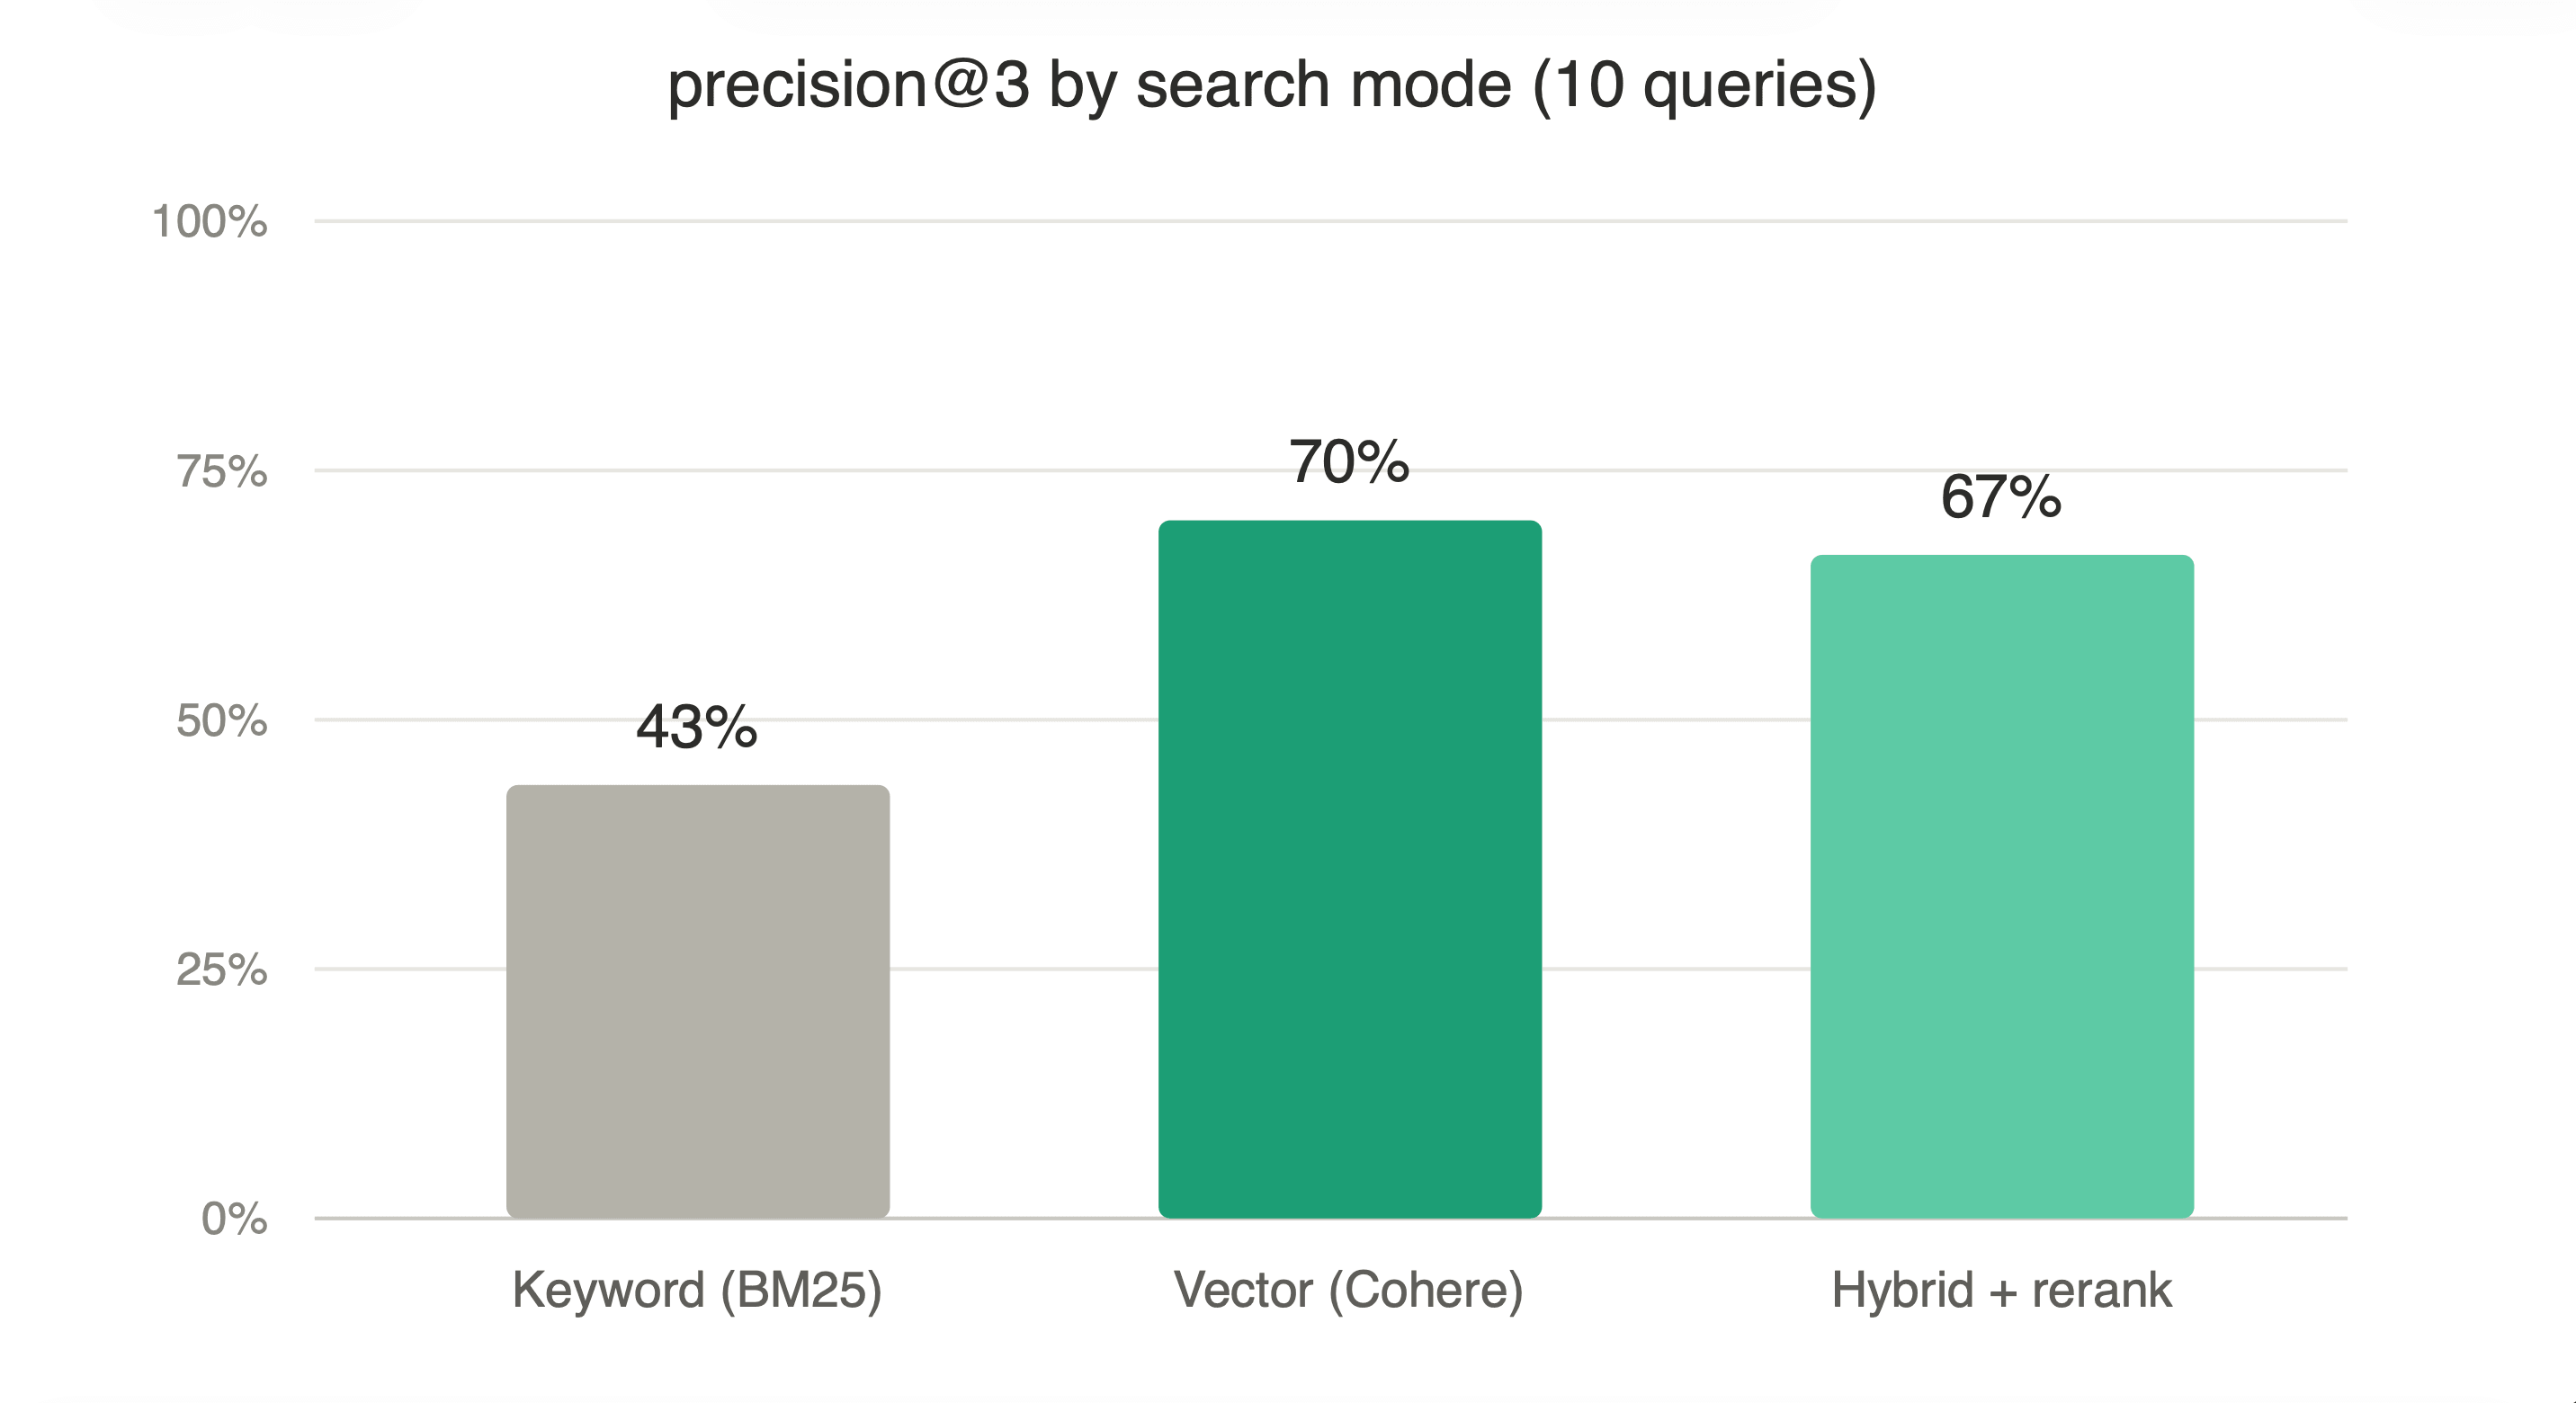
Précision@3 moyennée sur les 10 requêtes d’évaluation. Le vecteur score bien au-dessus des mots-clés, et le mode hybride est à quelques points du vecteur.
Ce que disent les chiffres
D’après le tableau :
- La recherche vectorielle a scoré bien au-dessus de la recherche par mots-clés avec 70 % contre 43 % de précision@3 moyenne. Les 3 requêtes où les mots-clés ont scoré 0 (« prompt engineer », « développeur python en fintech », « ML bien rémunéré avec equity ») avaient au moins 1 résultat pertinent avec le vecteur.
- Hybride + rerank n’a pas battu le vecteur à cette échelle. L’écart de 67 % contre 70 % est dans le bruit : le reranker ajoute un appel Cohere par requête, et la partie FTS lui fournit des quasi-correspondances lexicales qu’il doit ensuite filtrer.
- Aucun mode n’est strictement dominé. « Vision par ordinateur et ingénierie robotique » est la seule requête où les mots-clés (1,00) score au-dessus du vecteur (0,67), car les entreprises pertinentes contiennent toutes des termes robotiques littéraux dans leurs descriptions.
Quand activer hybride + rerank
Cela dépend de plusieurs facteurs :
- Taille du pool de candidats. Avec quelques centaines de lignes, le vecteur seul est généralement suffisant. La récupération en 2 étapes du mode hybride nécessite un pool plus grand (10 000+) avant que l’étape de rerank vaille son coût.
- Type de requête. Les requêtes avec à la fois une intention sémantique et des mots-clés distinctifs (un nom de marque, une technologie spécifique) bénéficient du mode hybride. Les requêtes purement sémantiques généralement non.
- Qualité du reranker. Le rerank-v3.5 de Cohere a bien performé dans notre évaluation. Si vous remplacez par un reranker différent, ré-exécutez
eval.pyavant de lui faire confiance, car un reranker plus faible peut réordonner les bons résultats vectoriels vers le bas sur un petit pool de candidats.
Exécutez eval.py sur vos propres données pour décider. Ajouter une requête est une chaîne plus un prédicat de vérité terrain.
Note : l’évaluation hybride s’exécute bien avec une clé Cohere gratuite. La limite de débit d’essai la fait reculer et se terminer en ~90s au lieu de ~15s.
Ajouter une interface web avec Streamlit
Streamlit transforme le même backend de recherche en une application web cliquable. Le cœur de recherche et rendu est ci-dessous :
# app.py
import streamlit as st
from lib import search

mode = st.sidebar.radio("Mode", ["hybrid", "vector", "keyword"])
seniority = st.sidebar.selectbox("Seniority", ["any", "Entry level", "Associate", "Mid-Senior level", "Director", "Internship", "Not Applicable"])
min_salary = st.sidebar.slider("Min salary ($/yr)", 0, 500_000, 0, step=10_000)

query = st.text_input("Search jobs", placeholder="e.g. remote ML engineer...")

if query:
    where_clauses = []
    if seniority != "any":
        where_clauses.append(f"seniority = '{seniority}'")
    if min_salary > 0:
        where_clauses.append(f"salary_min_annual >= {min_salary}")
    where = " AND ".join(where_clauses) or None

    df = search(query, mode=mode, where=where, limit=10)
    for _, row in df.iterrows():
        with st.container(border=True):
            st.markdown(f"### [{row['title']}]({row['apply_url']})")
            st.markdown(f"**{row['company']}** — {row['location']}")
            st.caption(row["description_snippet"] + "…")
Exécutez-le :
streamlit run app.pyVous obtenez une page de recherche complète sur localhost:8501 avec une boîte de recherche, un toggle de mode, des filtres de barre latérale pour l’ancienneté, le mot-clé source et le salaire, plus des cartes de résultats avec des badges, des scores et des aperçus d’extraits.
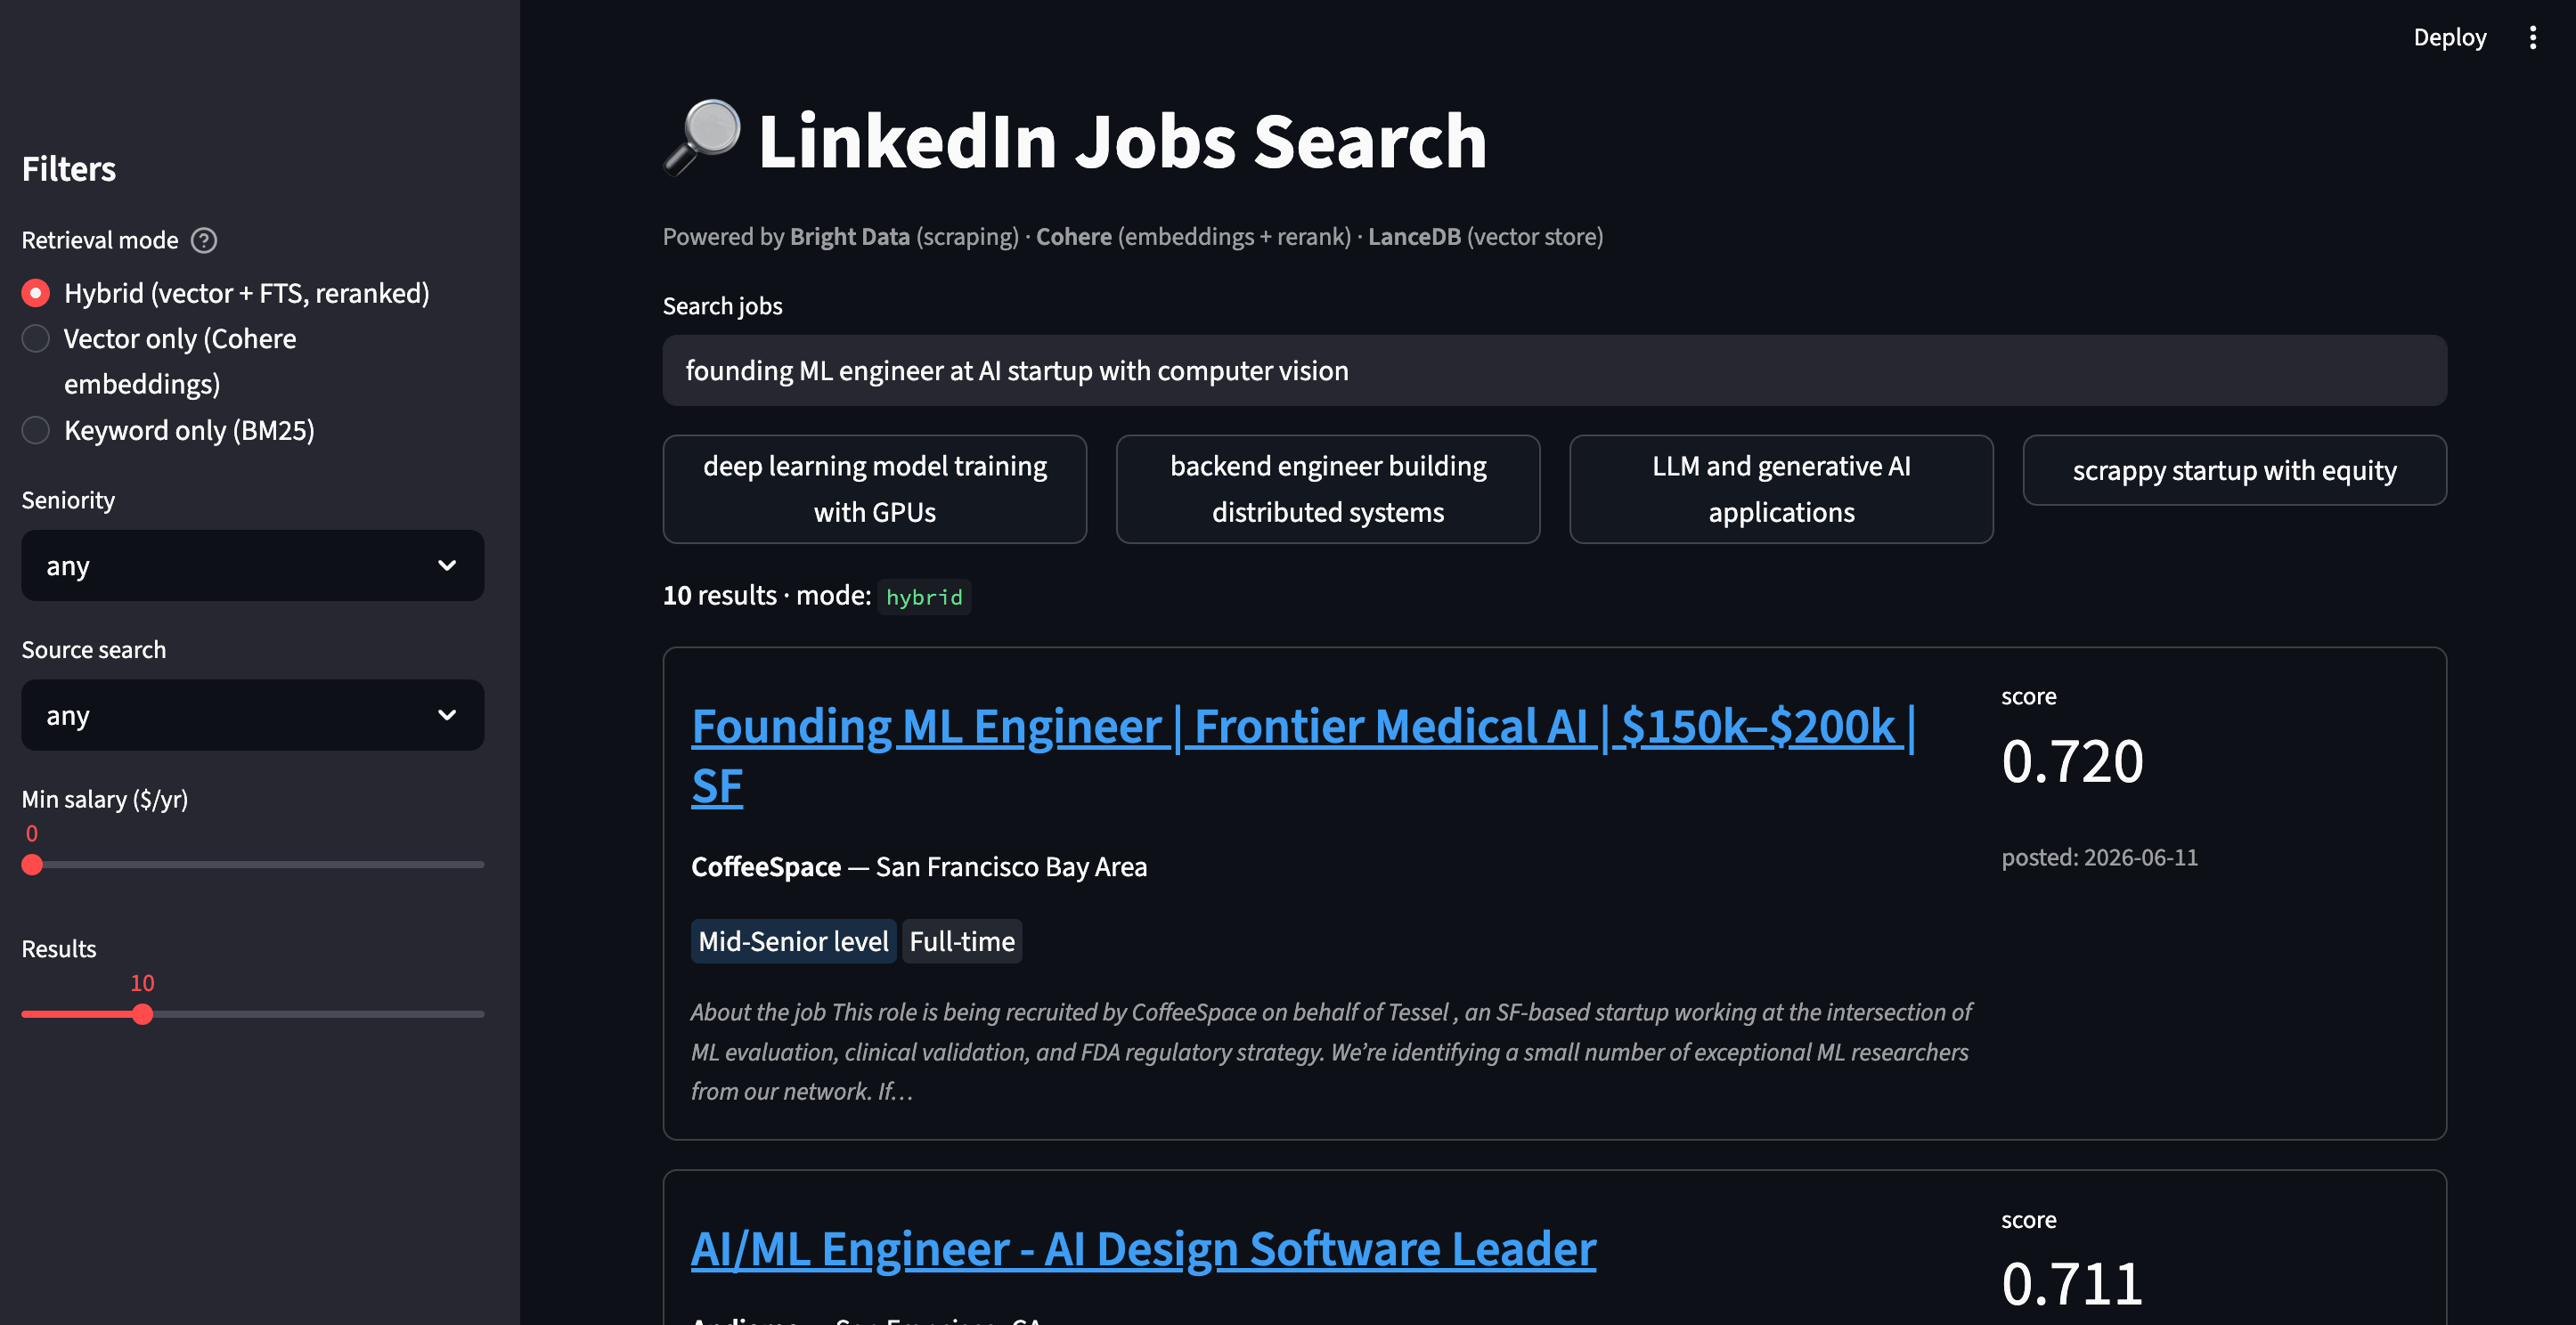
L’application Streamlit exécutant une recherche hybride. Le badge de score sur chaque carte est le score de pertinence de Cohere, et l’extrait sous les badges montre pourquoi chaque résultat a atteint le top 3.
Le voyage dans le temps gratuit avec LanceDB
Cela couvre la recherche et l’UI. LanceDB a une autre fonctionnalité qui vaut la peine d’être montrée. Chaque écriture dans LanceDB crée automatiquement une nouvelle version, sans coût ni infrastructure supplémentaire. C’est ainsi que fonctionne le format colonnaire Lance sous-jacent. Pour qu’une version soit facile à trouver plus tard, index.py la tague après chaque ingestion :
table.tags.create(f"ingest-{datetime.now():%Y-%m-%d-%H%M}", table.version)Notre script compagnon versions.py vous permet ensuite de parcourir et d’ouvrir des snapshots historiques. Après avoir exécuté python index.py une fois, vous verrez 1 tag. Après une deuxième ingestion (par exemple, re-scraper une semaine plus tard) vous en verrez 2 :
$ python versions.py

📊 table 'jobs'  ·  current version: 13  ·  200 rows

🏷  tags (2):
  • ingest-2026-05-20-0905           → version 7
  • ingest-2026-05-20-0906           → version 13  ← current

  travel back with: `python versions.py --tag <name>`

$ python versions.py --tag ingest-2026-05-20-0905

📌 snapshot 'ingest-2026-05-20-0905'  ·  version 7  ·  200 rows
  • Associate Machine Learning Engineer  — Handshake
  • Machine Learning Engineer            — RZR
  • Machine Learning Engineer            — ChatGPT Jobs
Le voyage dans le temps est un appel table.checkout(tag_or_version). Pour un produit de recherche d’emploi, il répond à des questions comme « quels postes étaient publiés le trimestre dernier ? » ou « la distribution des salaires évolue-t-elle dans le temps ? » sans base de données de séries temporelles séparée. C’est l’une des raisons pour lesquelles nous avons choisi LanceDB ici.
Coût et échelle
Pour la démo (200 emplois, ~5 exemples de requêtes) :
| Élément | Coût |
|---|---|
| Scrape Bright Data (204 enregistrements à 0,0015 $/enregistrement) | 0,31 $ |
| Embeddings Cohere (~228 000 tokens au total à 0,10 $/1M) | ~0,02 $ |
| Rerank Cohere (~0,002 $/requête, Rerank v3.5 à 2 $ / 1 000 recherches) | ~0,01 $ pour 5 requêtes |
| LanceDB | gratuit |
La démo de bout en bout coûte ~0,34 $ au total. Ces prix sont issus d’une exécution en 2026, vérifiez donc les tarifs actuels des fournisseurs.
Monter en échelle
La démo locale gère 200 emplois. Quelques leviers couvrent le chemin d’ici à un jeu de données à l’échelle de production :
- Plus d’emplois. Changez
LIMIT_PER_INPUT(max 1 000 par mot-clé) ou ajoutez plus de recherches par mots-clés. 10 000 emplois coûtent ~15 $ en crédits Bright Data. - Plus de mots-clés / localisations. Ajoutez des entrées à la liste
SEARCHESdansscrape.py. - Rafraîchissement planifié. L’upsert
merge_insertque nous avons construit signifie que ré-exécuter le pipeline actualise ce qui a changé. Bright Data supporte la collecte et la livraison planifiées depuis le tableau de bord. Associez cela à l’upsert et vous avez un jeu de données qui se met à jour automatiquement. - Index vectoriel. Au-delà de ~10 000 lignes, remplacez la recherche par force brute par un index HNSW ou IVF_PQ via
table.create_index(vector_column_name="vector"). Il se construit sur CPU par défaut. Pour une construction GPU, passezaccelerator="cuda"(ou"mps"sur Apple Silicon) avec PyTorch>2.0. L’indexation GPU automatique est actuellement une fonctionnalité LanceDB Enterprise. - Vector store de production. LanceDB OSS scale à des millions de vecteurs sur un seul nœud. Au-delà de centaines de millions de vecteurs ou de téraoctets de données, LanceDB Cloud et Enterprise ajoutent l’indexation distribuée et l’exécution de requêtes (leurs docs ciblent ~10 à 50B lignes / ~10 à 30 To).
Avant ces mesures de mise à l’échelle, cependant, la démo elle-même a des aspects à affiner.
8 bugs et pièges que nous avons rencontrés
Au cas où cela vous économise les heures qu’ils nous ont coûtées :
list_tables()ne retourne pas une liste. Dans LanceDB 0.30, elle retourne un objetListTablesResponsequi semble itérable dans le REPL maisif TABLE in db.list_tables()échoue silencieusement. Utiliseztry: db.open_table(TABLE)et attrapez l’exception à la place, ou.tablessur la réponse.table.checkout(tag)retourneNoneet mute le handle de table en place. Cela ressemble à un bug, mais non. Faitest = db.open_table(...); t.checkout(tag); use(t), past = db.open_table(...).checkout(tag).- Le
CohereReranker()par défaut utilise un ancien modèle (rerank-english-v3.0dans les versions testées). Passez un modèle explicitement, soitrerank-v3.5(ce que nous épinglons ici) ourerank-v4.0-propour une meilleure qualité. Le défaut ne vous avertit pas. - Utilisez
/trigger+ polling, pas/scrape, pour les vrais lots. Le mode synchrone (/scrape) est conçu pour les petites extractions. Maintenir la connexion ouverte pourlimit_per_input=100× 2 mots-clés (~200 emplois) peut expirer, donc utilisez/trigger+ polling pour tout ce qui dépasse ~50 enregistrements. - Quelques enregistrements scrapés sont des lignes d’erreur. Sur 204 emplois, 4 avaient un champ
errordéfini au lieu d’unjob_title(par exemple,"Crawl aborted on job cancel"). Ils ressemblent superficiellement à des enregistrements normaux, donc filtrez-les dansindex.pyoumerge_insertéchouera sur unjob_idvide. - Les salaires viennent en 2 périodes (
yrethr) mais le champ du schéma est le même. Sans normaliser en annuel (multiplier horaire par 2080), un filtre commesalary_min_annual >= 200000rate silencieusement les contrats horaires bien rémunérés et inclut des postes salariés implausiblement bas. - Les chaînes d’aide
argparseavec des%bruts se cassent sur Python 3.14. Écrire--where "salary > 200000 AND location LIKE '%SF%'"dans votre texte d’aide lèveValueError: badly formed help stringcar argparse essaie de le formater. Échappez en%%ou reformulez l’exemple. - Streamlit rend le texte entre les signes
$comme des maths LaTeX. Un salaire comme$150k,$200kaffiché avecst.markdownoust.captiondevient des maths illisibles. Échappez chaque$dans vos chaînes d’affichage (leapp.pydu dépôt le fait avec unreplaced’une ligne), ou les badges de salaire s’affichent en charabia.
Ce que vous pouvez construire ensuite
Le pattern, Bright Data ⟶ embeddings ⟶ vector DB ⟶ recherche hybride, se généralise à presque n’importe quel domaine :
| Domaine | Produit Bright Data | Ce que vous interrogeriez |
|---|---|---|
| Accès web agentique | Le MCP Bright Data (niveau gratuit actuellement 5 000 requêtes/mois) | « donner à un agent IA des outils de recherche + scrape en direct, puis ancrer ses réponses dans un cache LanceDB de résultats passés » |
| Corpus de sites entiers | API de crawl | « indexer un site de documentation entier ou une base de connaissances pour la récupération hybride » |
| E-commerce | API Web Scraper (produits Amazon) | « chaussures de course confortables à moins de 100 $ avec 4+ étoiles » |
| Immobilier | API Web Scraper (Zillow / Redfin) | « maison familiale calme près de bonnes écoles, 3+ chambres » |
| Intelligence d’actualités | API SERP + Web Unlocker | « articles sur la sécurité IA de cette semaine, classés par pertinence pour l’alignement » |
| Prospection commerciale | Infos entreprises LinkedIn | « startups Série A en IA de santé basées en Europe » |
| Restaurants | Jeu de données Yelp | « restaurant italien cosy avec terrasse » |
Quelques extensions naturelles de ce projet exact :
- Recherche multimodale. Passez à Cohere
embed-v4.0(nativement multimodal) et embedez les logos d’entreprises aux côtés des descriptions de postes. - Filtres extraits par LLM. Laissez l’utilisateur taper « emplois ML à distance payant 200 000 $+ » et demandez à un LLM d’extraire automatiquement
remote=true, salary_min_annual >= 200000. - Recherches sauvegardées avec alertes email. Ré-exécutez une requête contre le scrape le plus récent et notifiez sur les nouvelles correspondances.
- Correspondance de CV. Embedez un CV et recherchez des emplois par similarité avec le candidat. L’assistant IA de recherche d’emploi LinkedIn de Bright Data est un exemple plus complet.
- Un Scraper auto-maintenu. Donnez à un agent accès au MCP de Bright Data et il peut inspecter la page, écrire le Scraper, et tenter une correction quand la mise en page change, plutôt que vous corrigiez
scrape.pyà la main. Le Scraper Studio de Bright Data emballe cela comme un produit géré, transformant une invite en langage naturel en un Scraper auto-réparant.
Prochaines étapes
La recherche par mots-clés ratait les bons postes, et la recherche vectorielle les trouvait même quand les titres ne correspondaient jamais à la requête. Dans l’évaluation, le vecteur a scoré 70 % de précision@3 contre 43 % pour les mots-clés, avec le mode hybride n’apportant aucune amélioration à cette échelle.
Le projet complet sur GitHub comprend 9 petits fichiers. Pour l’utiliser sur vos propres données, exécutez d’abord python eval.py, car le meilleur mode dépend des données, pas de celui qui est le plus complexe. Décidez ensuite d’une cadence de rafraîchissement, où merge_insert n’upserte que ce qui a changé et versions.py prend un snapshot de chaque ingestion. Et avant tout déploiement, planifiez une routine de rotation des clés, car les clés BD et Cohere vont dans .env.
Le même pattern fonctionne pour tout ce que Bright Data peut scraper, pas seulement les emplois. À partir de là, vous disposez d’un moteur de recherche sémantique réutilisable pour n’importe quel jeu de données que vous scrapez.
FAQ
Puis-je l’utiliser pour d’autres sites que LinkedIn ?
Oui. La Bibliothèque de Web Scrapers de Bright Data couvre des centaines de sites (Amazon, Zillow, Yelp, et plus), chacun avec son propre dataset_id. Remplacez le DATASET_ID dans scrape.py et le mapping to_row() dans index.py pour la nouvelle forme JSON. La logique de recherche et d’indexation est agnostique aux données et se transporte.
Ai-je besoin d’un compte Cohere payant pour cela ?
Non, une clé d’essai exécute toute la démo. L’endpoint Rerank d’essai de Cohere est actuellement limité à 10 appels/min, donc eval.py rencontre un 429 et recule automatiquement (~90s au lieu de ~15s). Le Scraping web, l’indexation et la recherche ad hoc restent bien en dessous des limites. Mettez à niveau uniquement si vous itérez souvent sur l’évaluation.
Pourquoi LanceDB, pas Pinecone, Weaviate ou pgvector ?
LanceDB est une bibliothèque embarquée sans serveur, sans base de données séparée, et sans facture de service géré. Il supporte la recherche hybride et le reranking Cohere nativement, et chaque écriture est un snapshot de version. Pour un pipeline sur une seule machine sans ops, c’est le moins de surcharge. Les autres sont capables mais ajoutent plus d’infrastructure.
À quelle fréquence devrais-je ré-exécuter le Scraper ?
Une fois par jour convient à un site d’emploi actif. Bright Data peut exécuter la collecte planifiée depuis le tableau de bord, et l’upsert merge_insert déduplique côté LanceDB, donc les ré-exécutions sont peu coûteuses. Les annonces de plus de ~30 jours sont généralement fermées, donc les anciens snapshots deviennent historiques, et versions.py les garde consultables.