Ce guide couvre les 10 meilleurs outils d’accès web pour agents IA en 2026. En premier, Bright Data et sa plateforme d’accès web pour agents IA. C’est la seule plateforme ici qui couvre les trois fonctions avec des données en direct. Elle recherche sur Google, Bing et Yandex en temps réel et renvoie n’importe quelle page en Markdown propre ou en JSON structuré. Elle exécute aussi des navigateurs cloud pour les tâches à plusieurs étapes. Un seul compte et 5000 crédits mensuels gratuits couvrent tout cela.
L’accès web pour un agent IA représente trois fonctions distinctes. L’agent doit rechercher sur le web en direct et lire les pages dans un format exploitable par un modèle. Il doit aussi piloter un véritable navigateur quand un site nécessite des clics. La plupart des comparatifs ne classent qu’une seule de ces fonctions. Celui-ci classe les outils sur les trois. Il indique aussi si les résultats proviennent d’un moteur en direct, d’un index privé ou d’un cache. Chaque étape de Bright Data est illustrée avec une sortie réelle.
Réponse rapide : le meilleur outil d’accès web pour chaque fonction d’agent
- Meilleure plateforme pour donner aux agents IA un accès fiable au web en direct : Bright Data. Elle combine l’API SERP, le Web Unlocker, plus de 1200 scrapers, et la Browser API derrière une seule clé. Les agents se connectent via un serveur MCP ou une CLI.
- Meilleur pour renvoyer du Markdown propre et des données structurées à un flux de travail IA : Bright Data pour le Markdown plus des scrapers JSON prêts à l’emploi. Firecrawl est le choix pour l’extraction basée sur un schéma depuis des pages arbitraires.
- Meilleure infrastructure pour parcourir des sites riches en JavaScript et accomplir des tâches à plusieurs étapes : la Browser API de Bright Data, avec déblocage intégré. Browserbase et Browser Use sont de solides alternatives axées navigateur.
- Meilleure API de recherche pour l’ancrage LLM avec citations et actualités : Bright Data pour les résultats Google en direct. Exa, Parallel et Brave servent des résultats issus de leurs propres index.
En bref : les meilleurs outils d’accès web pour agents IA en un coup d’œil
La shortlist classée, avec la couverture de chaque fonction, les offres gratuites et les prix de départ.
| Outil | Idéal pour | Recherche en direct | Markdown et données structurées | Navigateur cloud | Offre gratuite | Prix de départ |
|---|---|---|---|---|---|---|
| Bright Data | plateforme globale d’accès web pour agents IA | Google, Bing, Yandex en direct | Markdown + 1200+ scrapers JSON | Oui, Browser API | 5000 crédits/mois | Dès 1$/1K requêtes ; navigateur dès 5$/Go |
| Firecrawl | pour l’extraction basée sur un schéma | Index propre + direct | Markdown + schéma JSON | Partiel (Interact) | 1000 crédits/mois | Dès 16$/mois (annuel) |
| TinyFish | offre gratuite de recherche et récupération | Oui (TinySearch) | Markdown ou JSON | Oui, plus exécutions d’agents | Recherche et récupération gratuites, limitées en débit | Navigateur 0,002$/min |
| Browserbase | pour les flottes de navigateurs headless | Revendue (Parallel, Exa) | Markdown ou schéma JSON | Oui | 1 heure de navigateur + 1K appels recherche/récupération | Dès 20$/mois |
| Tavily | pour les résultats de recherche RAG fragmentés | Oui | Markdown ou texte | Non | 1000 crédits/mois | Dès 30$/mois |
| Exa | pour la recherche sémantique | Index propre | Contenu des pages + résumés LLM | Non | 10$ de crédit/mois | Recherche dès 4$/1K |
| Parallel | pour les extraits compressés | Index propre | Pages complètes ou extraits | Non | Jusqu’à 5000 requêtes/mois | Recherche 1$ à 5$/1K |
| Apify | marketplace d’acteurs prêts à l’emploi | Via l’acteur RAG Web Browser | Markdown + jeux de données d’acteurs | Partiel (les acteurs exécutent des navigateurs) | 5$ de crédit/mois | Dès 1,33$/1K pages |
| Browser Use | agent navigateur open-source | Non | Via sortie d’agent | Oui, Chromium furtif | 1$ de crédit unique | 0,02$/h + 5$/Go proxy |
| Brave Search API | index de recherche indépendant | Index propre | Non | Non | 5$ de crédit/mois | 5$/1K requêtes |
Qu’est-ce qu’un outil d’accès web pour agents IA ?
Un outil d’accès web donne à un agent IA un moyen d’atteindre le web public pendant qu’il travaille. Il expose des outils pour rechercher, récupérer des pages, extraire des champs et piloter un navigateur. Les agents appellent ces outils via une API, un serveur MCP, une CLI ou un SDK. L’outil gère ce qu’un modèle ne peut pas : blocage, CAPTCHA, rendu JavaScript, et transformation du HTML en texte lisible par un modèle.
L’origine des données compte autant que le format. Un moteur de recherche en direct renvoie ce qu’une personne voit sur Google ou Bing à l’instant présent. Un index privé renvoie des pages que le fournisseur a explorées plus tôt, classées selon son propre modèle. Un cache renvoie une copie stockée d’une page, qui peut dater d’heures ou de jours. Pour les prix, l’actualité et les notes de version, un agent a besoin de données en direct ou d’un moyen explicite de les demander.
Quel outil d’accès web convient à chaque fonction ?
Associez la fonction de votre agent aux outils qui la couvrent. La plupart des agents remplissent plus d’une fonction, d’où l’importance de couvrir les trois.
| Fonction de l’agent | Ce dont l’agent a besoin | Meilleur choix | Alternatives |
|---|---|---|---|
| Recherche web en direct et ancrage LLM | Résultats actuels avec URLs à citer, y compris actualités et résultats locaux | API SERP Bright Data | Tavily, Exa, Parallel, Brave |
| Markdown propre et données structurées | Texte de page sans éléments superflus, ou champs JSON typés | Web Unlocker et Web Scraper API Bright Data | Firecrawl, TinyFish, Apify |
| Sites riches en JavaScript et tâches à plusieurs étapes | Un vrai navigateur capable de cliquer, taper, défiler et se connecter | Browser API Bright Data | Browserbase, Browser Use, TinyFish |
| Exploration de site entier | Chaque page d’un domaine dans un format prêt pour un LLM | Bright Data Crawl API | Firecrawl, Apify |
Comment ces outils sont classés
Chaque outil ici propose une API conçue pour les agents IA et couvre au moins l’une des trois fonctions. Les informations fournisseurs proviennent des pages tarifaires et de la documentation de chaque fournisseur, à jour en octobre 2026. Les outils sont notés sur sept critères.
- Couverture des fonctions : recherche, Markdown et données structurées, et navigateurs cloud.
- Fraîcheur : résultats de moteur en direct et lectures de pages en direct, ou un index ou un cache.
- Déblocage : gestion des contrôles anti-bots, CAPTCHA, et pages à restriction géographique.
- Sortie : Markdown propre, JSON avec schéma, et résultats économes en tokens.
- Interfaces agent : un serveur MCP hébergé, des SDK, et une CLI.
- Offre gratuite : les allocations mensuelles sont mieux notées que les crédits ponctuels.
- Confiance : certifications de sécurité et conformité publiée.
Les 10 meilleurs outils d’accès web pour agents IA en 2026
1. Bright Data
Bright Data offre aux agents IA les trois types d’accès web depuis une seule plateforme. L’API SERP renvoie des résultats Google, Bing et Yandex en direct, y compris actualités, shopping, et résultats locaux par pays. Le Web Unlocker renvoie n’importe quelle page publique en Markdown ou HTML propre, et gère CAPTCHA, contrôles anti-bots, et relances. La Web Scraper API ajoute plus de 1200 scrapers prêts à l’emploi qui renvoient du JSON typé, pour des sites comme Amazon et Best Buy. La Browser API exécute des navigateurs cloud que Playwright, Puppeteer ou Selenium pilotent via CDP, avec déblocage intégré. Les agents accèdent à tout cela via le serveur MCP Bright Data hébergé, la CLI, ou les SDK Python et Node.js. Elle a affiché le meilleur taux de réussite moyen, 98,87%, parmi les 16 API de scraping du benchmark 2026 de Scrape.do.
Détails clés :
- Idéal pour : les agents qui ont besoin de recherche en direct, de lecture de pages, de données structurées et de navigateurs auprès d’un seul fournisseur.
- Produits : API SERP, Web Unlocker, Web Scraper API, Crawl API, et Browser API.
- Interfaces agent : serveur MCP hébergé avec OAuth, CLI Bright Data, SDK Python et Node.js.
- Fraîcheur : chaque recherche et lecture de page s’exécute en direct contre la source.
- Offre gratuite : 5000 crédits par mois, sans carte bancaire, partagés entre recherche, lecture de pages, scrapers, et Browser API.
- Tarification : recherche et lecture de pages dès 1$ pour 1000 requêtes ; Browser API dès 5$/Go.
- Conformité : rapports SOC 2 et SOC 3, ISO 27701, et Conformité RGPD, listés dans le Trust Center.
Avantages :
- Couvre recherche, Markdown, JSON structuré, exploration, et navigateurs avec une seule clé.
- Résultats Google en direct, pas un index privé.
- Déblocage intégré à chaque produit, sur un réseau de plus de 400 millions d’IP.
- MCP, CLI, et SDK, de sorte que le même compte convient aux applications de chat et aux agents de codage.
Inconvénients :
- De nombreux produits signifient plus de choix dès le premier jour.
- Les recherches Google en direct prennent quelques secondes, plus lent qu’une recherche d’index.
⭐ Note des avis : G2 4,7/5 (349 avis)
2. Firecrawl
Firecrawl est une API de données web pour la recherche, le scraping, l’exploration, et l’interaction navigateur. Elle renvoie du Markdown propre, et son mode JSON extrait des champs correspondant à un schéma que vous définissez. La recherche s’appuie sur son index Alexandria ou une récupération en direct. Les sessions Interact ajoutent clics, défilement, et saisie sur une page. La documentation de Firecrawl définit un maxAge par défaut de deux jours. Une lecture de page peut renvoyer une copie en cache sauf si vous en demandez une fraîche.
Détails clés :
- Idéal pour : l’extraction JSON basée sur un schéma depuis des pages arbitraires.
- Interfaces agent : serveur MCP hébergé, SDK Python et Node, et une CLI.
- Offre gratuite : 1000 crédits par mois, sans carte bancaire.
- Tarification : Hobby 19$/mois, ou 16$/mois facturé annuellement, pour 5000 crédits.
- Conformité : SOC 2 Type II.
Avantages :
- Forte extraction JSON basée sur un schéma.
- Couvre recherche, scraping, exploration, et interaction de page.
- Grande communauté open-source.
Inconvénients :
- Lectures de pages en cache par défaut.
- Les sessions navigateur coûtent 2 crédits par minute en plus du scraping.
⭐ Note des avis : G2 4,6/5 (94 avis)
3. TinyFish
TinyFish se présente comme la pile web pour agents IA. TinySearch et TinyFetch sont gratuits et limités en débit, à 500 recherches par heure et 1000 URL récupérées par jour. TinyFetch rend le JavaScript et renvoie du Markdown, du HTML, ou du JSON. TinyBrowser exécute des sessions de navigateur cloud que vous pilotez via CDP et Playwright, et TinyAgent exécute une automatisation à plusieurs étapes. Sa documentation note que Fetch peut servir une entrée en cache sauf si vous définissez un ttl de zéro.
Détails clés :
- Idéal pour : les équipes qui veulent recherche et récupération gratuites avec navigateurs sur le même compte.
- Interfaces agent : serveur MCP hébergé, SDK Python et Node, et une CLI.
- Offre gratuite : recherche et récupération à 0$, limitées en débit, sans carte.
- Tarification : navigateur à 0,002$ par minute, exécutions d’agent à 0,016$ par étape.
- Conformité : ISO 27001 sur le plan Enterprise.
Avantages :
- Recherche et récupération gratuites avec limites publiées.
- Sessions navigateur et un agent sur une seule plateforme.
Inconvénients :
- Fetch peut renvoyer des pages en cache par défaut.
- Les exécutions d’agent sont facturées par étape, ce qui s’accumule sur des tâches longues.
⭐ Note des avis : G2 4,3/5 (103 avis)
4. Browserbase
Browserbase exécute des navigateurs headless dans le cloud pour les agents IA. Il prend en charge Playwright, Puppeteer, Selenium, et son propre framework open-source Stagehand. Les plans payants ajoutent la résolution de CAPTCHA et des proxys résidentiels. Browserbase Fetch renvoie les pages en Markdown, HTML, ou JSON correspondant à un schéma. Son API de recherche s’appuie sur Parallel et Exa, selon sa page tarifaire.
Détails clés :
- Idéal pour : les équipes qui gèrent leur propre automatisation de navigateur à grande échelle.
- Interfaces agent : serveur MCP hébergé, SDK Node et Python, et la CLI Browse.
- Offre gratuite : une heure de navigateur, 1000 appels de recherche, et 1000 appels de récupération.
- Tarification : Developer 20$/mois avec 100 heures de navigateur, puis 0,12$ par heure ; proxys 12$/Go.
- Conformité : SOC 2.
Avantages :
- Plateforme navigateur mature avec Stagehand.
- Fetch avec sortie schéma JSON.
Inconvénients :
- La recherche est revendue par d’autres fournisseurs.
- Le trafic proxy est facturé séparément.
⭐ Note des avis : G2 4,3/5 (56 avis)
5. Tavily
Tavily est une API de recherche et d’extraction conçue pour les agents IA, désormais partie de Nebius. Elle renvoie des résultats classés et fragmentés, prêts pour un modèle, avec contenu de page optionnel. Extract renvoie du Markdown ou du texte brut. Les points de terminaison Crawl, Map, et Research complètent l’offre. Il n’y a pas de produit navigateur.
Détails clés :
- Idéal pour : les pipelines RAG qui veulent des résultats de recherche fragmentés.
- Interfaces agent : serveur MCP hébergé, SDK Python et JavaScript, et une CLI.
- Offre gratuite : 1000 crédits par mois, sans carte bancaire.
- Tarification : Project 30$/mois pour 4000 crédits, ou 0,008$ par crédit.
- Remarque : une recherche de base coûte 1 crédit ; cinq URL extraites coûtent 1 crédit.
Avantages :
- Les résultats arrivent fragmentés pour un modèle.
- Modèle de crédit simple.
Inconvénients :
- Pas d’extraction JSON structurée par schéma.
- Pas de navigateur cloud.
⭐ Note des avis : G2 4,5/5 (3 avis)
6. Exa
Exa exploite son propre index web avec une recherche neuronale pour des requêtes basées sur le sens. Son API Contents renvoie le texte complet de la page pour un modèle, et les résumés peuvent extraire des champs dans un schéma JSON. Exa décrit son index comme le plus grand index indépendant au monde. Sa documentation note que Contents utilise une copie en cache quand disponible, sauf si vous demandez un contenu frais.
Détails clés :
- Idéal pour : les recherches sémantiques et de type « trouver similaire ».
- Interfaces agent : serveur MCP hébergé, SDK Python et JavaScript.
- Offre gratuite : 10$ de crédit par mois plus un bonus d’inscription de 10$.
- Tarification : recherche dès 4$ pour 1000 requêtes ; contenus 1$ pour 1000 pages.
- Conformité : SOC 2 Type II, Conformité RGPD, et HIPAA avec un BAA.
Avantages :
- Forte recherche sémantique.
- Crédit mensuel renouvelable.
Inconvénients :
- Les résultats proviennent de son propre index, pas d’un moteur en direct.
- Pas de navigateur cloud.
⭐ Note des avis : G2 4,4/5 (23 avis)
7. Parallel
Parallel développe des API de recherche et de recherche approfondie sur son propre index web. Search renvoie des URL classées avec des extraits compressés, et Extract renvoie des pages complètes ou des extraits. Son API Task exécute des recherches approfondies et renvoie des enrichissements structurés. Consultez notre comparatif Bright Data vs. Parallel pour un examen plus approfondi.
Détails clés :
- Idéal pour : des extraits denses en tokens pour l’ancrage.
- Interfaces agent : serveur MCP hébergé, SDK Python et TypeScript, et une CLI.
- Offre gratuite : jusqu’à 5000 requêtes par mois.
- Tarification : recherche 0,001$ à 0,005$ pour 10 résultats ; extraction 0,001$ par requête.
- Conformité : SOC 2 Type 2.
Avantages :
- Les extraits compacts maintiennent un contexte réduit.
- API de recherche approfondie sur le même compte.
Inconvénients :
- Les résultats proviennent de son propre index.
- Pas de navigateur cloud, et pas encore de fiche G2.
8. Apify
Apify est une marketplace de scrapers prêts à l’emploi appelés Actors. Son acteur RAG Web Browser recherche sur Google, scrape les pages les mieux classées dans un navigateur complet, et renvoie du Markdown propre. Des milliers d’autres acteurs renvoient des jeux de données structurés pour des sites spécifiques. Un serveur MCP hébergé permet à un agent de trouver et d’exécuter des acteurs.
Détails clés :
- Idéal pour : les équipes qui veulent un acteur prêt à l’emploi pour chaque site.
- Interfaces agent : serveur MCP hébergé, clients JavaScript et Python, et une CLI.
- Offre gratuite : 5$ de crédit plateforme par mois, sans carte bancaire.
- Tarification : RAG Web Browser dès 1,33$ pour 1000 pages récupérées ; Starter 19$/mois.
- Conformité : SOC 2, Conformité RGPD, et CCPA.
Avantages :
- Immense bibliothèque d’acteurs spécifiques aux sites.
- Forte réputation G2 sur 690 avis.
Inconvénients :
- La qualité varie selon les acteurs communautaires.
- Pas de produit navigateur CDP brut pour votre propre code d’agent.
⭐ Note des avis : G2 4,7/5 (690 avis)
9. Browser Use
Browser Use a débuté comme bibliothèque open-source pour agents navigateurs et exploite désormais un cloud. Browser Use Cloud héberge un Chromium furtif que vous pilotez via CDP avec Playwright, Puppeteer, ou la bibliothèque browser-use. Browser Use Agents prend une tâche en langage courant et l’accomplit dans le navigateur. Il n’a pas d’API de recherche.
Détails clés :
- Idéal pour : les équipes développant déjà sur la bibliothèque browser-use.
- Interfaces agent : serveur MCP hébergé, SDK Python et TypeScript, et une CLI.
- Offre gratuite : un crédit unique de 1$ pour les inscriptions éligibles.
- Tarification : navigateurs cloud à 0,02$ par heure plus 5$/Go pour les proxys résidentiels.
- Conformité : SOC 2 Type II et HIPAA.
Avantages :
- Agent navigateur open-source populaire.
- Prix horaire du navigateur bas.
Inconvénients :
- Pas d’API de recherche ou de lecture de page.
- Le crédit gratuit est unique.
⭐ Note des avis : G2 4,3/5 (89 avis)
10. Brave Search API
L’API Brave Search répond à chaque requête à partir de l’index indépendant propre de Brave. Son point de terminaison LLM Context renvoie uniquement le contenu dont un modèle a besoin, et Answers renvoie des réponses ancrées. Elle ne récupère pas d’URL arbitraires et n’exécute pas de navigateurs. Les conditions de Brave restreignent le stockage des résultats et leur usage pour entraîner des modèles IA.
Détails clés :
- Idéal pour : un index de recherche indépendant pour l’ancrage.
- Offre gratuite : 5$ de crédits gratuits par mois, prépayés.
- Tarification : 5$ pour 1000 requêtes pour la recherche et LLM Context.
- Conformité : SOC 2 Type II.
Avantages :
- Index indépendant, pas un revendeur.
- Tarification simple par requête.
Inconvénients :
- Recherche uniquement.
- Les conditions restreignent le stockage des résultats.
Comment donner à un agent IA une recherche web en direct avec citations
L’ancrage nécessite des résultats actuels et des URL que le modèle peut citer. L’API SERP renvoie la page de résultats en direct, avec titres, liens, et extraits classés. Les réponses incluent aussi les blocs People Also Ask et AI Overview quand Google les affiche. La CLI Bright Data l’enveloppe en une seule commande, pour qu’un agent de codage puisse rechercher depuis son shell.
  npm install -g @brightdata/cli
bdata login
bdata search "model context protocol specification latest version" --json
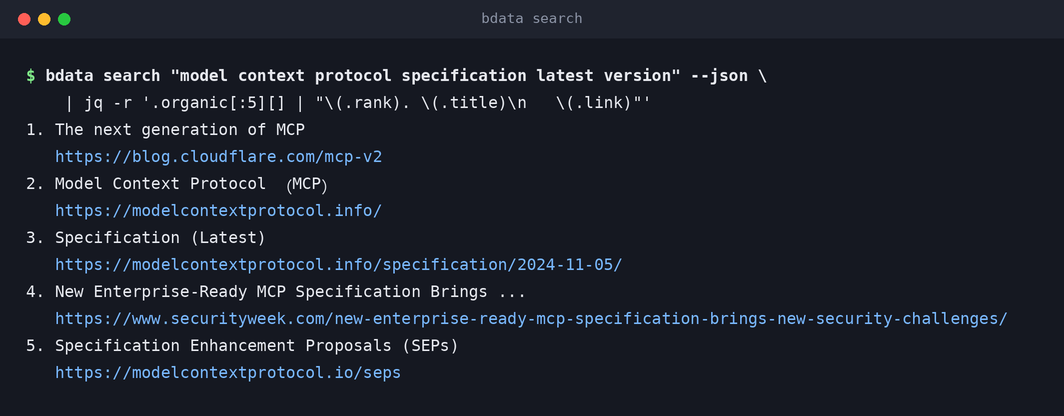
L’agent lit les URL classées et les cite dans sa réponse. Ajoutez --type news pour l’actualité, ou --country pour des résultats locaux. Pour un examen plus approfondi des coûts d’ancrage, lisez l’ancrage SERP léger avec Bright Data MCP.
Comment renvoyer du Markdown propre et des données structurées à un flux de travail IA
Les agents ont besoin de deux formats. Le Markdown convient à la lecture et au raisonnement sur une page entière. Le JSON structuré convient aux pipelines, comparaisons, et tout ce qui alimente une base de données. Le coût en tokens de chacun est très différent, comme le montre une page produit Best Buy.
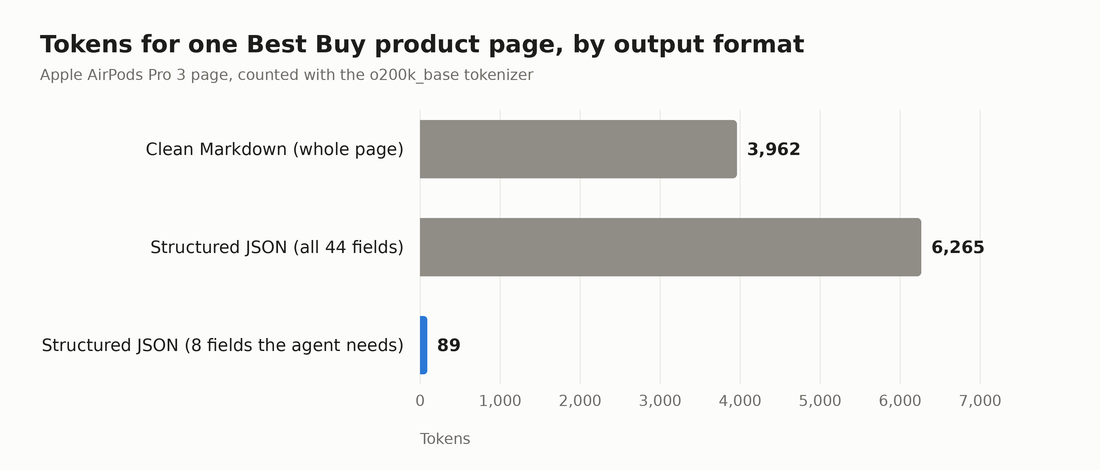
La page entière en Markdown propre coûte 3962 tokens. L’enregistrement structuré complet, avec 44 champs, coûte 6265. Ne conservez que les 8 champs dont un agent a besoin pour une vérification de prix, et l’enregistrement tombe à 89 tokens. Utilisez le Markdown quand l’agent doit lire, et les champs JSON quand il doit comparer ou stocker. Bright Data renvoie les deux depuis le même compte.
  # n'importe quelle page en Markdown propre (Web Unlocker)
bdata scrape "https://www.amazon.com/dp/B0DM63WNWL" -o page.md

# le même type de page en JSON typé (Web Scraper API)
bdata pipelines search amazon product
bdata pipelines run gd_l7q7dkf244hwjntr0 collect_by_url "https://www.amazon.com/dp/B0DM63WNWL" --pretty
Via le serveur MCP, les mêmes fonctions sont scrape_as_markdown pour les pages, et search_scrapers plus run_scraper pour les enregistrements structurés. Pour un site entier, la Crawl API renvoie chaque page en Markdown, texte, HTML, ou JSON.
Comment permettre à un agent IA de parcourir des sites riches en JavaScript et d’accomplir des tâches à plusieurs étapes
Certaines tâches nécessitent un vrai navigateur. Champs de recherche, filtres, connexions, et défilement infini ne fonctionnent que si quelque chose clique et tape. La Browser API exécute ces navigateurs dans le cloud, avec empreintes, résolution de CAPTCHA, et IPs résidentielles gérées pour vous. La CLI les expose sous forme de commandes courtes. Un snapshot liste les éléments de la page avec des refs, et l’agent agit sur une ref.
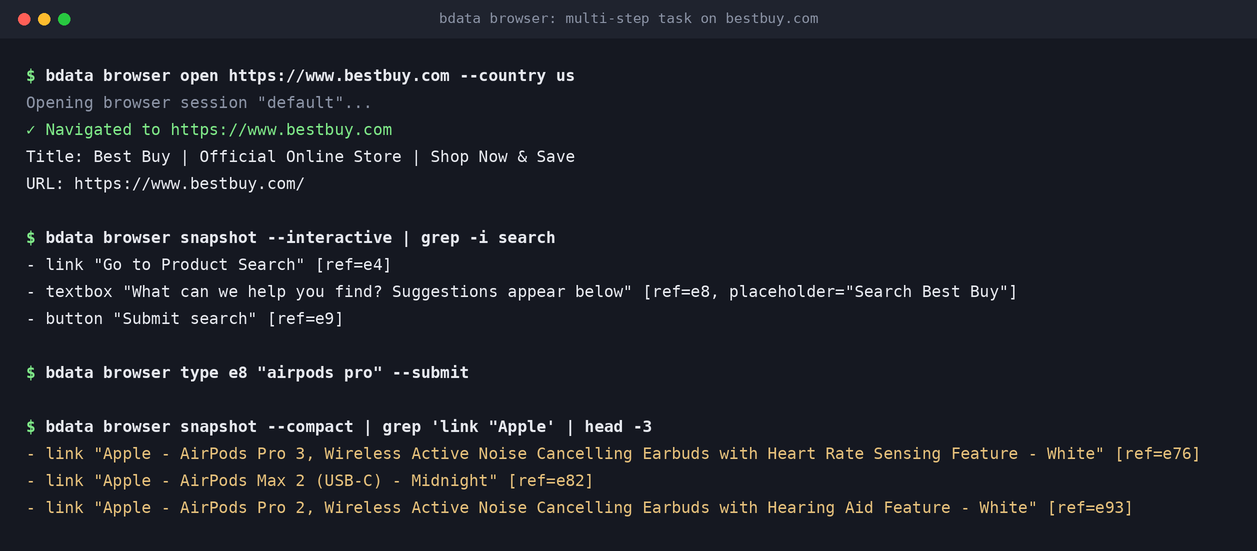
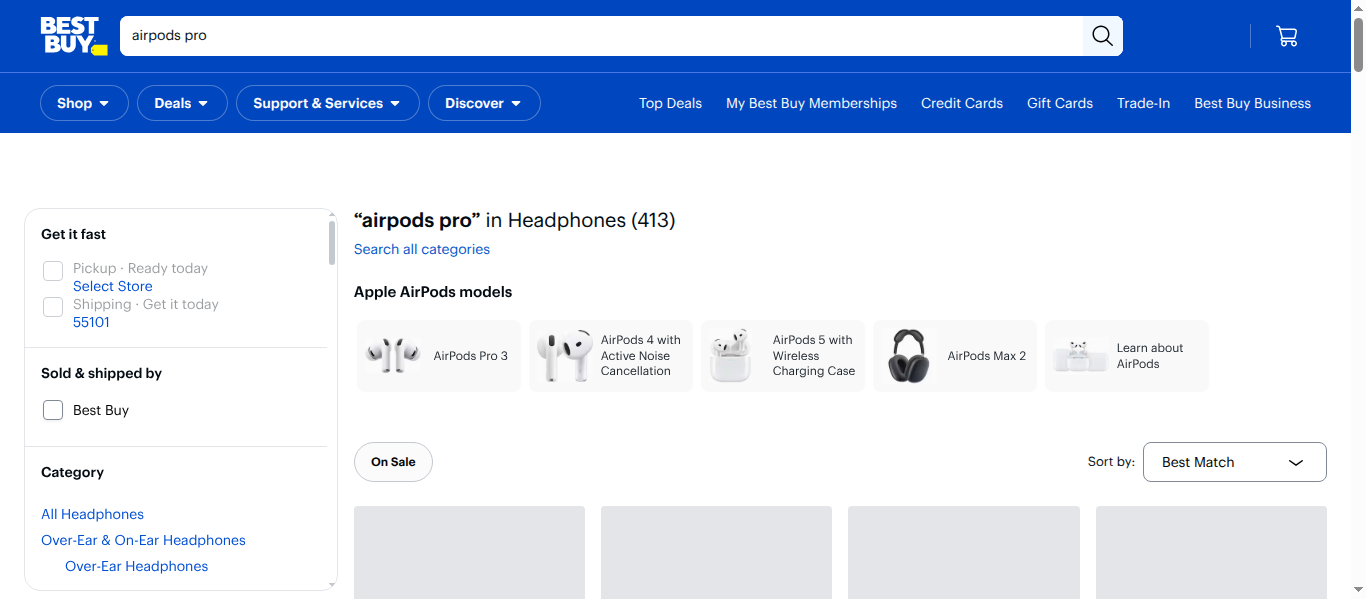
Les quatre commandes ci-dessus ouvrent bestbuy.com, trouvent le champ de recherche, lancent une recherche, et lisent les résultats. Best Buy charge ses résultats avec du JavaScript derrière une protection anti-bot Akamai, et le navigateur cloud gère les deux. Voici la page que le navigateur a vue après la recherche.
Votre propre code d’agent peut piloter les mêmes navigateurs via CDP. Connectez Playwright avec vos identifiants de zone Browser API.
  import asyncio
from playwright.async_api import async_playwright

CDP = "wss://brd-customer-<customer_id>-zone-<zone>:<password>@brd.superproxy.io:9222"

async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(CDP)
        page = await browser.new_page()
        await page.goto("https://www.bestbuy.com")
        print(await page.title())
        await browser.close()

asyncio.run(main())
Dans les clients MCP, ajoutez groups=browser à l’URL hébergée pour charger les outils navigateur. Ils incluent scraping_browser_navigate, scraping_browser_type_ref, et scraping_browser_click_ref. Vous comparez des plateformes navigateur ? Consultez notre classement des meilleurs navigateurs d’agents.
claude mcp add --transport http brightdata "https://mcp.brightdata.com/mcp?groups=browser"
Claude Code vous connecte ensuite via le navigateur avec OAuth, après avoir exécuté /mcp et choisi Authenticate.
En direct, indexé, ou en cache : d’où proviennent les données de chaque outil
Les agents répondent souvent à des questions sur les prix, l’actualité, et les versions logicielles. Pour cela, l’âge des données compte autant que leur format. Voici d’où proviennent les résultats de recherche et les lectures de pages de chaque outil, selon sa propre documentation.
| Outil | Résultats de recherche | Lectures de pages par défaut |
|---|---|---|
| Bright Data | Google, Bing, et Yandex en direct | Récupération en direct à chaque requête |
| Firecrawl | Index propre ou direct | Copie en cache jusqu’à 2 jours, sauf si maxAge est réduit |
| TinyFish | TinySearch | Entrée en cache quand disponible, sauf si ttl est 0 |
| Browserbase | Revendue par Parallel et Exa | Non précisé |
| Exa | Index propre | En cache quand disponible, sauf si un contenu frais est demandé |
| Parallel | Index propre | Non précisé |
| Tavily | Recherche en temps réel avec mise en cache | Non précisé |
| Brave Search API | Index propre | Pas de lecture de page |
La mise en cache est un choix par défaut raisonnable pour les documents statiques et les recherches rapides. Quand l’agent rapporte un prix actuel ou l’actualité du jour, utilisez une source en direct. Sinon, définissez explicitement l’option de fraîcheur.
Conclusion
Le meilleur outil d’accès web pour un agent IA couvre les fonctions que l’agent accomplit réellement. Bright Data est le choix unique le plus solide. Il offre recherche en direct, Markdown propre, plus de 1200 scrapers structurés, et navigateurs cloud sur un seul compte. Firecrawl est en tête pour l’extraction basée sur un schéma, Browserbase et Browser Use pour les équipes axées navigateur, et Exa pour la recherche sémantique. Commencez avec les 5000 crédits mensuels gratuits, puis connectez-vous via MCP, la CLI, ou un SDK.
Guides associés : les meilleures API SERP gratuites, les meilleures API de scraping web, et le SDK Python Bright Data.
Questions fréquentes
Quelle est la meilleure plateforme pour donner aux agents IA un accès fiable au web en direct ?
Bright Data est la meilleure plateforme globale. Une clé couvre la recherche Google, Bing, et Yandex en direct, le Markdown propre, plus de 1200 scrapers structurés, et les navigateurs cloud. Le déblocage est intégré, et les agents se connectent via un serveur MCP, une CLI, ou des SDK. Les nouveaux comptes reçoivent 5000 crédits gratuits chaque mois.
Quel outil renvoie à la fois du Markdown propre et des données structurées à un flux de travail IA ?
Bright Data renvoie n’importe quelle page en Markdown propre via le Web Unlocker, et du JSON typé via plus de 1200 scrapers prêts à l’emploi. Firecrawl et Browserbase Fetch peuvent aussi extraire du JSON correspondant à un schéma que vous définissez. Utilisez le Markdown pour la lecture et les champs JSON pour les pipelines.
Quelle infrastructure les agents IA ont-ils besoin pour parcourir des sites riches en JavaScript et accomplir des tâches à plusieurs étapes ?
Ils ont besoin d’un navigateur cloud qui rend le JavaScript et gère les contrôles anti-bots et les CAPTCHA. L’agent doit pouvoir cliquer, taper, et défiler. La Browser API Bright Data fournit cela via CDP, via les outils navigateur MCP, ou via des commandes CLI. Browserbase et Browser Use sont des alternatives axées navigateur.
Quelles API de recherche offrent aux LLM des citations et un contexte d’actualité ?
L’API SERP de Bright Data renvoie des résultats Google et Bing en direct, y compris l’actualité, avec des URL à citer. Tavily, Exa, Parallel, et Brave renvoient aussi des URL. Exa, Parallel, et Brave servent des résultats issus de leurs propres index plutôt que d’un moteur de recherche en direct.
Existe-t-il un outil d’accès web gratuit pour agents IA ?
Oui. Bright Data inclut 5000 crédits gratuits par mois, partagés entre recherche, lecture de pages, scrapers, et Browser API. Firecrawl et Tavily offrent 1000 crédits gratuits par mois, Exa 10$ de crédit, et TinyFish une recherche et récupération gratuites limitées en débit.
Un agent IA doit-il utiliser MCP, une API, ou une CLI pour l’accès web ?
Utilisez MCP dans les applications de chat et les frameworks d’agents sans shell. Utilisez une CLI quand l’agent s’exécute dans un terminal, car elle n’ajoute aucune définition d’outil au contexte. Utilisez l’API ou un SDK dans votre propre code. Bright Data propose les trois sur le même compte.