Scraper Etsy signifie collecter les données des annonces, boutiques et avis depuis les pages publiques d’Etsy. Etsy a signalé plus de 100M d’articles et 5,6M de vendeurs actifs dans son rapport annuel 2025. Etsy utilise DataDome. Une requête directe renvoie un 403 et une page de blocage. Les 2 corrections habituellement tentées en premier sont un User-Agent Chrome et l’imitation TLS. Les deux donnent toujours un 403. Ce guide montre ce qui change le 403, ce que robots.txt bloque, et quels problèmes d’extraction corrompent un jeu de données Etsy sans générer d’erreur.
En bref
- Etsy utilise DataDome derrière Fastly. DataDome place un score de risque dans son propre en-tête de réponse. Vous pouvez noter une requête avant même d’écrire un crawler.
- Etsy a refusé les 9 transports testés. Un navigateur avec interface a chargé la première page en 2,2 secondes. Etsy a refusé la deuxième requête.
- robots.txt interdit la recherche par mot-clé et l’historique des ventes, et ne déclare aucun sitemap. Les pages d’annonces et de boutiques restent accessibles. Mais les conditions d’Etsy sont plus strictes.
- La devise et le prix suivent l’IP de sortie. Notre échantillon de jeu de données comptait 19 devises. Une moyenne non filtrée de cette colonne était 227x trop élevée.
Ce qu’Etsy renvoie à une requête automatisée
Lisez d’abord le refus. Ne refaites pas la requête. Une requête simple vous indique quel fournisseur fonctionne en périphérie et comment ce fournisseur vous a noté. N’importe quelle URL d’annonce fonctionne. Celle-ci appartient à un vendeur, elle a donc peut-être déjà disparu :
curl -sD - -o /dev/null https://www.etsy.com/listing/753913297/smoky-quartz-ring-rose-gold-ring-womenLe serveur renvoie un 403 avec ces en-têtes :
HTTP/2 403
server: DataDome
x-datadome: protected
x-datadome-riskscore: 0.9230727100377928
accept-ch: Sec-CH-UA,Sec-CH-UA-Mobile,Sec-CH-UA-Platform,Sec-CH-UA-Arch,Sec-CH-UA-Full-Version-List,Sec-CH-UA-Model,Sec-CH-Device-Memory
set-cookie: datadome=ovuDEZ4S0taK1jDAOvZ9W3Uq2qUujN_iPPE3uXp7~r3msKXSvMFPp4j30em5IvR0...
via: 1.1 varnish
x-served-by: cache-del-vibw2260027-DEL
Ce blocage contient 3 faits. Etsy utilise DataDome, et non l’Akamai Bot Manager encore mentionné dans d’anciens guides, prévoyez donc en fonction des couches de détection de DataDome. Fastly fonctionne devant Etsy, et les en-têtes Via et X-Served-By montrent ce relais. X-DataDome-riskscore est le score de DataDome mesurant à quel point la requête ressemblait à un bot, sur une échelle où 1,0 est le pire. Etsy peut changer de fournisseur, relancez donc la commande avant de planifier en fonction de ces 3 faits.
Cet en-tête vous donne un chiffre mesurable. Dans nos tests, le score était déterministe. Les 6 échantillons entrelacés de la même requête ont tous renvoyé 0.9230727100377928. Le score suit la signature de la requête, l’IP appelante et le cookie datadome une fois que vous en recevez un, et non un compteur cumulé de requêtes. Vos propres chiffres peuvent donc différer, et sur une autre adresse le classement entre configurations clients peut aussi différer.
Le corps, 776 octets dans nos essais, est une page de blocage DataDome qui charge ct.captcha-delivery.com/c.js. Cette page de blocage contient un script de challenge, pas de données d’annonce, donc un parseur qui la lit renvoie des champs vides plutôt qu’une erreur. La configuration intégrée contenait 't':'fe', le contrôle d’appareil de DataDome, donc cette requête a reçu un challenge qu’un vrai navigateur peut résoudre plutôt qu’un bannissement permanent. Le champ 't' indique la note actuelle et prend d’autres valeurs selon cette note, lisez donc votre propre valeur plutôt que de supposer 'fe'.
Nous avons envoyé chaque requête depuis 1 client minimal à 3 en-têtes et varié uniquement le chemin. Chaque chemin de contenu testé a renvoyé le même 403 et le même score 0,482, tandis que /robots.txt et une URL qui ne résout rien sont allés vers Apache sans protection :
path                                       HTTP server     riskscore
/                                          403  DataDome   0.482
/listing/753913297/smoky-quartz-ring...    403  DataDome   0.482
/shop/AnemoneJewelry                       403  DataDome   0.482
/legal/terms/                              403  DataDome   0.482
/robots.txt                                200  Apache     -
/nonexistent-path-xyz                      404  Apache     -
Donc sur les chemins protégés par DataDome, c’est l’appelant qui est noté, pas l’URL.
Une requête avec un User-Agent Googlebot a contourné DataDome et atteint un limiteur de débit à la place. Apache a répondu 429 Too Many Requests avec une chaîne de référence nicki_. Au moins 1 agent déclaré de moteur de recherche atteint son propre limiteur de débit, séparé de DataDome.
Pourquoi les empreintes d’en-têtes et TLS ne suffisent pas
Le score de risque permet de tester les conseils habituels sur les en-têtes, où un chiffre plus bas signifie moins ressemblant à un bot. Nous avons gardé l’IP et l’URL constantes, varié uniquement les en-têtes de requête sur un client requests, et enregistré le score renvoyé par DataDome :
headers sent                                         score    HTTP
requests, library default headers                    0.977    403
+ Chrome User-Agent only                             0.923    403
full 12-header Chrome set                            0.503    403
User-Agent + accept + sec-fetch-site (3 headers)     0.482    403
Ce tableau contient 2 résultats. Ajouter un User-Agent Chrome n’a presque pas changé la note, car tout le reste de la requête venait toujours de requests. Et le jeu à 3 en-têtes a obtenu un meilleur score que le jeu complet à 12 en-têtes, donc sur cette cible, la cohérence comptait plus que le nombre d’en-têtes.
Ces 3 en-têtes ont obtenu 0,482, copiez donc exactement la valeur accept :
User-Agent:      Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36
                 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36
accept:          text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,
                 image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
sec-fetch-site:  none
Nous avons retiré 1 en-tête à la fois du jeu complet et enregistré chaque changement, un signe plus signifiant que le score s’est dégradé :
run                              score     change
full set (baseline)              0.503
minus accept                     0.845     +0.342
minus user-agent                 0.784     +0.281
minus sec-fetch-site             0.669     +0.166
minus every sec-ch-ua* header    0.503      0.000
DataDome annonce 7 indices client dans son propre en-tête de réponse Accept-CH. Notre jeu complet en contenait 3, mais retirer tous les en-têtes sec-ch-ua n’a rien changé. L’en-tête accept a fait plus bouger le score que le User-Agent.
L’imitation TLS est l’étape suivante habituelle, nous l’avons donc testée seule. Chaque essai envoyait les mêmes 3 en-têtes, seule l’empreinte TLS et HTTP/2 changeait. Les valeurs JA4 ci-dessous viennent de curl_cffi plutôt que d’Etsy, elles changent donc à chaque mise à jour du profil par cette bibliothèque :
transport                             JA4                      riskscore  HTTP
python requests (OpenSSL, HTTP/1.1)   t13d1712h1_ab0a1bf427ad  0.482      403
curl_cffi impersonate=chrome110       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome116       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome124       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome131       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome133a      t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=firefox133      t13d1716h2_5b57614c22b0  0.503      403
curl_cffi impersonate=safari17_0      t13d2014h2_a09f3c656075  0.663      403
curl_cffi impersonate=safari17_2_ios  t13d2014h2_a09f3c656075  0.663      403
Ce tableau contient 3 empreintes différentes, une pour chacun de Chrome, Firefox et Safari. Le simple requests en HTTP/1.1 a toujours obtenu un meilleur score que les 3. Cette colonne n’affiche que les 2 premières parties d’un JA4. La troisième partie encode la liste d’extensions et diffère entre les profils Chrome qui partagent ici un préfixe.
Le transport a fait varier le score de 0,181 entre le meilleur et le pire essai, mais aucun essai n’a renvoyé de page. Aucune empreinte testée n’a suffi seule.
Les empreintes TLS ne valent donc pas l’effort sur cette cible. Nous avons relu les trames HTTP/2 de chaque profil, y compris l’ordre des pseudo-en-têtes qui diffère selon le moteur :
profile      SETTINGS                       | window   | pri | pseudo-header order
chrome131    1:65536;2:0;4:6291456;6:262144 | 15663105 | 0   | m,a,s,p
firefox133   1:65536;2:0;4:131072;5:16384   | 12517377 | 0   | m,p,a,s
safari17_0   2:0;4:4194304;3:100            | 10485760 | 0   | m,s,p,a
Ces 3 handshakes sont des copies correctes, et Etsy a refusé les 3. DataDome décide donc selon autre chose que le handshake.
Ce qui exécute réellement le contrôle
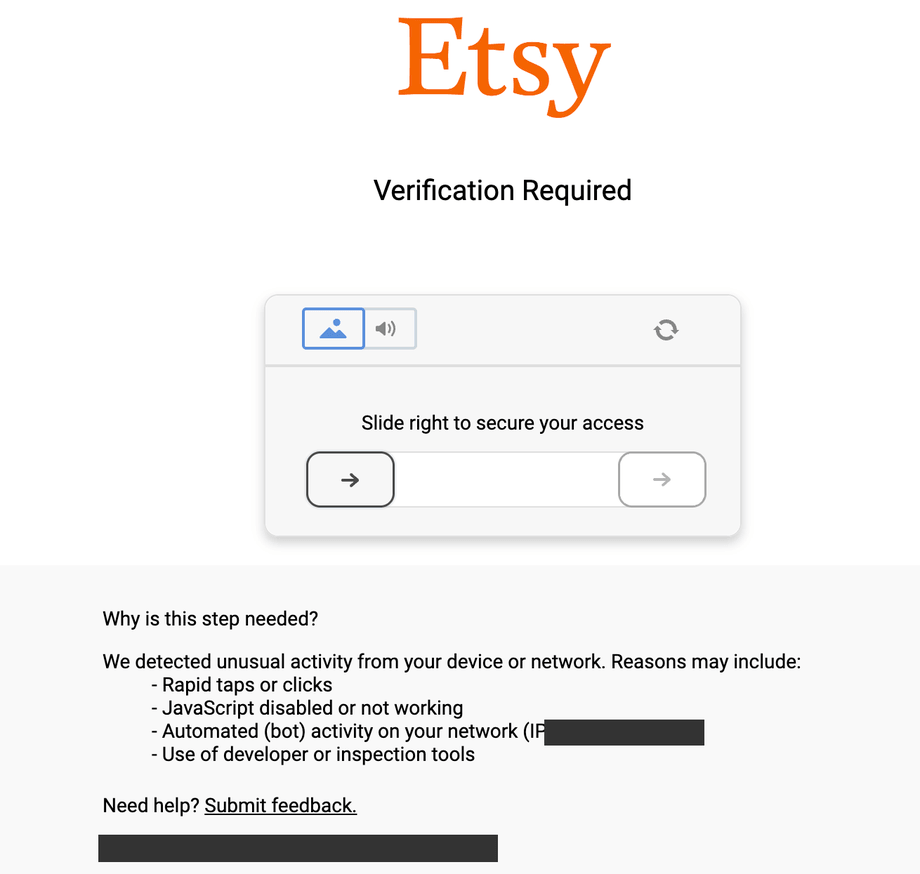
Dans un navigateur avec interface, le challenge DataDome s’affiche comme un curseur, et 2 de ses 4 raisons sont l’IP appelante et l’utilisation d’outils de développement :
Ce chargeur c.js fait 14 Ko, construit une URL d’iframe et récupère une deuxième page. Cette deuxième page contenait un script inline de 596 Ko le jour où nous l’avons récupérée, et les noms de ses modules montrent ce qu’il faudrait réimplémenter :
detection-js/dist/vm-obf.js     the detection engine, VM-obfuscated
detection-js/dist/captcha.js    challenge coordination
./picasso                       canvas-based device-class fingerprinting
./mouseMaths                    pointer-movement analysis
./slidercaptcha  ./hash  ./helpers  ./bean
Le module de détection est stocké en bytecode pour un interpréteur embarqué dans le même fichier. C’est pourquoi une recherche textuelle du bundle ne trouve ni webdriver, ni cdc_, ni headless, ni _phantom. Un bundle en bytecode masque ces chaînes, que les sondes s’exécutent ou non, donc ce résultat de recherche ne vous apprend rien.
La version récupérée s’identifiait comme 1.34.0, chronométrait sa propre exécution, et envoyait cette durée comme signal. Cette version a aussi affiché un avertissement console vous demandant de fermer les DevTools avant de continuer. Attendez-vous à une version différente et une liste de modules différente au moment où vous regarderez, car ce moteur suit le cycle de version de DataDome plutôt que celui d’Etsy. L’architecture derrière ces noms change bien plus lentement.
La requête de vérification comporte 16 champs et encode l’environnement du navigateur dans userEnv, ddCaptchaEnv et plv3.
Il y a donc 2 conclusions pratiques. Reproduire cette sortie depuis requests signifie réimplémenter une VM obfusquée contre une chaîne de version qui s’incrémente. Et DataDome collecte la sortie canvas et le mouvement du curseur, qui n’existent qu’après qu’un vrai moteur de navigateur a rendu la page. Le déblocage spécifique à DataDome exécute ce moteur de navigateur en service et est conçu pour renvoyer la page rendue plutôt que le blocage.
Cette seconde conclusion est testable, nous avons donc exécuté un simple Chromium Playwright sans patch furtif ni proxy. Chaque mode a tourné 3 fois depuis la même adresse sur laquelle tous les transports ci-dessus avaient été refusés :
headless=True (default)        403  403  403     1,530 B    0.5s
headless=True --headless=new   403  403  403     1,530 B    0.4s
headless=False (headed)        200  200  200   532,049 B    2.2s   Product JSON-LD present
Les deux fenêtres ont tourné depuis 1 machine sans proxy, donc la fenêtre avec interface affiche les prix en devise locale :
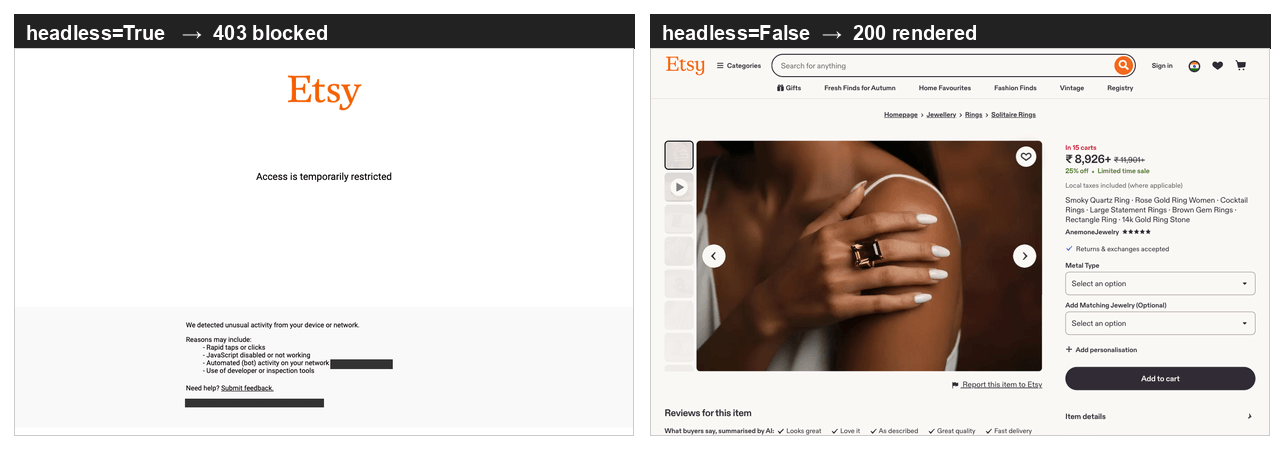
Chromium headless inclut HeadlessChrome dans son propre User-Agent, donc ces lignes diffèrent sur plus que la fenêtre. Pour vérifier une page manuellement, ou récupérer quelques pages, un navigateur avec interface est la réponse la plus simple. L’infrastructure de déblocage est conçue pour les requêtes après la première, et pour une seule récupération, une exécution avec interface est environ 10 fois plus rapide qu’en passant par elle.
Pourquoi un navigateur seul n’est pas un crawler
Nous avons chargé 12 annonces une par une dans une seule page de navigateur, à 2 secondes d’intervalle, et obtenu 1 succès et 11 refus :
#1   200   444,123 B
#2   403     1,527 B
#3-12 403   ~1,530 B each
Abandonner le contexte de navigation entre les navigations a restauré le 200, donc les refus venaient de l’état de session plutôt que de l’adresse. Plus tard dans la même période de test, cette correction a cessé de fonctionner. Etsy a alors refusé chaque requête depuis cette adresse, peu importe la nouveauté du contexte.
Le score de risque n’a pas bougé alors que le taux de succès passait de toutes les requêtes à aucune. L’essai à 3 en-têtes mesurait toujours 0.4822 à 4 décimales près, des heures et plusieurs centaines de requêtes après la première lecture.
L’en-tête X-DataDome-riskscore note 1 requête à la fois, il est donc utile pour tester 1 changement, mais pas pour surveiller un crawl. Un pipeline qui le surveille rapportera un succès tout en ne collectant rien.
Collecter plus de quelques pages nécessite 2 choses, un nouveau contexte de navigation et une adresse que DataDome n’a pas déjà refusée. Abandonner le contexte entre les navigations est peu coûteux, commencez donc par là, mais cette correction ne dure que jusqu’à ce que DataDome refuse l’adresse. Les proxys résidentiels vous donnent un pool d’adresses à faire tourner.
Web Unlocker gère les deux, et le script plus bas reste dans le quota gratuit. Browser API gère les deux à l’intérieur d’un navigateur hébergé que votre code Playwright pilote.
Ce que robots.txt et les conditions Etsy n’autorisent pas
Avant de construire quoi que ce soit, lisez vous-même le robots.txt d’Etsy, car le fichier interdit la recherche par mot-clé et Etsy le réécrit sans préavis. Quand nous l’avons lu, ce fichier faisait 1 818 lignes et ne déclarait que 3 groupes de user-agent, *, AdsBot-Google-Mobile et Spinn3r :
User-agent: *
Disallow: /search?*q=
Disallow: /search/?*q=
Disallow: */shop/*/sold*
Disallow: */listing/*/favoriters*
Disallow: /api/
Allow:    /search/shops
Le groupe générique interdit les résultats de recherche par mot-clé dans toutes les variantes de locale. Ce groupe couvre tout crawler non nommé par les 2 autres groupes. L’historique des annonces vendues et le nombre de favoris sont aussi interdits, et ce sont parmi les signaux de demande les plus clairs publiés par Etsy. Les pages d’annonces et de boutiques n’ont aucune règle Disallow, elles restent donc accessibles.
Le fichier ne déclare aucune directive Sitemap:, et /sitemaps.xml répond 403 avec un corps vide. Ces 2 absences comptent autant que les règles Disallow ci-dessus. Les deux sont des vérifications d’1 ligne à répéter, car Etsy peut réajouter l’une ou l’autre sans préavis. Tant qu’elles restent absentes, vous devez découvrir les annonces depuis les pages qu’Etsy laisse ouvertes.
Etsy ne nommait aucun crawler IA dans le fichier à notre lecture, et ne publiait ni llms.txt ni ai.txt. Cette absence est l’élément le plus susceptible d’avoir changé dans cette section depuis notre vérification.
DataDome refuse ces crawlers en périphérie quoi qu’il en soit. GPTBot et ClaudeBot ont tous deux reçu un 403, et tous deux ont obtenu un score de 0,9814 dans notre test, plus élevé que les 0,923 obtenus par la même adresse avec un User-Agent Chrome. Des chaînes User-Agent absurdes avec les mêmes en-têtes ont obtenu le même score, donc DataDome note l’absence d’un navigateur connu plutôt que le nom du crawler.
Les conditions d’utilisation d’Etsy, mises à jour pour la dernière fois le 26 août 2025, indiquent que vous acceptez de « ne pas crawler, scraper ou utiliser de spider sur une page quelconque des Services » sans autorisation expresse.
Vérifiez si votre couche de collecte applique robots.txt pour vous, et à quel moment elle décide. Le point de terminaison de déblocage résidentiel décide par requête. Sur un compte sans KYC complété, une requête pour le chemin de recherche interdit renvoie la règle et le formulaire KYC :
Residential Failed (bad_endpoint): Requested site is not available for immediate
residential (no KYC) access mode in accordance with robots.txt. To get full
residential access for targeting this site, fill in the KYC form:
https://brightdata.com/cp/kyc
Le même compte a récupéré /shop/AnemoneJewelry sans erreur, et la réponse faisait 983 937 octets. Le point de terminaison lit le même robots.txt que vous, puis sert les chemins autorisés et achemine les chemins interdits vers une revue de conformité plutôt que vers un proxy. Décidez si votre cas d’usage nécessite les chemins interdits avant de commencer à construire.
Si vous construisez vous-même la couche de récupération, vous prenez cette décision dans le code, et vous possédez et maintenez la gestion de robots.txt par cible.
Ce que l’API officielle d’Etsy renvoie, et ce qu’elle omet
L’API est le chemin autorisé, vérifiez donc ce qu’elle fait avant de la rejeter. Le choix entre une API officielle et le scraping est général, et sur Etsy il dépend des champs que la spécification omet. Nous avons récupéré directement la spécification OpenAPI et compté 76 chemins, dont 31 opérations GET nécessitent seulement une clé d’application et aucun OAuth vendeur. Ces totaux évoluent chaque fois qu’Etsy ajoute ou retire un point de terminaison, recomptez donc depuis ce fichier plutôt que depuis ce paragraphe.
Les affirmations courantes sur l’API v3 sont fausses sur 3 points. findAllListingsActive n’a pas été retiré, et accepte keywords, min_price, max_price, taxonomy_id, shop_location, currency et buyer_country, avec un limit maximum de 100 par appel. getReviewsByListing et getReviewsByShop renvoient le texte des avis avec une simple clé d’application. getShop renvoie transaction_sold_count, review_count, review_average, num_favorers et listing_active_count pour n’importe quelle boutique.
La spécification porte 1 champ de demande et omet le reste. getListing ne nécessite qu’une clé d’application et renvoie views, un compteur de vues cumulatif actualisé une fois par jour, dans le schéma ShopListingWithAssociations. Rechercher dans tout le document ne trouve aucun champ pour le volume de recherche, les impressions, le taux de conversion ou les ventes par annonce. Le schéma ShopListing comptait 50 propriétés à notre décompte, dont num_favorers, quantity et price, et aucune n’était un compteur de ventes. Revérifiez ce chiffre par rapport à la spécification, mais aucun champ de vente n’est encore apparu.
Les transactions par annonce ont bien un point de terminaison, getShopReceiptTransactionsByListing, mais il nécessite le scope OAuth transactions_r, que seul un propriétaire de boutique peut accorder pour sa propre boutique. Pour toute boutique que vous n’exploitez pas, Etsy publie les ventes à vie au niveau boutique comme un total actuel sans historique, et rien par annonce.
Cet écart explique le marché d’outils tiers autour d’Etsy. Certains produits vendent des estimations de ventes par annonce ou de volume de recherche par mot-clé pour des boutiques qu’ils n’exploitent pas. Rien dans la spécification que nous avons lue ne renvoie ces chiffres pour une boutique que vous ne possédez pas, ces données doivent donc venir de l’extérieur de cette API.
Etsy applique des limites de débit par clé d’application, par seconde et par jour. Les en-têtes de réponse x-limit-per-second et x-limit-per-day rapportent les deux, et Etsy renvoie un 429 avec un retry-after quand vous dépassez l’une ou l’autre.
La page des limites de débit étiquette ses chiffres « Example Value » plutôt que valeurs par défaut. L’ancienne paire « 10 000 par jour, 10 par seconde » avait disparu de cette page à notre lecture. Lisez vos propres limites depuis le Developer Portal.
Scraper les pages d’annonces et de boutiques Etsy avec Python
Les pages d’annonces Etsy intègrent du JSON-LD schema.org, donc l’étape d’extraction ne nécessite aucun sélecteur CSS et ne casse pas quand Etsy restyle le balisage autour. L’étape de récupération nécessite une infrastructure, et vous avez 2 façons de procéder. Une API débloquée fonctionne partout et nécessite un compte. Un navigateur local ne nécessite aucun compte et convient pour quelques pages.
Le script ci-dessous nécessite 1 bibliothèque et 2 variables d’environnement :
python3 -m venv .venv && source .venv/bin/activate
pip install requests
export BRIGHTDATA_API_KEY="your-api-token"
export BRIGHTDATA_ZONE="web_unlocker"
Le jeton provient du panneau de contrôle Bright Data. Chaque requête avec ce jeton dépense le solde de votre compte, gardez-le donc dans une variable d’environnement plutôt que dans un script versionné.
Vous créez la seconde valeur sous Web Access → Add API → Web Unlocker API. La charge utile de la requête l’appelle une zone, mais le panneau de contrôle l’étiquetait comme une API quand nous l’avons configuré, donc rechercher « zone » dans le panneau ne trouvait rien. BRIGHTDATA_ZONE doit correspondre au nom que vous saisissez là, puisque le script utilise par défaut web_unlocker. Le formulaire avertit que le nom est permanent :
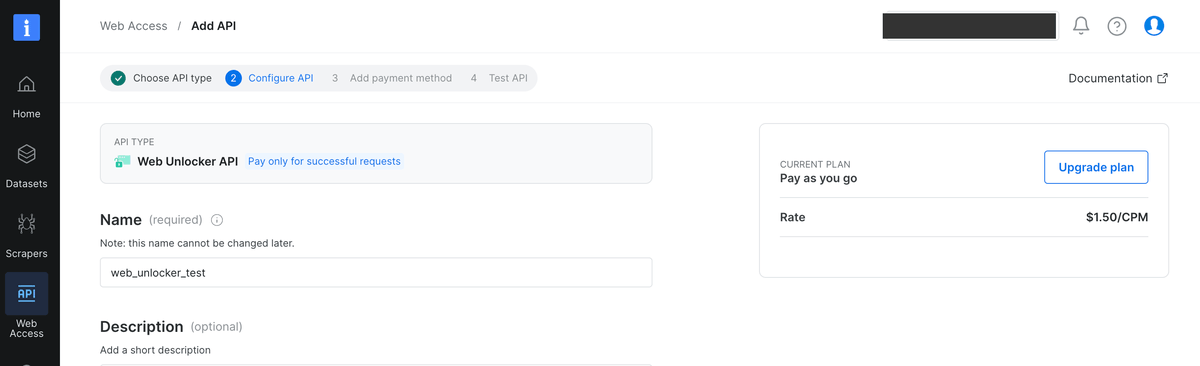
La zone dans cette capture est nommée web_unlocker_test, donc la valeur par défaut du script la manquerait. Soit définissez BRIGHTDATA_ZONE au nom que vous avez saisi, soit utilisez web_unlocker et laissez la valeur par défaut telle quelle. Le guide de démarrage rapide Web Unlocker documente les deux, et nous avons commencé avec le quota gratuit sans carte quand nous avons configuré ceci. La page de tarification Web Unlocker liste le quota gratuit actuel et le tarif paiement à l’utilisation au-delà, indiqué pour 1K requêtes réussies. Le panneau écrit ce tarif en CPM.
Ce script envoie la requête via le point de terminaison Web Unlocker et analyse le résultat :
import json
import os
import re
import requests

API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
ZONE = os.environ.get("BRIGHTDATA_ZONE", "web_unlocker")
ENDPOINT = "https://api.brightdata.com/request"

LD_JSON = re.compile(
    r'<script[^>]*type\s*=\s*[\'"]application/ld\+json[\'"][^>]*>(.*?)</script\s*>',
    re.S | re.I,
)


def fetch_html(url, country="us"):
    """Return the rendered HTML for an Etsy URL, or raise on failure."""
    # Checked here rather than at import, so the browser path below runs
    # without an account.
    if not API_KEY:
        raise SystemExit("BRIGHTDATA_API_KEY is not set, see the exports above")
    response = requests.post(
        ENDPOINT,
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": country},
        timeout=90,
    )
    response.raise_for_status()
    body = response.text
    # A quota error arrives as HTTP 200 with a short text body, and a block page
    # arrives as HTTP 200 of valid HTML. Neither contains ld+json, which is the
    # content this actually wants, so test for that rather than for either error.
    if not LD_JSON.search(body):
        raise RuntimeError(f"no ld+json in response, most likely blocked: {body[:200]!r}")
    return body


def product_jsonld(html):
    """Pick the Product block by @type. Every listing we opened had four."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "Product":
                return node
    return None


def parse_listing(node):
    """Flatten a Product node, keeping the offer's range rather than its lowest price."""
    offer = node.get("offers", {})
    # schema.org allows a list of offers and a single priceSpecification object,
    # and Etsy serves both, so normalize before indexing into them.
    if isinstance(offer, list):
        offer = offer[0] if offer else {}
    specs = offer.get("priceSpecification", [])
    if isinstance(specs, dict):
        specs = [specs]
    base = next((s for s in specs if "priceType" not in s), {})
    was = next(
        (s for s in specs if "Strikethrough" in str(s.get("priceType", ""))), {}
    )
    # Not every listing carries a priceSpecification. Without this fallback a
    # single-variant listing records a null price and raises nothing.
    # A range arrives three ways: nested in priceSpecification, as AggregateOffer's
    # own lowPrice and highPrice, or not at all. Try them in that order.
    low = base.get("minPrice") or offer.get("lowPrice") or offer.get("price")
    high = base.get("maxPrice") or offer.get("highPrice") or offer.get("price")
    # availability is the only field that marks a dead listing, and JSON-LD lets it
    # arrive as a bare term, an array, or an @id object. Normalize before comparing.
    avail = offer.get("availability") or ""
    if isinstance(avail, list):
        avail = avail[0] if avail else ""
    if isinstance(avail, dict):
        avail = avail.get("@id", "")
    rating = node.get("aggregateRating", {})
    return {
        "sku": node.get("sku"),
        "title": node.get("name"),
        # Etsy serves a dead listing as a full HTTP 200 page that still
        # carries a price, so availability is the only field that says so.
        "availability": str(avail).rsplit("/", 1)[-1],
        "currency": offer.get("priceCurrency"),
        "price_min": low,
        # high can be a bundle maximum rather than the item's, where a listing
        # has an add-on axis. Count the axes before trusting it as a maximum.
        "price_max": high,
        "list_price": was.get("price"),
        # True only where the variations differ in price. Same-price variants
        # read false, so this is a price-spread test, not a variation test.
        "has_variations": None if low is None else low != high,
        "rating": rating.get("ratingValue"),
        "review_count": rating.get("reviewCount"),
        "shop": node.get("brand", {}).get("name"),
    }


if __name__ == "__main__":
    url = (
        "https://www.etsy.com/listing/753913297/"
        "smoky-quartz-ring-rose-gold-ring-women"
    )
    node = product_jsonld(fetch_html(url, country="us"))
    if node is None:
        raise SystemExit("no Product block on page: blocked, or the layout changed")
    print(json.dumps(parse_listing(node), indent=2))
Nous avons exécuté le script sur une annonce active, et il a renvoyé un enregistrement aplati. La fourchette de prix vient d’1 annonce avec de nombreuses variations à prix séparés :
{
  "sku": "753913297",
  "title": "Smoky Quartz Ring · Rose Gold Ring Women · Cocktail Rings · ...",
  "availability": "InStock",
  "currency": "USD",
  "price_min": "89.25",
  "price_max": "5613.75",
  "list_price": "119.00",
  "has_variations": true,
  "rating": "4.5",
  "review_count": 99,
  "shop": "AnemoneJewelry"
}
Sur 3 exécutions sur la même annonce, les récupérations ont pris 23 à 27 secondes et renvoyé entre 540 Ko et 750 Ko. Ces chiffres sont le coût de l’étape de déblocage. Budgétez une latence dans cette fourchette plutôt que le timing sub-seconde d’un blocage.
Si vous avez seulement besoin de quelques pages et préférez ne pas ouvrir de compte, un navigateur local atteint le même résultat avec à peu près le même volume de code. Ce navigateur fonctionne depuis une adresse que DataDome n’a pas déjà refusée. Il nécessite un affichage, donc sur un serveur exécutez-le avec interface sous un affichage virtuel comme Xvfb plutôt qu’en mode headless. Installez Playwright et Chromium une fois :
python3 -m venv .venv && source .venv/bin/activate   # skip if already active
pip install playwright requests
playwright install chromium
Puis remplacez la récupération, en gardant les 2 mêmes fonctions d’analyse. Placez ceci au-dessus du bloc __main__, avec les autres fonctions :
from playwright.sync_api import sync_playwright


def fetch_html_browser(url):
    """Fetch one page with a visible browser, since headless returns a 403."""
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=False)
        context = browser.new_context(locale="en-US")
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        html = page.content()
        browser.close()
        # Same rule as the guard above: test for the content you want. A block
        # page is valid HTML, so only the missing ld+json shows it.
        if not LD_JSON.search(html):
            raise RuntimeError("no ld+json on page, most likely a block page")
        return html
Changez 1 ligne à l’intérieur du bloc __main__, et rien d’autre :
node = product_jsonld(fetch_html_browser(url)) # was: fetch_html(url, country="us")Notre exécution a renvoyé 535 247 octets et s’est analysée proprement via les 2 mêmes fonctions. La page était aussi tarifée en INR, car un navigateur sur votre machine sort depuis votre propre adresse, et le chemin navigateur ne prend aucun argument country. Sans cet argument, vous ne pouvez pas définir le pays de sortie, ce chemin convient donc à quelques pages plutôt qu’à un jeu de données.
Le code ci-dessus analyse la page plutôt que de l’envoyer à un modèle. Etsy publie les champs en données structurées, donc les lire est déterministe et pratiquement gratuit. Sur l’annonce mesurée, sélectionner le bloc Product et l’aplatir prend une médiane de 0,3 milliseconde.
Confier la même page à un modèle de langage à la place signifie 179 599 jetons de HTML brut, soit la majeure partie d’une fenêtre de contexte de 200K jetons pour 1 produit. Retirer d’abord le balisage réduit cela à 5 352 jetons, une réduction de 97 %. Ce ratio compte plus que le choix du modèle.
Mais un parseur qui cesse de correspondre renvoie un champ vide plutôt qu’une erreur, tandis qu’un modèle produirait au moins quelque chose de faux et visible. Privilégiez donc le chemin déterministe sur un site qui publie du schema.org. Utilisez le temps économisé pour vérifier que le parseur renvoie toujours les champs attendus.
Les pages de boutique ont aussi 4 de ces blocs, sous des types différents, et l’un d’eux montre d’où viennent les URL d’annonces. /shop/{shop_name} renvoie un nœud Organization décrivant la boutique et un nœud ItemList dont itemListElement contient les URL complètes des annonces. shop_itemlist sélectionne l’ItemList par @type, donc la même fonction avec Organization à la place renvoie les propres champs de la boutique. Sur la boutique testée, numberOfItems indiquait 1 842 alors qu’une seule page renvoyait 36 URL, et ?page=2 en renvoyait 36 de plus sans chevauchement.
L’énumérateur prend un nom de boutique en entrée, vous avez donc besoin d’une source de noms de boutiques, et 3 sources fonctionnent sans toucher au chemin de recherche interdit. Vous pouvez utiliser des boutiques déjà suivies, le point de terminaison findAllListingsActive ci-dessus, ou un jeu de données préparé. Ce point de terminaison prend keywords avec une simple clé d’application, et inclut un shop_id sur chaque annonce renvoyée.
Nous avons récupéré des pages sur toute la plage et au-delà de la fin déclarée :
page  2    36 items
page 25    36 items
page 51    36 items
page 52     6 items      51 x 36 + 6 = 1,842
page 53    no ItemList block
page 60    no ItemList block
Le total correspond aux 1 842 déclarés par la boutique. Au-delà de la fin, Etsy continue de répondre avec une page complète d’environ 420 Ko et sans ItemList.
Etsy ne renvoie aucune erreur ni tableau vide sur lequel s’arrêter, donc une boucle qui attend l’un ou l’autre continuera indéfiniment la pagination sur des pages d’apparence normale. Arrêtez-vous plutôt sur le bloc manquant, et laissez le total déclaré vérifier votre travail. Les modèles habituels pour la collecte paginée supposent l’un de ces 2 signaux, ils ne s’appliquent donc pas ici.
Les deux fonctions vont dans le même fichier que les fonctions précédentes, car elles utilisent LD_JSON et fetch_html. Commentez le point d’entrée que vous n’exécutez pas, car l’énumérateur prend 20 minutes :
def shop_itemlist(html):
    """Pick the ItemList block. The first block on a shop page is a video."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "ItemList":
                return node
    return None


def enumerate_shop(shop_name, country="us"):
    """Page a shop until the ItemList stops appearing, and hand back the declared
    count so the caller can check it."""
    base = f"https://www.etsy.com/shop/{shop_name}"
    urls, declared, page = [], None, 1
    while True:
        suffix = "" if page == 1 else f"?page={page}"
        try:
            node = shop_itemlist(fetch_html(base + suffix, country=country))
            if node is None:
                break
            declared = node.get("numberOfItems", declared)
            urls += [item["item"]["url"] for item in node["itemListElement"]]
        except (RuntimeError, requests.RequestException, KeyError, TypeError,
            AttributeError) as err:
            print(f"stopped at page {page}: {err}", flush=True)
            break
        print(f"page {page}: {len(urls)} of {declared}", flush=True)
        # Breaking on the declared count here would make the comparison below
        # vacuous, so page until the ItemList block stops appearing.
        page += 1
    return urls, declared


if __name__ == "__main__":
    urls, declared = enumerate_shop("AnemoneJewelry")
    print(len(urls), "collected,", declared, "declared")
L’énumérateur effectue 53 récupérations sur les pages mesurées ci-dessus, renvoie 1 842 URL, et vérifie le total par rapport au compte déclaré par la boutique. Comparez ces 2 chiffres à chaque exécution, car une lecture incomplète renvoie moins d’URL sans générer d’erreur.
Le try doit couvrir l’analyse autant que la récupération. Une boucle de 53 requêtes est assez longue pour recevoir la réponse de limitation de débit, et un seul itemListElement malformé fait les mêmes dégâts qu’une requête échouée. Sans la protection, l’un ou l’autre lève une exception à la page 30 et écarte toutes les URL collectées jusque-là. Capturer les deux vous laisse avec une lecture incomplète plutôt qu’une exécution perdue, et la comparaison de compte le montre. La gestion des requêtes échouées en Python suit un modèle standard, et la seule partie spécifique à Etsy consiste à placer l’analyse dans la protection.
À la latence mesurée ci-dessus, 53 récupérations représentent 20 à 24 minutes et 53 requêtes sur le quota mensuel gratuit, pour 1 boutique. Exécutez d’abord l’énumérateur sur une petite boutique et observez le compte de pages augmenter avant de l’utiliser sur une boutique avec 1 842 annonces. Définissez aussi une limite d’utilisation sur la zone, afin qu’une exécution défaillante s’arrête à un plafond plutôt qu’à votre solde.
Nous avons exécuté la même découverte via le point de terminaison boutique Etsy de la Web Scraper API comme job par lot. Nous avons exécuté le job sur la boutique plutôt que sur des URL d’annonces, et limité à 50 enregistrements pour la comparaison. Il a renvoyé 50 annonces en 168,9 secondes, soit environ 3,4 secondes par enregistrement, sans doublons ni URL préfixées par locale dans cette exécution.
Collecter toute cette boutique nécessite 53 récupérations d’énumération plus 1 842 récupérations d’annonces, soit 1 895 requêtes et environ 13 heures en mono-thread. Vérifiez ces 1 895 par rapport au quota gratuit actuel avant de commencer. Au-delà de ce quota, le même travail est facturé au tarif paiement à l’utilisation par 1K requêtes réussies.
Fixez aussi country ici. Nous avons récupéré la même boutique sans ce paramètre et obtenu des URL /de/listing/ et des titres en allemand. Ces URL entreraient dans un jeu de données comme clés différentes pour des articles déjà stockés sous leur forme /listing/.
Problèmes d’extraction qui corrompent silencieusement un jeu de données Etsy
Chaque problème ici renvoie un HTTP 200 et ne lève aucune exception. Sur les 5, 4 écrivent une ligne plausible mais fausse et le cinquième écrit une ligne vide. À la place, vous découvrez un chiffre erroné des mois plus tard. Les métriques de qualité des données détectent ce genre d’échec après le stockage des données, et ne pas écrire la ligne défectueuse coûte moins cher.
Une page d’annonce a 4 blocs JSON-LD, pas 1. Etsy incluait Product, VideoObject, BreadcrumbList et FAQPage dans 4 balises script séparées sur chaque annonce ouverte, toutes du type application/ld+json. Le code source de la page les montre sur 4 lignes consécutives :
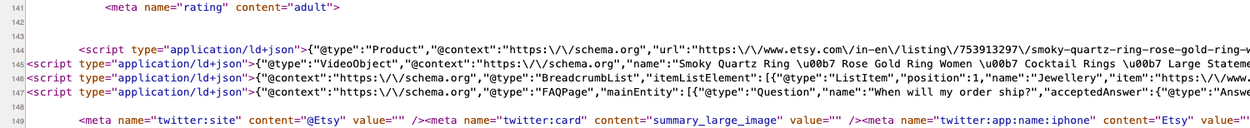
Un code qui appelle find() et prend la première correspondance fonctionne sur les pages d’annonces et renvoie silencieusement le bloc vidéo sur les pages de boutiques. Sélectionnez par @type plutôt que par position. Rien d’autre dans la mécanique de l’analyse JSON en Python ne change.
Une page de boutique a aussi 4 blocs, dans un ordre différent :
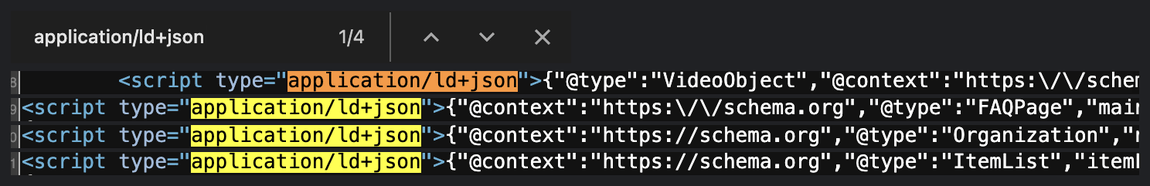
Sur la boutique testée, le premier bloc est une vidéo et l’ItemList recherché est le dernier, donc prendre la première correspondance échoue. Le script ci-dessus sélectionne plutôt par @type.
Sur une annonce avec variations, offers.price est le prix le plus bas de la fourchette, pas toute la fourchette. Sur l’annonce testée, offers.price indiquait 89.25 alors que l’entrée priceSpecification imbriquée dans offers déclarait minPrice 89.25 et maxPrice 5613.75. Un parseur qui lit offers.price enregistre la variation la moins chère et abandonne la fourchette. Stocker maxPrice à la place n’est pas non plus la solution, car sur cette annonce maxPrice est le prix d’un lot plutôt que de l’article seul.
Nous avons collecté la même URL avec les variations activées et obtenu 61 enregistrements séparés, 1 par variante, tarifés de 89,25 à 1 871,25. Une seule ligne d’annonce dans votre table représente 61 SKU achetables sur une fourchette de prix de 21x.
Un second menu déroulant sur la page multiplie cette fourchette :
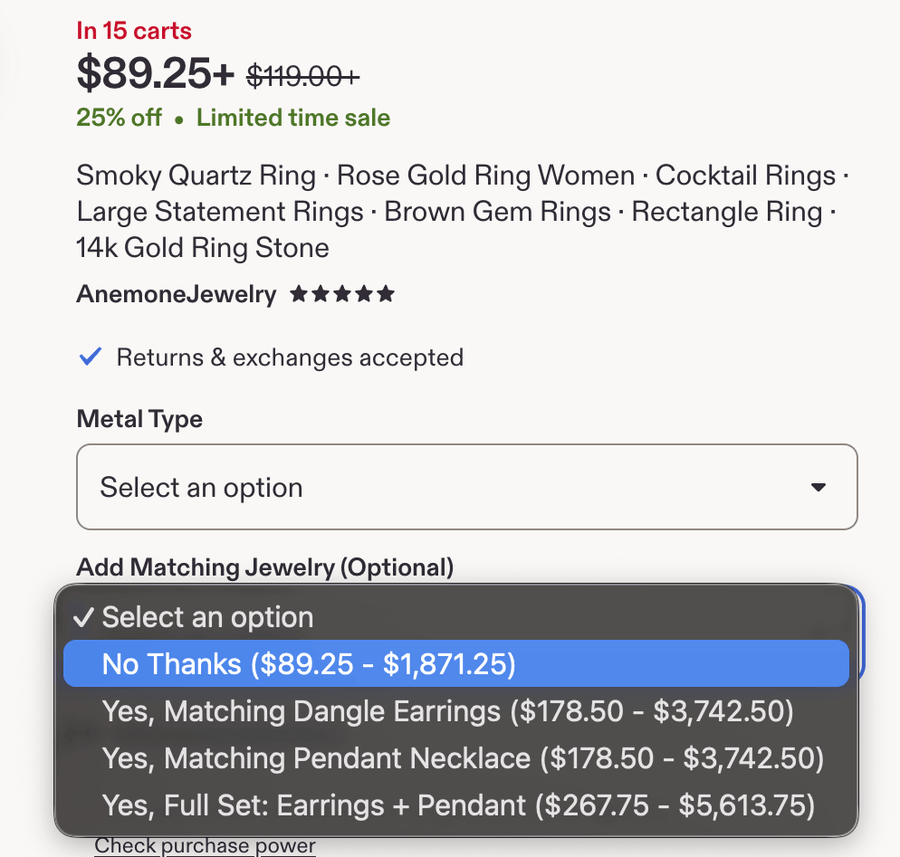
Ces 2 maximums mesurent des choses différentes, et cette annonce a 2 axes de variation. Metal Type va de 14k Gold Filled à 89,25 aux 3 options en or massif à 1 871,25. Add Matching Jewelry (Optional) multiplie ensuite cette fourchette. No Thanks va de 89,25 à 1 871,25, soit une seule pièce assortie va de 178,50 à 3 742,50, et Full Set: Earrings + Pendant va de 267,75 à 5 613,75.
Le maxPrice déclaré est la bague en or massif plus les deux pièces assorties, 3 articles à 1 prix. L’extraction de variations a renvoyé la bague seule et correspondait exactement à la ligne No Thanks.
Donc chaque fois qu’une annonce a un axe d’extension, maxPrice est le maximum pour un lot plutôt que pour l’article. Une série de prix construite dessus suit silencieusement les lots. Comptez les axes de variation avant de stocker une fourchette comme propre au produit. Ils ne sont pas dans le JSON-LD, lisez-les donc depuis la page rendue ou extrayez les variations.
Le même tableau priceSpecification contient aussi une seconde entrée étiquetée StrikethroughPrice, donc le prix soldé et le prix de liste apparaissent côte à côte, distingués seulement par une URL schema.org. Cette entrée a son propre minPrice et maxPrice. Le list_price enregistré par le script est le prix le plus bas de la fourchette du prix de liste, tout comme offers.price est le plus bas de la fourchette actuelle.
La locale suit l’IP de sortie, et elle change plus que le symbole monétaire. Nous avons récupéré 1 annonce 3 fois dans la même heure, en changeant uniquement le pays de sortie :
country   currency   price    variation range      title
us        USD        89.25    89.25 - 5613.75      Smoky Quartz Ring, Rose Gold Ring Women
de        EUR        95.71    95.71 - 5058.76      Rauchquarzring, Damenring aus Roségold
gb        GBP        82.77    82.77 - 4338.22      Smoky Quartz Ring, Rose Gold Ring Women
La même annonce s’affiche différemment selon chaque pays de sortie :
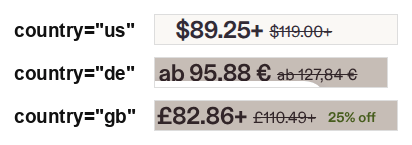
Ces captures proviennent d’une récupération ultérieure aux 3 lignes, et seul le chiffre en dollars est resté identique. La page allemande écrit aussi son prix le plus bas comme ab, soit « à partir de », et le + indique la même chose sur les 2 autres pages.
Les 3 récupérations ont renvoyé le même SKU, la même note et le même nombre d’avis, à 3 prix différents dans 3 devises. Le ratio entre le prix le plus bas et le plus élevé diffère entre les 3 lignes, 62,9x sur la ligne US contre 52,9x et 52,4x, donc plus que le taux de change a bougé entre ces récupérations. La sortie allemande a aussi renvoyé un titre traduit automatiquement, alors que les 2 locales anglaises ont conservé l’original.
Un pool rotatif qui ignore la géographie produit une série de prix mélangeant 3 devises et un corpus textuel mélangeant les langues, et rien dans le pipeline ne signale de problème. Fixez le pays de sortie par exécution de collecte et stockez la devise à côté de chaque prix.
Le même problème apparaît dans les données préparées. L’échantillon de 1 000 enregistrements téléchargé comptait 19 devises, avec 109 lignes dans une devise autre que l’USD, dont 14 tarifées en dong vietnamien. Cet échantillon s’actualise, votre copie différera donc de ces totaux. Effectuez la même comparaison sur votre propre copie.
Faire la moyenne de la colonne prix sans lire la colonne devise gonfle la moyenne :
mean(final_price), all rows          31,238.84   n=991
mean(final_price), currency = USD       137.57   n=882
                                        ~227x
median(final_price), all rows            26.00
Dans cette colonne, 14 lignes sur 991 contribuent à 87 % du total, mais 109 lignes sont non-USD et toutes nécessitent un traitement. La requête s’exécute, la colonne est un float propre, et la réponse est fausse de 2 ordres de grandeur. La médiane bouge à peine, car les lignes non-USD sont une petite part de la colonne. Une moyenne et une médiane qui divergent autant vous indiquent seulement la présence d’une longue traîne. Grouper par la colonne devise sépare les unités mélangées de l’asymétrie ordinaire.
Un article arXiv de mars 2026 sur les annonces de marketplace, cité à nouveau plus bas, a restreint son échantillon aux annonces tarifées en USD avant toute analyse. Cela résout le problème après la collecte plutôt que pendant. Filtrer ainsi change aussi la population décrite par la moyenne, car cela abandonne les annonces en d’autres devises au lieu de les convertir.
Ce problème est plus difficile à voir sur le chemin agent. Nous avons récupéré cette annonce via un serveur MCP dont le schéma n’accepte qu’une URL, et obtenu la vitrine tchèque tarifée en CZK. L’appel REST à pays fixé rapporte la même annonce à 89,25 USD.
La cause est l’interface de l’outil, pas la récupération. Sans paramètre de pays ou de locale à définir, vous prenez quelle que soit la sortie utilisée par le serveur. Vérifiez ce comportement sur tout serveur de ce type avant de le connecter à un agent, car la sortie détermine la devise de chaque réponse en aval.
Collectez donc les données Etsy dans votre propre stockage sur une locale fixée, et faites lire ce stockage par l’agent plutôt que de récupérer en direct à chaque question. Un agent qui répond silencieusement dans une devise différente à chaque fois est pire qu’un agent qui ne peut pas répondre.
Une annonce expirée est une page complète avec un prix dessus. Etsy ne renvoie pas un 404 pour une annonce expirée ou épuisée. Nous avons récupéré une annonce de 2007 et obtenu un HTTP 200, 465 563 octets, un bloc Product complet, et price 13.00 USD.
La page se rend entièrement, et affiche à la fois la bannière épuisée et le prix :
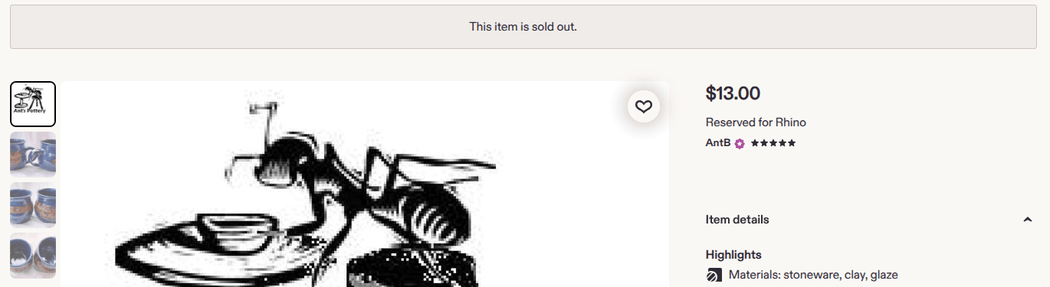
offers.availability est le seul champ qui contredit le prix, et il indique schema.org/OutOfStock. Un parseur qui l’ignore enregistre un article mort au prix plein, donc le script ci-dessus lit ce champ.
Ce champ est moins fiable dans les données préparées que sur la page. Dans cette même copie, 74 lignes sur 1 000 étaient des annonces épuisées, availability était vide sur les 74, et 65 affichaient quand même un prix numérique. Le signe là est un paramètre show_sold_out_detail sur l’URL stockée. Ne garder que les lignes dont availability indique InStock écarterait 798 lignes actives, car le champ est aussi absent sur la plupart d’entre elles.
Une réponse 2xx ne signifie pas que vous avez des données. Ce problème se situe dans la couche de collecte plutôt que dans la charge utile, et nous l’avons constaté avec le script ci-dessus pendant les tests. Le point de terminaison de déblocage s’explique dans le corps. Quand le compte a atteint une limite de débit de requêtes, il a répondu 200 avec un corps texte brut de 111 octets indiquant Your system is sending too many of this type of request. La ligne de statut reste un succès, donc raise_for_status() passe, le parseur ne trouve aucun bloc Product, et une boucle écrit des lignes vides sans la moindre exception.
La Web Scraper API gère le même cas par conception. Son point de terminaison de collecte synchrone renvoie les enregistrements sous 1 minute, et les jobs plus longs continuent de façon asynchrone. Le même point de terminaison répond 202 avec un snapshot_id et un retry-after quand un job dépasse cette minute, vous pouvez donc collecter le résultat une fois prêt, comme le documente la référence API. Les deux réponses sont des statuts de succès, branchez-vous donc sur le code de statut avant d’indexer dans une liste d’enregistrements.
La protection dans fetch_html fait 2 lignes et teste une page contenant du ld+json plutôt que l’une ou l’autre erreur. Exécuter l’énumérateur sur une boutique active a révélé un troisième cas, un 200 avec un corps vide, et la même protection l’a capturé sans aucun changement. Testez donc la réponse pour le contenu recherché plutôt que contre les erreurs déjà vues, car le texte d’erreur d’un fournisseur n’est pas une interface stable. Écrivez l’équivalent pour quelle que soit la couche de récupération utilisée, car un statut de succès ne garantit pas la charge utile.
Un exemple traité prouve qu’un problème existe, pas qu’il est courant. Nous avons vérifié les problèmes de fourchette de prix et de barré sur 100 annonces issues des 2 chemins de découverte. Les variations sont présentes sur 98 sur 100, et initial_price diffère de final_price sur les mêmes 98. Aucun des deux problèmes n’est un cas limite à reporter. Ces 100 proviennent des 2 chemins de découverte ci-dessus plutôt que d’un échantillon aléatoire parmi les catégories d’Etsy. Lisez donc 98 comme un minimum pour les annonces de bijoux plutôt qu’un taux pour le site.
La même vérification montre que l’annonce utilisée ci-dessus est inhabituelle sur un point. Cette annonce a 99 avis, alors que la médiane est de 1 dans ce crawl et de 0 dans l’échantillon du jeu de données publié.
Quand acheter un jeu de données géré plutôt que maintenir un scraper
Vous pouvez construire le scraper, et le code ci-dessus en constitue la majeure partie. La décision porte sur les échecs que vous voulez gérer vous-même.
Nous avons passé la même annonce via la Web Scraper API à nouveau, cette fois en collectant par URL plutôt qu’en découvrant depuis une boutique. Elle a renvoyé 58 champs contre les 14 du bloc Product brut, et les champs supplémentaires traitent la plupart des problèmes ci-dessus :
raw JSON-LD (geo=us)          Web Scraper API
-----------------------------------------------------
price 89.25 (range minimum)   final_price 89.25
119.00 (StrikethroughPrice)   initial_price 119
not present                   discount_percentage 25
not present                   listing_has_variations true
not present                   reviews_count_shop 15129
not present                   is_star_seller false
4 embedded reviews            6 top_reviews
14 fields                     58 fields
Vous configurez cet extracteur par URL d’entrée, et définissez all_variations sur true pour le problème de fourchette de prix :
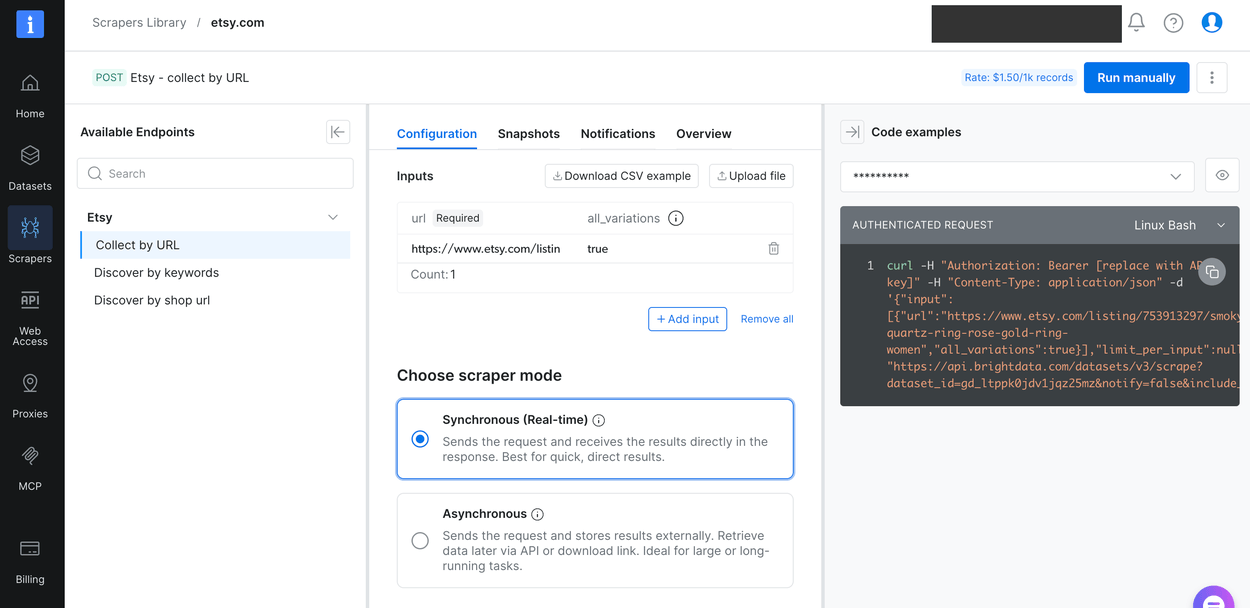
Les 6 champs comparés entre les deux chemins concordaient exactement, et il s’agissait de la devise, du prix facturé, du prix de liste, de la note, du nombre d’avis sur l’article et de l’origine d’expédition. Effectuez cette vérification avant de faire confiance à l’un ou l’autre chemin.
La comparaison des temps s’inverse, et le mode détermine de combien. Via le point de terminaison synchrone, l’extraction structurée a pris environ 50 secondes pour un seul enregistrement, contre 27 secondes pour la récupération brute. Elle rend et normalise plutôt que de renvoyer des octets. Les 50 secondes laissent environ 10 secondes dans le délai d’1 minute ci-dessus. Le point de terminaison est conçu pour 1 URL et une réponse immédiate.
Nous avons exécuté le même scraper comme job par lot à la place et obtenu les 50 enregistrements ci-dessus à 3,4 secondes chacun. Chaque enregistrement coûte environ 1/8 des 27 secondes que prend une récupération brute. En mode batch, le 202 est la réponse attendue, pas une erreur à gérer.
Pour un crawl récurrent, le chemin structuré retire la maintenance des sélecteurs, la fixation de locale et la gestion des fourchettes de prix de votre équipe, pour les champs qu’il renvoie. Pour 1 annonce, il est plus lent quel que soit le mode choisi. Le diff ci-dessus montre la gestion des prix résolue, et l’exécution de 50 enregistrements n’a montré aucune URL préfixée par locale. La maintenance des sélecteurs est la seule partie qu’aucune exécution unique ne peut tester. Le chemin structuré est facturé de la même manière que Web Unlocker, avec le quota gratuit actuel et le tarif par 1K enregistrements sur la page de tarification Web Scraper API.
Le même échantillon contient 2 types d’enregistrements plutôt qu’1, prévoyez donc les deux côté achat. Sur les 1 000 lignes, 128 ont le jeu de champs complet, et les 872 autres laissent 12 de leurs champs vides, dont description, product_category et store_country.
Cette répartition suit l’ancienneté des annonces, avec l’enregistrement complet sur les articles listés à partir de fin 2025. Un extrait en masse couvrant plusieurs années mélange donc les deux types dans 1 fichier. Ce ratio devrait évoluer vers l’enregistrement complet à mesure que le corpus vieillit. Vérifiez la couverture des champs par rapport à vos propres colonnes requises avant de décider la taille de la commande, pas après.
Le volume d’avis nécessite la même vérification avant de commander. Dans la copie récupérée, 753 sur 1 000 annonces n’avaient aucun avis, donc la médiane est zéro. Les 10 % d’annonces en tête ont 98 % de tous les avis. La moyenne de 52,5 par annonce décrit le fichier dans son ensemble et aucune annonce que vous ouvrirez.
L’asymétrie des avis ressemble au cas des devises, mais c’est un échec différent avec une correction différente. Le cas des devises ci-dessus est une erreur d’unité, et la moyenne est fausse. Le volume d’avis est de l’asymétrie, et là la moyenne est correcte pour un total. Un échantillon aléatoire de 1 000 annonces devrait renvoyer environ 52 500 avis, utilisez donc la moyenne quand vous planifiez un corpus en masse. Sur un échantillon de taille pilote, cette concentration rend l’estimation peu fiable.
La couverture est une question différente. Avec 753 des 1 000 à zéro, seulement environ 25 % des lignes achetées ont un avis quelconque.
Si les données dont vous avez besoin sont historiques plutôt qu’en direct, un jeu de données préparé évite le crawl. La page jeu de données Etsy liste le nombre de champs actuel, le total d’enregistrements, le prix par enregistrement et la commande minimum, et ces 4 chiffres constituent l’arithmétique côté achat.
Le chiffre par enregistrement sur cette page est le tarif ponctuel, et les calendriers d’actualisation du semestriel au quotidien se présentent en abonnements qui le réduisent. La fraîcheur des données compte aussi. La page décrit les enregistrements pré-collectés comme vieux de quelques jours à quelques mois, tandis que la collecte à la demande vous permet de fixer cette limite avant la commande. Vous sélectionnez le calendrier d’actualisation et le niveau de volume directement sur la page du jeu de données.
Ces chiffres changent sans préavis, lisez-les donc depuis la page avant de budgétiser, et traitez les 2 pages de tarification de la même manière. La page du jeu de données affiche un échantillon des enregistrements sous la ligne de résumé, flouté jusqu’à ce que vous demandiez l’accès :
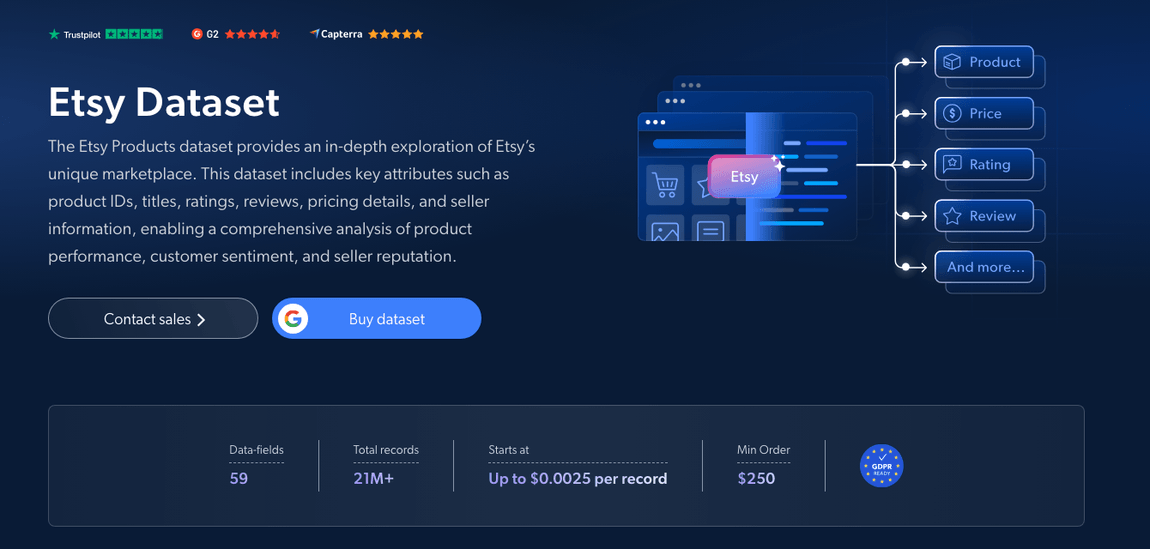
Un point de référence externe vaut plus qu’une affirmation de fournisseur ici. Ce même article, Mecha-nudges for Machines, documente la provenance de ses données dans l’Annexe B. Les auteurs indiquent que les données brutes « ont été obtenues auprès de l’entreprise Bright Data, qui fournit des jeux de données structurés d’annonces de produits Etsy ». Leur extrait « a été collecté le 12 novembre 2025 et livré le même jour ». Ils décrivent 2 instantanés, de 5M et 1,06M d’annonces. Cette annexe est vérifiable, et un cas d’usage fournisseur ne l’est pas.
La règle ici est étroite. Construisez le scraper quand vous avez besoin de quelques milliers d’annonces énumérables par URL, et pouvez accepter de fixer 1 locale. Achetez la couche de collecte quand la liste des URL est la partie difficile, ou quand le crawl doit continuer de tourner. Achetez-la aussi quand le jeu de données alimente un travail de tarification, car les champs de fourchette de prix et de prix barré arrivent déjà séparés. La colonne devise nécessite toujours un filtrage quel que soit le chemin.
Sur la boutique mesurée ci-dessus, construire coûte 1 895 requêtes et environ 13 heures en mono-thread pour 1 842 annonces. Le côté achat est une commande minimum d’enregistrements préparés. Ces 2 chiffres ne sont pas directement comparables, car le coût de construction est par boutique et le coût d’achat est un minimum réparti sur plusieurs boutiques.
Réflexions finales
Etsy bloque la récupération ordinaire tout en publiant du JSON-LD schema.org sur ces mêmes pages publiques, donc l’extraction est un travail rapide et l’accès constitue l’essentiel du travail. Le transport ne détermine pas l’accès, car un navigateur avec interface a chargé une page que 9 clients HTTP ajustés n’ont pas pu charger, et Etsy a refusé ce même navigateur à sa seconde requête. Le problème d’ingénierie est donc de savoir comment continuer à collecter, pas comment ressembler à un navigateur. Quel que soit le chemin choisi, les échecs de données coûtent plus cher que les échecs d’accès, car une colonne à devises mélangées ou une annonce morte au prix plein s’analyse proprement et vous ne le découvrez que des mois plus tard. Récupérez 1 annonce via une récupération brute et un extracteur structuré, comparez les champs, et laissez le résultat décider entre construire ou acheter avant d’écrire le crawler.
Questions fréquentes
Existe-t-il une API pour Etsy ?
Oui. L’Etsy Open API v3 listait 76 chemins à notre décompte, dont 31 opérations GET ne nécessitent qu’une clé d’application. Elle renvoie annonces, boutiques, avis et taxonomie. Pour les boutiques que vous n’exploitez pas, elle omet les ventes par annonce, le volume de recherche par mot-clé, le taux de conversion et l’historique, dont de nombreux projets de données ont besoin.
L’API Etsy est-elle gratuite ?
L’API elle-même n’a aucun prix publié, mais l’accès dépend d’une approbation et de limites de débit définies par clé d’application. Etsy décide qui obtient des limites plus élevées, et peut ajouter des conditions ou frais supplémentaires. Le coût pratique est la limite de débit plutôt qu’un tarif.
Pourquoi mon scraper Etsy est-il bloqué ?
Etsy utilise DataDome, qui renvoie un 403 avec une courte page de blocage et un en-tête X-DataDome-riskscore notant votre requête, où 1,0 est le pire. Le score suit votre IP appelante et la signature de la requête. Dans nos tests, modifier les en-têtes a baissé le score et l’imitation TLS Chrome l’a augmenté, et aucun des deux n’a renvoyé de page.
Etsy autorise-t-il le web scraping ?
Pas sans autorisation expresse d’Etsy. Les conditions sont le document le plus strict. robots.txt interdit la recherche par mot-clé, l’historique des ventes et les favoris dans toutes les variantes de locale, et laisse les pages d’annonces et de boutiques ouvertes. Etsy réécrit ce fichier sans préavis, lisez donc la copie en direct avant de construire.
Peut-on scraper Etsy avec Python ?
Oui. Les pages d’annonces intègrent du JSON-LD schema.org, donc l’extraction ne nécessite aucun sélecteur CSS. Choisissez le bloc application/ld+json dont @type est Product, puis aplatissez l’objet offre. La récupération est la moitié difficile, et collecter en volume nécessite de nouveaux contextes de navigation et des adresses rotatives.
Comment obtenir les données de ventes Etsy ?
Les ventes ne sont publiques qu’au niveau boutique. Le point de terminaison getShop renvoie transaction_sold_count, un chiffre à vie pour toute la boutique. Rien ne le décompose par annonce pour une boutique que vous n’exploitez pas, donc les chiffres par annonce d’un outil viennent d’ailleurs. Traitez-les comme des estimations et vérifiez-les par rapport aux totaux de la boutique.
Etsy a-t-il un sitemap pour le crawling ?
Aucun à notre dernière vérification. Le fichier robots.txt ne déclare aucune directive Sitemap:, et /sitemaps.xml renvoie un 403 avec un corps vide. Sans sitemap, vous devez découvrir les URL depuis les pages de boutiques, le point de terminaison API findAllListingsActive, ou un jeu de données préparé. Aucun de ces 3 ne touche au chemin de recherche interdit.
Etsy bloque-t-il les crawlers IA comme GPTBot ?
Pas nommément à notre vérification. Le fichier robots.txt ne déclare que 3 groupes de user-agent, aucun n’étant un crawler IA, et Etsy ne publie ni llms.txt ni ai.txt. DataDome a quand même refusé GPTBot et ClaudeBot, tous deux obtenant un score pire de 0,9814 contre les 0,923 obtenus par un User-Agent Chrome. Des chaînes absurdes ont obtenu le même score.