Facebook compte 3,07 milliards d’utilisateurs actifs mensuels en 2026, soit le plus grand nombre de toutes les plateformes sociales. Son infrastructure anti-bot multicouche fait du scraping l’un des défis techniques les plus difficiles en ingénierie des données. Cet article classe les 8 meilleurs scrapers Facebook en 2026, testés dans de vraies conditions anti-bot avec des comparaisons de prix honnêtes. Bright Data domine le secteur avec un taux de réussite moyen de 98,44 % dans le benchmark indépendant de Scrape.do portant sur 11 fournisseurs.
Dans cet article, nous allons aborder :
- Ce qu’est un scraper Facebook et en quoi il diffère de l’API Graph
- Les 4 critères utilisés pour évaluer chaque outil de cette liste
- Des avis classés sur 8 scrapers Facebook avec tarifs, avantages et inconvénients
- Un tableau comparatif côte à côte pour sélectionner rapidement l’outil adapté
- Comment choisir le bon scraper Facebook selon votre cas d’usage spécifique
TL;DR : Meilleurs scrapers Facebook en un coup d’œil
| Outil | Type | Niveau gratuit | Prix de départ | Idéal pour |
|---|---|---|---|---|
| Bright Data | API Scraper dédiée + jeux de données | 5 000 enregistrements/mois gratuits | 0,75 $/1K requêtes | Meilleur global |
| Apify | Actors no-code prêts à l’emploi | 5 $ de crédits mensuels | 49 $/mois | Scraping web sans code |
| Oxylabs | API de scraping web généraliste | Essai 7 jours, 2K résultats | 49 $/mois | Échelle entreprise |
| Decodo | API de scraping web généraliste | Essai 7 jours, 1K résultats | ~0,25 $/1K | Meilleur rapport qualité-prix |
| Zyte | API de scraping web généraliste | 5 $ de crédits pendant 30 jours | 1,01 $/1K | Workflows développeurs |
| ScrapingBee | API de scraping web généraliste | Essai 1K crédits | 49 $/mois | Configuration rapide |
| ScraperAPI | API de scraping web généraliste | Essai 5K crédits | 49 $/mois | Flexibilité d’intégration |
| Nimble | API de scraping web propulsée par l’IA | Essai limité | Contactez-nous | Analyse assistée par IA |
Qu’est-ce qu’un scraper Facebook ?
Un scraper Facebook extrait automatiquement les données publiquement disponibles sur Facebook. Il cible les pages, publications, profils, groupes, annonces Marketplace, événements, Reels et commentaires sans navigation manuelle. Il retourne une sortie structurée à grande échelle.
L’API Graph de Facebook n’est pas un remplacement équivalent. Elle nécessite un compte développeur, une soumission d’application et une approbation après examen. Elle impose des limites de débit strictes. Elle restreint l’accès à la plupart des données de pages publiques, notamment les publications, les métriques d’engagement et les annonces Marketplace. Un scraper Facebook accède aux mêmes données que n’importe quel navigateur peut voir, sans approbation d’API, sans contraintes de limite de débit, ni restrictions sur le type d’entité.
Trois catégories de scrapers Facebook existent en 2026. Premièrement, les API de scraping Facebook dédiées avec des modèles prêts à l’emploi et une sortie JSON structurée. Ce sont les plus rapides à déployer et nécessitent le moins de code personnalisé. Deuxièmement, les API de scraping web généralistes adaptables à Facebook via une logique d’analyse personnalisée. Elles conviennent aux développeurs qui souhaitent un contrôle total sur le HTML brut. Troisièmement, les outils visuels no-code pour les non-développeurs souhaitant collecter des données en pointant et cliquant, sans écrire une seule ligne de code.
Comment avons-nous évalué ces scrapers ?
Chaque outil de cette liste a été évalué selon quatre critères mesurant les performances réelles du scraping Facebook. Ces critères déterminent si un outil réussit en production, et pas seulement dans un environnement de démonstration.
Performance de contournement anti-bot
Facebook déploie des redirections vers des murs de connexion, du fingerprinting comportemental, une limitation du débit par IP et du contenu dynamique rendu en JS. Nous avons mesuré comment chaque outil gère ces défenses sans retourner des réponses vides ou bloquées. Un code de statut 200 avec du HTML vide compte comme un échec. Seuls les outils qui combinent des proxys résidentiels rotatifs avec une usurpation d’empreinte au niveau du navigateur réussissent systématiquement ce test.
Couverture des données et structure de sortie
Nous avons comptabilisé combien de types d’entités Facebook chaque outil prend en charge. La gamme complète comprend les pages, profils, groupes, annonces Marketplace, événements, Reels, publications, commentaires, hashtags et publicités. Nous avons également vérifié si la sortie est du JSON structuré pré-analysé ou du HTML brut nécessitant une extraction manuelle. Une sortie pré-analysée élimine une couche d’ingénierie entière de votre pipeline et réduit considérablement le délai d’accès aux données.
Tarification et évolutivité
Nous avons comparé le coût par 1K enregistrements réussis, la disponibilité d’un niveau gratuit et le comportement tarifaire à volumes élevés. Les modèles de paiement au succès ne facturent que les enregistrements livrés. Les modèles basés sur des crédits consomment des crédits pour chaque requête, y compris les requêtes échouées et bloquées. Cette distinction est d’autant plus importante lors du scraping de pages Facebook fortement protégées où les taux de blocage sont élevés.
Expérience développeur
Nous avons évalué la simplicité de l’API, la prise en charge des SDK par langage, les options no-code, la qualité de la documentation et la disponibilité du mode batch asynchrone. Une documentation médiocre engendre des coûts d’ingénierie cachés, quel que soit le prix par requête de l’outil. L’exécution batch asynchrone est essentielle pour les tâches traitant des millions d’URL Facebook pendant la nuit.
Les meilleurs scrapers Facebook, classés
Voici les 8 meilleurs scrapers Facebook disponibles en 2026, classés selon les critères ci-dessus. Chaque avis couvre les tarifs, les avantages, les inconvénients et un verdict pour vous aider à choisir.
1. Bright Data : Meilleur scraper Facebook global
Bright Data est la plateforme de scraping Facebook la mieux classée en 2026.
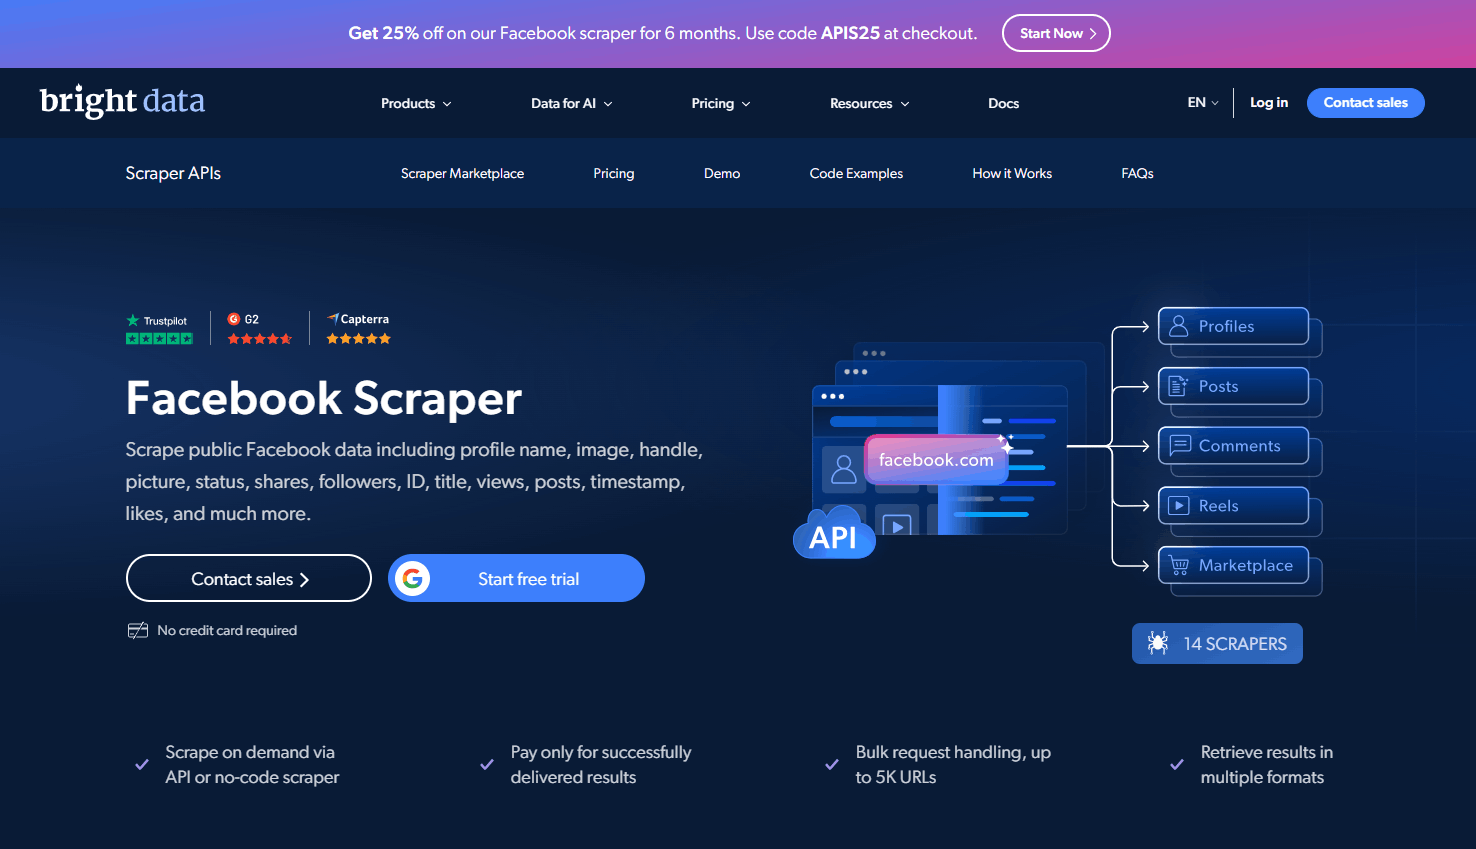
Dans le benchmark indépendant de Scrape.do portant sur 11 fournisseurs de scraping, Bright Data a atteint un taux de réussite moyen de 98,44 %. C’est le score le plus élevé enregistré dans le test. Aucun autre outil de cette liste n’a atteint ce niveau. L’API de Scraping Web de Bright Data comprend 15 modèles de scrapers Facebook dédiés couvrant tous les principaux types d’entités.
Types de données Facebook couverts nativement :
- Pages Facebook : nom, description, nombre d’abonnés, coordonnées, fréquence de publication et totaux d’engagement
- Profils Facebook : biographie, localisation, historique professionnel, formation et publications publiques
- Groupes Facebook : nombre de membres, texte des publications publiques et métriques d’engagement
- Annonces Marketplace : titre, prix, état, localisation du vendeur et description du produit
- Événements Facebook : titre, date, lieu, nom de l’organisateur et nombre de participants
- Facebook Reels : nombre de vues, de likes, de commentaires et texte de la légende
- Publications Facebook : contenu textuel, URL des médias, détail des réactions, nombre de partages et horodatage de publication
- Commentaires Facebook : nom de l’auteur, texte, horodatage et nombre de réponses
- Hashtags : volume de publications et statut de tendance
- Publicités : contenu créatif, dates de diffusion, catégorie de ciblage et plage d’impressions estimées
Aucun sélecteur CSS ni règle XPath n’est requis. Aucune maintenance manuelle du parser de votre côté lors des mises à jour de la mise en page Facebook.
Deux modes d’accès pour chaque équipe :
Les développeurs appellent l’API REST directement. Le point de terminaison accepte des URL cibles ou des paramètres de recherche et retourne du JSON structuré avec une simultanéité illimitée pour les grands travaux batch. Les utilisateurs non techniques accèdent aux mêmes scrapers via un panneau de contrôle no-code. Ce panneau accepte des URL ou des termes de recherche et exporte les résultats en CSV ou JSON. Aucun code n’est requis à aucune étape.
Jeux de données Facebook prêts à l’emploi :
Besoin de données historiques en masse sans exécuter un scraper en direct ? Utilisez plutôt les jeux de données Facebook de Bright Data. Ce sont des jeux de données pré-collectés mis à jour à la demande ou selon un calendrier de livraison personnalisé. Le jeu de données des profils Facebook contient plus de 31 millions d’enregistrements de profils, disponibles au téléchargement à 250 $ pour 100K enregistrements. Cela élimine l’infrastructure de scraping pour les cas d’usage historiques et supprime le problème de démarrage à froid sur les nouveaux projets.
Navigateur de scraping pour les pages Facebook à fort contenu JavaScript :
Le frontend React de Facebook charge le contenu de manière asynchrone après la réponse HTML initiale. Une requête HTTP basique retourne un shell vide sans contenu de publication ni données de profil. Le Navigateur de scraping de Bright Data est un navigateur cloud géré. Il exécute JavaScript et résout les CAPTCHAs automatiquement. Il usurpe les empreintes du navigateur au niveau de la session pour passer la détection comportementale de Facebook. Il gère le pipeline de rendu complet de Facebook sans aucune infrastructure de navigateur headless à provisionner ou à gérer.
Réseau de proxys résidentiels de plus de 400 millions d’IPs :
Le réseau de proxys de Bright Data achemine les requêtes via des IPs résidentielles éthiquement sourcées dans 195 pays. Le géociblage au niveau de la ville vous permet de scraper Facebook en tant qu’utilisateur depuis n’importe quel emplacement spécifique dans le monde. L’acheminement via le pool de plus de 400 millions d’IPs résidentielles de Bright Data fait apparaître chaque requête comme du trafic utilisateur organique. Les systèmes d’analyse comportementale de Facebook ne peuvent pas détecter ce schéma comme non organique à grande échelle.
Serveur MCP Facebook pour les workflows IA :
Bright Data propose un serveur MCP Facebook pour l’intégration directe d’agents IA. Il se connecte à Claude, GPT-4 et autres plateformes LLM sans code API personnalisé. Les agents IA peuvent interroger les données Facebook en temps réel via l’interface MCP. Aucun autre outil de cette liste n’offre une intégration native de serveur MCP pour les données Facebook. Cela en fait un différenciateur pour les équipes qui construisent des pipelines de recherche et de surveillance alimentés par l’IA.
Tarification :
Le niveau gratuit fournit 5 000 enregistrements par mois sans carte de crédit requise. Le paiement à l’utilisation est de 0,75 $ par 1K enregistrements sans engagement mensuel et avec une simultanéité illimitée. Le plan Scale est à 499 $/mois et comprend 384 000 enregistrements à 1,30 $/1K pour les dépassements. La tarification Enterprise est personnalisée, avec des remises sur volume, un gestionnaire de compte dédié, un SLA premium et une assistance prioritaire.
Promotions actives : utilisez le code APIS25 lors du paiement pour 25 % de réduction sur l’API Scraper pendant 3 mois. Bright Data égale votre premier dépôt dollar pour dollar jusqu’à 500 $.
Idéal pour : Les pipelines de données Facebook en production à toute échelle, des développeurs solo aux équipes d’ingénierie de données en entreprise.
Avantages :
- Taux de réussite le plus élevé de tous les fournisseurs testés : 98,44 % dans un benchmark indépendant de 11 plateformes
- 15 modèles Facebook prêts à l’emploi couvrant tous les principaux types d’entités avec sortie JSON structurée
- La tarification au succès élimine le gaspillage de coûts sur les requêtes échouées ou bloquées
- Plus de 31 millions d’enregistrements de profils Facebook pré-collectés disponibles pour téléchargement immédiat
- Le serveur MCP Facebook permet l’intégration d’agents IA sans écrire de code API personnalisé
Inconvénients :
- Coût par requête plus élevé que les outils généralistes simples pour les pages publiques basiques non protégées
- L’étendue complète de la plateforme peut sembler complexe pour les équipes n’ayant besoin que d’un seul type de données Facebook
2. Apify : Meilleur scraper Facebook no-code
Apify est une plateforme cloud construite autour d’Actors de scraping prêts à l’emploi pour des dizaines de sites web.
Le marketplace d’Actors d’Apify offre la barrière technique la plus basse pour les non-développeurs de cette liste. Les utilisateurs saisissent des URL Facebook ou des termes de recherche, sélectionnent un format de sortie et téléchargent les résultats. Aucune configuration de proxy. Aucune configuration de navigateur. Aucune logique d’analyse personnalisée requise à aucune étape.
Fonctionnalités clés :
- Actors Facebook prêts à l’emploi pour les pages, publications, commentaires, groupes, profils, publicités et Marketplace
- Marketplace d’Actors communautaires avec des dizaines de scrapers Facebook activement maintenus
- Exécutions planifiées intégrées, livraison par webhook et stockage de jeux de données en plusieurs formats
- Accès API programmatique pour les développeurs déclenchant des Actors comme étapes de pipeline automatisées
Tarification : Le plan gratuit comprend 5 $ de crédits mensuels (environ 500 pages Facebook). Le Starter est à 49 $/mois avec 49 $ de crédits. Le Scale est à 499 $/mois. Certains Actors facturent 0,75 $/1K résultats en plus des crédits de plateforme.
Idéal pour : Les non-développeurs et les petites équipes qui ont besoin de données Facebook structurées sans construire un pipeline de scraping.
Avantages :
- Aucun code requis : saisissez des URL et téléchargez des résultats structurés en JSON, CSV, Excel ou HTML
- Large couverture Facebook : pages, profils, groupes, Marketplace, événements, Reels et publicités
- Planification intégrée, livraison par webhook et export de jeux de données en plusieurs formats
Inconvénients :
- Proxys de centre de données par défaut ; les IPs résidentielles coûtent plus cher pour les pages Facebook fortement protégées
- Les Actors communautaires varient en qualité de maintenance et peuvent se casser lors des mises à jour du DOM Facebook sans préavis
- L’exécution uniquement en batch limite le contrôle précis sur le rythme des requêtes individuelles
3. Oxylabs : Meilleur pour le scraping à l’échelle entreprise
Oxylabs est un fournisseur d’infrastructure de scraping web généraliste ciblant les équipes de données en entreprise.
La plateforme offre une fiabilité de niveau entreprise et une gestion de compte dédiée pour les déploiements à grande échelle. Un essai de 7 jours avec 2K résultats vous permet de tester sur vos types de pages Facebook avant de vous engager. La configuration de sélecteurs assistée par IA réduit le temps de configuration des parsers personnalisés.
Fonctionnalités clés :
- API de Scraping Web avec configuration de sélecteurs XPath et CSS assistée par IA
- Web Unblocker pour un accès Facebook de type proxy avec gestion de session persistante
- Exécution batch en temps réel et asynchrone avec planification pour les workflows récurrents
- Gestionnaire de compte dédié sur les plans Enterprise
- Plus de 150 emplacements de géociblage couvrant tous les principaux marchés
Tarification : Essai gratuit de 7 jours avec 2K résultats. Plans d’abonnement à partir de 49 $/mois couvrant jusqu’à 98K requêtes. Tarification Enterprise disponible pour les remises sur volume.
Idéal pour : Les grandes organisations ayant besoin de SLAs personnalisés, d’une gestion de compte dédiée et d’un scraping multi-sites à l’échelle entreprise.
Avantages :
- SLAs de niveau entreprise avec gestion de compte dédiée sur tous les plans Enterprise
- Modes temps réel et batch asynchrone pour une intégration flexible des workflows entre équipes
- La configuration de sélecteurs assistée par IA réduit le temps de configuration des parsers personnalisés
Inconvénients :
- Aucun modèle de scraper Facebook dédié ; nécessite une configuration manuelle du parser par type d’entité
- Coût de base plus élevé que les alternatives au paiement au succès pour les projets de plus petite envergure
4. Decodo : Meilleur rapport qualité-prix pour l’API de scraping Facebook
Decodo propose une API de scraping généraliste avec une tarification conçue pour les équipes soucieuses des coûts.
Decodo facture environ 0,25 $ par 1K requêtes réussies. C’est le prix par requête le plus bas de cette liste. Son Site Unblocker gère automatiquement la rotation des proxys et la gestion des sessions. Le parser JSON structuré intégré élimine le besoin de configurer des règles XPath ou CSS pour les types de pages Facebook standard.
Fonctionnalités clés :
- API de Scraping Web avec modes d’exécution en temps réel et asynchrone
- Site Unblocker pour un accès de type proxy avec gestion automatique des sessions
- Parser JSON structuré intégré ne nécessitant aucune configuration de sélecteur
- Ciblage par pays dans plus de 150 emplacements
- Essai gratuit de 7 jours avec 1K résultats et garantie de remboursement de 14 jours
Tarification : Plan Standard à 0,50 $ pour 2K requêtes réussies (environ 0,25 $/1K). Niveaux d’abonnement à volume plus élevé disponibles pour les charges de travail plus importantes.
Idéal pour : Les petites et moyennes équipes qui ont besoin de données Facebook avec un budget limité et peuvent écrire leur propre logique de post-traitement et d’analyse.
Avantages :
- Coût par requête le plus bas des huit fournisseurs de cette liste à environ 0,25 $/1K
- La garantie de remboursement de 14 jours réduit le risque d’essai pour les nouveaux utilisateurs évaluant la plateforme
- Le parser JSON intégré ne nécessite aucune configuration de sélecteur XPath ou CSS pour les pages basiques
Inconvénients :
- Aucun modèle d’entité Facebook dédié pour les publications, profils ou annonces Marketplace
- Sortie JSON moins structurée que les API Facebook dédiées pour les données imbriquées complexes
5. Zyte : Meilleur scraper Facebook orienté développeurs
Zyte est une plateforme de scraping orientée développeurs avec un IDE cloud et des capacités d’automatisation de navigateur avancées.
La force de Zyte réside dans le scripting d’interactions navigateur multi-étapes. Cela inclut l’expansion des fils de commentaires, le défilement des fils d’actualité infinis et la navigation dans le contenu Facebook chargé dynamiquement. Zyte retourne du HTML brut ou du texte simple par défaut. Cela donne aux développeurs un contrôle total sur la couche d’extraction et le pipeline de normalisation des données.
Fonctionnalités clés :
- API Zyte généraliste avec rotation automatique des proxys et détection de bannissement
- Rendu JavaScript pour le contenu Facebook dynamique via des navigateurs headless gérés
- IDE cloud pour scripter des interactions navigateur multi-étapes incluant défilement infini et expansion des commentaires
- Modes d’intégration HTTP et proxy disponibles dans une API unifiée
- Plus de 150 emplacements de géociblage par pays
Tarification : 5 $ de crédits de plateforme gratuits pendant 30 jours. À partir de 1,01 $ par 1K réponses. Les requêtes de rendu navigateur coûtent significativement plus cher que les requêtes HTTP basiques sur le même plan.
Idéal pour : Les développeurs Python et Node.js qui ont besoin d’un contrôle total sur les séquences de navigation Facebook et qui sont à l’aise pour écrire et maintenir des parsers personnalisés.
Avantages :
- L’IDE cloud permet de scripter des interactions Facebook multi-étapes complexes comme le défilement infini et les fils de commentaires
- Modes HTTP et rendu navigateur disponibles dans un seul point de terminaison API unifié
- Système de crédits par requête transparent sans frais généraux cachés
Inconvénients :
- Aucun parser de données Facebook intégré ; toute la logique d’extraction doit être écrite et maintenue manuellement
- Le rendu navigateur double approximativement le coût par requête par rapport au mode HTTP basique
- Courbe d’apprentissage plus raide pour les workflows Facebook complexes nécessitant une navigation multi-étapes
6. ScrapingBee : Meilleur pour une configuration rapide
ScrapingBee est une API de scraping en temps réel avec une empreinte d’intégration minimale.
Son constructeur de requêtes visuel et ses SDK couvrent Python, Node.js, PHP et Ruby. Votre première requête Facebook peut partir en moins de 10 minutes. Les règles d’extraction générées par IA gèrent le ciblage basique des champs sans configuration CSS ou XPath manuelle. Une intégration de serveur MCP ajoute la compatibilité avec les outils de workflow IA pour les équipes construisant des pipelines propulsés par LLM.
Fonctionnalités clés :
- API en temps réel avec rendu JavaScript pour les pages Facebook dynamiques basées sur React
- Constructeur de requêtes HTML visuel avec en-têtes personnalisés, cookies et scripting de scénarios JavaScript
- Règles d’extraction générées par IA pour cibler des champs de données Facebook spécifiques
- Support SDK pour Python, Node.js, PHP et Ruby
- Intégration de serveur MCP pour la compatibilité avec les workflows IA et les outils LLM
Tarification : Essai de 7 jours avec 1K crédits API gratuits. Plans à partir de 49 $/mois pour 250K crédits. Les modes proxy premium et furtif consomment de 10 à 75 fois plus de crédits par requête que le mode basique.
Idéal pour : Les développeurs qui ont besoin de commencer rapidement à collecter des données Facebook pour des cas d’usage de pipeline simples sans configuration complexe.
Avantages :
- Temps de configuration le plus rapide de toutes les API de cette liste : première requête en moins de 10 minutes
- Les règles d’extraction générées par IA réduisent significativement le temps de configuration manuelle du parser
- Support SDK natif pour quatre langages de programmation nativement
Inconvénients :
- Aucun parser d’entité Facebook intégré ; nécessite une configuration manuelle des règles d’extraction par type de page
- La consommation de crédits augmente fortement lorsque des proxys premium sont requis pour les pages protégées
- Exécution en temps réel uniquement ; aucun mode batch asynchrone pour traiter de grandes files d’URL Facebook
7. ScraperAPI : Meilleur pour la flexibilité d’intégration
ScraperAPI propose quatre modes d’intégration distincts. Cela le rend très adaptable pour les équipes avec des architectures techniques variées et des contraintes de pipeline existantes.
Son mode API asynchrone met en file d’attente de grands lots d’URL Facebook et livre les résultats via webhook. Cela convient aux équipes de données exécutant des travaux batch nocturnes sur des milliers d’annonces Marketplace ou de pages Facebook. La couverture SDK s’étend à Python, Node.js, PHP, Ruby et Java. C’est la prise en charge de langages la plus large de cette liste.
Fonctionnalités clés :
- Quatre modes d’intégration : serveur proxy, API en temps réel, API asynchrone et SDK par langage
- API asynchrone pour la mise en file d’attente de grands lots d’URL Facebook avec livraison des résultats par webhook
- SDK pour Python, Node.js, PHP, Ruby et Java
- Sortie en HTML brut, texte simple ou format Markdown
- Plus de 70 emplacements de ciblage géographique
Tarification : Essai gratuit de 7 jours avec 5K crédits. Plans à partir de 49 $/mois pour 100K crédits. Le rendu JavaScript et les proxys résidentiels consomment des crédits supplémentaires par requête au-delà du tarif de base.
Idéal pour : Les équipes de développement qui ont besoin de plusieurs modes d’intégration pour s’adapter à une architecture de pipeline de données existante sans réingénierie de leur workflow.
Avantages :
- Quatre modes d’intégration : serveur proxy, API en temps réel, API asynchrone et SDK par langage
- La livraison asynchrone par webhook convient aux grands travaux de traitement batch Facebook nocturnes
- Couverture SDK la plus large de cette liste : Python, Node.js, PHP, Ruby et Java
Inconvénients :
- Aucun parser de données Facebook intégré ; la sortie structurée nécessite d’écrire votre propre logique d’extraction
- Le ciblage géographique est limité à de grandes régions sur les plans de niveau inférieur
- Le coût effectif par requête Facebook augmente une fois le rendu JS et les proxys résidentiels activés
8. Nimble : Meilleur scraper Facebook propulsé par l’IA
Nimble est une API de scraping généraliste propulsée par l’IA qui s’adapte aux types de pages Facebook.
Son analyse assistée par IA réduit le code d’extraction nécessaire par type d’entité Facebook. La rotation d’IP résidentielles avec géociblage au niveau de la ville et de l’état gère la surveillance au niveau IP de Facebook. La plupart des niveaux de tarification de Nimble nécessitent une conversation avec les ventes. Cela rend la comparaison des coûts difficile sans un devis direct de l’équipe commerciale.
Fonctionnalités clés :
- API de scraping généraliste propulsée par l’IA adaptable à plusieurs types de pages Facebook
- Rotation d’IP résidentielles avec géociblage au niveau de la ville et de l’état
- Analyse HTML vers JSON assistée par IA pour une sortie structurée légère
- Options de facturation à l’utilisation et par abonnement mensuel
Tarification : Essai limité disponible. Des plans à l’utilisation et mensuels sont proposés. La tarification nécessite de contacter les ventes pour la plupart des niveaux et n’est pas listée publiquement sur le site web.
Idéal pour : Les équipes explorant l’extraction assistée par IA qui souhaitent réduire le travail d’analyse personnalisée sur des structures de pages Facebook variées.
Avantages :
- L’extraction assistée par IA réduit les exigences de configuration manuelle CSS et XPath
- Géociblage au niveau de la ville pour une collecte de données régionales Facebook précise
- Facturation flexible : options de paiement à l’utilisation ou d’abonnement mensuel disponibles
Inconvénients :
- Non spécifique à Facebook ; nécessite une adaptation manuelle pour chaque type d’entité Facebook
- L’opacité des tarifs rend la comparaison des coûts difficile sans une conversation directe avec les ventes
- Communauté plus petite et documentation publiquement disponible moins abondante que les grands fournisseurs de cette liste
Tableau comparatif côte à côte
Utilisez ce tableau pour comparer les huit scrapers Facebook en un coup d’œil. Les mêmes données apparaissent dans le TL;DR ci-dessus pour les lecteurs qui ont fait défiler jusqu’à cette section.
TL;DR : Meilleurs scrapers Facebook en un coup d’œil
| Outil | Type | Fiabilité | Niveau gratuit | Prix de départ | Idéal pour |
|---|---|---|---|---|---|
| Bright Data | API Scraper dédiée + jeux de données | 98,44 % mesuré | 5 000 enregistrements/mois gratuits | 0,75 $/1K requêtes | Meilleur global |
| Apify | Actors no-code prêts à l’emploi | Aucun benchmark public | 5 $ de crédits mensuels | 49 $/mois | Scraping web sans code |
| Oxylabs | API de scraping web généraliste | Aucun benchmark public | Essai 7 jours, 2K résultats | 49 $/mois | Échelle entreprise |
| Decodo | API de scraping web généraliste | Aucun benchmark public | Essai 7 jours, 1K résultats | ~0,25 $/1K | Meilleur rapport qualité-prix |
| Zyte | API de scraping web généraliste | Aucun benchmark public | 5 $ de crédits pendant 30 jours | 1,01 $/1K | Workflows développeurs |
| ScrapingBee | API de scraping web généraliste | Aucun benchmark public | Essai 1K crédits | 49 $/mois | Configuration rapide |
| ScraperAPI | API de scraping web généraliste | Aucun benchmark public | Essai 5K crédits | 49 $/mois | Flexibilité d’intégration |
| Nimble | API de scraping web propulsée par l’IA | Aucun benchmark public | Essai limité | Contactez-nous | Analyse assistée par IA |
Comment choisir le bon scraper ?
Le bon scraper Facebook dépend de quatre facteurs de décision. Les faire correspondre à votre situation évite de payer trop pour des capacités dont vous n’avez pas besoin.
Quel volume avez-vous besoin ?
Pour des millions d’enregistrements Facebook par mois, choisissez Bright Data ou Oxylabs. Les deux gèrent des travaux concurrents à haut volume sans dégradation de limite de débit à grande échelle. Pour moins de 100K enregistrements par mois, ScraperAPI ou ScrapingBee gèrent la charge à un coût total inférieur. Decodo offre le meilleur prix par requête pour les équipes traitant moins de 500K requêtes mensuelles.
Quelle est votre expertise technique ?
Les non-développeurs devraient utiliser les Actors no-code d’Apify ou le panneau de contrôle no-code de Bright Data. Les deux retournent des données structurées sans écrire de code ni configurer de parsers. Les développeurs construisant des pipelines de production obtiennent le plus de flexibilité avec l’API de Bright Data. L’IDE cloud de Zyte et les quatre modes d’intégration de ScraperAPI sont également de bons choix pour les équipes à forte composante ingénierie.
Quel type de données avez-vous besoin ?
Pour du JSON pré-analysé provenant de types d’entités Facebook spécifiques (publications, Marketplace, profils), choisissez Bright Data ou Apify. Les deux retournent une sortie propre sans logique d’extraction personnalisée. Pour du HTML brut à traiter vous-même, Zyte ou ScraperAPI offrent un contrôle maximal. Besoin de données Facebook historiques en masse sans exécuter un scraper en direct ? Les jeux de données Facebook de Bright Data fournissent un accès immédiat à des millions d’enregistrements pré-collectés.
Quel modèle de tarification convient à votre budget ?
Le paiement au succès chez Bright Data (0,75 $/1K) signifie zéro gaspillage sur les requêtes échouées ou bloquées. Cet avantage croît avec le niveau de protection des pages Facebook cibles. Les plans basés sur des crédits chez ScrapingBee et ScraperAPI (49 $/mois) conviennent aux charges de travail prévisibles avec des volumes mensuels connus. La tarification basée sur le volume de Decodo (~0,25 $/1K) est la plus rentable pour les types de pages Facebook basiques sans protection anti-bot lourde.
Que pouvez-vous faire avec les données Facebook ?
Voici les cinq cas d’usage les plus précieux pour les données Facebook publiques en 2026. Selon The Business Research Company, le scraping web est un marché de 1,17 milliard de dollars en 2026. La demande des entreprises pour les données sociales alimente le TCAC de 18,5 %. Facebook est l’une des plus grandes sources de données sociales publiquement accessibles, avec 3,07 milliards d’utilisateurs actifs mensuels.
Intelligence compétitive
Surveillez les pages de marques concurrentes pour la fréquence de publication, les taux d’engagement, la croissance des abonnés et les changements de stratégie de contenu. Un scraper de pages Facebook sur un calendrier quotidien retourne des données structurées sur les concurrents. Il montre la fréquence de publication, la répartition par type de contenu et quelles publications génèrent le plus de réactions. Ajoutez des données d’engagement Facebook pré-scrapées pour une base de référence de performance historique. Cela élimine le problème de démarrage à froid sur les nouveaux projets d’intelligence compétitive.
Étude de marché et analyse des sentiments
Collectez des commentaires et réactions publics sur des sujets industriels, des mentions de marques et des discussions sur des produits à grande échelle. Ces données alimentent des modèles de sentiment qui suivent les évolutions d’opinion dans le temps. Combinez les données Facebook avec des outils de scraping Instagram pour une vue multiplateforme plus complète. L’analyse des sentiments multiplateforme révèle comment la perception de la marque diffère selon le canal et le segment d’audience.
Génération de leads
Extrayez les coordonnées des pages Facebook professionnelles publiques pour la prospection commerciale à grande échelle. Les pages Facebook professionnelles publiques incluent souvent des numéros de téléphone, adresses e-mail, URL de sites web et adresses physiques. Un scraper de pages Facebook structuré retourne tous ces champs en un seul appel API. Aucune navigation manuelle requise.
Pourquoi surveiller la bibliothèque de publicités Facebook ?
Suivez les créatifs publicitaires Facebook des concurrents, les variations de texte et les dates de diffusion pour une intelligence publicitaire compétitive. La bibliothèque de publicités publique de Facebook contient toutes les publicités actives et récemment diffusées. Elle inclut les images, vignettes vidéo, catégories de ciblage et plages d’impressions. La scraper sur un calendrier régulier construit un flux complet d’intelligence publicitaire compétitive. Le coût est une fraction de la surveillance manuelle à toute échelle significative.
Collecte de données Marketplace
Scrapez Facebook Marketplace pour des benchmarks de prix, des tendances de disponibilité des produits et l’activité des vendeurs par catégories. Les annonces Marketplace comprennent le titre, le prix, l’état, la localisation du vendeur et la description du produit. Ces données soutiennent la recherche de prix, l’analyse de la demande et la cartographie de la disponibilité régionale par catégories de produits.
Qu’est-ce qui rend Facebook difficile à scraper ?
Quatre défis techniques expliquent pourquoi les approches de scraping basiques échouent et pourquoi la bonne infrastructure est importante.
Comment Facebook détecte-t-il les bots ?
Facebook utilise la surveillance au niveau IP, le fingerprinting comportemental, les vérifications de rendu navigateur et les redirections vers des murs de connexion. La seule contre-mesure fiable est de combiner des proxys résidentiels rotatifs avec une usurpation d’empreinte au niveau du navigateur. Les IPs de centres de données sont signalées à des volumes de requêtes élevés presque immédiatement. L’acheminement via le pool de plus de 400 millions d’IPs résidentielles de Bright Data fait apparaître chaque requête comme du trafic utilisateur organique. Les systèmes d’analyse comportementale de Facebook ne peuvent pas détecter ce schéma comme non organique à grande échelle.
Pourquoi le rendu JavaScript est-il important ?
Le frontend React de Facebook charge le contenu de manière asynchrone après la réponse HTML initiale. Une requête HTTP GET basique retourne un shell vide. Le contenu des publications, les compteurs d’engagement et les données de profil sont absents de la réponse brute. Seul un navigateur headless complet ou un navigateur cloud géré peut rendre les données Facebook réelles. Le Navigateur de scraping de Bright Data gère cela automatiquement, y compris la résolution de CAPTCHA et l’évasion d’empreinte au niveau de la session. Vous n’avez pas besoin de gérer une infrastructure de navigateur pour l’utiliser.
Comment gérer la limitation de débit ?
Facebook applique des limites de débit agressives par IP et par session. Le dépassement de ces limites déclenche des CAPTCHAs et des blocages durs sur la session requérante. Un scraping efficace à grande échelle nécessite une limitation du débit des requêtes, une rotation des sessions et une logique de réessai automatique avec backoff exponentiel. Les plateformes de scraping gérées absorbent cette complexité en interne. Les outils proxy HTTP bruts vous obligent à implémenter chaque couche de logique de réessai et de gestion des sessions. Cela ajoute une surcharge d’ingénierie qui s’accumule considérablement à des volumes élevés.
Pourquoi la volatilité du DOM casse-t-elle les scrapers ?
Le DOM de Facebook change fréquemment et sans préavis. Les sélecteurs CSS et les règles XPath codés en dur se cassent lorsque Facebook met à jour sa structure frontend. Les parsers personnalisés nécessitent une maintenance régulière après chaque changement de DOM, créant un coût d’ingénierie continu. Les API de scraping Facebook dédiées maintiennent leurs propres parsers en interne et absorbent cette charge de maintenance. Lorsque Facebook met à jour sa structure de page, le fournisseur d’API livre un parser mis à jour. Votre pipeline continue de livrer des données structurées sans aucun changement de code de votre côté.
Prêt à collecter des données Facebook à grande échelle ? Commencez gratuitement avec Bright Data et accédez à l’infrastructure de scraping Facebook la plus fiable disponible.
Questions fréquemment posées
Q : Quelles données peut-on scraper depuis Facebook ?
Les pages publiques de Facebook exposent une large gamme de types de données accessibles. Depuis les pages professionnelles, vous pouvez collecter les noms, descriptions, nombres d’abonnés et de likes. Depuis les publications, vous pouvez extraire le contenu textuel, les URL des médias, les nombres de commentaires, de partages, les totaux de réactions et les horodatages de publication. Les événements exposent le titre, la date, le lieu, le nom de l’organisateur et le nombre de participants. Les groupes publics fournissent le nombre de membres, le texte des publications publiques et les métriques d’engagement. Les annonces Marketplace retournent le titre, le prix, l’état, la localisation du vendeur et la description du produit. Les pages professionnelles dans la section À propos affichent souvent des numéros de téléphone, adresses e-mail, URL de sites web et adresses physiques. Les profils privés et tout contenu derrière un mur de connexion ne sont pas accessibles aux scrapers travaillant avec des données publiquement visibles.
Q : Quel est le meilleur scraper Facebook pour les non-développeurs ?
Le panneau de contrôle no-code de Bright Data et les Actors prêts à l’emploi d’Apify sont les deux meilleures options pour les non-développeurs. Bright Data fournit 15 modèles Facebook prêts à l’emploi couvrant les pages, profils, groupes, annonces Marketplace, événements, publications, Reels, commentaires, hashtags et publicités. Les utilisateurs sélectionnent un modèle, saisissent une URL ou un terme de recherche, et téléchargent les résultats en CSV ou JSON sans aucun code requis. Le marketplace d’Actors d’Apify offre une expérience similaire : saisissez des URL Facebook, choisissez un format de sortie (JSON, CSV, Excel ou HTML), et téléchargez des résultats structurés. Les deux outils retournent des données Facebook propres et structurées sans nécessiter aucune expérience de programmation ni configuration.
Q : Comment les scrapers Facebook gèrent-ils la détection anti-bot ?
Trois techniques principales sont utilisées. Premièrement, les proxys résidentiels rotatifs distribuent les requêtes sur des millions d’adresses IP réelles, empêchant les déclencheurs de limite de débit par IP. Facebook ne peut pas distinguer les requêtes d’un grand pool d’IPs résidentielles du trafic utilisateur organique. Deuxièmement, l’usurpation d’empreinte navigateur réplique des signatures de navigateur légitimes incluant les chaînes user-agent, les résolutions d’écran et les langues acceptées. Cela contourne la détection basée sur les empreintes qui signale les outils de scraping connus ou les modèles de navigateurs headless. Troisièmement, les navigateurs headless gérés exécutent JavaScript et passent les vérifications comportementales que les simples requêtes HTTP échouent. Le Navigateur de scraping de Bright Data combine ces trois techniques dans un service géré avec résolution automatique de CAPTCHA, ce qui en fait la solution la plus complète pour contourner les défenses multicouches de Facebook.
Q : Quelle est la différence entre un scraper Facebook et l’API Graph de Facebook ?
L’API Graph de Facebook est l’interface développeur officielle de Facebook. Elle nécessite un compte développeur, l’enregistrement d’une application et l’approbation après examen avant d’accorder tout accès. Elle applique des limites de débit strictes et restreint la plupart des données de pages publiques, notamment les publications, les métriques d’engagement, les annonces Marketplace et les détails des événements. Elle nécessite également une maintenance continue des permissions au fur et à mesure que Facebook met à jour ses politiques d’API. Un scraper Facebook accède aux mêmes données publiquement visibles que n’importe quel navigateur peut voir, sans approbation d’API ni contraintes de limite de débit. Il retourne une sortie structurée de tous les types d’entités Facebook publiques, notamment Marketplace, groupes, événements et Reels, sans aucune restriction d’accès au-delà de ce qui est publiquement disponible pour tout visiteur.
Q : Peut-on scraper les groupes Facebook et les annonces Marketplace ?
Oui, pour les groupes publics et les annonces Marketplace publiques. Depuis les groupes Facebook publics, vous pouvez collecter le nombre de membres, le texte des publications publiques, les métriques d’engagement et la description du groupe. Le scraper Facebook pour les groupes de Bright Data retourne ces champs en JSON structuré pré-analysé. Depuis Facebook Marketplace public, vous pouvez extraire le titre de l’annonce, le prix, l’état, la localisation du vendeur, la description du produit et l’URL de l’annonce. Le scraper Facebook Marketplace de Bright Data couvre tous les champs d’annonce standard en un seul appel API. Les groupes privés ou fermés nécessitent une authentification et ne sont pas accessibles aux scrapers travaillant avec des données publiquement visibles.
Q : Combien coûte le scraping Facebook ?
Le spectre de tarification des outils de cette liste : le modèle de paiement au succès de Bright Data facture 0,75 $ par 1K enregistrements avec un niveau gratuit de 5 000 enregistrements par mois et sans engagement mensuel. Decodo facture environ 0,25 $ par 1K sur son plan standard, le coût par requête le plus bas de cette liste. Le plan Starter d’Apify est à 49 $/mois avec 49 $ de crédits de plateforme, couvrant environ 3 900 à 4 900 pages Facebook selon l’Actor sélectionné. ScraperAPI et ScrapingBee commencent tous deux à 49 $/mois pour respectivement 100K et 250K crédits. Le rendu JavaScript et l’utilisation de proxys résidentiels augmentent les coûts effectifs sur toutes les plateformes. Le modèle de paiement au succès de Bright Data élimine le gaspillage de coûts sur les requêtes échouées ou bloquées, ce qui est un avantage significatif lors du scraping de pages Facebook fortement protégées.
Q : Quelle est la façon la plus rapide de collecter des données Facebook à grande échelle ?
Deux approches fonctionnent le mieux à grande échelle. Pour les données historiques en masse, les jeux de données Facebook prêts à l’emploi de Bright Data fournissent un accès immédiat à des millions d’enregistrements pré-collectés sans scraper requis. Le jeu de données des profils Facebook seul contient plus de 31 millions d’enregistrements disponibles pour téléchargement immédiat. Pour la collecte à grande échelle en temps réel, l’API de Scraping Web de Bright Data avec une simultanéité illimitée traite autant d’URL Facebook que votre travail l’exige simultanément. Les deux approches retournent une sortie JSON structurée. L’approche par jeux de données est plus rapide pour la recherche et l’analyse historiques. L’approche par API est meilleure pour la surveillance en temps réel ou les exigences de données fréquemment mises à jour.