Dans ce guide, vous verrez :
- Ce qu’est un outil de Scraping web par IA
- Les facteurs clés pour choisir le meilleur outil de scraping IA pour votre cas d’usage
- Les 9 meilleurs outils de Scraping web par IA disponibles en 2026
- Un tableau comparatif récapitulatif pour évaluer chaque solution en un coup d’œil
Plongeons-y !
Qu’est-ce qu’un outil de Scraping web par IA ?
Un outil de Scraping web par IA utilise l’intelligence artificielle pour automatiser l’extraction de données à partir de sites web. Il peut s’agir d’une plateforme cloud proposant des API de scraping alimentées par l’IA, d’une bibliothèque Python ou JavaScript, ou d’un produit entièrement sans code construit autour d’un flux de travail visuel.
L’avantage du scraping alimenté par l’IA par rapport aux Scrapers traditionnels est la capacité à s’adapter aux changements de mise en page sans mises à jour constantes du code, réduisant la maintenance et améliorant la précision. La contrepartie est que le traitement par IA ajoute de la latence et peut occasionnellement produire des résultats hallucinés lorsqu’une extraction basée sur des LLM est impliquée.
En général, les outils modernes de Scraping web par IA incluent des fonctionnalités telles que :
- Des invites en langage naturel pour cibler des champs de données spécifiques
- L’intégration avec des fournisseurs de LLM (OpenAI, Anthropic, Gemini, et autres)
- Des connecteurs préconstruits pour les sites web et marketplaces populaires
- Le rendu JavaScript pour les applications dynamiques à page unique
- Le contournement des anti-bots et la gestion des Proxys pour éviter les blocages de scraping
Comment nous avons sélectionné les meilleurs outils de scraping IA
Lors de l’évaluation des principales solutions de Scraping web par IA, voici les éléments clés à garder à l’esprit :
- Capacités : L’éventail de fonctionnalités que l’outil prend en charge, de l’extraction de pages simples au crawling de sites complets et aux pipelines de données structurées.
- Nature : Si l’outil est un produit SaaS commercial, open-source, ou une offre hybride combinant les deux.
- Langages de programmation pris en charge : Les langages et frameworks avec lesquels la solution s’intègre, et si une voie sans code existe.
- Fournisseurs d’IA pris en charge : Les modèles d’IA auxquels l’outil se connecte, ou s’il utilise une IA propriétaire en interne.
- Tarification : Plans et prix directement depuis le site web de l’outil, vérifiés au moment de la publication.
- Étoiles GitHub : Adoption par la communauté pour les projets open-source, comme signal de maturité et de dynamisme.
Top 9 des outils de Scraping web par IA
Voici un tableau comparatif TL;DR des 9 meilleurs outils de scraping IA, suivi d’avis approfondis sur chacun :
| Outil | Type | Open-Source | Sans code | Prix de départ | Étoiles GitHub |
|---|---|---|---|---|---|
| Bright Data | Infrastructure complète | ✔️ (intégrations MCP, LangChain) | ✔️ | À partir de 0,75 $/1k enregistrements | N/A |
| Firecrawl | API développeur | ✔️ | ❌ | Gratuit à 599 $/mois | 125k+ |
| Crawl4AI | Bibliothèque open-source | ✔️ | ❌ | Gratuit | 66,7k+ |
| Browse AI | Plateforme sans code | ❌ | ✔️ | 19 $/mois (annuel) | N/A |
| Apify | Marketplace d’Actors | ✔️ (actors) | ✔️ | Gratuit à 999 $/mois | N/A |
| ScrapeGraphAI | Open-source + API | ✔️ | ❌ | Gratuit à 425 $/mois | 26,3k+ |
| Diffbot | IA entreprise | ❌ | ✔️ | Gratuit à 899 $/mois | N/A |
| Browserbase | Infrastructure de navigateur cloud | ✔️ (SDK Stagehand) | ❌ | Gratuit à 99 $/mois | N/A |
| Octoparse | Bureau sans code + cloud | ❌ | ✔️ | Gratuit à 69 $/mois | N/A |
1. Bright Data
Bright Data est une infrastructure de données web conçue pour la performance, l’échelle et la conformité. Approuvée par 50,000+ clients, elle offre une suite complète d’outils de scraping IA soutenue par l’un des plus grands réseaux de Proxys au monde : plus de 100 millions d’IPs couvrant des pools résidentiels, de centres de données et ISP.
L’infrastructure est conçue pour fournir des données web en temps réel, prêtes pour les LLM, pour les agents IA, les pipelines RAG, l’entraînement de modèles et la collecte d’intelligence spécifique à des secteurs verticaux. Chaque produit de scraping est soutenu par une technologie de contournement anti-bot de pointe, vous permettant de vous concentrer sur votre application plutôt que de gérer les blocages.
Les outils de scraping IA disponibles dans Bright Data comprennent :
- API SERP : Résultats de moteurs de recherche en temps réel, prêts pour les LLM, sur Google, Bing et autres, optimisés pour les agents IA et les systèmes RAG.
- API Unlocker : Contourne les CAPTCHAs et les systèmes de détection de bots à grande échelle, permettant un accès transparent à n’importe quelle page web publique.
- Agent Browser : Navigateurs furtifs sans serveur conçus pour les flux de travail multi-étapes basés sur des agents avec chargement de contenu dynamique et déverrouillage intégré.
- AI Scraper Studio : Créez et déployez des points de terminaison de scraping personnalisés pour n’importe quel site web avec un constructeur visuel sans code, fournissant des données structurées à la demande et à grande échelle.
- Marketplace de Jeux de données : Jeux de données structurés prêts à l’emploi, continuellement mis à jour, pour l’entraînement de modèles, le développement de graphes de connaissances et le déploiement instantané.
Les intégrations open-source incluent langchain-brightdata pour les pipelines LangChain et @brightdata/mcp pour les agents IA basés sur le Model Context Protocol.
Tarification :
- AI Scraper Studio : À partir de 0,75 $/1 000 enregistrements (remise promotionnelle de 25 %, prix régulier 1 $/1k)
- API Unlocker : À partir de 1 $/1 000 requêtes
- Agent Browser : À partir de 5 $/Go
- Proxys résidentiels : À partir de 2,50 $/Go (remise promotionnelle de 50 %, prix régulier 5 $/Go)
- Proxy de centre de données : À partir de 0,90 $/IP
- Essai gratuit disponible sans carte de crédit requise
2. Firecrawl
Firecrawl est une API de Scraping web orientée développeurs qui convertit n’importe quelle URL en Markdown propre prêt pour les LLM ou en JSON structuré. Avec plus de 125 000 étoiles GitHub, c’est l’un des outils de scraping IA les plus largement adoptés dans la communauté des développeurs depuis son lancement.
Firecrawl gère automatiquement le rendu JavaScript, les défis CAPTCHA et le contenu dynamique, facilitant son intégration dans les pipelines IA et les applications LLM. Son API est disponible pour Python, Node.js, Go, Rust et tout langage via REST. Pour des comparaisons avec les outils de Bright Data, voir Bright Data vs. Firecrawl.
Les capacités clés incluent :
- Scrape : Convertir n’importe quelle URL unique en Markdown, HTML ou JSON structuré avec un seul appel API
- Crawl : Scraper récursivement des sites web entiers en suivant les liens sur les sous-pages
- Search : Recherche web avec extraction instantanée du contenu des résultats
- Extract : Extraction de données structurées alimentée par LLM utilisant des schémas en langage naturel
- Rendu JavaScript : Support complet de navigateur headless pour les SPAs et les pages dynamiques
Tarification :
- Gratuit : 1 000 crédits/mois (1 crédit = 1 page)
- Hobby : 16 $/mois (facturé annuellement) : 5 000 crédits/mois
- Standard : 83 $/mois (facturé annuellement) : 100 000 crédits/mois
- Growth : 333 $/mois (facturé annuellement) : 500 000 crédits/mois
- Scale : 599 $/mois : 1 000 000 crédits/mois
- Entreprise : Crédits et limites de débit personnalisés
3. Crawl4AI
Crawl4AI est une bibliothèque Python open-source conçue spécifiquement pour le Scraping web adapté aux LLM. Avec plus de 66 700 étoiles GitHub, c’est l’un des projets de scraping open-source à la croissance la plus rapide disponibles aujourd’hui.
Contrairement aux Scrapers polyvalents, Crawl4AI est conçu de zéro pour les flux de travail IA : il produit du Markdown propre optimisé pour l’efficacité des tokens, prend en charge des stratégies de découpage pour l’ingestion RAG, et s’intègre directement avec les fournisseurs de LLM populaires via son pipeline d’extraction.
Les capacités clés incluent :
- Architecture async-first : Construite sur asyncio et Playwright pour un scraping concurrent à haut débit
- Sortie Markdown optimisée pour les LLM : Supprime la navigation, les publicités et le contenu générique pour produire un contenu propre pour l’ingestion IA
- Stratégies d’extraction : Sélecteurs CSS, XPath, extraction basée sur LLM et filtrage de contenu par similarité cosinus
- Support multi-navigateurs : Chromium, Firefox et WebKit via Playwright
- Exécution JavaScript : Exécute du JS personnalisé avant l’extraction, gère le contenu dynamique et les pages à chargement différé
- Intégrations de fournisseurs IA : OpenAI, Anthropic, Gemini, Ollama, Groq et autres via le pipeline d’extraction
Tarification : Crawl4AI est entièrement gratuit et open-source sous la licence Apache 2.0. Des niveaux cloud et support optionnels sont disponibles pour les équipes souhaitant une infrastructure gérée ou un support dédié.
4. Browse AI
Browse AI est une plateforme de Scraping web et de surveillance sans code qui permet aux utilisateurs d’extraire et de suivre des données depuis n’importe quel site web sans écrire une seule ligne de code. Approuvée par des équipes de grandes entreprises pour automatiser les flux de travail répétitifs de collecte de données.
Le mode d’entraînement visuel de Browse AI vous permet de pointer et cliquer pour apprendre à son IA quels champs de données extraire. Une fois configuré, le robot s’exécute selon un calendrier et pousse les résultats directement vers Google Sheets, Airtable, ou l’une de ses 7 000+ intégrations via Zapier, Make et webhooks.
Les capacités clés incluent :
- 250+ robots préconstruits : Scrapers prêts à l’emploi pour LinkedIn, Amazon, Twitter/X et d’autres sites populaires
- Surveillance de sites web : Détection de changements alimentée par IA avec notifications lors de la mise à jour du contenu
- 7 000+ intégrations : Connexions natives à Google Sheets, Airtable, Zapier, Make, Slack et plus
- Scraping en masse : Exécuter plusieurs URLs dans une seule tâche en utilisant une liste d’URLs ou une entrée CSV
- Accès API : Déclencher et récupérer les exécutions de robots par programmation via l’API REST
Tarification :
- Starter : 19 $/mois : 12 000 crédits/an
- Professional : 69 $/mois : 60 000 crédits/an
- Team : 500 $/mois : crédits et limites d’équipe personnalisés
- Facturation mensuelle disponible à des tarifs légèrement plus élevés
5. Apify
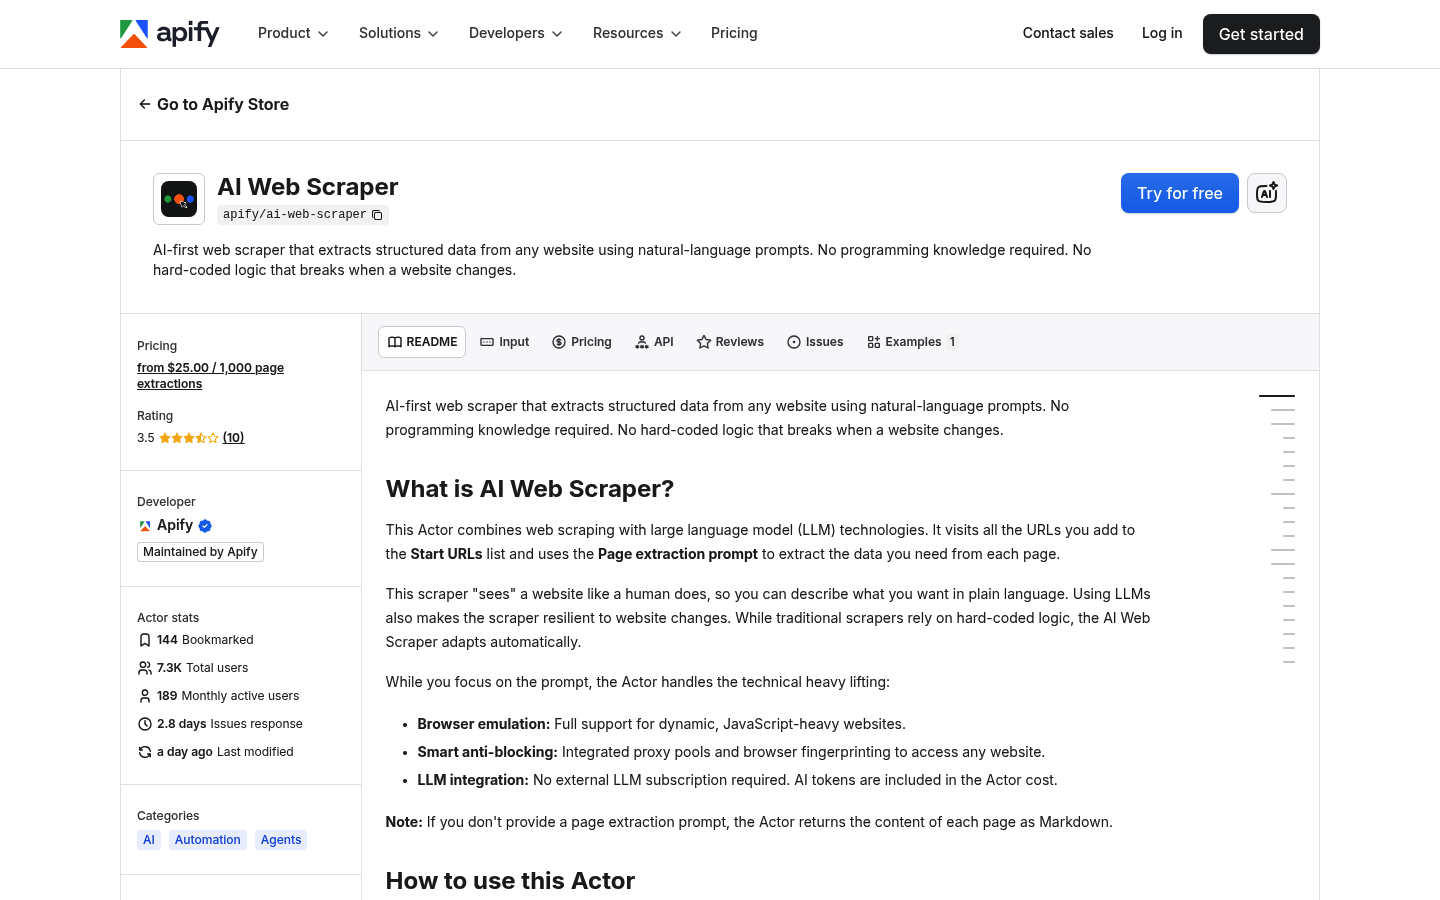
Apify est une plateforme complète de Scraping web et d’automatisation centrée autour d’un marketplace de plus de 33 000 « Actors » réutilisables (programmes sans serveur s’exécutant dans le cloud) pouvant être planifiés, déclenchés via API ou enchaînés dans des pipelines.
Son offre IA phare est l’Actor AI Web Scraper, qui accepte une invite en langage naturel (ex. : « extraire les noms de produits et les prix de cette page ») et retourne du JSON structuré sans nécessiter de code ni de sélecteurs CSS. Cela rend Apify accessible aux utilisateurs non techniques tout en restant hautement extensible pour les développeurs créant des Actors personnalisés en JavaScript ou Python.
Les capacités clés incluent :
- 33 000+ Actors : Scrapers préconstruits pour toutes les grandes plateformes, des réseaux sociaux au e-commerce en passant par l’immobilier
- AI Web Scraper : Extraction pilotée par le langage naturel sans code requis
- Planificateur et webhooks : Exécuter des Actors selon un calendrier cron ou les déclencher par programmation
- Stockage de Jeux de données : Magasins clé-valeur et jeux de données intégrés pour persister et exporter les résultats
- Gestion des Proxys : Rotation intégrée de Proxys résidentiels et de centres de données sur toutes les exécutions
Tarification :
- Gratuit : 0 $ : 5 $ en crédits de plateforme, 0,20 $/unité de calcul
- Starter : 29 $/mois : 29 $ en crédits de plateforme, 0,20 $/unité de calcul
- Scale : 199 $/mois : 199 $ en crédits de plateforme, 0,16 $/unité de calcul (tarif réduit)
- Business : 999 $/mois : 999 $ en crédits de plateforme
6. ScrapeGraphAI
ScrapeGraphAI est une bibliothèque de Scraping web native IA et une API cloud qui utilise des LLM pour extraire des données structurées de n’importe quelle page web à l’aide d’une invite en langage naturel. La bibliothèque open-source a accumulé plus de 26 300 étoiles GitHub et l’API commerciale est certifiée SOC 2 Type II.
L’une des caractéristiques distinctives de ScrapeGraphAI est sa flexibilité en matière de fournisseurs LLM : il prend en charge OpenAI, Anthropic, Google Gemini, Azure, Groq, Ollama (modèles locaux) et plusieurs autres. Cela le rend pratique pour les équipes ayant des préférences spécifiques de modèles ou des exigences sur site.
Les capacités clés incluent :
- Scrape : Convertir n’importe quelle URL en Markdown propre, HTML ou captures d’écran avec mode furtif optionnel
- Extract : Extraction de données structurées alimentée par LLM depuis des pages web utilisant des schémas en langage naturel
- Search : Recherche web avec extraction de contenu intégrée en un seul appel
- Crawl : Crawling complet de site avec extraction par page à une profondeur configurable
- Monitor : Surveiller les pages web pour détecter les changements et recevoir des notifications webhook
- Plusieurs fournisseurs IA : OpenAI, Anthropic, Gemini, Azure, Groq, Ollama et autres
Tarification :
- Gratuit : 0 $ : 500 crédits/mois
- Starter : 17 $/mois : 10 000 crédits/mois
- Growth : 85 $/mois : 100 000 crédits/mois
- Pro : 425 $/mois : 750 000 crédits/mois
- Entreprise : Crédits personnalisés et support dédié
7. Diffbot
Diffbot est une plateforme d’extraction IA de niveau entreprise qui identifie automatiquement le type de n’importe quelle page web (article, produit, personne, organisation, avis, événement) et retourne du JSON entièrement structuré, sans aucune configuration de modèle. Fondée en 2012, c’est l’une des sociétés de données web IA les plus établies sur le marché.
Au-delà de l’extraction au niveau des pages, Diffbot exploite un Knowledge Graph contenant plus de 31 milliards d’entités du monde réel, le rendant adapté aux cas d’usage impliquant la résolution d’entités, la cartographie des relations et la construction de bases de connaissances à grande échelle.
Les capacités clés incluent :
- Détection automatique de type : Identifie les types de pages article, produit, personne, événement et autres sans configuration
- Knowledge Graph : Plus de 31 milliards d’entités avec données relationnelles pour la résolution d’entités et les requêtes sémantiques
- API Crawl : Crawler des domaines entiers et appliquer des règles d’extraction sur toutes les pages découvertes
- API Langage Naturel : Extraction de faits et de relations alimentée par NLP à partir de texte
- Aucun codage requis : API REST sans configuration de sélecteur pour les types de pages pris en charge
Tarification :
- Gratuit : 0 $ : 10 000 crédits/mois (1 crédit = 1 extraction de page)
- Startup : 299 $/mois : 250 000 crédits/mois (0,001 $ par crédit)
- Scale : 899 $/mois : 1 000 000 crédits/mois (0,0009 $ par crédit)
- Entreprise : Attribution de crédits et tarification personnalisées
8. Browserbase
Browserbase est une infrastructure de navigateur headless hébergée dans le cloud conçue pour les agents IA et les flux de travail automatisés. Plutôt qu’une API de scraping au sens traditionnel, elle fournit des navigateurs distants évolutifs que votre agent ou script contrôle via Playwright, Puppeteer ou Selenium, avec mode furtif et rotation de Proxys intégrés au niveau de l’infrastructure.
Browserbase est particulièrement utile pour les développeurs d’agents IA qui ont besoin de sessions de navigateur fiables et observables à grande échelle. Ses outils de replay de session et de débogage offrent une visibilité complète sur ce que chaque session de navigateur a accompli, ce qui est essentiel pour diagnostiquer les échecs dans des flux de travail multi-étapes complexes.
Les capacités clés incluent :
- Navigateurs furtifs : Navigateurs cloud avec gestion intégrée des empreintes digitales et évasion de la détection de bots
- Compatible Playwright/Puppeteer/Selenium : Remplacement direct des navigateurs headless locaux, sans modification de code nécessaire
- Replay de session : Replay visuel complet de chaque session de navigateur pour le débogage et l’audit
- Proxys intégrés : Rotation de Proxys résidentiels avec facturation par Go, inclus dans tous les plans payants
- SDK Stagehand : Framework d’agents IA open-source construit sur Browserbase pour l’automatisation de navigateur en langage naturel
Tarification :
- Gratuit : 0 $ : sessions limitées pour le prototypage
- Developer : 20 $/mois : puis 0,12 $/heure de navigateur
- Production : 99 $/mois : puis 0,10 $/heure de navigateur, 5 Go de Proxys inclus
- Entreprise : Tarification personnalisée avec infrastructure dédiée
9. Octoparse
Octoparse est une plateforme de Scraping web sans code établie, disponible à la fois comme application de bureau Windows/Mac et comme service cloud. Présente sur le marché depuis 2014, elle est largement utilisée par les analystes métier, les chercheurs en Etude de marché et les équipes opérationnelles qui ont besoin de données structurées sans écrire de code.
Octoparse utilise l’IA pour détecter automatiquement les champs de données et les modèles de pagination lorsque vous chargez une page dans son Scraper visuel, réduisant considérablement le temps de configuration par rapport à la configuration manuelle des sélecteurs. Sa bibliothèque de plus de 250 modèles couvre de nombreux sites web populaires et types de données prêts à l’emploi.
Les capacités clés incluent :
- Scraper visuel pointer-cliquer : Pas de sélecteurs CSS ni de XPath : cliquez sur les données souhaitées sur la page en direct
- 250+ modèles : Scrapers préconstruits pour Amazon, LinkedIn, Tripadvisor et d’autres grands sites
- Détection automatique de pagination : L’IA identifie et gère automatiquement les ensembles de données multi-pages
- Extraction cloud : Exécuter des tâches sur les serveurs cloud d’Octoparse 24h/24 7j/7, exporter vers Excel, CSV, JSON ou bases de données
- Rotation d’IP : Rotation intégrée de Proxys pour réduire les blocages lors des exécutions à grande échelle
- Exécutions planifiées : Configurer des Scrapers pour s’exécuter selon un calendrier fixe sans intervention manuelle
Tarification :
- Gratuit : 0 $ : 10 tâches de scraping, 50 000 lignes/mois exportées, exécution locale
- Standard : À partir de 69 $/mois : 100 tâches, extraction cloud, 3 exécutions cloud simultanées
- Entreprise : À partir de 399 $ : limites de tâches personnalisées, ressources cloud dédiées, support prioritaire
- Garantie de remboursement de 5 jours sur tous les plans payants
Conclusion
Le paysage du Scraping web par IA en 2026 s’est considérablement diversifié, avec de solides options à tous les niveaux : des bibliothèques Python open-source comme Crawl4AI et ScrapeGraphAI aux plateformes d’entreprise complètes comme Bright Data et Diffbot, en passant par des outils sans code comme Browse AI et Octoparse pour les utilisateurs non techniques.
Le bon outil dépend de vos priorités. Si vous avez besoin d’une échelle maximale, de fiabilité et d’un accès à la plus large infrastructure de Proxys, la suite Bright Data couvrant l’API Unlocker, l’Agent Browser et l’API Web Scraper est l’option la plus complète disponible. Pour les pipelines LLM orientés développeurs, Firecrawl et Crawl4AI offrent la meilleure expérience d’intégration avec les frameworks IA modernes. Pour les équipes ayant besoin d’un marketplace d’actors prêt à l’emploi, les 33 000+ scrapers préconstruits d’Apify réduisent considérablement le délai d’accès aux données.
Quel que soit l’outil choisi, assurez-vous qu’il gère nativement la rotation de Proxys et le contournement des anti-bots : ils ne sont plus optionnels pour tout flux de travail de scraping en production.