L’architecture de pipeline de données est la conception du système qui déplace les données des sources vers les personnes, modèles et agents. Elle définit comment les données sont collectées, stockées, vérifiées, transformées et servies.
Quand des sites web publics sont une source, un pipeline peut enregistrer un succès alors qu’un détaillant sert une page de sélection de pays au lieu des prix. Depuis une connexion domestique, chacun des 4 clients open-source a récupéré 13 pages de recherche et de listing 3 fois. Sur 88 réponses réussies, 39 n’avaient aucune donnée utilisable.
Ce guide montre comment concevoir chaque étape, choisir un modèle, détecter ces échecs et décider quoi construire ou acheter.
TL;DR
- Vérifiez les données attendues, pas les pages de blocage. Un détecteur de pages de blocage n’a signalé que 8 des 39 réponses réussies sans données.
- Modélisez chaque champ à sa propre granularité. Amazon partage un total d’avis unique entre les variantes d’une annonce, donc additionner les lignes a surévalué le nombre d’avis de 20 produits de 23%.
- À volume élevé, laissez une IA écrire le parseur, pas lire chaque page. Le contenu principal d’une page Amazon utilisait 19 fois les tokens de son enregistrement à 12 champs.
- Comparez les collecteurs par coût par enregistrement accepté. Dans le test de récupération, 39 des 88 réponses réussies n’avaient aucune donnée, donc comptez seulement les lignes qui passent votre contrat de données.
Diagramme et étapes de l’architecture de pipeline de données
Une architecture de pipeline de données typique comporte 5 étapes. Chaque étape fait un travail, et l’étape suivante peut vérifier sa sortie :
- Collecter. Extraire les données de chaque source, en utilisant la capture de données de modification pour les bases de données, les appels API pour les outils SaaS, et les requêtes HTTP ou navigateur pour les sites web.
- Stocker en brut. Écrire les données dans un stockage objet exactement comme elles sont arrivées, avant toute analyse. Dans une architecture medallion, ces données brutes forment la couche bronze.
- Valider. Vérifier chaque enregistrement par rapport à un contrat de données qui liste les champs requis, les types et les plages. Envoyer les enregistrements qui échouent en quarantaine, avec un code de raison.
- Transformer. Dédupliquer, joindre et modéliser les données dans un entrepôt ou lakehouse. Les tables silver contiennent les lignes validées, et les tables gold sont prêtes à l’emploi.
- Servir. Livrer le résultat aux tableaux de bord, applications, modèles et agents IA.
Un orchestrateur tel qu’Airflow, Dagster ou Prefect planifie les étapes. La surveillance suit la fraîcheur, le volume, les taux de remplissage des champs et le coût par enregistrement accepté sur toutes ces étapes.
Le pipelining de données est le terme général pour construire et exécuter des pipelines, et « data pipes » est un nom informel pour les pipelines eux-mêmes. ETL (extraction, transformation, chargement) est un modèle parmi d’autres, et ELT en est un autre, qui charge d’abord les données brutes et les transforme dans l’entrepôt.
Une architecture de pipeline de big data utilise les mêmes 5 étapes à un volume où le stockage et le calcul doivent évoluer séparément. Elle garde donc généralement les données dans un stockage objet et des formats de tables ouverts.
Les données web publiques ajoutent une étape de découverte qui trouve les URLs valant la peine d’être collectées, et l’API SERP peut l’exécuter à partir des résultats de recherche. Pour la collecte, la Web Scraper API de Bright Data renvoie des enregistrements structurés depuis des sites web publics. Web Unlocker gère les défenses anti-bot et renvoie la page brute pour les équipes qui écrivent leurs propres parseurs.
Ce diagramme d’architecture de pipeline de données montre comment les étapes se connectent quand des sites web publics sont l’une des sources :
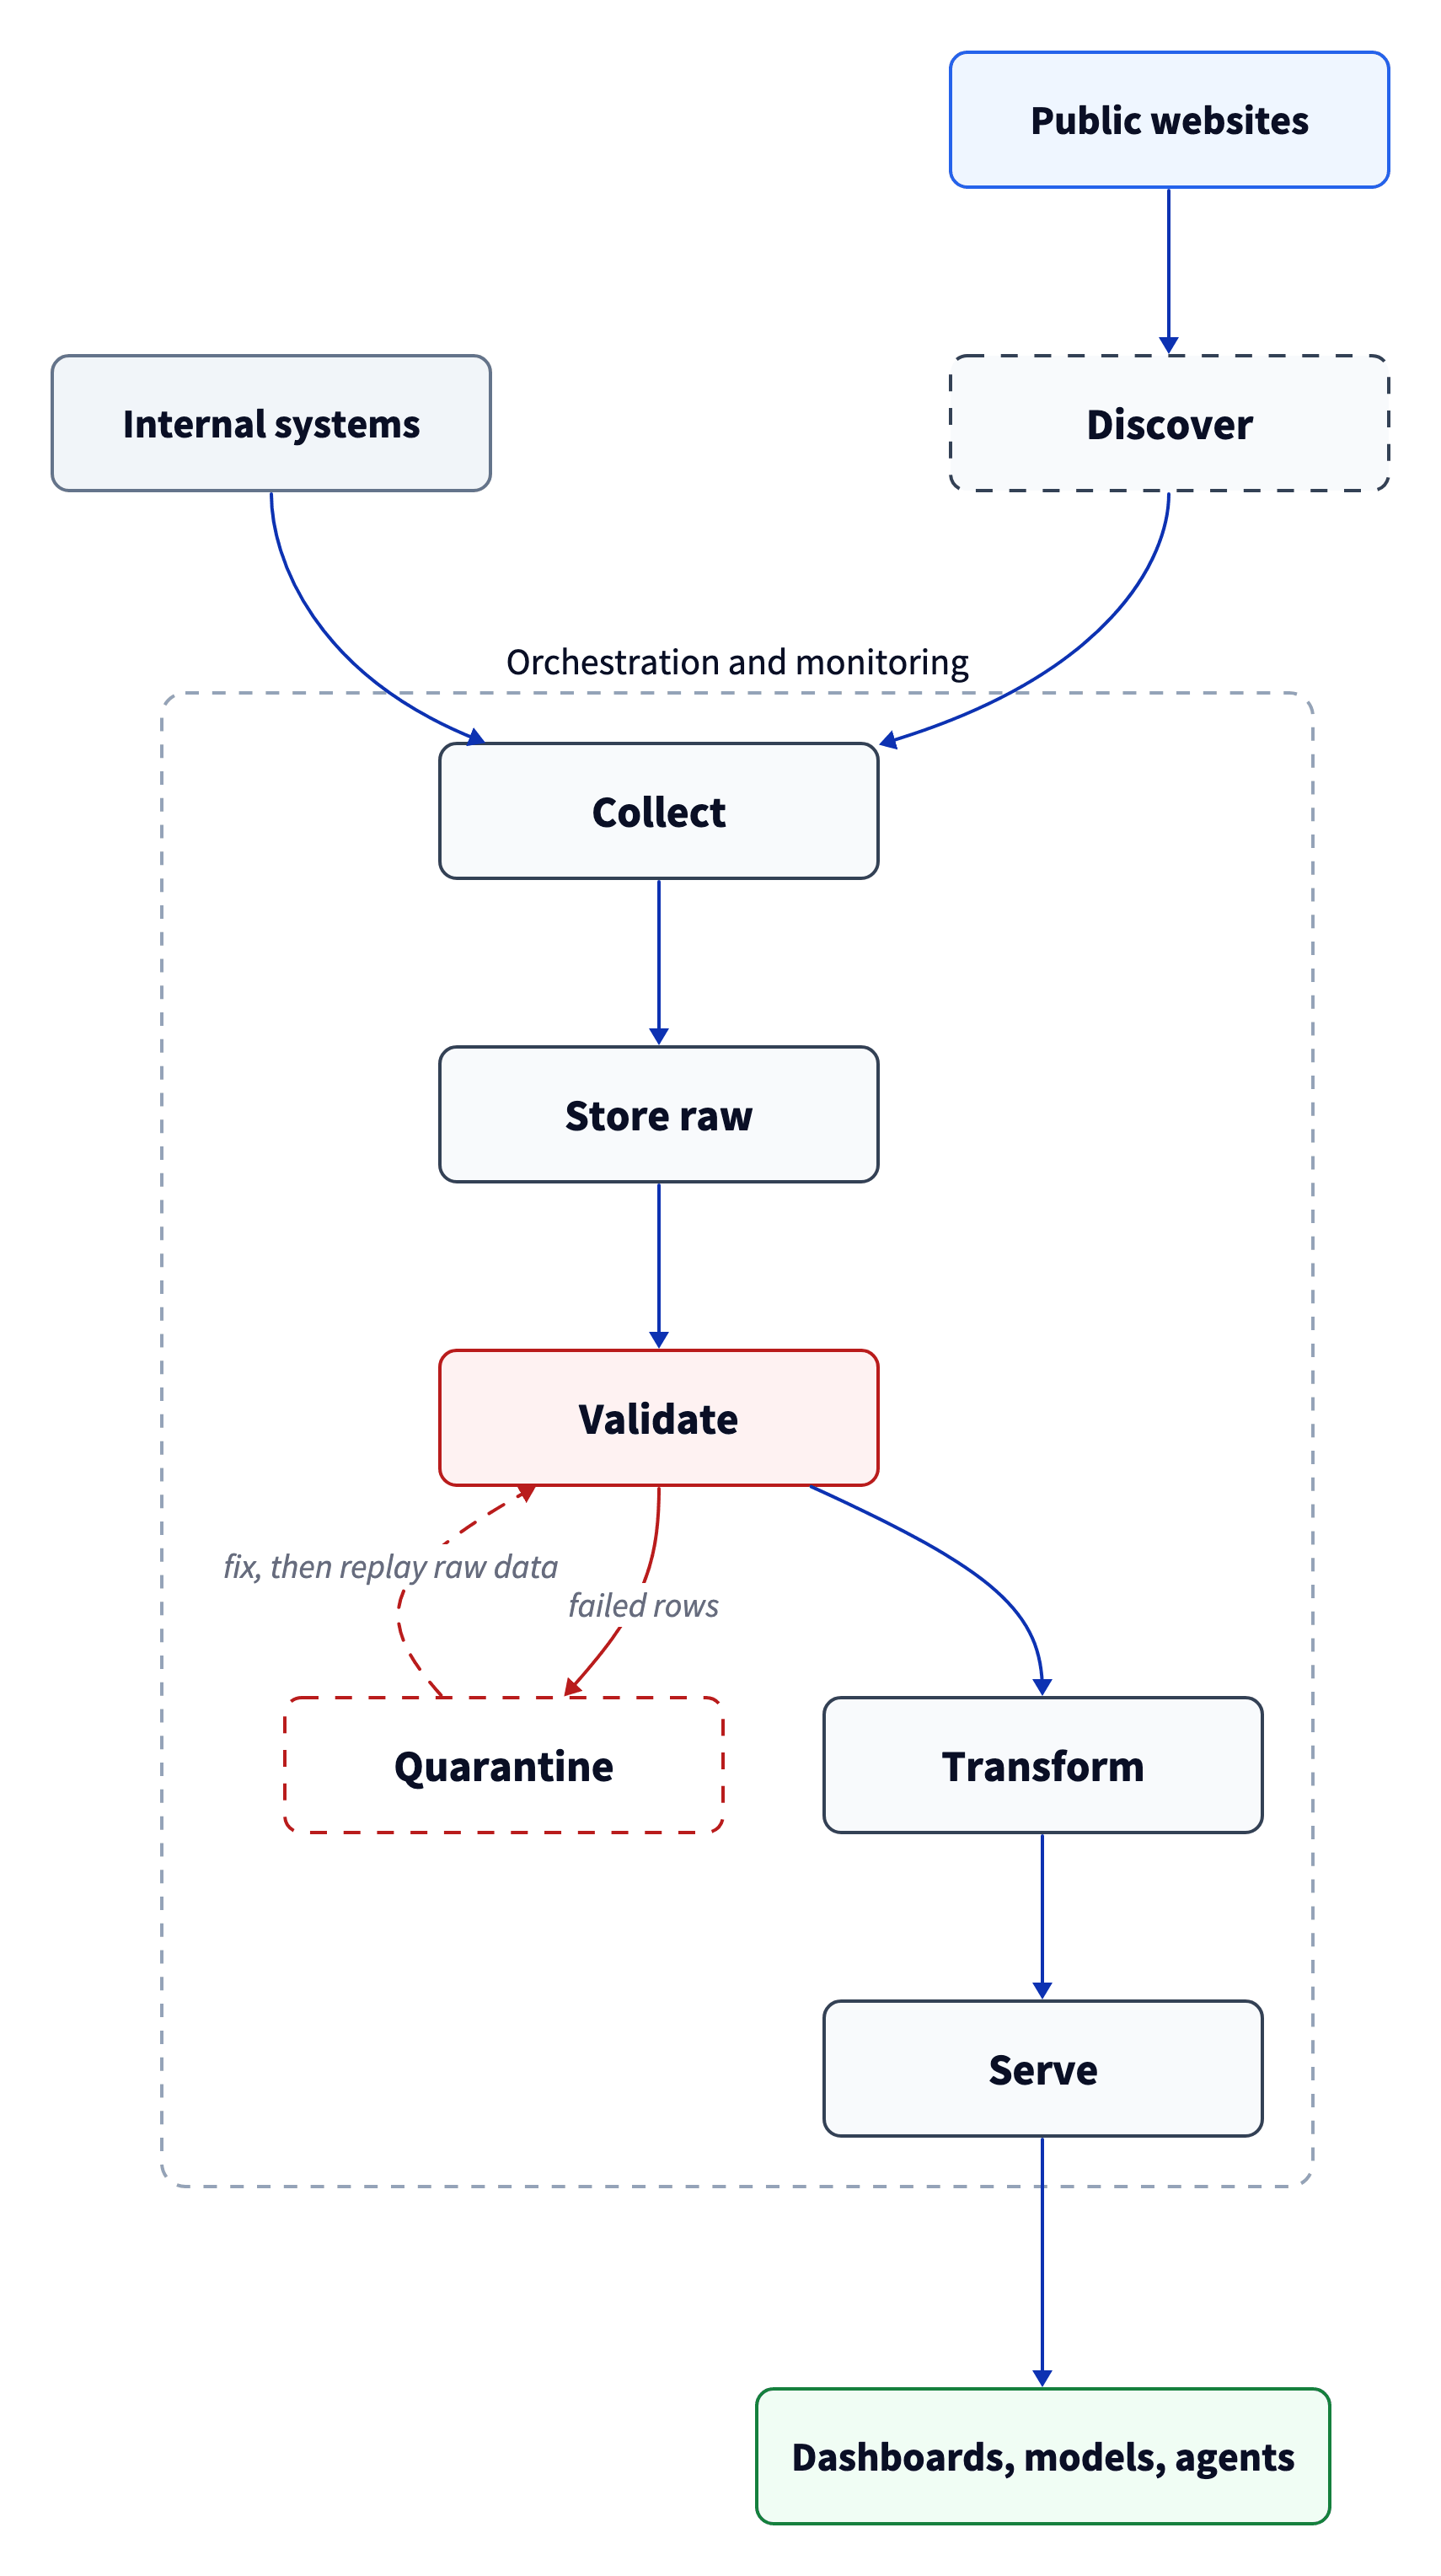
Les sources web ajoutent le plus de travail à l’étape de validation et sur le chemin de quarantaine.
Exemples d’architecture de pipeline de données par batch, streaming, hybride et à la demande
Le bon modèle dépend de la rapidité avec laquelle la décision a besoin de nouvelles données.
Batch. Un détaillant collecte les prix concurrents de 50K produits chaque nuit, et un agent de retarification les lit le matin. La Web Scraper API peut livrer chaque exécution directement vers des destinations telles qu’Amazon S3, Google Cloud Storage ou Snowflake.
Streaming. Une équipe de marque surveille les publications sociales et les actualités, car une mention peut perdre de la valeur en quelques heures. Kafka transporte les événements, un processeur de flux tel que Flink calcule des comptes sur des fenêtres temporelles, et un connecteur écrit les résultats dans une table Iceberg. Pour un exemple travaillé avec Spark, consultez le guide Spark Structured Streaming avec des données web.
Hybride. Une équipe de recherche en investissement garde un batch quotidien d’offres d’emploi pour l’historique et diffuse les changements de prix pour une courte liste de surveillance de produits. Les anciennes conceptions exécutaient cela comme 2 chemins séparés, connus sous le nom d’architecture Lambda. De nombreuses piles plus récentes écrivent le flux dans une table Iceberg, donc les tâches batch et streaming lisent les mêmes données.
À la demande. Un agent d’achat vérifie le prix et le stock en direct d’un produit quand un utilisateur demande. Le pipeline sert la dernière ligne validée sauf si elle est plus ancienne que ce que la décision permet. Si c’est le cas, une requête synchrone Web Scraper API renvoie un enregistrement à jour en un seul appel, et le pipeline le vérifie par rapport au même contrat. Donnez à la récupération en direct un délai d’expiration que l’utilisateur peut accepter, et s’il expire, répondez avec la ligne stockée et son âge.
Paramètres par défaut pour une architecture de pipeline de données moderne
Commencez une nouvelle conception de pipeline de données à partir de ces défauts pour chaque couche :
| Couche | Défaut | Pourquoi |
|---|---|---|
| Stockage et tables | Fichiers bruts dans un stockage objet, tables dans un format ouvert tel qu’Apache Iceberg | Snowflake, Databricks et les moteurs open-source lisent les mêmes tables Iceberg, donc une copie des données peut tous les servir |
| Transformation | Modèles SQL dans le contrôle de version, construits avec un outil tel que dbt | Les modèles bénéficient d’une revue de code et de tests comme tout autre code |
| Orchestration | Une version supportée d’Airflow, Dagster ou Prefect | Vérifiez la fenêtre de support avant de commencer. Airflow 2 a atteint sa fin de vie en avril 2026 |
| Contrats de données | Un fichier de contrat pour chaque table, dans un format tel que l’Open Data Contract Standard (ODCS) | ODCS peut aussi indiquer comment les agents IA peuvent utiliser les données, donc les règles d’utilisation sont stockées avec les types et propriétaires |
| Accès des agents | Une interface Model Context Protocol (MCP) sur des tables gouvernées | La plupart des frameworks d’agents supportent MCP, et un projet de la Linux Foundation le maintient |
Si vous utilisez encore AWS Data Pipeline, planifiez une migration, car AWS l’a fermé aux nouveaux clients en 2024.
Pourquoi les données web publiques ont besoin d’un pipeline d’ingestion de données différent
Contrairement aux sources internes, les sites web publics ne coordonnent pas leurs changements avec votre équipe. Ils peuvent changer le balisage et les défenses anti-bot sans préavis, varier le contenu selon la localisation ou le client, et renvoyer un statut de succès sans données. Les sources internes changent généralement de manière planifiée, comme une migration de schéma ou une nouvelle version d’API.
Un statut de succès ne garantit pas que les données sont arrivées
Un statut 2xx montre seulement qu’un serveur a répondu. Un test de récupération sur 13 pages de recherche et de listing montre ce qu’un statut 2xx peut cacher. Les pages provenaient de sites de vente au détail, voyage, emploi, immobilier, avis et recherche.
Chacun des 4 clients open-source courants a récupéré chaque page 3 fois, depuis une connexion internet domestique en Inde, sans proxys. Une réponse comptait comme donnée seulement si elle contenait les motifs HTML qui marquent les annonces de ce site. Votre part de réponses réussies vides différera selon le client et le réseau, donc mesurez-la avec une vérification de contenu comme celle ci-dessous.
| Client | Réponses 2xx | Réponses 2xx sans données | Sites avec données dans l’une des 3 récupérations (sur 13) |
|---|---|---|---|
Python requests, en-têtes par défaut |
15 | 9 | 2 |
Python requests, en-têtes Chrome |
24 | 10 | 5 |
curl_cffi imitant Chrome |
29 | 9 | 7 |
| Chrome headless (Playwright) | 20 | 11 | 3 (8 dans une nouvelle exécution avec un User-Agent normal) |
Sur tous les clients, 39 des 88 réponses réussies n’avaient aucune donnée utilisable, 27 avec HTTP 200 et 12 avec HTTP 202. Un code de statut pouvait signaler une récupération échouée mais ne pouvait pas confirmer une bonne.
L’une des 39 était cette page, qu’un détaillant a servie avec HTTP 200 à la connexion domestique en Inde au lieu des résultats de recherche :
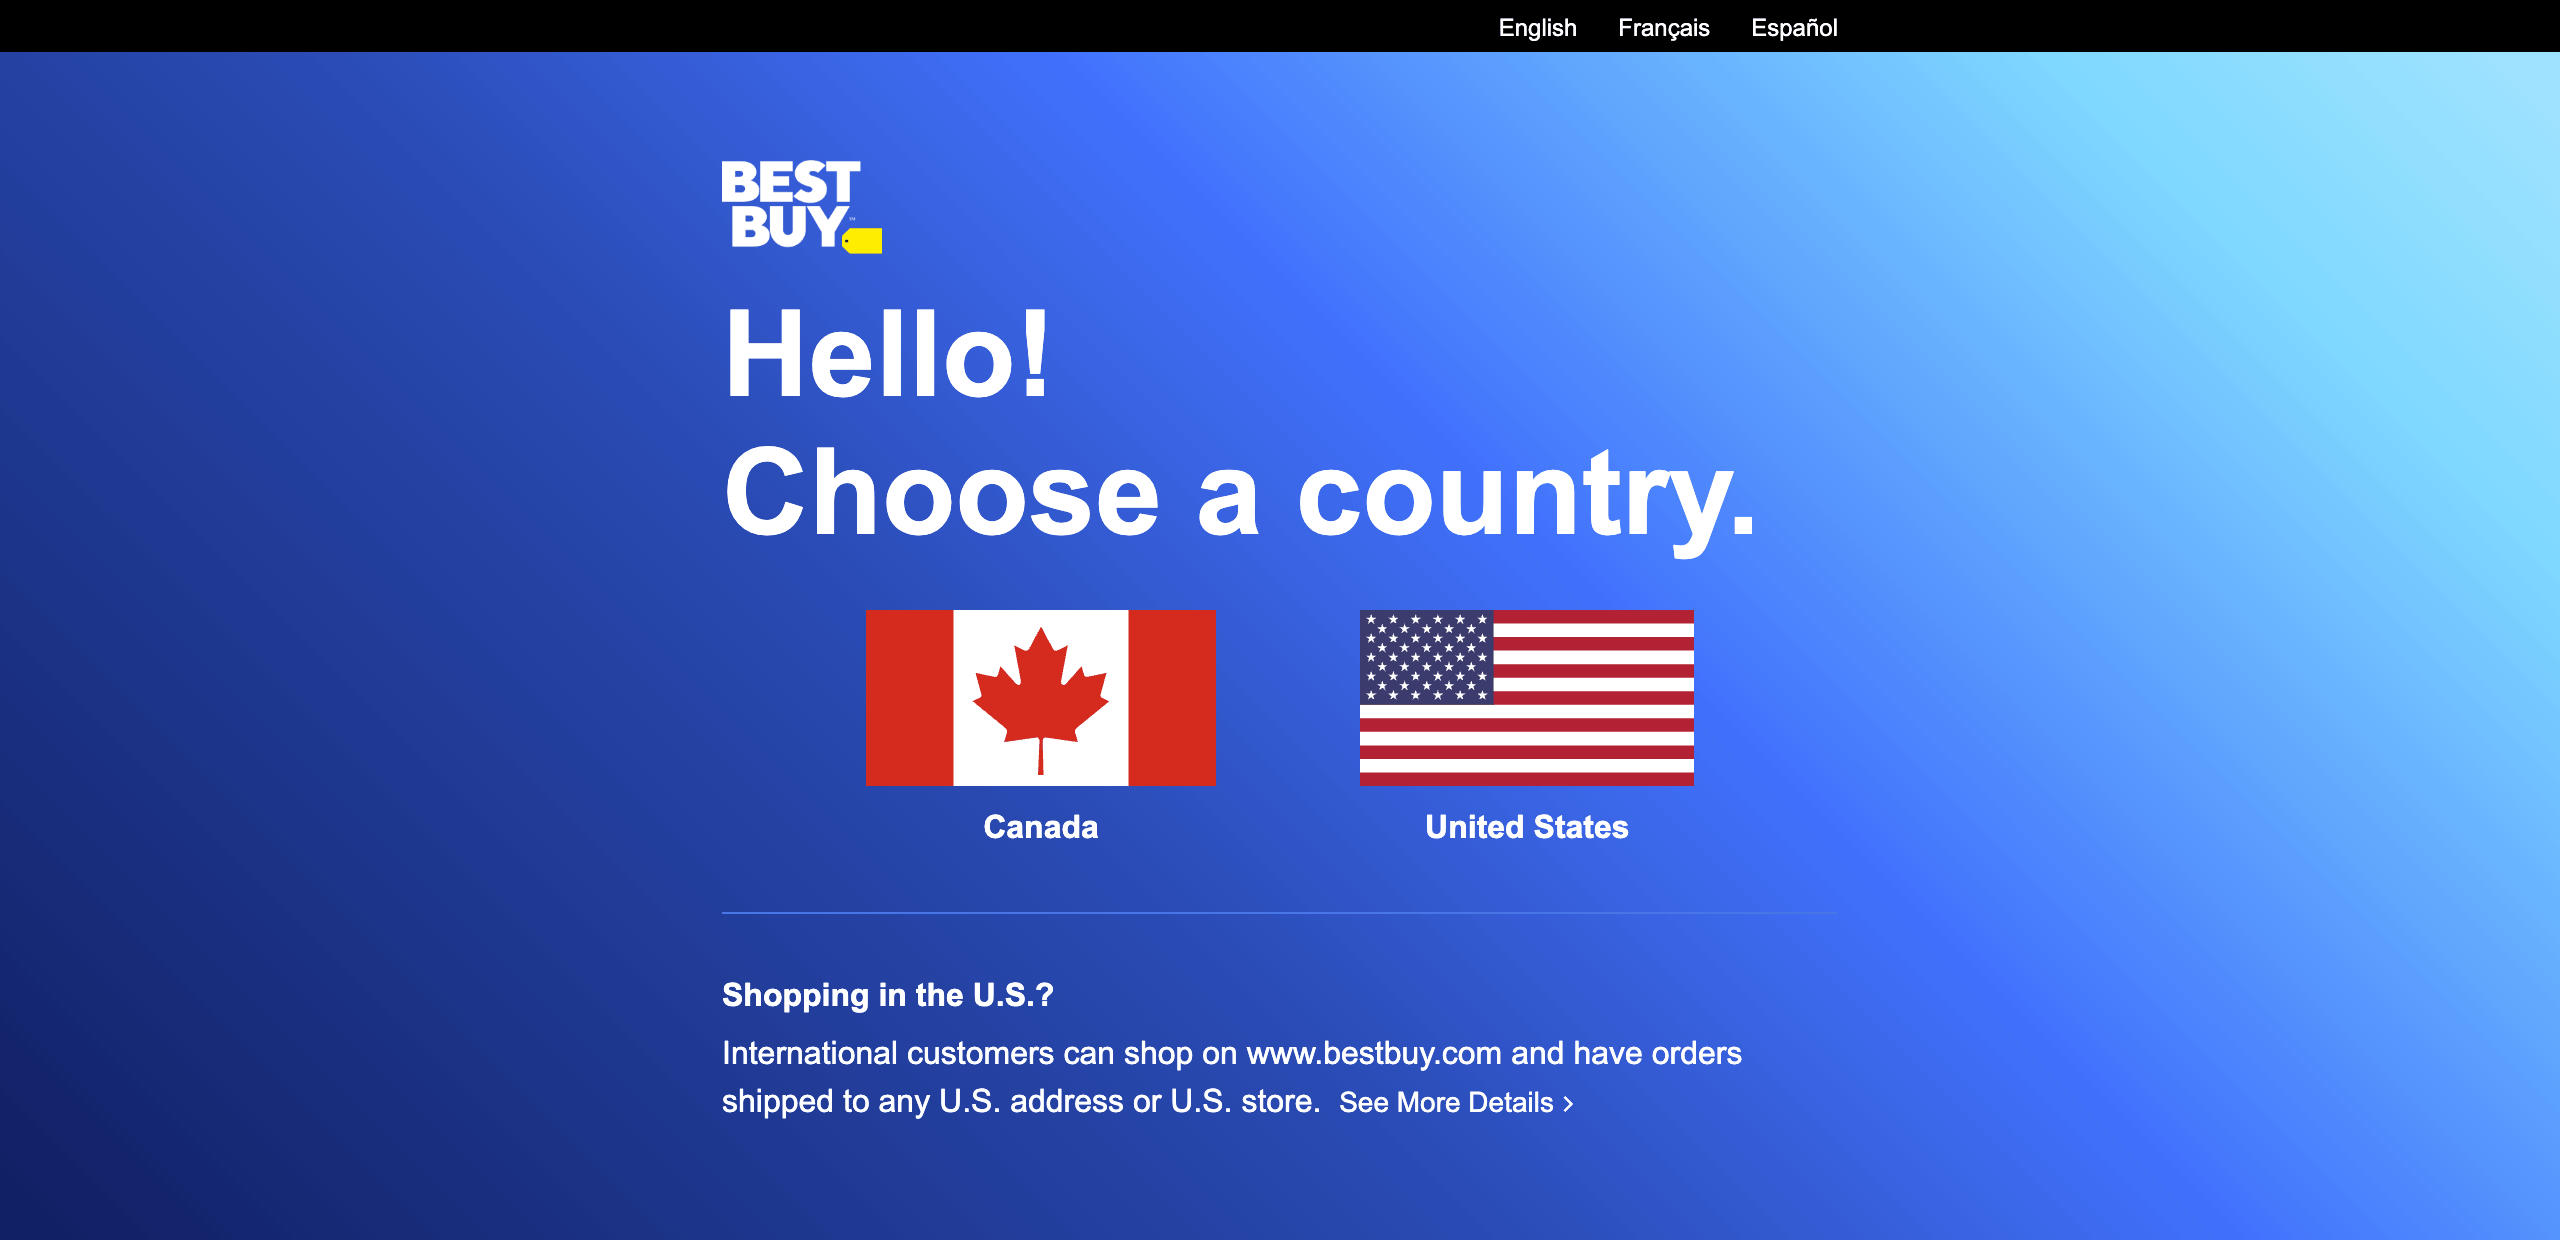
Rendu à partir du HTML sauvegardé de cette réponse.
Les échecs ne ressemblaient pas à des erreurs. Un détecteur construit à partir de 8 signatures courantes de pages de blocage, telles que les pages d’appui prolongé et de trafic inhabituel, n’a signalé que 8 des 39. Le reste était des pages de défi que la liste ne couvrait pas, une page de sélection de pays d’un détaillant, des pages uniquement JavaScript, et des pages de 670 Ko avec des résultats vides.
Les pages de 670 Ko semblaient complètes sauf pour une zone de résultats vide :
La page que Chrome headless a reçue avec HTTP 202, rendue à partir de son HTML sauvegardé. Une vérification sur la taille de réponse l’aurait laissée passer.
Le même détecteur a signalé 12 des 49 bonnes réponses comme bloquées. Sur 2 des sites, un script de défense anti-bot se charge sur des pages de listing normales, et sa balise correspondait à l’une des signatures. Testez les données attendues, pas une page de blocage.
Les défenses anti-bot comparent les clients aux vrais navigateurs
Les sites peuvent identifier un client avant l’envoi de tout HTML, en comparant son empreinte TLS et ses en-têtes à ceux de vrais navigateurs. Dans une vérification d’empreinte, l’empreinte TLS de Web Unlocker correspondait à celle d’un Chrome installé à jour. Au moment du test, la cible Chrome la plus récente dans la bibliothèque d’imitation curl_cffi avait 5 versions majeures de retard sur le Chrome installé. Chrome headless n’a obtenu de données que de 3 des 13 sites alors que son User-Agent contenait HeadlessChrome, et de 8 avec un User-Agent normal.
Depuis cette connexion domestique, 5 des 13 sites n’ont renvoyé aucune donnée à aucun client open-source, mais le test n’a pas séparé le client du réseau. Maintenir l’accès fonctionnel signifie suivre les versions de navigateurs, les empreintes, les en-têtes et la réputation IP au fur et à mesure qu’ils changent. Vous engagez soit des personnes pour ce travail, soit vous l’achetez, via Web Unlocker pour les pages ou la Browser API pour des sessions navigateur complètes.
Les agents font face aux mêmes défenses
Sur les 13 URLs du test de récupération, l’outil WebFetch de Claude Code a renvoyé des listings de 2 d’entre elles en une seule exécution. Sur les 11 autres requêtes, 7 ont renvoyé un statut d’erreur.
Les 4 restantes ont renvoyé une page de défi, une page de sélection de pays, une page vide et un message d’erreur, toutes avec un statut de succès. L’agent doit vérifier le contenu lui-même.
Pour l’accès en direct, les agents peuvent utiliser le serveur MCP Bright Data, qui exécute des recherches et des récupérations de pages via l’API SERP et Web Unlocker.
Certains sites permettent aussi aux agents de s’identifier et d’obtenir un accès selon des termes convenus. Les sites sur Cloudflare peuvent vérifier les agents qui signent leurs requêtes avec Web Bot Auth. La norme Really Simple Licensing (RSL) permet à un site de publier des termes de licence. Quand un site offre l’un ou l’autre, prévoyez de l’utiliser.
Vérifiez ce que le collecteur rapporte, pas seulement le statut HTTP
Web Unlocker rapporte le résultat de chaque récupération dans 2 en-têtes de réponse. x-brd-status-code contient le statut du site cible. x-brd-error contient la raison quand une récupération échoue, comme listé dans les codes d’erreur Web Unlocker. Votre code d’ingestion doit décider quoi faire en fonction de ces en-têtes, du statut propre de l’appel API, et du contenu.
Sauvegardez cette vérification sous content_check.py. Elle lève une erreur pour une mauvaise clé ou zone, et sinon renvoie accept, retry, ou quarantine dans son champ action :
import os, re, requests

# One marker per source, a pattern that appears only when real records are present.
MARKERS = {
    "amazon_search": r'data-component-type="s-search-result"',
    "walmart_search": r'"usItemId"',
}


def fetch_and_check(source: str, url: str, min_hits: int = 5) -> dict:
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"},
        timeout=(15, 240),
    )
    # A bad key or zone name. A retry won't fix it.
    if r.status_code in (400, 401, 403):
        r.raise_for_status()
    # The fetch failed or reached a rate limit. Retry later.
    if r.headers.get("x-brd-error") or r.status_code == 429 or r.status_code >= 500:
        reason = r.headers.get("x-brd-error") or f"HTTP {r.status_code}"
        return {"source": source, "action": "retry", "reason": reason[:60]}
    hits = len(re.findall(MARKERS[source], r.text))
    action = "accept" if hits >= min_hits else "quarantine"
    return {
        "source": source,
        "action": action,
        "target_status": r.headers.get("x-brd-status-code"),
        "marker_hits": hits,
        "bytes": len(r.content),
    }


if __name__ == "__main__":
    amazon = "https://www.amazon.com/s?k=noise+cancelling+headphones"
    walmart = "https://www.walmart.com/search?q=noise+cancelling+headphones"
    print(fetch_and_check("amazon_search", amazon))
    print(fetch_and_check("walmart_search", walmart))
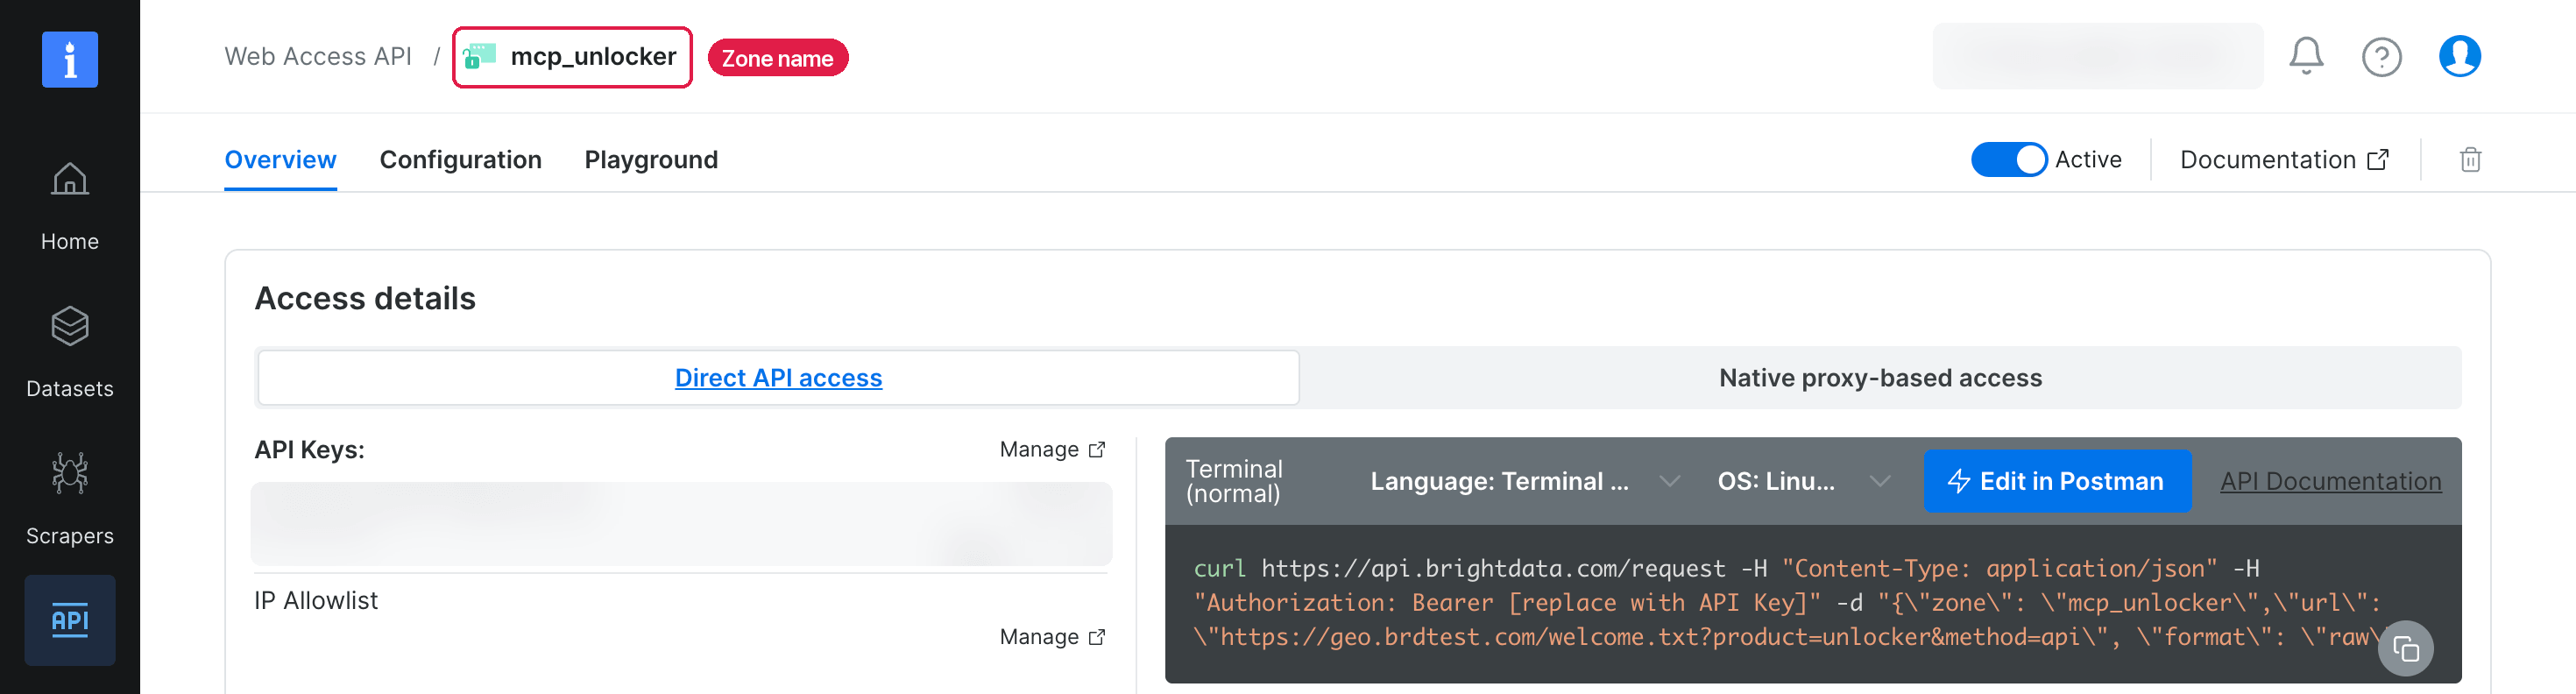
Pour l’exécuter, créez une zone Web Unlocker, une configuration nommée pour ce produit, sous Web Access dans le panneau de contrôle Bright Data. Les nouveaux comptes reçoivent des crédits gratuits mensuels, suffisants pour exécuter les scripts de ce guide.
Créez une clé API sous Paramètres du compte dans le panneau de contrôle, et sauvegardez-la dans une variable d’environnement nommée BRIGHTDATA_API_KEY. Remplacez web_unlocker par le nom de votre zone. Le nom apparaît en haut de la page de la zone, et l’exemple de requête de la page l’utilise :
Après pip install requests, exécutez python content_check.py. Une exécution d’exemple a accepté les deux pages :
{'source': 'amazon_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 16, 'bytes': 1516805}
{'source': 'walmart_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 395, 'bytes': 1535496}
Votre pipeline répète une récupération retry avec un backoff, attendant plus longtemps après chaque échec. Une page quarantine va vers une personne ou un classificateur, car la source a peut-être changé. Les interfaces peuvent changer sans préavis, donc quand une source renvoie soudainement aucune donnée, vérifiez d’abord que son marqueur apparaît encore dans le HTML de la page.
Un pipeline d’ingestion de données de référence pour les sources web
Le pipeline de référence ci-dessous utilise la Web Scraper API, qui renvoie des enregistrements structurés, de sorte que les vérifications de validation examinent les champs au lieu d’analyser les pages.
Filtrer ce que la découverte renvoie
Pour une recherche sur un modèle de casque, l’API SERP a renvoyé les 7 résultats organiques de Google, l’AI Overview, les vidéos et People Also Ask comme champs JSON séparés. Google n’a classé que 3 pages de détaillants parmi les 7, et l’une d’elles vendait un produit différent, la version écouteurs du même modèle. La déclaration de l’AI Overview sur le prix citait un avis YouTube, pas un détaillant, comme sa première source. Traitez les réponses IA comme des affirmations à vérifier, et filtrez les résultats par domaine et par un identifiant tel qu’un numéro de modèle.
Construire et exécuter le pipeline
Le pipeline prend une liste d’URLs de produits, telles que des résultats de découverte filtrés. Il démarre une tâche avec le point de terminaison /trigger de la Web Scraper API, la suit avec /progress, et télécharge les enregistrements avec /snapshot. Avec include_errors=true, l’API rapporte chaque entrée échouée comme son propre enregistrement avec un error_code.
En Python, le SDK Bright Data remplace ces 3 appels par un seul appel par scraper. Le script ci-dessous appelle directement les points de terminaison, donc chaque étape reste visible, et le script fonctionne avec n’importe quel orchestrateur. Sauvegardez-le sous pipeline.py. Ses fonctions suivent les étapes du diagramme, avec collect(), store_raw(), validate(), et model() pour les tables, puis domain_checks() pour les signalements :
"""Reference web data pipeline that collects, stores raw, validates, models, and checks.

Collection: Bright Data Web Scraper API (async trigger + snapshot download).
Storage: a local folder in place of object storage (bronze), DuckDB for silver and gold.
"""
import json, os, sys, time, pathlib, datetime as dt
import duckdb, requests
from pydantic import BaseModel, Field, ValidationError

API = "https://api.brightdata.com/datasets/v3"
# Replay needs no key.
HEADERS = {"Authorization": f"Bearer {os.environ.get('BRIGHTDATA_API_KEY', '')}"}
DATASET = "gd_l7q7dkf244hwjntr0"  # Amazon products, collect by URL
LAKE = pathlib.Path("lake")


def collect(inputs: list[dict]) -> str:
    """Trigger an async collection and wait for it. Returns the snapshot ID."""
    params = {"dataset_id": DATASET, "include_errors": "true"}
    r = requests.post(
        f"{API}/trigger", headers=HEADERS, json=inputs, params=params, timeout=60
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]
    deadline = time.time() + 3600  # fail after an hour, so the orchestrator can alert
    while time.time() < deadline:
        url = f"{API}/progress/{snapshot_id}"
        p = requests.get(url, headers=HEADERS, timeout=60).json()
        if p["status"] == "ready":
            summary = {k: p.get(k) for k in ("records", "errors", "error_codes")}
            print("progress:", summary)
            return snapshot_id
        if p["status"] in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} ended as {p['status']}")
        time.sleep(15)
    raise TimeoutError(f"snapshot {snapshot_id} not ready after 1 hour")


def store_raw(snapshot_id: str) -> pathlib.Path:
    """Write the snapshot unchanged to an immutable, partitioned path."""
    url = f"{API}/snapshot/{snapshot_id}"
    r = requests.get(url, headers=HEADERS, params={"format": "ndjson"}, timeout=300)
    # Anything but 200, such as 202 while the snapshot builds, isn't data.
    if r.status_code != 200:
        raise RuntimeError(
            f"snapshot {snapshot_id} not downloadable: HTTP {r.status_code}"
        )
    day = dt.datetime.now(dt.timezone.utc).date()
    path = LAKE / "bronze/amazon_products" / f"dt={day}" / f"{snapshot_id}.ndjson"
    path.parent.mkdir(parents=True, exist_ok=True)
    if not path.exists():  # a stored snapshot is never rewritten
        path.write_bytes(r.content)
    return path


class Product(BaseModel):
    """The data contract, which defines what downstream tables can receive."""
    asin: str = Field(pattern=r"^[A-Z0-9]{10}$")
    parent_asin: str | None = None
    title: str = Field(min_length=3)
    final_price: float = Field(gt=0, lt=100_000)
    currency: str = Field(pattern=r"^[A-Z]{3}$")
    rating: float | None = Field(default=None, ge=0, le=5)
    reviews_count: int | None = Field(default=None, ge=0)
    buybox_seller: str | None = None
    timestamp: dt.datetime


def validate(path: pathlib.Path) -> tuple[list[dict], list[dict]]:
    """Split a raw file into accepted rows and quarantined rows with a reason."""
    accepted, quarantined = [], []
    for line in path.read_text().splitlines():
        rec = json.loads(line)
        if rec.get("error_code"):  # failed input, reported per record
            quarantined.append({"input": rec.get("input"), "reason": rec["error_code"]})
            continue
        try:
            row = Product(**rec).model_dump()
            row["snapshot_file"] = path.name  # lineage back to the raw bytes
            accepted.append(row)
        except ValidationError as e:
            fields = ",".join(str(x["loc"][0]) for x in e.errors())
            reason = f"contract:{fields}"
            quarantined.append({"input": rec.get("url"), "reason": reason})
    return accepted, quarantined


def model(accepted: list[dict]) -> duckdb.DuckDBPyConnection:
    """Load silver idempotently, then build gold tables at the right grain."""
    con = duckdb.connect(str(LAKE / "warehouse.duckdb"))
    con.execute("SET TimeZone = 'UTC'")  # store and show every observation in UTC
    con.execute("""CREATE TABLE IF NOT EXISTS silver_prices (
        asin TEXT, parent_asin TEXT, title TEXT, final_price DOUBLE,
        currency TEXT, rating DOUBLE, reviews_count BIGINT, buybox_seller TEXT,
        observed_at TIMESTAMPTZ, snapshot_file TEXT,
        PRIMARY KEY (asin, observed_at))""")
    # The primary key makes a rerun a no-op instead of a duplicate.
    for r in accepted:
        con.execute(
            "INSERT OR IGNORE INTO silver_prices VALUES (?,?,?,?,?,?,?,?,?,?)",
            [r["asin"], r["parent_asin"] or r["asin"], r["title"], r["final_price"],
             r["currency"], r["rating"], r["reviews_count"], r["buybox_seller"],
             r["timestamp"], r["snapshot_file"]],
        )
    con.execute("""CREATE OR REPLACE VIEW latest_prices AS
        SELECT * FROM silver_prices
        QUALIFY row_number() OVER (PARTITION BY asin ORDER BY observed_at DESC) = 1""")
    # Price belongs to the variant. Reviews belong to the parent listing.
    con.execute("""CREATE OR REPLACE VIEW gold_parent_reviews AS
        SELECT parent_asin, max(reviews_count) AS reviews_count, max(rating) AS rating,
               count(DISTINCT asin) AS variants_seen
        FROM latest_prices GROUP BY parent_asin""")
    return con


def domain_checks(con: duckdb.DuckDBPyConnection) -> None:
    """Compare each product with its previous observation. Flag, never drop."""
    con.execute("""CREATE OR REPLACE TABLE flags AS
        WITH obs AS (
            SELECT *,
                lag(final_price) OVER w AS prev_price,
                lag(currency) OVER w AS prev_currency,
                lag(reviews_count) OVER w AS prev_reviews,
                lag(buybox_seller) OVER w AS prev_seller
            FROM silver_prices WINDOW w AS (PARTITION BY asin ORDER BY observed_at))
        SELECT asin, observed_at, 'price_moved_over_30pct' AS flag FROM obs
            WHERE abs(final_price - prev_price) / prev_price > 0.3
        UNION ALL SELECT asin, observed_at, 'currency_changed' FROM obs
            WHERE currency <> prev_currency
        UNION ALL SELECT asin, observed_at, 'reviews_went_down' FROM obs
            WHERE reviews_count < prev_reviews
        UNION ALL SELECT asin, observed_at, 'reviews_jumped_over_50pct' FROM obs
            WHERE reviews_count > prev_reviews * 1.5
        UNION ALL SELECT asin, observed_at, 'buybox_seller_changed' FROM obs
            WHERE buybox_seller <> prev_seller""")


if __name__ == "__main__":
    # --replay loads every bronze file into the tables again, with no new crawl.
    if sys.argv[1] == "--replay":
        raws = sorted(LAKE.glob("bronze/amazon_products/*/*.ndjson"))
    else:
        inputs = json.load(open(sys.argv[1]))
        snapshot_id = sys.argv[2] if len(sys.argv) > 2 else collect(inputs)
        raws = [store_raw(snapshot_id)]
    for raw in raws:
        ok, bad = validate(raw)
        con = model(ok)
        print(f"{raw.name}: accepted={len(ok)} quarantined={len(bad)}")
        for q in bad:
            print("quarantine:", q)
    domain_checks(con)
    print(con.sql(
        "SELECT count(*) AS rows, count(DISTINCT asin) AS asins FROM silver_prices"
    ))
    print(con.sql(
        "SELECT * FROM gold_parent_reviews WHERE variants_seen > 1 ORDER BY parent_asin"
    ))
    print(con.sql("SELECT * FROM flags ORDER BY asin"))
La valeur DATASET dans le script est l’ID du scraper de produits Amazon, l’un des scrapers préconstruits que Bright Data maintient. Sa page dans le panneau de contrôle montre cet ID dans son exemple de requête, à côté d’un champ d’entrée zipcode :
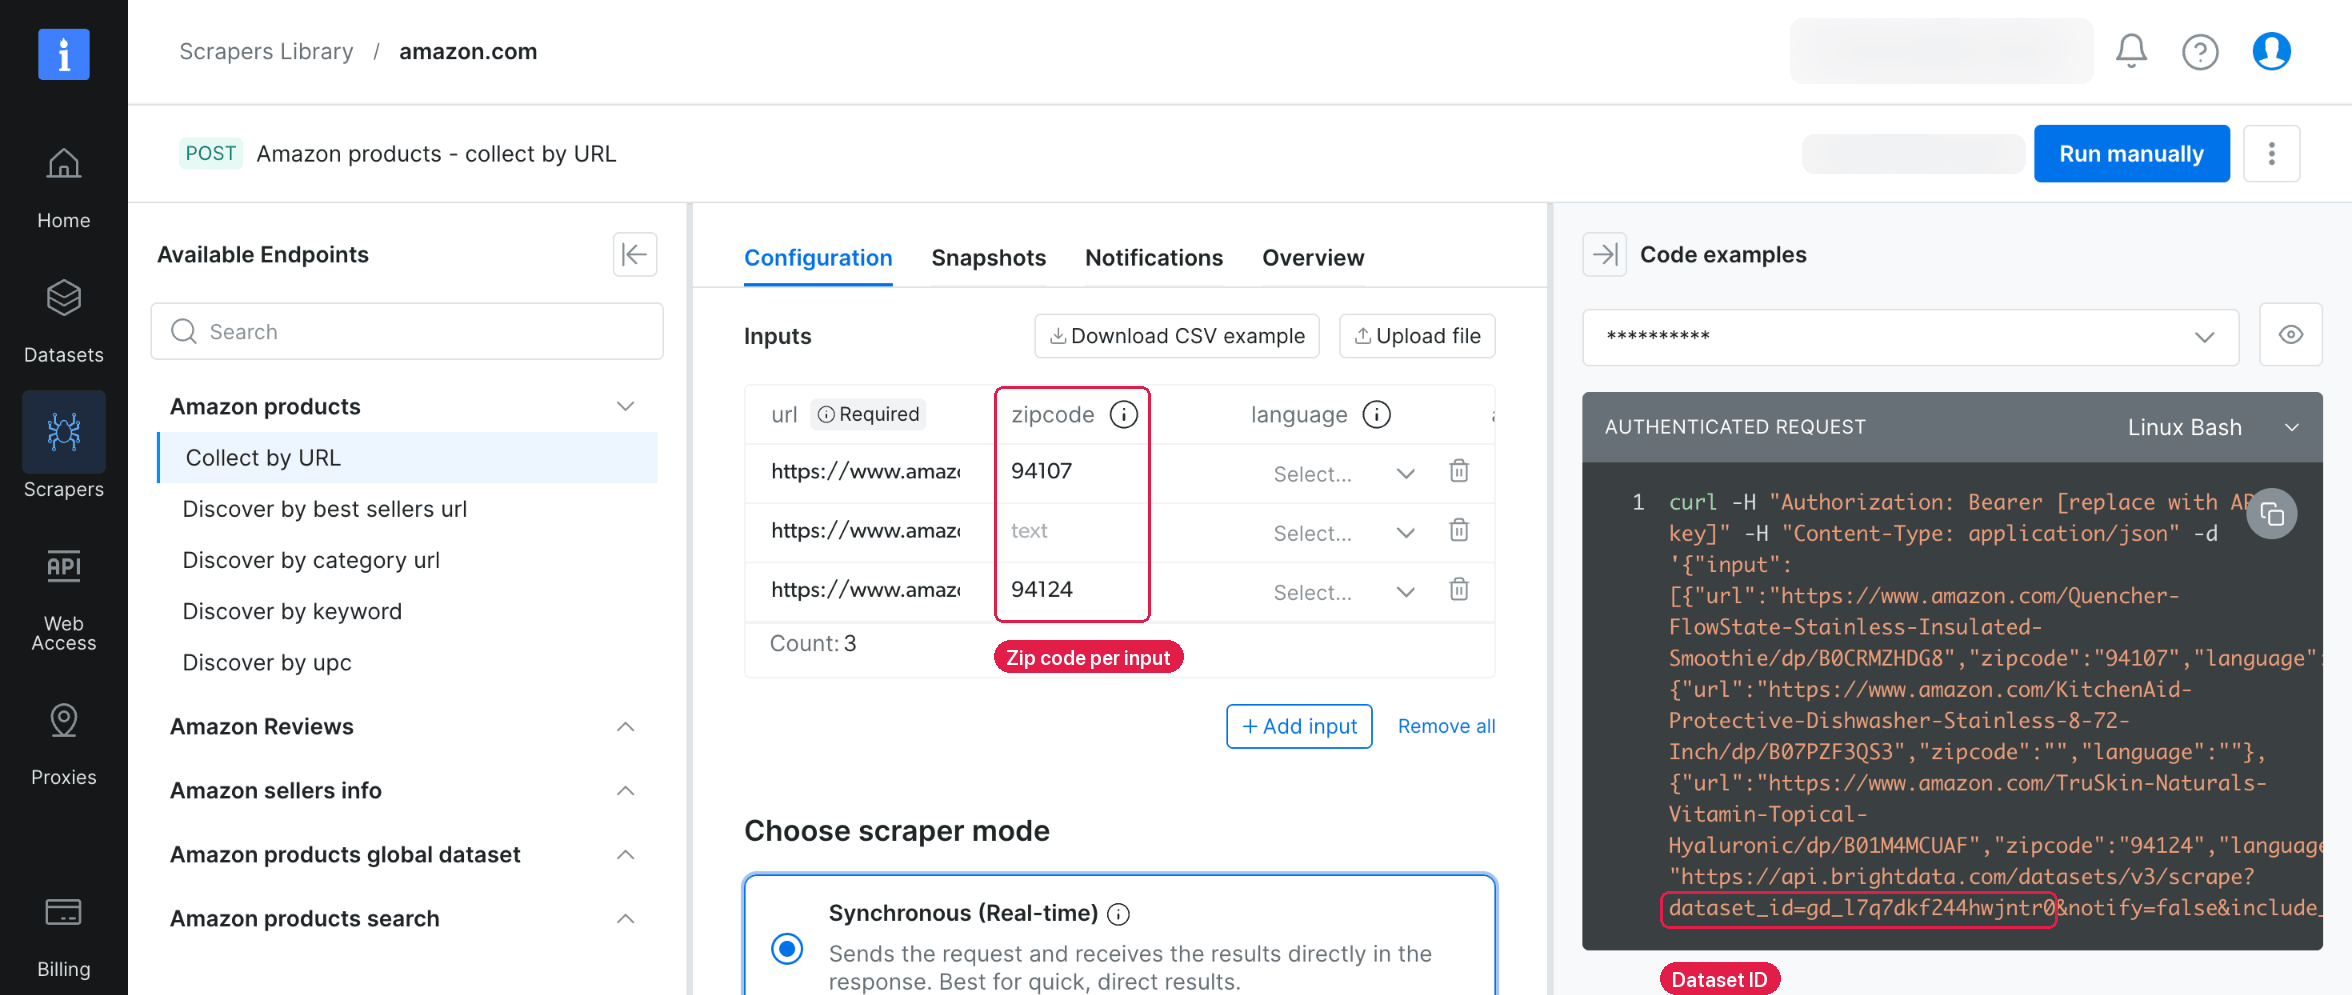
L’exemple de requête de la page utilise le point de terminaison synchrone /scrape, qui renvoie les enregistrements dans le même appel. Le script utilise plutôt /trigger, qui exécute de grands lots en arrière-plan et livre les résultats sous forme d’instantané.
Sur Python 3.10 ou ultérieur, sauvegardez vos entrées sous inputs.json au format [{"url": "https://www.amazon.com/dp/<ASIN>", "zipcode": "<ZIP>"}], où <ASIN> est l’ID du produit Amazon. Puis exécutez :
pip install requests pydantic duckdb
export BRIGHTDATA_API_KEY="your_api_key"
python pipeline.py inputs.json
python pipeline.py --replay
La première commande python collecte et charge une exécution. La commande --replay charge à nouveau chaque fichier brut sauvegardé dans les tables, sans appeler l’API. La sortie ci-dessous provient d’une liste de surveillance de 20 produits Amazon et 1 ID délibérément invalide, collectés deux fois à environ 2 heures d’intervalle puis rejoués :
sd_mvgo38o997m0dxre9.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
sd_mvgsyvcx1fcvvspadf.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
┌───────┬───────┐
│ rows  │ asins │
│ int64 │ int64 │
├───────┼───────┤
│    40 │    20 │
└───────┴───────┘

┌─────────────┬───────────────┬────────┬───────────────┐
│ parent_asin │ reviews_count │ rating │ variants_seen │
│   varchar   │     int64     │ double │     int64     │
├─────────────┼───────────────┼────────┼───────────────┤
│ B0FMZYMXNR  │          3015 │    4.2 │             3 │
│ B0GKGDTLG2  │           668 │    4.5 │             6 │
│ B0H1QVR9JS  │         17115 │    4.3 │             2 │
└─────────────┴───────────────┴────────┴───────────────┘

┌────────────┬────────────────────────────┬───────────────────────────┐
│    asin    │        observed_at         │           flag            │
│  varchar   │  timestamp with time zone  │          varchar          │
├────────────┼────────────────────────────┼───────────────────────────┤
│ B0FDKQZ18F │ 2026-10-20 14:53:09.044+00 │ buybox_seller_changed     │
│ B0HJ5K8WN4 │ 2026-10-20 14:53:11.293+00 │ reviews_jumped_over_50pct │
└────────────┴────────────────────────────┴───────────────────────────┘
Pour garder la démo simple, ces exécutions n’ont pas défini de code postal, mais les exécutions en production devraient en définir un. La table silver a conservé les deux observations des 20 produits. Rejouer à nouveau a laissé la table à 40 lignes, car la clé primaire bloque les lignes dupliquées.
Choix de conception qui détectent les problèmes tôt
- Écrivez les données brutes une fois et ne les modifiez jamais. Avec le fichier brut conservé, ajouter un champ ne nécessite aucune nouvelle exploration. Ajoutez-le au contrat
Productet à la tablesilver_prices, supprimezlake/warehouse.duckdb, et exécutez--replay. Le champ vendeur buy-box du script, qui enregistre le marchand qui remporte le bouton par défaut Ajouter au panier, a été ajouté de cette façon. - Rejetez tout téléchargement qui n’est pas HTTP 200. Le point de terminaison d’instantané renvoie HTTP 202 pendant que la tâche est encore en cours, comme le font de nombreuses API asynchrones. Un code qui saute cette vérification sauvegarde le message d’attente comme donnée. Le contrat le met alors en quarantaine, car le message n’a aucun des champs requis.
- Ajoutez des signalements après la vérification du contrat, et ne supprimez jamais les lignes signalées. Une vérification de schéma détecte un prix manquant, pas un prix associé à la mauvaise taille d’emballage. Dans la sortie ci-dessus, les vérifications de domaine ont signalé un changement de vendeur buy-box et un nombre d’avis qui est passé de 27 à 52. Les comptes peuvent aussi baisser, comme de 15 à 14 dans une troisième exécution, ce qui ressemble à des avis que le site a retirés.
- Gardez un code de raison en quarantaine. Une ligne
dead_pagesignifie que l’URL d’entrée a disparu, donc celui qui possède la liste d’entrées la retire. Une lignecontract:signifie qu’un champ était manquant ou hors plage, donc un ingénieur de données vérifie la source. - Gardez le fuseau horaire sur chaque horodatage. Une colonne sans fuseau horaire a stocké une observation de 14h53 UTC comme 20h23 heure locale, ce qui casse les comparaisons entre sources. Utilisez
TIMESTAMPTZet UTC.
Avant d’exécuter le pipeline en production
Quiconque utilise vos données, à l’intérieur ou à l’extérieur de l’entreprise, juge généralement chaque livraison sur la couverture, la fraîcheur, la provenance et la reproductibilité. Ces pratiques soutiennent ces 4 mesures :
- Envoyez un résumé d’exécution avec chaque livraison. Listez les entrées, les lignes acceptées, les raisons de quarantaine et les signalements, afin que les utilisateurs puissent voir exactement ce que couvre le jeu de données. Vérifiez aussi la couverture par rapport à une référence indépendante, telle que le sitemap du site, car les métriques d’une exécution ne couvrent que les entrées que vous avez envoyées.
- Alertez par rapport à la référence de chaque source. Envoyez une alerte quand le taux d’acceptation d’une exécution ou le taux de remplissage d’un champ tombe en dessous de sa référence. Chaque champ a besoin de sa propre référence, fixée à partir de son historique récent, tel qu’une médiane mobile des 7 dernières exécutions.
- Fixez une gravité pour chaque signalement. Un agent peut utiliser un prix erroné avant qu’un analyste ne le voie. Bloquez les agents de lire des lignes avec des signalements de prix ou de devise, et envoyez les signalements moins graves, tels qu’une petite baisse d’avis, à une personne. Vérifiez aussi ponctuellement un échantillon quotidien de lignes acceptées par rapport à leurs pages source, car les règles ne détectent que les erreurs que vous avez prédites.
- Mesurez les vérifications elles-mêmes. Suivez les faux positifs, les faux négatifs, le taux de révision manuelle et les incidents par source. Le détecteur de pages de blocage dans le test de récupération a signalé de bonnes pages comme bloquées, donc chaque vérification a besoin de son propre taux d’erreur.
- Gardez un seul fichier de contrat. Le code d’ingestion et les tests de table doivent lire le même fichier. Des outils tels que l’open-source
datacontract-clitestent un fichier ODCS directement par rapport aux tables. - Laissez le collecteur vous notifier. Le déclencheur de la Web Scraper API accepte une URL de webhook dans
endpointavecnotifydéfini surtrue, afin que l’orchestrateur puisse démarrer la validation quand l’instantané est prêt. - Budgétisez pour le stockage brut. Une page Amazon de 2,4 Mo compressée en gzip à 449 Ko, donc collecter 100K pages brutes par jour ajoute environ 45 Go de stockage chaque jour. L’enregistrement JSON complet du même produit faisait 24 Ko avant compression, environ 100 fois plus petit que la page. Stockez chaque corps de réponse brute avec son statut et ses en-têtes en JSON ou dans un fichier d’archive WARC, puis déplacez les anciens fichiers vers un stockage froid.
Modélisez chaque champ à la granularité que le site web utilise
La granularité d’une table est ce qu’une ligne représente, telle qu’une variante de produit ou une annonce parente. Un enregistrement extrait ressemble à une ligne, mais ses champs peuvent décrire des choses différentes. Sur une place de marché, le prix appartient généralement à la variante exacte. Les évaluations et les nombres d’avis appartiennent souvent à l’annonce parente qui regroupe toutes les couleurs et tailles.
Sur l’annonce Amazon de l’un des casques de la liste de surveillance, le total des avis apparaît au-dessus des options de couleur qu’il couvre :
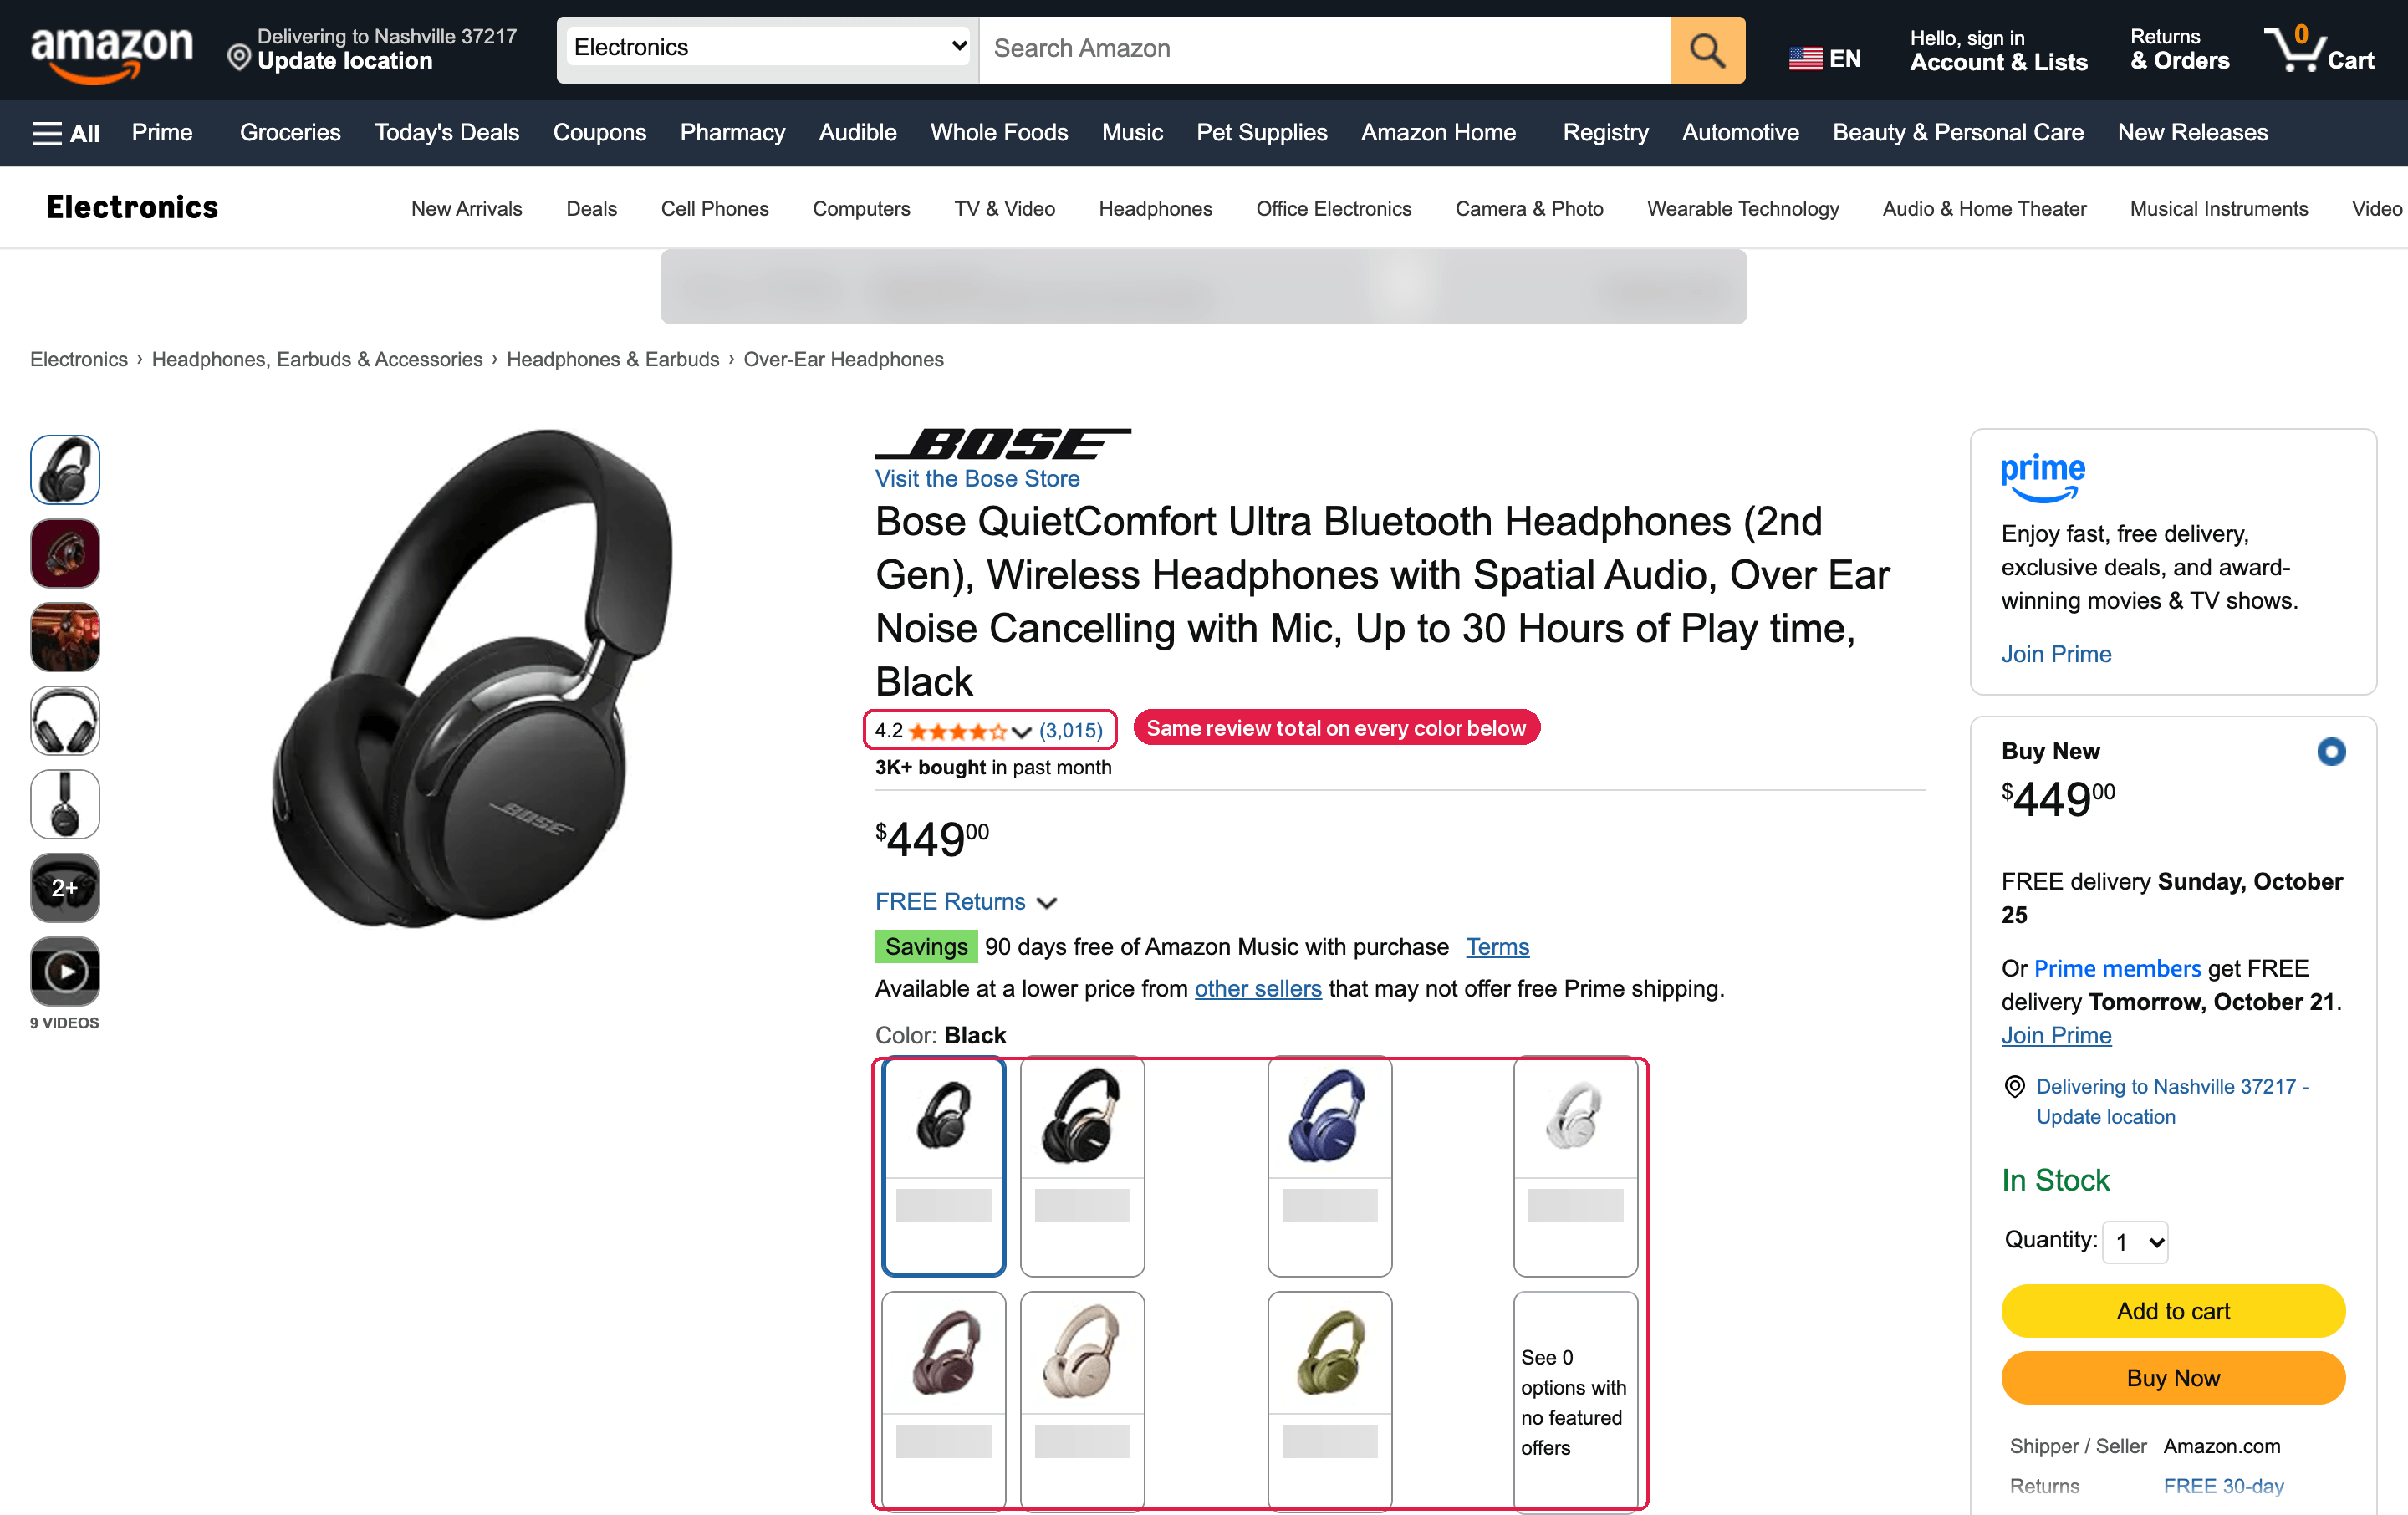
L’annonce telle que collectée, rendue à partir de son HTML sauvegardé. Les 3 couleurs de la liste de surveillance ont chacune rapporté les mêmes 3 015 évaluations.
Dans la liste de surveillance de 20 produits, 11 produits étaient des variantes de seulement 3 annonces parentes, telles que 6 versions d’une paire de cache-oreilles. Donc les 20 produits appartenaient à seulement 12 annonces parentes. Une somme ligne par ligne compte alors les 3 015 évaluations du casque Bose 3 fois, une fois par couleur. Chaque enregistrement Web Scraper API inclut un parent_asin, donc un GROUP BY dessus compte chaque total d’avis une seule fois :
-- Wrong grain: one review total per variant row
SELECT sum(reviews_count) AS naive_variant_sum FROM latest_prices;

-- Right grain: one review total per parent listing
SELECT sum(reviews_count) AS parent_grain_sum, count(*) AS parents
FROM gold_parent_reviews;
Sur lake/warehouse.duckdb, les 2 requêtes ont renvoyé :
┌───────────────────┐
│ naive_variant_sum │
│      int128       │
├───────────────────┤
│            139537 │
└───────────────────┘

┌──────────────────┬─────────┐
│ parent_grain_sum │ parents │
│      int128      │  int64  │
├──────────────────┼─────────┤
│           113052 │      12 │
└──────────────────┴─────────┘
La somme au niveau ligne a surévalué le nombre d’avis de 23%. Vous ne pouvez pas non plus stocker le prix au niveau parent, car les variantes de cache-oreilles allaient de 12,95$ à 14,99$. Écrivez la granularité de chaque champ dans le contrat de données, et construisez une table gold par granularité.
La localisation fait aussi partie de la granularité. Les offres et estimations de livraison peuvent changer selon la localisation de l’acheteur. Définissez le code postal ou le pays sur chaque entrée, et stockez-le avec chaque enregistrement. Le scraper de produits Amazon prend un zipcode sur chaque entrée.
Le prix est souvent plusieurs champs. Le champ coupon_description, par exemple, contenait une offre multi-achat sur 1 des 20 produits. Sur 5 autres, il contenait un essai gratuit Amazon Music, qui n’est pas une remise de prix. Le badge Économies dans la capture d’écran Bose ci-dessus est l’un de ces essais.
Stockez le prix de liste, le prix de vente, le type d’offre et le texte du coupon séparément, et analysez un coupon avant de le compter comme une remise. Déclarez aussi les types, car JSON écrit 449$ comme 449, et un chargeur qui déduit les types à partir d’un échantillon peut faire du prix un entier.
Faire correspondre les produits entre détaillants
Une correspondance de titre peut joindre une paire de casques avec les écouteurs qui partagent son nom de produit, donc faites correspondre sur les identifiants. Mais les identifiants sont souvent manquants ou incohérents. Seulement 7 des 20 annonces Amazon affichaient un UPC (Universal Product Code) sur la page. Sony a aussi écrit un modèle de base de 2 façons, comme WH-CH720N/P et WHCH720N/W.
Faites donc correspondre par ordre de confiance. Commencez par un GTIN (Global Trade Item Number), tel qu’un UPC. Ensuite, essayez la marque plus un numéro de modèle normalisé, puis une correspondance de titre avec un seuil de confiance. Normalisez les numéros de modèle en supprimant les séparateurs et les suffixes de couleur.
Sur les 20 produits, seulement 6 n’avaient ni UPC ni numéro de modèle, et les 6 étaient des variantes d’un seul produit. Donc seules les correspondances de titre de ce produit nécessitaient une révision humaine.
Fixez les calendriers de rafraîchissement selon la rapidité des changements de données
Les données web perdent de la valeur à des vitesses différentes, et le calendrier de rafraîchissement devrait correspondre. Même les champs d’un enregistrement changent à des vitesses différentes. Les exécutions horaires de la liste de surveillance montrent à quel point :
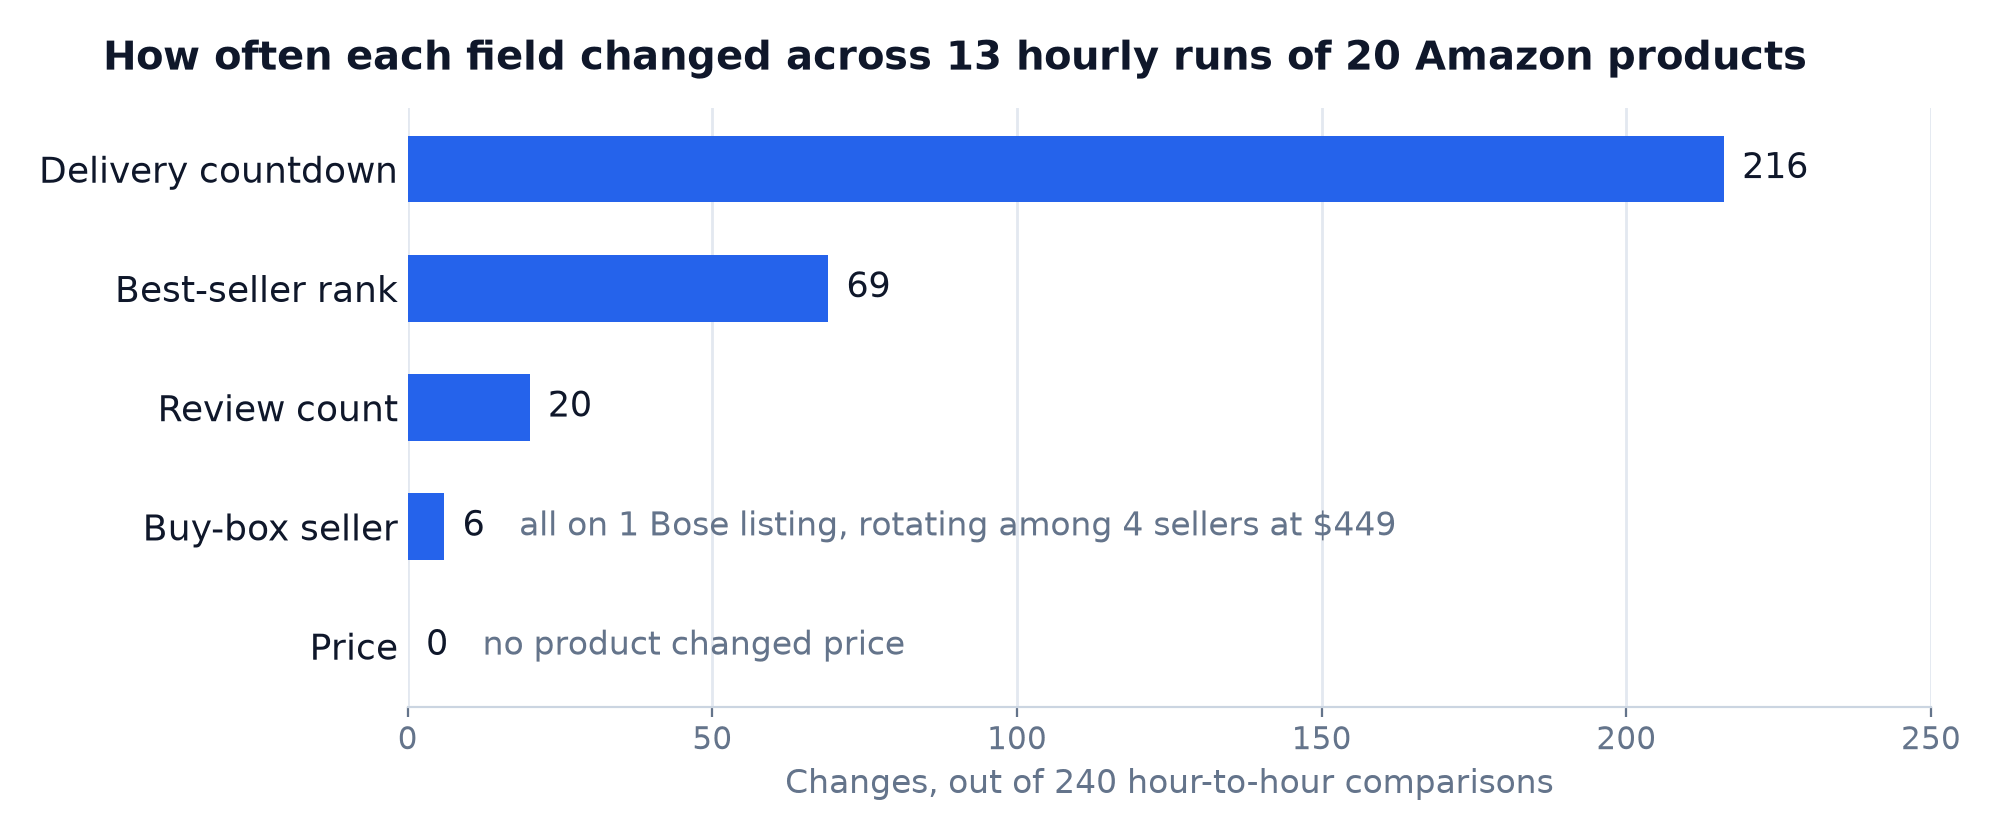
Collecté avec la Web Scraper API. Le compte à rebours de livraison est le message d’Amazon « Commandez dans les 2 h 44 min ».
Sur une annonce Bose, la buy box s’est déplacée entre 4 vendeurs 6 fois pendant que le prix restait à 449$. Un moniteur qui ne suivait que le prix aurait manqué chaque changement.
Regroupez les produits selon la rapidité de changement de leurs champs clés, et donnez à chaque groupe son propre calendrier de collecte, afin que les dépenses aillent là où les données changent. Exécutez une petite tâche plusieurs fois par jour, à des heures variées, sur les produits où la buy box compte, et une tâche quotidienne pour le reste.
L’exploration incrémentale réduit le coût de la fraîcheur en recollectant seulement les pages susceptibles d’avoir changé, en utilisant des signaux tels que les dates lastmod dans les sitemaps. Après la collecte, comparez un hachage des champs que votre contrat utilise, afin que les étapes ultérieures ne retraitent que les enregistrements modifiés.
Dans le test de récupération, le hachage HTML brut différait à chaque récupération répétée. Sur les 240 comparaisons heure par heure des exécutions horaires, un hachage d’enregistrement complet a changé dans 239 cas. La plupart de ces changements venaient du compte à rebours de livraison. Un hachage des 8 champs du contrat autres que l’horodatage n’a changé que 26 fois, chacun un vrai changement de nombre d’avis ou de vendeur buy-box.
Un âge médian faible peut cacher quelques enregistrements très anciens. Mesurez donc la fraîcheur comme une distribution, avec l’âge p50 et p99 par source, et alertez sur le p99.
Architecture de pipeline de données pour l’IA et les agents
Un pipeline IA utilise les mêmes 5 étapes, généralement avec un modèle ou un agent à l’étape de service.
Laissez une IA écrire les parseurs pour les sources à volume élevé
La question principale est de savoir si un grand modèle de langage devrait extraire des données de chaque page. Une page produit Amazon, comptée avec le tokenizer o200k_base, aide à y répondre :
| Forme de la même page produit | Octets | Tokens |
|---|---|---|
| Page complète en HTML brut | 2 446 738 | 911 129 |
| Page complète en markdown | 236 088 | 97 977 |
| Contenu principal seulement, extrait du HTML brut | 17 339 | 3 252 |
| Enregistrement JSON complet, tous les champs | 23 923 | 7 692 |
| Enregistrement JSON réduit (12 champs) | 501 | 171 |
Le markdown de page complète convient à un agent lisant une page, mais à volume élevé, les équipes réduisent généralement les pages à leur contenu principal avant l’extraction. Réduit de cette façon, la page utilisait encore 19 fois les tokens de l’enregistrement à 12 champs. À un exemple de 0,10$ par million de tokens d’entrée, 100K de telles pages par jour coûtent environ 33$ en entrée modèle. Lire les enregistrements à 12 champs à la place coûterait environ 2$.
Les deux chiffres excluent la collecte, que chaque chemin paie à un taux différent. Comparez donc le coût total, pas seulement le coût de tokens. Le contenu principal extrait commençait par une offre de garantie supplémentaire, et un modèle le lisant peut encore choisir le mauvais prix ou la mauvaise variante. Un enregistrement Web Scraper API livre le prix et la variante comme champs séparés, donc aucun modèle n’a à les extraire du texte de la page.
Choisissez l’approche selon le volume et le risque. Pour une source collectée des milliers de fois par jour, utilisez le modèle pour écrire le parseur et le corriger quand il casse. Un code ordinaire exécute ensuite ce parseur sur chaque page et renvoie la même sortie pour la même page. Scraper Studio exécute ce modèle comme un service, construisant un scraper à partir d’une invite en langage simple, avec une auto-réparation en un clic quand le site change.
Pour les sites à faible volume dont les mises en page changent souvent, l’extraction IA page par page peut coûter moins que la maintenance d’un parseur. Dans les deux cas, vérifiez la sortie par rapport au même contrat.
Quand la validation échoue, un agent de codage peut proposer une correction de parseur et la rejouer sur les pages brutes dans la couche bronze. Le rejeu montre combien de lignes en quarantaine la correction récupère et si une ligne acceptée a changé, et un humain révise les deux avant la fusion.
Servez les agents depuis des tables validées
Pour les agents, une récupération en direct est plus risquée qu’une lecture de table, car une récupération bloquée peut arrêter la tâche d’un agent pendant qu’un utilisateur attend. En septembre 2026, par exemple, Cloudflare a changé les paramètres par défaut pour les domaines nouvellement ajoutés afin de bloquer les agents IA et les bots d’entraînement sur les pages qui affichent des publicités. Servez donc d’abord les agents depuis des tables validées, via une interface MCP qui inclut les règles d’utilisation du contrat.
Les agents ont aussi besoin d’une vérification d’injection de prompt, car le texte de page, y compris les champs d’avis et de titre dans vos tables, peut contenir des instructions destinées à un agent. Pour les lectures en direct, le serveur MCP de Bright Data a un portail de contenu, activé par défaut. Il demande à l’utilisateur de confirmer avant de renvoyer un texte de page qui ressemble à des instructions pour changer la configuration du serveur.
Suivez les réponses IA comme source de données
Les assistants IA sont aussi une source de données, car leurs réponses peuvent atteindre un acheteur avant tout résultat de recherche. Dans un test, la première recommandation de ChatGPT pour la même question d’achat était Bose dans 3 des 5 exécutions et Sony dans 2. Échantillonnez donc chaque invite plusieurs fois, et gardez le même pays à chaque exécution pour que les résultats restent comparables. Les scrapers de chat IA de la Web Scraper API collectent les réponses de ChatGPT, Copilot, Gemini, Perplexity et Grok, avec leurs citations en JSON structuré.
Construire ou acheter la couche de collecte
La plupart de l’infrastructure de pipeline de données, y compris le stockage, la transformation et l’orchestration, fonctionne sur des outils bien établis. La collecte depuis des sites web protégés est différente, car elle doit changer chaque fois que les navigateurs et les défenses anti-bot changent.
Comparez les coûts par enregistrement accepté, pas par requête. Web Unlocker facture seulement les résultats réussis, et la Web Scraper API seulement les enregistrements livrés. Divisez les dépenses totales par les enregistrements qui passent votre contrat.
Du côté construction, incluez les heures d’ingénieur passées sur les proxys, les corrections de parseur et le déblocage. Des deux côtés, comptez ce que coûte une mauvaise livraison, telle qu’une décision de retarification basée sur de mauvais prix.
Comparez les collecteurs sur vos propres URLs
Obtenez ces coûts à partir d’un benchmark, comme de nombreuses équipes d’achat évaluent les fournisseurs dans une preuve de concept. Exécutez votre collecteur actuel et chaque candidat sur les mêmes URLs pendant plusieurs jours, depuis le réseau et à la concurrence que votre pipeline utilise réellement. Comparez chaque candidat sur les mêmes mesures :
| Mesure | Comment la compter |
|---|---|
| Enregistrements acceptés | Lignes qui passent votre contrat de données, par source |
| Échecs par raison | Blocages, défis et réponses réussies qui échouent votre vérification de contenu, telles que des pages vides ou de mauvaise région |
| Coût par 1K enregistrements acceptés | Toutes les dépenses, y compris les nouvelles tentatives, les proxys et les heures d’ingénieur ci-dessous, par 1K lignes acceptées |
| Latence | Temps de livraison p50 et p95, pour les tâches batch et les récupérations en direct |
| Heures d’ingénieur | Temps passé sur les blocages, les corrections de parseur et les alertes pendant le test |
Les crédits gratuits mensuels de Bright Data peuvent couvrir un premier test sur un échantillon de vos URLs.
Décidez par source
Décidez pour chaque source séparément, car un pipeline mélange généralement des sites protégés et non protégés. Comptez un site comme protégé quand votre propre client échoue à la vérification de contenu pendant le benchmark :
| Situation | Construire | Acheter |
|---|---|---|
| Quelques sites non protégés, collectés occasionnellement | Oui | Commencez avec des crédits gratuits, puis passez au paiement à l’utilisation au fur et à mesure que le volume augmente |
| Sites protégés, collectés selon un calendrier | Seulement avec une équipe qui suit les versions de navigateurs, et généralement avec des proxys résidentiels | Web Unlocker ou la Browser API gère l’accès, donc votre équipe écrit seulement les parseurs |
| Sites où vous avez besoin d’enregistrements, pas de pages | Souvent pas la peine sauf si le site est central à votre produit | La Web Scraper API renvoie du JSON structuré, et Scraper Studio construit des scrapers personnalisés à partir d’une invite |
| Données dont vous avez besoin mais pas besoin de collecter vous-même | Non | Jeux de données, rafraîchis selon un calendrier avec seulement les enregistrements nouveaux ou mis à jour, ou la Web Archive API pour les pages déjà collectées |
| Agents qui naviguent ou cherchent en direct | Seulement pour les petits outils internes | Serveur MCP, qui utilise l’API SERP et Web Unlocker |
Un contrat de données rend aussi le collecteur facile à changer, donc essayer un nouveau est peu risqué. Les tables en aval, les signalements et les alertes dépendent seulement des champs du contrat. Changer signifie connecter l’étape de collecte à un nouveau collecteur et relancer le benchmark sur vos propres URLs. Continuez à suivre le taux d’acceptation de chaque source, car les sites changent leurs défenses au fil du temps.
Pour la planification budgétaire, la page de tarification Web Scraper API liste les tarifs actuels de paiement à l’utilisation et les forfaits volume. Le guide des métriques de qualité des données aide à définir « accepté » avant de comparer les coûts.
Conformité et provenance
Collectez seulement des données publiques, sans vous connecter et à des taux de requêtes que chaque site peut gérer. Collectez des données personnelles seulement où vous avez une base légale, et vérifiez le statut de droit d’auteur de tout ce que vous republiez ou sur lequel vous entraînez.
Gardez la provenance avec chaque enregistrement, y compris l’URL source, l’heure de collecte, la méthode, la version du code, et les conditions d’utilisation qui s’appliquaient. Vous pouvez alors montrer où et comment chaque enregistrement a été collecté.
Bright Data détient la certification ISO 27001 et un rapport SOC 2 Type II, tous deux listés sur son aperçu de sécurité.
Comment les tests ont été exécutés
Chaque test a été exécuté contre des sites et services en direct, qui changent avec le temps :
| Test | Configuration |
|---|---|
| Test de récupération | Chacun des 4 clients open-source a récupéré 13 pages de recherche et de listing 3 fois. Les clients étaient Python requests avec en-têtes par défaut, requests avec en-têtes Chrome, curl_cffi avec sa cible Chrome 150, et Chrome 155 headless via Playwright. Tous exécutés depuis une connexion internet domestique en Inde, sans proxys. Une réponse comptait comme donnée quand elle avait les motifs HTML qui marquent les annonces du site, et un détecteur séparé vérifiait 8 signatures de pages de blocage. Une nouvelle exécution headless avec un User-Agent normal a récupéré chaque page 2 fois. |
| Vérification d’empreinte | Poignées de main TLS de Web Unlocker, Python requests, curl_cffi (cible Chrome 150), et Chrome 155 installé, comparées sur tls.peet.ws |
| Récupération par agent | Les mêmes 13 URLs, une exécution via l’outil WebFetch que les agents Claude Code utilisent |
| Pipeline de référence | 20 produits Amazon plus 1 ID délibérément invalide, Web Scraper API, 2 exécutions à environ 2 heures d’intervalle et une troisième environ 17 heures plus tard |
| Exécutions horaires | Les mêmes 20 produits, 13 exécutions à une heure d’intervalle, 240 comparaisons heure par heure |
| Découverte | Une recherche Google pour un modèle de casque via l’API SERP |
| Comptes de tokens | Une page produit Amazon via Web Unlocker (HTML et markdown) et la Web Scraper API (JSON), tokenizer o200k_base, contenu principal extrait avec trafilatura 2.3 |
| Réponses IA | Une question d’achat à ChatGPT via la Web Scraper API, 5 exécutions sans pays défini |
Réflexions finales
Quand un pipeline de données collecte depuis des sites web publics, une réponse peut avoir un statut de succès et aucune donnée, et un enregistrement peut mélanger plusieurs granularités.
Stockez les données brutes inchangées, vérifiez le contenu par rapport à un contrat de données, signalez les changements inhabituels, et rejouez toute correction de parseur qu’un agent propose avant de la fusionner. Si la couche de collecte coûte plus en temps d’ingénieur qu’en requêtes, la Web Scraper API peut exécuter cette étape pour votre équipe. Commencez par exécuter une vérification de contenu sur votre source la moins fiable, et comptez combien de ses réponses réussies contiennent des enregistrements utilisables. Puis exécutez les mêmes URLs via Web Unlocker ou la Web Scraper API sur un compte Bright Data gratuit, et comparez le coût par enregistrement accepté.
FAQ
Que sont les « data pipes » ?
« Data pipes » est un nom informel pour les pipelines de données, les systèmes qui déplacent les données de leurs sources vers les outils qui les utilisent. Un pipeline typique collecte, stocke, vérifie, transforme et sert les données. L’architecture de pipeline de données est leur conception, qui définit les étapes, les outils et les vérifications entre elles.
Qu’est-ce que le pipelining de données ?
Le pipelining de données est la pratique de construire et d’exécuter des pipelines de données, qui déplacent les données des sources vers les outils qui les utilisent. Le travail couvre la collecte, le stockage, la vérification, la transformation et le service des données, plus la planification et la surveillance de chaque étape. Ce n’est pas la même chose que le pipelining d’instructions dans les CPU, qui chevauche les étapes du processeur à l’intérieur d’une puce.
Quelles sont les 5 étapes d’un pipeline de données ?
Les 5 étapes d’un pipeline de données typique sont collecter, stocker en brut, valider, transformer et servir. La collecte extrait les données des sources, et le stockage brut les garde inchangées. La validation les vérifie par rapport à un contrat de données, la transformation les modélise en tables, et le service les livre aux tableaux de bord, modèles ou agents.
Qu’est-ce qu’une architecture de pipeline de données moderne ?
Une architecture de pipeline de données moderne stocke généralement les données brutes dans un stockage objet et garde les tables dans un format ouvert tel qu’Apache Iceberg. Elle transforme les données avec un outil tel que dbt et planifie les étapes avec un orchestrateur tel qu’Airflow. Un contrat de données contrôle ce qui entre dans les tables, et les agents peuvent les lire via le Model Context Protocol (MCP).
Quels sont quelques exemples de pipelines de données ?
Un lot nocturne de prix concurrents chargé dans un entrepôt est un exemple courant. Un flux de publications sociales traité en quelques minutes pour la surveillance de marque en est un autre. Un hybride garde un historique quotidien et diffuse les changements pour une courte liste de surveillance, et un pipeline à la demande récupère des données en direct quand un agent demande. Les 4 utilisent les mêmes 5 étapes.
L’IA peut-elle créer des pipelines de données ?
Oui, un agent de codage peut écrire la majeure partie du code d’un pipeline pendant qu’un humain révise chaque changement. Pour la collecte, Scraper Studio de Bright Data construit un scraper à partir d’une invite en langage simple. L’extraction IA page par page fonctionne si chaque sortie passe le contrat de données, mais elle utilise plus de tokens. Le contenu principal d’une page Amazon faisait 3 252 tokens, contre 171 pour un enregistrement à 12 champs.
Qu’est-ce qu’un pipeline d’ingestion de données ?
Un pipeline d’ingestion de données, la première partie d’un pipeline de données, collecte et stocke les données des sources. Les sources web ont besoin d’une vérification de contenu. Dans un test de clients open-source sur 13 sites, 39 des 88 réponses réussies n’avaient aucune donnée. Pour les sites avec des défenses anti-bot, Web Unlocker de Bright Data renvoie la page, ou la Web Scraper API renvoie des enregistrements structurés.
Qu’est-ce qu’un pipeline de big data ?
Un pipeline de big data est un pipeline de données construit pour des volumes où le stockage et le calcul doivent évoluer séparément. Il stocke généralement les données dans un stockage objet et les garde dans des formats de tables ouverts tels qu’Apache Iceberg ou Delta Lake. Des moteurs distribués tels que Spark ou Flink les traitent.