


Crawler Threads
Crawlez Threads à grande échelle sur les publications et les profils. Collectez des données publiques telles que l’URL de la publication, l’ID de la publication, le contenu, la date de publication, le nom d’utilisateur de l’auteur, l’URL du profil de l’auteur, le nombre d’abonnés, le nombre de réponses, le nombre de republications, les likes, les publications citées, les médias joints, et bien plus encore.

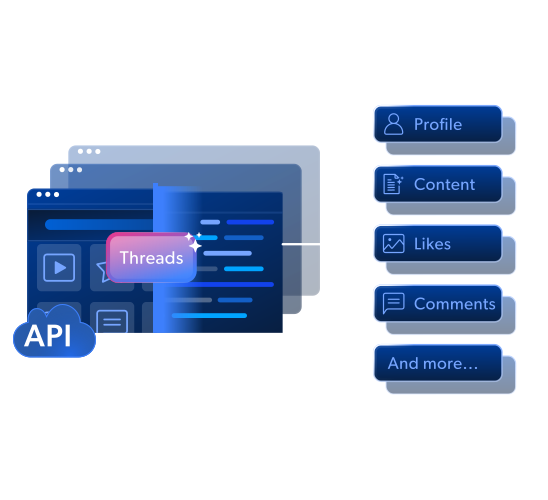
- Scrape à la demande via API ou scraper sans code
- Responsable de compte dédié
- Gestion de demandes en masse, jusqu'à 5K URLs
- Récupérer les résultats en plusieurs formats
Approuvé par 50,000+ clients dans le monde entier


Crawlers Threads disponibles
 383+
 14+
Vous voulez juste des données Threads ? Passez le crawling.
Achetez un jeu de données Threads
Tarification du Crawler Threads
Ne payez que pour ce qui est livré avec succès. Pas de frais cachés, pas de frais pour les livraisons échouées.

- Payez uniquement pour le succès, sans frais cachés
- Commencez gratuitement avec 5 000 crédits mensuels
- Aucun engagement initial, annulez à tout moment
- Support expert 24/7 et fonctionnalités entreprise

EXEMPLES DE CODE
Crawlez facilement les données Threads sans vous soucier d’être bloqué.
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.threads.com/@dividendology_yt/post/DML_enxRaOq?hl=en"},{"url":"https://www.threads.com/@sanantoniozoo/post/DMLlEMux-wk?hl=en"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_md75myxy14rihbjksa&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"post_id": "DewYeislPSJ",
"url": "https:\/\/www.threads.com\/@itsmenanaali\/post\/DewYeislPSJ",
"post_time": "2026-10-21T12:13:57.000Z",
"profile_name": "itsmenanaali",
"profile_url": "https:\/\/www.threads.com\/@itsmenanaali",
"post_content": null,
"number_of_likes": 0
},
{
"timestamp": "2026-10-22",
"post_id": "DexZ5RunNBP",
"url": "https:\/\/www.threads.com\/@repdeluzio\/post\/DexZ5RunNBP",
"post_time": "2026-10-21T21:45:35.000Z",
"profile_name": "repdeluzio",
"profile_url": "https:\/\/www.threads.com\/@repdeluzio",
"post_content": "The Iran War has cost the average American family more than $2,000. \n\nWe are ALL paying for this reckless war that Trump...",
"number_of_likes": 16
},
{
"timestamp": "2026-10-22",
"post_id": "DevYd84jNvX",
"url": "https:\/\/www.threads.com\/@borrisbrandonramirez\/post\/DevYd84jNvX",
"post_time": "2026-10-21T02:54:38.000Z",
"profile_name": "borrisbrandonramirez",
"profile_url": "https:\/\/www.threads.com\/@borrisbrandonramirez",
"post_content": "God sees beyond the walls of our church. \nGod delights in our discipline and obedience even in the marketplace. \n\nWe don...",
"number_of_likes": 4
},
{
"timestamp": "2026-10-22",
"post_id": "DewWpKsnHzd",
"url": "https:\/\/www.threads.com\/@gregsedwards\/post\/DewWpKsnHzd",
"post_time": "2026-10-21T11:57:55.000Z",
"profile_name": "gregsedwards",
"profile_url": "https:\/\/www.threads.com\/@gregsedwards",
"post_content": "\u0022Intentionally suffering is just another form of indulgence.\u0022 - @markmanson",
"number_of_likes": 0
},
{
"timestamp": "2026-10-22",
"post_id": "DexJsOIAJl1",
"url": "https:\/\/www.threads.com\/@anirban.mitra93\/post\/DexJsOIAJl1",
"post_time": "2026-10-21T19:23:59.000Z",
"profile_name": "anirban.mitra93",
"profile_url": "https:\/\/www.threads.com\/@anirban.mitra93",
"post_content": "Pujo ends. The longing stays.\nAnother Pujo in the archives, another piece of my heart left behind.",
"number_of_likes": 0
}
]curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.threads.com/@abc7la"},{"url":"https://www.threads.com/@adriellereinaauthor"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_mde7jg3ld2h3hnnf2&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@doctorkowj",
"profile_name": "柯文哲",
"profile_id": "63439331208",
"about_formatted": "心存善念,盡力而為",
"number_of_followers": 612514,
"website": "https:\/\/www.facebook.com\/DoctorKoWJ",
"instagram_profile_url": "https:\/\/www.instagram.com\/doctorkowj"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@wen_shih_cheng",
"profile_name": "温世政 Wen Shih-Cheng",
"profile_id": "80177097255",
"about_formatted": "南投縣長候選人|牙醫師\n草屯囡仔|南投温顧|世代幸福",
"number_of_followers": 30237,
"website": "https:\/\/www.facebook.com\/wEnShihheng\/",
"instagram_profile_url": "https:\/\/www.instagram.com\/wen_shih_cheng"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@huang.guochang",
"profile_name": "黃國昌",
"profile_id": "63274537854",
"about_formatted": "溫暖而富有人性的國蔥老師",
"number_of_followers": 75800,
"website": null,
"instagram_profile_url": "https:\/\/www.instagram.com\/huang.guochang"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@su.chiaohui",
"profile_name": "蘇巧慧",
"profile_id": "63447798401",
"about_formatted": "2026新北市長候選人\n立法委員|樹林、鶯歌、新莊西盛\n主任委員|民主進步黨新北市黨部\n【Podcast節目】搜尋訂閱:水獺媽媽巧巧話\n#新時代 #新市長\n#溫暖 #創新 #會做事",
"number_of_followers": 190787,
"website": "https:\/\/donate.newebpay.com\/chiao\/huiwin2026",
"instagram_profile_url": "https:\/\/www.instagram.com\/su.chiaohui"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@chiayionefish",
"profile_name": "蔡易餘",
"profile_id": "63097833574",
"about_formatted": "#蔡易餘家己人\n#靈活ㄉ胖子 #專業立委\n#重力嘉速度\n📩 陳情、服務案件請私訊「蔡易餘家己人」FB",
"number_of_followers": 61093,
"website": "https:\/\/portaly.cc\/chiayionefish",
"instagram_profile_url": "https:\/\/www.instagram.com\/chiayionefish"
}
]API pour un accès fluide aux données Threads
Extraction de données web complète, évolutive et conforme
API pour un accès fluide aux données Threads
Adapté à votre flux de travail
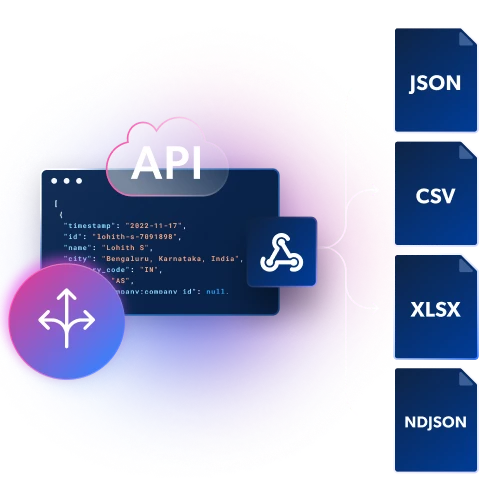
Obtenez des données structurées en fichiers JSON, NDJSON ou CSV via Webhook ou livraison par API.
Infrastructure intégrée et déblocage
Bénéficiez d’un contrôle et d’une flexibilité maximaux sans maintenir de Proxy ni d’infrastructure de déblocage. Scrapez facilement des données depuis n’importe quelle géolocalisation en évitant les CAPTCHAs et les blocages.
Infrastructure éprouvée
La plateforme de Bright Data alimente plus de 20 000 entreprises dans le monde, offrant une tranquillité d’esprit avec 99,99 % de disponibilité et l’accès à plus de 150 M d’IPs d’utilisateurs réels couvrant 195 pays.
Conformité de premier plan dans le secteur
Nos pratiques de confidentialité respectent les lois sur la protection des données, notamment le cadre réglementaire européen de protection des données, le RGPD et le CCPA.
API pour un accès fluide aux données Threads


Crawling Threads simplifié
Cas d'usage du crawling Threads
Sentiment des consommateurs et surveillance de marque
Suivi des tendances et des conversations
Intelligence sur les créateurs et concurrents
Pionniers de la collecte éthique de données web
Nous avons établi la référence en matière de pratiques éthiques et conformes de données web. Notre réseau de pairs est fondé sur la confiance, chaque membre y adhérant personnellement, avec la garantie d’une collecte nulle de données personnelles. Nous défendons la collecte exclusive de données publiquement accessibles, soutenue par un processus de Vérification KYC leader de l’industrie et une politique d’utilisation acceptable transparente. Notre équipe mondiale et multilingue de Conformité et Éthique, la première du genre, garantit que nous restons à l’avant-garde des évolutions réglementaires et des meilleures pratiques.
Pourquoi 50,000+ clients choisissent Bright Data

100% Conforme

Support mondial 24/7

Couverture complète des données

Qualité de données inégalée

Infrastructure puissante

Solutions personnalisées
Bright Data est utilisé par les meilleures marques mondiales



FAQ sur le Crawler Threads
Qu'est-ce que le crawler Threads ?
Le crawler Threads est un outil automatisé qui découvre et collecte des données publiques depuis Threads à grande échelle. Vous n'avez pas besoin d'une liste complète d'URLs. Vous pouvez partir d'un mot-clé, d'une catégorie, d'une URL de recherche ou d'une page spécifique. Le crawler trouve les enregistrements correspondants et renvoie les données dans un format structuré.
Quelle est la différence entre crawler et scraper Threads ?
Le crawling consiste à découvrir : trouver les pages. Le scraping consiste à extraire : récupérer des champs précis sur une page déjà connue. Un scraper a besoin que vous lui indiquiez quelle URL visiter. Un crawler trouve les enregistrements pour vous puis extrait les données. Utilisez le crawler lorsque vous n'avez pas la liste complète des URLs, ou quand la liste change constamment, comme chaque article d'une catégorie ou chaque résultat pour un mot-clé. Si vous avez déjà les URLs exactes, la collecte par URL est l'option la plus directe.
En quoi le crawler Threads diffère-t-il d'un jeu de données Threads ?
Un jeu de données est constitué de données déjà collectées, que vous achetez sous forme de fichier prêt à l'emploi. Le crawler collecte des données fraîches lorsque vous l'exécutez, selon vos propres paramètres. Choisissez un jeu de données si vous voulez une couverture large immédiatement sans configuration. Choisissez le crawler si vous avez besoin d'une portée spécifique, des données les plus récentes ou d'une collecte selon un calendrier que vous contrôlez.
En quoi le crawler Threads diffère-t-il de l'utilisation de proxys ?
Les proxys sont une infrastructure. Ils font passer vos requêtes par différentes adresses IP, mais vous devez quand même construire et maintenir le crawler, l'analyseur et le système de déblocage. Le crawler Threads inclut tout cela : gestion des proxys, rendu complet du navigateur, résolution de CAPTCHA, analyse des données et livraison. Choisissez les proxys si vous voulez écrire et posséder le code. Choisissez le crawler si vous voulez simplement les données.
Le crawler Threads est-il identique à l'API Crawl de Bright Data ?
Non. L'API Crawl fonctionne sur n'importe quel site web public. Vous lui donnez une URL racine, et elle renvoie le contenu du site en Markdown, Texte, HTML ou JSON. Le crawler Threads est conçu uniquement pour Threads. Il renvoie des champs prêts à l'emploi spécifiques à Threads, afin que vous n'ayez pas à écrire votre propre logique d'analyse.
Quelles entrées puis-je utiliser pour démarrer un crawl ?
Cela dépend du crawler que vous choisissez. Les points de départ courants sont une URL directe, un mot-clé, une URL de catégorie, une URL de recherche, ou une URL de profil, de vendeur ou de boutique. Vous pouvez envoyer jusqu'à 5 000 URLs dans une seule requête groupée.
Puis-je programmer des crawls récurrents de Threads ?
Oui. Le crawler prend en charge la collecte par lots et programmée, ce qui vous permet de relancer le même crawl à intervalles réguliers. Cela est utile pour suivre les évolutions dans le temps, comme les prix, la disponibilité, les classements ou les chiffres d'engagement, sans avoir à démarrer chaque exécution manuellement.
Dois-je gérer les blocages, les CAPTCHAs ou le rendu JavaScript ?
Non. La gestion des proxys, la résolution de CAPTCHA et le rendu complet du navigateur sont tous intégrés. Le crawler fonctionne sur le réseau de Bright Data, qui compte plus de 400 millions d'IP d'utilisateurs réels dans 195 pays, vous permettant ainsi de crawler Threads depuis n'importe quel emplacement sans maintenir votre propre système de déblocage.
Comment le crawler Threads est-il facturé ?
Vous ne payez que pour les enregistrements livrés avec succès. Les livraisons échouées ne sont jamais facturées. Vous pouvez commencer avec le niveau gratuit incluant 5 000 enregistrements par mois sans carte de crédit, puis passer au paiement à l'utilisation ou à un plan mensuel selon votre croissance. Les détails des plans se trouvent dans la section tarifs ci-dessus.
Est-il légal de crawler Threads ?
Le crawler ne collecte que des données publiquement disponibles. Les pratiques de confidentialité de Bright Data respectent les lois sur la protection des données, notamment le RGPD et le CCPA. L'entreprise applique également un processus de Vérification KYC et une Politique d'Utilisation Acceptable publique. Vous restez responsable de vous assurer que votre propre usage des données respecte les lois qui vous sont applicables.
Vous voulez en savoir plus ?
Parlez à un expert pour discuter de vos besoins de crawling Threads