


- API-based data extraction
Use our interface to build your API request and retrieve clean, structured data - Automation at scale
Build your own scheduler to control the frequency of data collection - Flexible delivery
Deliver data to your preferred storage or download it in JSON, CSV, or NDJSON


Web Data API
The most reliable Web Data API. Access structured, real-time data from any website with automatic proxy rotation, anti-bot bypass, and JavaScript rendering. Start with 650+ ready-made data endpoints for popular platforms.

1633 scrapers
- Access real-time web data via API
- Pay only for successfully delivered results
- Bulk request handling, up to 5K URLs
- Retrieve structured results in multiple formats
Approuvé par 50,000+ clients dans le monde entier


Effortlessly access structured web data

Web Data APIs
Web Data API Library
Remove the need to develop and maintain infrastructure. Simply extract high-volume structured web data and ensure scalability and reliability using our Web Data API.
 126.3K+
 11.7K+

Web Data Scraper API Pricing
Ne payez que pour ce qui est livré avec succès. Aucun frais caché, aucun frais pour les livraisons échouées.

Bénéficiez de 25 % de réduction sur l'API Scraper pendant 3 mois. Utilisez le code APIS25 lors du paiement.
Nous acceptons ces méthodes de paiement:

Proxy-Based Scraper vs. Web Data API
 Surveillance et maintenance
 Infrastructure de grattage
 Analyse
 Temps de mise sur le marché
 Efficacité des coûts
CODE EXAMPLES
Dedicated endpoints for 100+ domains.
Entrée
JSON
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.linkedin.com/in/elad-moshe-05a90413/"},{"url":"https://www.linkedin.com/in/jonathan-myrvik-3baa01109"},{"url":"https://www.linkedin.com/in/aviv-tal-75b81/"},{"url":"https://www.linkedin.com/in/bulentakar/"},{"url":"https://www.linkedin.com/in/nnikolaev/"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_l1viktl72bvl7bjuj0&format=json&uncompressed_webhook=true"
Sortie
JSON
[
  {
    "db_source": "1789233410509",
    "timestamp": "2026-09-12",
    "id": "mar***-ro***ts-*********1b6***",
    "name": "Marsha R******, **",
    "city": "Walnut Creek, California, United States",
    "country_code": "US",
    "position": "Chief of Staff\/APIC Hospital Operations Kaiser Walnut Creek Med Center; President, CAL Alumni Association Board",
    "about": "The***rma***te *********rou********************* la***************************************"
  },
  {
    "db_source": "1789233410509",
    "timestamp": "2026-09-12",
    "id": "men***kha***811***",
    "name": "Menna ** S****h",
    "city": "Al Jizah, Egypt",
    "country_code": "EG",
    "position": "Junior Architect",
    "about": "•As***rec*** gr********* ar*********************ng ***************************************"
  },
  {
    "db_source": "1789233410509",
    "timestamp": "2026-09-12",
    "id": "pri***914***213***",
    "name": "Priya *",
    "city": "Bengaluru, Karnataka, India",
    "country_code": "IN",
    "position": "HSBC | MBA- SIBM Bengaluru ( 2022-2024) | B. Com (2018-2021)",
    "about": null
  },
  {
    "db_source": "1789233410509",
    "timestamp": "2026-09-12",
    "id": "тат***а-к***сти*********422***",
    "name": "Тат***а К***сти******",
    "city": "Russia",
    "country_code": "RU",
    "position": "флорист - мегафлаверс",
    "about": null
  },
  {
    "db_source": "1789233410509",
    "timestamp": "2026-09-12",
    "id": "guo***an-***707******",
    "name": "Guo Q**n **",
    "city": "Hong Kong, Hong Kong SAR",
    "country_code": "HK",
    "position": null,
    "about": null
  }
]
Entrée
JSON
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.amazon.com/Quencher-FlowState-Stainless-Insulated-Smoothie/dp/B0CRMZHDG8","asin":"B0CRMZHDG8","origin_url":"https://www.amazon.com/Quencher-FlowState-Stainless-Insulated-Smoothie/dp/B0CRMZHDG8","zipcode":"94107","language":""},{"url":"https://www.amazon.com/KitchenAid-Protective-Dishwasher-Stainless-8-72-Inch/dp/B07PZF3QS3","asin":"B07PZF3QS3","zipcode":"","language":""},{"url":"https://www.amazon.com/TruSkin-Naturals-Vitamin-Topical-Hyaluronic/dp/B01M4MCUAF","asin":"","origin_url":"https://www.amazon.com/TruSkin-Naturals-Vitamin-Topical-Hyaluronic/dp/B01M4MCUAF","zipcode":"94124","language":""}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_l7q7dkf244hwjntr0&format=json&uncompressed_webhook=true"
Sortie
JSON
[
  {
    "db_source": "1788947229099",
    "timestamp": "2026-09-09",
    "title": "Fingerprint Padlock, Dhiedas Pad Lock with Fingerprint Bluetooth Key Waterproof Heavy Duty Combination Lock for Outdoor ...",
    "seller_name": "ZHO***HAN***RUI***",
    "brand": "Dhiedas",
    "description": "About this item 🔐【Fingerprint Padlock with Key backup】Adopted advanced biometric technology, fingerprint padlock quickl...",
    "initial_price": 47.19,
    "currency": "USD"
  },
  {
    "db_source": "1788947229099",
    "timestamp": "2026-09-09",
    "title": "SANNIX 20 Pieces Cartoon Cute Gel Ink RollerBall Pens Bulk Assorted Styles Novelty Writing Pen for Kids Gift School Offi...",
    "seller_name": "******",
    "brand": "SANNIX",
    "description": "About this item What Will You Receive: You will receive 20 cute cartoon gel pens in different styles, with animal shapes...",
    "initial_price": 7.99,
    "currency": "USD"
  },
  {
    "db_source": "1788947229099",
    "timestamp": "2026-09-09",
    "title": "Biomar Labs Front Hood Trunk Tuning Badge 82mm Compatible with BMW Emblem 51148132375 Eyes EO 8",
    "seller_name": "Biomar L**s",
    "brand": "Biomar Labs",
    "description": "Compatible with BMW emblem with part number 51148132375. Compatible with BMW models: Compatible with ActiveHybrid 7-2013...",
    "initial_price": 17.99,
    "currency": "USD"
  },
  {
    "db_source": "1788950830367",
    "timestamp": "2026-09-09",
    "title": "Kurgo Big Baxter Dog Backpack Harness, Chili\/Barn Red",
    "seller_name": null,
    "brand": "Kurgo",
    "description": "Get Fido packed up and ready to go with this lightweight, tough, custom-fit Baxter Dog Pack. Great for everyday use or b...",
    "initial_price": null,
    "currency": "USD"
  },
  {
    "db_source": "1788950830367",
    "timestamp": "2026-09-09",
    "title": "PetSafe Healthy Pet Simply Feed Auto Feeder, Programmable, Holds 24 Cups",
    "seller_name": "Ama***.co***",
    "brand": "PetSafe",
    "description": "Say goodbye to the early morning wake up meow or nose boop. The Healthy Pet Simply Feed will serve your pet breakfast so...",
    "initial_price": 82.99,
    "currency": "USD"
  }
]
Entrée
JSON
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.zillow.com/homedetails/2506-Gordon-Cir-South-Bend-IN-46635/77050198_zpid/?t=for_sale"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_lfqkr8wm13ixtbd8f5&format=json&uncompressed_webhook=true"
Sortie
JSON
[
  {
    "db_source": "1789231677736",
    "timestamp": "2026-09-12",
    "zpid": 89047361,
    "city": "Oswego",
    "state": "IL",
    "homeStatus": "OTHER",
    "address:city": "Oswego",
    "address:streetAddress": "245 Wolverine Dr"
  },
  {
    "db_source": "1789231677736",
    "timestamp": "2026-09-12",
    "zpid": 305690751,
    "city": "Halifax",
    "state": "NS",
    "homeStatus": "OTHER",
    "address:city": "Halifax",
    "address:streetAddress": "76 Convoy Ave"
  },
  {
    "db_source": "1789231677736",
    "timestamp": "2026-09-12",
    "zpid": 32444181,
    "city": "Ballston Spa",
    "state": "NY",
    "homeStatus": "OTHER",
    "address:city": "Ballston Spa",
    "address:streetAddress": "207 Whitetail Ct"
  },
  {
    "db_source": "1789231677736",
    "timestamp": "2026-09-12",
    "zpid": 2057184796,
    "city": "Ajax",
    "state": "ON",
    "homeStatus": "OTHER",
    "address:city": "Ajax",
    "address:streetAddress": "39 Palmer Dr #Basement"
  },
  {
    "db_source": "1789231677736",
    "timestamp": "2026-09-12",
    "zpid": 234739041,
    "city": "Pinola",
    "state": "MS",
    "homeStatus": "OTHER",
    "address:city": "Pinola",
    "address:streetAddress": "204 Swamp Rd"
  }
]
Entrée
JSON
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.instagram.com/p/Cuf4s0MNqNr","country":""},{"url":"https://www.instagram.com/p/DP861NijuwE","country":""}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_lk5ns7kz21pck8jpis&format=json&uncompressed_webhook=true"
Sortie
JSON
[
  {
    "db_source": "1789251570154",
    "timestamp": "2026-09-12",
    "url": "https:\/\/www.instagram.com\/p\/DYoNj6jjbXn\/",
    "user_posted": "jimmybonez400",
    "description": "Happy Birthday Sonny, More Life More Blessings 💪🏾💪🏾💪🏾",
    "hashtags": null,
    "num_comments": 16,
    "date_posted": "2026-05-22T04:56:16.000Z"
  },
  {
    "db_source": "1789251570154",
    "timestamp": "2026-09-12",
    "url": "https:\/\/www.instagram.com\/p\/DV2XPmBjyGi\/",
    "user_posted": "iamlomax",
    "description": "Out Celebrating for Pops B-Day",
    "hashtags": null,
    "num_comments": 2,
    "date_posted": "2026-03-14T03:18:07.000Z"
  },
  {
    "db_source": "1789251570154",
    "timestamp": "2026-09-12",
    "url": "https:\/\/www.instagram.com\/p\/DdJakwUx3ri\/",
    "user_posted": "clemsonmbb",
    "description": "Today and every day, we remember the thousands of lives lost on 9\/11\/2001 and the heroic efforts of our first responders...",
    "hashtags": null,
    "num_comments": 0,
    "date_posted": "2026-09-11T12:30:47.000Z"
  },
  {
    "db_source": "1789251570154",
    "timestamp": "2026-09-12",
    "url": "https:\/\/www.instagram.com\/p\/DclhsjoDugE\/",
    "user_posted": "southbyseacollege",
    "description": "Rookie Year ⚾\n\n#WORKWEEK hats for @txstdeltazeta",
    "hashtags": [
      "#WORKWEEK"
    ],
    "num_comments": 0,
    "date_posted": "2026-08-28T14:00:04.000Z"
  },
  {
    "db_source": "1789251570154",
    "timestamp": "2026-09-12",
    "url": "https:\/\/www.instagram.com\/reel\/Dc_ghIEMETa\/",
    "user_posted": "ciiky",
    "description": "🦣Mamut Parrillero🦣\n\n#publi\n\nBuenísimas tardes 🥰!!\n\nEn @mamut_parrillero puedes disfrutar de una combinación que nos h...",
    "hashtags": [
      "#publi",
      "#MamutParrillero",
      "#Sushi",
      "#BarbacoaCoreana",
      "#BarcelonaFood"
    ],
    "num_comments": 74,
    "date_posted": "2026-09-07T16:20:31.000Z"
  }
]
LE MEILLEUR DX DE SA CATÉGORIE
Facile à démarrer. Plus facile à mettre à l’échelle.
Stabilité inégalée
Garantissez des performances constantes et minimisez les défaillances en vous appuyant sur la première infrastructure de proxy au monde.
Web Scraping simplifié
Mettez votre scraping en pilote automatique en utilisant des API prêtes à la production, ce qui permet d’économiser des ressources et de réduire la maintenance.
Évolutivité illimitée
Adaptez sans effort vos projets de scraping pour répondre aux demandes de données, tout en maintenant des performances optimales.
DÉPLOYEZ PLUS RAPIDEMENT
Un API call. Des tonnes de données.
Découverte des données
Détecter les structures et les modèles de données afin de garantir une extraction efficace et ciblée des données.
Gestion des demandes en bulk
Réduisez la charge du serveur et optimisez la collecte de données pour les tâches de scraping à haut volume.
Analyse des données
Convertit efficacement le HTML brut en données structurées, facilitant ainsi l’intégration et l’analyse des données.
Validation des données
Garantissez la fiabilité des données et gagnez du temps lors des contrôles manuels et du prétraitement.
SOUS LE CAPOT
Ne vous souciez plus jamais des proxies et des CAPTCHA
- Rotation automatique des IP
- Résolution de CAPTCHA
- Rotation des agents utilisateur
- En-têtes personnalisés
- Rendu JavaScript
- Proxys résidentiels
Every 15 minutes, our customers collect enough web data to train ChatGPT from scratch.
API pour un accès fluide aux données Web Data
Extraction de données web complète, évolutive et conforme
API pour un accès fluide aux données Web Data
Extraction de données web complète, évolutive et conforme
Adapté à votre flux de travail
Obtenez des données structurées en fichiers JSON, NDJSON ou CSV via Webhook ou livraison par API.
Infrastructure intégrée et déblocage
Bénéficiez d’un contrôle et d’une flexibilité maximaux sans maintenir de Proxy ni d’infrastructure de déblocage. Scrapez facilement des données depuis n’importe quelle géolocalisation en évitant les CAPTCHAs et les blocages.
Infrastructure éprouvée
La plateforme de Bright Data alimente plus de 20 000 entreprises dans le monde, offrant une tranquillité d’esprit avec 99,99 % de disponibilité et l’accès à plus de 150 M d’IPs d’utilisateurs réels couvrant 195 pays.
Conformité de premier plan dans le secteur
Nos pratiques de confidentialité respectent les lois sur la protection des données, notamment le cadre réglementaire européen de protection des données, le RGPD et le CCPA.
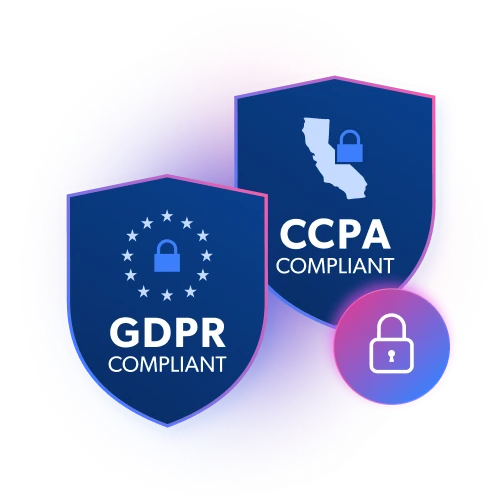
API pour un accès fluide aux données Web Data
Extraction de données web complète, évolutive et conforme

FLEXIBLE
Adapté à votre flux de travail
Obtenez des données structurées en fichiers JSON, NDJSON ou CSV via Webhook ou livraison par API.
SCALABLE
Infrastructure intégrée et déblocage
Bénéficiez d'un contrôle et d'une flexibilité maximaux sans maintenir de Proxy ni d'infrastructure de déblocage. Scrapez facilement des données depuis n'importe quelle géolocalisation en évitant les CAPTCHAs et les blocages.
STABLE
Infrastructure éprouvée
La plateforme de Bright Data alimente plus de 20 000 entreprises dans le monde, offrant une tranquillité d'esprit avec 99,99 % de disponibilité et l'accès à plus de 150 M d'IPs d'utilisateurs réels couvrant 195 pays.
COMPLIANT
Conformité de premier plan dans le secteur
Nos pratiques de confidentialité respectent les lois sur la protection des données, notamment le cadre réglementaire européen de protection des données, le RGPD et le CCPA.USE CASES
Web Data APIs for every use case


Web Data API FAQs
What is a Web Data API?
A Web Data API is a cloud-based service that enables developers to extract structured, real-time data from any public website without building or maintaining scraping infrastructure. It automates proxy rotation, CAPTCHA solving, JavaScript rendering, and data parsing — delivering clean, structured outputs in formats like JSON, CSV, and Markdown for immediate use in applications, AI pipelines, and analytics workflows.
Who can benefit from using a Web Data API?
Data analysts, AI/ML engineers, data scientists, and developers who need reliable, structured web data for AI training, RAG pipelines, market intelligence, price monitoring, lead enrichment, and big data applications will find a Web Data API especially valuable. It removes the complexity of managing scraping infrastructure so teams can focus on building with data.
Why choose a Web Data API over manual scraping methods?
A Web Data API overcomes the limitations of manual web scraping — such as dealing with website structure changes, IP blocks, CAPTCHAs, and the high cost of infrastructure maintenance. It provides an automated, scalable, and reliable solution for structured data extraction, significantly reducing operational costs, development time, and ongoing maintenance burden.
What makes Bright Data's Web Data API unique in the market?
Bright Data's Web Data API stands out through its combination of 600+ pre-built domain-specific data endpoints, bulk request handling, automated data validation, and support for multiple output formats. Backed by the world's largest proxy network (150M+ IPs) and advanced JavaScript rendering, it delivers industry-leading success rates, broad web coverage, and high data integrity at petabyte scale.
How can I get started with Bright Data's Web Data API?
Getting started is straightforward via Bright Data's control panel, which provides comprehensive API documentation, code examples in multiple languages, and a user-friendly dashboard for API key management. With a free trial available, you can immediately access a highly scalable and reliable platform for structured web data extraction — no proxy setup or infrastructure required.
What specific use cases is the Web Data API optimized for?
Bright Data's Web Data API supports a wide range of use cases including competitive price monitoring, market trend analysis, dynamic pricing algorithms, AI/LLM training datasets, sentiment analysis, lead enrichment, and real-time data feeds for financial and e-commerce platforms. It empowers data and engineering teams to implement data-driven strategies at scale across every major industry.
How does the Web Data API handle large-scale data extraction tasks?
The Web Data API is built for high-concurrency and batch processing scenarios, supporting up to 5,000 URLs per bulk request. With automatic retries, intelligent proxy rotation, and distributed infrastructure, it ensures developers can scale their data collection operations efficiently — accommodating massive request volumes with high throughput and minimal failure rates.
In which data formats can the Web Data API deliver extracted information?
Bright Data's Web Data API delivers extracted web data in versatile structured formats including JSON, NDJSON, and CSV, as well as raw HTML and Markdown — ensuring seamless integration with analytics tools, AI pipelines, cloud storage, and data processing workflows. Multiple delivery options are supported including direct download, webhooks, and external cloud storage.