Scraper Walmart à grande échelle donne aux équipes de pricing les prix, le stock et les avis que voient les acheteurs, collectés sur des milliers de pages selon un calendrier.
La détection de bots de Walmart n’est que le premier problème. Quand j’ai récupéré des pages produits depuis des IPs rotatives, Walmart tarifait chaque page pour un magasin différent. Si votre scraper ne définit pas de code postal ou de magasin, Walmart choisit un magasin selon l’adresse IP. Votre tableau de prix mélange alors les magasins, sans aucune erreur pour vous avertir.
Ce guide explique les défenses et limites de listing de Walmart, quelle méthode choisir, et comment collecter des prix au niveau du magasin en Python.
TL;DR
- Le magasin peut changer le prix. Sur 8 codes postaux, le même gallon de lait variait de 2,42$ à 6,28$.
- Définir le magasin par requête a fonctionné. Avec un ID de magasin, l’API Walmart Scraper de Bright Data a retourné exactement les prix que le navigateur affichait dans les deux magasins comparés.
- Un listing de catégorie Walmart s’est arrêté vers 390 produits uniques. Il revendiquait environ 2 450 articles mais en affichait 389, et le diviser en 9 tranches de prix en a trouvé 2 069.
- Un statut 200 ne signifiait pas un succès. Walmart servait son défi « Robot ou humain ? » avec un HTTP 200, donc vérifiez le contenu et l’ID de magasin de chaque enregistrement.
Comment Walmart détecte les scrapers
Les pages produits de Walmart étaient protégées par Akamai, HUMAN, et un pare-feu applicatif web (WAF) F5. Les en-têtes, cookies et configuration runtime d’une seule réponse de page produit montraient les 3 :
| Couche | Comment je l’ai reconnue | Ce que recevaient les scripts |
|---|---|---|
| Edge Akamai | En-têtes x-ak-protocol et server-timing: ak_p, le cookie akavpau_p2, et les cookies Bot Manager ak_bmsc et bm_sv dans les sessions navigateur |
418 Access Denied pour les appels GraphQL sans les en-têtes client de Walmart |
| HUMAN, anciennement PerimeterX | Un capteur propriétaire à /px/PXu6b0qd2S/init.js et les cookies _pxhd, _px3, et _pxvid |
Une redirection 307 vers /blocked, puis une page « Robot ou humain ? » appuyer-maintenir avec statut 200 |
| WAF F5 | 6 cookies préfixés TS dans une session navigateur, tel que TS012768cf |
Aucune réponse de blocage tracée à celui-ci |
Chrome headless classique, lancé avec Playwright, a obtenu le CAPTCHA appuyer-maintenir de HUMAN les deux fois où j’ai essayé. La page de défi ressemblait à une page Walmart normale et retournait un statut 200 :
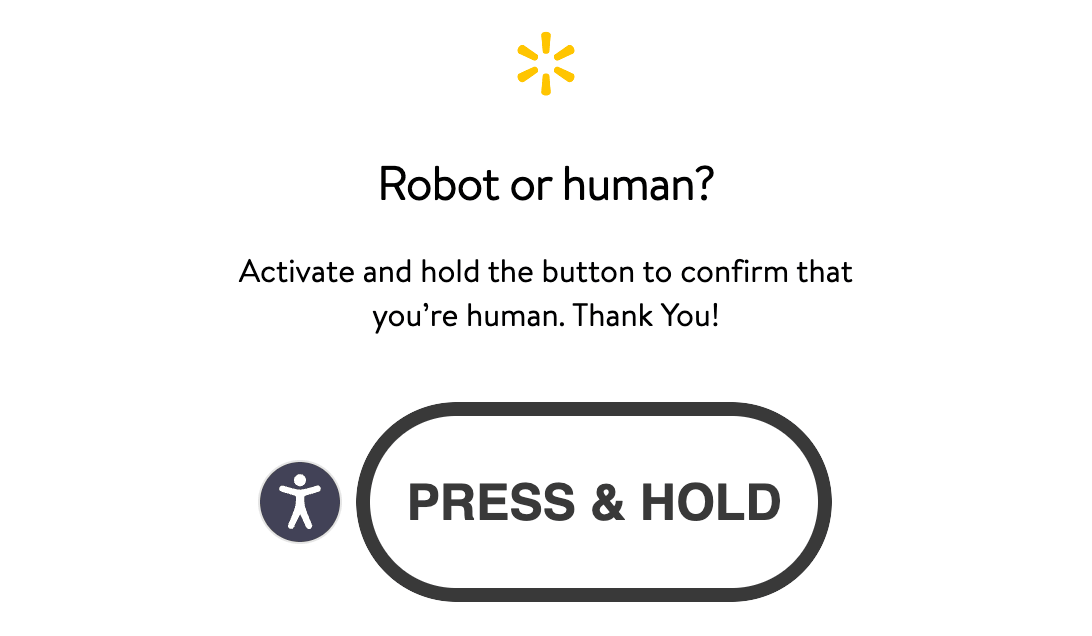
Un scraper qui vérifie seulement le code de statut enregistrerait cette page comme un succès.
La même configuration runtime activait ThreatMetrix, un service de profilage d’appareils, uniquement sur les pages de compte telles que le panier, les commandes, le portefeuille et les abonnements. Cette liste n’incluait pas les pages produit, catégorie ou avis, celles dont a besoin le suivi de prix.
Le propre indicateur de bot de Walmart n’indiquait pas si une requête passait. Chaque page produit intégrait un objet psych avec des champs tels que isAkamaiBot. Ce champ valait "1" même sur les pages que Walmart servait en intégralité, donc jugez une réponse par son contenu et son ID de magasin.
Quels clients HTTP étaient défiés
Sur la même IP, le fait que Walmart affiche un défi dépendait du client HTTP. J’ai demandé les 5 mêmes URLs de produits Walmart avec 6 clients HTTP depuis une IP de connexion domestique non-américaine, 1 URL par round. Dans chaque round, les clients demandaient cette URL un par un, à 2 secondes d’intervalle, chacun gardant son propre pot de cookies.
Sur les 5 URLs, 3 étaient mortes, et elles donnaient quand même un signal clair. Un client qui passait obtenait la page 404 de Walmart, tandis qu’un client défié obtenait la page de défi :
| Client | Pages de défi sur 5 requêtes |
|---|---|
| curl avec LibreSSL | 4 |
Python requests |
2 |
httpx avec HTTP/2 |
1 |
curl_cffi imitant Firefox |
2 |
curl_cffi imitant Chrome |
0 |
curl_cffi imitant Safari |
0 |
Dans les 2 rounds avec des URLs de produits en direct, curl, requests, et le profil Firefox ont obtenu le défi. Dans les mêmes rounds, à quelques secondes d’intervalle, les profils Chrome et Safari ont obtenu la page produit.
Notre guide curl_cffi couvre la configuration d’imitation, et notre article sur le fingerprinting TLS couvre ce que révèle la poignée de main.
Via une session américaine sur les proxys résidentiels de Bright Data, les 6 mêmes clients ont fait 30 requêtes sans une seule page de défi. Chaque client a obtenu une IP résidentielle américaine. Les résultats dépendent de chaque combinaison client et proxy, donc testez le vôtre contre Walmart à la concurrence que vous prévoyez d’utiliser.
Où les pages Walmart conservent leurs données
Walmart rendait les pages produit, recherche, catégorie et avis avec le routeur de pages Next.js. Chaque page intégrait son modèle de données en JSON dans une balise de script __NEXT_DATA__. Sur une page produit de bonbons, ce JSON représentait 401 Ko des 592 Ko de HTML. Ces chemins JSON contenaient les champs importants :
- Pages produit :
props.pageProps.initialData.data.product, incluant le prix, la disponibilité, le vendeur, et un objetlocation - Pages recherche et catégorie :
props.pageProps.initialData.searchResult.itemStacks[].items, avec le total rapporté danssearchResult.aggregatedCount - Pages avis :
props.pageProps.initialData.data.reviews, avec son propre bloc de pagination
La balise avait un attribut nonce, donc faites correspondre par id avec un motif qui autorise des attributs supplémentaires.
Dans le navigateur, l’API GraphQL de Walmart servait des données que la page n’intégrait pas, tels que les détails d’article plus bas dans la page. L’API utilisait des requêtes persistées, qui sont des requêtes enregistrées que le client appelle par un hash SHA-256 dans l’URL :
/orchestra/pdp/graphql/ItemByIdBtf/<sha256-hash>/ip/<item-id>Walmart bloquait les rejeux scriptés de ces appels GraphQL. Sans les en-têtes client x-o-* de Walmart, un appel scripté vers /orchestra/home/graphql obtenait le 418 d’Akamai. Avec les en-têtes, il obtenait un blocage HUMAN en JSON avec statut 412.
Ces en-têtes incluaient aussi la version de l’app web, qui change avec les mises à jour de Walmart, donc les valeurs codées en dur dans les anciens scrapers open-source deviennent obsolètes.
Le script ci-dessous récupère une page produit via l’API Web Unlocker de Bright Data, puis lit les données produit et le magasin pour lequel elle a été tarifée. Il nécessite Python 3.9 ou ultérieur et requests, votre clé API dans BRIGHTDATA_API_TOKEN, et le nom de votre zone Web Unlocker dans BRIGHTDATA_UNLOCKER_ZONE :
import json
import os
import re

import requests

API_KEY = os.environ["BRIGHTDATA_API_TOKEN"]
ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]  # votre nom de zone Web Unlocker
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__"[^>]*>(.*?)</script>', re.S)


def fetch(url: str) -> tuple[str, str]:
    """Retourne le code de statut et le HTML de la page."""
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": "us"},
        timeout=180,
    )
    r.raise_for_status()
    # Web Unlocker rapporte le code de statut de la page cible dans cet en-tête.
    return r.headers.get("x-brd-status-code", ""), r.text


def parse_product(html: str) -> dict:
    if "Robot or human" in html:
        raise RuntimeError("page de défi, pas une page produit")
    match = NEXT_DATA.search(html)
    if match is None:
        raise RuntimeError("pas de bloc __NEXT_DATA__ dans la page")
    data = json.loads(match.group(1))["props"]["pageProps"]["initialData"]
    product = data["data"]["product"]
    location = product.get("location") or {}
    price = (product.get("priceInfo") or {}).get("currentPrice") or {}
    return {
        "us_item_id": product.get("usItemId"),
        "name": product.get("name"),
        "price": price.get("price"),
        "availability": product.get("availabilityStatus"),
        "seller": product.get("sellerName"),
        "store_id": (location.get("storeIds") or [None])[0],
        "zip": location.get("postalCode"),
    }


status, html = fetch("https://www.walmart.com/ip/10450114")
if status != "200":
    raise RuntimeError(f"statut de page {status}, pas 200")
print(status, json.dumps(parse_product(html), indent=2))
Une exécution a retourné un produit en direct tarifé pour un magasin que le script n’a jamais demandé. Votre exécution montrera probablement un autre magasin :
200 {
  "us_item_id": "10450114",
  "name": "Great Value Whole Vitamin D Milk, Gallon",
  "price": 3.32,
  "availability": "IN_STOCK",
  "seller": "Walmart.com",
  "store_id": "3081",
  "zip": "95829"
}
L’API Web Unlocker rapporte le propre code de statut de Walmart dans l’en-tête x-brd-status-code, comme le décrit sa page de codes d’erreur. Le script vérifie cet en-tête avant d’analyser la page.
Analysez d’abord le JSON intégré. Pour les données que la page n’intègre pas, appelez GraphQL depuis une session navigateur, car les appels scriptés étaient bloqués.
Pourquoi un prix Walmart dépend du magasin
La documentation de l’API Affiliate Marketing de Walmart indiquait que le prix et la disponibilité d’un article dépendent du code postal et de l’ID de magasin de la requête. Sur les prix en magasin, un porte-parole de Walmart a déclaré à CNBC que « le prix que vous voyez est le même pour tout le monde dans un magasin donné ». Chaque page produit était tarifée pour un magasin spécifique.
La page nommait ce magasin dans son texte « Pickup from », et le prix variait selon le magasin. Le même gallon de lait coûtait 3,32$ au magasin de Sacramento assigné par Walmart et 3,03$ dans un magasin d’Atlanta que j’ai choisi manuellement :
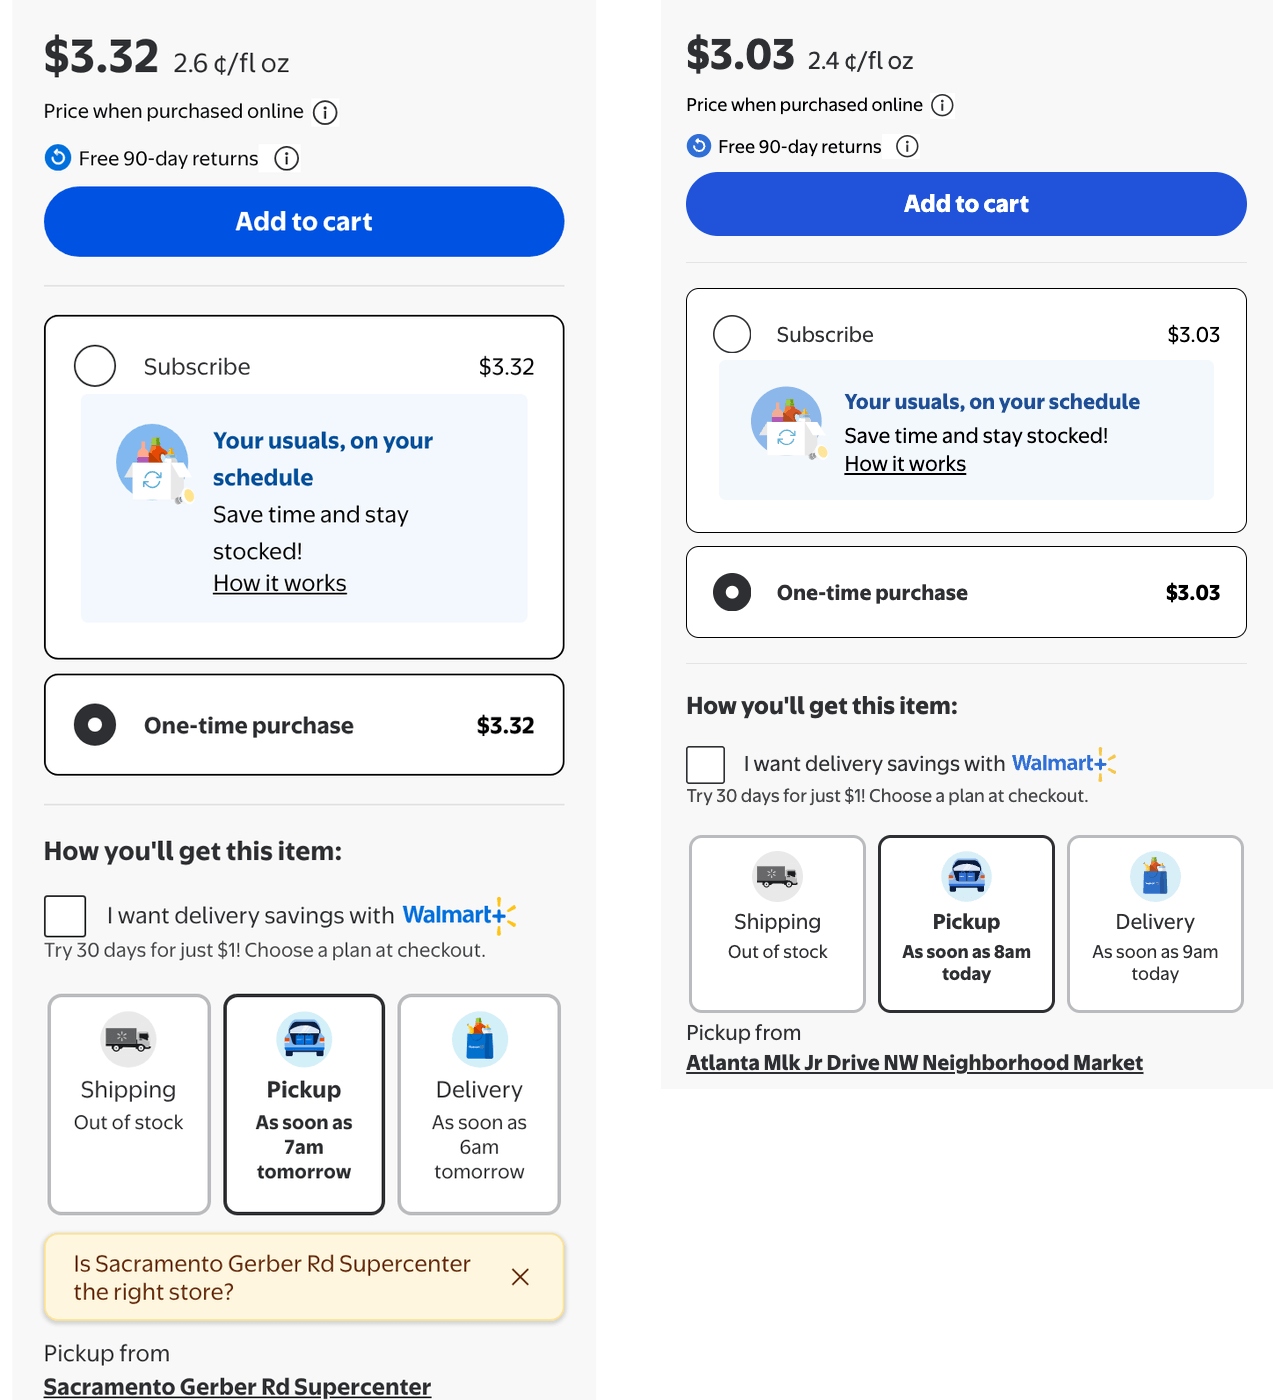
Sans le magasin dans chaque enregistrement, ces 2 prix pour le même lait ressembleraient à un changement de prix.
Quand une requête n’incluait aucune localisation, Walmart choisissait un magasin, l’enregistrait dans l’objet location de la page, et marquait le choix comme IMPLICIT. Certaines connexions obtenaient un magasin par défaut, le magasin 3081 à Sacramento, code postal 95829, qui est le magasin dans la sortie du script. Walmart basait le magasin sur l’IP de sortie, donc les IPs rotatives changeaient aussi le magasin :
- IPs rotatives : chacune des 48 pages produit était tarifée pour un magasin différent.
- Autres connexions : une IP de connexion non-américaine et une IP satellite ont toutes deux obtenu le magasin par défaut. Walmart a localisé une autre session à Big Water, Utah, code postal 84741, et lui a aussi donné le magasin par défaut.
Pourquoi définir le magasin depuis un script n’était pas fiable
J’ai essayé 2 méthodes, et les deux ont laissé le choix du magasin à Walmart :
- Cookies de localisation : j’ai défini
assortmentStoreIdet un cookielocGuestDataconstruit à la main. Sur 9 requêtes avec les cookies, 6 ont obtenu la page de défi, alors que 0 des 3 requêtes sans eux l’ont obtenue. Les 3 qui ont passé ont gardé le magasin de l’IP. - Choisir l’IP de sortie : Walmart utilisait sa propre géolocalisation IP. Cette géolocalisation correspondait au code postal d’une recherche IP standard sur seulement 5 des 11 pages, donc le code postal d’une IP ne prédisait pas le magasin.
Comment un code postal ou un ID de magasin définit le magasin
L’entrée zipcode de l’API Walmart Scraper de Bright Data définit la localisation pour chaque requête. J’ai collecté 4 articles d’épicerie dans chacun des 8 codes postaux, et le même gallon de lait entier Great Value a montré 8 prix différents :
| Code postal | ID de magasin dans l’enregistrement | Prix |
|---|---|---|
| 60614, Chicago, IL | 5402 | 2,42$ |
| 75201, Dallas, TX | 5823 | 2,46$ |
| 72712, Bentonville, AR | 100 | 2,72$ |
| 33177, zone Miami, FL | 6397 | 2,92$ |
| 94103, San Francisco, CA | 2648 | 3,32$ |
| 10001, New York, NY | 3520, Secaucus Supercenter, NJ | 4,07$ |
| 99504, Anchorage, AK | 4359 | 4,98$ |
| 96813, Honolulu, HI | 3478 | 6,28$ |
Les bananes variaient de 0,13$ à Bentonville à 0,42$ à Honolulu. Les œufs coûtaient 1,67$ dans les 8 codes postaux, mais le retrait était indisponible dans 3 d’entre eux. Enregistrez la disponibilité par magasin, de la même manière que le prix.
Définir le magasin comptait encore pour la poudre de protéine, qui variait moins que le lait. J’ai collecté 387 de ses produits deux fois, d’abord sans code postal puis avec le code postal de Bentonville. Les enregistrements de la première exécution provenaient de 170 magasins différents, et 24 produits ont changé de prix entre les 2 exécutions.
Un code postal n’est pas un magasin. Le code postal 10001 à Manhattan se résolvait au Secaucus Supercenter dans le New Jersey, magasin 3520. Le sélecteur de magasin de Walmart listait plusieurs magasins pour le code postal 30303 à Atlanta :
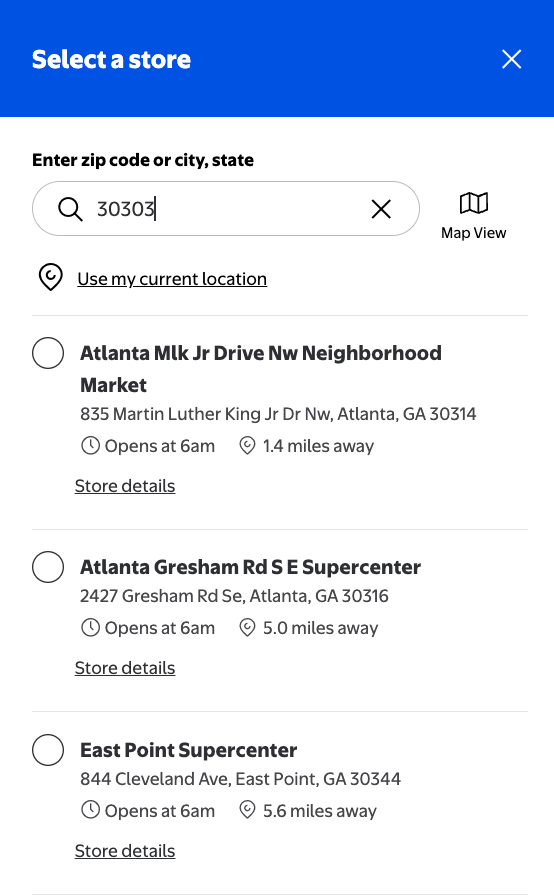
Les 3 premiers magasins listés pour le code postal 30303. Un code postal pointe vers une zone, et un ID de magasin pointe vers un magasin.
Quand vous avez besoin d’un magasin spécifique, l’API Walmart Scraper accepte aussi un store_id. L’URL de page de chaque magasin sur walmart.com contenait son ID, tel que 100 dans walmart.com/store/100-bentonville-ar. Le plan du site des magasins de Walmart, walmart.com/sitemap_store_main.xml, listait ces URLs par type de magasin, incluant des pages pour 3 582 Supercenters et 675 Neighborhood Markets. Quand j’ai défini les 2 magasins des captures d’écran de lait, l’API a retourné les prix que le navigateur affichait, 3,32$ à Sacramento et 3,03$ à Atlanta.
Des exécutions répétées pour le même code postal ont retourné les mêmes prix. Le lait de Chicago coûtait à nouveau 2,42$ lors de 2 exécutions ultérieures dans les 90 minutes. À Bentonville, 2 jobs exécutés simultanément ont retourné les mêmes prix pour les 39 produits que les deux jobs ont collectés. Un jour plus tard, le code postal 72712 se résolvait toujours au magasin 100, et le lait y coûtait toujours 2,72$.
Que consigner avec chaque prix
Les deux prix de lait dans les captures d’écran avaient le label de Walmart « Price when purchased online », donc traitez les prix scrapés comme les prix en ligne de chaque magasin.
La disponibilité dépend aussi de la méthode de traitement. Sur la page du lait, l’expédition affichait rupture de stock tandis que le retrait et la livraison depuis le même magasin affichaient en stock. Les enregistrements de l’API Walmart Scraper avaient des indicateurs séparés de retrait et de livraison pour cela. Leur champ Fulfillment_type nommait qui exécutait la commande, tel que le vendeur ou Walmart Fulfillment Services.
Les prix unitaires de Walmart utilisaient aussi différentes unités. Le même gallon affichait un unit_price de 0,023 par once liquide à Miami et 1,02 par quart à New York. Recalculez les prix unitaires à partir de la taille du paquet. Pour le lait, l’enregistrement complet listait la taille de paquet sous specifications comme 128 onces liquides.
Les prix changent aussi au fil du temps. Walmart a rapporté plus de 11 000 rollbacks, son terme pour les réductions de prix temporaires, dans un seul trimestre.
Indexez chaque prix par ID de magasin, code postal, et horodatage, et consignez la disponibilité pour chaque méthode de traitement. Rejetez tout enregistrement tarifé pour une localisation que vous n’avez pas demandée.
Comment travailler dans les limites de listing et d’avis de Walmart
La page de catégorie de poudre de protéine de Walmart rapportait environ 2 450 articles et un maxPage de 25. Les pages 1 à 10 contenaient environ 50 emplacements produit chacune, dont environ 10 étaient sponsorisés. Les pages après la page 11 n’avaient aucun produit :
| Page de catégorie | Emplacements produit retournés |
|---|---|
| 1 à 10 | 47 à 50 par page |
| 11 | 13 dans une exécution, 0 dans une autre |
| 12 à 25 | 0 |
Les pages 1 à 11 avaient 501 emplacements au total, et elles contenaient 389 produits uniques. Cette limite de pagination venait du listing même de Walmart, donc elle apparaissait de la même façon dans chaque session que j’ai exécutée.
Dans un navigateur de bureau, les numéros de page atteignaient quand même 25, et la page 12 retournait la page introuvable de Walmart :
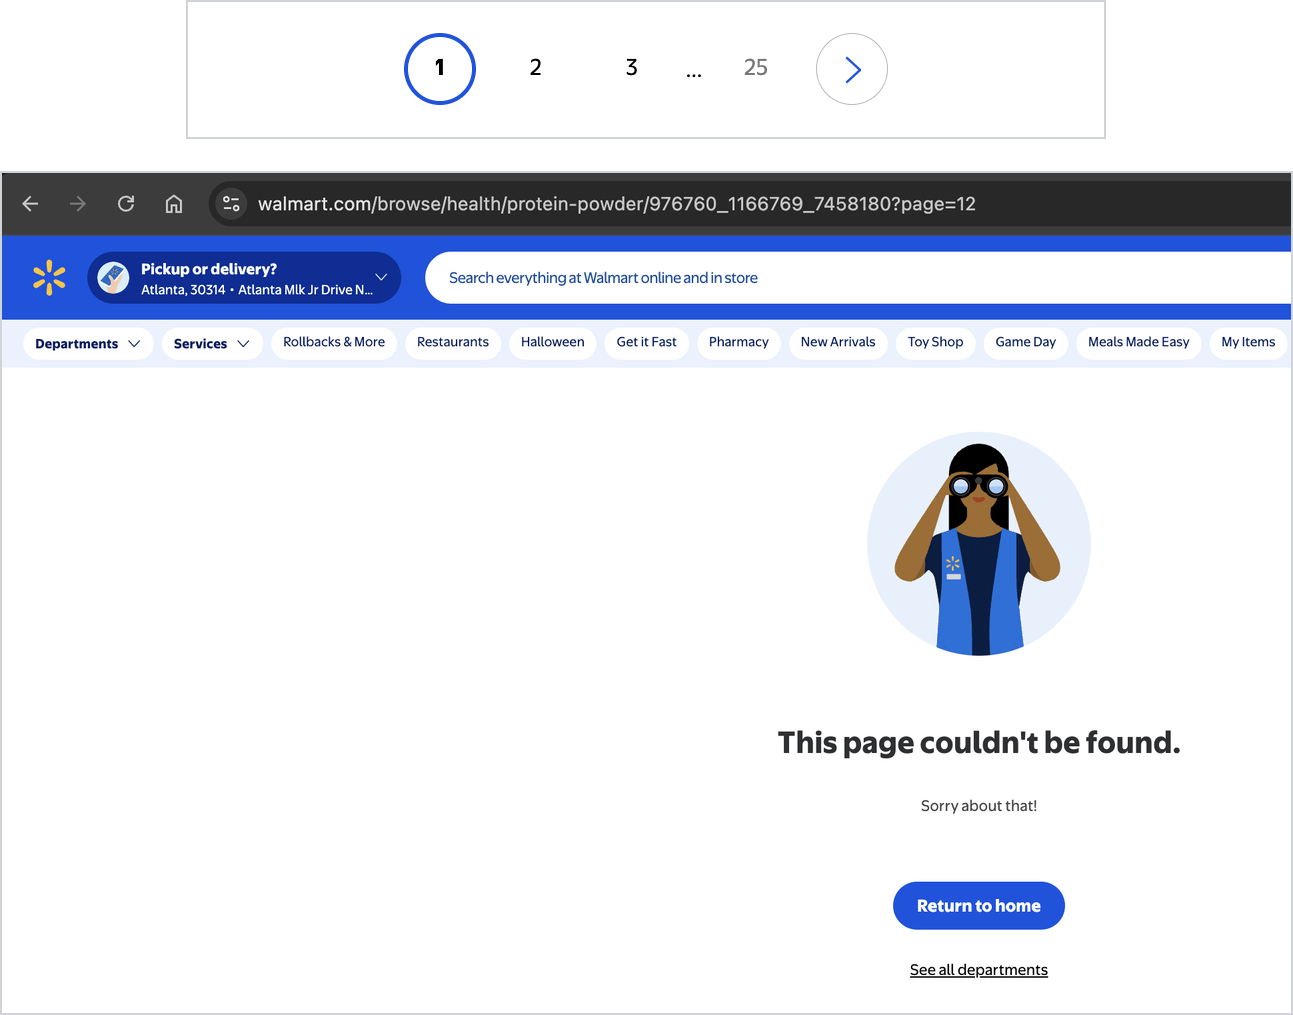
Un scraper qui suivait les numéros de page jusqu’à 25 n’obtenait rien après la page 11.
Comment diviser une catégorie en tranches de prix
La découverte de catégorie de l’API Walmart Scraper accepte des URLs de catégorie avec les filtres de prix de Walmart, donc vous pouvez collecter une catégorie tranche par tranche. Comme référence, l’URL de catégorie non filtrée a retourné 393 produits uniques, proche des 389 que montrait le listing.
Les paramètres d’URL min_price et max_price de Walmart divisent la catégorie en tranches de prix, et chaque tranche rapportait son propre nombre. J’ai d’abord divisé la catégorie à 15$, 25$, 35$, 50$, et 75$. J’ai ensuite divisé les 3 tranches qui rapportaient plus de 500 produits, à 42$, 62$, et 100$, et exécuté la découverte sur les 9 tranches :
| Tranche de prix | Produits rapportés par Walmart | Produits uniques découverts |
|---|---|---|
| 0$ à 15$ | 75 | 60 |
| 15$ à 25$ | 230 | 189 |
| 25$ à 35$ | 429 | 330 |
| 35$ à 50$, en 2 tranches | 718 | 569 |
| 50$ à 75$, en 2 tranches | 592 | 484 |
| 75$ et plus, en 2 tranches | 519 | 444 |
Les 9 tranches ont retourné 2 069 produits uniques, soit environ 5 fois la référence. La colonne totalise 2 076 car quelques produits apparaissaient dans 2 tranches. Aucune tranche n’a retourné plus de 330 produits uniques, donc chacune restait sous la limite de pagination.
Les nombres rapportés par Walmart étaient 17 % à 30 % plus élevés que les produits uniques retournés par chaque ligne. Dans la tranche 0$ à 15$, les 2 pages de listing ne montraient que 62 produits uniques, pas les 75 rapportés par Walmart. La découverte en a retourné 60, proche des 62 sur les pages. Traitez le nombre rapporté par Walmart comme une limite supérieure.
Divisez chaque catégorie en tranches de prix jusqu’à ce que chaque tranche retourne moins de produits uniques que sa limite de pagination, qui était d’environ 390 pour la poudre de protéine.
Les plans de site produit de Walmart listaient bien plus de produits qu’un listing de catégorie. Via l’API Web Unlocker, j’ai récupéré un index de plan de site produit qui pointait vers 5 916 fichiers de plan de site. Le premier fichier seul contenait 50 000 URLs de produits de catégories mixtes, et chaque URL n’avait qu’une date de dernière modification. Utilisez les plans de site pour des listes d’URLs à l’échelle du catalogue, et utilisez les tranches de prix pour les catégories que vous suivez.
Où s’arrêtent les résultats de recherche et les avis
La recherche avait sa propre limite de page. Une recherche pour « laptop » rapportait 20 251 résultats mais un maxPage de 14, à 40 résultats par page, donc au maximum 560 résultats étaient accessibles. Quand c’est possible, découvrez les produits via les catégories ou les plans de site.
Quand vous avez besoin des résultats de recherche eux-mêmes, comme dans le suivi de share-of-shelf, utilisez le scraper de recherche produits Walmart, dont les enregistrements signalaient les résultats sponsorisés. Une recherche pour « protein powder » a retourné 568 enregistrements, incluant 164 sponsorisés. Parmi ces enregistrements, 55 IDs d’articles apparaissaient plus d’une fois, et 52 d’entre eux étaient à la fois des résultats sponsorisés et organiques. Gardez les deux placements pour le share-of-shelf, et dédupliquez par ID d’article pour une liste de produits.
Les avis avaient leur propre limite de pagination. La page du lait montrait 399 133 évaluations, dont 27 412 avaient un texte écrit. Sous le tri par défaut, sa pagination montrait 10 avis par page et s’arrêtait à 10 000. La page 1001 n’échouait pas mais retournait à nouveau la page 1, donc arrêtez-vous au nombre de pages rapporté par Walmart au lieu d’attendre une page vide.
Le scraper d’avis Walmart accepte une entrée sort_by pour l’ordre des avis. Pour un produit de bonbons avec 127 évaluations, il a retourné les 41 avis écrits.
Pourquoi votre liste d’URLs a besoin de mises à jour régulières
Environ 1 ancienne URL de produit sur 7 était morte. Sur 150 URLs de produits vieilles d’environ 2 ans, 22 retournaient 404 ou 410, et 37 autres pages en direct n’avaient pas de prix.
Exécutez à nouveau la découverte assez souvent pour garder votre liste d’URLs à jour, afin que chaque job collecte des produits en direct.
Comment choisir une méthode pour Scraper Walmart
Chaque méthode ci-dessous fait une quantité différente du travail pour vous, de l’accès brut aux pages jusqu’aux enregistrements finis. La page de tarification de chaque produit liste ses prix actuels :
| Méthode | Ce qu’elle gère pour vous | Base de facturation | Sélection de magasin | Tarification actuelle |
|---|---|---|---|---|
| Proxys résidentiels rotatifs avec votre propre parseur | IPs résidentielles rotatives pour votre propre client et parseur | Par Go de trafic | Défini par Walmart depuis l’IP de sortie | Tarification des proxys résidentiels |
| API Web Unlocker avec votre propre parseur | Déblocage, avec le code de statut de Walmart dans un en-tête de réponse | Par requête réussie | Défini par Walmart depuis l’IP de sortie | Tarification Web Unlocker |
| API Walmart Scraper | Découverte, collecte, et enregistrements analysés avec champs de magasin | Par enregistrement livré | Défini par requête avec zipcode et store_id |
Tarification Web Scraper API |
| API Browser | Un navigateur complet avec un solveur de CAPTCHA intégré, pour les flux interactifs | Par Go de trafic | Défini en choisissant un magasin sur la page | Tarification Browser API |
| Jeux de données Walmart | Données produits, avis et vendeurs Walmart prêtes à l’emploi | Par enregistrement | Défini au moment de la collecte | Tarification des jeux de données |
Les proxys résidentiels et l’API Web Unlocker livrent la page brute, donc votre équipe exécute l’analyse et la validation du magasin. L’API Walmart Scraper retourne des enregistrements analysés que vous pouvez valider directement.
Les proxys résidentiels vous donnent un contrôle total de chaque requête. Vous choisissez le client, les en-têtes et le parseur, ce qui convient aux équipes qui exécutent déjà leur propre pile.
L’API Web Unlocker gère l’accès pour que vous puissiez vous concentrer sur l’analyse. Elle a aussi récupéré les plans de site produit de Walmart pour des listes d’URLs à l’échelle du catalogue.
L’API Walmart Scraper convient au travail au niveau du magasin en volume. Ses entrées zipcode et store_id définissent la localisation, et ses enregistrements rapportent le magasin pour lequel ils ont été tarifés, donc votre pipeline peut vérifier chaque enregistrement.
Utilisez l’API Browser pour les flux interactifs. Elle exécute un navigateur complet, ce qui convient pour explorer une page et capturer de nouveaux points de terminaison. Pour un volume à l’échelle du catalogue, combinez-la avec l’API Walmart Scraper ou l’API Web Unlocker.
Les jeux de données conviennent aux remplissages rétroactifs et à l’analyse à l’échelle du catalogue. Les jeux de données Walmart offrent un choix de calendriers de rafraîchissement.
Les agents peuvent exécuter des recherches de produit unique. Le CLI Bright Data a un pipeline walmart_product, et le serveur MCP Bright Data a un outil web_data_walmart_product. À partir d’une URL de produit, le pipeline CLI a retourné un enregistrement avec le même schéma que les enregistrements de l’API Walmart Scraper.
Comparez chaque méthode par coût par enregistrement valide, car une page tarifée pour le mauvais magasin n’est pas un enregistrement utilisable au niveau du magasin.
Comment construire un pipeline de prix au niveau du magasin avec l’API Walmart Scraper
Pour Scraper Walmart à grande échelle, découvrez les URLs par tranche de prix, définissez un code postal ou un ID de magasin sur chacune, et vérifiez l’ID de magasin de chaque enregistrement. L’API Walmart Scraper a des scrapers séparés pour les produits, avis, vendeurs et recherche, tous disponibles via la même API REST. Les nouveaux comptes peuvent démarrer sur le palier gratuit. Chaque scraper a son propre ID de jeu de données et ses propres entrées :
| Scraper | ID de jeu de données | Entrées principales | Utilisez-le pour |
|---|---|---|---|
| Produits Walmart | gd_l95fol7l1ru6rlo116 |
url avec zipcode et store_id facultatif, ou découverte par category_url, keyword, ou sku |
Prix au niveau du magasin, détails produit, et images |
| Codes postaux produits Walmart | gd_m693oc1r1gebnayxq |
url avec zip_code et store_id facultatif, ou découverte par catégorie ou mot-clé |
Magasin de retrait, quantité en stock, et ETA de livraison |
| Avis Walmart | gd_mpql1v8g2o8o6l1wzd |
url avec sort_by facultatif |
Avis écrits |
| Infos vendeurs Walmart | gd_m7ke48w81ocyu4hhz0 |
Page vendeur url |
Profils vendeurs |
| Recherche produits Walmart | gd_m7khey0wb7wviejgj |
Page de recherche url |
Résultats de recherche avec indicateurs sponsorisés |
Dans le panneau de contrôle, le scraper de produits Walmart acceptait un code postal et un store_id avec chaque URL :
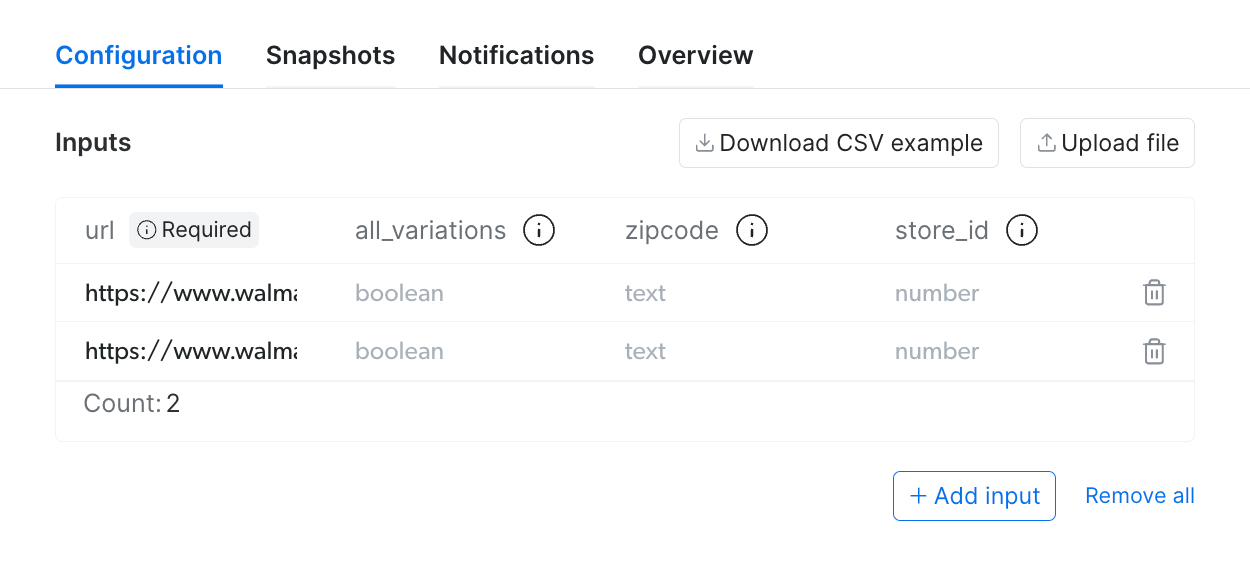
Les colonnes zipcode et store_id demandent un magasin pour chaque enregistrement.
Créer les helpers partagés
Ces helpers nécessitent une clé API dans BRIGHTDATA_API_TOKEN. La fonction post respecte Retry-After, donc votre client attend et réessaie quand il atteint les limites de requêtes async :
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
WALMART_PRODUCTS = "gd_l95fol7l1ru6rlo116"


def post(url, **kwargs):
    """POST qui respecte Retry-After pour rester dans les limites de débit."""
    for attempt in range(6):
        r = requests.post(url, headers=HEADERS, timeout=120, **kwargs)
        if r.status_code != 429:
            r.raise_for_status()
            return r
        time.sleep(int(r.headers.get("Retry-After") or 2 ** (attempt + 1)))
    r.raise_for_status()


def wait_and_download(snapshot_id, every=30):
    while True:
        r = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                         timeout=60)
        r.raise_for_status()
        status = r.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id} terminé en tant que {status}")
        time.sleep(every)
    while True:  # 202 signifie que le fichier est encore en cours d'assemblage
        r = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                         params={"format": "json"}, timeout=300)
        if r.status_code == 200:
            return r.json()
        r.raise_for_status()
        time.sleep(10)
Les blocs de découverte et de collecte ci-dessous réutilisent post, wait_and_download, API, et HEADERS, donc gardez les 3 blocs dans le même fichier.
Découvrir les URLs de produits par tranche de prix
Ces fonctions divisent une catégorie en tranches de prix et retournent une liste triée d’URLs uniques :
def price_ranges(category_url, edges):
    """Une entrée de découverte par tranche de prix.

    Choisissez des bornes qui gardent chaque tranche sous la limite de pagination.
    """
    sep = "&" if "?" in category_url else "?"
    urls = [f"{category_url}{sep}min_price={lo}&max_price={hi}"
            for lo, hi in zip(edges, edges[1:])]
    return [{"category_url": u, "all_variations": False} for u in urls]


def discover(category_url, edges, per_range=600):
    body = {"input": price_ranges(category_url, edges),
            "limit_per_input": per_range}
    params = {"dataset_id": WALMART_PRODUCTS, "type": "discover_new",
              "discover_by": "category_url", "include_errors": "true"}
    job = post(f"{API}/trigger", params=params, json=body)
    records = wait_and_download(job.json()["snapshot_id"])
    urls = {r["url"].split("?")[0] for r in records if r.get("url")}
    return sorted(urls)
Avec per_range=600, un seul job de découverte sur les 9 tranches de prix de poudre de protéine a retourné 2 069 URLs de produits uniques.
Les enregistrements d’erreur avaient un message error descriptif aux côtés de leur error_code, tel que le statut 410 Gone que Walmart retournait pour les produits supprimés. discover ne garde que les enregistrements avec une url, donc lisez les enregistrements d’erreur depuis le snapshot brut quand vous vérifiez une exécution.
Collecter et valider les enregistrements au niveau du magasin
Collectez ensuite chaque URL avec un code postal, et validez chaque enregistrement avant qu’il n’atteigne votre entrepôt de données. Incluez input, error, et error_code dans la liste de champs, afin que chaque enregistrement garde son entrée et tout détail d’erreur. Ajoutez specifications si vous recalculez les prix unitaires à partir de la taille du paquet :
FIELDS = "|".join([
    "product_id", "product_name", "final_price", "currency", "unit_price",
    "available_for_pickup", "available_for_delivery", "store_id",
    "store_name", "store_location", "seller", "timestamp",
    "input", "error", "error_code",  # gardez l'entrée et les détails d'erreur
])


def collect(urls, zipcode, store_id=None, webhook=None):
    """Démarre un job async pour un code postal. Retourne l'ID de snapshot."""
    params = {"dataset_id": WALMART_PRODUCTS, "include_errors": "true",
              "format": "json", "custom_output_fields": FIELDS}
    if webhook:  # Bright Data POST les enregistrements finis vers cette URL
        params |= {"endpoint": webhook, "uncompressed_webhook": "true",
                   "auth_header": os.environ["WEBHOOK_AUTH_HEADER"]}
    row = {"zipcode": zipcode} | ({"store_id": store_id} if store_id else {})
    body = {"input": [{"url": u, **row} for u in urls]}
    job = post(f"{API}/trigger", params=params, json=body)
    return job.json()["snapshot_id"]


def validate(records, zipcode, store_id=None):
    """Garde les enregistrements tarifés pour le magasin demandé. Route le reste par raison."""
    valid, rejected, seen = [], [], set()
    for rec in records:
        url = rec["input"]["url"]
        if rec.get("error_code"):
            rejected.append((url, rec["error_code"]))
            continue
        where = rec.get("store_location") or ""
        if store_id:  # store_location montre alors le propre code postal du magasin
            matched = bool(where) and str(rec.get("store_id")) == str(store_id)
        else:  # store_location devrait montrer le code postal demandé
            matched = where.endswith(", " + zipcode)
        if not matched:
            rejected.append((url, f"tarifé pour {where or 'aucun magasin'}"))
            continue
        try:
            price = float(rec["final_price"])
        except (KeyError, TypeError, ValueError):
            rejected.append((url, "pas de prix, vérifier la disponibilité"))
            continue
        key = (rec["product_id"], rec["store_id"])
        if key not in seen:
            seen.add(key)
            valid.append(rec | {"final_price": price})
    return valid, rejected


if __name__ == "__main__":
    category = ("https://www.walmart.com/browse/health/protein-powder/"
                "976760_1166769_7458180")
    edges = [0, 15, 25, 35, 42, 50, 62, 75, 100, 100000]
    urls = discover(category, edges, per_range=5)
    print(len(urls), "URLs de produits découvertes")
    records = wait_and_download(collect(urls, zipcode="72712"))
    valid, rejected = validate(records, "72712")
    print(len(valid), "enregistrements valides,", len(rejected), "rejetés")
Une exécution avec 5 produits par tranche et le code postal de Bentonville, 72712, a affiché les nombres ci-dessous. Pendant que les jobs de découverte et de collecte s’exécutent, le script sonde leurs résultats. Vos nombres différeront, car ils dépendent des listings de Walmart le jour où vous exécutez le pipeline :
42 URLs de produits découvertes
41 enregistrements valides, 1 rejeté
Les 41 enregistrements valides étaient tous tarifés pour le magasin 100 à Bentonville. Walmart listait le produit restant sans prix. La liste rejected consigne pourquoi chaque enregistrement a été rejeté.
Avec un code postal seul, store_location montrait le code postal demandé, donc validate confirme chaque enregistrement par rapport à ce code postal. Pour un magasin spécifique, envoyez son store_id avec un code postal où ce magasin est disponible, tel que le propre code postal du magasin. L’enregistrement montrait alors le propre code postal du magasin, donc passez le même store_id à validate, qui compare les IDs de magasin. L’API vérifiait l’appariement, donc le magasin 3520 à Secaucus, envoyé avec le 72712 de Bentonville, a produit un enregistrement d’erreur nommant l’écart.
À l’échelle du catalogue, un seul job avec le code postal 72712 a exécuté les 2 069 URLs découvertes, et validate a vérifié la localisation rapportée de chaque enregistrement.
Exécuter le pipeline en volume
En volume, 4 pratiques rendent le pipeline plus prévisible.
Regroupez les URLs en jobs. Les jobs s’exécutent de manière asynchrone, donc laissez wait_and_download sonder le résultat. Utilisez le déclencheur async pour chaque job. Quand un job nécessite plus de temps, le point de terminaison synchrone retourne un ID de snapshot à sonder, donc démarrer en async garde un seul chemin de code.
Comptez les entrées uniques. L’API dédupliquait les entrées répétées, donc un job de 34 entrées avec 2 répétitions a retourné 32 enregistrements. La même URL envoyée avec 3 codes postaux comptait comme 3 entrées, et chacune était tarifée pour son propre magasin.
Vérifiez les enregistrements d’erreur avant de réessayer. Les enregistrements d’erreur nommaient leur cause, donc retirez les URLs de produits mortes de votre liste et renvoyez le reste.
Livrez vers votre stockage. Appelez collect(urls, zipcode, webhook=URL), et mettez la valeur complète de l’en-tête, tel que Bearer <secret>, dans WEBHOOK_AUTH_HEADER. Bright Data POST les enregistrements finis vers l’URL du webhook avec cette valeur comme en-tête Authorization. Le guide de livraison couvre l’accusé de réception envoyé par votre point de terminaison, les IPs source à autoriser, et des destinations telles qu’Amazon S3, Google Cloud Storage, et Snowflake.
Gardez la validation du magasin dans votre pipeline, afin que chaque enregistrement dans votre entrepôt ait une localisation vérifiée.
Réflexions finales
Scraper Walmart à grande échelle est autant un problème de localisation de magasin qu’un problème d’accès. Chaque prix appartient au magasin pour lequel il a été tarifé, et un statut de succès ne vous dit pas quel était ce magasin. Définissez un code postal ou un ID de magasin sur chaque requête de collecte, et divisez la découverte en tranches de prix qui restent chacune sous la limite de pagination.
Quand vous avez besoin d’un remplissage rétroactif plutôt que de prix de magasin quotidiens, partez d’un jeu de données Walmart. Sinon, exécutez quelques tranches de prix et codes postaux via l’API Walmart Scraper sur le palier gratuit, puis montez en échelle une fois que la validation du magasin passe.
FAQ
Comment scraper les prix Walmart par code postal ?
Envoyez un code postal avec chaque URL de produit au lieu de dépendre de l’IP de sortie, que Walmart utilise autrement pour choisir un magasin. Un code postal peut se résoudre à un magasin dans un autre état, donc ajoutez un ID de magasin quand vous avez besoin d’un magasin spécifique. L’API Walmart Scraper de Bright Data accepte les deux et rapporte le magasin pour chaque enregistrement.
Walmart a-t-il une API publique ?
Quand j’ai vérifié, les APIs de Walmart étaient pour les partenaires. L’API Affiliate Marketing retournait le prix et la disponibilité par code postal pour les apps qui gagnent des frais de référence. Les recherches de magasin nécessitaient une approbation supplémentaire. Les APIs Marketplace couvraient seulement les propres catalogues des vendeurs, donc les trackers de prix au niveau du magasin collectent les pages produit publiques.
Peut-on Scraper les avis Walmart ?
Oui. Sur une page produit de lait, la pagination des avis de Walmart montrait 10 avis par page et s’arrêtait à 10 000 sous le tri par défaut. La page 1001 retournait à nouveau la page 1, donc arrêtez-vous au nombre de pages rapporté par Walmart. Le scraper d’avis Walmart de Bright Data collecte les avis écrits et accepte une entrée sort_by pour l’ordre des avis.
Existe-t-il un jeu de données de produits Walmart ?
Oui. Bright Data propose des jeux de données Walmart prêts à l’emploi pour les produits, avis et vendeurs selon un calendrier de rafraîchissement que vous choisissez. Ils conviennent aux remplissages rétroactifs et à l’analyse à l’échelle du catalogue. Pour des prix quotidiens au niveau du magasin, collectez des enregistrements actuels pour un code postal ou un ID de magasin avec l’API Walmart Scraper.