Google a fermé son API JSON Custom Search aux nouveaux clients, l’accès des clients existants prenant fin le 1er janvier 2027. Existe-t-il donc encore une API de recherche Google à laquelle s’inscrire ? Pas pour des résultats full-web, car les options publiques de Google recherchent des sites choisis ou renvoient des réponses Gemini basées sur Google Search. L’API SERP de Bright Data renvoie des résultats Google full-web au format JSON.
Custom Search JSON API renvoie un 403 aux nouveaux projets. Les requêtes HTTP directes vers google.com ont échoué silencieusement lors des tests, avec un statut 200 et 0 résultat.
Ce guide compare les options de Google, explique pourquoi les requêtes directes échouent, et montre comment migrer.
En bref
- Google ne vend aucune API de recherche full-web en libre-service aux nouveaux développeurs. La date de fin de Custom Search JSON API est le 1er janvier 2027.
- Grounding with Google Search renvoie des réponses Gemini, pas des listes de résultats. Ses conditions interdisent la mise en cache ou l’analyse des résultats, ou l’indexation de leurs liens.
- Les requêtes HTTP directes vers Google Search n’ont donné aucun résultat lors des tests. Les navigateurs sur la même connexion ont ensuite reçu un CAPTCHA.
- L’API SERP de Bright Data renvoie la page de résultats de Google en JSON. 5K requêtes par mois sont gratuites, puis 1,50 $ pour 1 000 requêtes réussies. Un adaptateur plug-and-play convertit les appels
cse.list().
Quel remplacement de Custom Search API convient à votre code
Trouvez ce dont votre code a besoin :
| Si votre code a besoin de | Utilisez |
|---|---|
| Résultats de recherche Google pour l’ensemble du web | API SERP Bright Data |
| Recherche limitée à une liste fixe de sites | API SERP Bright Data avec des filtres site:, ou Agent Search, de Google |
Conserver les paramètres cse.list() existants |
L’adaptateur à l’étape 3 |
| Résultats Google Images | L’adaptateur à l’étape 3 avec searchType="image" |
| Un outil de recherche MCP (Model Context Protocol), LangChain ou n8n | Bright Data Web MCP, un outil LangChain, ou le nœud n8n |
| Une réponse Gemini affichée à l’utilisateur qui a posé la question | Grounding with Google Search |
| Une correction pour un message d’erreur | Le tableau de dépannage |
Ce qu’il est advenu de l’API Google Custom Search JSON
Google a annoncé la fermeture le 20 janvier 2026. Son aperçu de Custom Search JSON API marque l’API comme « fermée aux nouveaux clients » et donne aux clients existants jusqu’au 1er janvier 2027.
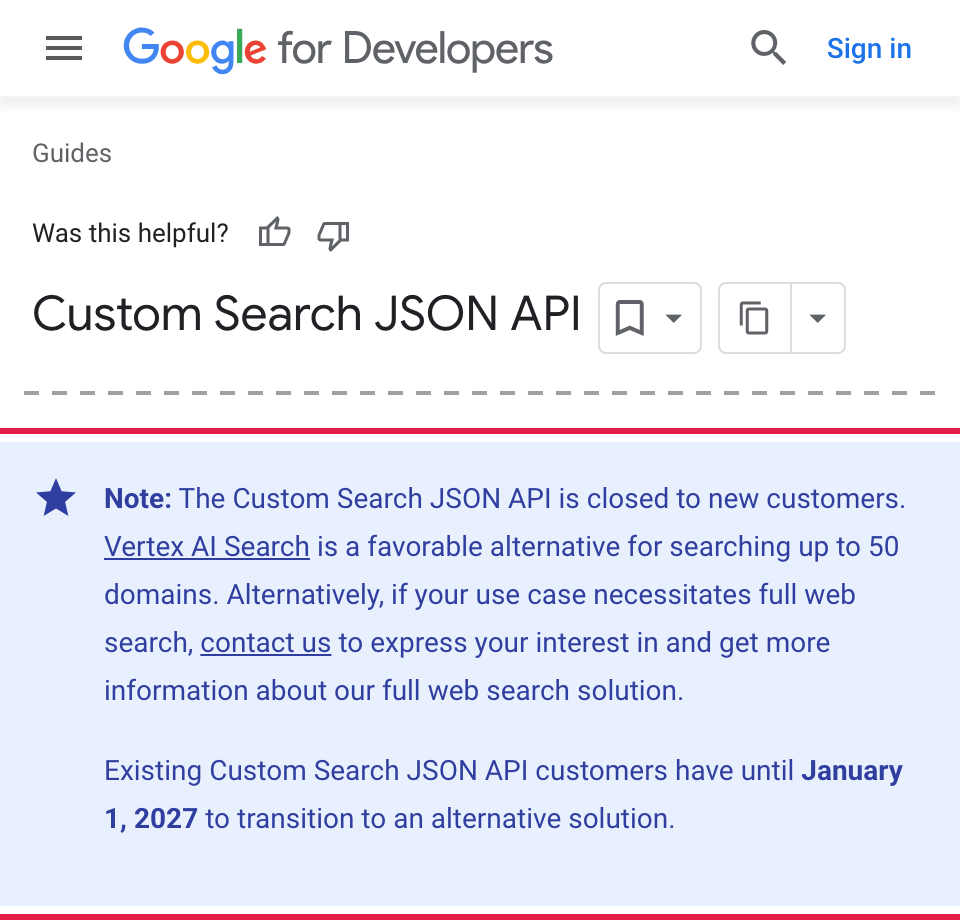
Les nouveaux projets reçoivent déjà un 403 de Custom Search JSON API, même avant l’échéance de 2027. Voici la réponse, raccourcie à ses champs principaux.
{
  "error": {
    "code": 403,
    "message": "This project does not have the access to Custom Search JSON API.",
    "status": "PERMISSION_DENIED"
  }
}
Sur le forum des développeurs de Google, un développeur signale ce 403 sur un projet existant après un changement de facturation.
Le tableau met les limites documentées de Google à côté de l’API SERP Bright Data :
| Custom Search JSON API | API SERP Bright Data | |
|---|---|---|
| Utilisation gratuite | 100 requêtes par jour, environ 3K par mois | 5K requêtes par mois, sans carte de crédit |
| Utilisation payante | 5 $ pour 1 000 requêtes, jusqu’à 10K par jour | 1,50 $ pour 1 000 requêtes réussies, concurrence illimitée |
| Résultats par requête | Jusqu’à 10 | Une page de résultats Google complète |
| Résultats par requête de recherche | Jusqu’à 100 | Paginer avec start, ou obtenir les positions 1 à 100 en un seul appel |
| Localisation | gl favorise les résultats d’un pays |
Résultats tels que vus par un utilisateur dans le pays que vous définissez |
| Ce que renvoie l’API | Résultats d’un moteur de recherche programmable, qui recherche un sous-ensemble de l’index de Google | La page de résultats de Google, y compris les publicités et People Also Ask lorsque Google les affiche. Un paramètre supplémentaire ajoute l’AI Overview |
La migration est plus facile qu’il n’y paraît, car les résultats de Custom Search différaient déjà des résultats de google.com. La page d’aide de Google indique qu’un moteur full-web ne recherche qu’« un sous-ensemble du corpus total de Google Web Search » et exclut les résultats en temps réel. Vous n’avez donc pas besoin de reproduire exactement les anciens résultats. Vérifiez les nouveaux résultats par rapport à google.com, et utilisez les résultats Custom Search sauvegardés pour trouver des bugs dans votre migration.
Les propres alternatives à Custom Search API de Google
Google oriente les utilisateurs de Custom Search vers Agent Search et un formulaire d’intérêt full-web. Grounding with Google Search, une fonctionnalité de l’API Gemini, apparaît aussi lorsque vous recherchez un remplacement :
| Produit et portée | Ce qu’il renvoie | Prix catalogue |
|---|---|---|
| Agent Search (aussi appelé Vertex AI Search), pour jusqu’à 50 domaines | Résultats et réponses de ces sites | 4 $ pour 1 000 requêtes de recherche de site web |
| Grounding with Google Search (API Gemini), pour Google Search | Une réponse Gemini avec des liens | 14 $ pour 1 000 requêtes de recherche |
| Solution de recherche full-web, pour l’index complet de Google | Non documenté publiquement | Formulaire d’intérêt uniquement |
Si votre moteur recherchait une liste fixe de sites, vous avez 2 options. L’API SERP Bright Data accepte la même liste sous forme de filtres site:, et Agent Search prend en charge jusqu’à 50 domaines.
Grounding est le produit le plus proche de la recherche web, mais ses conditions limitent ce que vous pouvez construire. Les conditions de l’API Gemini exigent que vous affichiez les résultats ancrés à l’utilisateur qui a posé la question. Elles vous interdisent de « mettre en cache, encadrer, syndiquer, revendre, analyser, entraîner sur, ou apprendre d’une autre manière » de ces résultats ou d’indexer leurs liens.
Microsoft a également retiré ses API Bing Search en août 2025. Nos guides sur les alternatives à l’API Bing Search et les meilleures API SERP comparent les autres fournisseurs.
Aucun des produits en libre-service de Google ne donne aux nouveaux clients des résultats de recherche full-web. L’API SERP Bright Data le fait.
Pourquoi les requêtes directes vers Google Search échouent
Avec la fermeture de Custom Search, la solution de repli évidente est de demander directement la page de résultats Google. Google Search exige JavaScript depuis janvier 2025. Lors de tests effectués depuis 1 connexion haut débit domestique, 10 requêtes provenant de clients HTTP puis plusieurs vrais navigateurs n’ont obtenu aucun résultat de recherche :
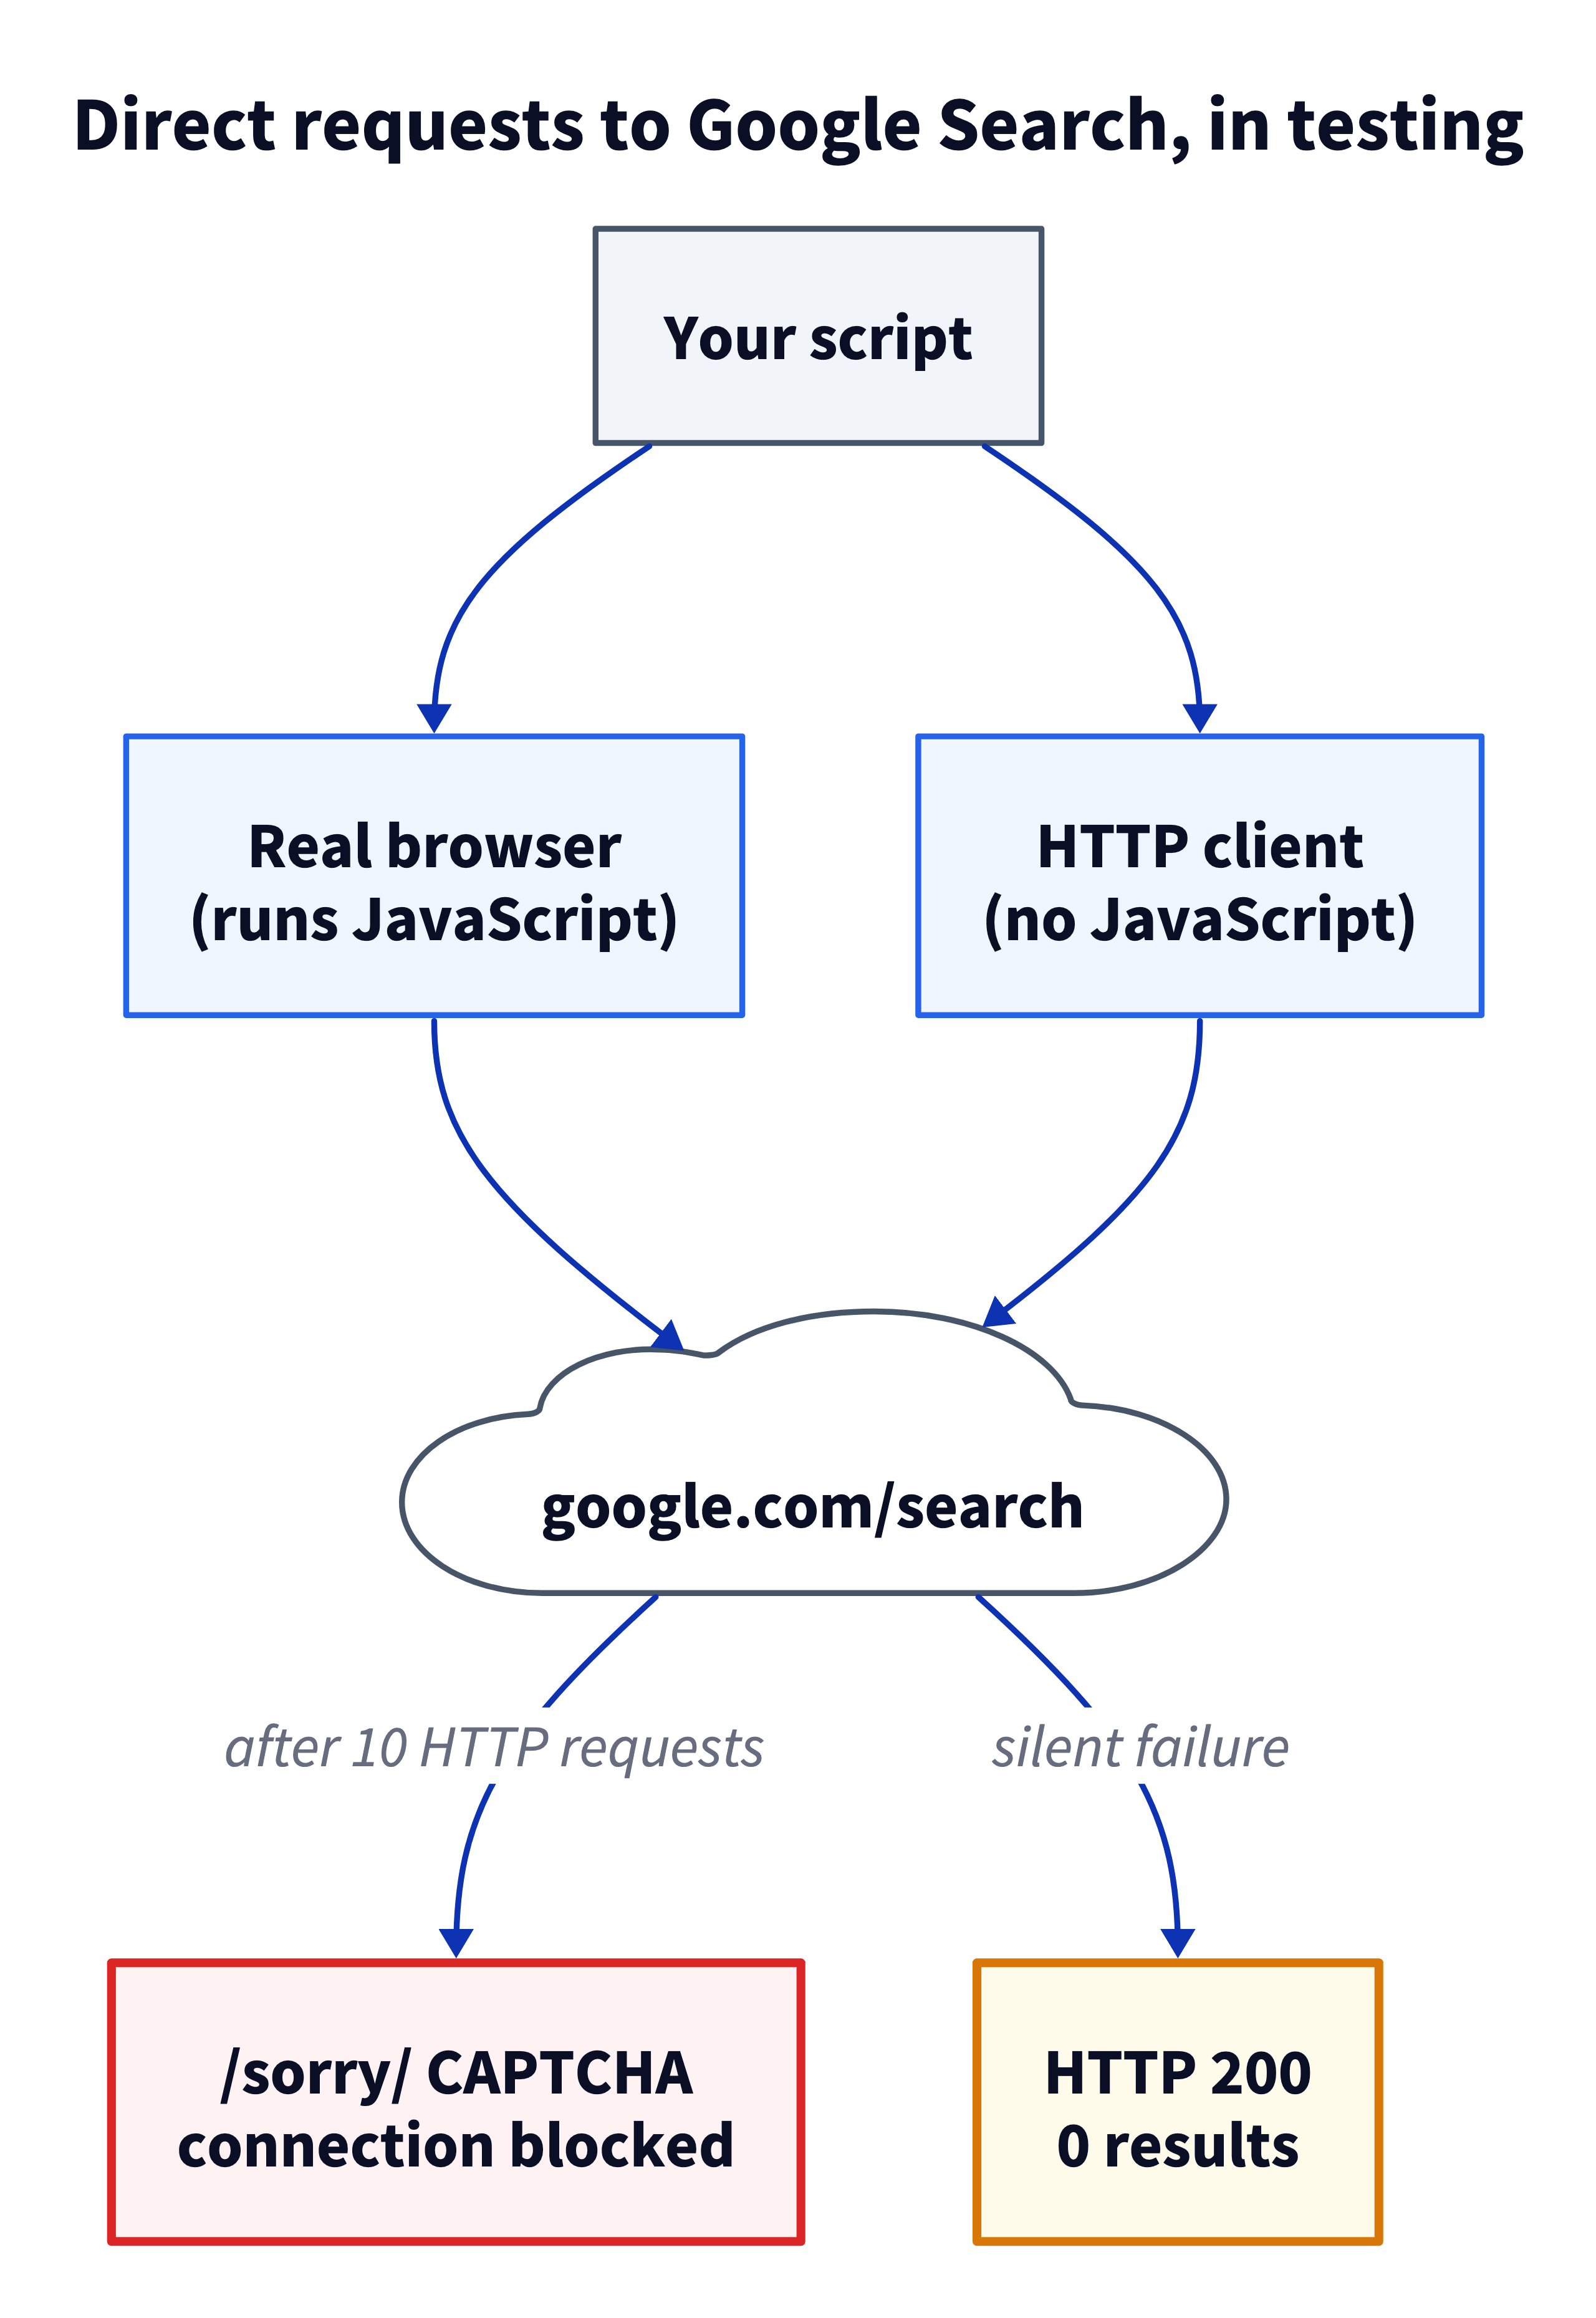
Les clients HTTP échouent de la manière la plus difficile à détecter. Les 10 requêtes provenaient de 5 configurations courantes de clients HTTP, y compris curl et Python httpx. Les 10 ont obtenu le statut 200 et aucun résultat, de sorte qu’un scraper qui ne vérifie que les codes de statut enregistre un succès et ne stocke rien. La page ne contenait qu’un script qui doit s’exécuter dans un moteur JavaScript avant que n’apparaisse aucun résultat.
Vérifiez chaque réponse pour des résultats, pas seulement le code de statut.
Chaque navigateur testé, y compris Chromium et Chrome en mode headless, a exécuté le JavaScript mais a obtenu la page CAPTCHA /sorry/ de Google dès sa première requête. Ils se sont exécutés après ces 10 requêtes HTTP, et le blocage s’appliquait à toute la connexion pendant 40 minutes ou plus.
À volume de production, vous devriez exécuter le JavaScript de Google pour chaque recherche et maintenir des parseurs pour un balisage changeant. L’API SERP de Bright Data gère les navigateurs et les parseurs pour vous et renvoie des résultats analysés.
Comment migrer le code Custom Search JSON API vers l’API SERP de Bright Data
Vous envoyez une URL de recherche Google normale, et la réponse est cette page au format JSON. Les étapes 1 à 3 constituent la migration principale.
Étape 1 : Configurer et envoyer une première requête
Vous avez besoin d’un compte Bright Data gratuit, d’une clé API, et d’une zone API SERP. Une zone est un ensemble nommé de paramètres que vos requêtes utilisent. Si votre équipe de sécurité examine d’abord les nouveaux fournisseurs, envoyez-lui le lien du Trust Center de Bright Data. Cette page répertorie les rapports SOC 2 et SOC 3, les certificats ISO 27701, et la documentation sur la conformité RGPD.
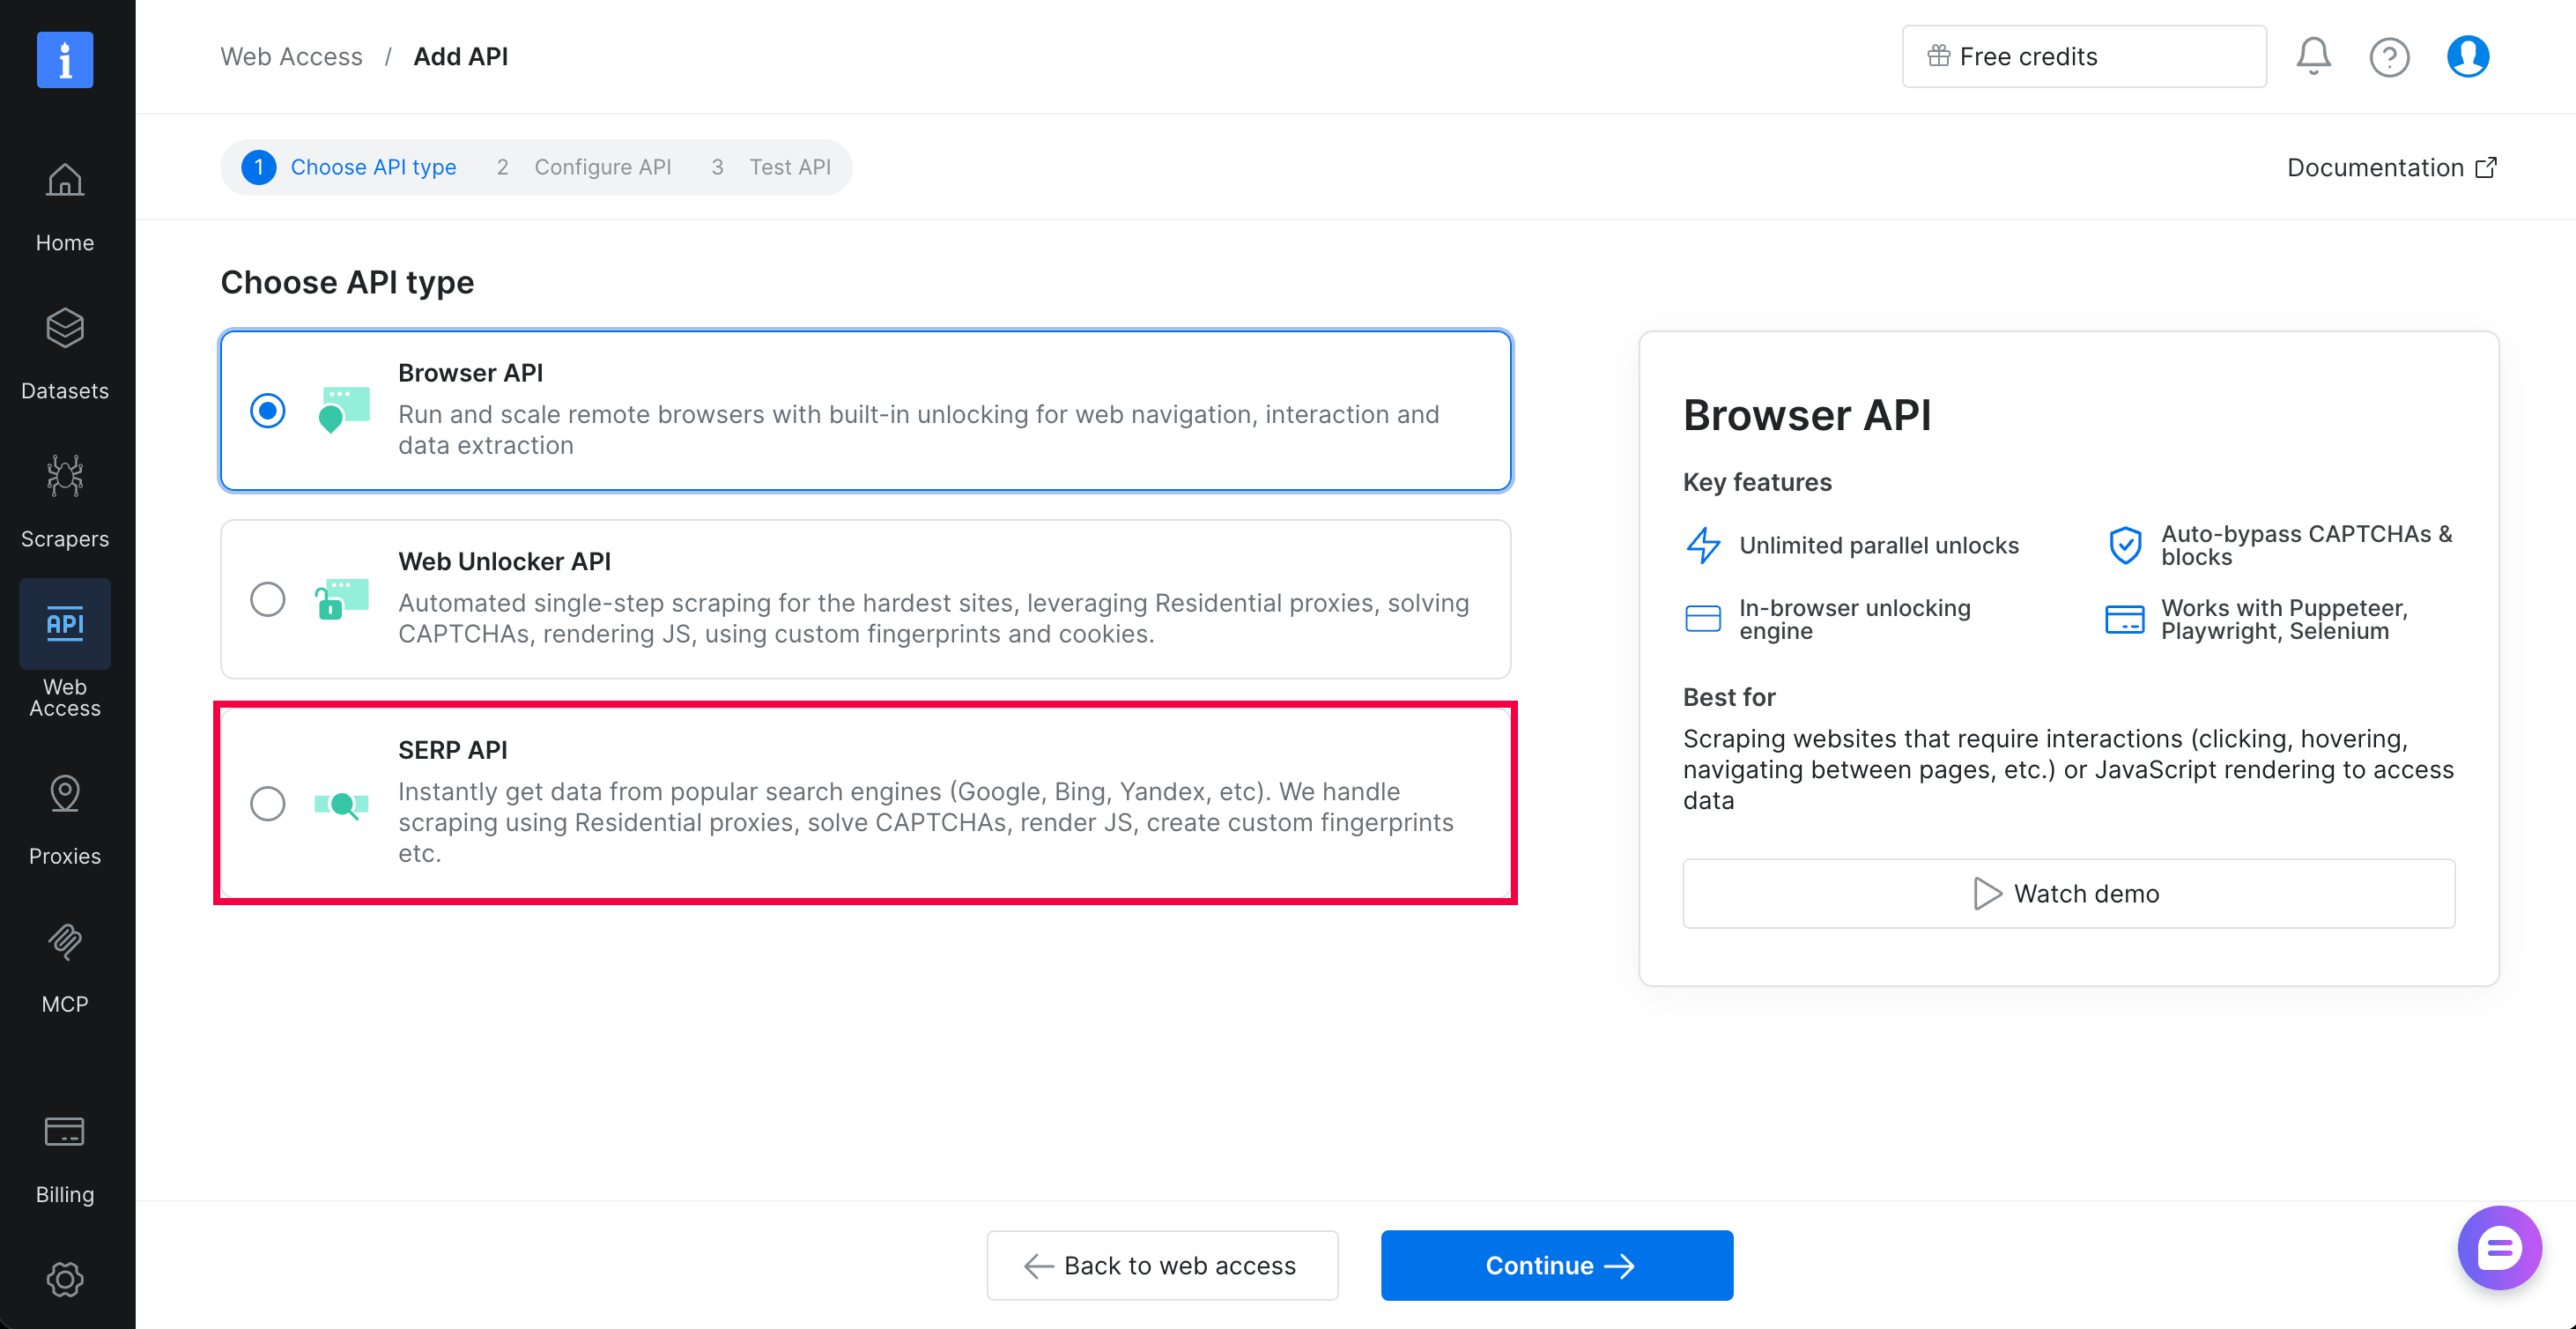
Dans le panneau de contrôle, une zone est appelée une API. Ouvrez Web Access, sélectionnez Create API, choisissez SERP API, et sélectionnez Continue :
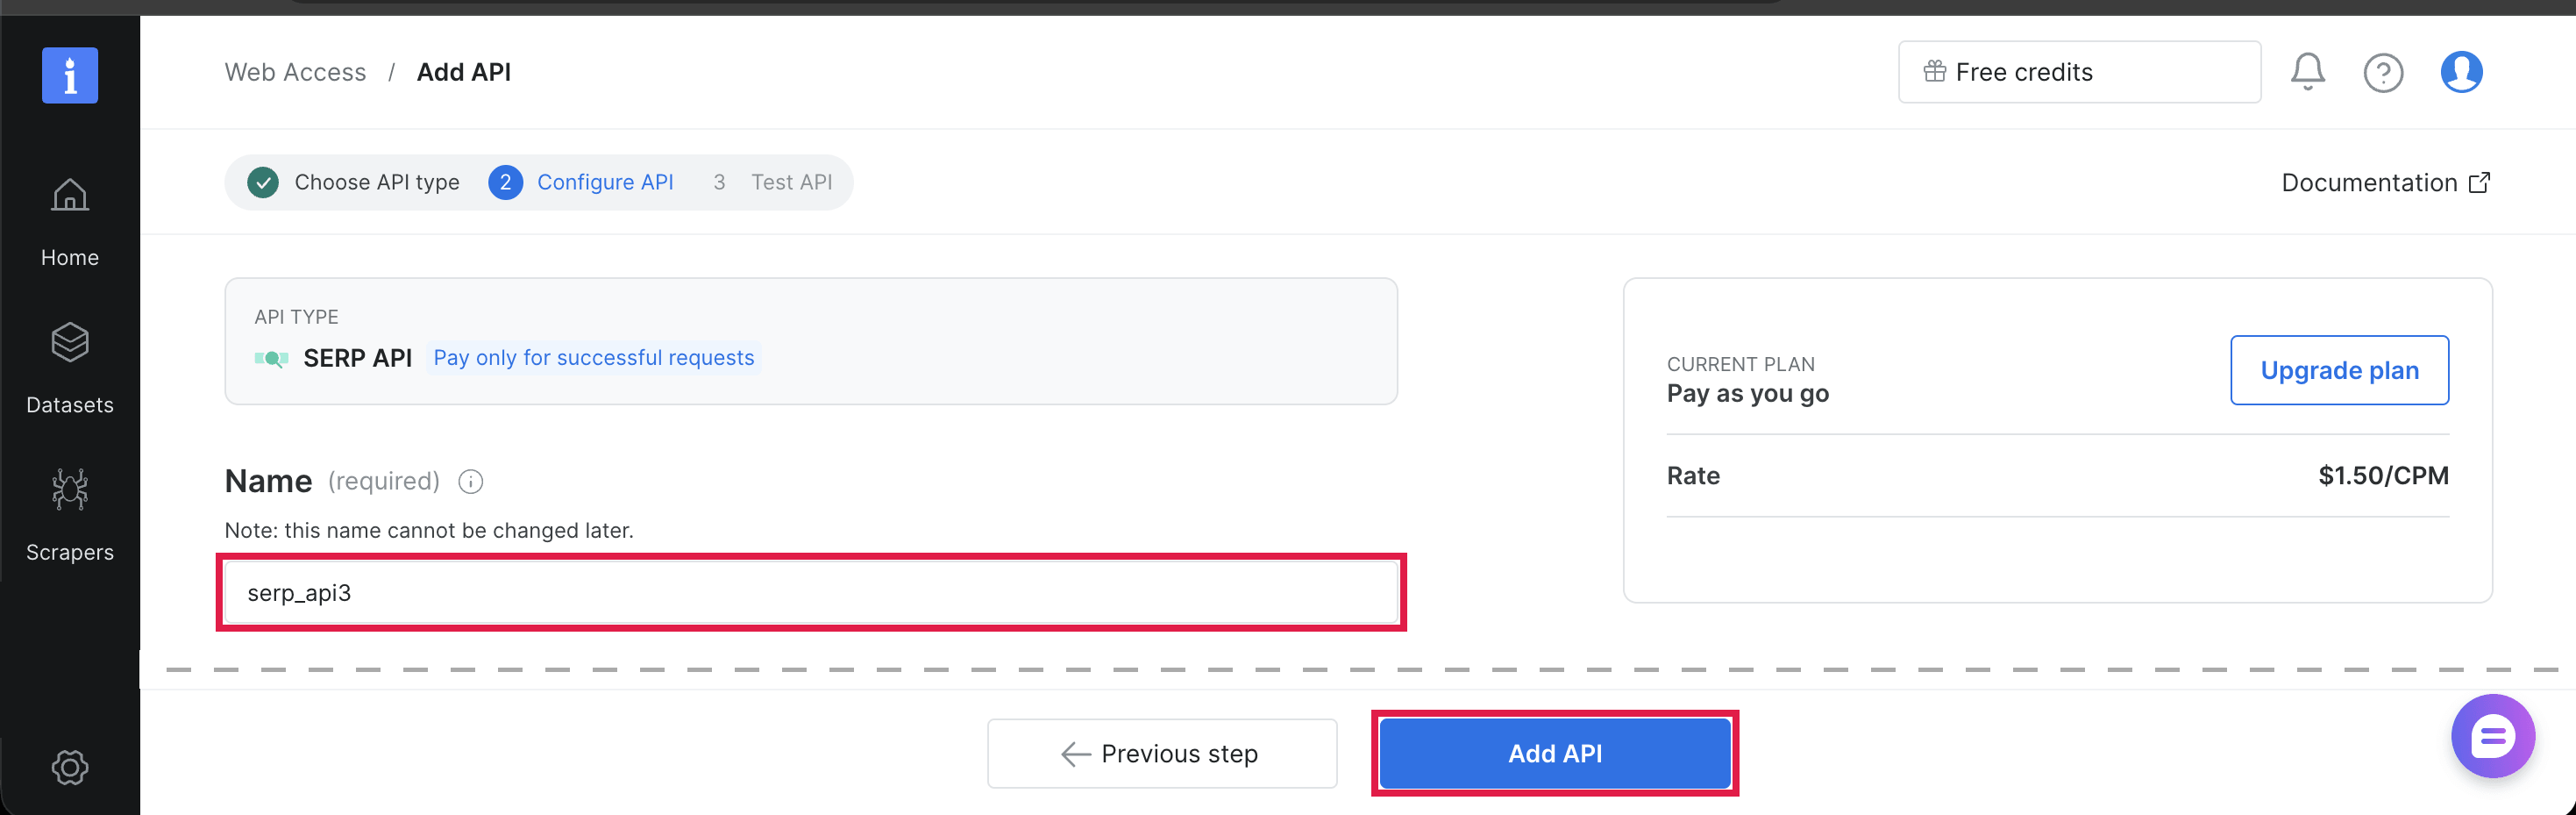
Donnez un nom à l’API, assurez-vous que le format de données est Raw HTML, et sélectionnez Add API. Le JSON provient d’un paramètre dans chaque requête, et non de ce réglage. Le nom d’API que vous avez choisi est le nom de votre zone, que vous définissez dans BRIGHTDATA_SERP_ZONE ci-dessous :
La clé API se trouve dans la barre Quick start en bas de la page Home :
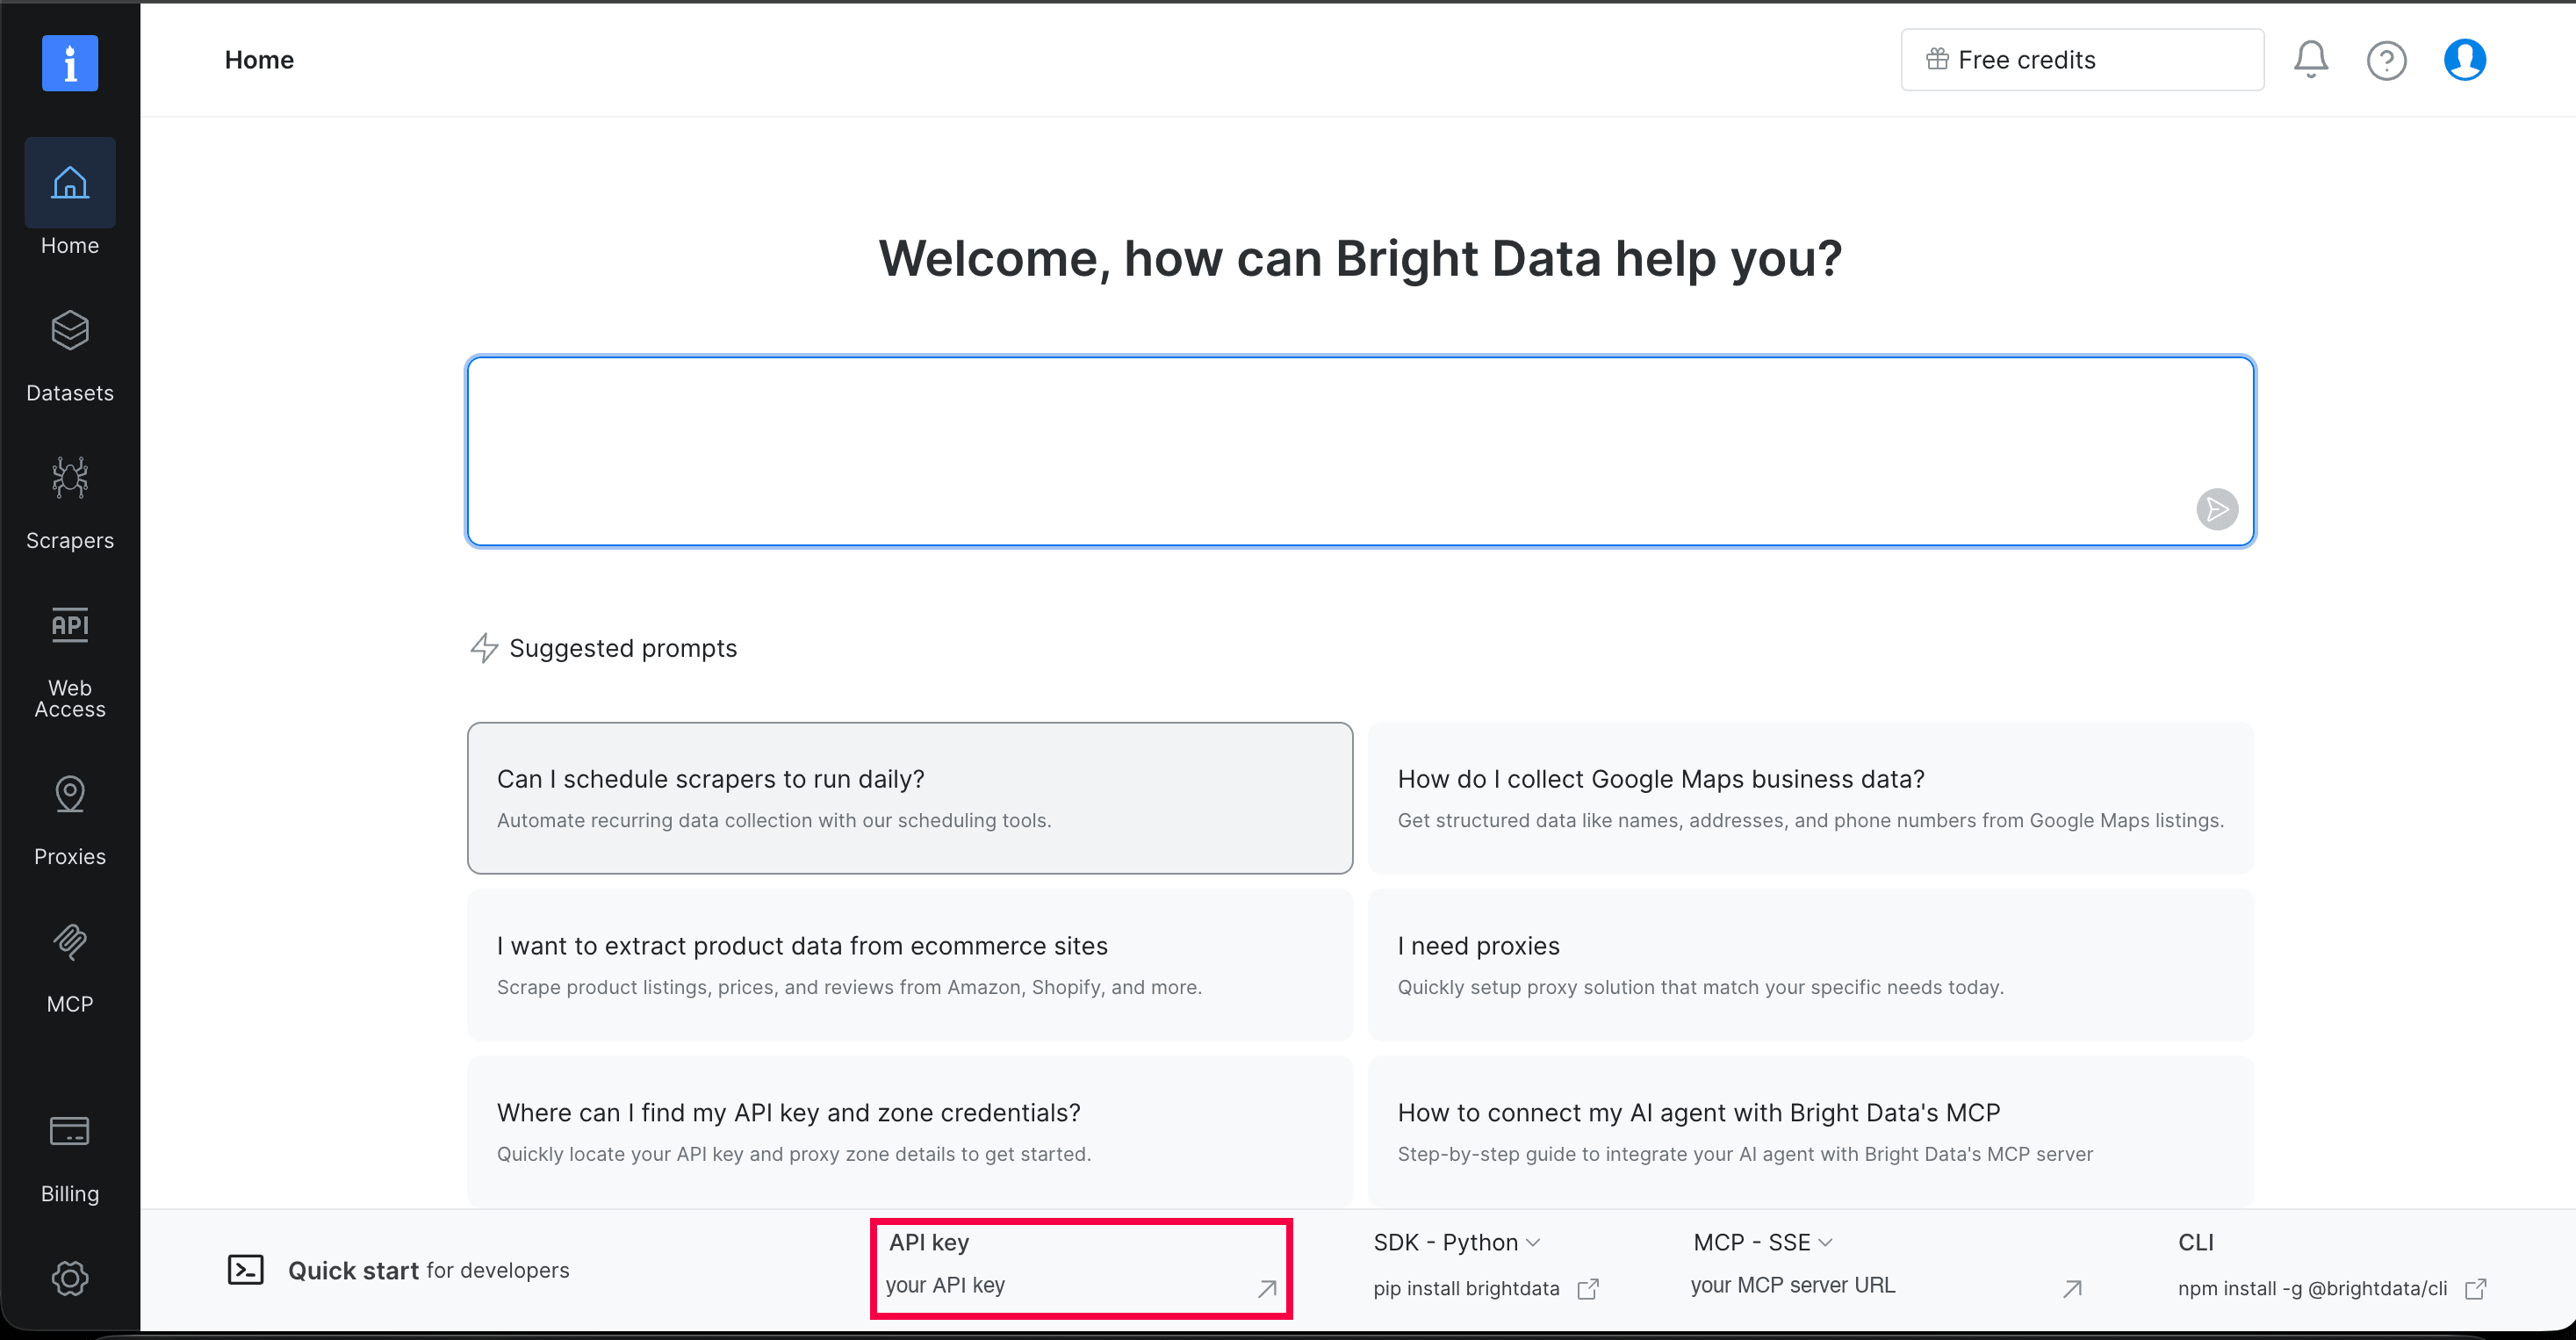
Créez un environnement virtuel, définissez la clé et le nom de zone, et installez l’unique dépendance Python. Remplacez les deux valeurs par votre propre clé et nom de zone :
python3 -m venv .venv && source .venv/bin/activate
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_SERP_ZONE="serp_api1"
python -m pip install "httpx>=0.27,<1"
Sur Windows PowerShell, utilisez plutôt ce bloc :
python -m venv .venv; .venv\Scripts\Activate.ps1
$env:BRIGHTDATA_API_KEY = "your-api-key"
$env:BRIGHTDATA_SERP_ZONE = "serp_api1"
python -m pip install "httpx>=0.27,<1"
Avec uv, ignorez l’environnement virtuel et démarrez chaque script avec uv run --with "httpx>=0.27,<1" python, suivi du nom du script.
Un seul POST vers le point de terminaison /request de Bright Data récupère une URL Google via votre zone et renvoie une page de résultats. Cette commande curl envoie cette requête et affiche la réponse de manière formatée :
curl https://api.brightdata.com/request \
  -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
  -H "Content-Type: application/json" \
  --data @- <<EOF | python -m json.tool
{
  "zone": "$BRIGHTDATA_SERP_ZONE",
  "url": "https://www.google.com/search?q=is+there+a+google+search+api&gl=us&hl=en&brd_json=1",
  "format": "raw"
}
EOF
Le paramètre brd_json=1 convertit la page en JSON analysé, et "format": "raw" renvoie ce JSON tel quel. La réponse ci-dessous est raccourcie :
{
  "general": {
    "search_engine": "google",
    "query": "is there a google search api",
    "language": "en",
    "country_code": "US"
  },
  "organic": [
    {
      "link": "https://developers.google.com/custom-search/v1/overview",
      "title": "Custom Search JSON API | Google for Developers",
      "description": "The Custom Search JSON API lets you develop websites and applications to retrieve and display search results from Programmable Search Engine ...",
      "rank": 1
    }
  ],
  "pagination": {
    "current_page": 1,
    "next_page": 2,
    "next_page_start": 10
  }
}
Cette même réponse contenait aussi 8 recherches associées et 4 questions People Also Ask. La réponse de Custom Search n’a de champs pour ni l’un ni l’autre.
Étape 2 : Associer les paramètres de Custom Search aux paramètres de Google
La référence des paramètres de requête Google de Bright Data et sa liste de paramètres et opérateurs d’URL de recherche Google expliquent les paramètres de Google en détail. Les champs de réponse se trouvent dans items[] pour Custom Search et dans organic[] dans la réponse de l’API SERP :
| Custom Search JSON API | Google, via l’API SERP |
|---|---|
q |
q |
num (maximum 10) |
Supprimé par Google. L’adaptateur demande plus de pages |
start (compte à partir de 1) |
start (compte à partir de 0, par pas de 10) |
gl (favorise les résultats d’un pays) |
gl (exécute la recherche comme un utilisateur dans ce pays) |
hl (langue de l’interface) |
hl |
siteSearch=a.com |
site:a.com ajouté à q |
siteSearchFilter=e |
-site:a.com ajouté à q |
exactTerms=a b |
"a b" ajouté à q |
excludeTerms=a |
-"a" ajouté à q |
fileType=pdf |
filetype:pdf ajouté à q |
dateRestrict=d7 |
tbs=qdr:d7, et de même pour w, m, et y |
safe=active |
safe=active |
searchType=image |
udm=2 (Google Images) |
title, link |
title, link |
snippet |
description |
displayLink |
Nom d’hôte de link |
queries.nextPage |
Calculé par l’adaptateur |
Sur Google, 3 paramètres fonctionnent différemment :
Google compte les décalages à partir de 0. Custom Search traite start=11 comme le haut de la page 2, et Google traite start=10 comme la page 2. Envoyez start par pas de 10 et écartez les résultats avant votre position de départ dans le code, comme le fait l’adaptateur.
Google a supprimé num. La documentation de l’API SERP indique que Google a déprécié num le 11 septembre 2025. Chaque page Google contient environ 10 résultats, et l’adaptateur demande autant de pages que num en nécessite. Pour plus de résultats par requête, Bright Data peut renvoyer le top 100 des résultats Google, positions 1 à 100, en un seul appel.
Sur Google, gl définit le pays de recherche. La requête « cloud hosting pricing » a renvoyé des premiers résultats britanniques, allemands et indiens qui ne partageaient aucune URL avec les premiers résultats américains. Définissez gl sur chaque requête selon le pays depuis lequel vos utilisateurs recherchent.
Étape 3 : Ajouter un adaptateur plug-and-play pour cse.list()
L’adaptateur envoie les appels cse.list() à l’API SERP de Bright Data et fonctionne sur Python 3.9 et versions ultérieures. Il accepte les paramètres de Custom Search du tableau et conserve les champs title, link, snippet, et displayLink dans items. Il ignore cx avec un avertissement, car la recherche Google n’a pas d’ID de moteur, et il ajoute des paramètres attempts et timeout.
À chaque point d’appel, le changement ressemble à ceci :
# Avant, avec le client API Google
res = service.cse().list(q=query, cx=CX, num=10).execute()

# Après, avec les mêmes champs items principaux, sans ID de moteur, et gl et hl définis
from cse_to_serp import cse_list

res = cse_list(q=query, num=10, gl="us", hl="en")
Vérifiez 3 autres choses à chaque point d’appel :
- Si votre moteur recherchait une liste fixe de sites, placez-les dans la requête sous la forme
(site:a.com OR site:b.com). Une requête restreinte à 2 sites de documentation de cette manière a renvoyé 10 résultats, tous provenant de ces 2 hôtes. - Dans un gestionnaire de requête web, passez
attempts=1et untimeoutadapté au budget de temps du gestionnaire. - Là où vous captiez
HttpError, captez plutôt(httpx.HTTPError, ValueError, RuntimeError).
Enregistrez l’adaptateur sous cse_to_serp.py, ou clonez le dépôt d’accompagnement sur GitHub, qui contient aussi les autres scripts ci-dessous et des tests hors ligne. Voici le fichier complet :
"""Replace Google Custom Search JSON API calls with the Bright Data SERP API.

Same cse.list() parameters and core items fields.
"""

import math
import os
import time
import warnings
from urllib.parse import urlencode, urlparse

import httpx

API_URL = "https://api.brightdata.com/request"
API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
if not API_KEY:
    raise RuntimeError("Set the BRIGHTDATA_API_KEY environment variable "
                       "to your Bright Data API key (step 1).")
ZONE = os.environ.get("BRIGHTDATA_SERP_ZONE", "serp_api1")
RETRY_STATUSES = {429, 500, 502, 503, 504}


def fetch_serp(params: dict, attempts: int = 4, timeout: float = 60) -> dict:
    """Fetch one Google results page as parsed JSON."""
    url = "https://www.google.com/search?" + urlencode(params)
    body = {"zone": ZONE, "url": url, "format": "raw"}
    headers = {"Authorization": f"Bearer {API_KEY}"}
    for attempt in range(attempts):
        try:
            resp = httpx.post(API_URL, json=body, headers=headers,
                              timeout=timeout)
        except httpx.TransportError:  # timeout or dropped connection
            if attempt == attempts - 1:
                raise
            time.sleep(16 + attempt * 10)
            continue
        error = (resp.headers.get("x-brd-error")  # API-level errors
                 or resp.headers.get("x-brd-err-msg"))  # proxy-level errors
        if resp.status_code == 200 and not error:
            page = resp.json()
            if "general" not in page:  # not a parsed results page
                raise ValueError("Unexpected response: " + resp.text[:200])
            return page
        if not error and resp.status_code not in RETRY_STATUSES:
            break  # wrong key, zone, or URL, so retrying will not help
        if attempt < attempts - 1:
            # Back off before resending the same query.
            time.sleep(16 + attempt * 10)
    resp.raise_for_status()
    code = (resp.headers.get("x-brd-error-code")  # maps to the error catalog
            or resp.headers.get("x-brd-err-code"))
    raise RuntimeError(f"SERP API error {code}: {error or resp.status_code}")


def cse_list(q, num=10, start=1, gl=None, hl=None, siteSearch=None,
             siteSearchFilter="i", exactTerms=None, excludeTerms=None,
             fileType=None, dateRestrict=None, safe="off", searchType=None,
             attempts=4, timeout=60, **extra):
    """Accept cse.list() parameters, return a dict in cse.list() format."""
    if extra.pop("cx", None):  # no engine ID, so every call searches Google
        warnings.warn("cx is ignored. Add (site:a.com OR site:b.com) to q "
                      "if your engine searched a fixed list of sites")
    if extra:  # fail loudly instead of ignoring a filter
        raise TypeError(f"No mapping for: {sorted(extra)}")
    if exactTerms:  # Custom Search filters become Google search operators
        q = f'{q} "{exactTerms}"'
    if excludeTerms:
        q = f'{q} -"{excludeTerms}"'
    if fileType:
        q = f"{q} filetype:{fileType}"
    if siteSearch:
        exclude = "-" if siteSearchFilter == "e" else ""
        q = f"{q} {exclude}site:{siteSearch}"
    params = {"q": q, "brd_json": 1}  # brd_json=1 returns parsed JSON
    if gl:
        params["gl"] = gl
    if hl:
        params["hl"] = hl
    if safe == "active":
        params["safe"] = "active"
    if dateRestrict:  # "d7" -> qdr:d7 (past 7 days), "m6" -> qdr:m6
        params["tbs"] = "qdr:" + dateRestrict
    if searchType == "image":
        return image_list(params, num, start, attempts, timeout)
    if searchType:
        raise ValueError(f"No mapping for: searchType={searchType}")

    # Custom Search counts from 1 (start=11 is page 2), Google from 0
    # (start=10 is page 2). Track each result's Google position.
    first = start - 1
    offset = first // 10 * 10  # the Google page that contains `start`
    items, next_start = [], None
    # Fetch the pages for positions first to first + num - 1, 1 request each
    for _ in range(math.ceil((num + first - offset) / 10)):
        params["start"] = offset
        page = fetch_serp(params, attempts, timeout)
        for i, result in enumerate(page.get("organic", [])):
            position = offset + i
            if position < first or not result.get("link"):
                continue
            if len(items) == num:
                next_start = position + 1  # convert to 1-based
                break
            items.append({
                "title": result.get("title", ""),
                "link": result["link"],
                "snippet": result.get("description", ""),
                "displayLink": urlparse(result["link"]).netloc,
            })
        if next_start:
            break
        offset = (page.get("pagination") or {}).get("next_page_start")
        if not offset:  # Google has no further pages for this query
            break
    else:
        next_start = offset + 1  # continue at the next Google page

    response = {"items": items, "queries": {}}
    if next_start:
        response["queries"]["nextPage"] = [{"startIndex": next_start}]
    return response


def image_list(params, num, start, attempts, timeout):
    """Google Images returns the whole image grid in one request."""
    params["udm"] = 2
    page = fetch_serp(params, attempts, timeout)
    images = [i for i in page.get("images") or [] if i.get("original_image")]
    items = [{
        "title": image.get("image_alt", ""),
        "link": image["original_image"],
        "snippet": image.get("image_alt", ""),
        "displayLink": urlparse(image["original_image"]).netloc,
    } for image in images[start - 1:start - 1 + num]]
    response = {"items": items, "queries": {}}
    if start - 1 + num < len(images):
        response["queries"]["nextPage"] = [{"startIndex": start + num}]
    return response


if __name__ == "__main__":
    res = cse_list("httpx timeout configuration", num=10,
                   gl="us", hl="en")
    for i, item in enumerate(res["items"], start=1):
        print(i, item["displayLink"], "|", item["title"][:60])
L’exécution de python cse_to_serp.py a affiché ceci comme ses 5 premiers résultats. Les résultats proviennent de la page en direct de Google, donc les vôtres peuvent différer.
1 www.python-httpx.org | Timeouts
2 github.com | Proposal: Add a Global Timeout Setting in httpx #3356
3 www.python-httpx.org | QuickStart
4 stackoverflow.com | python - Httpx requests timing out when it shouldn't
5 oneuptime.com | How to Use httpx for Async HTTP Requests
Avec num=10, chaque appel nextPage récupère une seule page Google, ce qui coûte 1 requête.
Avec searchType="image", 1 requête pour « ergonomic office chair » a renvoyé 100 images, tandis que Custom Search renvoyait au maximum 10 par requête. Chaque appel de l’adaptateur récupère la grille d’images complète et en renvoie num images.
Remplacer l’outil de recherche dans les agents MCP, LangChain et n8n
Les agents qui se connectent aux outils via MCP n’ont besoin d’aucun adaptateur. Le serveur Bright Data Web MCP expose la recherche Google comme son outil search_engine, et le serveur hébergé est une seule URL avec un niveau gratuit. Dans Claude Code, vous l’ajoutez avec une seule commande :
claude mcp add --transport http brightdata https://mcp.brightdata.com/mcpLes clients MCP prenant en charge OAuth, comme Claude Code et Cursor, se connectent via votre navigateur, sans clé API dans un fichier de configuration. Pour les tâches CI et les scripts, utilisez plutôt https://mcp.brightdata.com/mcp?token=YOUR_API_KEY. Ajoutez &tools=search_engine,scrape_as_markdown à cette URL pour donner à l’agent la recherche plus un outil qui lit chaque page de résultats en Markdown.
Les agents de codage peuvent aussi utiliser le CLI de Bright Data. Installez-le avec npm install -g @brightdata/cli, puis exécutez brightdata login pour vous connecter via votre navigateur. L’agent obtient une commande brightdata search.
Pour le code qui appelle déjà LangChain, la méthode GoogleSearchAPIWrapper.results() renvoie des dicts avec title, link, et snippet. Les éléments de l’adaptateur ont les mêmes clés. Installez le package de base de LangChain, qui nécessite Python 3.10 ou ultérieur, avec python -m pip install "langchain-core>=1.0,<2". Enregistrez ce fichier sous langchain_tool.py à côté de l’adaptateur cse_to_serp.py, et passez google_search dans la liste d’outils de votre agent.
"""LangChain tool that replaces GoogleSearchAPIWrapper.results()."""

from langchain_core.tools import ToolException, tool

from cse_to_serp import cse_list


@tool
def google_search(query: str) -> list[dict]:
    """Search Google and return the top results with title, link, snippet."""
    try:  # 2 attempts and a 20 s timeout limit each search
        return cse_list(q=query, num=10, gl="us", hl="en",
                        attempts=2, timeout=20)["items"]
    except Exception as exc:
        raise ToolException(f"Google search failed: {exc}") from exc


google_search.handle_tool_error = True  # the agent gets the error as text
Pour un agent complet construit de cette manière, consultez Utiliser LangChain et Bright Data pour la recherche web.
Les workflows no-code qui appellent Custom Search obtiennent le même 403, et le forum communautaire n8n a un fil de discussion sur cette erreur exacte. Le nœud n8n officiel de Bright Data s’installe comme le nœud communautaire @brightdata/n8n-nodes-brightdata. Il dispose d’une opération Web Search qui envoie la requête à Google via la zone que vous sélectionnez, comme votre zone API SERP. Remplacez la requête Custom Search du workflow par cette opération.
Exécuter des recherches à volume de production
Les tâches par lots, et les agents qui envoient de nombreuses recherches dans une seule tâche, doivent exécuter plusieurs requêtes en même temps. Le module serp_batch.py du dépôt d’accompagnement exécute une version asynchrone de la boucle de requête et de nouvelle tentative de l’adaptateur en parallèle. Séparément, l’API SERP elle-même offre un mode asynchrone pour des lots de 1K requêtes ou plus.
Le bloc principal du fichier envoie les mêmes 10 requêtes deux fois, et la deuxième exécution est servie depuis son cache en mémoire.
{'queries': 20, 'cache_hits': 10, 'empty': 0, 'failed': 0}Sa fonction search_many() dispose de 3 paramètres et d’un ensemble de compteurs.
concurrencydéfinit le nombre de requêtes exécutées simultanément. L’API SERP n’a pas de limite de concurrence, donc réglez-la selon la charge que votre propre système peut gérer.deadlinelimite le temps total pour une requête, donc gardez-le court pour un outil d’agent et plus long pour une tâche par lots.ttldéfinit combien de temps une page en cache reste valide.- Les compteurs affichent les hits de cache, les résultats vides, et les échecs, donc un filtre
site:ou une valeurglerronés apparaissent tôt comme résultats vides.
Un appel renvoie un dict qui associe chaque requête à sa page analysée, ou à None si la requête a échoué.
import asyncio

from serp_batch import search_many

pages = asyncio.run(search_many(["redis cache ttl", "nginx rate limiting"],
                                concurrency=20, gl="us", hl="en"))
Obtenir l’AI Overview et les questions People Also Ask
Les agents, pipelines RAG, et équipes SEO peuvent avoir besoin de plus qu’une liste de 10 liens. La page Google pour « what is retrieval augmented generation » affiche un AI Overview et des questions People Also Ask, que Custom Search n’a jamais renvoyées.
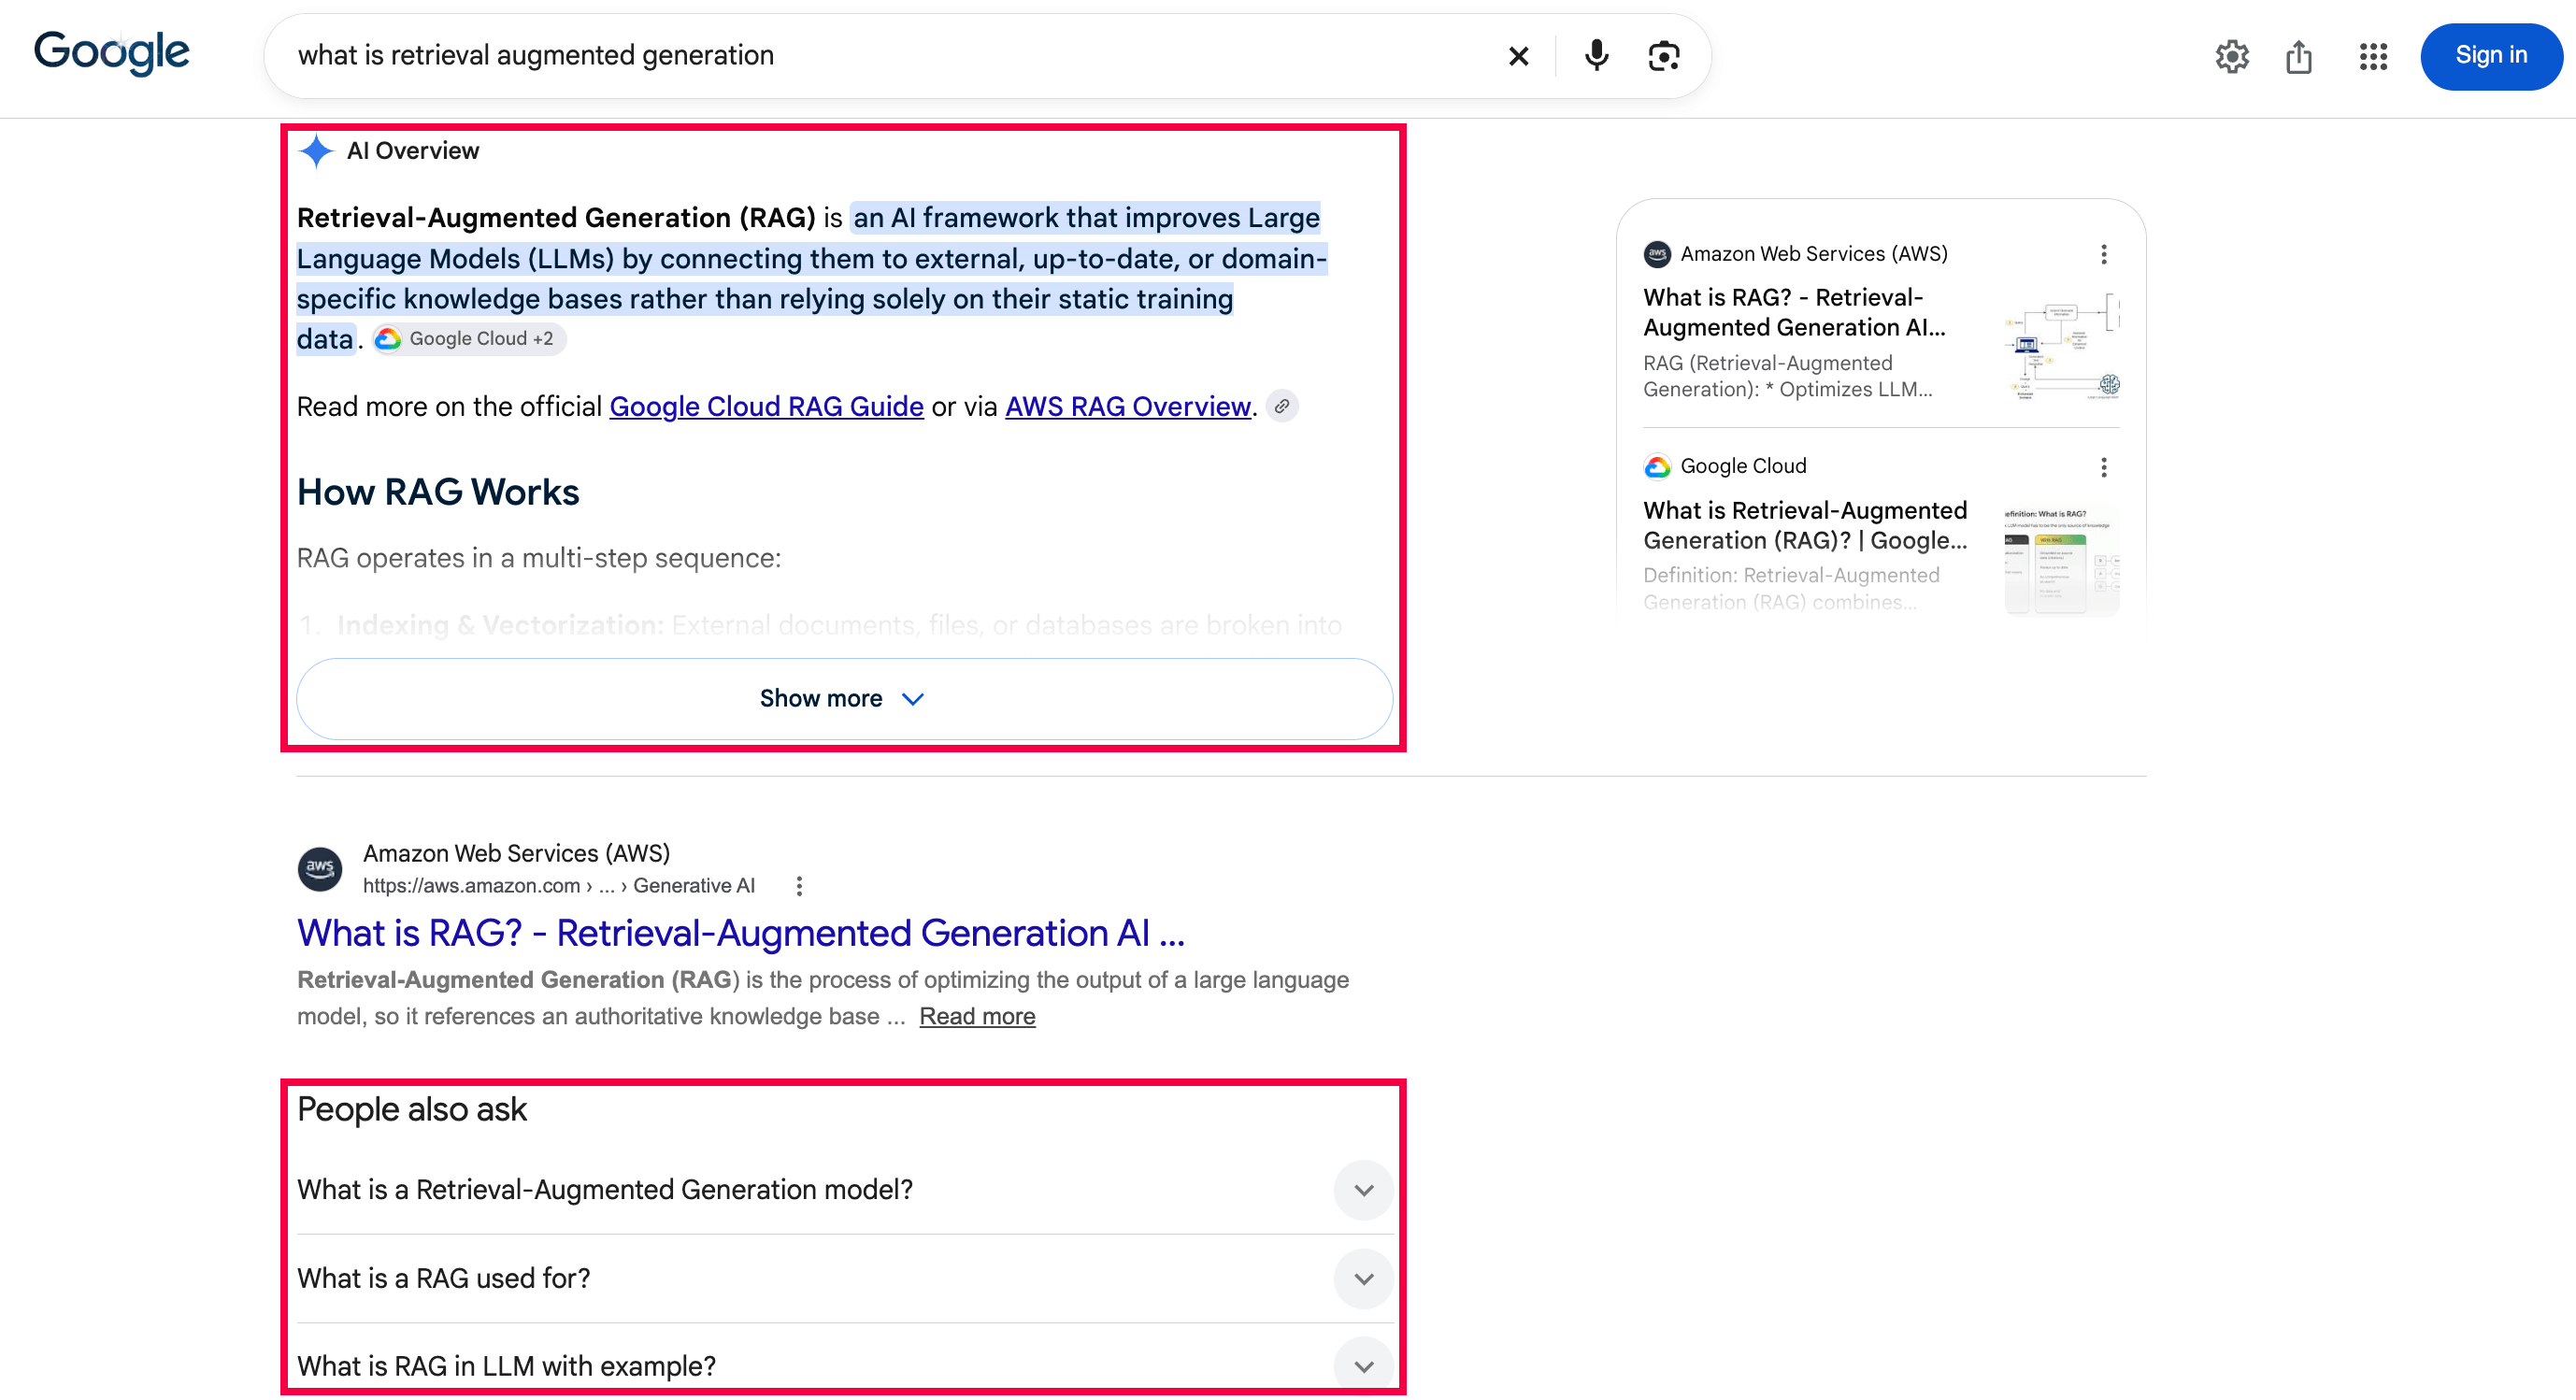
Un paramètre supplémentaire demande l’AI Overview, et la même réponse contient toutes les questions People Also Ask. Enregistrez ce script à côté de l’adaptateur cse_to_serp.py de l’étape 3.
"""Read the AI Overview and People Also Ask questions from one Google query."""

from cse_to_serp import fetch_serp

page = fetch_serp({
    "q": "what is retrieval augmented generation",
    "gl": "us",
    "hl": "en",
    "brd_json": 1,
    "brd_ai_overview": 2,  # requests the AI Overview
})

overview = page.get("ai_overview") or {}
print("AI Overview text blocks:", len(overview.get("texts", [])))
print("AI Overview sources:", len(overview.get("references", [])))
questions = dict.fromkeys(  # keeps each question once, in order
    item["question"] for item in page.get("people_also_ask", [])
    if item.get("question")
)
for question in list(questions)[:2]:
    print("People also ask:", question)
Le script a affiché cette sortie. La page de Google est en direct, donc vos questions peuvent différer de la capture d’écran.
AI Overview text blocks: 3
AI Overview sources: 8
People also ask: Does ChatGPT use Retrieval-Augmented Generation?
People also ask: What is RAG in LLM with example?
Chaque entrée references contient le href et le title de la page citée, afin que les équipes SEO puissent suivre quels sites l’AI Overview cite. La page Google AI Overview API de Bright Data explique le paramètre en détail. Pour le mode AI de Google, l’API Google Scraper renvoie les résultats du mode AI Search au format JSON.
Un pipeline RAG qui lit les pages de résultats peut les récupérer via le même point de terminaison /request. Utilisez une zone Web Unlocker et la même clé API.
Liste de contrôle de migration avant le 1er janvier 2027
Exécutez ces étapes pendant que votre clé Custom Search fonctionne encore, car l’élément 2 en a besoin.
- Trouvez chaque point d’appel. Recherchez dans votre code
customsearch/v1,cse().list, et des wrappers commeGoogleSearchAPIWrapper. Dans une grande base de code, un agent de codage peut exécuter cette recherche et effectuer le changement de l’étape 3 à chaque point d’appel. - Enregistrez les résultats de Custom Search pour un échantillon de requêtes de production réelles, afin de conserver une référence une fois la clé inopérante. Si la clé a déjà cessé de fonctionner, enregistrez plutôt les résultats de google.com pour les mêmes
glethl. - Commencez par le niveau gratuit, puis budgétisez 1 requête API SERP par page de résultats.
- Laissez l’adaptateur convertir les valeurs
startbasées sur 1 en valeurs basées sur 0 de Google, ou convertissez-les vous-même et demandez des pages entières. - Définissez
glethlsur chaque requête. - Comparez les anciens et nouveaux résultats comme des ensembles d’URL, pas par rang exact. Pour les agents, réexécutez aussi vos évaluations de tâche et notez les réponses finales. Attendez-vous à certaines différences, car les nouveaux résultats proviennent de la page de résultats complète de Google, et non du sous-ensemble de l’index de Custom Search.
- Basculez derrière un indicateur de fonctionnalité, exécutez les deux chemins en parallèle pendant quelques jours, puis supprimez la clé Google.
Pour l’élément 6, l’assistant compare_baseline.py note chaque requête de 0 à 1. Le score est la part des 10 principales URL sauvegardées qui apparaissent encore dans les 10 nouveaux premiers résultats.
D’abord, exécutez chaque requête deux fois via l’API SERP et notez les 2 exécutions l’une par rapport à l’autre. Le classement de Google peut changer entre les appels, donc un score juste en dessous de 1,0 peut être normal. Lors des tests, 2 exécutions d’une requête avec le même gl ont obtenu un score de 1,0, et une exécution américaine par rapport à une exécution britannique a obtenu un score de 0,0. Ensuite, notez chaque requête enregistrée, examinez manuellement les scores les plus bas, et vérifiez les filtres gl et site: pour tout score proche de 0.
Dépanner les erreurs de migration
Il s’agit de problèmes de configuration lors de la première exécution ou de comportements de Google.
| Symptôme | Cause | Correction |
|---|---|---|
| Google renvoie 403 sur les appels Custom Search | API fermée aux nouveaux clients | Une nouvelle clé n’aidera pas. Migrez vers l’API SERP Bright Data |
RuntimeError: Set the BRIGHTDATA_API_KEY environment variable… |
Variable non définie dans ce terminal | Définissez BRIGHTDATA_API_KEY comme à l’étape 1 |
| 401 « Invalid token » | Clé API Bright Data incorrecte | Copiez la clé depuis la barre Quick start sur Home |
400 zone "..." not found |
Nom de zone incorrect | Utilisez le nom que vous avez donné à l’API à l’étape 1 |
UserWarning: cx is ignored… |
La recherche Google n’a pas d’ID de moteur | Supprimez cx. Si le moteur recherchait une liste fixe de sites, ajoutez (site:a.com OR site:b.com) à q |
TypeError: No mapping for: [...] |
Un paramètre absent du tableau de l’étape 2 | Ajoutez l’équivalent Google à q ou aux params de l’adaptateur, ou supprimez le paramètre |
KeyError sur pagemap ou searchInformation |
L’adaptateur renvoie 4 champs principaux | Supprimez le code qui lit le champ, ou mappez-le depuis la réponse de l’API SERP |
items a moins de num résultats |
La page de Google contenait moins de résultats organiques | Suivez queries.nextPage |
items est vide |
Aucune correspondance, ou un filtre site: ou une valeur gl erronés |
Essayez la requête sur google.com |
| Les résultats diffèrent de Custom Search | Custom Search recherchait un sous-ensemble de l’index de Google | Comparez les ensembles d’URL. Exécutez d’abord chaque requête deux fois pour voir la variation normale |
Un message RuntimeError: SERP API error… inclut la valeur x-brd-error-code ou x-brd-err-code. Trouvez le code dans le catalogue d’erreurs de l’API SERP.
Conclusion
Le produit de recherche full-web de Google n’est pas public, et la date de fin de Custom Search JSON API est le 1er janvier 2027. Les options publiques de Google recherchent une liste fixe de domaines ou renvoient des réponses Gemini, et les conditions Gemini interdisent la mise en cache ou l’analyse des résultats. Les requêtes HTTP directes n’ont donné aucun résultat lors des tests, donc l’API SERP Bright Data est le remplacement pratique lorsque votre code a besoin de la page de résultats.
L’adaptateur de l’étape 3 gère le start basé sur 0 de Google et le num supprimé, donc votre code a principalement besoin de gl à chaque appel. Exécutez vos requêtes enregistrées via le niveau gratuit de l’API SERP Bright Data, sans carte de crédit, et comparez-les à votre référence Custom Search ou à google.com.
FAQ
L’API Google Custom Search est-elle abandonnée ?
Oui, en 2 étapes. Google a fermé Custom Search JSON API aux nouveaux clients en janvier 2026, l’accès des clients existants prenant fin le 1er janvier 2027. Google suggère Agent Search pour jusqu’à 50 domaines. L’API SERP Bright Data renvoie des résultats Google full-web au format JSON.
Google a-t-il une API de recherche ?
Pas une API de recherche full-web à laquelle les nouveaux développeurs peuvent s’inscrire. Google propose Agent Search pour jusqu’à 50 domaines et Grounding with Google Search, qui renvoie des réponses Gemini avec des liens. Le produit de recherche full-web de Google n’est pas public. Pour des résultats Google en JSON, utilisez l’API Google Search de Bright Data, qui fait partie de son API SERP.
L’API de recherche Google est-elle gratuite ?
Pas pour les nouveaux développeurs qui ont besoin de résultats full-web. Custom Search JSON API donne aux clients existants 100 requêtes gratuites par jour, puis facture 5 $ pour 1 000, jusqu’au 1er janvier 2027. L’API SERP de Bright Data renvoie des résultats Google en JSON, avec 5K requêtes gratuites par mois.
Qu’est-ce qui peut remplacer l’API Google Custom Search ?
L’API SERP Bright Data remplace directement Custom Search JSON API, car elle renvoie la page de résultats complète de Google au format JSON. Les propres options de Google renvoient des réponses IA ou recherchent une liste fixe de domaines. Un adaptateur Python open-source et plug-and-play convertit vos appels cse.list() en paramètres Google.
Comment puis-je scraper les résultats de recherche Google ?
Pas avec un client HTTP seul. Google Search exige JavaScript, donc lors des tests, les clients HTTP ont obtenu une page 200 sans résultat. Les navigateurs sur la même connexion ont ensuite obtenu une page CAPTCHA. L’API SERP Bright Data renvoie la page de résultats de Google en JSON analysé, sans navigateurs ni parseurs à maintenir pour vous.
Pourquoi l’API Custom Search renvoie-t-elle 403 ?
Google a fermé Custom Search JSON API aux nouveaux clients en janvier 2026, donc une nouvelle clé ou un nouveau projet ne corrigera pas l’erreur 403. Sur le forum des développeurs de Google, un développeur signale aussi qu’un projet existant a perdu l’accès après un changement de facturation. Déplacez les appels vers l’API SERP Bright Data, qui renvoie les résultats Google en JSON.