L’API de recherche web Parallel répond à la requête d’un agent à partir de son propre index, avec des URL classées et des extraits Markdown. L’API SERP de Bright Data récupère la page de résultats de moteur de recherche (SERP) en direct depuis Google et d’autres moteurs. Elle renvoie la page qu’un utilisateur dans un pays ou une ville donné verrait.
Le premier résultat de Google pour “plombier urgence” à Chicago était un pack de cartes de 3 entreprises locales. Parallel a renvoyé des pages classées sans pack de cartes, l’agent manquerait donc ce que voient d’abord les utilisateurs de Chicago.
Ce guide compare les deux sur les résultats, la localisation, les tarifs et le contenu de page complet, avec du code exécutable.
En bref
- Choisissez Bright Data lorsque la réponse dépend de ce que Google affiche. Il renvoie la page de Google, et le mode Avancé de Parallel a renvoyé 35 à 43 % des URL de cette page sur 30 requêtes.
- Choisissez Parallel lorsque le classement de Google n’a pas d’importance. Le mode Avancé a renvoyé une médiane de 4 082 tokens d’extraits pour 10 résultats.
- Les résultats locaux changent souvent selon la ville. Les pages de Google pour 3 villes ne partageaient aucune URL organique sur 3 des 4 requêtes, et le paramètre de localisation de Parallel acceptait des pays, pas des villes.
- Ajouter Bright Data nécessite une seule entrée de configuration MCP. Une clé fonctionne pour la recherche et le scraping. Le niveau gratuit ne nécessite pas de carte de crédit.
Ce que renvoient Bright Data et Parallel
Bright Data et Parallel répondent à la même requête d’agent à partir de sources différentes. Bright Data récupère la page de résultats en direct du moteur de recherche, et Parallel interroge son propre index de recherche.
Avec une SERP en direct, l’agent peut aussi récupérer les pages complètes qu’il choisit :
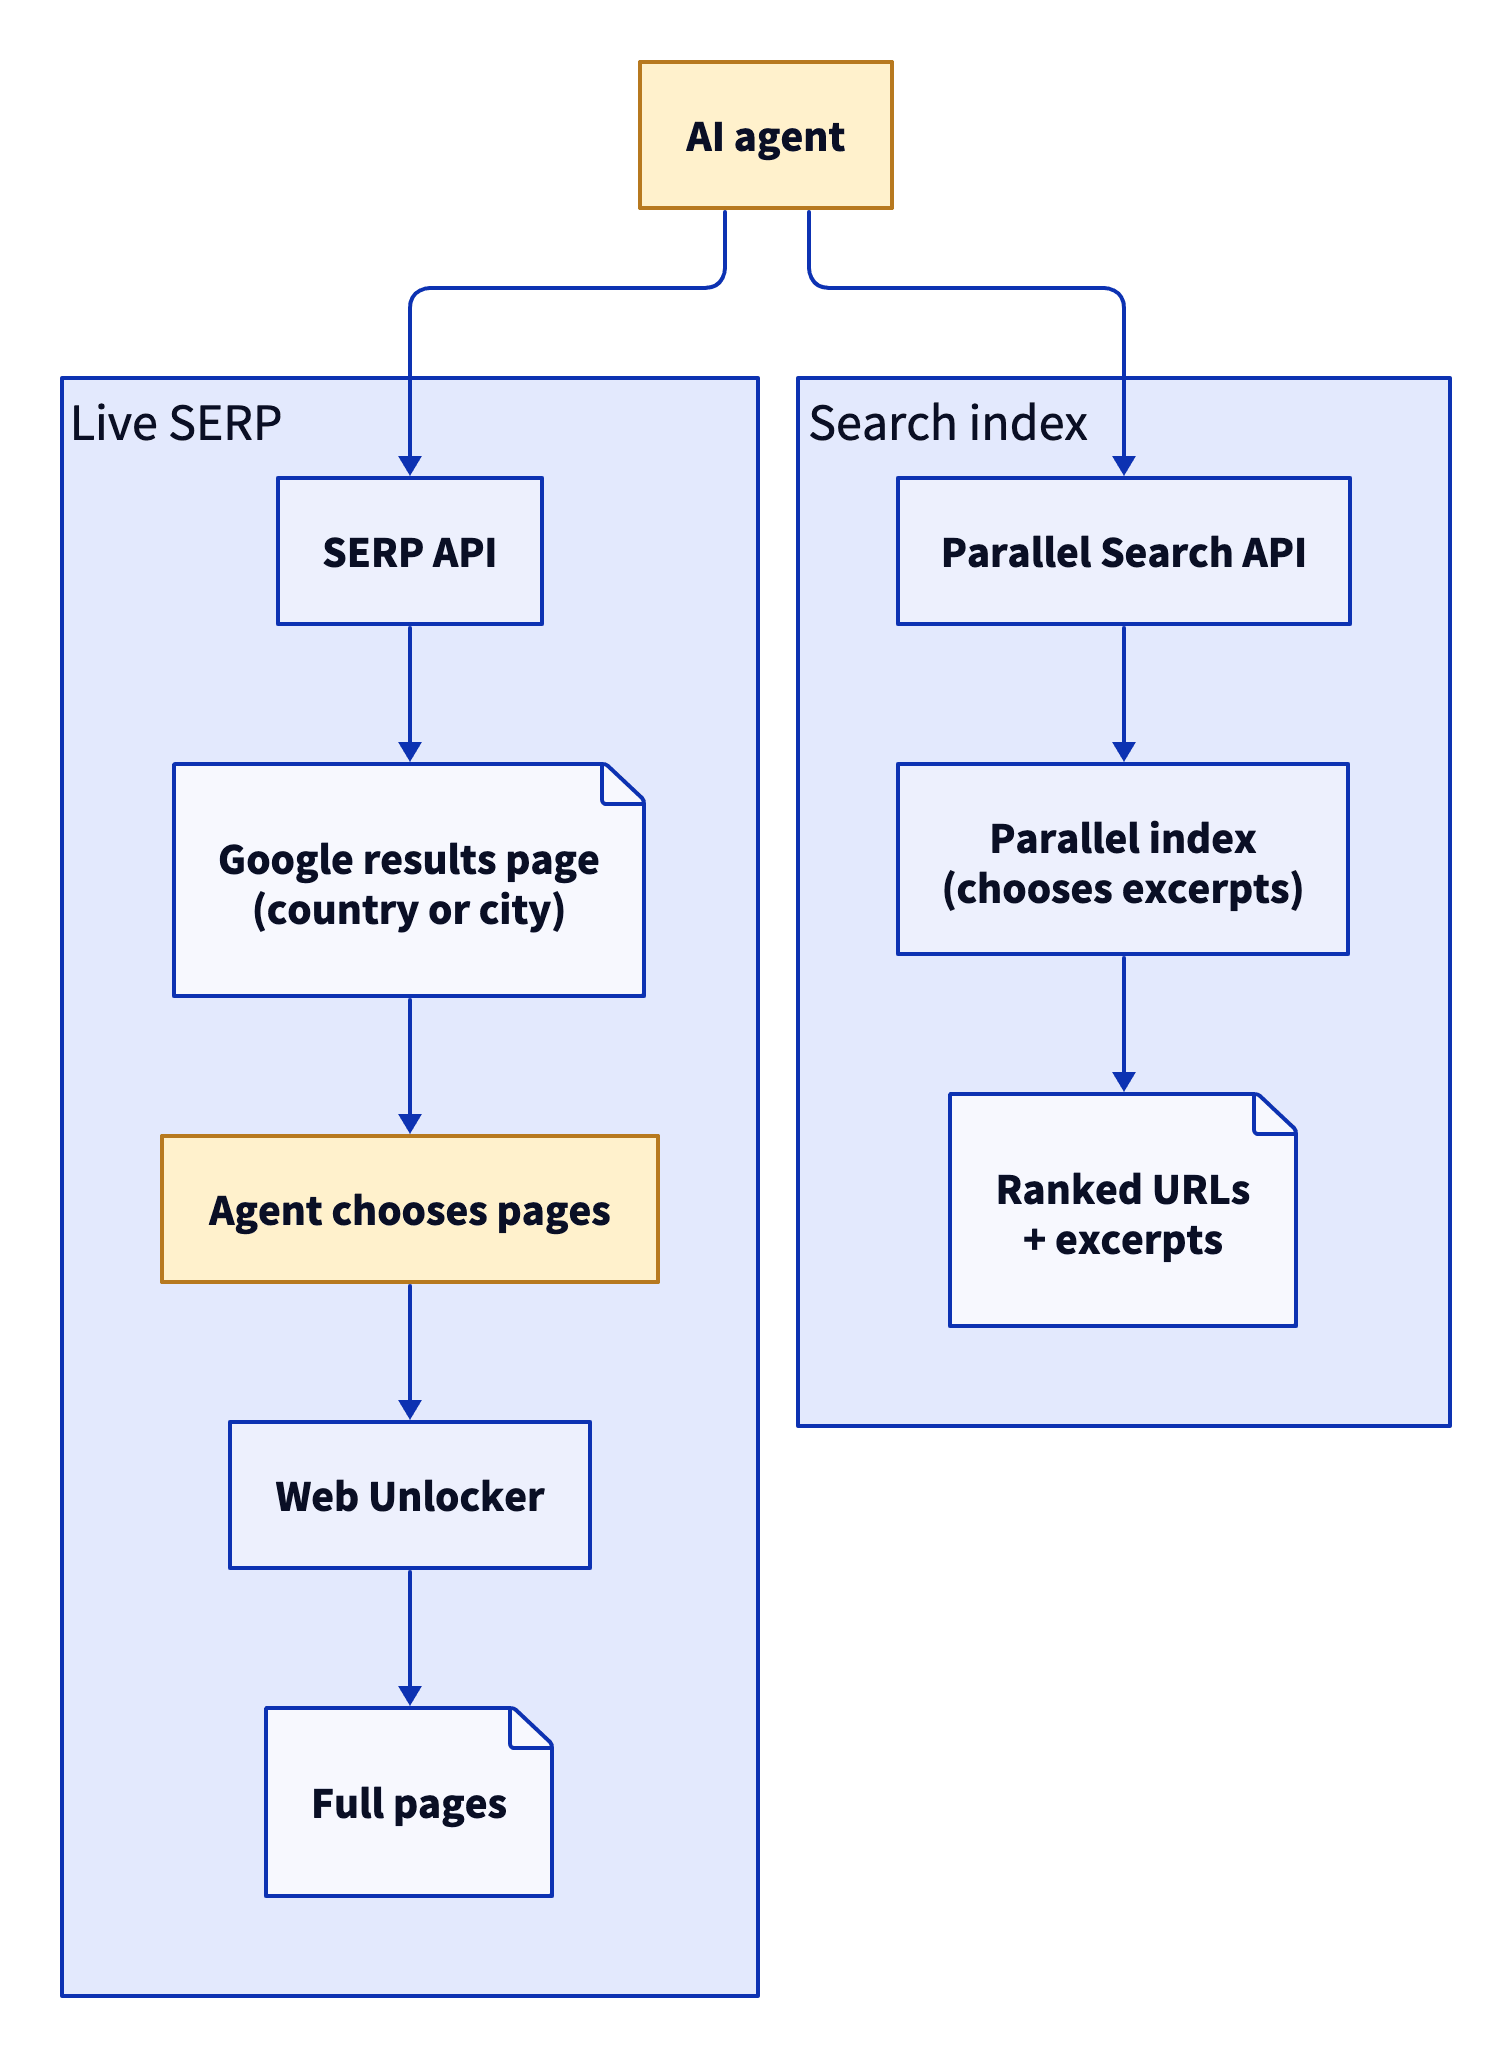
Avec une SERP en direct, l’agent choisit les pages à lire. Avec un index de recherche, c’est l’index qui choisit les extraits.
Bright Data : résultats en direct et pages complètes pour les agents
L’API SERP renvoie la page de résultats en direct sous forme de JSON analysé, HTML brut ou Markdown, y compris les fonctionnalités SERP comme le pack de cartes (listes d’entreprises locales de Google) et l’AI Overview. Web Unlocker récupère les pages liées à ces résultats et est conçu pour les pages avec protection anti-bot. Le serveur MCP Bright Data encapsule la recherche et le scraping en outils Model Context Protocol (MCP) pour les agents, et les deux outils utilisent une seule clé API.
Parallel : extraits classés depuis son propre index
L’API de recherche de Parallel accepte un objective en langage naturel plus des search_queries courtes, et renvoie des URL classées avec des extraits Markdown choisis pour l’objectif. Ses modes turbo, fast, basic et advanced offrent un choix entre latence et qualité, et advanced était le mode par défaut lors des tests. Parallel vend aussi une API Extract pour le contenu de page complet, plus d’autres API pour agents.
Bright Data vs. Parallel : comparaison directe
Bright Data renvoie la page de résultats en direct du moteur de recherche plus les pages auxquelles elle renvoie, et Parallel classe les pages de son propre index de recherche. Chaque fait sur Parallel dans ce tableau provient de la documentation ou de la page de tarifs de Parallel, vérifiées pendant les tests. La page de l’API SERP liste les moteurs, localisations et forfaits actuels de Bright Data.
| Bright Data | Parallel | |
|---|---|---|
| Source des résultats | Page de résultats en direct du moteur de recherche | Propre index de Parallel, avec une récupération en direct lorsque sa copie en cache dépasse un âge maximum configuré |
| Classement | Classement propre du moteur | Classement de pertinence de Parallel pour l’objectif |
| Moteurs | Google, Bing et autres moteurs majeurs | Son propre index |
| Localisation | Ciblage par pays et par ville | Code pays, à partir d’une liste fixe. Les autres codes sont ignorés avec un avertissement |
| Sortie | JSON analysé, HTML ou Markdown de la page de résultats complète | URL, titre, date de publication, extraits Markdown |
| Fonctionnalités SERP | Organique, pack de cartes, AI Overview, People Also Ask, shopping, publicités | Non applicable (liste classée uniquement) |
| Contenu de page | Markdown de page complète via Web Unlocker ou le serveur MCP | Extraits dans le même appel, texte complet via Extract |
| Pages avec protection anti-bot | Web Unlocker, conçu pour les sites protégés contre les bots | Pas de déblocage, et pas d’accès aux sites qui le bloquent, selon Parallel |
| Serveur MCP | MCP hébergé ou local, gratuit pour commencer sans carte de crédit | Search MCP, gratuit sans clé API |
La comparaison avec l’API Brave Search et la comparaison avec Exa testent les 2 mêmes approches avec d’autres API d’index. Pour une liste plus large, consultez les meilleures API SERP et de recherche web et les meilleurs outils de recherche pour agents IA.
Tarifs et limites de débit : API SERP Bright Data vs. API de recherche Parallel
L’API SERP ne facture que les requêtes réussies, vous ne payez donc que pour les résultats reçus. Vous pouvez démarrer en libre-service, avec un tarif au paiement à l’utilisation, et les forfaits mensuels plus importants réduisent le tarif par 1 000 requêtes. Parallel tarifait chaque recherche par mode lors des tests, et son mode Avancé par défaut coûtait 5 fois plus que Turbo et Fast.
Consultez la page de tarifs de Parallel et la page de tarifs de l’API SERP Bright Data pour les tarifs actuels avant de planifier votre budget :
| API SERP Bright Data | Parallel (tarifs catalogue lors des tests) | |
|---|---|---|
| Prix de recherche | Tarif libre-service au paiement à l’utilisation, ou forfaits mensuels Scale avec un tarif plus bas selon le volume (tarifs actuels sur la page de tarifs) | 1 $ par 1 000 requêtes pour Turbo et Fast, et 5 $ par 1 000 pour Basic et Advanced. Chaque prix incluait 10 résultats, et les résultats supplémentaires coûtaient 1 $ par 1 000 |
| Contenu de page complet | Web Unlocker, via le serveur MCP ou sa propre API (tarifs actuels) | Extract à 1 $ par 1 000 URL |
| Niveau gratuit | Niveau gratuit mensuel récurrent, aucune carte de crédit requise (quota actuel sur la page de tarifs) | 5 $ de crédits par mois, pour les organisations ayant ajouté une carte de crédit |
| Facturation | Seules les requêtes réussies sont facturées | Par 1 000 requêtes, selon le mode |
| Limites de débit et simultanéité | Les forfaits Scale listent une simultanéité illimitée | 600 requêtes par minute par défaut, personnalisable sur les forfaits entreprise |
Le prix unitaire n’est qu’une partie de la facture d’un agent. Chaque résultat, extrait et page que le modèle lit ajoute aussi des tokens de modèle à la facture. Dans une boucle qui cherche, lit et cherche à nouveau, le modèle relit les résultats antérieurs à chaque tour, et ces tokens sont facturés de nouveau. Comparez le coût par réponse, qui est la dépense d’API plus le coût des tokens de modèle, divisé par les réponses réellement utilisées par votre agent.
Par exemple, un agent qui effectue 3 recherches et lit 3 pages fait 6 appels d’API par réponse. Multipliez ces appels par les tarifs actuels de chaque API, puis ajoutez les tokens de modèle que l’agent lit, pour comparer le coût par réponse.
Même requête, résultats différents : le chevauchement de Parallel avec Google
Le mode Avancé par défaut de Parallel a renvoyé 35 à 43 % des URL de la première page de Google. Ses modes Turbo et Fast ont renvoyé 6 à 18 %.
J’ai envoyé les mêmes 30 requêtes américaines à Google via l’API SERP, et aux 4 modes de Parallel, puis comparé les 10 premières URL. Le tableau montre la part des URL principales de Google que chaque mode de Parallel a également renvoyée, avec le nombre de requêtes de chaque groupe entre crochets. La première page de Google a changé entre les exécutions, une fourchette indique donc les résultats de 2 exécutions :
| Groupe (requêtes) | Advanced | Basic | Fast | Turbo |
|---|---|---|---|---|
| Factuel (5) | 35 à 61 % | 33 à 53 % | 15 à 18 % | 11 à 17 % |
| Documentation technique (5) | 50 à 63 % | 64 % | 27 % | 11 % |
| Actualités (4) | 25 à 36 % | 31 à 42 % | 26 à 39 % | 5 à 8 % |
| Marque et SEO (6) | 21 à 42 % | 29 à 52 % | 12 à 16 % | 3 à 8 % |
| Commercial (6) | 35 à 52 % | 37 à 53 % | 8 à 10 % | 0 à 2 % |
| Local (4) | 17 à 25 % | 17 % | 0 % | 0 % |
| Toutes les requêtes (30) | 35 à 43 % | 39 à 45 % | 15 à 18 % | 6 % |
Le SDK de Parallel recommandait un objectif en langage naturel et 2 ou 3 requêtes de recherche par appel. Avec ces paramètres, le mode Advanced a renvoyé 34 % et le mode Fast 11 %, les paramètres recommandés n’ont donc pas augmenté le chevauchement. Chaque groupe comporte 4 à 6 requêtes, considérez donc chaque ligne de groupe comme un indicateur approximatif et la ligne de 30 requêtes comme le chiffre global.
Parallel classe les pages selon l’objectif, ce qui fonctionne bien pour les questions de recherche ouvertes. Le suivi de classement, le suivi de visibilité IA, la surveillance de marque et la surveillance publicitaire nécessitent la page que les utilisateurs voient réellement. C’est la page de résultats de Google, que l’API SERP renvoie.
Ciblage au niveau de la ville : résultats Google à Chicago, Austin et Seattle
Les résultats de Google ont changé selon la ville sur 3 des 4 requêtes locales, et le paramètre de localisation de Parallel acceptait des pays, pas des villes, lors des tests. L’API SERP a récupéré la première page de Google pour 4 requêtes à intention locale à Chicago, Austin et Seattle :
| Requête | URL organiques partagées entre 2 villes | Entreprises du pack de cartes partagées |
|---|---|---|
| plombier urgence | Aucune | Aucune |
| meilleure pizza | Aucune | Aucune |
| dentiste ouvert samedi | Aucune | Aucune |
| devis assurance auto | 6 sur 9 | Google n’a affiché aucun pack de cartes |
Au-dessus du pack de cartes, la page de Google pour Chicago affiche la localisation appliquée :
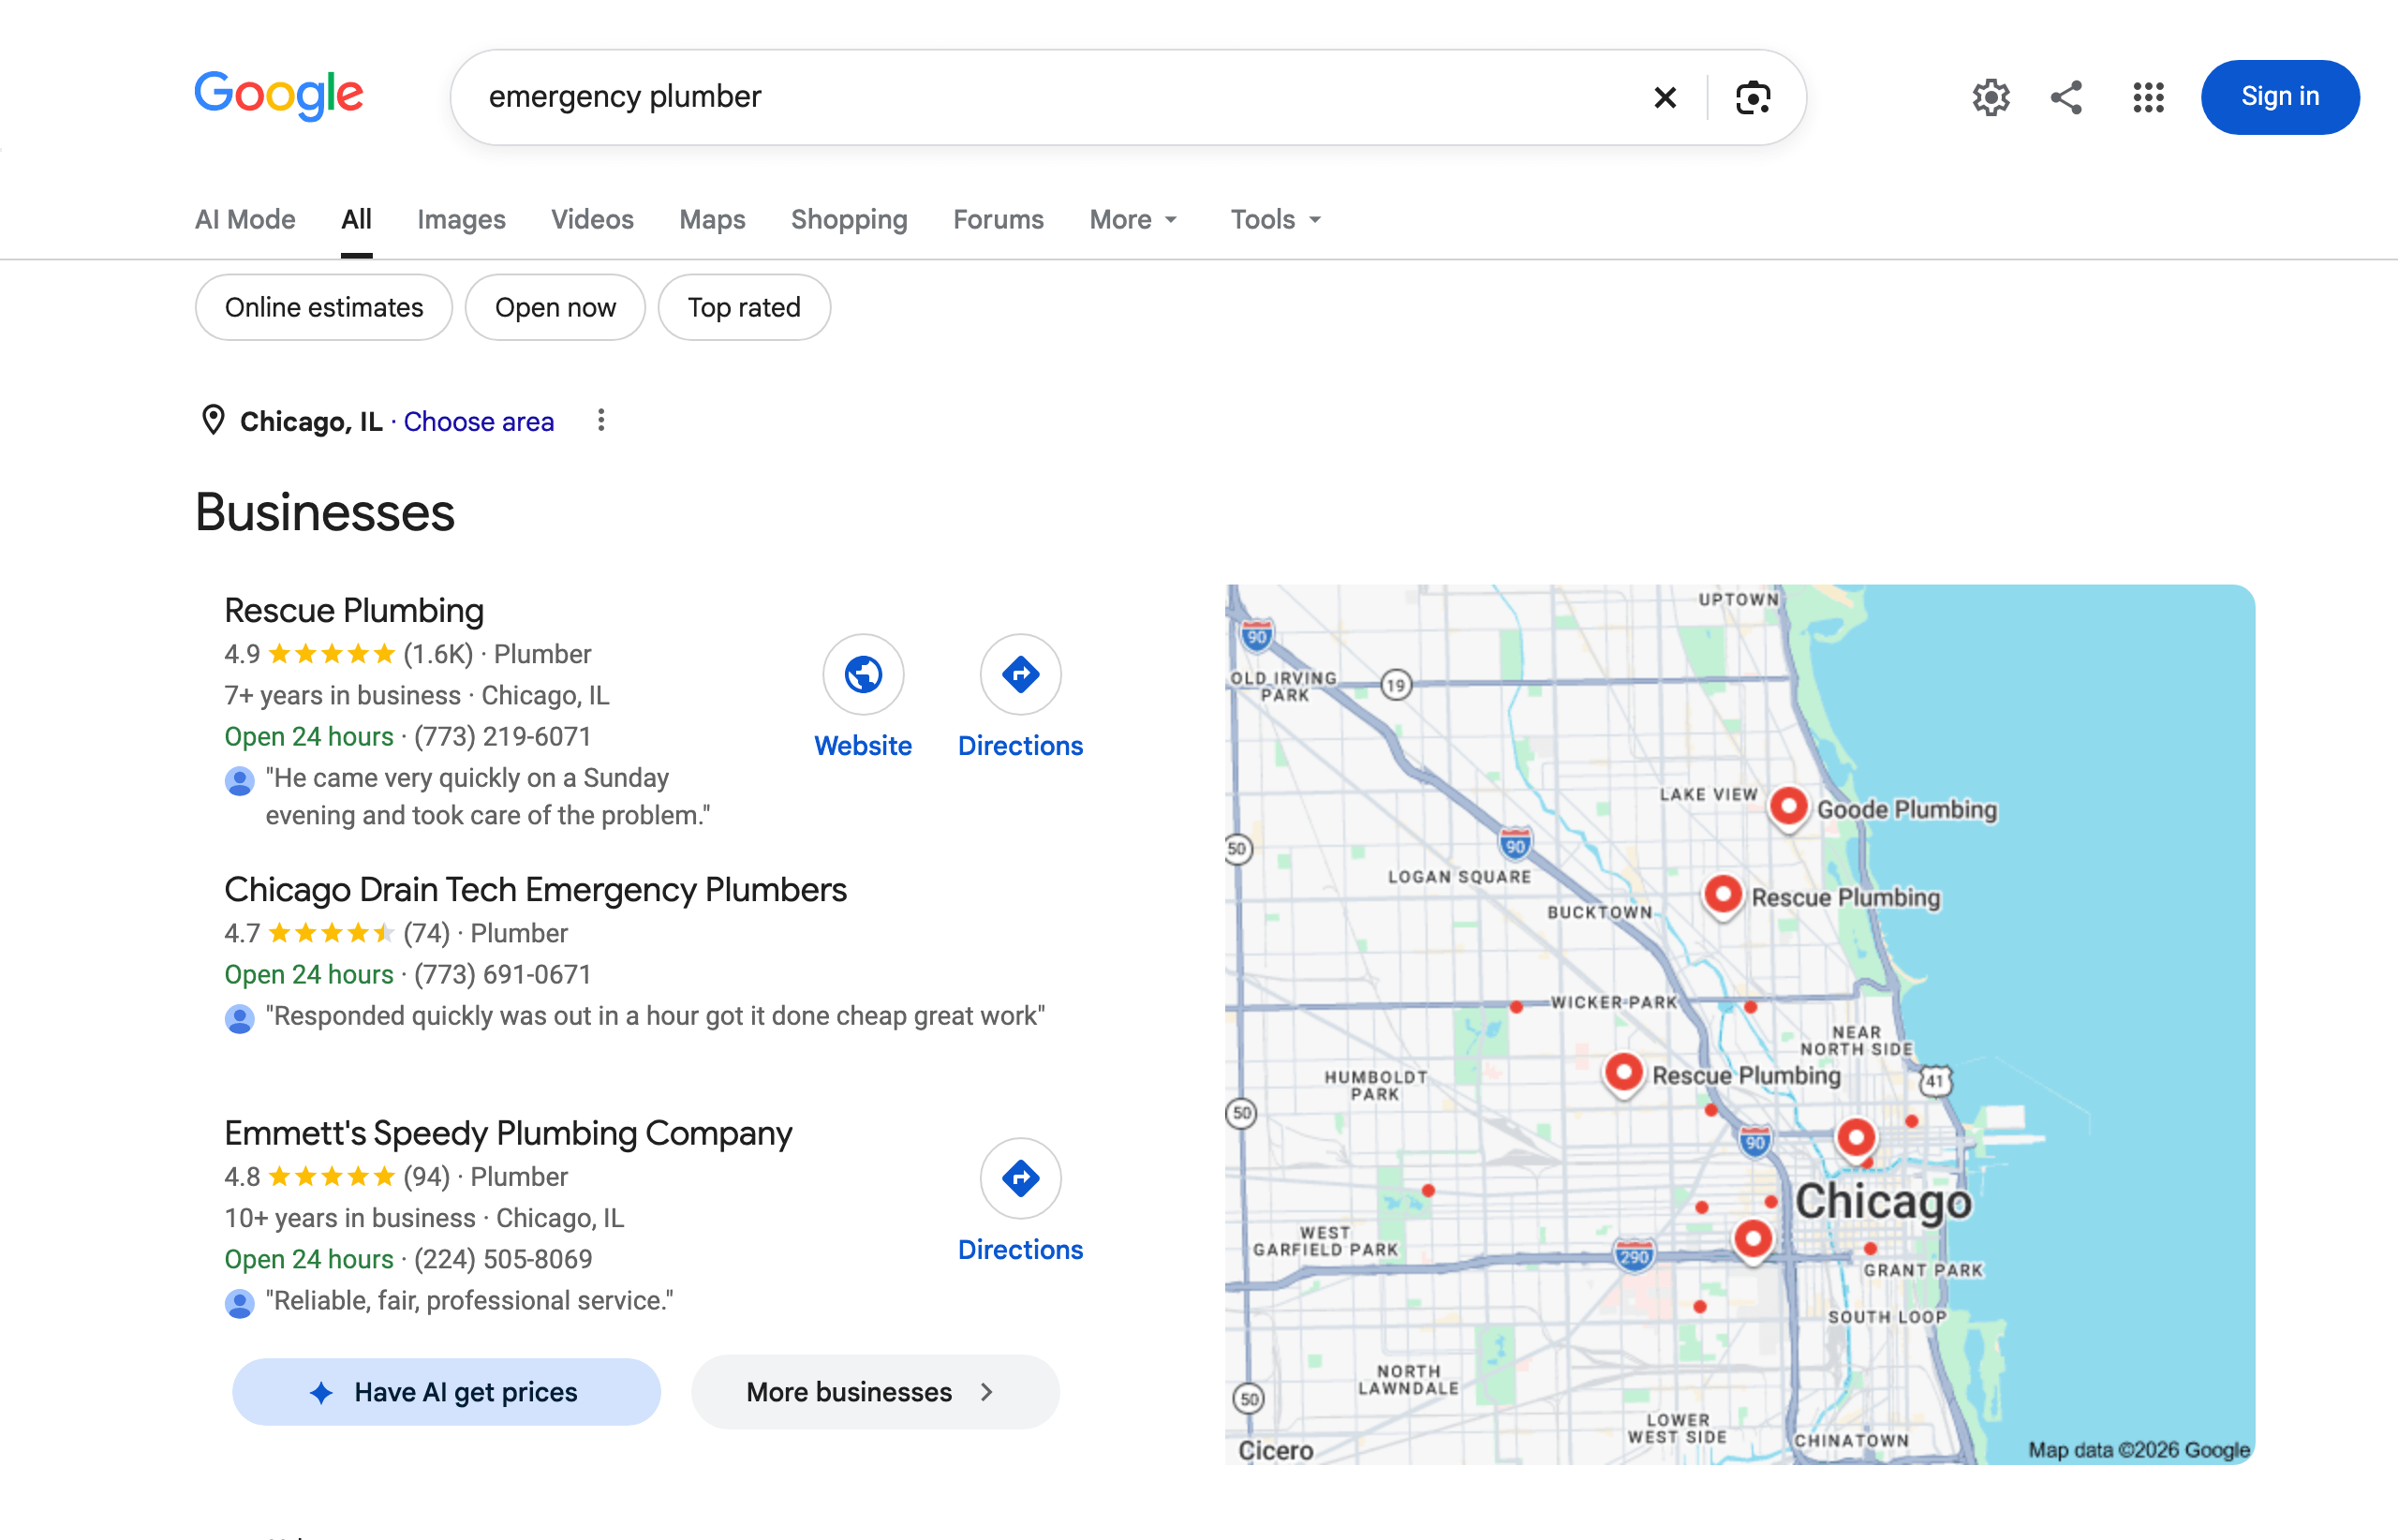
L’étiquette de localisation confirme le ciblage.
La page d’Austin pour la même requête liste d’autres entreprises :
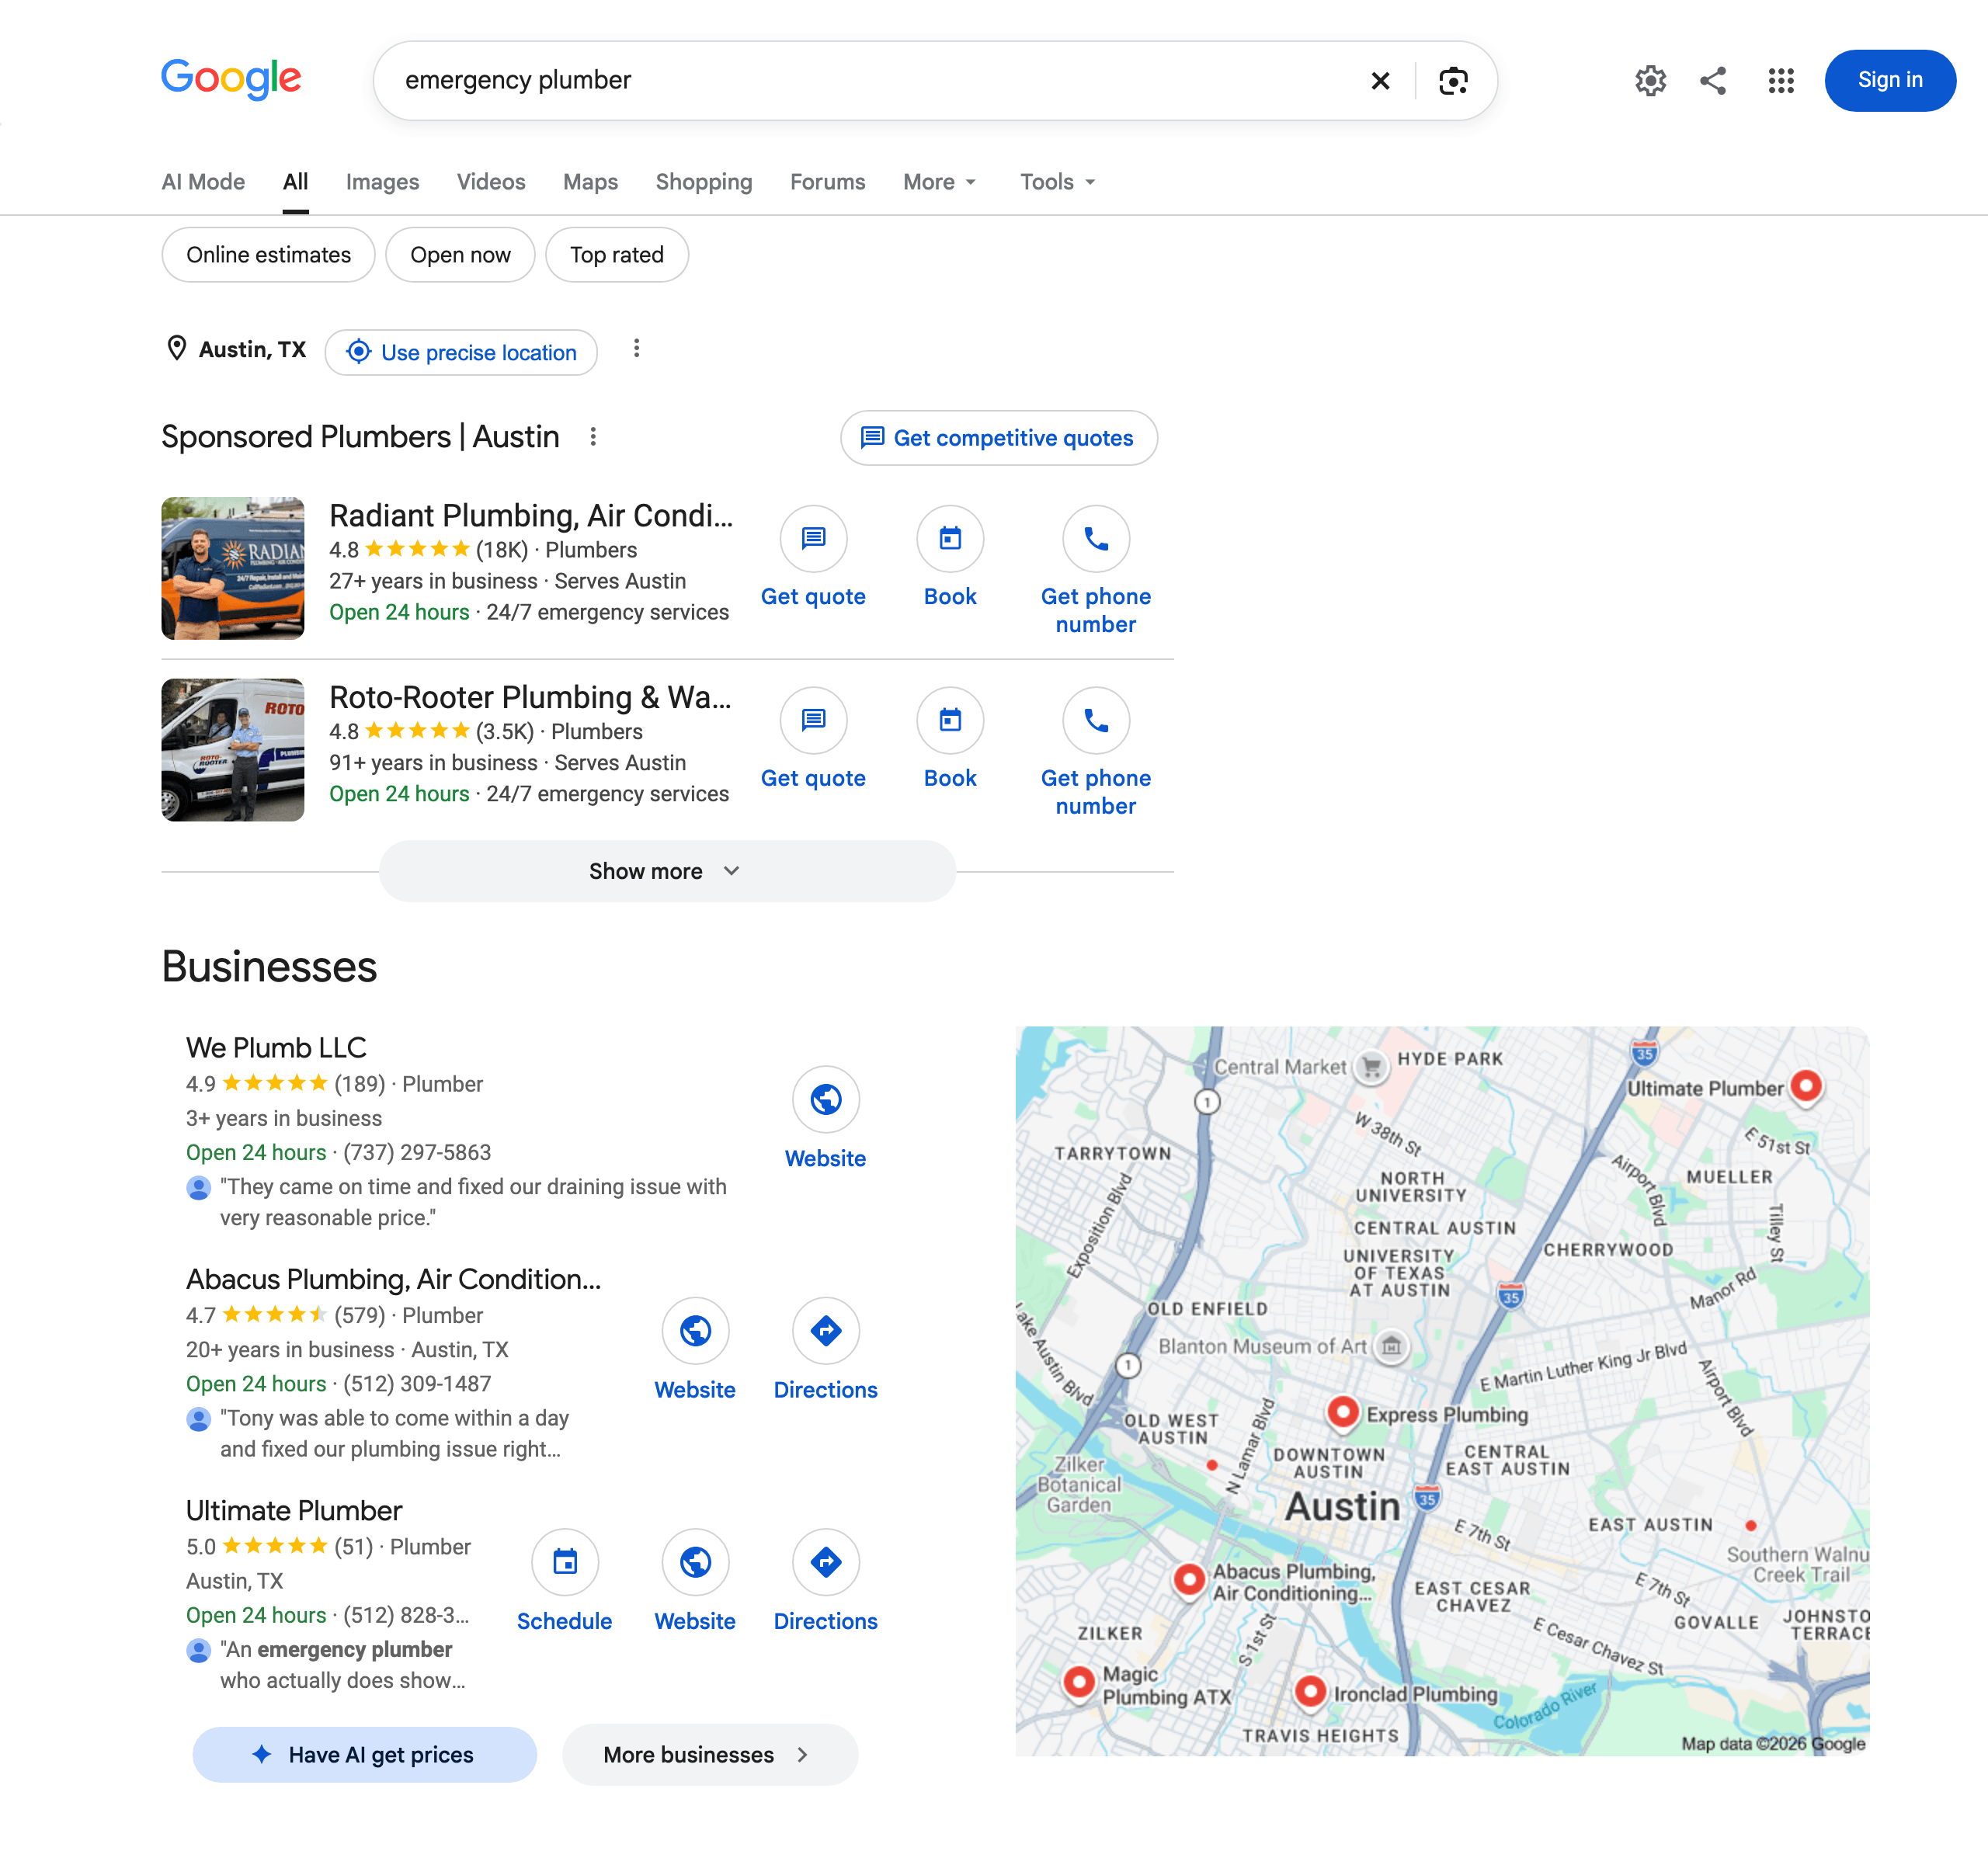
Même requête et même moteur, aucune entreprise partagée. Un paramètre au niveau du pays ne peut demander la page d’aucune des deux villes.
Pour “dentiste ouvert samedi” avec la localisation réglée sur les États-Unis, les résultats de Parallel incluaient une page de Los Angeles et une recherche Yelp pour Port St. Lucie, en Floride. Ajouter le nom de la ville au texte de la requête a aidé Parallel à faire correspondre davantage de résultats locaux de Google. Avec le nom de la ville ajouté à chaque requête, le mode Advanced a renvoyé 39 des 107 URL des pages ciblées par ville de Google. Les extraits de Parallel nommaient 4 des 27 entreprises des packs de cartes de Google.
Avec la localisation réglée sur les Émirats arabes unis, le Vietnam ou le Nigeria, Parallel renvoyait quand même des résultats, plus un avertissement indiquant que la localisation “n’est pas actuellement prise en charge. Le paramètre de localisation est ignoré.” Si vous utilisez Parallel, vérifiez le champ warnings, car ces résultats n’avaient aucun pays appliqué. L’API SERP applique le pays à chaque requête, et la même requête a renvoyé des packs de cartes locaux dans les 3 pays.
Le ciblage par ville dans l’API SERP utilise le paramètre uule de Google. L’API SERP accepte un nom de localisation canonique simple, comme Chicago,Illinois,United States, sans encodage supplémentaire. Ajoutez brd_mobile=1 à l’URL de recherche pour obtenir la page de résultats mobile, car de nombreux outils de suivi de classement rapportent séparément les résultats mobiles et de bureau.
Fonctionnalités SERP qu’un index de recherche ne renvoie pas
Sur les 30 requêtes de test, les pages de Google ont montré ces fonctionnalités SERP, et l’index de Parallel n’en a renvoyé aucune :
| Fonctionnalité SERP | Requêtes l’ayant affichée |
|---|---|
| People Also Ask | 21 sur 30 |
| AI Overview | 15 sur 30 |
| Résultats vidéo | 8 sur 30 |
| Pack de cartes | 4 sur 30 |
| Résultats shopping | 4 sur 30 |
| Publicités | 3 sur 30 |
Un agent qui rapporte ce que Google indique aux utilisateurs a besoin de l’AI Overview lui-même. L’aperçu pour “meilleur crm pour petite entreprise” recommandait HubSpot, Pipedrive et Zoho, et listait ses sources dans un panneau à côté de la réponse :
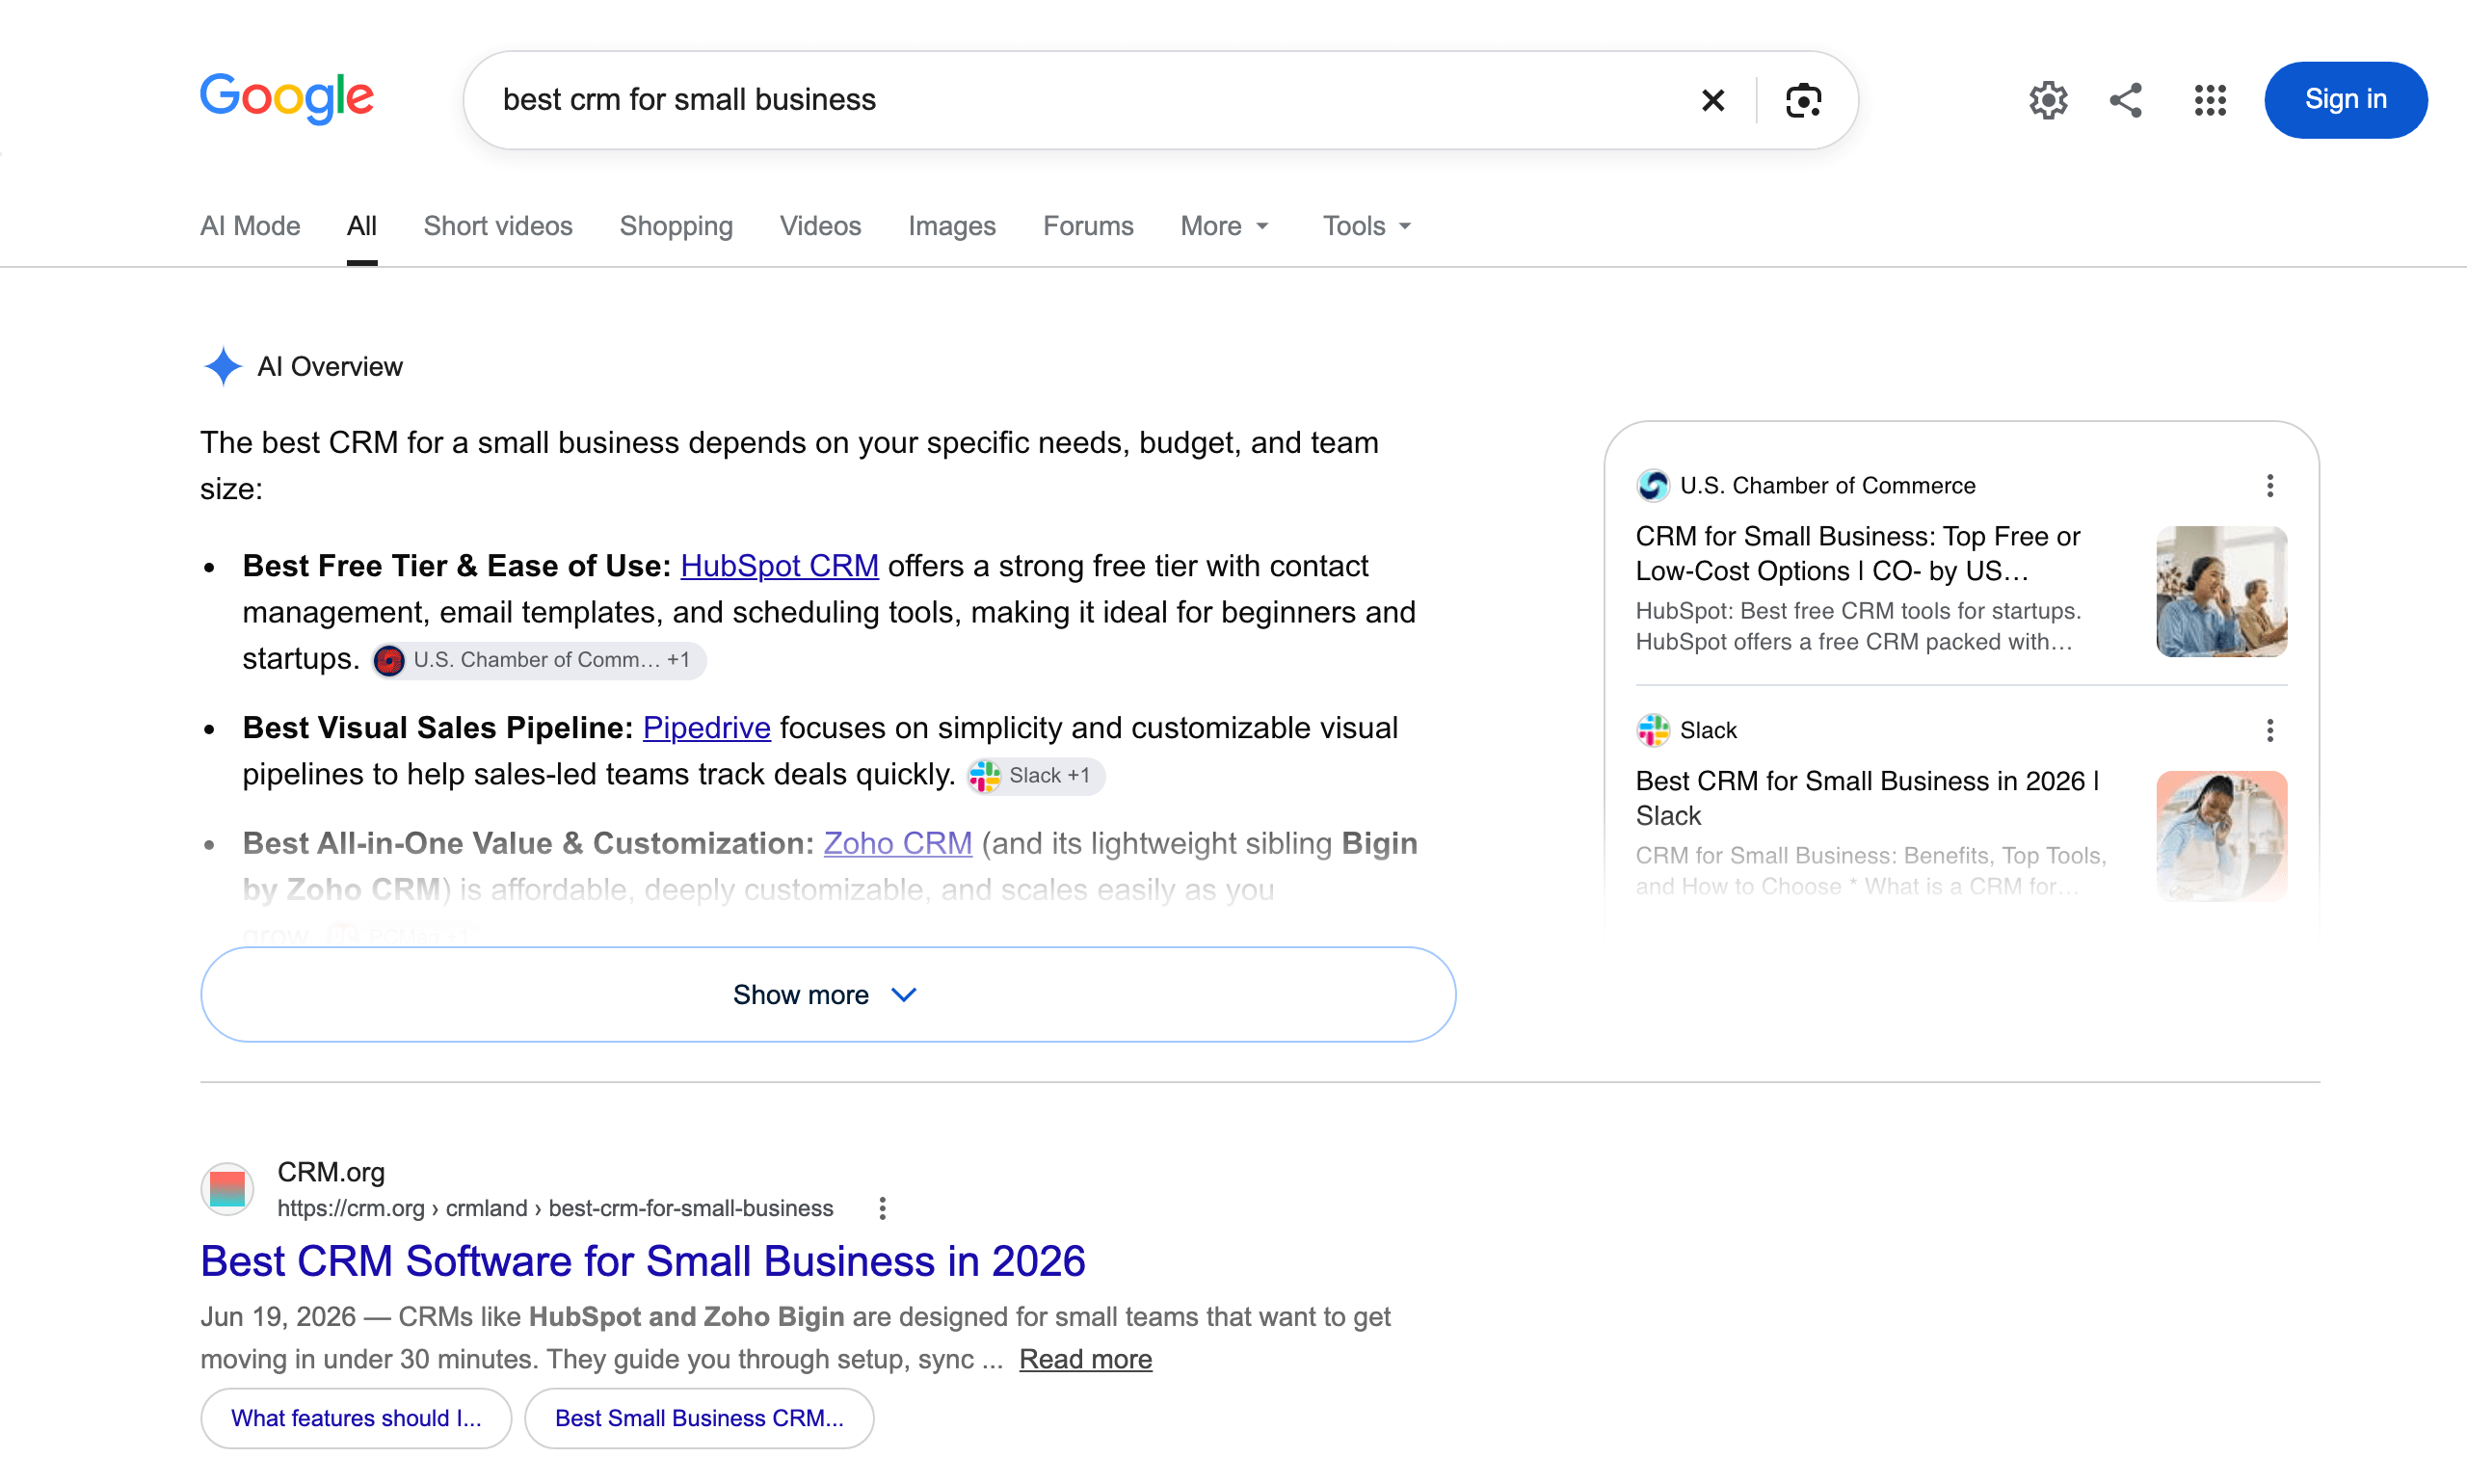
Google met à jour l’aperçu au fil du temps, la réponse peut donc changer entre les exécutions.
Les 15 aperçus citaient 64 sources, et les résultats Fast et Advanced de Parallel pour les mêmes requêtes en incluaient 7. Environ 9 pages sur 10 citées par l’IA de Google n’étaient pas dans les résultats de Parallel.
L’API SERP avec brd_json=1 renvoie la page complète en JSON analysé, avec l’aperçu dans un champ ai_overview et ses sources sous references. Un agent peut citer l’aperçu et vérifier quelles pages Google a citées.
SERP en direct vs. index de recherche : actualité, copies en cache et pages bloquées
L’API SERP récupère la page de Google au moment de la requête, ses résultats incluent donc les nouvelles histoires dès que Google les affiche. Pour 14 articles d’actualité que Google News a étiquetés comme datant de 20 minutes à 17 heures, j’ai interrogé Parallel avec des termes clés de chaque titre. Le mode Advanced a renvoyé l’URL exacte de l’article pour 9 des 14, y compris un article publié 55 minutes plus tôt. Le mode Fast en a renvoyé 6, et les 2 modes ensemble en ont trouvé 10.
Les 14 articles provenaient de Google News via l’API SERP, avec tbm=nws pour les résultats d’actualité et tbs=qdr:d pour la journée écoulée. Pour la surveillance de l’actualité, où chaque article manqué compte, interrogez Google News de la même manière.
Pour les pages complètes, l’API Extract de Parallel a renvoyé du contenu pour 15 des 18 pages de vente au détail, de voyage et d’annonces en 2,1 secondes ou moins. La page de tarifs de Parallel indiquait 1 à 3 secondes pour les pages en cache et 60 à 90 secondes pour les récupérations en direct. Ce timing correspond aux copies en cache, et une copie en cache peut afficher la mauvaise localisation pour votre utilisateur.
Les copies renvoyées par Extract affichaient une localisation de livraison que les requêtes ne demandaient pas. La page Target affichait “Ship to 51503 Council Bluffs” près du haut, et la page Walmart affichait “Sacramento, 95829” au même endroit. Si un agent cite des prix, des stocks ou des délais de livraison à un utilisateur à Austin, l’agent a besoin de la page pour la localisation de cet utilisateur. L’API SERP accepte le pays ou la ville à chaque requête, et Web Unlocker récupère la page au moment de la requête depuis le pays choisi.
Le site web de Parallel décrivait Parallel comme n’ayant “aucune capacité à atteindre un site ayant décidé de vous bloquer” et aucun déblocage pour ces sites. Web Unlocker est conçu pour les pages avec protection anti-bot, et les outils scrape_as_markdown et scrape_batch du serveur MCP acheminent les requêtes à travers lui.
Pages complètes via le serveur MCP : l’agent choisit ce qu’il lit
Dans le serveur MCP Bright Data, search_engine renvoie la liste de résultats de Google. scrape_batch renvoie ensuite les pages choisies par l’agent en Markdown complet dans un seul appel. Une clé API et un niveau gratuit fonctionnent pour les deux outils.
La liste de résultats est compacte, avec lien, titre et description par résultat. Sur les 30 requêtes de test, la liste avait une médiane d’environ 720 tokens avec le tokenizer o200k_base. Parallel renvoyait des extraits à chaque recherche à la place. Une réponse de 10 résultats avait une médiane de 5 438 tokens en mode Fast et de 4 082 tokens en mode Advanced.
Avec les extraits, chaque recherche ajoute le texte de l’extrait au contexte. Avec la liste de résultats compacte, seules les pages que l’agent ouvre ajoutent du texte de page. L’agent décide combien de pages ouvrir, il contrôle donc la quantité de texte de page ajoutée pour chaque réponse.
Les pages complètes conservent les tableaux, blocs de code et prix qu’un extrait peut omettre. Découpez les longues pages en segments et conservez les plus pertinents avant que le modèle ne rédige la réponse. La fenêtre de contexte contient alors ce dont la question a besoin.
Connectez le serveur MCP hébergé et chargez uniquement les 2 outils utilisés par ce flux de travail. Chaque outil chargé ajoute sa définition au contexte de l’agent avant le premier appel, moins d’outils gardent donc le contexte petit.
Ce .mcp.json pour Claude Code lit la clé depuis la variable d’environnement BRIGHTDATA_API_KEY. La clé n’est pas stockée dans le fichier ni affichée dans les URL journalisées :
{
  "mcpServers": {
    "bright-data": {
      "type": "http",
      "url": "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_batch",
      "headers": {
        "Authorization": "Bearer ${BRIGHTDATA_API_KEY}"
      }
    }
  }
}
Enregistrez-le sous .mcp.json à la racine de votre projet. Les clients prenant en charge les en-têtes personnalisés acceptent la même URL et le même en-tête dans leur propre format de configuration. Obtenez une clé API depuis les paramètres de votre compte Bright Data. La référence des outils MCP documente les outils et groupes d’outils.
Lors des tests, le serveur hébergé encapsulait la sortie de search_engine et scrape_batch dans des marqueurs les étiquetant comme données web non fiables. Les marqueurs indiquent au modèle de traiter chaque page comme des données plutôt que des instructions. Ils ajoutent une couche de protection contre l’injection de prompt qui fonctionne aux côtés des défenses propres de l’agent.
Quand choisir Bright Data ou Parallel
Le bon choix dépend de la tâche que l’outil de recherche effectue dans votre agent.
Choisissez Bright Data lorsque l’agent a besoin de la page de résultats en direct ou de la page complète :
- Ce que Google affiche au moment de la requête, y compris les classements, les AI Overviews, People Also Ask, les publicités, les résultats shopping et le pack de cartes
- Résultats pour un pays ou une ville spécifique
- Moteurs au-delà de Google, comme Bing, Baidu, Yandex et Naver
- Travaux par lots à fort volume, avec une simultanéité illimitée listée pour les forfaits Scale
- Pages complètes via Web Unlocker, conçu pour les sites protégés contre les bots, avec la même clé que la recherche
Choisissez Parallel lorsque l’agent a besoin d’extraits classés pour répondre :
- Pages classées avec extraits en un seul appel
- Modes Turbo et Fast à faible latence
- Un prix bas par recherche en Turbo et Fast
- Questions de recherche ouvertes où le classement de Google n’a pas d’importance
Certains agents effectuent les deux tâches. Dans ce cas, encapsulez les deux dans un seul outil de recherche qui achemine chaque requête selon l’intention. Les questions locales, commerciales et “ce que Google affiche” vont vers l’API SERP, et les questions de recherche ouvertes vers Parallel. Le même wrapper est un bon endroit pour journaliser chaque appel et fixer des limites de dépenses.
Certaines questions n’ont pas besoin de recherche. Lorsque l’agent vérifie les mêmes pages connues selon un calendrier, comme une page de tarifs chaque matin, récupérez-les directement via Web Unlocker. Une récupération directe évite de payer la même recherche à chaque vérification.
Les deux démarrent gratuitement. L’API SERP dispose d’un niveau gratuit mensuel récurrent sans carte de crédit requise. Parallel offrait 5 $ de crédits par mois lors des tests.
Méthodologie de test
Les résultats de chevauchement et de fonctionnalités SERP proviennent d’une seule configuration :
- Les mêmes 30 requêtes, en 6 groupes, ont été envoyées à Google via l’API SERP et aux 4 modes de Parallel.
- La localisation était réglée sur les États-Unis, et Google renvoyait des résultats de bureau en anglais.
- Chaque requête était l’objectif de Parallel et sa seule requête de recherche.
- La comparaison utilisait les 10 premières URL de chaque API, après suppression des balises de suivi comme le
srsltidde Google. - Chaque chiffre de chevauchement est la part moyenne par requête sur une exécution. Advanced et Fast ont été exécutés deux fois, et Turbo et Basic une fois, quelques heures plus tard.
- Les comptages de fonctionnalités SERP proviennent de la première exécution. Lors de la seconde exécution, les résultats de Parallel incluaient 6 des 61 sources citées par les AI Overviews.
Mesurer le chevauchement avec Google sur vos propres requêtes
Le chevauchement de Parallel avec Google dépend des requêtes. Échantillonnez 100 requêtes ou plus à partir des journaux de votre agent, réparties par type comme local, commercial et technique. Les requêtes journalisées incluent la variété que les requêtes de test écrites à la main manquent. Utilisez le niveau gratuit de l’API SERP pour la moitié Google du test.
Avant d’exécuter le script, obtenez une clé API Parallel et le nom de votre zone API SERP. Une zone est la configuration de produit nommée que chaque requête Bright Data spécifie. Pour en ajouter une, ouvrez le panneau de contrôle Bright Data et choisissez Créer une API > API SERP. Copiez le nom de la zone depuis son onglet Aperçu :
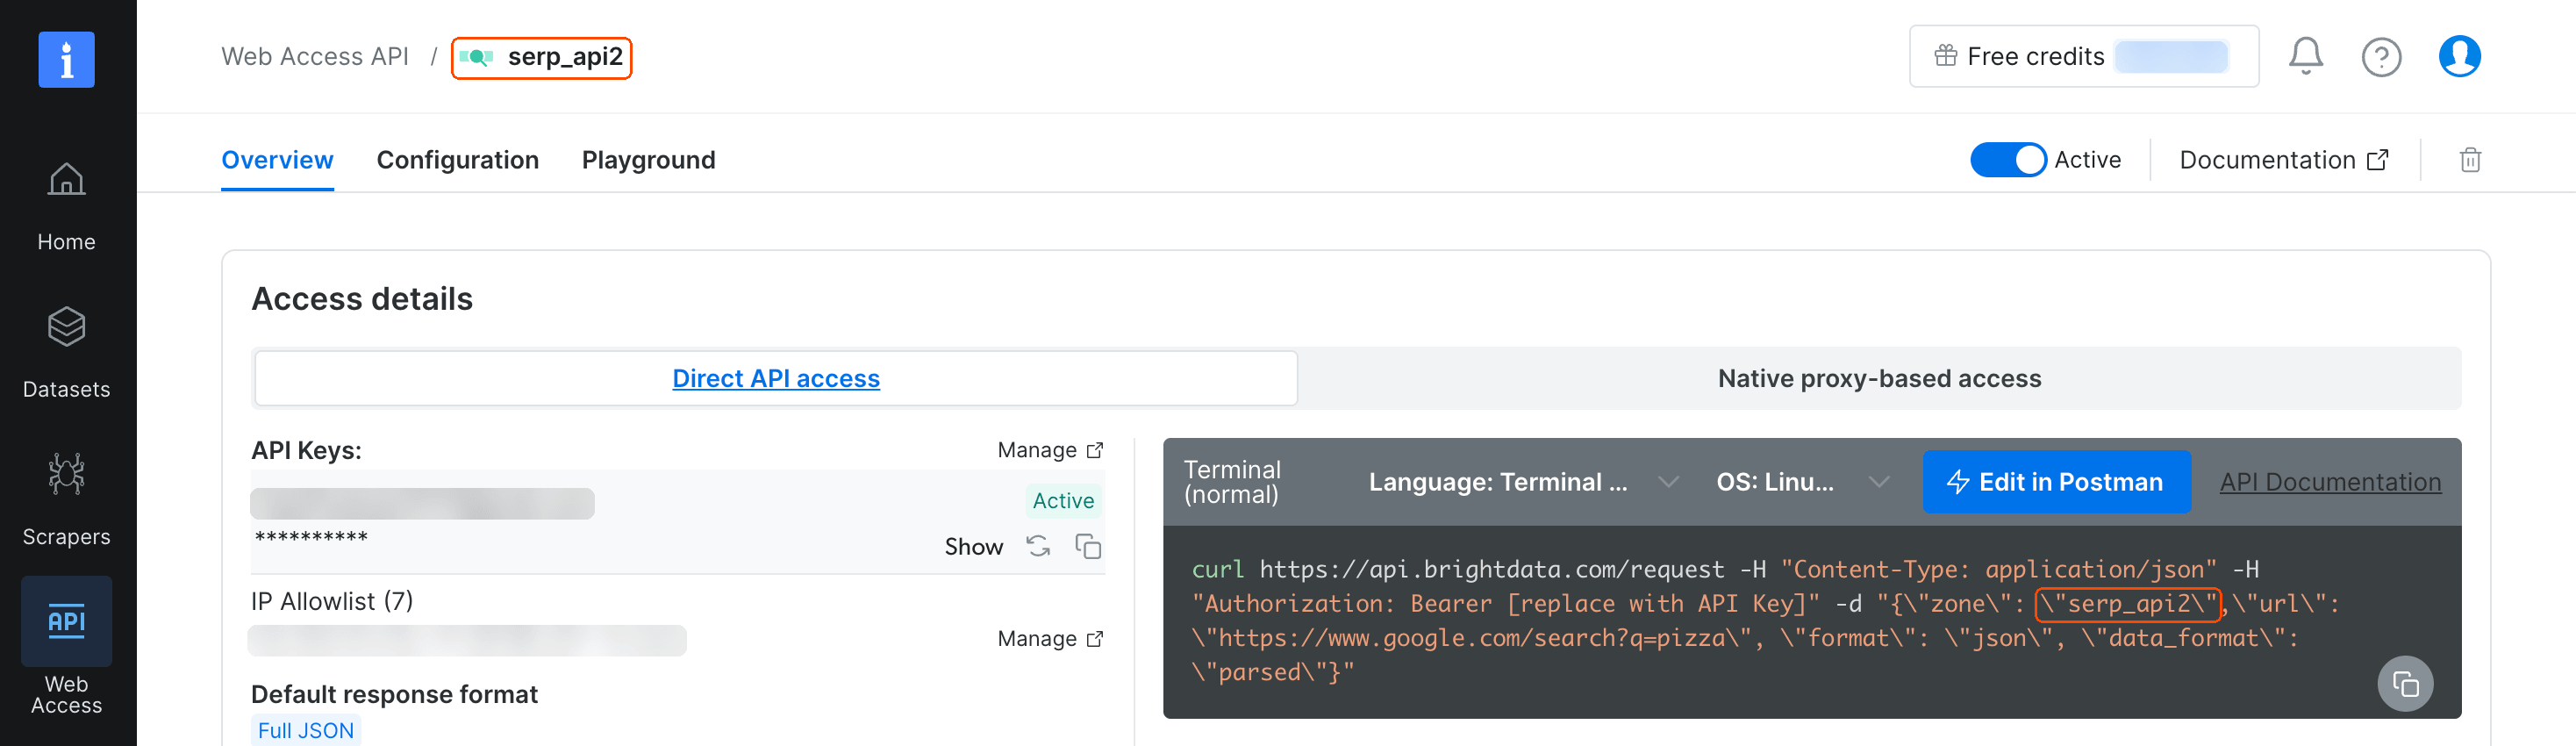
La clé API provient du lien Gérer sur la même page.
Enregistrez ce script sous overlap_check.py. Il accepte des requêtes en arguments et affiche combien des URL principales de Google apparaissent aussi dans les 10 premières de Parallel :
# /// script
# requires-python = ">=3.9"
# dependencies = ["requests"]
# ///
# Affiche combien des 10 premières URL de Google (via l'API SERP Bright Data)
# apparaissent aussi dans les 10 premières de Parallel. Nécessite BRIGHTDATA_API_KEY,
# BRIGHTDATA_SERP_ZONE et PARALLEL_API_KEY dans l'environnement.
import json
import os
import sys
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

BRIGHTDATA_API_KEY = os.environ["BRIGHTDATA_API_KEY"]
BRIGHTDATA_SERP_ZONE = os.environ["BRIGHTDATA_SERP_ZONE"]
PARALLEL_API_KEY = os.environ["PARALLEL_API_KEY"]
MODE = os.environ.get("PARALLEL_MODE", "advanced")
# Nom de localisation canonique facultatif, p. ex. "Chicago,Illinois,United States"
LOCATION = os.environ.get("GOOGLE_LOCATION", "")


session = requests.Session()
# Réessaie 429 (trop de requêtes), en attendant aussi longtemps que Retry-After le demande
session.mount("https://", HTTPAdapter(max_retries=Retry(
    total=3, status_forcelist=[429], allowed_methods=None,
    backoff_factor=1, raise_on_status=False)))


def post(url, headers, body, timeout):
    resp = session.post(url, headers=headers, json=body, timeout=timeout)
    resp.raise_for_status()
    return resp


def key(url):
    # Compare les URL sans schéma, "www.", fragment, barre oblique finale ou
    # balises de suivi comme le srsltid de Google, qui peuvent différer entre les requêtes
    parts = urllib.parse.urlsplit(url.lower().split("#")[0])
    query = urllib.parse.urlencode(
        [(k, v) for k, v in urllib.parse.parse_qsl(parts.query)
         if not k.startswith(("utm", "srsltid"))])
    host = parts.netloc.removeprefix("www.")
    return (host + parts.path).rstrip("/") + ("?" + query if query else "")


def google_top10(query):
    params = {"q": query, "gl": "us", "hl": "en", "brd_json": "1"}
    if LOCATION:
        params["uule"] = LOCATION
    body = {"zone": BRIGHTDATA_SERP_ZONE, "format": "raw",
            "url": "https://www.google.com/search?"
                   + urllib.parse.urlencode(params)}
    headers = {"Authorization": f"Bearer {BRIGHTDATA_API_KEY}"}
    resp = post("https://api.brightdata.com/request", headers, body, 120)
    # Bright Data rapporte le statut de la requête dans l'en-tête x-brd-error
    if resp.headers.get("x-brd-error"):
        raise RuntimeError(resp.headers["x-brd-error"])
    serp = resp.json()
    # Confirme que Google a appliqué la localisation avant d'utiliser les résultats
    city = LOCATION.split(",")[0]
    applied = serp.get("general", {}).get("location", "")
    if city and not applied.startswith(city):
        raise RuntimeError(f"Google n'a pas appliqué la localisation {LOCATION}")
    return [r["link"] for r in serp.get("organic", [])][:10]


def parallel_top10(query):
    body = {"objective": query, "search_queries": [query], "mode": MODE,
            "advanced_settings": {"location": "us", "max_results": 10}}
    resp = post("https://api.parallel.ai/v1/search",
                {"x-api-key": PARALLEL_API_KEY}, body, 60)
    return [r["url"] for r in resp.json()["results"]][:10]


def with_retries(fetch, query, attempts=3, pause=15):
    # Réessaie l'une ou l'autre API plusieurs fois, avec une pause entre les tentatives
    for attempt in range(attempts):
        try:
            return fetch(query)
        except (RuntimeError, requests.RequestException) as err:
            # Une réponse 4xx signifie que la requête elle-même doit être corrigée
            response = getattr(err, "response", None)
            if response is not None and response.status_code < 500:
                raise
            if attempt == attempts - 1:
                raise
            time.sleep(pause)


def compare(query):
    google = with_retries(google_top10, query)
    parallel = with_retries(parallel_top10, query)
    shared = {key(u) for u in google} & {key(u) for u in parallel}
    return {"query": query, "mode": MODE, "location": LOCATION,
            "shared": len(shared), "total": len({key(u) for u in google}),
            "google": google, "parallel": parallel}


def safe_compare(query):
    # Conserve les résultats des autres requêtes si une requête échoue
    try:
        return compare(query)
    except (RuntimeError, requests.RequestException) as err:
        return {"query": query, "error": str(err)}


# Les requêtes viennent des arguments, ou une par ligne sur stdin
queries = sys.argv[1:] or [line.strip() for line in sys.stdin if line.strip()]
# Exécute les requêtes en simultané et affiche les résultats dans l'ordre d'entrée
with ThreadPoolExecutor(max_workers=8) as pool:
    results = list(pool.map(safe_compare, queries))
# Conserve les URL brutes afin que les résultats puissent être re-notés sans nouvelles requêtes
with open("overlap_results.jsonl", "a") as f:
    f.writelines(json.dumps(r) + "\n" for r in results)
ok = [r for r in results if "error" not in r]
for r in results:
    if "error" in r:
        print(f"Erreur ({r['error']}) : {r['query']}")
    else:
        print(f"{r['shared']}/{r['total']} des URL principales de Google aussi dans "
              f"Parallel ({MODE}) : {r['query']}")
mean = sum(r["shared"] / max(r["total"], 1) for r in ok) / max(len(ok), 1)
noun = "requête" if len(ok) == 1 else "requêtes"
print(f"Moyenne sur {len(ok)} {noun} : {mean:.0%} des URL principales de Google "
      "aussi dans Parallel")
Le script comporte 6 parties :
google_top10récupère la première page de Google via l’API SERP avecbrd_json=1et vérifie que Google a appliqué la localisation.parallel_top10envoie la même requête à l’API de recherche de Parallel dans le mode choisi.keynormalise chaque URL, afin que la même page corresponde même lorsque les balises de suivi diffèrent.with_retriesréessaie l’une ou l’autre API plusieurs fois, avec une pause entre les tentatives.comparecompte les URL partagées par requête, et les dernières lignes affichent les résultats et enregistrent les URL brutes.safe_compareenregistre l’erreur lorsqu’une requête échoue, afin que les résultats des autres requêtes soient conservés.
Passez les requêtes en arguments, ou redirigez un fichier vers le script avec une requête par ligne. uv installe requests depuis l’en-tête du script à la première exécution. Sans uv, installez requests dans un environnement virtuel et exécutez le script avec python au lieu de uv run. Définissez le nom de la zone et les deux clés API, puis exécutez le script :
export BRIGHTDATA_API_KEY="votre-clé-api-bright-data"
export BRIGHTDATA_SERP_ZONE="votre-nom-de-zone-serp"
export PARALLEL_API_KEY="votre-clé-api-parallel"
uv run overlap_check.py "meilleur crm pour petite entreprise" \
  "performance index postgres jsonb" "dentiste ouvert samedi"
# Pour lire une requête par ligne depuis un fichier à la place, exécutez :
# uv run overlap_check.py < queries.txt
# Pour tester un autre mode Parallel, définissez-le d'abord, par exemple :
# export PARALLEL_MODE=fast
Si une ligne affiche une erreur 4xx, vérifiez le nom de la zone et les deux clés API. Pour ces 3 requêtes, une exécution a affiché :
2/9 des URL principales de Google aussi dans Parallel (advanced) : meilleur crm pour petite entreprise
4/9 des URL principales de Google aussi dans Parallel (advanced) : performance index postgres jsonb
1/9 des URL principales de Google aussi dans Parallel (advanced) : dentiste ouvert samedi
Moyenne sur 3 requêtes : 26 % des URL principales de Google aussi dans Parallel
La dernière ligne fait la moyenne de la part par requête, la même mesure que le tableau de chevauchement. Le 9 de chaque ligne est le nombre de résultats organiques sur la première page de Google pour cette requête. Les résultats changent entre les exécutions, et la requête Postgres a partagé 0 à 6 URL sur 9 exécutions. Basez une décision sur de nombreuses requêtes, et exécutez chaque requête plus d’une fois.
Chaque exécution ajoute aussi les URL brutes à overlap_results.jsonl. Vous pouvez re-noter ces résultats plus tard, par exemple avec une règle de correspondance d’URL différente, sans payer de nouvelles requêtes. Lorsque votre agent ou son trafic change, relancez la vérification sur un nouvel échantillon de vos journaux.
Définissez GOOGLE_LOCATION sur un nom de localisation canonique pour exécuter la vérification pour une seule ville américaine :
GOOGLE_LOCATION="Chicago,Illinois,United States" \
  uv run overlap_check.py "plombier urgence"
Avec Chicago, le script a affiché :
0/9 des URL principales de Google aussi dans Parallel (advanced) : plombier urgence
Moyenne sur 1 requête : 0 % des URL principales de Google aussi dans Parallel
Pour les requêtes de recherche ouvertes, où le classement de Google n’a pas d’importance, ajoutez 2 vérifications supplémentaires à la mesure de chevauchement. Vérifiez si les pages récupérées contiennent les preuves dont la réponse a besoin, et si la réponse est complète. Utilisez un juge LLM avec une grille écrite, et vérifiez le juge par rapport à un échantillon d’étiquettes humaines.
Réflexions finales
L’API SERP de Bright Data renvoie la page qu’une personne verrait dans une ville donnée, avec des fonctionnalités comme le pack de cartes et l’AI Overview. Sur 30 requêtes exécutées deux fois, le mode Advanced de Parallel a renvoyé 35 à 43 % des URL de la première page de Google, votre choix change donc ce que votre agent lit.
Pour le contenu de page complet, le serveur MCP récupère les pages avec la même clé API via Web Unlocker, conçu pour les sites avec protection anti-bot. Les extraits classés de Parallel conviennent bien aux questions de recherche ouvertes où le classement de Google n’a pas d’importance. Exécutez le script de chevauchement sur les requêtes journalisées de votre agent avec le niveau gratuit de l’API SERP, puis connectez le serveur MCP à votre agent.
FAQ
Qu’est-ce que la recherche web Parallel ?
La recherche web Parallel est une API de recherche que Parallel Web Systems a conçue pour les agents IA. Elle répond aux requêtes à partir de son propre index web avec des URL classées et des extraits Markdown, selon plusieurs modes de vitesse et de qualité. L’API SERP de Bright Data renvoie à la place la page de résultats en direct de Google, pour un pays ou une ville choisi.
La recherche Parallel est-elle gratuite ?
En partie. La page de tarifs de Parallel indiquait 5 $ de crédits gratuits par mois lors des tests, suffisant pour jusqu’à 5 000 recherches Turbo ou Fast. Les crédits nécessitaient une carte de crédit sur le compte, et le Search MCP hébergé de Parallel était gratuit sans clé API. L’API SERP de Bright Data inclut un niveau gratuit mensuel récurrent, sans carte de crédit requise.
Combien coûte l’API de recherche Parallel ?
La page de tarifs de Parallel indiquait 1 $ par 1 000 requêtes pour Turbo et Fast et 5 $ par 1 000 pour Basic et Advanced lors des tests. Chaque prix incluait 10 résultats, et les résultats supplémentaires coûtaient 1 $ par 1 000. L’API Extract de Parallel coûtait 1 $ par 1 000 URL. L’API SERP de Bright Data est en libre-service et ne facture que les requêtes réussies, avec les forfaits actuels sur sa page de tarifs.
Bright Data ou Parallel est-il meilleur pour les agents IA ?
Aucune des deux API n’est meilleure pour toutes les tâches. Choisissez Bright Data lorsque l’agent a besoin de la page de résultats en direct de Google, du ciblage par ville, des AI Overviews ou de pages avec protection anti-bot. Choisissez Parallel lorsque le classement de Google n’a pas d’importance, comme pour les questions de recherche ouvertes. Sur 30 requêtes de test exécutées deux fois, le mode Advanced de Parallel a renvoyé 35 à 43 % des URL de la première page de Google.
Quelle API est la meilleure pour la recherche web ?
Pour les agents ayant besoin de la page de résultats de Google, utilisez une API SERP comme celle de Bright Data. Elle renvoie la page de résultats en direct avec un ciblage au niveau de la ville et des fonctionnalités SERP comme les AI Overviews. Pour la recherche ouverte, une API d’index comme Parallel renvoie des extraits classés pour un objectif.