


Les proxys sont des adresses IP provenant d’un serveur qui se connecte à Internet en votre nom. Au lieu de transmettre directement vos requêtes aux sites web, les proxys les acheminent via un serveur, masquant votre adresse IP et votre localisation d’origine. Cela protège votre vie privée, empêche le suivi et évite les blocages. Les proxys chiffrent également vos données pour une sécurité renforcée.
Dans cet article, vous apprendrez à utiliser des proxys avec Python requests, notamment pour le scraping web. Le scraping web consiste à extraire des données de sites web, mais de nombreux sites ont des restrictions. Les proxys aident à contourner cela en changeant votre IP et votre localisation, rendant plus difficile votre détection et blocage par les sites web. Vous pouvez aussi utiliser plusieurs proxys pour distribuer les requêtes et accélérer le processus.
Ensuite, vous apprendrez à implémenter un proxy dans votre projet en utilisant le package Python Requests.
Comment Utiliser un Proxy avec une Requête Python
Afin d’utiliser un proxy avec une requête Python, vous devez établir un nouveau projet Python sur votre ordinateur pour écrire et exécuter les scripts Python de scraping web. Créez un répertoire (par exemple web_scrape_project) où vous stockerez vos fichiers de code source.
Tous les codes de ce tutoriel sont disponibles dans ce dépôt GitHub.
Installer les Packages
Après avoir créé votre répertoire, vous devez installer les packages Python suivants pour envoyer des requêtes à la page web et collecter les liens :
- La page web de Bright Data
Composants d’une Adresse IP Proxy
Avant d’utiliser un proxy, il est préférable de comprendre ses composants. Voici les trois composants principaux d’un serveur proxy :
- Protocole indique le type de contenu auquel vous pouvez accéder sur Internet. Les protocoles les plus courants sont HTTP et HTTPS.
- Adresse indique où se trouve le serveur proxy. L’adresse peut être une IP (par exemple
192.167.0.1) ou un nom d’hôte DNS (par exempleproxyprovider.com). - Port utilisé pour diriger le trafic vers le bon processus serveur lorsque plusieurs services s’exécutent sur une seule machine (par exemple numéro de port
2000).
En utilisant ces trois composants, une adresse IP proxy ressemblerait à ceci : 192.167.0.1:2000 ou proxyprovider.com:2000.
Comment Configurer des Proxys Directement dans Requests
Il existe plusieurs façons de configurer des proxys dans les requêtes Python, et dans cet article, vous examinerez trois scénarios différents. Dans ce premier exemple, vous apprendrez à configurer des proxys directement dans le module requests.
Pour commencer, vous devez importer les packages Requests et Beautiful Soup dans votre fichier Python pour le scraping web. Créez ensuite un répertoire appelé proxies contenant les informations du serveur proxy pour masquer votre adresse IP lors du scraping de la page web. Ici, vous devez définir à la fois les connexions HTTP et HTTPS à l’URL du proxy.
Vous devez également définir la variable Python pour définir l’URL de la page web dont vous souhaitez extraire les données. Pour ce tutoriel, l’URL est https://brightdata.com/
Ensuite, vous devez envoyer une requête GET à la page web en utilisant la méthode request.get(). Cette méthode prend deux arguments : l’URL du site web et les proxys. La réponse de la page web est ensuite stockée dans la variable response.
Pour collecter les liens, utilisez le package Beautiful Soup pour analyser le contenu HTML de la page web en passant response.content et html.parser comme arguments à la méthode BeautifulSoup().
Utilisez ensuite la méthode find_all() avec a comme argument pour trouver tous les liens sur la page web. Enfin, extrayez l’attribut href de chaque lien en utilisant la méthode get().
Voici le code source complet pour configurer des proxys directement dans requests :
# import packages.
import requests
from bs4 import BeautifulSoup

# Define proxies to use.
proxies = {
    'http': 'http://proxyprovider.com:2000',
    'https': 'http://proxyprovider.com:2000',
}

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
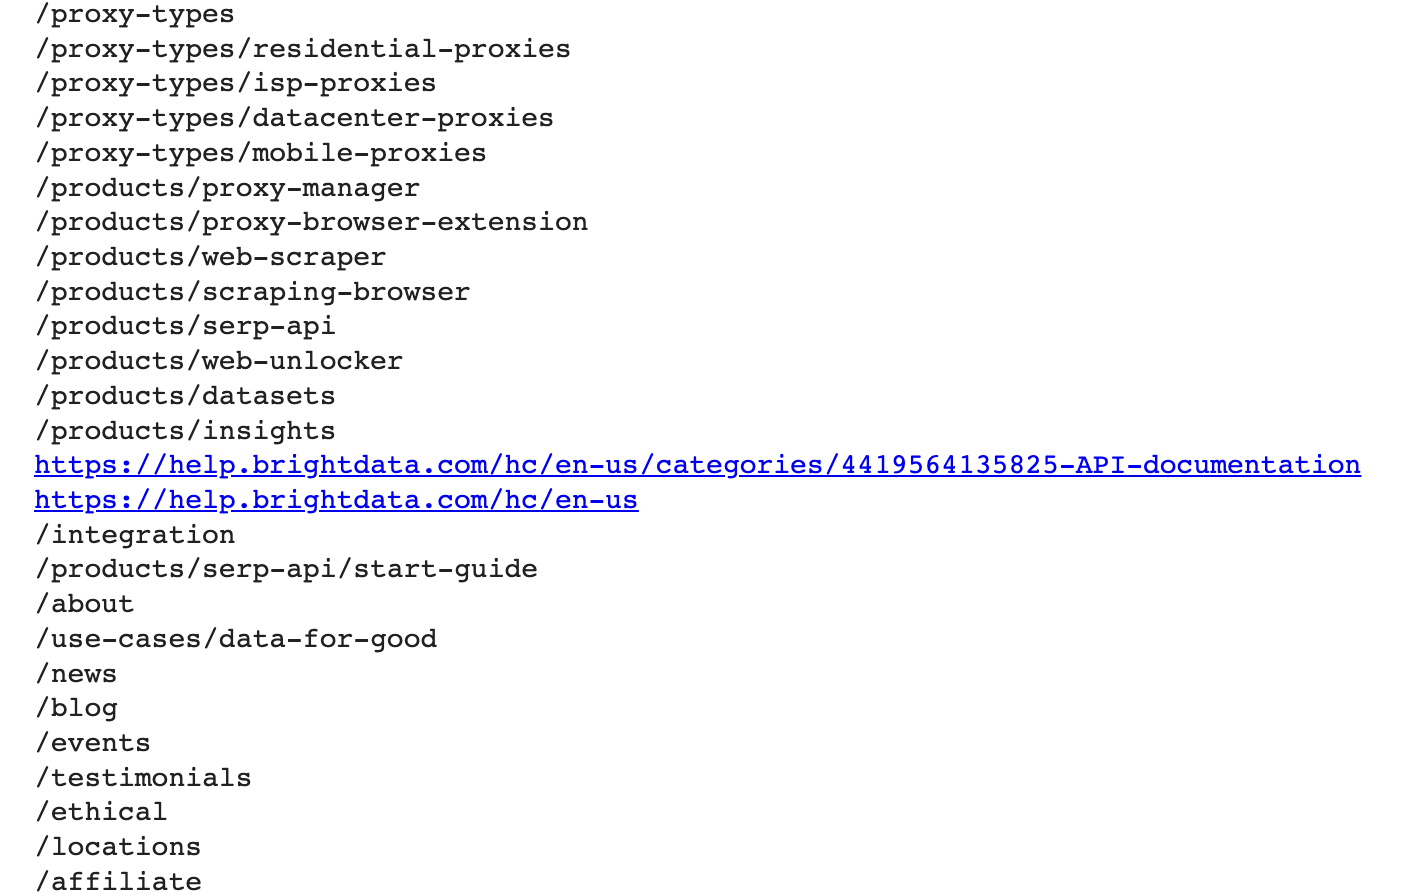
Lorsque vous exécutez ce bloc de code, il envoie une requête à la page web définie en utilisant l’adresse IP proxy, puis renvoie la réponse contenant tous les liens vers cette page web :
Comment Configurer des Proxys via des Variables d’Environnement
Parfois, vous devez utiliser le même proxy pour toutes vos requêtes vers différentes pages web. Dans ce cas, il est logique de définir des variables d’environnement pour votre proxy.
Pour rendre les variables d’environnement du proxy disponibles chaque fois que vous exécutez des scripts dans le shell, exécutez la commande suivante dans votre terminal :
export HTTP_PROXY='http://proxyprovider.com:2000'
export HTTPS_PROXY='https://proxyprovider.com:2000'
Ici, la variable HTTP_PROXY définit le serveur proxy pour les requêtes HTTP, et la variable HTTPS_PROXY définit le serveur proxy pour les requêtes HTTPS.
À ce stade, votre code Python comporte quelques lignes et utilise les variables d’environnement chaque fois que vous effectuez une requête vers la page web :
# import packages.
import requests
from bs4 import BeautifulSoup

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
Comment Faire Tourner des Proxys avec une Méthode Personnalisée et un Tableau de Proxys
La rotation des proxys est cruciale car les sites web bloquent ou restreignent souvent l’accès aux bots et scrapers lorsqu’ils reçoivent un grand nombre de requêtes depuis la même adresse IP. Lorsque cela se produit, les sites web peuvent soupçonner une activité de scraping malveillante et, par conséquent, mettre en place des mesures pour bloquer ou limiter l’accès.
En faisant tourner différentes adresses IP proxy, vous pouvez éviter d’être détecté, apparaître comme plusieurs utilisateurs organiques, et contourner la plupart des mesures anti-scraping mises en place sur le site web.
Afin de faire tourner les proxys, vous devez importer quelques bibliothèques Python : Requests, Beautiful Soup, et Random.
Créez ensuite une liste de proxys à utiliser pendant le processus de rotation. Cette liste doit contenir les URL des serveurs proxy dans ce format : http://proxyserver.com:port :
# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]
Créez ensuite une méthode personnalisée appelée get_proxy(). Cette méthode sélectionne aléatoirement un proxy dans la liste des proxys en utilisant la méthode random.choice() et renvoie le proxy sélectionné au format dictionnaire (clés HTTP et HTTPS). Vous utiliserez cette méthode chaque fois que vous enverrez une nouvelle requête :
# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}
Une fois que vous avez créé la méthode get_proxy(), vous devez créer une boucle qui envoie un certain nombre de requêtes GET en utilisant les proxys tournants. Dans chaque requête, la méthode get() utilise un proxy choisi aléatoirement spécifié par la méthode get_proxy().
Vous devez ensuite collecter les liens du contenu HTML de la page web en utilisant le package Beautiful Soup, comme expliqué dans le premier exemple.
Enfin, le code Python capture toutes les exceptions qui se produisent pendant le processus de requête et affiche le message d’erreur dans la console.
Voici le code source complet pour cet exemple :
# import packages
import requests
from bs4 import BeautifulSoup
import random

# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]


# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}


# Send requests using rotated proxies
for i in range(10):
    # Set the URL to scrape
    url = 'https://brightdata.com/'
    try:
        # Send a GET request with a randomly chosen proxy
        response = requests.get(url, proxies=get_proxy())

        # Use BeautifulSoup to parse the HTML content of the website.
        soup = BeautifulSoup(response.content, "html.parser")

        # Find all the links on the website.
        links = soup.find_all("a")

        # Print all the links.
        for link in links:
            print(link.get("href"))
    except requests.exceptions.RequestException as e:
        # Handle any exceptions that may occur during the request
        print(e)
Utiliser le Service Proxy Bright Data avec Python
Si vous recherchez un proxy fiable, rapide et stable pour vos tâches de scraping web, ne cherchez pas plus loin que Bright Data, une infrastructure de données web qui propose différents types de proxys pour un large éventail de cas d’usage.
Bright Data dispose d’un vaste réseau de plus de 400M+ monthly IPs proxy résidentielles et de plus de 770 000 proxys de centre de données qui les aident à fournir des solutions proxy fiables et rapides. Leurs offres de proxy sont conçues pour vous aider à surmonter les défis du scraping web, de la vérification des publicités, et d’autres activités en ligne nécessitant une collecte de données web anonyme et efficace.
Intégrer les proxys de Bright Data dans vos requêtes Python est facile. Par exemple, utilisez les proxys de centre de données pour envoyer une requête à l’URL utilisée dans les exemples précédents.
Si vous n’avez pas encore de compte, inscrivez-vous chez Bright Data, puis ajoutez vos informations pour enregistrer votre compte.
Une fois cela fait, suivez ces étapes pour créer votre premier proxy :
Cliquez sur View proxy product sur la page d’accueil pour voir les différents types de proxy proposés par Bright Data :

Sélectionnez Datacenter Proxies pour créer un nouveau proxy, et sur la page suivante, ajoutez vos informations, puis enregistrez-le :

Une fois votre proxy créé, vous pouvez consulter les paramètres importants (par exemple hôte, port, nom d’utilisateur et mot de passe) pour commencer à y accéder et l’utiliser :
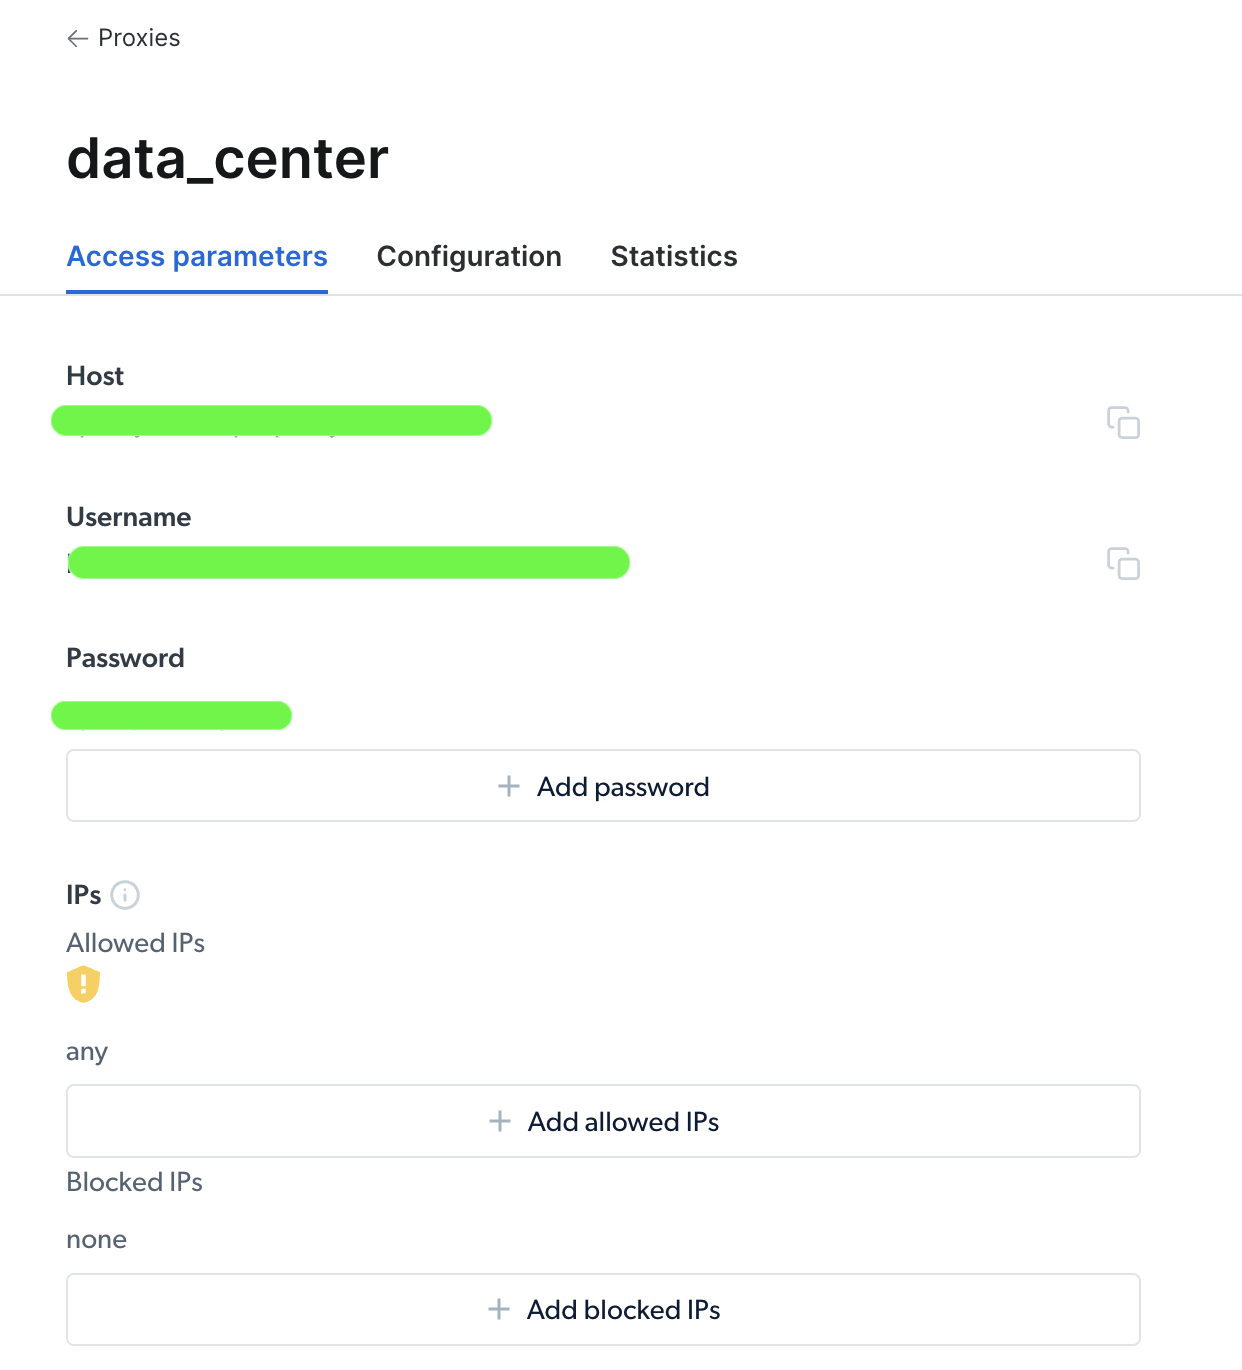
Une fois que vous avez accédé à votre proxy, vous pouvez utiliser les informations de paramètres pour configurer votre URL proxy et envoyer une requête en utilisant le package Python Requests. Le format de l’URL proxy est username-(session-id)-password@host:port.
Remarque : Le
session-idest un nombre aléatoire créé en utilisant un package Python appelérandom.
Voici à quoi ressemblerait votre exemple de code pour configurer votre proxy de Bright Data dans une requête Python :
import requests
from bs4 import BeautifulSoup
import random

# Define parameters provided by Brightdata
host = 'brd.superproxy.io'
port = 33335
username = 'username'
password = 'password'
session_id = random.random()

# format your proxy
proxy_url = ('http://{}-session-{}:{}@{}:{}'.format(username, session_id,
                                                     password, host, port))

# define your proxies in dictionary
proxies = {'http': proxy_url, 'https': proxy_url}

# Send a GET request to the website
url = "https://brightdata.com/"
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website
links = soup.find_all("a")

# Print all the links
for link in links:
    print(link.get("href"))
Ici, vous importez les packages et définissez les variables hôte, port, nom d’utilisateur, mot de passe et session_id du proxy. Vous créez ensuite un dictionnaire proxies avec les clés http et https et les identifiants du proxy. Enfin, vous passez le paramètre proxies à la fonction requests.get() pour effectuer la requête HTTP et collecter les liens depuis l’URL.
Et voilà ! Vous venez de réaliser une requête réussie en utilisant le service proxy de Bright Data.
Conclusion
Dans cet article, vous avez appris pourquoi vous avez besoin de proxys ainsi que les différentes façons de les utiliser pour envoyer une requête à une page web en utilisant le package Python Requests.
Avec l’infrastructure web de Bright Data, vous pouvez obtenir des proxys fiables pour votre projet couvrant n’importe quel pays ou ville dans le monde. Ils proposent plusieurs façons d’obtenir les données dont vous avez besoin grâce à divers types de proxys et outils de scraping web adaptés à vos besoins spécifiques.
Que vous cherchiez à collecter des données d’étude de marché, à surveiller les avis en ligne, ou à suivre les prix de la concurrence, Bright Data dispose des ressources nécessaires pour réaliser le travail rapidement et efficacement.


