---
title: "Comment utiliser ChromeDriver indétectable pour le Scraping web"
slug: web-scraping-with-undetected-chromedriver
date: 2026-02-16T08:01:20+00:00
modified: 2026-04-27T09:03:59+00:00
permalink: https://brightdata.fr/blog/donnees-web/web-scraping-with-undetected-chromedriver
type: blog
---
[ Blog ](https://brightdata.fr/blog "Blog") / [Données Web](https://brightdata.fr/blog/donnees-web)
[Données Web](https://brightdata.fr/blog/donnees-web)
# Comment utiliser ChromeDriver indétectable pour le Scraping web
Découvrez comment Undetected ChromeDriver permet de contourner les systèmes anti-bot pour le Scraping web, ainsi que des conseils étape par étape, des méthodes avancées et les principales limitations.
13 min de lecture
[  ](https://brightdata.com/blog/authors/antonello-zanini)
[Antonello Zanini
Technical Writer
](https://brightdata.com/blog/authors/antonello-zanini)

Dans ce guide, vous apprendrez :
- Ce qu’est Undetected ChromeDriver et en quoi il peut être utile
- Comment il minimise la détection des bots
- Comment l’utiliser avec Python pour le Scraping web
- Son utilisation avancée et ses méthodes
- Ses principales limites et inconvénients
- Technologies similaires
Plongeons-nous dans le vif du sujet !
## Qu’est-ce que Undetected ChromeDriver ?
[Undetected ChromeDriver](https://github.com/ultrafunkamsterdam/undetected-chromedriver)est une bibliothèque Python qui fournit une version optimisée du ChromeDriver de Selenium. Elle a été modifiée afin de limiter la détection par les services anti-bot tels que :
- Imperva
- DataDome
- Distil Networks
Elle peut également aider à contourner certaines protections Cloudflare, bien que cela puisse s’avérer plus difficile. Pour plus de détails, suivez notre guide sur[la manière de contourner Cloudflare](/blog/web-data/bypass-cloudflare).
Si vous avez déjà utilisé[des outils d’automatisation de navigateur](/blog/web-data/best-headless-browsers)tels que Selenium, vous savez qu’ils vous permettent de contrôler les navigateurs par programmation. Pour ce faire, ils configurent les navigateurs différemment des configurations utilisateur habituelles.
Les systèmes anti-bots recherchent ces différences, ou « fuites », afin d’identifier les bots de navigateur automatisés. ChromeDriver, qui passe inaperçu, modifie les pilotes Chrome afin de minimiser ces signes révélateurs, réduisant ainsi la détection des bots. Cela le rend idéal pour les sites de Scraping web protégés par[des mesures anti-scraping](/blog/web-data/anti-scraping-techniques)!
## Comment ça marche
Undetected ChromeDriver réduit la détection par Cloudflare, Imperva, DataDome et d’autres solutions similaires en utilisant les techniques suivantes :
- Renommer les variables Selenium pour imiter celles utilisées par les navigateurs réels
- Utilisation de chaînes User-Agent légitimes et réelles pour éviter la détection
- Permettre à l’utilisateur de simuler une interaction humaine naturelle
- Gestion correcte des cookies et des sessions lors de la navigation sur les sites web
- Activation de l’utilisation de Proxies pour contourner le blocage des adresses IP et empêcher la limitation du débit
Ces méthodes aident le navigateur contrôlé par la bibliothèque à contourner efficacement diverses défenses anti-scraping.
## Utilisation de ChromeDriver non détecté pour le Scraping web : guide étape par étape
La plupart des sites utilisent des mesures anti-bot avancées pour empêcher les scripts automatisés d’accéder à leurs pages. Ces mécanismes bloquent également efficacement[les robots de Scraping web](/blog/how-tos/what-is-a-scraping-bot).
Par exemple, supposons que vous souhaitiez extraire le titre et la description de la[page produit GoDaddy](https://www.godaddy.com/hosting/wordpress-hosting) suivante :
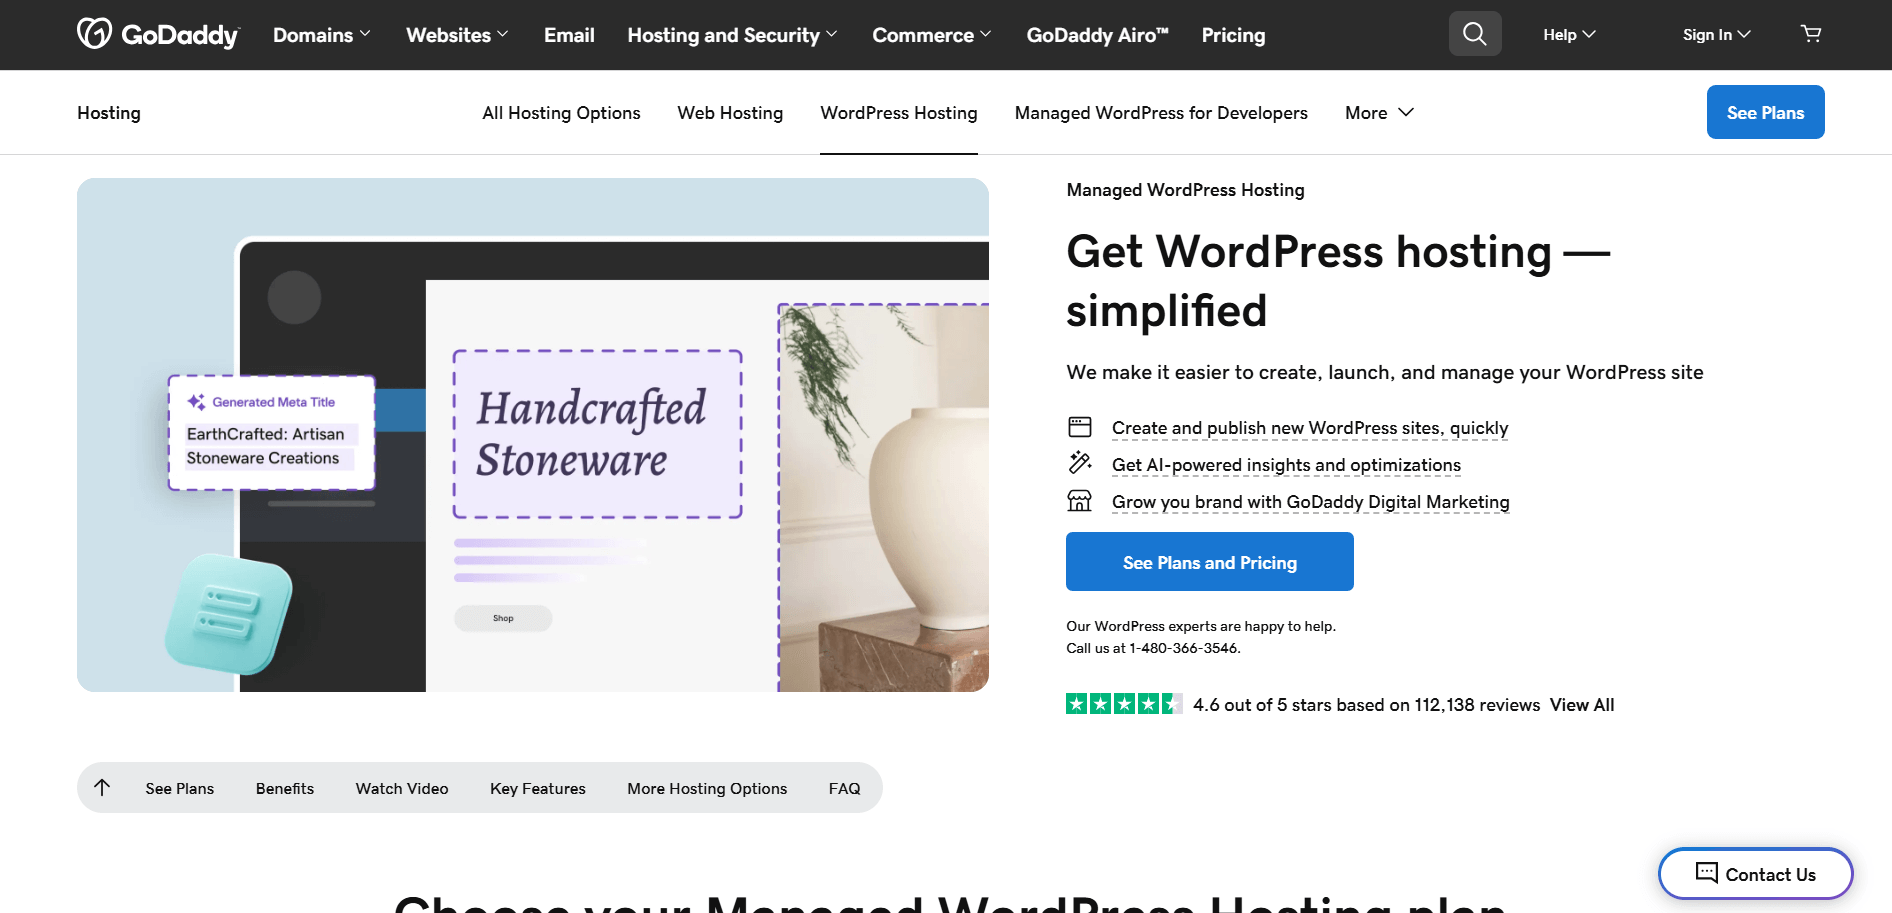Avec Selenium en Python, votre script de scraping ressemblera à ceci :
```none
# pip install selenium
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.common.by import By
# configure une instance Chrome pour démarrer en mode headless
options = Options()
options.add_argument("--headless")
# créer une instance de pilote web Chrome
driver = webdriver.Chrome(service=Service(), options=options)
# se connecter à la page cible
driver.get("https://www.godaddy.com/hosting/wordpress-hosting")
# logique de scraping...
# fermer le navigateur
driver.quit()
```
Si vous n’êtes pas familier avec cette logique, consultez notre guide sur[le Scraping web Selenium](/blog/how-tos/using-selenium-for-web-scraping).
Lorsque vous exécutez le script, il échoue en raison de cette page d’erreur :
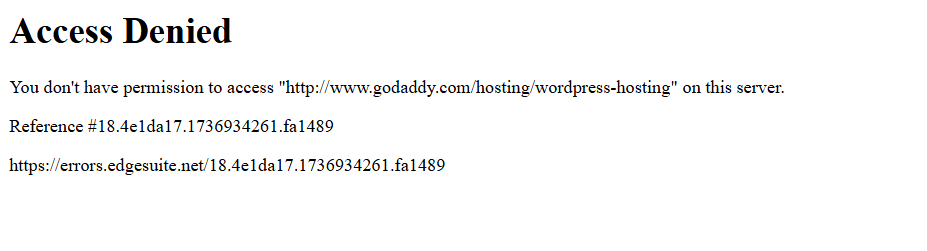En d’autres termes, le script Selenium a été bloqué par une solution anti-bot (Akamai, dans cet exemple).
Alors, comment contourner cela ? La réponse est Undetected ChromeDriver !
Suivez les étapes ci-dessous pour apprendre à utiliser la bibliothèque Python `undetected_chromedriver` pour le Scraping web.
### Étape n° 1 : prérequis et configuration du projet
Undetected ChromeDriver nécessite les prérequis suivants :
- **Dernière version de Chrome**
- **Python 3.6+**: si Python 3.6 ou une version ultérieure n’est pas installé sur votre ordinateur,[téléchargez-le depuis le site officiel](https://www.python.org/downloads/)et suivez les instructions d’installation.
**Remarque**: la bibliothèque télécharge et corrige automatiquement le fichier binaire du pilote pour vous, il n’est donc pas nécessaire de télécharger manuellement[`ChromeDriver`](https://developer.chrome.com/docs/chromedriver/downloads).
À présent, utilisez la commande suivante pour créer un répertoire pour votre projet :
```none
mkdir undetected-chromedriver-Scraper
```
Le répertoire `undetected-chromedriver-scraper` servira de dossier de projet pour votre Scraper Python.
Accédez-y et initialisez un[environnement virtuel](https://docs.python.org/3/library/venv.html):
```none
cd undetected-chromedriver-Scraper
python -m venv env
```
Ouvrez le dossier du projet dans votre IDE Python préféré.[Visual Studio Code avec l’extension Python](https://code.visualstudio.com/docs/languages/python)ou[PyCharm Community Edition](https://www.jetbrains.com/pycharm/download/#section=windows)sont deux excellents choix.
Ensuite, créez un fichier`scraper.py`dans le dossier du projet, en suivant la structure indiquée ci-dessous :
Actuellement,`scraper.py`est un script Python vide. Vous y ajouterez bientôt la logique de scraping.
Dans le terminal de votre IDE, activez l’environnement virtuel. Sous Linux ou macOS, utilisez :
```none
./env/bin/activate
```
De manière équivalente, sous Windows, exécutez :
```none
env/Scripts/activate
```
Génial ! Vous disposez désormais d’un environnement Python prêt pour le Scraping web via l’automatisation du navigateur.
### Étape n° 2 : installer Undetected ChromeDriver
Dans un environnement virtuel activé, installez Undetected ChromeDriver via le paquet pip[`undetected_chromedriver`](https://pypi.org/project/undetected-chromedriver/):
```none
pip install undetected_chromedriver
```
En arrière-plan, cette bibliothèque installera automatiquement Selenium, car il s’agit de l’une de ses dépendances. Vous n’avez donc pas besoin d’installer Selenium séparément. Cela signifie également que vous aurez accès à toutes les importations `Selenium` par défaut.
### Étape n° 3 : configuration initiale
Importez `undetected_chromedriver`:
```none
import undetected_chromedriver as uc
```
Vous pouvez ensuite initialiser un Chrome WebDriver avec :
```none
driver = uc.Chrome()
```
Tout comme Selenium, cela ouvrira une fenêtre de navigateur que vous pourrez contrôler à l’aide de l’API Selenium. Cela signifie que l’objet `driver` expose toutes les méthodes Selenium standard, ainsi que certaines fonctionnalités supplémentaires que nous explorerons plus tard.
**La principale différence est que cette version du pilote Chrome est corrigée pour aider à contourner certaines solutions anti-bot.**
Pour fermer le pilote, il suffit d’appeler la méthode `quit()`:
```none
driver.quit()
```
Voici à quoi ressemble une configuration de base de ChromeDriver non détecté :
```none
import undetected_chromedriver as uc
# Initialiser une instance Chrome
driver = uc.Chrome()
# Logique de scraping...
# Fermer le navigateur et libérer ses ressources
driver.quit()
```
Fantastique ! Vous êtes maintenant prêt à effectuer le Scraping web directement dans le navigateur.
### Étape n° 4 : Utilisez-le pour le Scraping web
**Avertissement**: cette section suit les mêmes étapes qu’une configuration Selenium standard. Si vous êtes déjà familiarisé avec le Scraping web Selenium, n’hésitez pas à passer à la section suivante avec le code final.
Commencez par utiliser la méthode `get()` pour naviguer dans le navigateur jusqu’à la page cible :
```none
driver.get("https://www.godaddy.com/hosting/wordpress-hosting")
```
Ensuite, visitez la page en mode incognito dans votre navigateur et inspectez l’élément que vous souhaitez extraire :
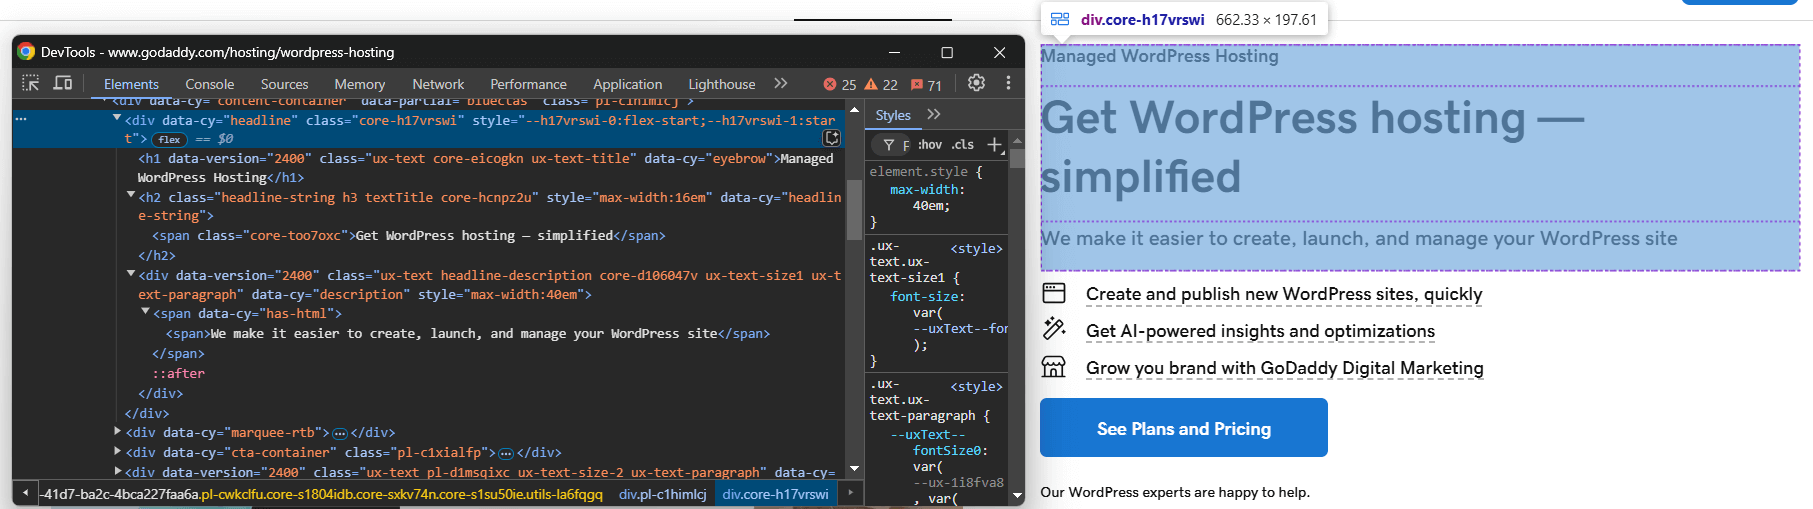Supposons que vous souhaitiez extraire le titre, le slogan et la description du produit.
Vous pouvez extraire tous ces éléments à l’aide du code suivant :
```none
headline_element = driver.find_element(By.CSS_SELECTOR, "[data-cy="headline"]")
title_element = headline_element.find_element(By.CSS_SELECTOR, "h1")
title = title_element.text
tagline_element = headline_element.find_element(By.CSS_SELECTOR, "h2")
tagline = tagline_element.text
description_element = headline_element.find_element(By.CSS_SELECTOR, "[data-cy="description"]")
description = description_element.text
```
Pour que le code ci-dessus fonctionne, vous devez importer `By` depuis Selenium :
```none
from selenium.webdriver.common.by import By
```
Enregistrez maintenant les données extraites dans un dictionnaire Python :
```none
product = {
"title": title,
"tagline": tagline,
"description": description
}
```
Enfin, exportez les données vers un fichier JSON :
```none
with open("product.json", "w") as json_file:
json.dump(product, json_file, indent=4)
```
N’oubliez pas d’importer `json` depuis la bibliothèque standard Python :
```none
import json
```
Et voilà ! Vous venez d’implémenter la logique de base du Scraping web Undetected ChromeDriver.
### Étape n° 5 : assembler le tout
Voici le script de scraping final :
```none
import undetected_chromedriver as uc
from selenium.webdriver.common.by import By
import json
# Créer une instance de Chrome Web Driver
driver = uc.Chrome()
# Se connecter à la page cible
driver.get("https://www.godaddy.com/hosting/wordpress-hosting")
# Logique de scraping
headline_element = driver.find_element(By.CSS_SELECTOR, "[data-cy="headline"]")
title_element = headline_element.find_element(By.CSS_SELECTOR, "h1")
title = title_element.text
tagline_element = headline_element.find_element(By.CSS_SELECTOR, "h2")
tagline = tagline_element.text
description_element = headline_element.find_element(By.CSS_SELECTOR, "[data-cy="description"]")
description = description_element.text
# Remplir un dictionnaire avec les données extraites
produit = {
"title": titre,
"tagline": slogan,
"description": description
}
# Exporter les données extraites au format JSON
avec open("produit.json", "w") comme json_file :
json.dump(produit, json_file, indent=4)
# Fermer le navigateur et libérer ses ressources
driver.quit()
```
Exécutez-le avec :
```none
python3 Scraper.py
```
Ou, sous Windows :
```none
python Scraper.py
```
Cela ouvrira un navigateur affichant la page Web cible, et non la page d’erreur comme avec Selenium vanilla :
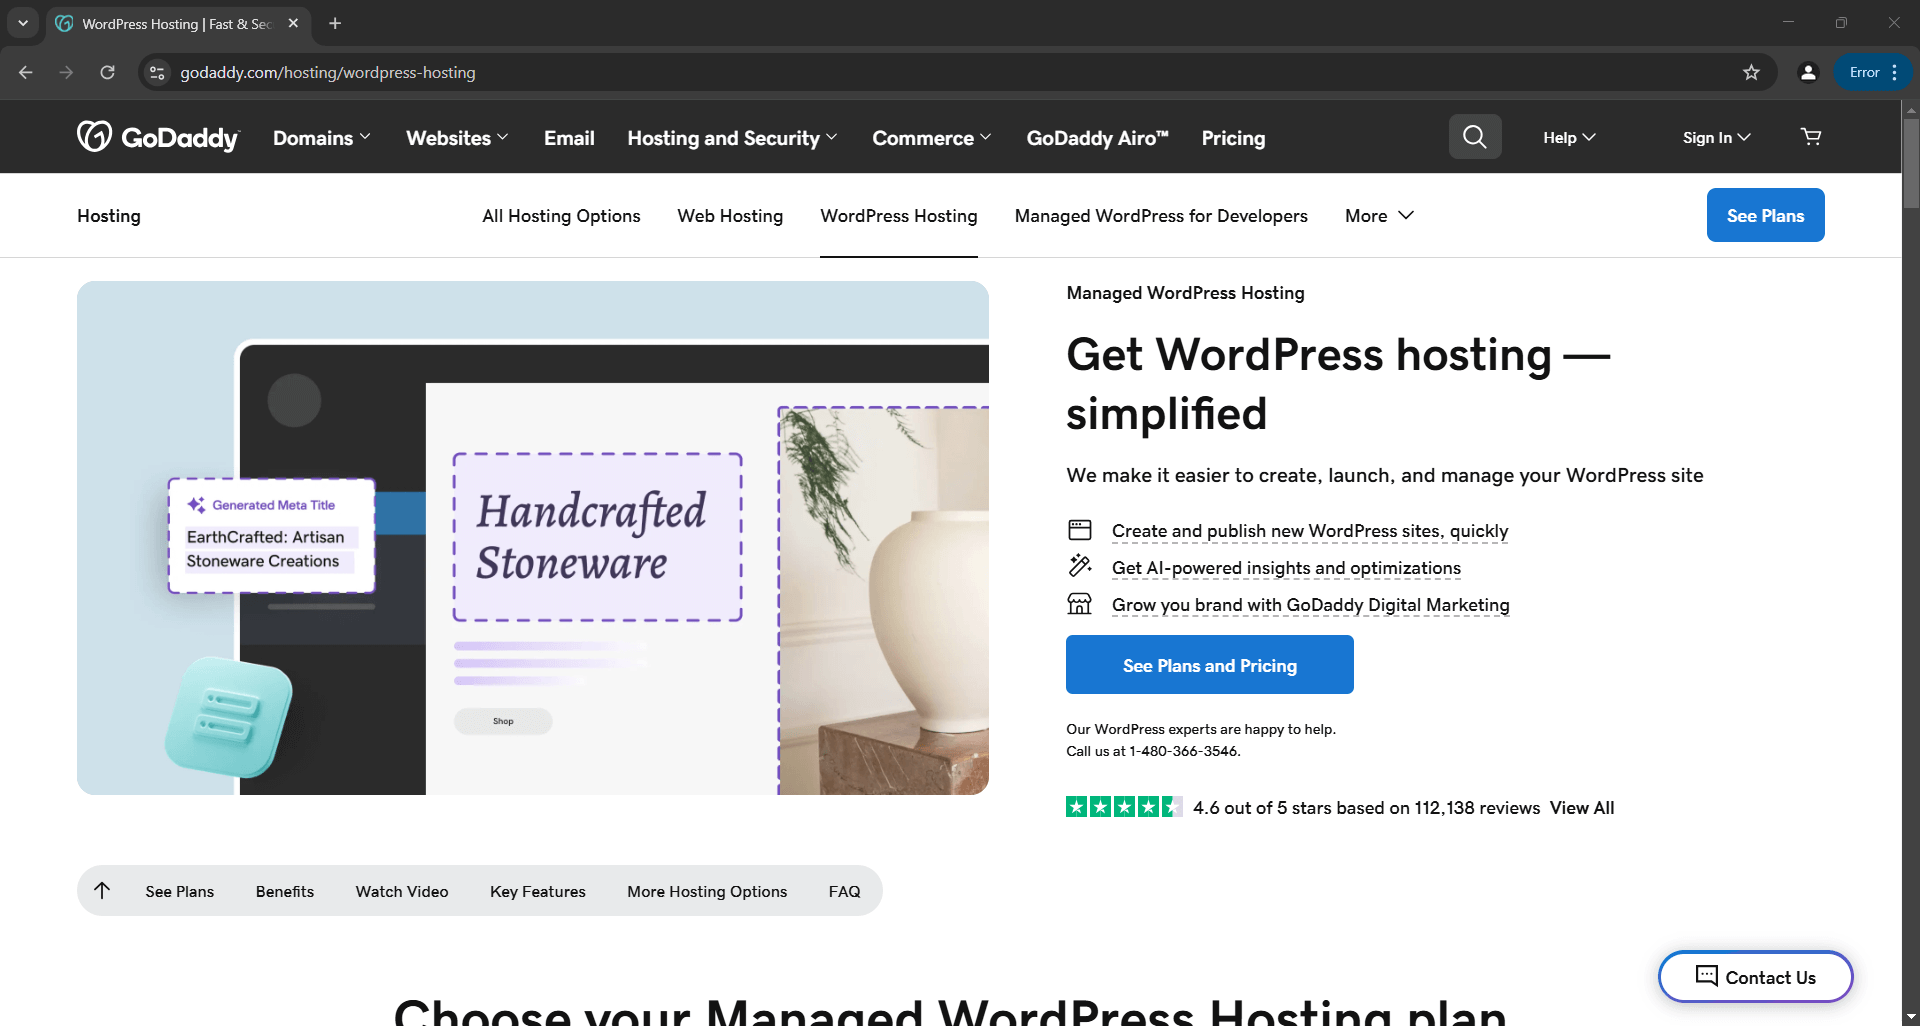Le script extraira les données de la page et produira le fichier `product.json` suivant :
```none
{
"title": "Hébergement WordPress géré",
"tagline": "Obtenez un hébergement WordPress simplifié",
"description": "Nous facilitons la création, le lancement et la gestion de votre site WordPress"
}
```
## `undetected_chromedriver`: utilisation avancée
Maintenant que vous savez comment fonctionne la bibliothèque, vous êtes prêt à explorer des scénarios plus avancés.
### Choisissez une version spécifique de Chrome
Vous pouvez spécifier une version particulière de Chrome à utiliser par la bibliothèque en définissant l’argument `version_main`:
```none
import undetected_chromedriver as uc
# Spécifiez la version cible de Chrome
driver = uc.Chrome(version_main=105)
```
Notez que la bibliothèque fonctionne également avec d’autres navigateurs basés sur Chromium, mais cela nécessite quelques ajustements supplémentaires.
### `avec` Sytnax
Pour éviter d’appeler manuellement la méthode`quit()`lorsque vous n’avez plus besoin du pilote, vous pouvez utiliser la syntaxe[`with`](https://docs.python.org/3/reference/compound_stmts.html#with)comme indiqué ci-dessous :
```none
import undetected_chromedriver as uc
with uc.Chrome() as driver:
driver.get("")
```
Lorsque le code à l’intérieur du bloc `with` est terminé, Python ferme automatiquement le navigateur pour vous.
**Remarque**: cette syntaxe est prise en charge à partir de la version 3.1.0.
### Intégration d’un Proxy
La syntaxe pour ajouter un Proxy à Undetected ChromeDriver est similaire à celle de Selenium. Il suffit de passer votre URL Proxy au drapeau `--proxy-server` comme indiqué ci-dessous :
```none
import undetected_chromedriver as uc
proxy_url = ""
options = uc.ChromeOptions()
options.add_argument(f"--proxy-server={proxy}")
```
**Remarque**: Chrome ne prend pas en charge les Proxys authentifiés via le drapeau `--proxy-server`.
### API étendue
`undetected_chromedriver` étend les fonctionnalités standard de Selenium avec certaines méthodes, notamment :
- `WebElement.click_safe()`: utilisez cette méthode si le fait de cliquer sur un lien entraîne une détection. Bien que son fonctionnement ne soit pas garanti, elle offre une approche alternative pour des clics plus sûrs.
- `WebElement.children(tag=None, recursive=False)`: cette méthode vous aide à trouver facilement les éléments enfants. Par exemple :
```none
# Obtenir le 6e enfant (de n'importe quelle balise) dans le corps, puis trouver tous les éléments ![]() de manière récursive.
images = body.children()[6].children("img", True)
```
## Limitations de la bibliothèque Python `undetected_chromedriver`
Bien que `undetected_chromedriver` soit une bibliothèque Python puissante, elle présente certaines limites connues. Voici les plus importantes que vous devez connaître !
### Blocages IP
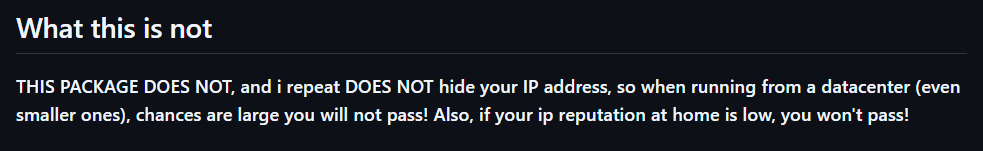
La page GitHub de la bibliothèque l’indique clairement :**le package ne masque pas votre adresse IP**. Ainsi, si vous exécutez un script à partir d’un centre de données, il y a de fortes chances que la détection ait toujours lieu. De même, si votre adresse IP personnelle a une mauvaise réputation, vous risquez également d’être bloqué !
[Pour masquer votre adresse IP](/blog/how-tos/five-ways-to-hide-your-ip-address), vous devez intégrer le navigateur contrôlé à un Proxy, comme démontré précédemment.
### Pas de prise en charge de la navigation GUI
En raison du fonctionnement interne du module, vous devez naviguer par programmation à l’aide de la méthode `get()`. Évitez d’utiliser l’interface graphique du navigateur pour la navigation manuelle : interagir avec la page à l’aide de votre clavier ou de votre souris augmente le risque de détection !
La même règle s’applique à la gestion des nouveaux onglets. Si vous devez travailler avec plusieurs onglets, ouvrez un nouvel onglet avec une page vierge en utilisant l’URL `data: (` oui, y compris la virgule) `,` que le pilote accepte. Ensuite, poursuivez avec votre logique d’automatisation habituelle.
Ce n’est qu’en respectant ces consignes que vous pourrez minimiser le risque de détection et profiter de sessions de Scraping web plus fluides.
### Prise en charge limitée du mode sans affichage
Officiellement, le mode sans affichage n’est pas entièrement pris en charge par la bibliothèque `undetected_chromedriver`. Cependant, vous pouvez l’essayer en utilisant la syntaxe suivante :
```none
driver = uc.Chrome(headless=True)
```
L’auteur a annoncé dans le journal des modifications de la version 3.4.5 que le mode headless devrait fonctionner et garantir la capacité de contournement des bots. Cependant, il reste instable. Utilisez cette fonctionnalité avec prudence et effectuez des tests approfondis pour vous assurer qu’elle répond à vos besoins en matière de scraping.
### Problèmes de stabilité
Comme mentionné sur la page PyPI du package, les résultats peuvent varier en fonction de nombreux facteurs. Aucune garantie n’est fournie, si ce n’est des efforts continus pour comprendre et contrer les algorithmes de détection.
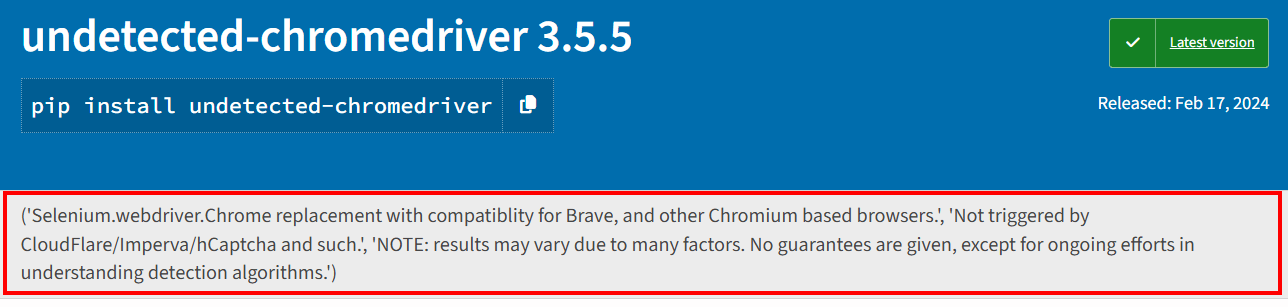Cela signifie qu’un script qui contourne aujourd’hui avec succès Distil, Cloudflare, Imperva, DataDome ou hCaptcha pourrait échouer demain si les solutions anti-bot sont mises à jour :
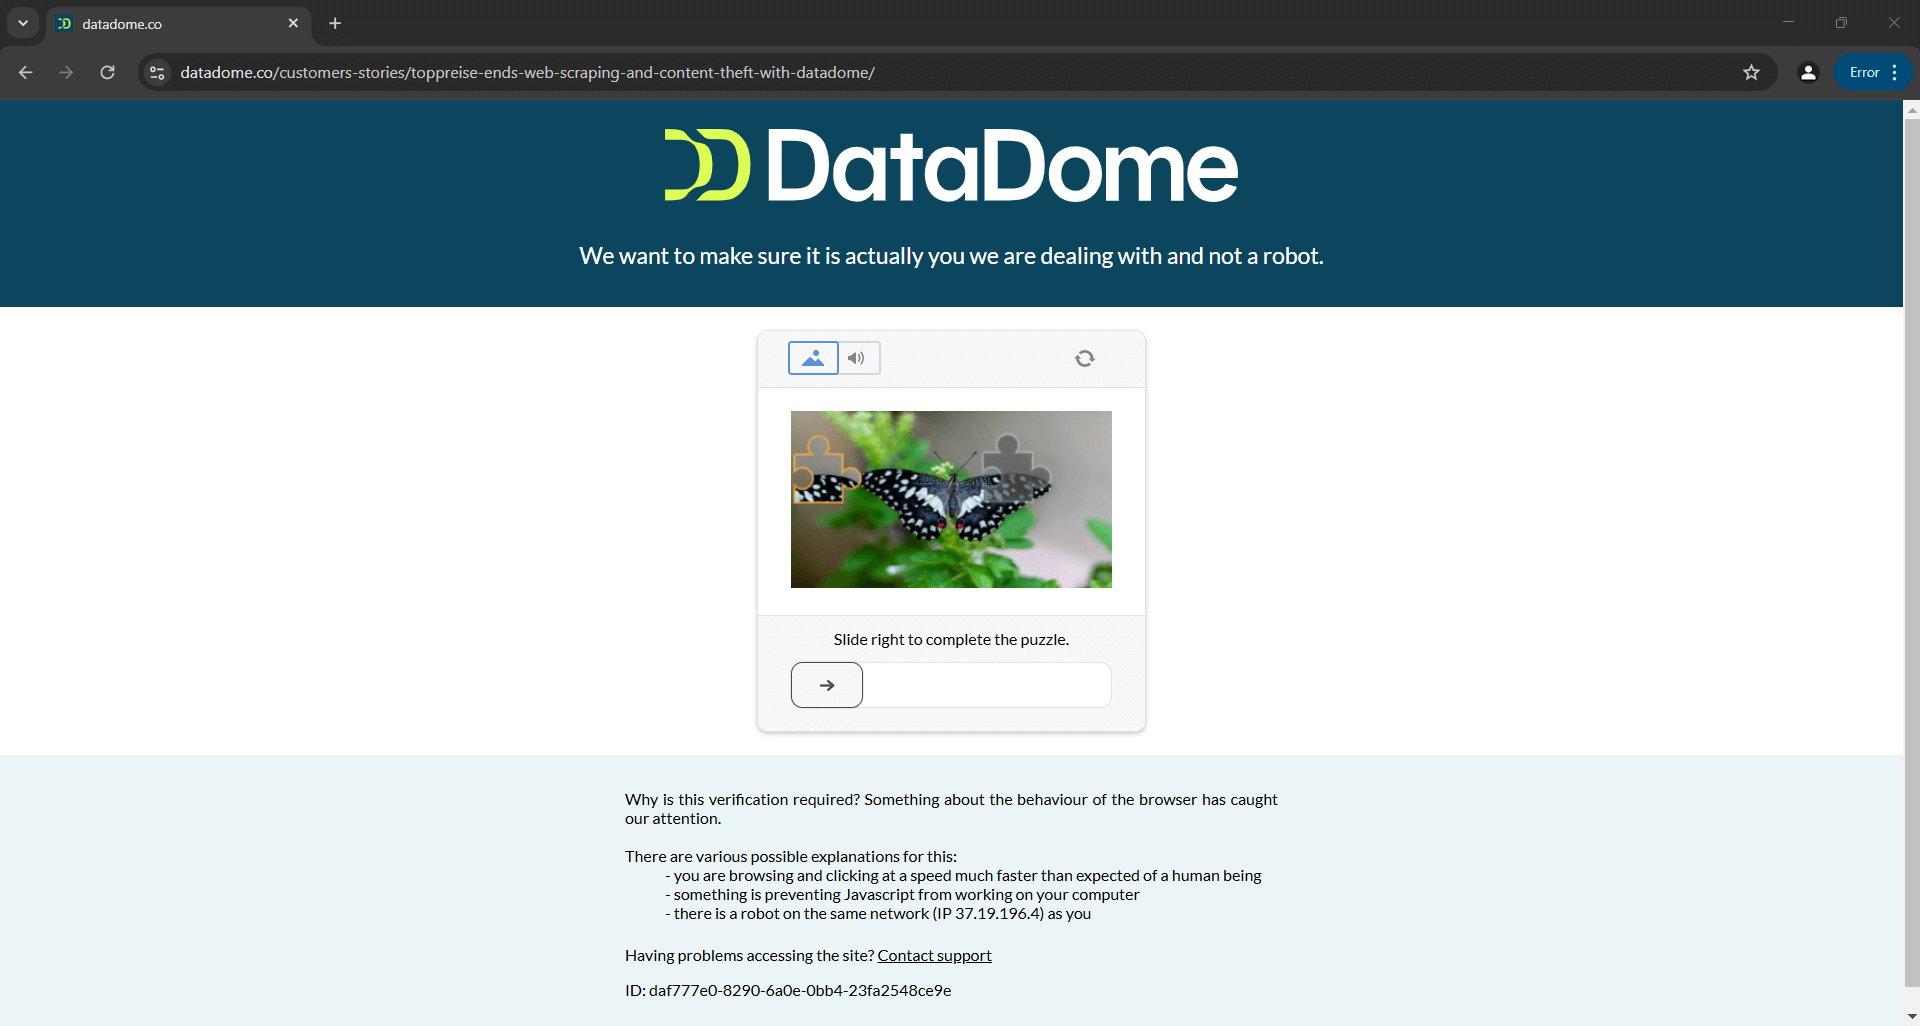L’image ci-dessus est le résultat d’un script fourni dans la documentation officielle. Cela démontre que même les scripts créés par les développeurs de l’outil peuvent ne pas toujours fonctionner comme prévu. Plus précisément, le script a déclenché un CAPTCHA, qui peut facilement bloquer votre logique d’automatisation.
Pour en savoir plus, consultez notre guide sur[la manière de contourner les CAPTCHA en Python](/blog/web-data/bypass-captchas-with-python).
## Lectures complémentaires
Undetected ChromeDriver n’est pas la seule bibliothèque qui modifie les pilotes de navigateur pour empêcher leur détection. Si vous souhaitez découvrir des outils similaires ou en savoir plus sur ce sujet, consultez ces guides :
- [Évitez d’être bloqué avec Puppeteer Stealth](/blog/how-tos/avoid-getting-blocked-with-puppeteer-stealth)
- [Évitez la détection des bots avec Playwright Stealth](/blog/how-tos/avoid-bot-detection-with-playwright-stealth)
- [Guide du Scraping web avec SeleniumBase](/blog/web-data/web-scraping-with-seleniumbase)
## Conclusion
Dans cet article, vous avez compris comment gérer la détection des bots dans Selenium à l’aide d’Undetected ChromeDriver. Cette bibliothèque fournit une version corrigée de ChromeDriver pour le Scraping web sans être bloqué.
Le problème est que les technologies anti-bot avancées telles que Cloudflare seront toujours en mesure de détecter et de bloquer vos scripts. Les bibliothèques telles que `undetected_chromedriver` sont instables : elles peuvent fonctionner aujourd’hui, mais ne fonctionneront peut-être plus demain.
Le problème ne réside pas dans l’API de Selenium pour contrôler un navigateur, mais dans les paramètres du navigateur lui-même. Cela implique que la solution est un navigateur basé sur le cloud, toujours mis à jour, évolutif et doté d’une fonctionnalité intégrée de contournement anti-bot. Ce navigateur existe, et il s’appelle[Navigateur de scraping](/products/scraping-browser)!
Le Navigateur de scraping de Bright Data est un navigateur cloud hautement évolutif qui fonctionne avec[Selenium](/products/scraping-browser/selenium),[Puppeteer](/products/scraping-browser/puppeteer),[Playwright](/products/scraping-browser/playwright) et bien d’autres. Il peut gérer pour vous l’empreinte digitale du navigateur, la résolution CAPTCHA et les nouvelles tentatives automatisées. De plus, il fait automatiquement tourner l’IP de sortie à chaque requête. Cela est possible grâce au réseau mondial de Proxy qui comprend :
- [Proxy de centre de données](/proxy-types/datacenter-proxies)– Plus de 770 000 adresses IP de centres de données.
- [Proxys résidentiels](/proxy-types/residential-proxies)– Plus de 72 millions d’IPs résidentielles dans plus de 195 pays.
- [Proxy ISP](/proxy-types/isp-proxies)– Plus de 700 000 adresses IP FAI.
- [Proxy mobile](/proxy-types)– Plus de 7 millions d’adresses IP mobiles.
Créez dès aujourd’hui un compte Bright Data gratuit pour essayer notre Navigateur de scraping ou tester nos Proxy.
Contacter ventesEssai gratuit
Table des matières
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Comment+utiliser+ChromeDriver+ind%C3%A9tectable+pour+le+Scraping+web&u=https://brightdata.fr/blog/donnees-web/web-scraping-with-undetected-chromedriver) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Comment+utiliser+ChromeDriver+ind%C3%A9tectable+pour+le+Scraping+web&url=https://brightdata.fr/blog/donnees-web/web-scraping-with-undetected-chromedriver) [ ](http://www.reddit.com/submit?title=Comment+utiliser+ChromeDriver+ind%C3%A9tectable+pour+le+Scraping+web&url=https://brightdata.fr/blog/donnees-web/web-scraping-with-undetected-chromedriver)
## Vous pourriez aussi être intéressé par
[  ](https://brightdata.fr/blog/ai/openhuman-with-bright-data "Accès Web Prêt pour la Production dans OpenHuman via le CLI Bright Data")
[AI

Antonello Zanini
Technical Writer
### Accès Web Prêt pour la Production dans OpenHuman via le CLI Bright Data
Intégrez le CLI Bright Data avec OpenHuman pour permettre un accès web prêt pour la production et la collecte de données pour les agents IA.
09-Sep-2026
14 min de lecture
](https://brightdata.fr/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.fr/blog/donnees-web/multimodal-web-scraping-with-minimax "Scraping Web Multimodal avec MiniMax")
[Données Web

Antonello Zanini
Technical Writer
### Scraping Web Multimodal avec MiniMax
Associez Bright Data Web Unlocker avec la vision MiniMax M3 pour extraire des données structurées à partir d’images et de captures d’écran de pages web.
09-Sep-2026
5 min de lecture
](https://brightdata.fr/blog/donnees-web/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.fr/blog/ai/best-cli-tools-for-codex "Les 10 meilleurs outils CLI pour Codex en 2026 – Testés & Classés")
[AI

Daniel Shashko
Web Data & AI Expert
### Les 10 meilleurs outils CLI pour Codex en 2026 – Testés & Classés
Les 10 outils CLI qui rendent Codex plus rapide et plus capable, en commençant par le Bright Data CLI pour un accès web réel depuis l’intérieur du sandbox.
06-Sep-2026
24 min de lecture
](https://brightdata.fr/blog/ai/best-cli-tools-for-codex)