---
title: "Scraping web avec Google Sheets"
slug: web-scraping-with-google-sheets
date: 2026-02-18T06:41:26+00:00
modified: 2026-02-18T06:41:44+00:00
permalink: https://brightdata.fr/blog/donnees-web/web-scraping-with-google-sheets
type: blog
---
[ Blog ](https://brightdata.fr/blog "Blog") / [Données Web](https://brightdata.fr/blog/donnees-web)
[Données Web](https://brightdata.fr/blog/donnees-web)
# Scraping web avec Google Sheets
Simplifiez le Scraping web avec Google Sheets en utilisant IMPORTXML et IMPORTHTML pour extraire facilement des données à partir de sites web.
11 min de lecture
[  ](https://brightdata.com/blog/authors/vivek-kumar-singh)
[Vivek Kumar Singh
](https://brightdata.com/blog/authors/vivek-kumar-singh)

Le scraping web est le processus qui consiste à extraire du contenu et des données de sites web à l’aide de scripts ou d’outils logiciels automatisés. Les informations extraites sont ensuite généralement exportées vers un format plus utile, tel qu’un fichier brut ou CSV, pour faciliter leur utilisation.
Si vous cherchez à simplifier vos workflows de Scraping web,[Google Sheets](https://workspace.google.com/intl/en_ca/products/sheets/)est là pour vous aider. Il s’agit d’un outil de gestion de données très populaire, idéal pour extraire des données structurées ou tabulaires à partir de sites web et pour analyser ou visualiser vos données. Vous pouvez par exemple l’utiliser pour extraire les détails et les prix des produits à partir de sites de commerce électronique ou pour récupérer les coordonnées à partir d’annuaires professionnels. Il est également utile pour suivre l’engagement sur les réseaux sociaux ou pour effectuer des analyses de l’opinion publique afin de mesurer l’efficacité des campagnes.
Dans ce tutoriel, vous apprendrez à configurer et à utiliser Google Sheets pour le Scraping web.
## Configurer vos Google Sheets
Pour commencer le Scraping web avec Google Sheets, vous devez créer une nouvelle feuille Google Sheet en vous rendant sur[https://sheets.google.com](https://sheets.google.com/)et en cliquant sur le bouton**+**:
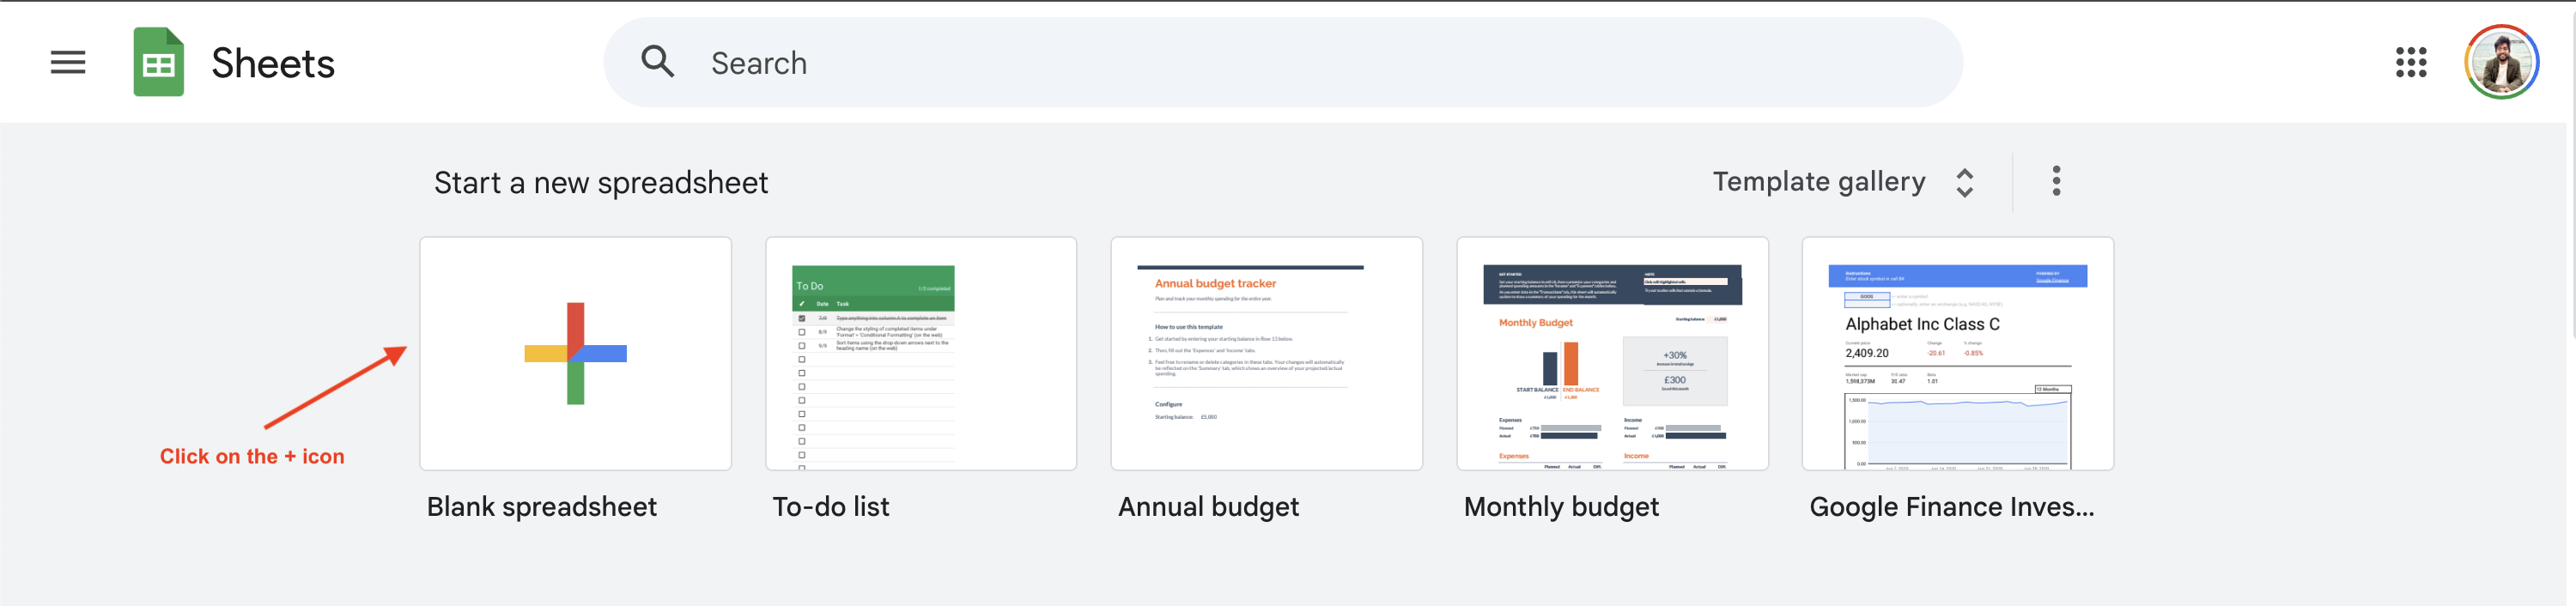Ce tutoriel montre comment extraire les informations sur les prix des livres à partir du[site web**Books to Scrape**](https://books.toscrape.com/catalogue/category/books/default_15/index.html), mais vous pouvez utiliser un autre site web en modifiant l’URL et les requêtes suivantes.
## Comprendre les formules de Google Sheets
Google Sheets prend en charge[de](https://support.google.com/docs/table/25273?hl=en)nombreuses[formules de cellule](https://support.google.com/docs/table/25273?hl=en)qui peuvent être utilisées pour diverses opérations, y compris le Scraping web. Voyons comment certaines de ces formules fonctionnent.
### IMPORTXML
La fonction[`IMPORTXML`](https://support.google.com/docs/answer/3093342?sjid=2557491900941403739-NC)vous permet d’interroger et d’importer des données structurées dans Google Sheets. Elle prend en charge les formats de fichiers XML, HTML, CSV et TSV. La syntaxe de la fonction est la suivante :
```none
=IMPORTXML(url, xpath_query)
```
La fonction importe les données à partir de l’URL Web spécifiée et utilise le localisateur[XPath](https://developer.mozilla.org/en-US/docs/Web/XPath)pour trouver l’élément pertinent sur la page Web. Par exemple, vous pouvez extraire le titre`H1`du site Web**Books to Scrape**en ajoutant la formule suivante dans une cellule Google Sheets :
```none
=IMPORTXML("https://books.toscrape.com/catalogue/category/books/default_15/index.html", "//h1")
```
Lors de la première utilisation, Google Sheets vous invite à autoriser l’accès avant de récupérer des données à partir de sites Web tiers :
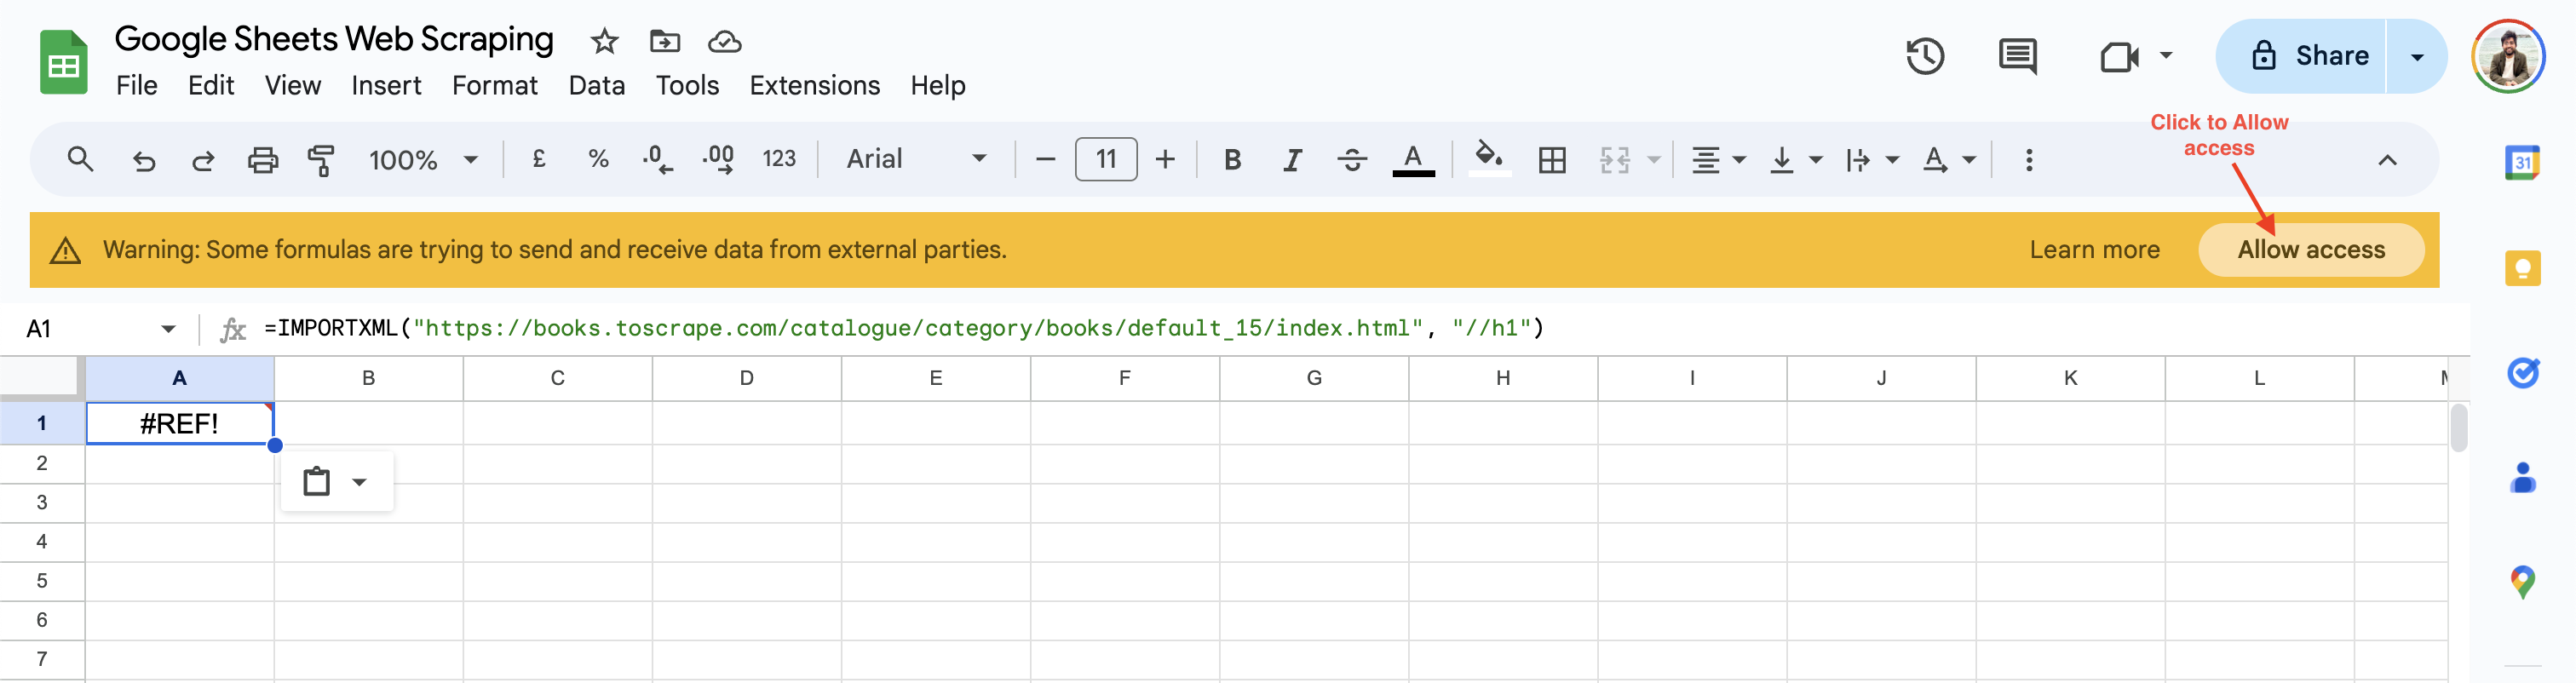Une fois que vous avez cliqué sur **Autoriser l’accès**, Google Sheets attribue à la cellule la valeur de l’en-tête `H1` de la page Web par **défaut**.
### IMPORTHTML
La fonction [`IMPORTHTML`](https://support.google.com/docs/answer/3093339?sjid=2557491900941403739-NC) vous permet d’importer des données à partir d’un tableau ou d’une liste sur une page HTML. La syntaxe de la fonction est la suivante :
```none
=IMPORTHTML(url, requête, index)
```
Cette fonction importe les données de `l'URL` vers la feuille en fonction de la `requête` spécifiée. L’attribut `query` peut être défini sur une `liste` ou `un tableau` en fonction du type de données que vous souhaitez importer. `L'index` commence à `1` et détermine le tableau ou la liste à importer. Par exemple, vous pouvez récupérer la liste des livres de **Books to Scrape** à l’aide de cette formule :
```none
=IMPORTHTML("https://books.toscrape.com/catalogue/category/books/default_15/index.html", "list", 2)
```
Cette formule affiche la liste des livres dans la cellule actuelle, comme indiqué ici :
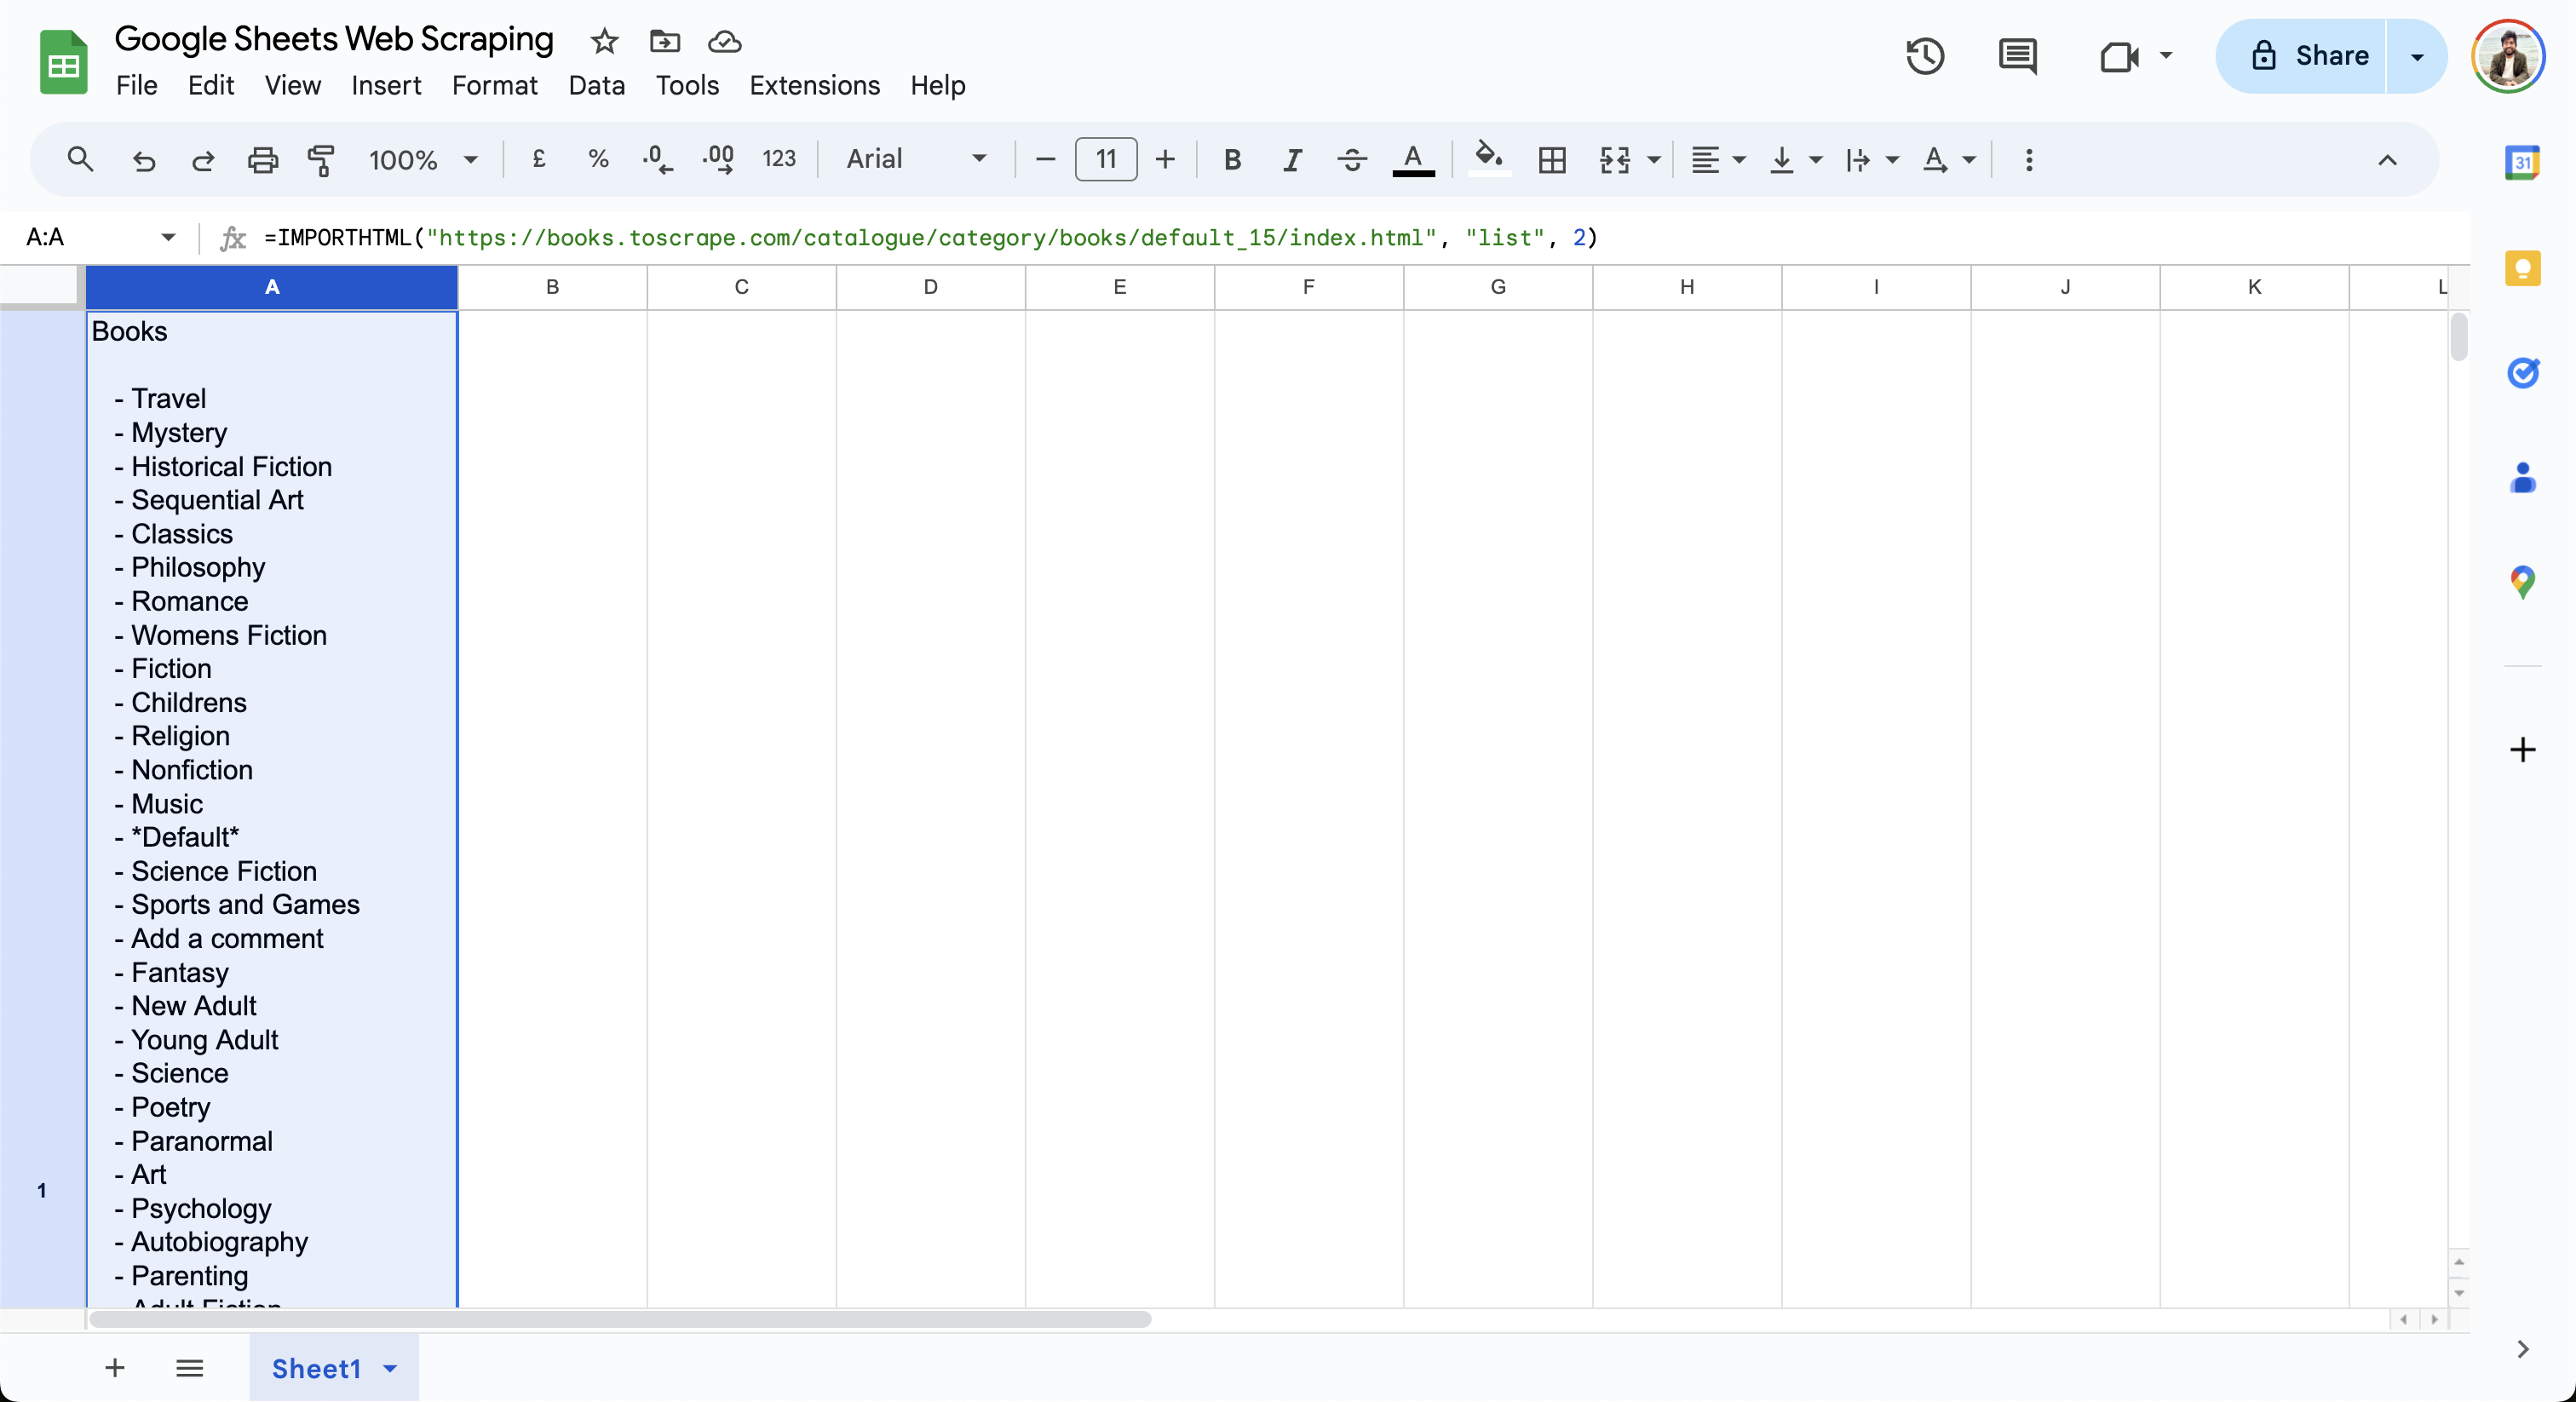Comme vous pouvez le constater, les formules`IMPORTXML`et`IMPORTHTML`sont faciles à utiliser et vous permettent de commencer à extraire des données d’une page web à l’aide de requêtes simples. Pour des cas d’utilisation plus complexes, consultez ce guide qui explique [comment utiliser VBA et Selenium pour le Scraping web dans Excel](/blog/how-tos/web-scraping-with-vba).
## Extraction de données à l’aide de la fonction IMPORTXML
Dans la section précédente, vous avez appris l’utilisation de base`de la fonction IMPORTXML`pour récupérer les titres des pages en spécifiant l’attribut XPath correspondant. L’attribut XPath est très puissant et vous permet d’accéder à n’importe quel élément d’une page Web, quelle que soit sa hiérarchie. Dans la section suivante, vous utiliserez`la fonction IMPORTXML`pour récupérer le titre, le prix et la note de tous les livres figurant sur[la](https://books.toscrape.com/catalogue/category/books/default_15/index.html)page Web[**Books to Scrape**](https://books.toscrape.com/catalogue/category/books/default_15/index.html).
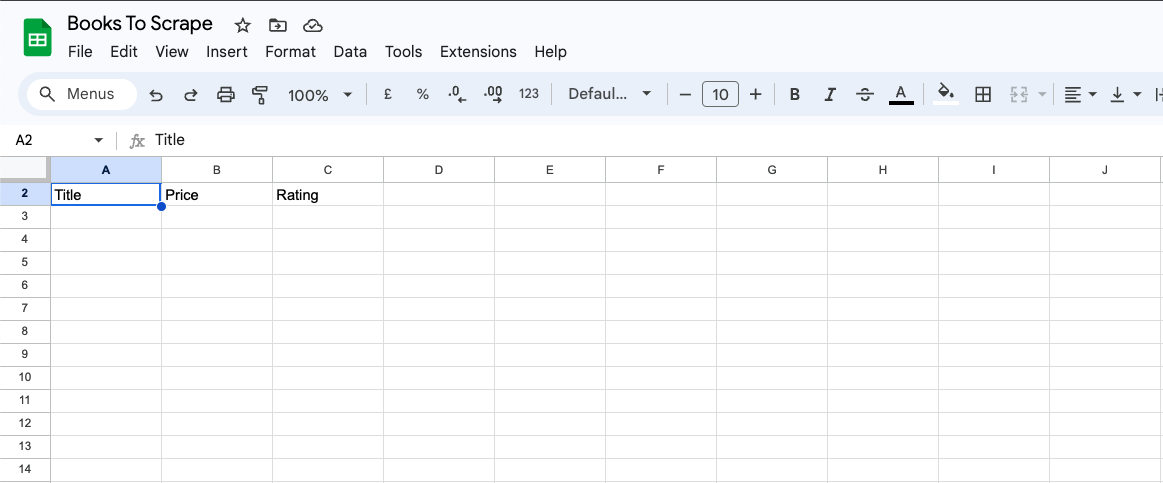
Pour commencer, ajoutez les colonnes **Titre**, **Prix** et **Note** dans Google Sheets :
Pour récupérer le titre du livre à partir de **Books to Scrape**, vous avez besoin de son emplacement XPath, que vous pouvez trouver à l’aide de l’outil **Inspecter** du navigateur. Pour trouver le XPath du titre du livre, cliquez avec le bouton droit de la souris sur le titre du premier livre et cliquez sur **Inspecter**. Cliquez ensuite sur **Copier > XPath** pour copier son localisateur XPath :
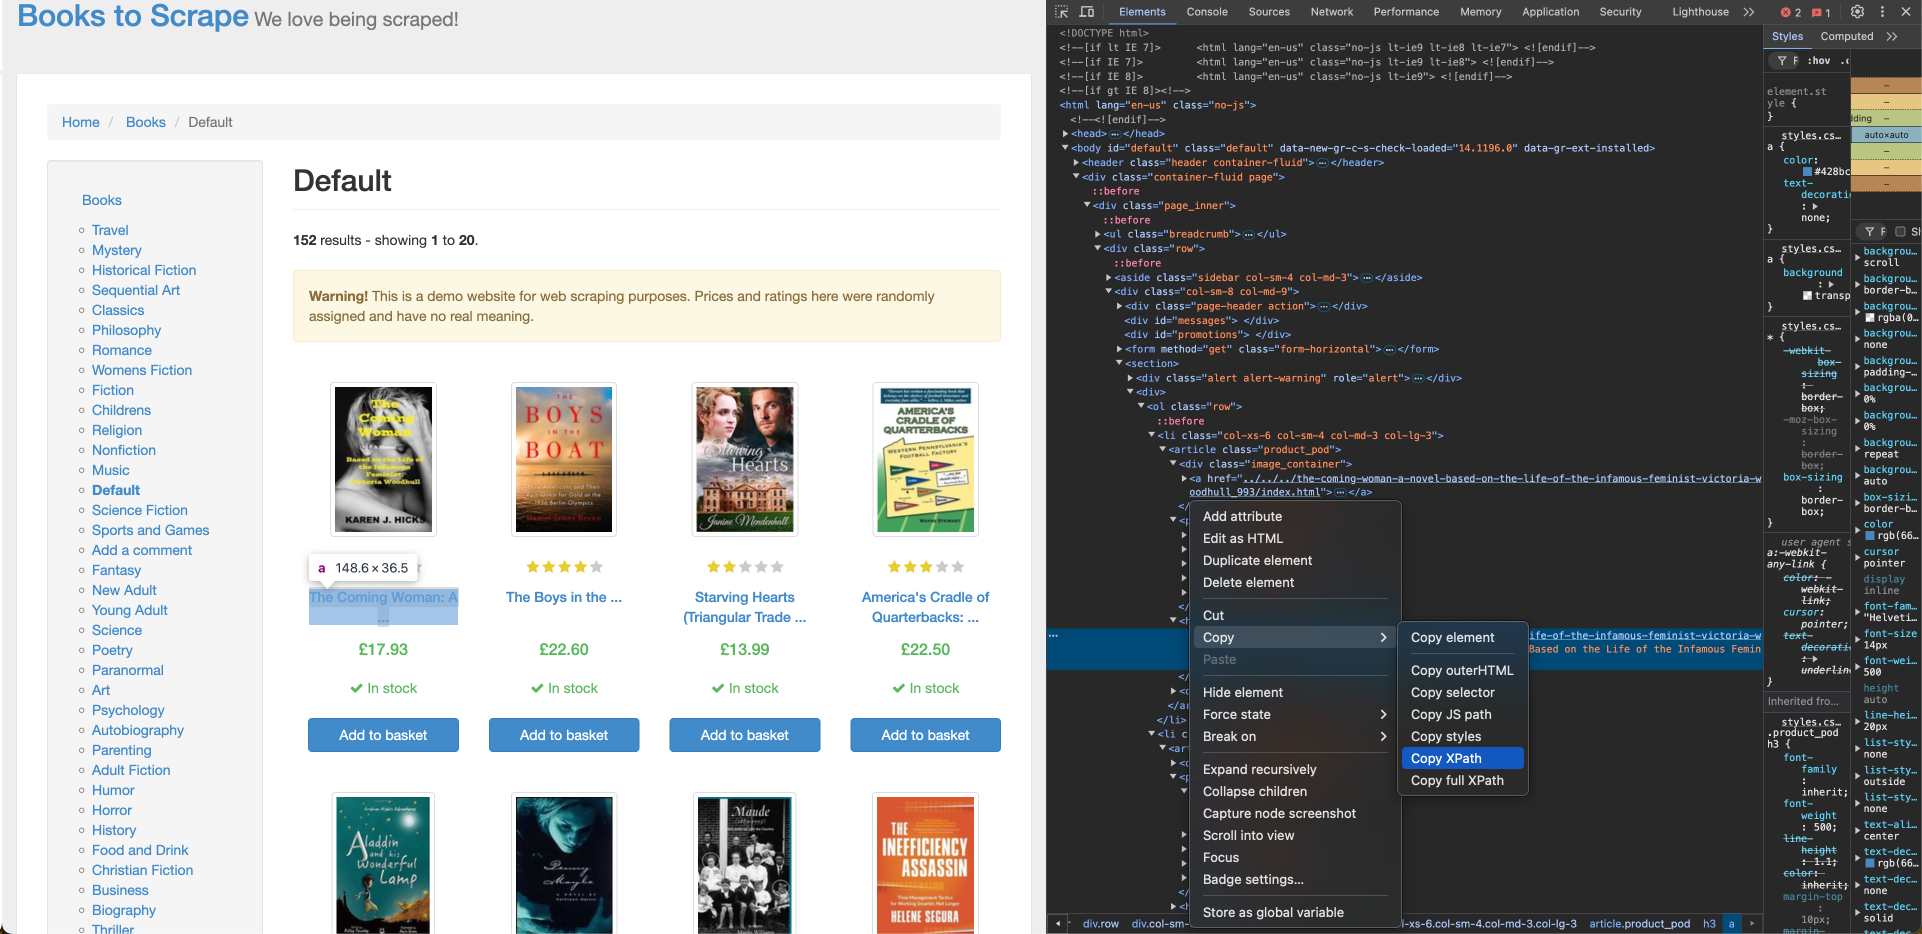Le XPath du titre du premier livre correspond à une balise d’ancrage (`a`) et ressemble à ceci :
```none
//*[@id="default"]/div/div/div/div/section/div[2]/ol/li[1]/article/h3/a
```
Vous devez apporter quelques modifications au XPath afin de vous assurer que le titre du livre est correctement importé pour tous les livres de la liste :
- Le XPath contient`li[1]`dans le chemin, indiquant que le premier livre est sélectionné. Remplacez-le par`li`pour récupérer tous les éléments.
- Le contenu interne de la balise`a`contient un titre de livre tronqué, mais la balise`a`contient un attribut`title`avec le titre complet du livre. Modifiez le`a`dans le XPath en`a/@title`pour utiliser l’attribut title.
- Remplacez toutes les guillemets doubles dans le XPath par des guillemets simples pour éviter les problèmes d’échappement dans la formule.
Une fois que vous avez ajusté le XPath, ajoutez la formule suivante avec le XPath mis à jour dans la cellule `A2` de votre feuille Google Sheet :
```none
=IMPORTXML("https://books.toscrape.com/catalogue/category/books/default_15/index.html", "//*[@id='default']/div/div/div/div/section/div[2]/ol/li/article/h3/a/@title")
```
La feuille importe les données de la page Web et met à jour les lignes comme suit :
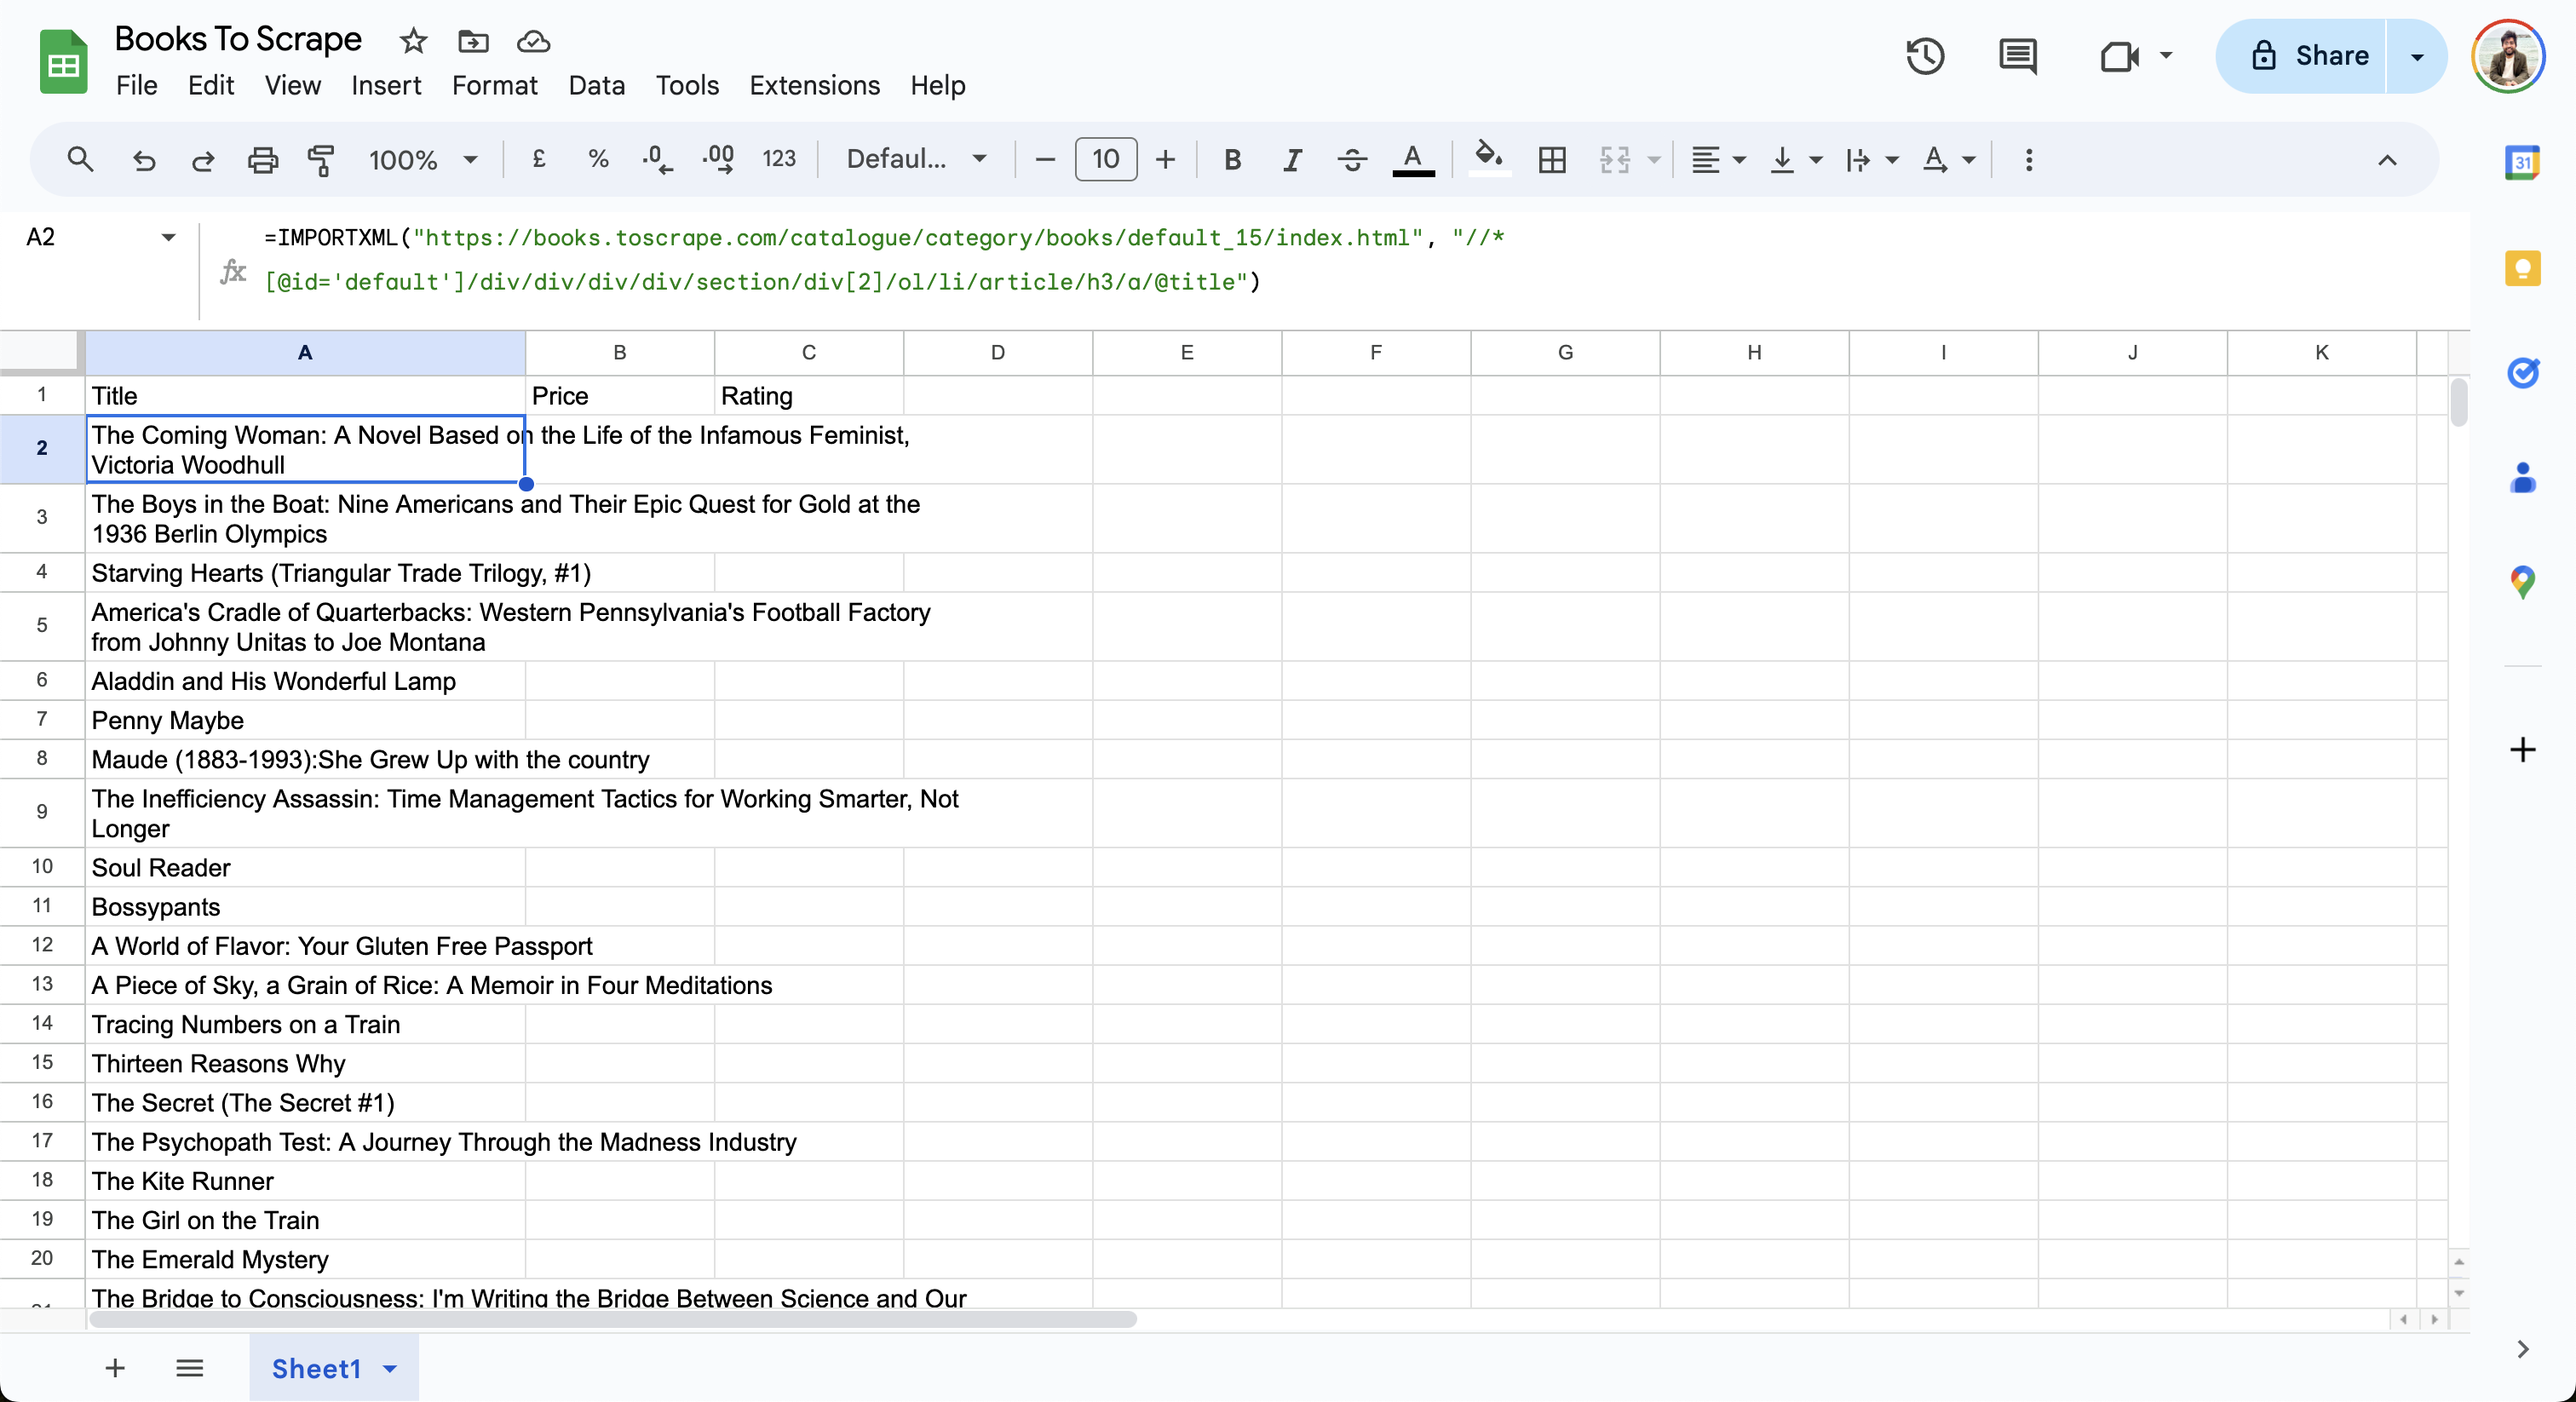Ensuite, construisez le XPath pour le prix et ajoutez-le à la cellule `B2` dans la feuille Google Sheet :
```none
=IMPORTXML("https://books.toscrape.com/catalogue/category/books/default_15/index.html", "//*[@id='default']/div/div/div/div/section/div[2]/ol/li/article/div[2]/p[1]")
```
Enfin, recherchez le chemin XPath pour la note et ajoutez-le à la cellule `C2` dans la feuille Google Sheet :
```none
=IMPORTXML("https://books.toscrape.com/", "//*[@id='default']/div/div/div/div/section/div[2]/ol/li/article/p/@class")
```
Les données finales dans la feuille se présentent comme suit :
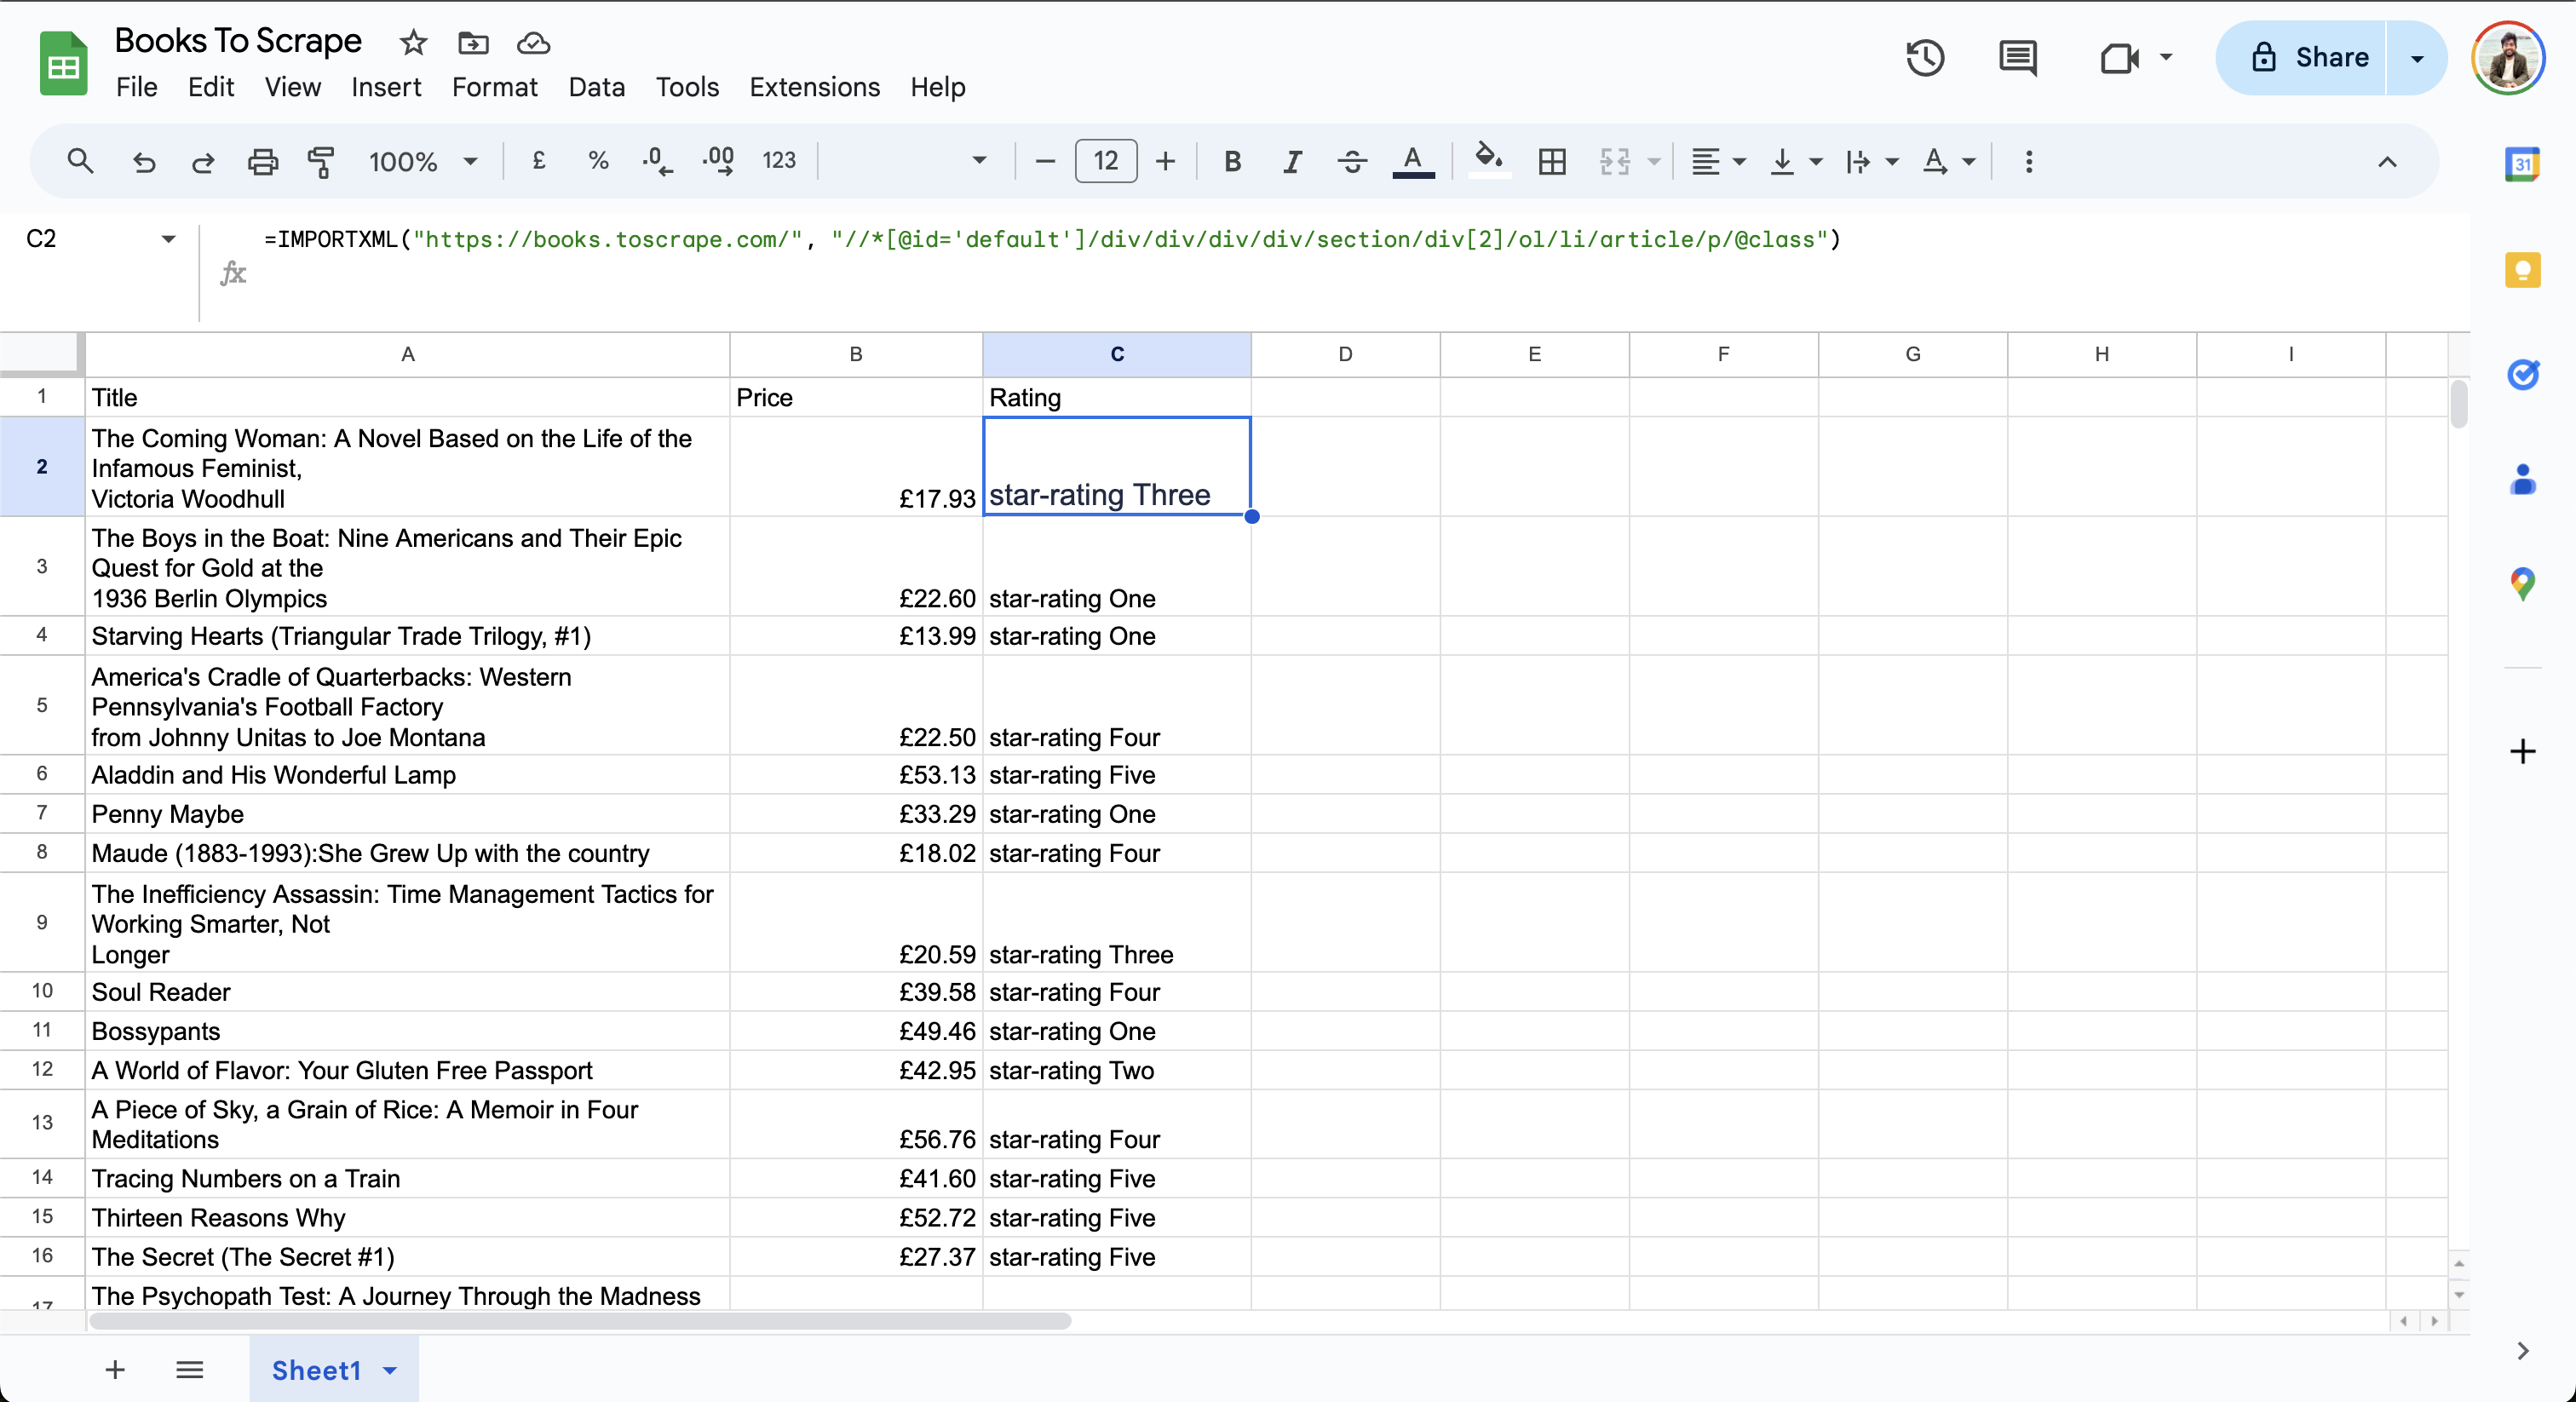Notez que la colonne**« Note »**affiche`une note de trois étoiles`ou`une note de quatre étoiles`. Étant donné que[XPath 2.0](https://www.w3.org/TR/xpath20/)n’est pas encore pris en charge par Google Sheets, vous ne pouvez pas manipuler les données pour simplifier le résultat.
## Gestion des pages Web complexes
Bien que Google Sheets soit bien adapté aux tâches de scraping simples, le scraping peut devenir difficile si le site web cible contient du contenu dynamique et une pagination ou s’il nécessite des interactions par clic. Par exemple, si votre page web charge du contenu de manière asynchrone à l’aide de JavaScript, les formules`IMPORTXML`et`IMPORTHTML`de Google Sheets ne peuvent pas en extraire les données, car elles ne prennent en charge que les pages web statiques. De même, si le contenu repose sur des interactions de l’utilisateur telles que des clics, des saisies ou des défilements, ces formules ne pourront pas extraire les données. Si vous souhaitez [extraire du contenu dynamique](/blog/how-tos/scrape-dynamic-websites-python), vous pouvez écrire un script qui utilise un navigateur sans interface graphique tel que Selenium.
Google Sheets ne peut pas non plus gérer automatiquement les tâches d’extraction paginées. Bien que vous puissiez ajouter manuellement la formule `IMPORTXML` après la dernière ligne avec une URL mise à jour, cette méthode n’est pas évolutive, car elle nécessite de répéter le processus pour chaque page.
Si vous recherchez des cas d’utilisation plus avancés, tels que la gestion de contenu dynamique ou de grands volumes de données, envisagez d’utiliser les produits Bright Data pour une extraction de données efficace. Bright Data fournit une API de Scraping web unifiée pour toutes les tâches d’extraction de données et gère en arrière-plan les complexités des Proxys, des CAPTCHA et des agents utilisateurs. Son API gère les requêtes en masse, l’analyse et la validation, ce qui vous permet de déployer et de mettre à l’échelle plus rapidement. De plus, elle fournit une [vaste collection de Jeux de données préconstruits](/products/datasets)provenant de sites web populaires, tels que[LinkedIn](/products/datasets)et[Zillow](/products/datasets/zillow), qui peuvent être intégrés à vos flux de travail existants, ce qui réduit les tracas liés à la maintenance des scripts de scraping.
## Automatisation de l’actualisation des données dans Google Sheets
Pour certaines tâches de scraping, telles que le suivi des prix ou de l’engagement sur les réseaux sociaux, vous devez actualiser automatiquement les données scrapées à intervalles réguliers afin de vous assurer d’avoir accès à des données précises pour l’analyse et la prise de décision.
Pour définir l’intervalle de calcul dans Google Sheets, il vous suffit de cliquer sur **Fichier > Paramètres** et d’accéder à l’onglet **Calcul**:
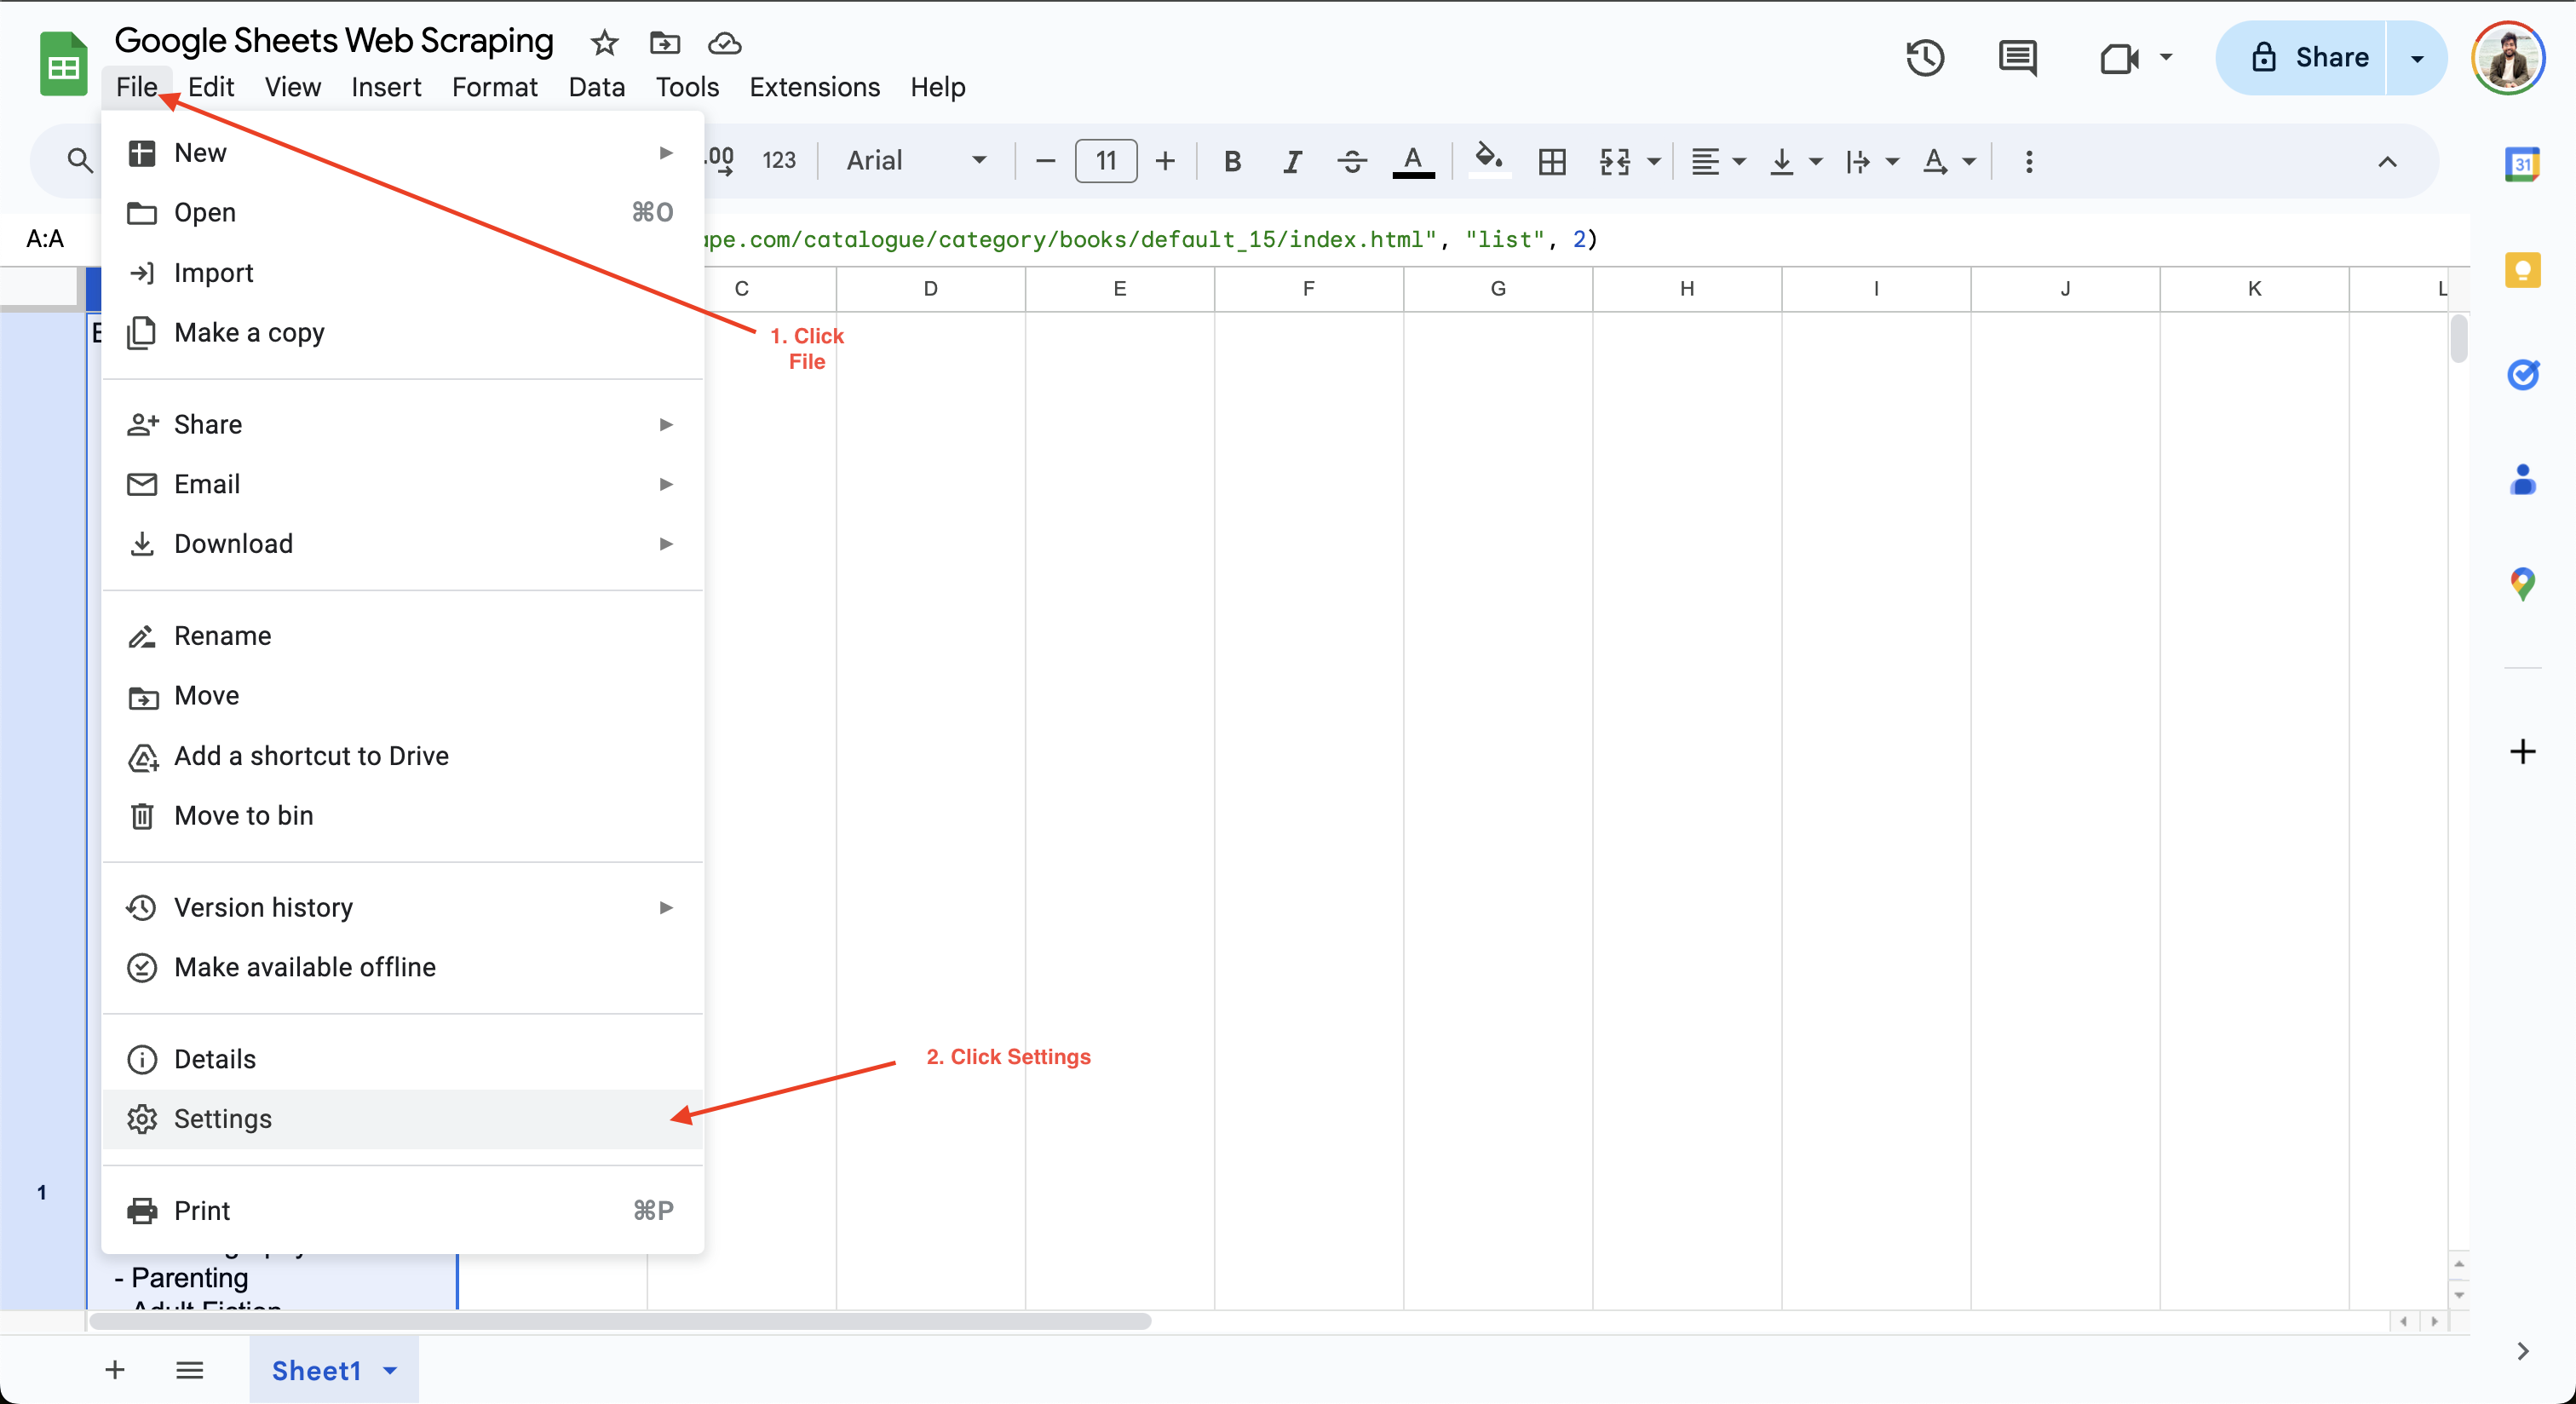Vous pouvez ensuite mettre à jour l’intervalle de calcul à une minute ou une heure. Par exemple, ici, le paramètre **Recalculer** est mis à jour sur **À chaque modification et toutes les minutes** afin de garantir que les données sont automatiquement actualisées toutes les minutes :
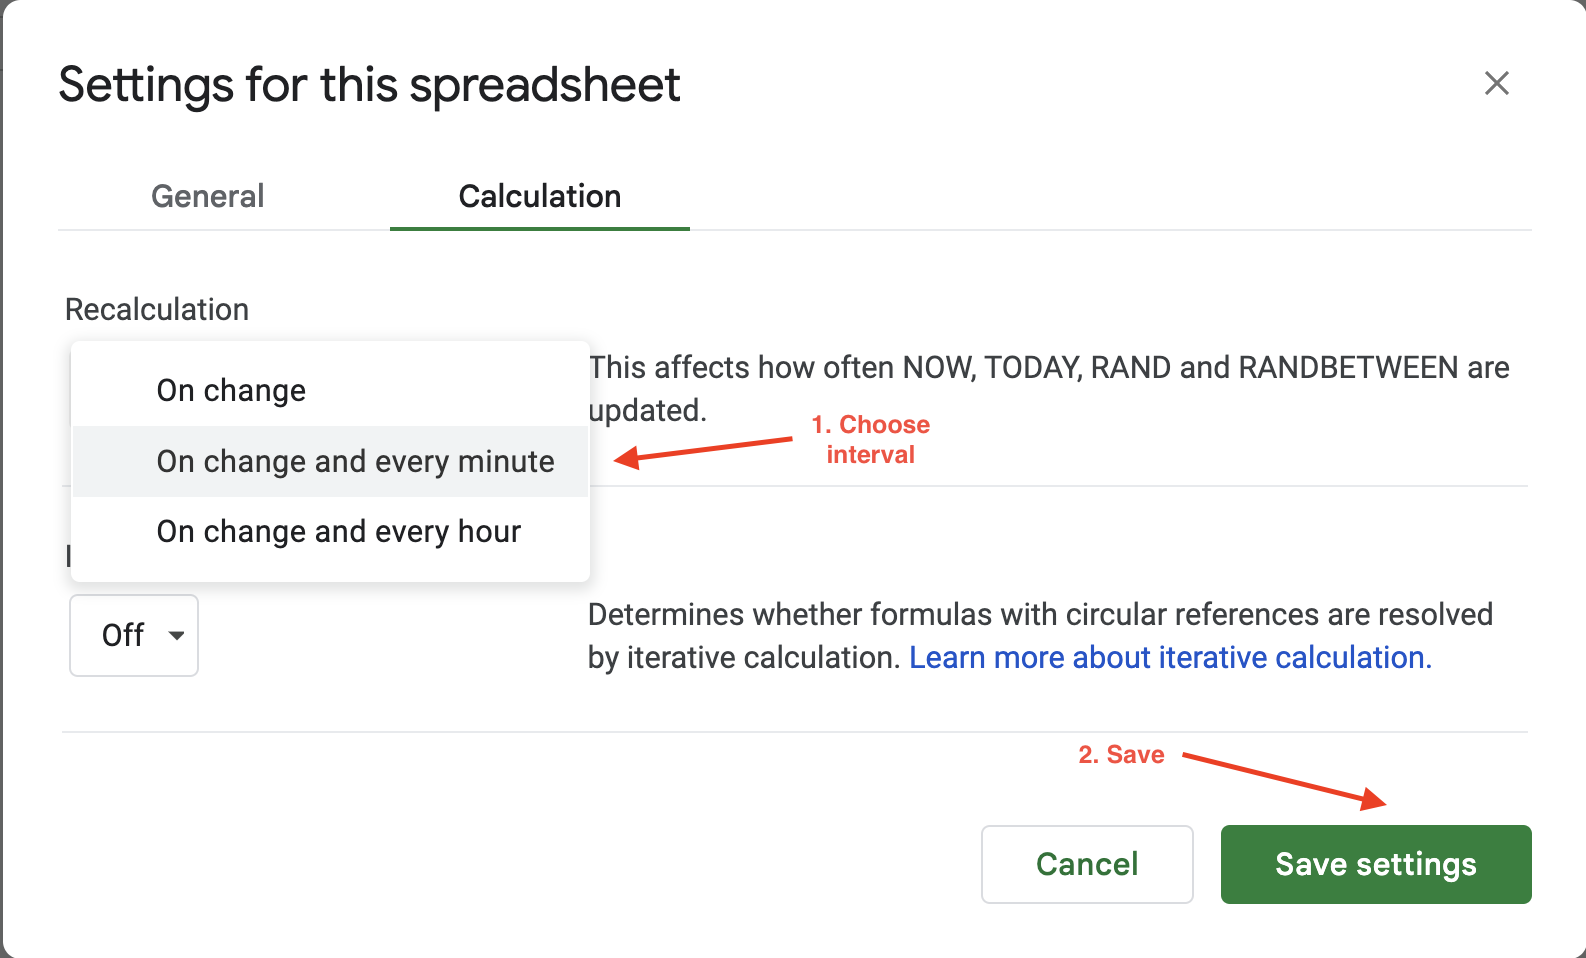Les options de rafraîchissement automatique de Google Sheets offrent une flexibilité limitée pour configurer la fréquence ou les déclencheurs de rafraîchissement, car vous ne pouvez choisir qu’entre deux valeurs : toutes les heures ou toutes les minutes. Si vous recherchez plus de flexibilité, Bright Data propose des ensembles de données propres, validés et à jour dans plusieurs formats de fichiers, tels que JSON, CSV et Parquet. Il est donc idéal pour les tâches de scraping à grande échelle qui nécessiteraient autrement la maintenance d’une vaste infrastructure.
## Mise en œuvre des meilleures pratiques et dépannage
Si vous souhaitez améliorer l’efficacité de votre scraping, veillez à être sélectif quant aux données que vous extrayez. Essayer de scraper des données inutiles peut ralentir votre processus et augmenter la charge sur le site web cible.
Si vous souhaitez extraire de grands volumes de données, ajoutez des délais artificiels entre les requêtes et envisagez d’exécuter les tâches pendant les heures creuses afin de vous assurer que le site web n’est pas surchargé par un trafic inattendu. Un trafic important peut entraîner des interdictions d’IP ou des limitations de débit, vous empêchant de poursuivre votre tâche d’extraction. Apprenez-en davantage sur [l’extraction de sites web sans être bloqué](/blog/web-data/web-scraping-without-getting-blocked).
Outre les interdictions d’IP, la présentation d’un[défi CAPTCHA](/blog/web-data/what-is-a-captcha)aux utilisateurs est une autre technique anti-bot couramment utilisée par les sites web pour restreindre l’accès au contenu jusqu’à ce que l’utilisateur vérifie qu’il est bien humain. Envisagez d’utiliser les[Proxys résidentiels Bright Data](/proxy-types/residential-proxies)pour les tâches de scraping avancées qui bénéficieraient de la rotation des IP et des solveurs CAPTCHA automatiques.
Avant de scraper des données, vous devez également consulter les conditions d’utilisation du site web afin de vous assurer de leur conformité. Vos scripts doivent suivre les instructions`du fichier robot.txt`pour interagir avec le site web. Consultez[ce guide](/blog/how-tos/robots-txt-for-web-scraping-guide)pour en savoir plus sur l’utilisation des règles`robot.txt`pour le Scraping web.
## Conclusion
Google Sheets est bien adapté au scraping de données provenant de sites web statiques qui ne comportent pas de contenu dynamique, d’éléments cachés ou de pagination. Dans cet article, vous avez appris à automatiser facilement les tâches d’extraction de données à l’aide des formules `IMPORTXML` et `IMPORTHTML` sans avoir besoin d’expérience préalable en matière de script.
Pour les tâches de scraping complexes qui impliquent du contenu dynamique ou de grands volumes de données,[Bright Data](/)fournit des API faciles à utiliser, flexibles, évolutives et performantes pour le scraping web dans différents formats, notamment JSON, CSV ou NDJSON. En coulisses, il gère les complexités du scraping en s’occupant de la rotation des adresses IP et des agents utilisateurs, des CAPTCHA et du contenu dynamique. Si vous êtes prêt à passer au niveau supérieur en matière de Scraping web, pensez à essayer [la meilleure API Web Scraper](/products/web-scraper).
Inscrivez-vous dès aujourd’hui pour un essai gratuit et commencez à optimiser vos flux de données !
Contacter ventesEssai gratuit
Table des matières
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Scraping+web+avec+Google+Sheets&u=https://brightdata.fr/blog/donnees-web/web-scraping-with-google-sheets) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Scraping+web+avec+Google+Sheets&url=https://brightdata.fr/blog/donnees-web/web-scraping-with-google-sheets) [ ](http://www.reddit.com/submit?title=Scraping+web+avec+Google+Sheets&url=https://brightdata.fr/blog/donnees-web/web-scraping-with-google-sheets)
## Vous pourriez aussi être intéressé par
[  ](https://brightdata.fr/blog/ai/openhuman-with-bright-data "Accès Web Prêt pour la Production dans OpenHuman via le CLI Bright Data")
[AI

Antonello Zanini
Technical Writer
### Accès Web Prêt pour la Production dans OpenHuman via le CLI Bright Data
Intégrez le CLI Bright Data avec OpenHuman pour permettre un accès web prêt pour la production et la collecte de données pour les agents IA.
09-Sep-2026
14 min de lecture
](https://brightdata.fr/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.fr/blog/donnees-web/multimodal-web-scraping-with-minimax "Scraping Web Multimodal avec MiniMax")
[Données Web

Antonello Zanini
Technical Writer
### Scraping Web Multimodal avec MiniMax
Associez Bright Data Web Unlocker avec la vision MiniMax M3 pour extraire des données structurées à partir d’images et de captures d’écran de pages web.
09-Sep-2026
5 min de lecture
](https://brightdata.fr/blog/donnees-web/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.fr/blog/ai/best-cli-tools-for-codex "Les 10 meilleurs outils CLI pour Codex en 2026 – Testés & Classés")
[AI

Daniel Shashko
Web Data & AI Expert
### Les 10 meilleurs outils CLI pour Codex en 2026 – Testés & Classés
Les 10 outils CLI qui rendent Codex plus rapide et plus capable, en commençant par le Bright Data CLI pour un accès web réel depuis l’intérieur du sandbox.
06-Sep-2026
24 min de lecture
](https://brightdata.fr/blog/ai/best-cli-tools-for-codex)