---
title: "Scrapy ou Requests : lequel est le meilleur pour le Scraping web ?"
slug: scrapy-vs-requests
date: 2026-02-16T08:04:53+00:00
modified: 2026-04-27T09:04:04+00:00
permalink: https://brightdata.fr/blog/donnees-web/scrapy-vs-requests
type: blog
---
[ Blog ](https://brightdata.fr/blog "Blog") / [Données Web](https://brightdata.fr/blog/donnees-web)
[Données Web](https://brightdata.fr/blog/donnees-web)
# Scrapy ou Requests : lequel est le meilleur pour le Scraping web ?
Comparez Scrapy et Requests pour le Scraping web afin de trouver l’outil le mieux adapté à vos besoins.
19 min de lecture
[  ](https://brightdata.com/blog/authors/federico-trotta)
[Federico Trotta
Technical Writer
](https://brightdata.com/blog/authors/federico-trotta)

Dans ce guide Scrapy vs Requests, vous découvrirez :
- Ce que sont Scrapy et Requests
- Une comparaison entre Scrapy et Requests pour le Scraping web
- Une comparaison entre Scrapy et Requests dans un scénario de pagination
- Les limites communes entre Scrapy et Requests dans les scénarios de Scraping web
C’est parti !
## Qu’est-ce que Requests ?
[Requests](https://pypi.org/project/requests/)est une bibliothèque Python permettant d’envoyer des requêtes HTTP. Elle est largement utilisée dans le Scraping web, généralement associée à des bibliothèques d’analyse HTML telles que[BeautifulSoup](https://pypi.org/project/beautifulsoup4/).
Les principales fonctionnalités de Requests pour le Scraping web sont les suivantes :
- **Prise en charge des méthodes HTTP**: vous pouvez utiliser toutes les principales méthodes HTTP telles que`GET`,`POST`,`PUT`,`PATCH` et`DELETE`, qui sont essentielles pour interagir avec les pages web et les API.
- **En-têtes personnalisés**: définissez des en-têtes personnalisés (par exemple,[`User-Agent`et autres](/blog/web-data/http-headers-for-web-scraping)) pour imiter un navigateur réel ou gérer l’authentification de base.
- **Gestion des sessions**: l’objet`requests.Session()`vous permet de conserver les cookies et les en-têtes sur plusieurs requêtes. Cela est utile pour le scraping de sites web qui nécessitent une connexion ou le maintien de l’état des sessions.
- **Délais d’expiration et gestion des erreurs**: vous pouvez définir des délais d’expiration pour éviter les requêtes bloquées et gérer les exceptions pour un scraping robuste.
- **Prise en charge des proxys**: vous pouvez acheminer vos requêtes via des proxys, ce qui est utile pour contourner les interdictions d’IP et accéder à des contenus soumis à des restrictions géographiques.
## Qu’est-ce que Scrapy ?
[Scrapy](https://scrapy.org/)est un framework open source de Scraping web écrit en Python. Il est conçu pour extraire des données de sites web de manière rapide, efficace et évolutive.
Scrapy fournit un framework complet pour explorer des sites web, extraire des données et les stocker dans différents formats (par exemple, JSON, CSV, etc.). Il est particulièrement utile pour les projets de Scraping web à grande échelle, car il peut gérer des tâches d’exploration complexes et des requêtes simultanées tout en respectant les règles d’exploration.
Les principales fonctionnalités de Scrapy pour le Scraping web sont les suivantes :
- **Exploration Web intégrée**: Scrapy est conçu pour être un[robot d’exploration Web](/blog/web-data/what-is-a-web-crawler). Cela signifie qu’il peut suivre automatiquement les liens d’une page Web, ce qui vous permet d’explorer plusieurs pages ou des sites entiers avec un minimum d’effort.
- **Requêtes asynchrones**: il utilise une architecture asynchrone pour traiter plusieurs requêtes simultanément. Cela le rend beaucoup plus rapide que[les clients HTTP Python](/blog/web-data/best-python-http-clients)tels que`requests`.
- **Sélecteurs pour l’extraction de données**: Scrapy offre la possibilité d’extraire des données du HTML à l’aide de XPaths et de sélecteurs CSS.
- **Middleware pour la personnalisation**: il prend en charge le middleware pour personnaliser la manière dont les requêtes et les réponses sont traitées.
- **Limitation automatique**: il peut limiter automatiquement les requêtes afin d’éviter de surcharger le serveur cible. Cela signifie qu’il peut ajuster la vitesse d’exploration en fonction des temps de réponse et de la charge du serveur.
- **Gestion`du`**[fichier](/blog/how-tos/robots-txt-for-web-scraping-guide)**`robots.txt`**: il respecte le[fichier`robots.txt`pour le Scraping web](/blog/how-tos/robots-txt-for-web-scraping-guide), garantissant ainsi que vos activités de scraping sont conformes aux règles du site.
- **Rotation des proxys et des agents utilisateurs**: Scrapy prend en charge[la](/blog/how-tos/user-agents-for-web-scraping-101)[rotation des proxys](/solutions/rotating-proxies)et[`des agents utilisateurs`](/blog/how-tos/user-agents-for-web-scraping-101)via des middlewares, ce qui permet d’éviter les interdictions et la détection d’adresses IP.
## Scrapy vs Requests : comparaison des fonctionnalités pour le Scraping web
Maintenant que vous savez ce que sont Requests et Scrapy, il est temps de comparer en détail leurs utilisations pour le Scraping web :
**Fonctionnalité****Scrapy****Requests****Cas d’utilisation**Projets de scraping complexes et à grande échelleTâches de Scraping web plus simples et prototypes**Requêtes asynchrones**Prise en charge intégrée des requêtes asynchronesPas de prise en charge intégrée**Exploration**Suivi automatique des liens et exploration de plusieurs pagesNécessite une implémentation manuelle pour l’exploration**Extraction de données**Prise en charge intégrée des sélecteurs XPath et CSSNécessite des bibliothèques externes pour gérer l’extraction des données**Concurrence**Gère plusieurs requêtes simultanément dès l’installationNécessite des intégrations externes pour gérer les requêtes simultanées**Middleware**Middlewares personnalisables pour gérer les Proxies, les réessais et les en-têtesPas de middleware intégré**Limitation**Limitation automatique intégrée pour éviter la surcharge des serveursPas de régulation intégrée**Rotation des proxys**Prend en charge la rotation des proxys via des middlewaresNécessite une implémentation manuelle**Gestion des erreurs**Mécanismes de réessai intégrés pour les requêtes ayant échouéNécessite une implémentation manuelle**Téléchargement de fichiers**Prend en charge le téléchargement de fichiers, mais nécessite une configuration supplémentairePrise en charge simple et directe du téléchargement de fichiers### Cas d’utilisation
Scrapy est un framework complet de Scraping web destiné aux projets de scraping complexes et à grande échelle. Il est idéal pour les tâches impliquant l’exploration de plusieurs pages, les requêtes simultanées et l’exportation de données dans des formats structurés.
Requests, quant à lui, est une bibliothèque qui gère les requêtes HHTP. Il est donc mieux adapté aux tâches simples telles que la récupération d’une seule page web, l’interaction avec des API ou le téléchargement de fichiers.
### Requêtes asynchrones et concurrence
Scrapy est basé sur[Twisted](https://docs.scrapy.org/en/latest/topics/architecture.html#event-driven-networking), un framework réseau événementiel pour Python. Cela signifie qu’il peut traiter simultanément des requêtes asynchrones et multiples, ce qui le rend beaucoup plus rapide pour le scraping à grande échelle.
Requests, en revanche, ne prend pas en charge les requêtes asynchrones ou simultanées de manière native. Si vous souhaitez effectuer des requêtes HTTP asynchrones, vous pouvez l’intégrer à[GRequests](https://github.com/spyoungtech/grequests).
### Exploration
Lorsque le paramètre[`ROBOTSTXT_OBEY`](https://docs.scrapy.org/en/latest/topics/settings.html#robotstxt-obey)est défini sur`True`, Scrapy lit le fichier`robots.txt`, suit automatiquement les liens autorisés sur une page web et explore les pages autorisées.
Requests ne dispose pas de capacités de crawling intégrées, vous devez donc définir manuellement les liens et effectuer des requêtes supplémentaires.
### Extraction de données
Scrapy offre une prise en charge intégrée pour l’extraction de données à l’aide de[sélecteurs XPath et CSS](/blog/web-data/xpath-vs-css-selectors), ce qui facilite l’analyse du HTML et du XML.
Requests n’inclut aucune fonctionnalité d’extraction de données. Vous devez utiliser des bibliothèques externes telles que[BeautifulSoup pour effectuer l’analyse et l’extraction des données](/blog/how-tos/beautiful-soup-web-scraping).
### Middleware
Scrapy propose des middlewares personnalisables pour gérer[les Proxies](https://docs.scrapy.org/en/2.11/_modules/scrapy/downloadermiddlewares/httpproxy.html),[les réessais](https://docs.scrapy.org/en/2.11/_modules/scrapy/downloadermiddlewares/retry.html),[les en-têtes](https://docs.scrapy.org/en/2.11/_modules/scrapy/downloadermiddlewares/defaultheaders.html), etc. Cela le rend très extensible pour les tâches de scraping avancées.
Requests ne fournit quant à lui aucune prise en charge des middlewares. Vous devez donc implémenter manuellement des fonctionnalités telles que[la rotation des Proxys](/blog/proxy-101/proxy-with-python-requests)ou les réessais.
### Limitation
Scrapy inclut une fonctionnalité de régulation automatique intégrée qui permet d’ajuster la vitesse d’exploration en fonction des temps de réponse et de la charge du serveur. Vous pouvez ainsi éviter de saturer le serveur cible avec des requêtes HTTP.
Requests ne dispose pas d’une fonctionnalité de régulation intégrée. Si vous souhaitez implémenter la régulation, vous devez ajouter manuellement des délais entre les requêtes, par exemple en utilisant la méthode `time.sleep()`.
### Rotation des proxys
Scrapy prend en charge la rotation des Proxies via des middlewares, ce qui permet d’éviter facilement les interdictions d’IP et de scraper des sites de manière anonyme.
Requests ne fournit pas de fonctionnalité de rotation des proxys intégrée. Si vous souhaitez gérer les proxys avec`Requests`, vous devez les configurer manuellement et écrire une logique personnalisée,[comme expliqué dans notre guide](/blog/how-tos/python-ip-rotation).
### Gestion des erreurs
Scrapy inclut des mécanismes de réessai intégrés pour[les requêtes ayant échoué](https://docs.scrapy.org/en/2.10/_modules/scrapy/downloadermiddlewares/retry.html), ce qui le rend robuste pour gérer les erreurs réseau ou les problèmes de serveur.
Au contraire, Requests vous oblige à gérer manuellement les erreurs et les exceptions, par exemple en utilisant le bloc[`try-except`](https://docs.python.org/3/tutorial/errors.html#handling-exceptions). Envisagez également des bibliothèques telles que[`retry-requests`](https://pypi.org/project/retry-requests/).
### Téléchargement de fichiers
Scrapy prend en charge le téléchargement de fichiers via[`FilesPipeline`](https://docs.scrapy.org/en/latest/topics/media-pipeline.html), mais nécessite une configuration supplémentaire pour gérer les fichiers volumineux ou le streaming.
Requests fournit une prise en charge simple et directe du téléchargement de fichiers avec le paramètre `stream=True` dans la méthode `requests.get()`.
## Scrapy vs Requests : comparaison des deux bibliothèques dans un scénario de pagination
Vous savez désormais ce que sont Requests et Scrapy. Préparez-vous à découvrir un tutoriel comparatif étape par étape pour un scénario spécifique de Scraping web !
L’accent sera mis sur la comparaison entre ces deux bibliothèques dans un scénario de pagination.[La gestion de la pagination dans le Scraping web](/blog/web-data/pagination-web-scraping)nécessite une logique personnalisée pour le suivi des liens et l’extraction de données sur plusieurs pages.
Le site cible sera[Quotes to Scrape](https://quotes.toscrape.com/), qui fournit des citations d’auteurs célèbres sur différentes pages :
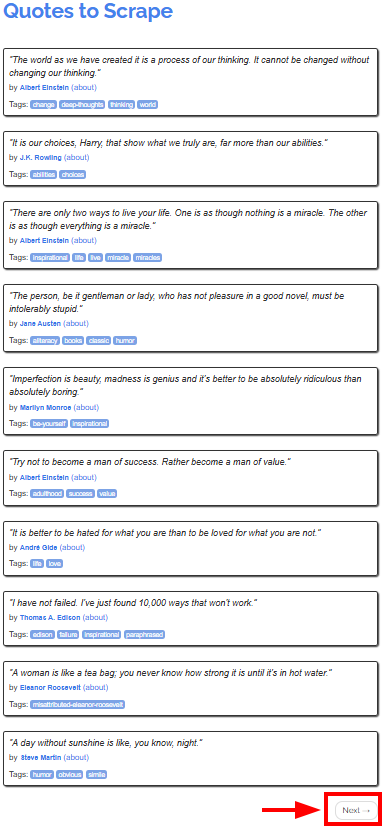L’objectif du tutoriel est de montrer comment utiliser Scrapy et Requests pour récupérer les citations de toutes les pages. Nous commencerons par Requests, car son utilisation peut être plus complexe que celle de Scrapy.
### Configuration requise
Pour reproduire les tutoriels pour Scrapy et Requests, vous devez avoir installé[Python 3.7 ou une version supérieure](https://www.python.org/downloads/)sur votre ordinateur.
## Comment utiliser Requests pour le Scraping web
Dans ce chapitre, vous apprendrez à utiliser Requests pour extraire toutes les citations du site cible.
Gardez à l’esprit que vous ne pouvez pas utiliser Requests seul pour extraire des données directement à partir de pages web. Vous aurez également besoin d’un[analyseur HTML tel que BeautifulSoup](/blog/web-data/best-html-parsers).
### Étape n° 1 : configuration de l’environnement et installation des dépendances
Supposons que vous appeliez le dossier principal de votre projet `requests_scraper/.` À la fin de cette étape, le dossier aura la structure suivante :
```none
requests_scraper/
├── requests_scraper.py
└── venv/
```
Où :
- `requests_scraper.py`est le fichier Python qui contient tout le code
- `venv/`contient l’environnement virtuel
Vous pouvez créer le répertoire[d’environnement virtuel](https://docs.python.org/3/library/venv.html)`venv/`comme suit :
```none
python -m venv venv
```
Pour l’activer, sous Windows, exécutez :
```none
venvScriptsactivate
```
De manière équivalente, sous macOS et Linux, exécutez :
```none
source venv/bin/activate
```
Vous pouvez maintenant installer les bibliothèques requises avec :
```none
pip install requests beautifulsoup4
```
### Étape n° 2 : configuration des variables
Vous êtes maintenant prêt à commencer à écrire du code dans le fichier `requests_scraper.py`.
Commencez par configurer les variables comme suit :
```none
base_url = "https://quotes.toscrape.com"
all_quotes = []
```
Ici, vous avez défini :
- `base_url`comme URL de départ du site web à scraper
- `all_quotes`comme une liste vide utilisée pour stocker toutes les citations au fur et à mesure qu’elles sont extraites
### Étape n° 3 : créer la logique de scraping
Vous pouvez implémenter la logique de scraping et de crawling à l’aide du code suivant :
```none
url = base_url
while url:
# Envoyer une requête GET à la page actuelle
response = requests.get(url)
# Analyser le code HTML de la page
soup = BeautifulSoup(response.text, "html.parser")
# Trouver tous les blocs de citations
quotes = soup.select(".quote")
for quote in quotes:
text = quote.select_one(".text").get_text(strip=True)
author = quote.select_one(".author").get_text(strip=True)
tags = [tag.get_text(strip=True) for tag in quote.select(".tag")]
all_quotes.append({
"text": text,
"author": author,
"tags": ",".join(tags)
})
# Rechercher le bouton « Suivant »
next_button = soup.select_one("li.next")
if next_button:
# Extraire l'URL du bouton « Suivant » et
# la définir comme prochaine page à extraire
next_page = next_button.select_one("a")["href"]
url = base_url + next_page
else:
url = None
```
Ce code :
- Instancier une boucle`while`qui continuera à s’exécuter jusqu’à ce que toutes les pages soient extraites
- Sous la boucle`while`:
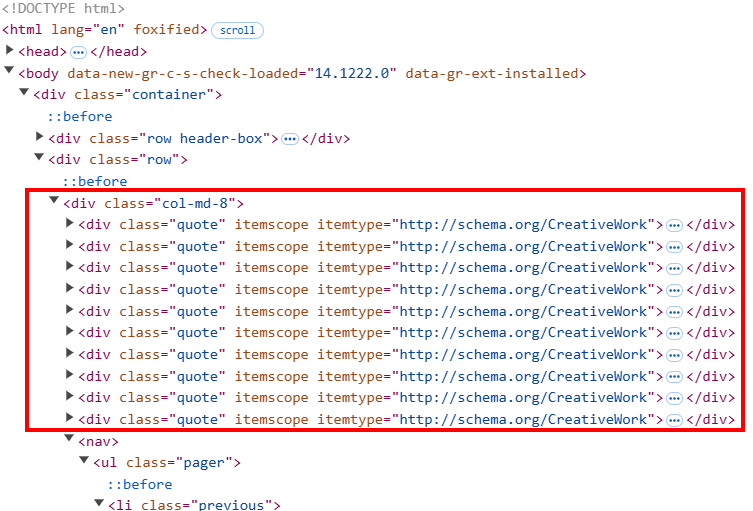
- `soup.``select``()`intercepte tous les éléments HTML de citation sur la page. Le code HTML de la page est structuré de manière à ce que chaque élément de citation ait une classe appelée`quote`.
- Le cycle`for`itère sur toutes les classes`quote`pour extraire le texte, l’auteur et les balises des citations à l’aide des méthodes de scraping de Beautiful Soup. Ici, vous avez besoin d’une logique personnalisée pour les balises, car chaque élément quote peut contenir plusieurs balises.
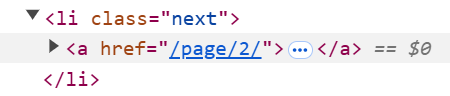
- Après avoir scrapé toute la page, le script recherche le bouton`suivant`. Si le bouton existe, il extrait le lien vers la page suivante. Ensuite, l’URL de base est mise à jour pour devenir la suivante via la variable`url = base_url + next_page`. Lorsque le processus atteint la dernière page, l’URL suivante est définie sur`None` et le processus se termine.
### Étape n° 4 : ajouter les données à un fichier CSV
Maintenant que vous avez récupéré toutes les données, vous pouvez les ajouter à un fichier CSV comme ci-dessous :
```none
with open("quotes.csv", mode="w", newline="", encoding="utf-8") as file:
writer = csv.DictWriter(file, fieldnames=["text", "author", "tags"])
writer.writeheader()
writer.writerows(all_quotes)
```
Cette partie du script utilise la bibliothèque[`csv`](https://docs.python.org/3/library/csv.html)pour :
- Spécifier le nom du fichier CSV de sortie comme`quotes.csv`.
- Ouvrir le CSV en mode écriture (`mode="w"`) et :
- Écrire la ligne d’en-tête dans le CSV
- Écrire toutes les citations récupérées dans le fichier
### Étape n° 5 : assembler le tout
Voici le code complet pour cette partie du tutoriel consacrée à Scrapy vs Requests :
```none
import requests
from bs4 import BeautifulSoup
import csv
# URL du site web
base_url = "https://quotes.toscrape.com"
# Liste pour stocker toutes les citations
all_quotes = []
# Commencez à extraire les données à partir de la première page
url = base_url
while url:
# Envoyez une requête GET à la page actuelle
response = requests.get(url)
# Analysez le code HTML de la page
soup = BeautifulSoup(response.text, "html.parser")
# Rechercher tous les blocs de citations
quotes = soup.select(".quote")
for quote in quotes:
text = quote.select_one(".text").get_text(strip=True)
author = quote.select_one(".author").get_text(strip=True)
tags = [tag.get_text(strip=True) for tag in quote.select(".tag")]
all_quotes.append({
"text": text,
"author": author,
"tags": ",".join(tags)
})
# Rechercher le bouton « Suivant »
next_button = soup.select_one("li.next")
if next_button:
# Extraire l'URL du bouton « Suivant » et
# la définir comme prochaine page à extraire
next_page = next_button.select_one("a")["href"]
url = base_url + next_page
else:
url = None
# Enregistrer les citations dans un fichier CSV
with open("quotes.csv", mode="w", newline="", encoding="utf-8") as file:
writer = csv.DictWriter(file, fieldnames=["text", "author", "tags"])
writer.writeheader()
writer.writerows(all_quotes)
```
Exécutez le script ci-dessus :
```none
python requests_scraper.py
```
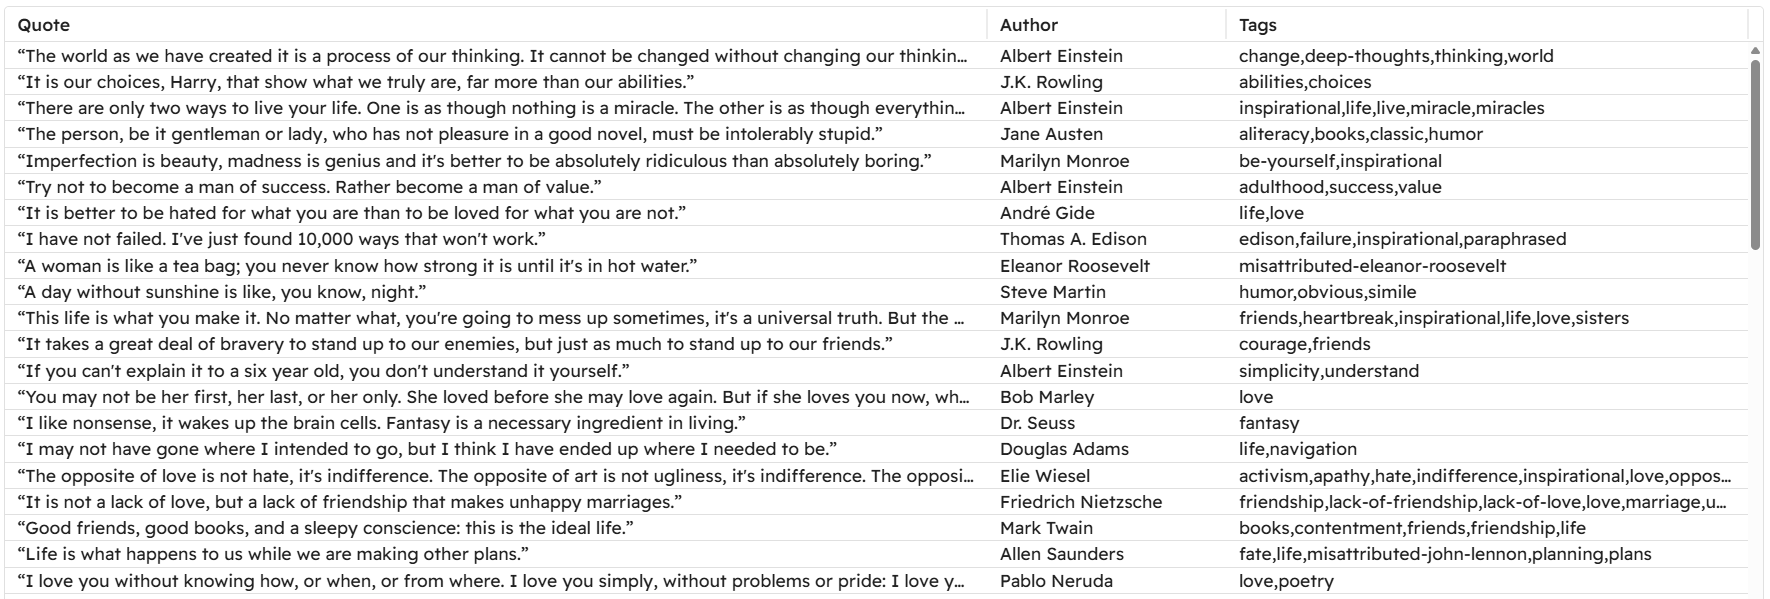
Un fichier`quotes.csv`apparaîtra dans le dossier du projet :
## Comment utiliser Scrapy pour le Scraping web
Maintenant que vous avez appris à utiliser Requests pour le Scraping web, vous êtes prêt à découvrir comment utiliser Scrapy avec la même page cible et le même objectif.
### Étape n° 1 : configuration de l’environnement et installation des dépendances
Supposons que vous souhaitiez appeler le dossier principal de votre projet `scrapy_scraper/.`
Tout d’abord, créez et activez un environnement virtuel comme indiqué précédemment, puis installez Scrapy :
```none
pip install scrapy
```
Lancez Scrapy pour remplir le dossier principal avec des fichiers prédéfinis dans `quotes_scraper/` à l’aide de la commande suivante :
```none
scrapy startproject quotes_scraper
```
Voici la structure finale de votre projet :
```none
scrapy_scraper/
├── quotes_scraper/ # Dossier principal du projet Scrapy
│ ├── __init__.py
│ ├── items.py # Définit la structure des données pour les éléments extraits
│ ├── middlewares.py # Middlewares personnalisés
│ ├── pipelines.py # Gère le post-traitement des données récupérées
│ ├── settings.py # Paramètres du projet
│ └── spiders/ # Dossier pour tous les spiders
├── venv/
└── scrapy.cfg # Fichier de configuration Scrapy
```
### Étape n° 2 : définir les éléments
Le fichier `items.py` définit la structure des données que vous souhaitez extraire. Puisque vous souhaitez récupérer les citations, les auteurs et les balises, définissez-le comme suit :
```none
import scrapy
class QuotesScraperItem(scrapy.Item):
quote = scrapy.Field()
author = scrapy.Field()
tags = scrapy.Field()
```
### Étape n° 3 : définir le spider principal
Dans le dossier `spiders/`, créez les fichiers Python suivants :
- `__init__.py`, qui marque le répertoire comme un paquet Python
- `quotes_spider.py`
Le fichier `quotes_spider.py` contient la logique de scraping proprement dite :
```none
import scrapy
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
from ..items import QuotesScraperItem
class QuotesSpider(CrawlSpider):
name = "quotes"
allowed_domains = ["quotes.toscrape.com"]
start_urls = ["https://quotes.toscrape.com/"]
# Définir les règles pour suivre les liens de pagination
rules = (
Rule(LinkExtractor(restrict_css="li.next a"), callback="parse_item", follow=True),
)
def parse_item(self, response):
# Extraire les citations, les auteurs et les balises
for quote in response.css("div.quote"):
item = QuotesScraperItem()
item["quote"] = quote.css("span.text::text").get()
item["author"] = quote.css("small.author::text").get()
item["tags"] = quote.css("div.tags a.tag::text").getall()
yield item
```
L’extrait ci-dessus définit la classe `QuotesSpider()` qui effectue les opérations suivantes :
- Définit l’URL à scraper.
- Définit la règle de pagination avec la classe`Rule()`, permettant au crawler de suivre toutes les pages suivantes.
- Extrait la citation, l’auteur et la balise à l’aide de la méthode`parse_item()`.
### Étape n° 4 : définir les paramètres
L’ajout des données à un fichier CSV nécessite certaines configurations spéciales dans Scrapy. Pour ce faire, ouvrez le fichier `settings.py` et ajoutez-y les variables suivantes :
```none
FEED_FORMAT = "csv"
FEED_URI = "quotes.csv"
```
Voici ce que font ces paramètres :
- `FEED_FORMAT`définit le format de sortie du fichier ([qui peut être de différents types](https://docs.scrapy.org/en/latest/topics/feed-exports.html#topics-feed-format-csv))
- `FEED_URI`définit le nom du fichier de sortie
### Étape n° 5 : lancer le crawler
Les fichiers Python non mentionnés dans les étapes précédentes ne sont pas utiles pour ce tutoriel, vous pouvez donc les laisser avec les données par défaut.
Pour lancer le crawler, allez dans le dossier `quotes_scraper/`:
```none
cd quotes_scraper
```
Ensuite, lancez le crawler :
```none
scrapy crawl quotes
```
Cette commande instancie la classe `QuotesSpider()` dans le fichier `quotes_spider.py`, qui est celle qui lance le crawler. Le fichier CSV final que vous obtenez est identique à celui que vous avez obtenu avec Requests et BeautifulSoup !
Cet exemple montre donc :
- En quoi Scrapy est plus adapté aux projets de grande envergure en raison de sa nature.
- La gestion de la pagination est plus facile avec Scrapy, car vous n’avez qu’à gérer une règle au lieu d’écrire une logique personnalisée, comme dans le cas précédent.
- Comment l’ajout de données à un fichier CSV est plus simple avec Scrapy. En effet, vous n’avez qu’à ajouter deux paramètres au lieu de créer la logique personnalisée classique que vous créeriez en écrivant un script Python qui le ferait.
## Limitations communes entre Scrapy et Requests
Bien que Scrapy et Requests soient largement utilisés dans les projets de Scraping web, ils présentent certains inconvénients.
Plus précisément, l’une des limitations courantes auxquelles toutes les bibliothèques ou tous les frameworks de scraping sont soumis est[le bannissement d’adresse IP](/blog/proxy-101/how-to-bypass-an-ip-ban). Vous avez appris que Scrapy offre une fonction de limitation, qui permet d’ajuster la vitesse à laquelle le serveur est sollicité. Cependant, cela n’est souvent pas suffisant pour éviter que votre adresse IP ne soit bannie.
La solution pour éviter que votre IP ne soit bannie consiste à implémenter des Proxys dans votre code. Voyons comment !
### Utilisation d’un Proxy avec Requests
Si vous souhaitez utiliser un seul Proxy dans Requests, utilisez la logique suivante :
```none
Proxy = {
"http": "",
"https": ""
}
response = requests.get(url, proxies=Proxy)
```
Pour en savoir plus sur les proxys et la rotation des proxys dans `Requests`, consultez ces guides sur notre blog :
- [Guide d’utilisation d’un Proxy avec Python Requests](/blog/proxy-101/proxy-with-python-requests)
- [Comment utiliser des proxys pour faire tourner les adresses IP dans Python](/blog/how-tos/python-ip-rotation)
### Utilisation d’un Proxy dans Scrapy
Si vous souhaitez implémenter un seul Proxy dans votre code, ajoutez les paramètres suivants au fichier `settings.py`:
```none
# Configurer un seul Proxy
HTTP_PROXY = ""
# Activer HttpProxyMiddleware et désactiver UserAgentMiddleware par défaut
DOWNLOADER_MIDDLEWARES = {
'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 110,
'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None,
}
```
Ces paramètres achemineront toutes les requêtes via le Proxy spécifié. Pour en savoir plus, consultez notre[guide d’intégration du Proxy Scrapy](/integration/scrapy).
Si vous souhaitez plutôt mettre en place des Proxys rotatifs, vous pouvez utiliser la[bibliothèque`scrapy-rotating-proxies`](https://pypi.org/project/scrapy-rotating-proxies/). De même, vous pouvez utiliser un Proxy résidentiel à rotation automatique.
Si vous recherchez des Proxys fiables, n’oubliez pas que le réseau de Proxys de Bright Data bénéficie de la confiance des entreprises du Fortune 500 et de plus de 20 000 clients dans le monde entier. Ce vaste réseau comprend :
- [**Proxys résidentiels**](/proxy-types/residential-proxies): plus de 72 millions d’IPs résidentielles dans plus de 195 pays.
- [**Proxy de centre de données**](/proxy-types/datacenter-proxies): plus de 770 000 adresses IP de centre de données.
- [**Proxy ISP**](/proxy-types/isp-proxies): plus de 700 000 adresses IP ISP.
- [**Proxy mobile**](/proxy-types): plus de 7 millions d’adresses IP mobiles.
## Conclusion
Dans cet article de blog comparant Scrapy et Requests, vous avez découvert le rôle de ces deux bibliothèques dans le Scraping web. Vous avez exploré leurs fonctionnalités pour la récupération de pages et l’extraction de données, et comparé leurs performances dans un scénario de pagination réel.
Requests nécessite davantage de logique manuelle, mais offre une plus grande flexibilité pour les cas d’utilisation personnalisés, tandis que Scrapy est légèrement moins adaptable, mais fournit la plupart des outils nécessaires au scraping structuré.
Vous avez également découvert leurs limites, telles que [les interdictions](/blog/proxy-101/how-to-bypass-an-ip-ban) potentielles [d’IP](/blog/proxy-101/how-to-bypass-an-ip-ban) et les problèmes liés au contenu géo-restreint. Heureusement, ces défis peuvent être surmontés[à l’aide de proxys](/proxy-types)ou[de](/proxy-types)solutions de Scraping web dédiées telles que[les Web Scrapers](/products/web-scraper) de Bright Data.
Les Scrapers s’intègrent parfaitement à Scrapy et Requests, vous permettant d’extraire des données publiques des principaux sites web sans aucune restriction.
Créez dès aujourd’hui un compte Bright Data gratuit pour découvrir nos API Proxy et Scraper et commencer votre essai gratuit !
Contacter ventesEssai gratuit
Table des matières
Dedicated Scraper APIs & No-Code Scrapers
Over 1000 scrapers for all popular domains. Simplify your web scraping.
[See pricing](/pricing/web-scraper "See pricing")
Just want data? Skip scraping.
Hundreds of ready-to-use datasets from all popular domains.
[See pricing](/pricing/datasets "See pricing")
[ ](https://news.ycombinator.com/submitlink?t=Scrapy+ou+Requests+%3A+lequel+est+le+meilleur+pour+le+Scraping+web+%3F&u=https://brightdata.fr/blog/donnees-web/scrapy-vs-requests) [ ](https://www.linkedin.com/shareArticle?mini=true&title=Scrapy+ou+Requests+%3A+lequel+est+le+meilleur+pour+le+Scraping+web+%3F&url=https://brightdata.fr/blog/donnees-web/scrapy-vs-requests) [ ](http://www.reddit.com/submit?title=Scrapy+ou+Requests+%3A+lequel+est+le+meilleur+pour+le+Scraping+web+%3F&url=https://brightdata.fr/blog/donnees-web/scrapy-vs-requests)
## Vous pourriez aussi être intéressé par
[  ](https://brightdata.fr/blog/ai/openhuman-with-bright-data "Accès Web Prêt pour la Production dans OpenHuman via le CLI Bright Data")
[AI

Antonello Zanini
Technical Writer
### Accès Web Prêt pour la Production dans OpenHuman via le CLI Bright Data
Intégrez le CLI Bright Data avec OpenHuman pour permettre un accès web prêt pour la production et la collecte de données pour les agents IA.
09-Sep-2026
14 min de lecture
](https://brightdata.fr/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.fr/blog/donnees-web/multimodal-web-scraping-with-minimax "Scraping Web Multimodal avec MiniMax")
[Données Web

Antonello Zanini
Technical Writer
### Scraping Web Multimodal avec MiniMax
Associez Bright Data Web Unlocker avec la vision MiniMax M3 pour extraire des données structurées à partir d’images et de captures d’écran de pages web.
09-Sep-2026
5 min de lecture
](https://brightdata.fr/blog/donnees-web/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.fr/blog/ai/best-cli-tools-for-codex "Les 10 meilleurs outils CLI pour Codex en 2026 – Testés & Classés")
[AI

Daniel Shashko
Web Data & AI Expert
### Les 10 meilleurs outils CLI pour Codex en 2026 – Testés & Classés
Les 10 outils CLI qui rendent Codex plus rapide et plus capable, en commençant par le Bright Data CLI pour un accès web réel depuis l’intérieur du sandbox.
06-Sep-2026
24 min de lecture
](https://brightdata.fr/blog/ai/best-cli-tools-for-codex)